书上216页对于汉明码的讲解过于勾史,所以特意写了一份文档,深入解析汉明码的工作原理。
为什么需要汉明码
在计算机通信或内存存储(如ECC内存)中,数据以二进制(0和1)形式传输。由于电磁干扰等原因,原本的“0”可能会变成“1”,或者“1”变成“0”。已有一些检错机制,例如奇偶校验,但是奇偶校验只能检测传输过程中是否发生错误,但是无法指出错误发生在哪一位。而汉明码解决了这一问题,它不仅能检测出错误,还能指出错误发生在哪一位。
汉明码的工作原理
利用汉明码检错时,可以分为两个过程:编码过程和检错过程。编码过程在原始二进制序列加入若干校验位后变成汉明码;检错过程接受传输过来的汉明码,并检查是否有传输错误。
下面通过一个例子讲解这一过程:我们要传输 11000100 的二进制序列。
编码过程:原始二进制序列→汉明码
首先,我们将 \(k=4\) 个校验位插入 \(n=8\) 个数据位中,最终形成 \(k+n=12\) 位汉明码。在最终的12位汉明码中,第1,2,4,8(2的幂次)位是新插入的校验位,其它位是原始的二进制数。
1 | index 1 2 3 4 5 6 7 8 |
然后分别计算 \(P_1\), \(P_2\), \(P_4\), \(P_8\)的值。\(P_i\) 的计算方式是:
- 找出 \(k=4\) 位二进制数中,右边第 \(log_2i\) 位(从0开始数)是 1 的数(这个数大于 \(i\),且不超过汉明码的位数 \(n+k\)),把这个数加入集合 \(S\)。
- \(P_n=\text{Xor}(P_i), i \in S\)。
例如,计算 \(P_2\)。我们要找到右边第 1 位(从0开始数)是 1 的数。这些数包括
1 | 3=0011 |
于是 \(S={3,6,7,10,11}\), \(P_2=\text{Xor}(P_3,P_6, P_7, P_{10}, P_{11})\)。
通过这一算法,我们可以算出 \(P_1, P_2, P_4, P_8\) 的值: \[ \begin {aligned} P_1&=\text{Xor}(P_3,P_5, P_7, P_9, P_{11})=0 \\\\ P_2&=\text{Xor}(P_3,P_6, P_7, P_{10}, P_{11})=0 \\\\ P_4&=\text{Xor}(P_5,P_6, P_7, P_{12})=1 \\\\ P_8&=\text{Xor}(P_9,P_{10}, P_{11}, P_{12})=1 \end {aligned} \] 因此,最终得到的 \(k+n=12\) 位汉明码为:
1 | index 1 2 3 4 5 6 7 8 9 10 11 12 |
检错过程:汉明码→错误位
接收到二进制序列后,我们需要检查它们是否有误。检查规则如下:
\[ \begin {aligned} C_1&=\text{Xor}(P_1, P_3,P_5, P_7, P_9, P_{11}) \\\\ C_2&=\text{Xor}(P_2, P_3,P_6, P_7, P_10, P_{11}) \\\\ C_4&=\text{Xor}(P_4, P_5, P_6, P_7,P_{12}) \\\\ C_8&=\text{Xor}(P_8, P_9, P_{10}, P_{11}, P_{12}) \end {aligned} \]
也就是
\[ \begin {aligned} C_1&=\text{Xor}(P_1, P_1^{'}) \\\\ C_2&=\text{Xor}(P_2, P_2^{'}) \\\\ C_4&=\text{Xor}(P_4, P_4^{'}) \\\\ C_8&=\text{Xor}(P_8, P_8^{'}) \end {aligned} \] 其中 \(P_i^{'}, i为2的幂次\) 表示接收到的二进制序列的校验位的“实然值”,\(P_i, i为2的幂次\) 表示校验位的“应然值”。如果应然值=实然值(即\(C_8C_4C_2C_1=0000\)),那么信息传输没有出错。
那么传输出错时会发生什么呢?看一个例子。
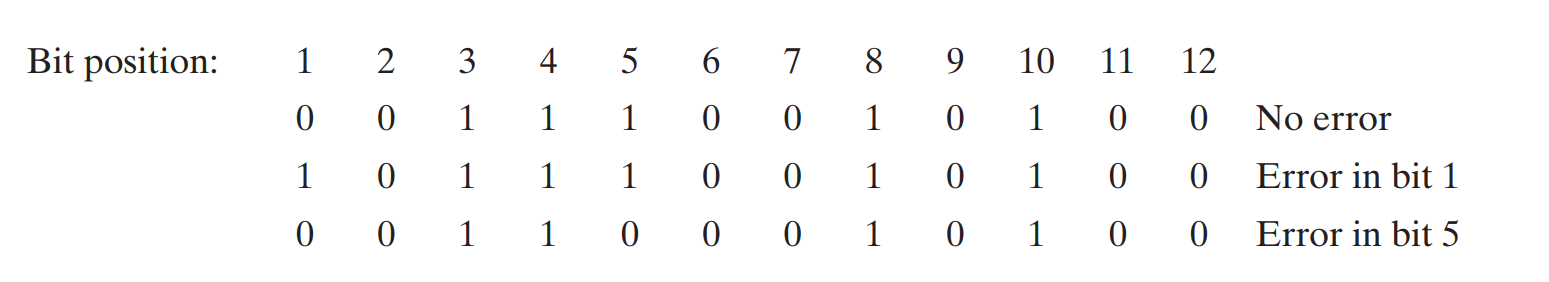
假设第1位出错,那么 \(C_8C_4C_2C_1=0001\),\(0001=1\);
假设第5为出错,那么 \(C_8C_4C_2C_1=0101\),\(0101=5\)。
为什么有这种巧妙的映射关系?这正来源于汉明码的精巧设计。
我们以第 5 位出错为例。在编码过程中,位置 5 的信息实际流向了两个部分:\(P_1\) 和 \(P_4\)。\(P_1\) 和 \(P_4\) 正是 5(0101)中为 1 的两位。在计算 \(C_8C_4C_2C_1\) 的时候,我们发现 \(C_1=1\),说明传输错误出现在3,5,7,9,11位;我们还发现 \(C_4=1\),说明传输错误出现在5,6,7,12位。两者的交集是5,所以第 5 位出现了传输错误。
\(n\) 和 \(k\) 的关系
让我们追本溯源。为什么 \(n=8\) 位二进制序列需要 \(k=4\) 个校验位呢?更普遍的问题是,如何根据 \(n\) 确定 \(k\)?\(n\) 和 \(k\) 有什么关系?
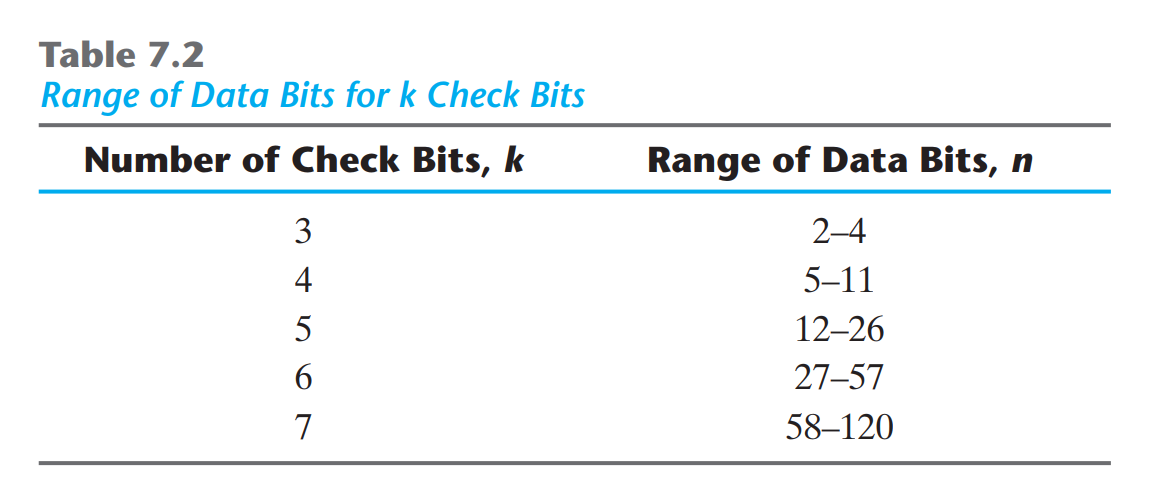
这里的核心逻辑是,\(C_kC_{k-1}...C_2C_1\) 要能够表示所有的错误情况。而全 0 代表没有出错,所以 \(C_kC_{k-1}...C_2C_1\) 最多能表示 \(2^k-1\) 种错误。而 \(n+k\) 位汉明码最多出现 \(n+k\) 种错误,因此 \(2^k-1≥n+k\)。这就是 \(n\) 和 \(k\) 的关系。
因此,在确定校验位个数 \(k\) 的时候,我们需要找到使 \(2^k-1≥n+k\) 成立的最小 \(k\)。下表列出了一些常见情况:
校验位错了怎么办
如果数据传输的过程中,出错的不是数据位,而是校验位怎么办?这样 \(P_i, i为2的幂次\) 就不是校验位的“使然值”了,算法还正确吗?
答案是肯定的:在汉明码看来,校验位和数据位是“平等”的。如果校验位本身在传输中出错了,汉明码同样能准确地定位到它,并把它纠正回来。
例如,\(P_1\) 出错,\(C_8C_4C_2C_1=0001\),表示第一位出错(其实上面也有写)
异或的真面目
我们也许对于“异或”操作有些疑惑。为什么偏偏是异或呢?为什么不能是与、或、同或,甚至其它运算呢?
书上有一行不起眼的字:“异或运算执行检‘奇’功能,当变量中1的个数为奇数时,结果为1;为偶数个1时,结果为0”。
实际上,“异或”检查的是一串数中为1的个数。如果1有偶数个,那么异或出来就是0;如果1有奇数个,那么异或出来就是1。说白了,还是和奇偶校验有关。
所以在实际做题的时候,我们没有必要老老实实地做异或运算,只需要数一数1有几个就可以了。
定理 设 \(x_1, x_2, ..., x_k\) 是一个二进制数序列,\(x_i \in \{0,1\}\)。则 \[ \text{Xor}(x_1, x_2, ...,x_k)= \begin{cases} 1 & x_1, x_2, ...,x_k中有奇数个1 \\\\ 0 & x_1, x_2, ...,x_k中有偶数个1 \end{cases} \]
汉明码的局限
虽然汉明码不担心校验位出错,但它有一个硬伤:它默认二进制序列只有一个位出错。如果有两个甚至多个位出错,汉明码检测不出来。因此,现代 ECC 内存通常使用 SEC-DED(扩展汉明码)。它在最后多加了一位“全总校验位”(全总校验位=前面所有位的异或),可以实现:
- 如果是 1 位错:定位并修好它。
- 如果是 2 位错:总校验位会发现异常,大喊“错得太多了,我修不了,但我知道数据坏了”,从而避免系统读入错误数据。