1 从线性分类器到深度学习
1.1 前几讲的优化问题回顾
监督学习的基本设置是:给定训练集 \(\{(x_i, y_i)\}_{i=1}^{N}\),模型用一个得分函数(score function)把输入 \(x\) 映射为每个类别的分数 \(s\),再用损失函数(loss function)衡量预测分数和真实标签之间的差距。在线性分类器中,常见形式是
\[ s = f(x; W) = Wx \]
其中 \(W\) 是要学习的参数。损失函数可以是多类 SVM/hinge loss,也可以是 softmax cross-entropy。完整训练目标通常由两部分组成:
\[ L(W) = L_{\text{data}}(W) + L_{\text{reg}}(W) \]
数据损失负责让模型拟合训练样本,正则化项负责限制参数复杂度,减少过拟合风险。
优化的核心问题是找到让损失尽可能小的参数 \(W\)。梯度下降(Gradient Descent)的更新形式为
\[ W \leftarrow W - \eta \nabla_W L \]
其中 \(\eta\) 是学习率。若直接对全部 \(N\) 个样本求和,代价会很高,因此实际训练常使用小批量随机梯度下降(Stochastic Gradient Descent, SGD):
\[ \nabla_W L \approx \frac{1}{|\mathcal{B}|}\sum_{i \in \mathcal{B}} \nabla_W L_i \]
这里 \(\mathcal{B}\) 是 minibatch,常见大小包括 \(32, 64, 128, 256\)。
1.2 数值梯度与解析梯度
梯度可以通过两种方式获得。
| 方法 | 优点 | 缺点 | 典型用途 |
|---|---|---|---|
| 数值梯度(Numerical Gradient) | 容易写,概念直观 | 很慢,只是近似值 | 检查实现是否正确 |
| 解析梯度(Analytic Gradient) | 快,精确 | 推导和实现容易出错 | 实际训练使用 |
实际深度学习代码的基本原则是:训练时使用解析梯度,但用数值梯度做 gradient check。这个原则在手写反向传播时特别重要,因为一个符号、维度或广播错误都可能让模型无法正常收敛。
1.3 优化器与学习率调度
SGD 是最基础的优化方法。在此基础上,现代训练还经常使用动量(Momentum)、RMSProp、Adam 等优化器。它们的共同目标是让参数更新方向更稳定、更适应不同参数的梯度尺度。
学习率调度(Learning Rate Scheduling)同样重要。常见策略包括:
| 策略 | 思想 | 适用直觉 |
|---|---|---|
| Step decay | 在固定 epoch 将学习率乘以某个系数,例如 ResNet 训练中在 30、60、90 epoch 乘 \(0.1\) | 简单可靠,常用于经典 CNN 训练 |
| Cosine decay | 学习率按余弦曲线平滑下降 | 避免突变,现代训练中常见 |
| Linear decay | 从初始学习率线性下降到较小值 | 易理解,常用于 warmup 后衰减 |
| Inverse square-root decay | 学习率随训练步数按反平方根衰减 | Transformer 训练中常见 |
考试重点:优化器和学习率调度改变的是“如何走向较小损失”,而神经网络结构改变的是“模型能表示什么函数”。Lecture 4 的主线是后者,以及如何高效计算这些结构的梯度。
2 全连接神经网络(Fully-Connected Network)
2.1 线性分类器的局限
线性分类器只能学习输入空间中的线性决策边界。如果数据在原始坐标中无法被直线或超平面分开,那么单层线性模型无论怎么优化都无法得到理想分类结果。
一个二维例子是:红点和蓝点在 \((x, y)\) 平面中呈环状或角度结构分布。原始坐标中没有一条直线可以将两类完全分开,但如果把坐标变换为极坐标特征
\[ \phi(x, y) = (r(x, y), \theta(x, y)) \]
变换后的空间可能就能用线性边界分开。这个例子说明:分类难不一定是线性分类器本身的优化问题,而可能是特征表示不够好。
2.2 两层神经网络
神经网络的核心思想是让模型自己学习特征变换。线性分类器可以写成
\[ s = Wx \]
两层神经网络可以写成
\[ h = \sigma(xW_1) \]
\[ s = hW_2 \]
或合并为
\[ s = \sigma(xW_1)W_2 \]
其中 \(W_1\) 把输入映射到隐藏层,\(\sigma\) 是非线性激活函数,\(W_2\) 把隐藏表示映射到类别分数。实际实现中通常还会加入可学习偏置:
\[ h = \sigma(xW_1 + b_1), \qquad s = hW_2 + b_2 \]
如果输入是一张 CIFAR-10 图像,展平后维度是 \(32 \times 32 \times 3 = 3072\)。一个隐藏层大小为 \(100\)、类别数为 \(10\) 的网络可以理解为
\[ x \in \mathbb{R}^{3072} \rightarrow h \in \mathbb{R}^{100} \rightarrow s \in \mathbb{R}^{10} \]
第一层学习 \(100\) 个中间模板或特征,第二层把这些模板组合成 \(10\) 个类别的分数。
2.3 全连接网络、MLP 与层数命名
“神经网络(Neural Network)”是很宽泛的说法。在这讲中讨论的结构更准确地叫做全连接网络(Fully-Connected Network)或多层感知机(Multi-Layer Perceptron, MLP)。
命名时要注意:课程中常把带一个隐藏层的网络称为 2-layer neural network,因为只数带参数的线性层:
\[ x \rightarrow W_1 \rightarrow h \rightarrow W_2 \rightarrow s \]
因此:
| 结构 | 常见名称 | 隐藏层数 |
|---|---|---|
| 输入 \(\rightarrow\) 线性层 \(\rightarrow\) 输出 | 1-layer model / linear classifier | 0 |
| 输入 \(\rightarrow\) 隐藏层 \(\rightarrow\) 输出 | 2-layer neural net | 1 |
| 输入 \(\rightarrow\) 隐藏层 \(\rightarrow\) 隐藏层 \(\rightarrow\) 输出 | 3-layer neural net | 2 |
易错点:激活函数通常不单独算作一层,dropout、normalization 等也不一定计入“layer”命名;具体论文或框架可能有不同习惯,要看上下文。
3 非线性激活函数与表达能力
3.1 为什么必须有非线性
如果没有激活函数,两层网络会退化为线性分类器:
\[ s = (xW_1)W_2 = x(W_1W_2) \]
令
\[ W' = W_1W_2 \]
则
\[ s = xW' \]
这和原始线性分类器没有本质区别。即使堆很多层线性变换,它们的复合仍然是一个线性变换:
\[ xW_1W_2\cdots W_k = xW' \]
因此,神经网络的表达能力来自线性层和非线性激活函数的交替组合。非线性让网络能够学习弯曲、分段、层级化的决策边界。
3.2 ReLU 作为默认激活函数
课程中把 ReLU 作为多数问题的良好默认选择:
\[ \mathrm{ReLU}(x) = \max(0, x) \]
ReLU 的优点包括:
- 计算简单;
- 正区间梯度为 \(1\),有利于梯度传播;
- 输出具有稀疏性,负值被截断为 \(0\);
- 在全连接网络和卷积网络中都很常用。
ReLU 的局部导数为
\[ \frac{d}{dx}\max(0,x)= \begin{cases} 1, & x>0 \\ 0, & x<0 \end{cases} \]
在 \(x=0\) 处不可导,实际实现中通常约定为 \(0\) 或任意子梯度值,这不会影响大多数训练过程。
3.3 前向传播示例
一个简单的两层网络训练代码可以非常短。以均方误差损失和 sigmoid 隐藏层为例:
1 | import numpy as np |
这段代码包含了深度学习训练循环的几个核心环节:
- 定义网络参数;
- 前向传播得到预测;
- 计算损失;
- 反向传播得到梯度;
- 用梯度下降更新参数。
关键理解:前向传播只是计算输出;真正让网络能学习的是反向传播计算出的每个参数对最终损失的影响。
4 网络容量、正则化与生物神经元类比
4.1 层数和隐藏单元数控制容量
隐藏层越宽、层数越深,模型通常具有更大的表示能力。隐藏单元可以理解为学习到的中间模板或特征,更多隐藏单元意味着模型可以组合更多模式。
但容量更大并不自动等于泛化更好。容量太小会欠拟合,容量太大又可能记住训练集噪声。课程中特别强调:不要把缩小网络规模当作主要正则化手段。更推荐的做法是使用更强的正则化,例如权重衰减、dropout、数据增强、早停等。
直觉上,如果一个大网络在训练集上表现很好但验证集不好,问题通常是泛化控制不足;直接把网络砍小可能会损失表示能力。更合理的方式是保留足够容量,同时通过正则化约束其有效复杂度。
4.2 生物神经元类比要谨慎
人工神经网络的命名受到生物神经元启发:输入类似树突接收信号,权重类似突触强度,激活函数类似神经元发放。但这种类比只能帮助入门,不能当作精确解释。
生物神经元和人工神经元的差别很大:
- 生物神经元有许多类型,不是统一的简单计算单元;
- 树突本身可以进行复杂非线性计算;
- 突触不是单个标量权重,而是复杂动态系统;
- 生物神经连接模式复杂,而常规人工网络为了计算效率组织成规则层。
结论:在 CS231n 的语境中,神经网络应主要被理解为可微分函数组合,而不是对大脑的忠实模拟。
5 损失函数、计算图与反向传播动机
5.1 神经网络如何接入损失函数
神经网络替代了线性分类器中的线性得分函数。原来可能是
\[ s = Wx \]
现在可以是
\[ s = W_2 \sigma(W_1x) \]
再把 \(s\) 输入 hinge loss 或 softmax loss。完整目标仍然是
\[ L = L_{\text{data}}(s, y) + L_{\text{reg}}(W_1,W_2) \]
若要学习 \(W_1\) 和 \(W_2\),必须计算
\[ \frac{\partial L}{\partial W_1}, \qquad \frac{\partial L}{\partial W_2} \]
对于简单线性模型,手推梯度还能接受;但对于深层网络、复杂损失、分支结构和现代模型,直接在纸上推完整矩阵微积分会非常繁琐。
5.2 计算图的思想
计算图(Computational Graph)把复杂函数拆成许多简单操作节点。每个节点只负责一个局部运算,例如加法、乘法、矩阵乘法、ReLU、sigmoid、loss 等。
例如一个线性分类器加 hinge loss 和正则化可以被拆成:
\[ x, W \rightarrow s = xW \rightarrow L_{\text{data}} \]
\[ W \rightarrow L_{\text{reg}} \]
\[ L = L_{\text{data}} + L_{\text{reg}} \]
神经网络、卷积网络、AlexNet,甚至更复杂的模型,都可以表示为计算图。图越复杂,手推整体梯度越痛苦,但每个节点的局部梯度往往很简单。
5.3 反向传播的核心定义
反向传播(Backpropagation)就是沿计算图递归应用链式法则,计算所有输入、参数和中间变量对最终损失的梯度。
每个节点在前向传播时计算输出,并缓存反向传播所需的中间值;在反向传播时接收来自后面节点的上游梯度,再乘以本节点的局部梯度,得到对输入的下游梯度。
可以概括为:
\[ \text{downstream gradient} = \text{upstream gradient} \times \text{local gradient} \]
这句话是整讲最核心的公式化直觉。
6 标量反向传播:链式法则如何在图上传递
6.1 简单例子:\(f(x,y,z)=(x+y)z\)
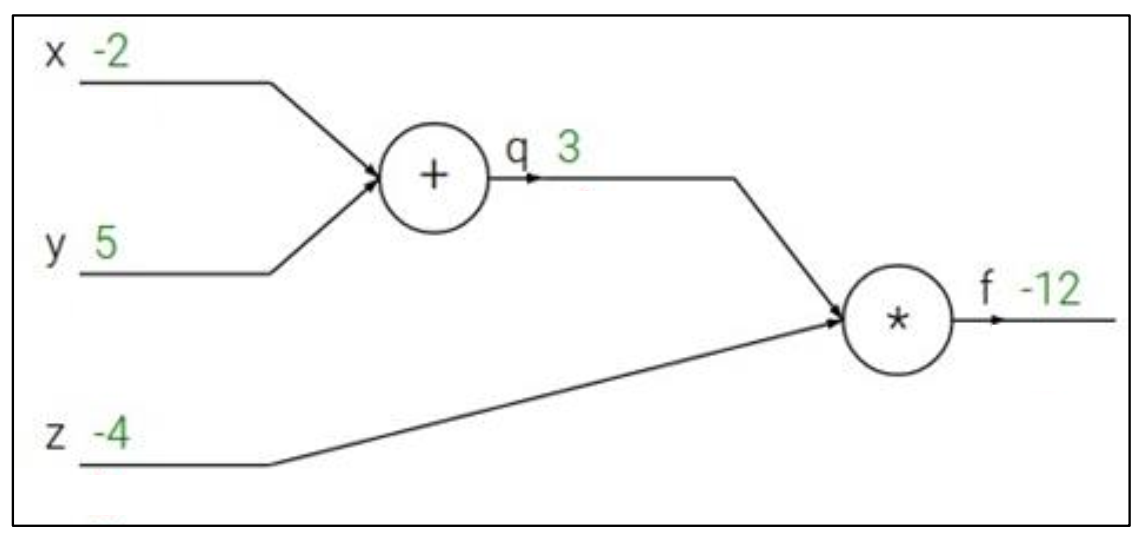
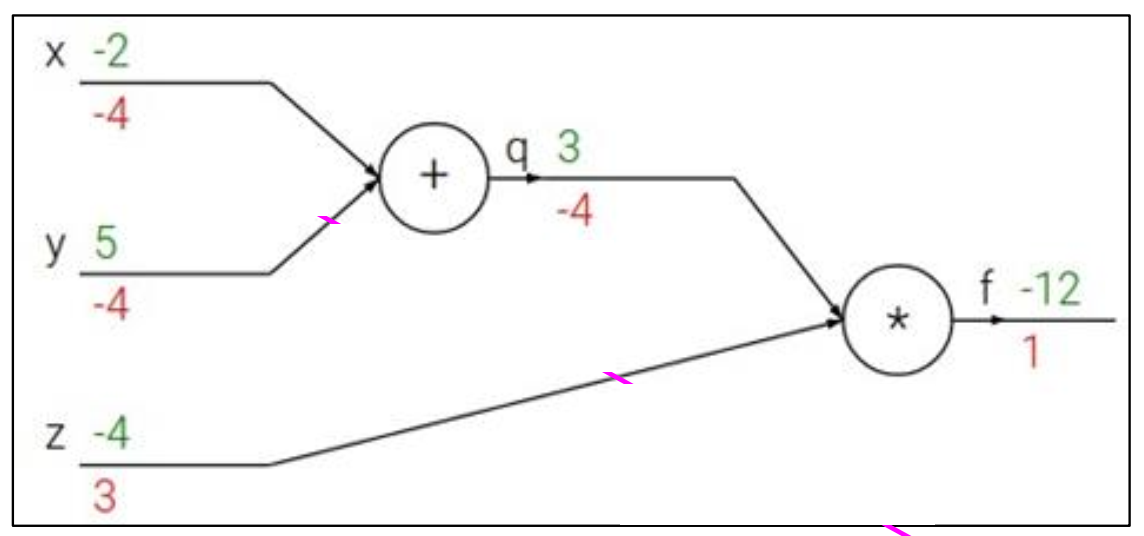
设
\[ f(x,y,z) = (x+y)z \]
并取
\[ x=-2,\qquad y=5,\qquad z=-4 \]
先拆成两个中间步骤:
\[ q = x + y \]
\[ f = qz \]
前向传播得到
\[ q = -2 + 5 = 3 \]
\[ f = 3 \times (-4) = -12 \]
局部导数为
\[ \frac{\partial q}{\partial x}=1,\qquad \frac{\partial q}{\partial y}=1 \]
\[ \frac{\partial f}{\partial q}=z,\qquad \frac{\partial f}{\partial z}=q \]
在当前数值下:
\[ \frac{\partial f}{\partial q}=-4,\qquad \frac{\partial f}{\partial z}=3 \]
最终要计算
\[ \frac{\partial f}{\partial x},\qquad \frac{\partial f}{\partial y},\qquad \frac{\partial f}{\partial z} \]
通过链式法则:
\[ \frac{\partial f}{\partial x} = \frac{\partial f}{\partial q} \frac{\partial q}{\partial x} = (-4)(1) = -4 \]
\[ \frac{\partial f}{\partial y} = \frac{\partial f}{\partial q} \frac{\partial q}{\partial y} = (-4)(1) = -4 \]
\[ \frac{\partial f}{\partial z} = q = 3 \]
因此反向传播结果是:
\[ \nabla f = \left(\frac{\partial f}{\partial x},\frac{\partial f}{\partial y},\frac{\partial f}{\partial z}\right) =(-4,-4,3) \]
6.2 上游梯度、局部梯度、下游梯度
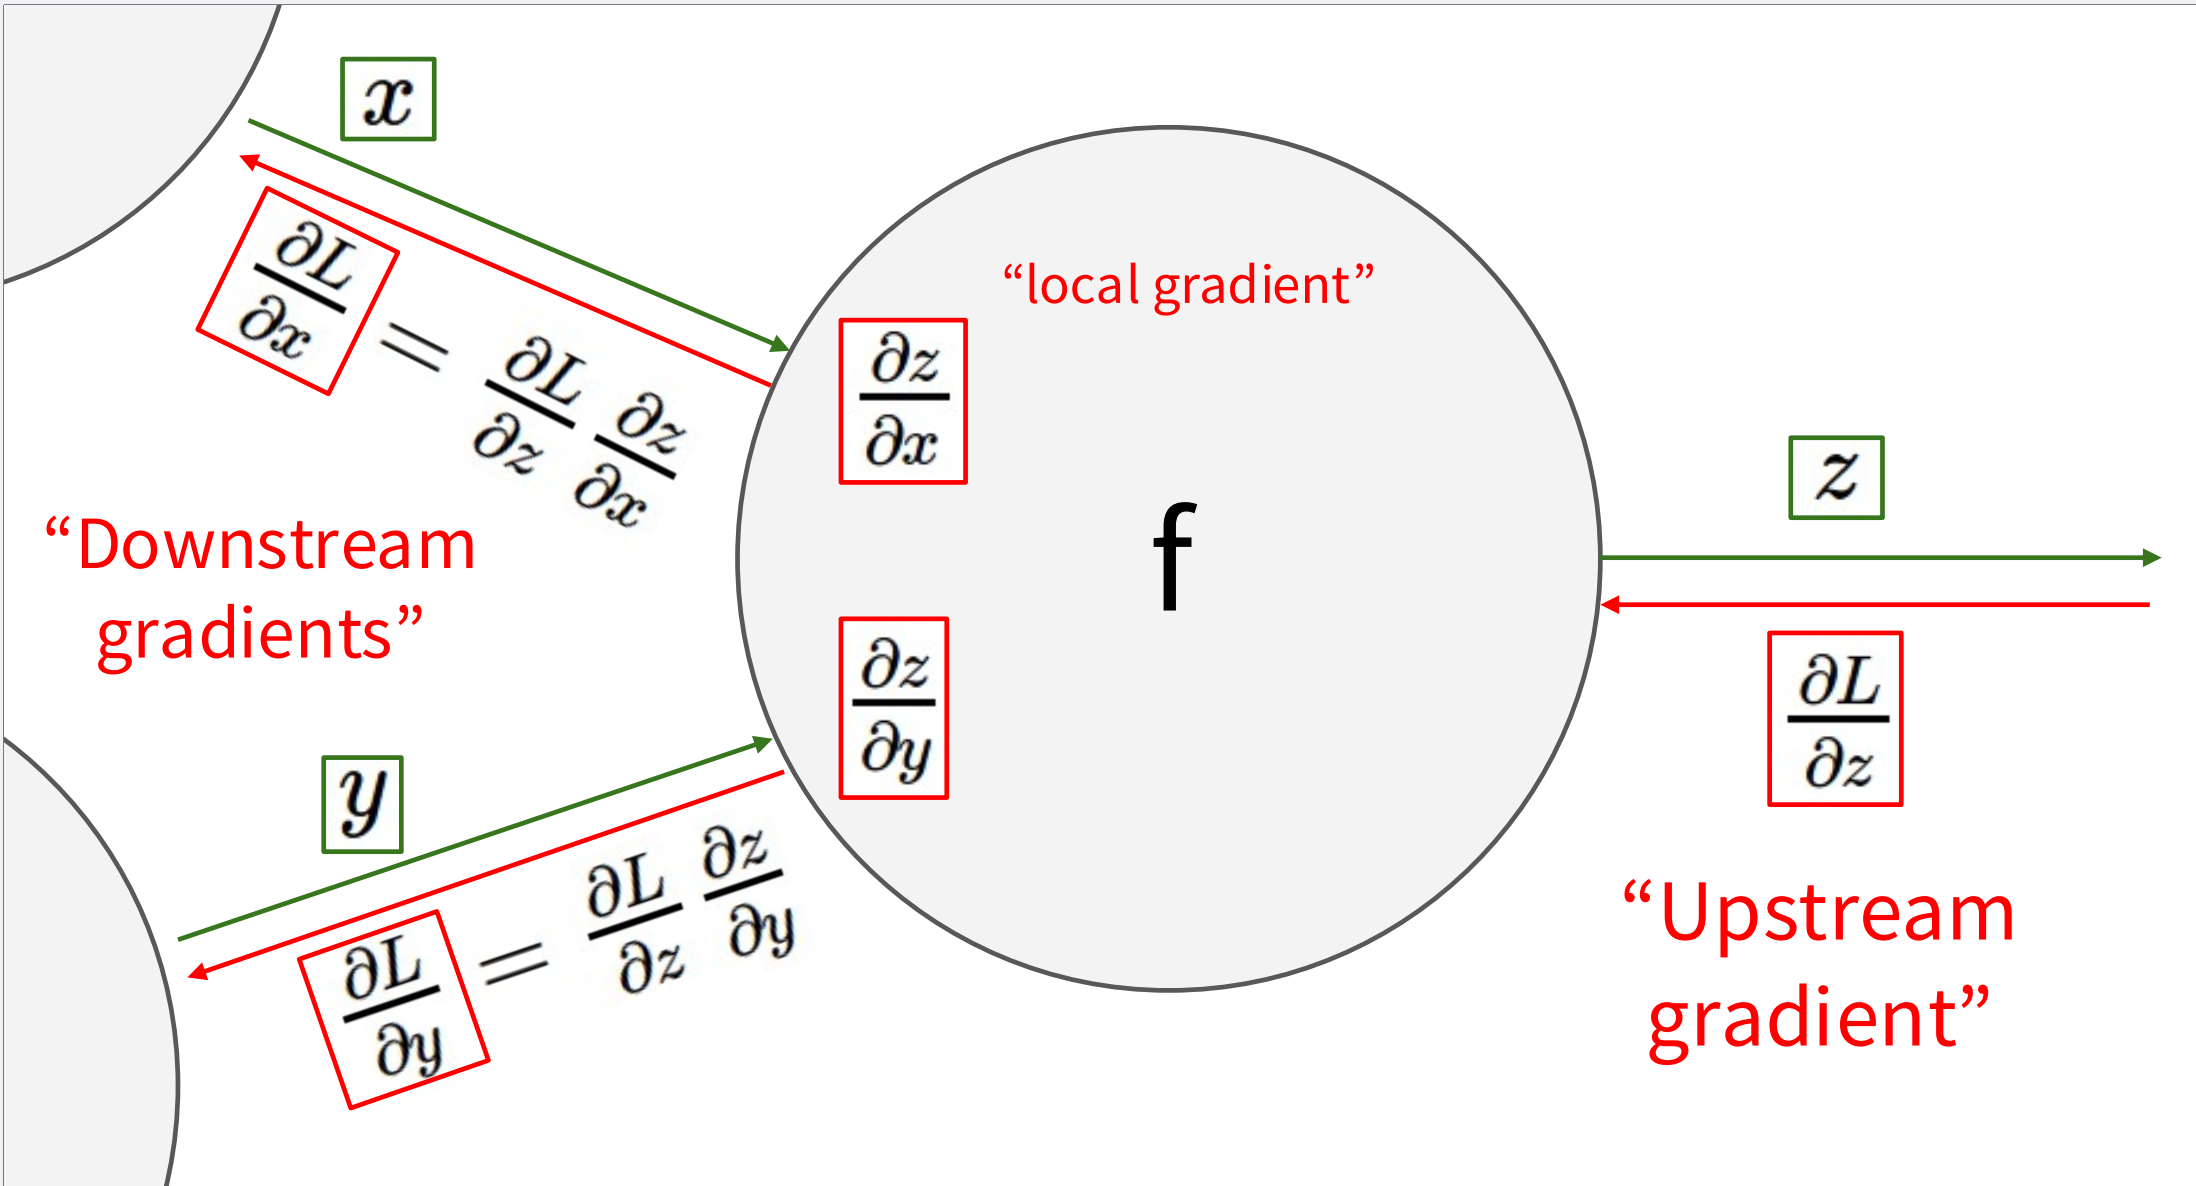
在图中,一个节点可以抽象为
\[ z = f(x,y) \]
最终损失为 \(L\)。反向传播到该节点时,后续图已经告诉我们
\[ \frac{\partial L}{\partial z} \]
这叫上游梯度(upstream gradient)。节点本身知道局部导数
\[ \frac{\partial z}{\partial x},\qquad \frac{\partial z}{\partial y} \]
因此它可以计算
\[ \frac{\partial L}{\partial x} = \frac{\partial L}{\partial z} \frac{\partial z}{\partial x} \]
\[ \frac{\partial L}{\partial y} = \frac{\partial L}{\partial z} \frac{\partial z}{\partial y} \]
这就是从右向左传播梯度的过程。
学习反向传播时最重要的心智模型:每个节点不需要理解整个网络,只需要知道“后面传来的梯度”和“自己这个小操作的局部导数”。
6.3 Sigmoid 例子
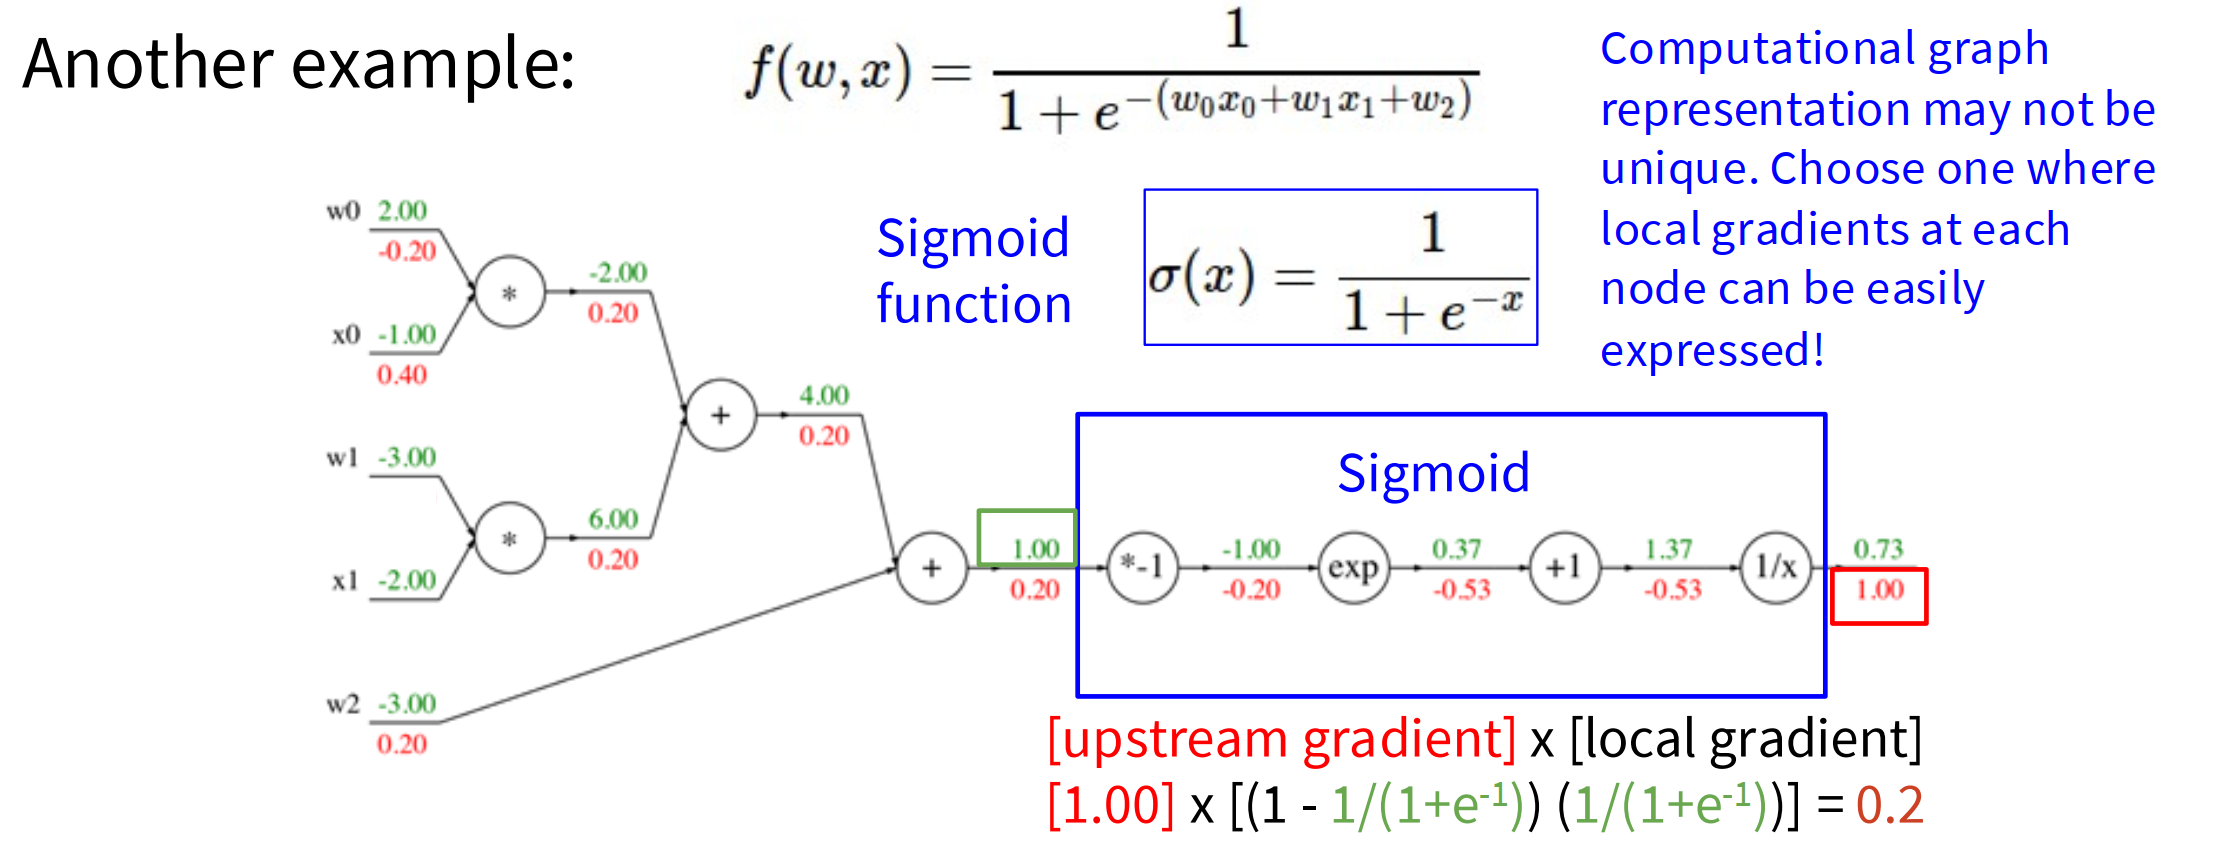
课程中的另一个例子是
\[ f(w,x)=\frac{1}{1+e^{-(w_0x_0+w_1x_1+w_2)}} \]
取
\[ w_0=2,\quad x_0=-1,\quad w_1=-3,\quad x_1=-2,\quad w_2=-3 \]
前向传播:
\[ s_0 = w_0x_0 = 2 \times (-1) = -2 \]
\[ s_1 = w_1x_1 = (-3)\times(-2)=6 \]
\[ s_2=s_0+s_1=4 \]
\[ s_3=s_2+w_2=1 \]
\[ L=\sigma(s_3)=\frac{1}{1+e^{-1}}\approx 0.73 \]
sigmoid 的导数是
\[ \frac{d\sigma(x)}{dx} = (1-\sigma(x))\sigma(x) \]
因此
\[ \frac{\partial L}{\partial s_3} = L(1-L) \approx 0.73 \times 0.27 \approx 0.20 \]
接着反向传播:
\[ \frac{\partial L}{\partial w_2}=0.20 \]
因为 \(s_3=s_2+w_2\),加法节点把梯度原样分给两个输入:
\[ \frac{\partial L}{\partial s_2}=0.20 \]
又因为 \(s_2=s_0+s_1\):
\[ \frac{\partial L}{\partial s_0}=0.20,\qquad \frac{\partial L}{\partial s_1}=0.20 \]
乘法节点 \(s_0=w_0x_0\) 给出:
\[ \frac{\partial L}{\partial w_0} = 0.20 \cdot x_0 = 0.20 \cdot (-1) = -0.20 \]
\[ \frac{\partial L}{\partial x_0} = 0.20 \cdot w_0 = 0.20 \cdot 2 = 0.40 \]
乘法节点 \(s_1=w_1x_1\) 给出:
\[ \frac{\partial L}{\partial w_1} = 0.20 \cdot x_1 = 0.20 \cdot (-2) = -0.40 \]
\[ \frac{\partial L}{\partial x_1} = 0.20 \cdot w_1 = 0.20 \cdot (-3) = -0.60 \]
这个例子非常适合练习反向传播,因为它同时包含乘法、加法、sigmoid 和多条梯度路径。
7 常见计算节点的梯度流规律
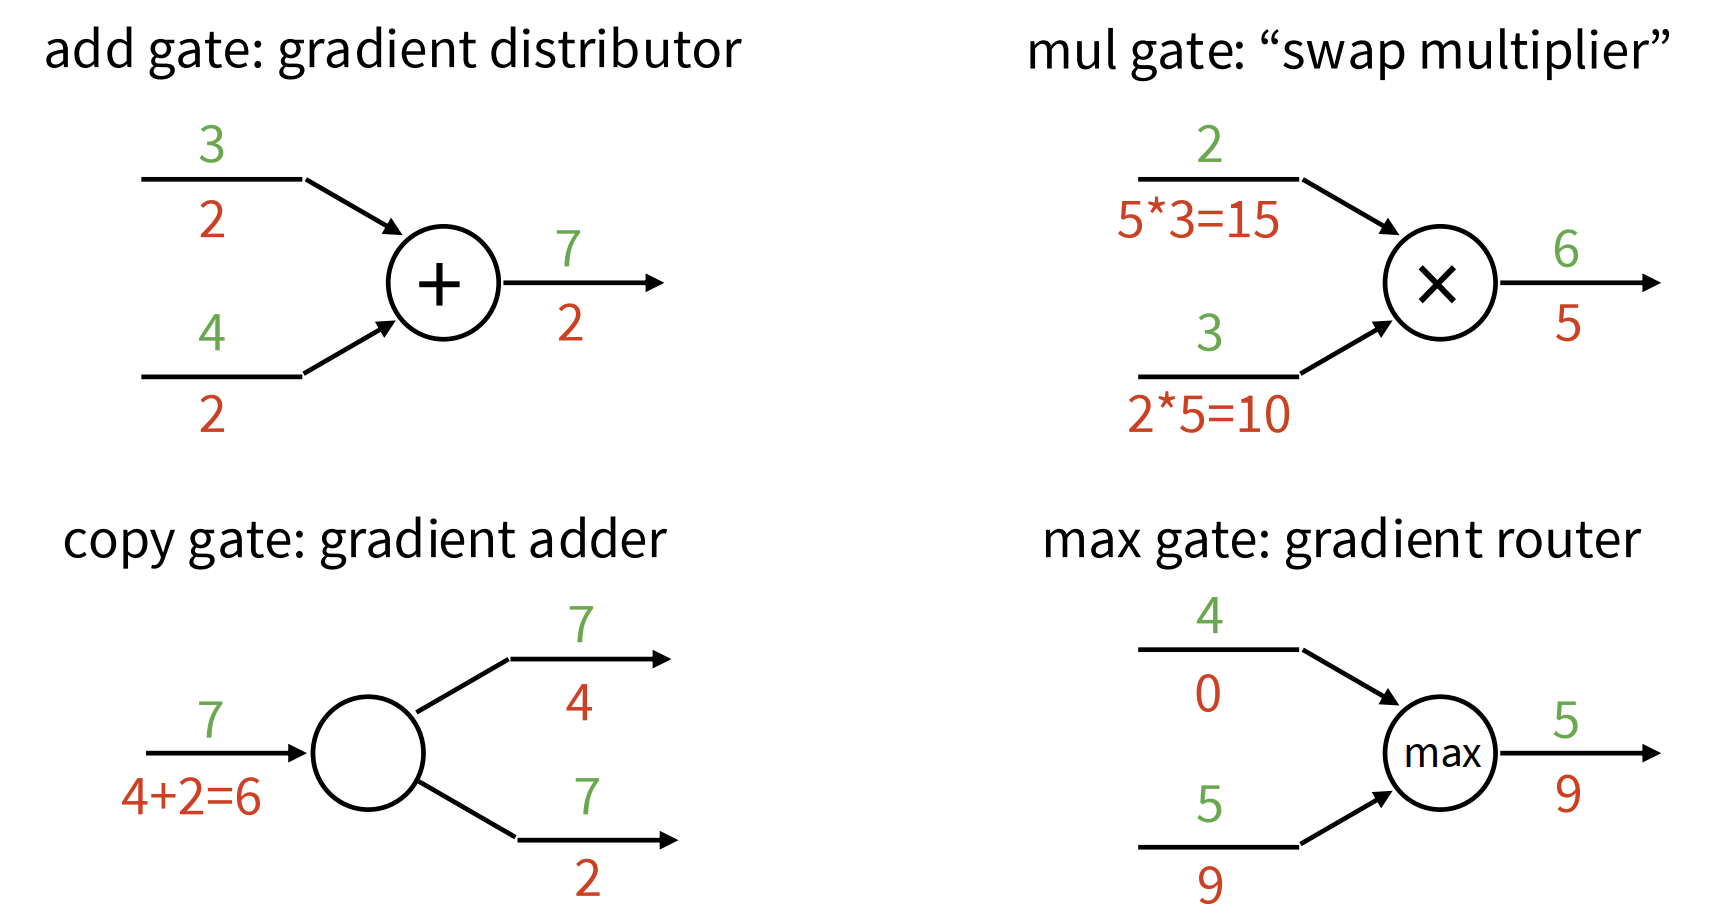
7.1 加法节点:梯度分发器
设
\[ z=x+y \]
局部导数为
\[ \frac{\partial z}{\partial x}=1,\qquad \frac{\partial z}{\partial y}=1 \]
因此如果上游梯度是 \(\frac{\partial L}{\partial z}=g\),那么
\[ \frac{\partial L}{\partial x}=g,\qquad \frac{\partial L}{\partial y}=g \]
加法节点会把上游梯度原样分发给每个输入。
7.2 乘法节点:交换乘子
设
\[ z=xy \]
局部导数为
\[ \frac{\partial z}{\partial x}=y,\qquad \frac{\partial z}{\partial y}=x \]
若上游梯度为 \(g\),则
\[ \frac{\partial L}{\partial x}=gy,\qquad \frac{\partial L}{\partial y}=gx \]
乘法节点的规律是:对某个输入求梯度时,乘上另一个输入的前向值。
7.3 复制节点:梯度相加器
如果同一个变量 \(x\) 被用于图中的多个分支,最终损失通过多条路径依赖它,那么所有路径贡献的梯度要相加:
\[ \frac{\partial L}{\partial x} = \sum_k \frac{\partial L}{\partial x}\bigg|_{\text{path }k} \]
这对应反向传播中的一个重要规则:一个变量被多次使用时,反向传播时要累加梯度,而不是覆盖梯度。
7.4 Max 节点:梯度路由器
设
\[ z=\max(x,y) \]
若 \(x>y\),则
\[ \frac{\partial z}{\partial x}=1,\qquad \frac{\partial z}{\partial y}=0 \]
若 \(y>x\),则
\[ \frac{\partial z}{\partial x}=0,\qquad \frac{\partial z}{\partial y}=1 \]
因此 max 节点会把上游梯度传给前向传播时取得最大值的输入,另一个输入得到 \(0\)。ReLU 本质上就是
\[ \max(0,x) \]
所以 ReLU 的反向传播也具有类似的“门控”效果:正值位置通过梯度,负值位置阻断梯度。
8 反向传播的代码实现方式
8.1 Flat code:手动展开计算图
对 sigmoid 例子,可以写成显式的前向和反向代码:
1 | def f(w0, x0, w1, x1, w2): |
这种写法对小例子清楚,但对大型网络不可维护。每换一个模型结构,就要手写大量反向传播代码。
8.2 Modularized implementation:forward/backward API
更通用的做法是把每个计算节点封装成对象或函数,并提供两个接口:
forward():计算输出,并缓存反向传播所需的输入或输出;backward():接收上游梯度,使用缓存的值和局部导数,返回下游梯度。
以乘法节点为例:
1 | class Multiply: |
这就是现代自动微分系统的基本思想。PyTorch、TensorFlow、JAX
等框架都维护计算图或等价的跟踪机制;前向传播时记录操作和必要中间值,调用
backward() 时自动沿图反向应用链式法则。
8.3 为什么前向传播要缓存中间值
许多局部导数依赖前向传播中的输入或输出。例如 sigmoid 的反向传播可以写成
\[ \frac{d\sigma(x)}{dx}=\sigma(x)(1-\sigma(x)) \]
如果前向传播已经算出了 \(\sigma(x)\),反向传播时直接复用这个值即可,不必重新计算指数函数。矩阵乘法、卷积、归一化等操作也类似:反向传播需要知道前向输入的形状、数值或统计量。
核心实现思想:forward 保存必要上下文,backward 消耗上游梯度并返回输入梯度。
9 向量、矩阵和张量上的反向传播
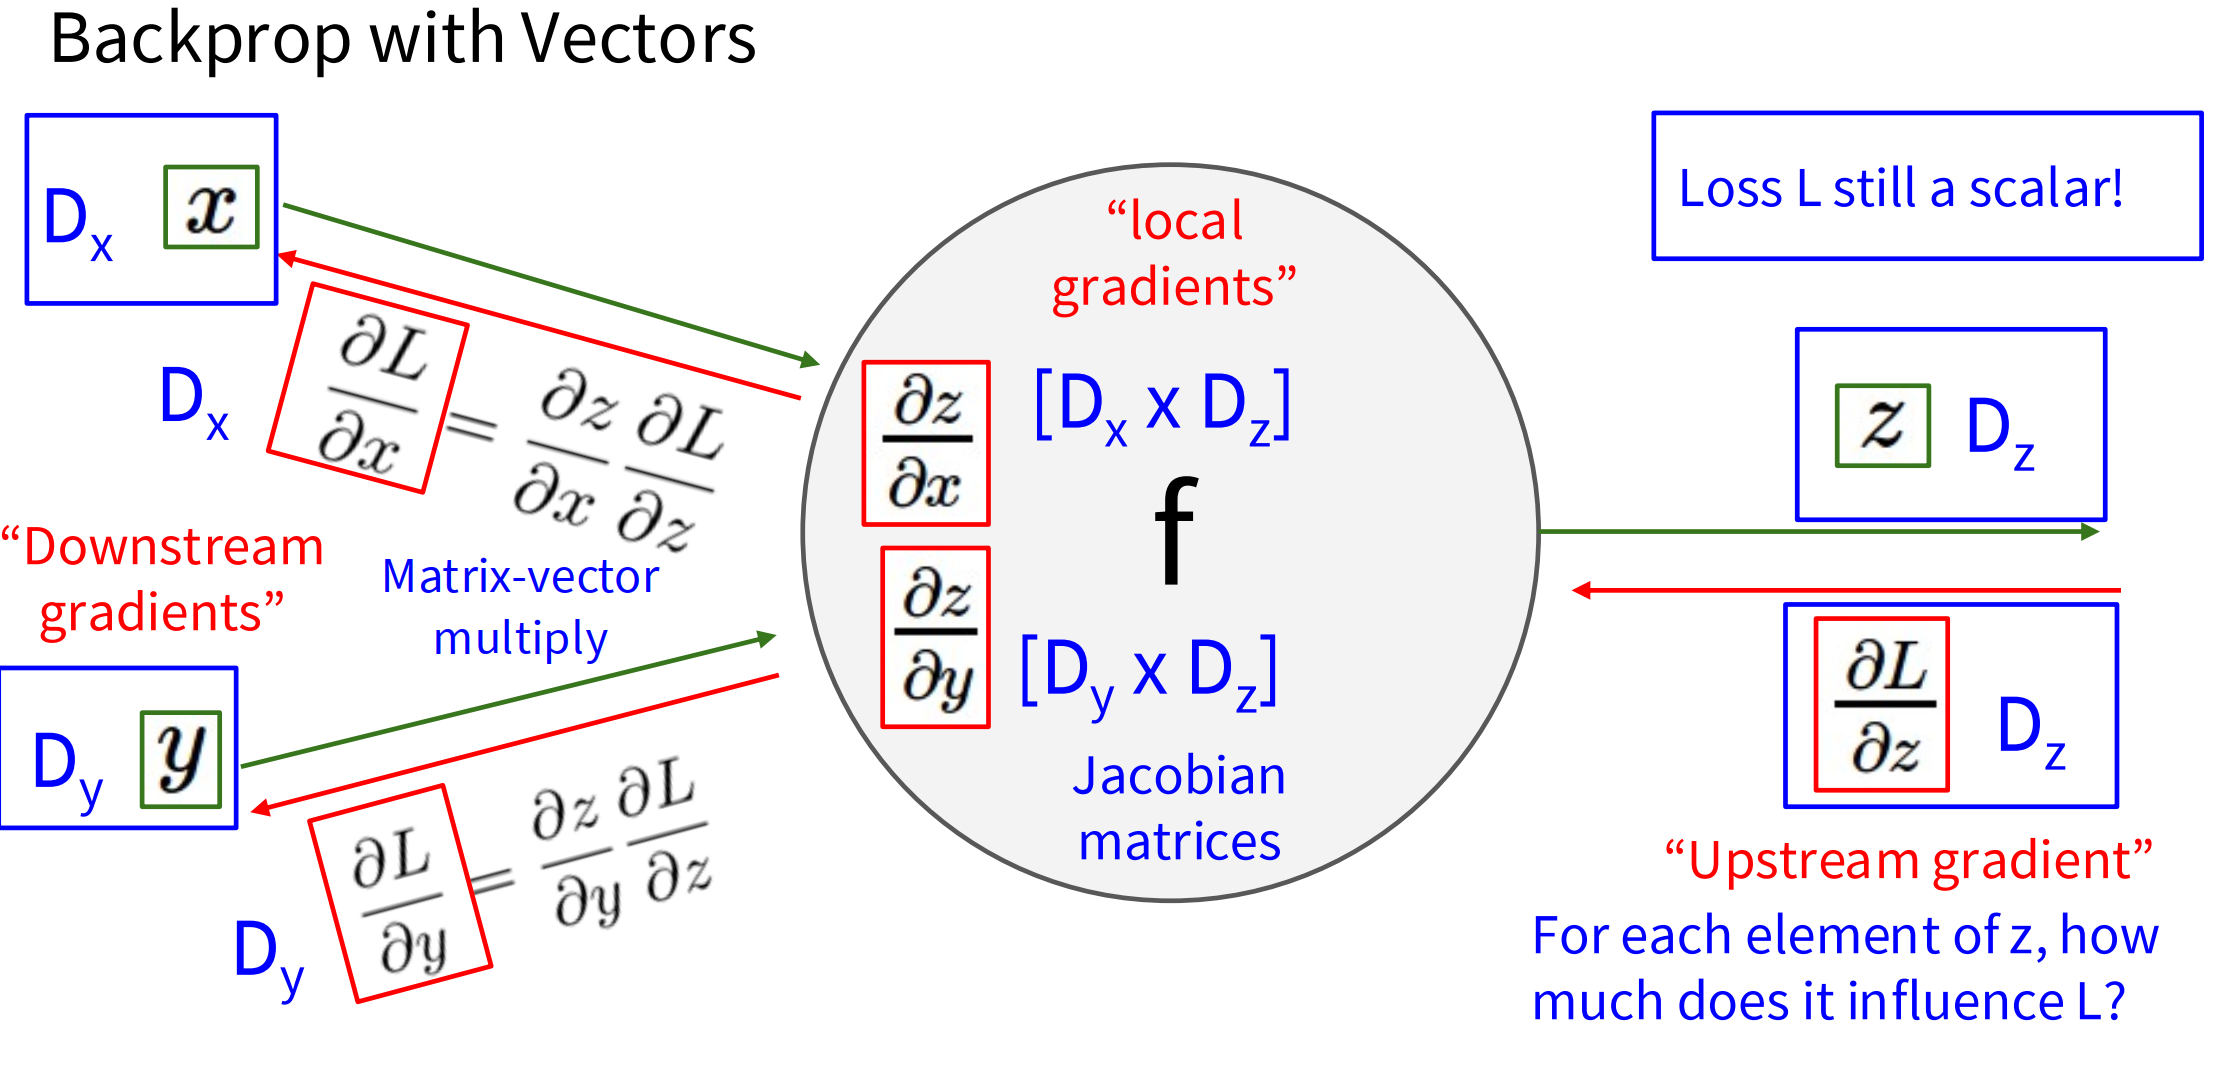
9.1 标量、向量与 Jacobian
导数的形状取决于输入和输出的形状。
| 函数类型 | 导数名称 | 含义 |
|---|---|---|
| 标量 \(\rightarrow\) 标量 | 普通导数 | 输入微小变化时输出如何变化 |
| 向量 \(\rightarrow\) 标量 | 梯度(Gradient) | 每个输入分量变化时标量输出如何变化 |
| 向量 \(\rightarrow\) 向量 | 雅可比矩阵(Jacobian) | 每个输入分量变化时每个输出分量如何变化 |
如果
\[ y=f(x),\qquad x\in\mathbb{R}^{D_x},\quad y\in\mathbb{R}^{D_y} \]
则 Jacobian 的形状可以理解为
\[ \frac{\partial y}{\partial x}\in\mathbb{R}^{D_x \times D_y} \]
不同教材可能使用转置约定,但本质都是记录“每个输出对每个输入”的局部变化关系。
9.2 损失仍然是标量
在神经网络训练中,即使中间变量是向量、矩阵或张量,最终损失 \(L\) 通常仍是一个标量。因此对任意中间变量 \(x\),反向传播得到的是
\[ \frac{\partial L}{\partial x} \]
它的形状与 \(x\) 本身相同。
这是检查反向传播实现时最重要的维度原则之一:
\[ \mathrm{shape}\left(\frac{\partial L}{\partial x}\right) = \mathrm{shape}(x) \]
9.3 向量 ReLU 的反向传播
设
\[ x= \begin{bmatrix} 1\\ -2\\ 3\\ -1 \end{bmatrix} \]
逐元素 ReLU 得到
\[ z=\max(0,x)= \begin{bmatrix} 1\\ 0\\ 3\\ 0 \end{bmatrix} \]
若上游梯度为
\[ \frac{\partial L}{\partial z} = \begin{bmatrix} 4\\ -1\\ 5\\ 9 \end{bmatrix} \]
ReLU 的 Jacobian 是对角矩阵:
\[ \frac{\partial z}{\partial x} = \begin{bmatrix} 1&0&0&0\\ 0&0&0&0\\ 0&0&1&0\\ 0&0&0&0 \end{bmatrix} \]
因此
\[ \frac{\partial L}{\partial x} = \begin{bmatrix} 4\\ 0\\ 5\\ 0 \end{bmatrix} \]
实际实现中不会显式构造这个 Jacobian,而是使用逐元素 mask:
\[ \frac{\partial L}{\partial x} = \frac{\partial L}{\partial z} \odot \mathbf{1}[x>0] \]
考试重点:很多逐元素操作的 Jacobian 都是稀疏对角矩阵,实际代码中应使用隐式乘法,而不是显式创建 Jacobian。
9.4 矩阵乘法的反向传播
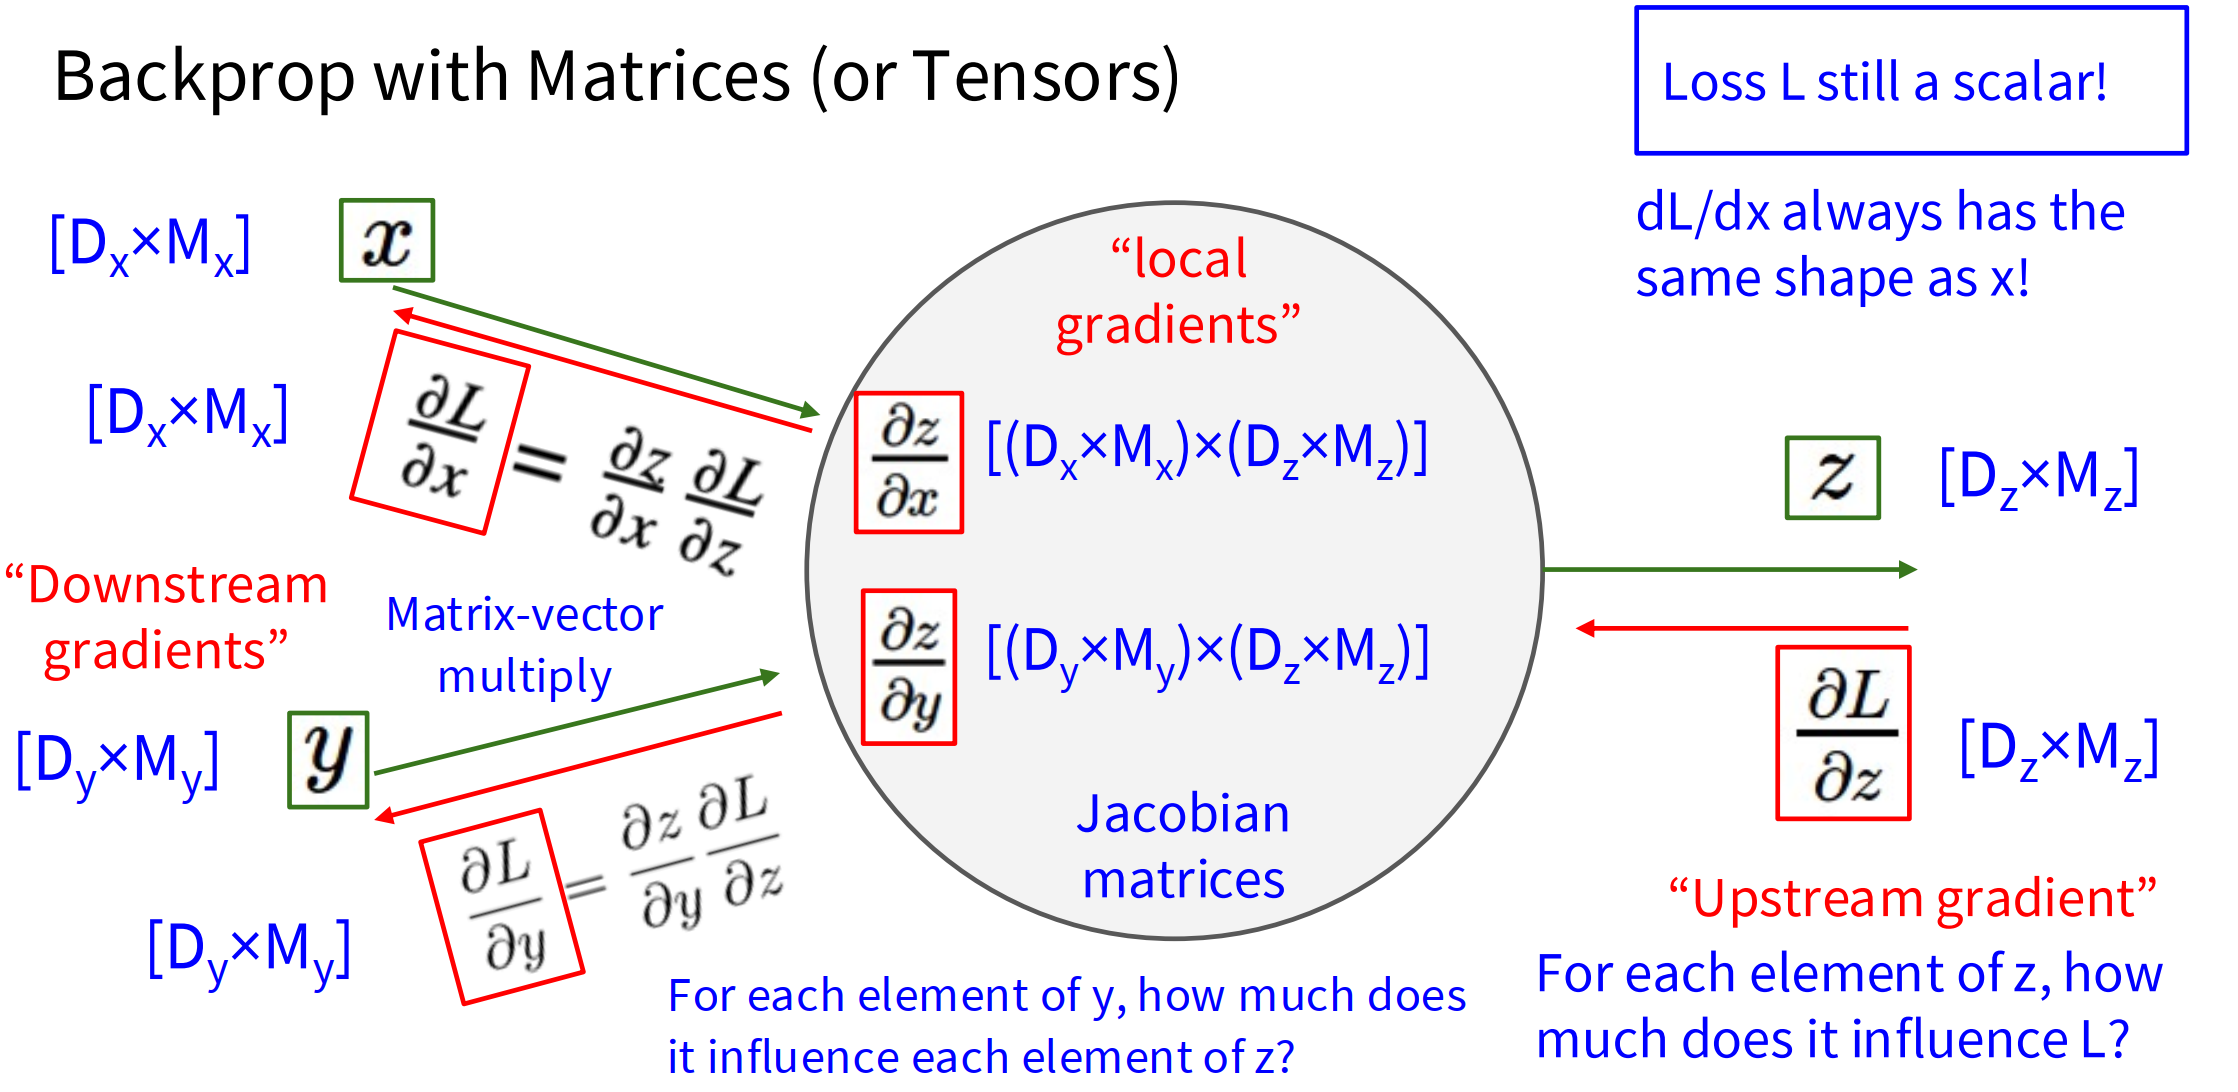
设矩阵乘法为
\[ Y = XW \]
其中
\[ X\in\mathbb{R}^{N\times D},\qquad W\in\mathbb{R}^{D\times M},\qquad Y\in\mathbb{R}^{N\times M} \]
给定上游梯度
\[ \frac{\partial L}{\partial Y}\in\mathbb{R}^{N\times M} \]
需要计算
\[ \frac{\partial L}{\partial X}\in\mathbb{R}^{N\times D} \]
和
\[ \frac{\partial L}{\partial W}\in\mathbb{R}^{D\times M} \]
公式为
\[ \frac{\partial L}{\partial X} = \frac{\partial L}{\partial Y} W^T \]
\[ \frac{\partial L}{\partial W} = X^T \frac{\partial L}{\partial Y} \]
可以用形状快速记忆:
\[ [N\times D] = [N\times M][M\times D] \]
\[ [D\times M] = [D\times N][N\times M] \]
也就是:
\[ dX = dY W^T,\qquad dW = X^T dY \]
9.5 为什么不能显式构造 Jacobian
对于矩阵乘法 \(Y=XW\),如果把所有元素展平成向量,那么 Jacobian 可能非常大。课程给出的量级例子是:若
\[ N=64,\qquad D=M=4096 \]
则某些 Jacobian 的规模会达到数百 GB。显式存储它们完全不现实。
因此深度学习框架的实际做法是:不显式形成 Jacobian,而是直接实现 Jacobian-vector product 或 vector-Jacobian product 的等价计算。例如矩阵乘法反传直接用矩阵乘法公式 \(dX=dYW^T\) 和 \(dW=X^TdY\)。
10 复习重点与易错点
10.1 本讲核心结论
- 全连接神经网络是线性层和非线性激活函数的堆叠。如果去掉非线性,多层线性网络仍然等价于一个线性分类器。
- ReLU 是多数问题中合理的默认激活函数,其反向传播等价于用 \(x>0\) 的 mask 过滤上游梯度。
- 反向传播是计算图上的链式法则。每个节点只需要上游梯度和局部梯度,就能计算输入梯度。
- forward/backward API 是自动微分框架的核心抽象。forward 计算输出并缓存上下文,backward 根据上游梯度返回下游梯度。
- 任何变量相对于标量损失的梯度,形状都与该变量相同。
- 不要显式构造大型 Jacobian。实际实现依赖隐式乘法和形状匹配。
10.2 必须熟练掌握的局部梯度
| 操作 | 前向 | 反向规律 |
|---|---|---|
| 加法 | \(z=x+y\) | \(dx=dz,\ dy=dz\) |
| 乘法 | \(z=xy\) | \(dx=dz\cdot y,\ dy=dz\cdot x\) |
| 复制 | \(x\) 被多处使用 | 各路径梯度相加 |
| Max | \(z=\max(x,y)\) | 梯度传给最大值对应输入 |
| ReLU | \(z=\max(0,x)\) | \(dx=dz\cdot \mathbf{1}[x>0]\) |
| Sigmoid | \(z=\sigma(x)\) | \(dx=dz\cdot z(1-z)\) |
| 矩阵乘法 | \(Y=XW\) | \(dX=dYW^T,\ dW=X^TdY\) |
10.3 反向传播手算流程
手算一个计算图的反向传播时,可以按固定流程:
- 从输入到输出做前向传播,写下每个中间变量的数值。
- 从最终损失开始,令 \(\frac{\partial L}{\partial L}=1\)。
- 按计算图反方向遍历节点。
- 对每个节点写出局部导数。
- 用“上游梯度 \(\times\) 局部梯度”得到输入梯度。
- 如果一个变量有多条路径流向损失,累加所有梯度贡献。
- 检查每个梯度的形状是否和对应变量一致。
10.4 常见错误
| 错误 | 为什么错 | 正确理解 |
|---|---|---|
| 忘记激活函数 | 多层线性变换仍是线性变换 | 必须交替使用线性层和非线性 |
| 把网络变小当作主要正则化 | 容量下降可能导致欠拟合 | 保持足够容量,使用更强正则化 |
| 反向传播时覆盖梯度 | 同一变量可能被多条路径使用 | 多路径梯度要相加 |
| 显式构造 Jacobian | 内存代价巨大 | 使用隐式乘法公式 |
| 矩阵乘法反传维度写反 | 公式容易混淆 | 用形状匹配记忆 \(dX=dYW^T,\ dW=X^TdY\) |
| 忽略 forward 缓存 | backward 需要前向中间值 | 每个节点应保存必要上下文 |
10.5 与下一讲的联系
下一讲进入卷积神经网络(Convolutional Neural Networks, CNN)。CNN 仍然遵循同一套原则:
\[ \text{forward computes values, backward propagates gradients} \]
区别在于卷积层、池化层、归一化层等节点有各自的局部运算和局部梯度。理解本讲的计算图和反向传播,是学习 CNN、RNN、Transformer 以及所有现代深度学习模型的基础。