本节的内容也比较难。我们先通过一个简单的聚类问题了解混合模型与EM算法的基本思想,然后介绍混合模型、EM算法的一般形式,最后通过几个例子,介绍混合模型和EM算法的应用。
6.1 引入:聚类问题
6.1.1 问题提出
所谓聚类,就是把一组数据分成若干类,是一种无监督的机器学习方法。
让我们看一个实际的聚类问题。假设医生通过体检采集了五名学生的身高数据 \(X=\{85,95,145,175,185\}\)。这五名学生分别来自幼儿组、小学组和大学组这三个类别。如何判断每个样本属于哪一类?
要知道每个样本属于哪一类,需要先知道每个类别的中心值(即均值),这样一来,样本离哪个类别的中心点最近,样本就属于哪一类。
然而,我们会发现逻辑陷入了一个死循环。
如果我们知道 \(85, 95\) 是幼儿,\(145\) 是小学生,\(175, 185\) 是大学生,那么
幼儿平均 \(\mu_1 = \frac{85+95}{2} = 90\)
小学平均 \(\mu_2 = 145\)
大学平均 \(\mu_3 = \frac{175+185}{2} = 180\)
这样,如果以后再来一个样本,例如 \(180\),我们就能立刻判断它属于大学组。
如果我们一开始就知道 \(\mu_1=90, \mu_2=145, \mu_3=180\),那也简单:
- \(85\) 离 \(90\) 最近,那它大概率是幼儿。
- \(175\) 离 \(180\) 最近,那它大概率是大学生。
然而,现在我们既不知道标签(即每个样本属于哪一类),也不知道每个类别的中心(均值)。这就像“鸡生蛋,蛋生鸡”,无法开始。
6.1.2 隶属度
那么应该怎么办?一个朴素的想法是,先根据主观经验,猜测三个类别的中心(均值),然后慢慢修正。具体计算如下。
我们需要先补充两个假设:
- 为了简化计算,假设三个组的身高都服从正态分布,且标准差都是 \(\sigma = 10\)(即方差 \(\sigma^2=100\))。
- 假设任选一个学生,属于幼儿、小学、大学的概率相等,即 \(\pi_1=\pi_2=\pi_3=1/3\)。
对于给定的身高 \(X_i\),它属于第 \(k\) 个组(中心为 \(\mu_k\))的概率由正态分布的概率密度函数给出: \[ P(Z_i=k, X_i) = \frac{1}{\sqrt{2\pi\sigma^2}} e^{ -\frac{(X_i - \mu_k)^2}{2\sigma^2} } \] 其中 \(Z_i\) 表示样本 \(X_i\) 的类别,\(Z_i=k\) 表示第 \(i\) 个样本 \(X_i\) 属于第 \(k\) 类。
下面给出隶属度的定义。 \[ \gamma_{ik} =P(Z_i=k | X_i)= \frac{P(Z_i=k, X_i)}{\sum\limits_{l \in \{1,2,3\}} P(Z_i=l, X_i)} \] 其中 \(\{1,2,3\}\) 是三个类别的下标,可以人为规定类别1是幼儿组,类别2是小学组,类别3是大学组。隶属度 \(\gamma_{ik}\) 代表第 \(i\) 个样本 \(X_i\) 属于第 \(k\) 类的可能性,或者样本 \(X_i\) 在第 \(k\) 类上的得分。相较 \(P(Z_i=k, X_i)\),隶属度做了归一化处理。
代入正态分布的概率密度函数可得
\[ \begin{aligned} \gamma_{ik} &= \frac{P(Z_i=k, X_i)}{\sum\limits_{l \in \{1,2,3\}} P(Z_i=l, X_i)} \\[0.8em] &= \frac{ \frac{1}{3} \cdot \frac{1}{\sqrt{2\pi\sigma^2}} \cdot \exp\left( -\frac{(x_i - \mu_k)^2}{2\sigma^2} \right) }{ \sum\limits_{l \in \{1,2,3\}} \left[ \frac{1}{3} \cdot \frac{1}{\sqrt{2\pi\sigma^2}} \cdot \exp\left( -\frac{(x_i - \mu_l)^2}{2\sigma^2} \right) \right] } \\[0.8em] &= \frac{\exp\left( -\frac{(x_i - \mu_k)^2}{2\sigma^2} \right)}{ \exp\left( -\frac{(x_i - \mu_1)^2}{2\sigma^2} \right) + \exp\left( -\frac{(x_i - \mu_2)^2}{2\sigma^2} \right) + \exp\left( -\frac{(x_i - \mu_3)^2}{2\sigma^2} \right) } \end{aligned} \]
下面以 \(X_3=145\) 为例,计算三个隶属度 \(\gamma_{31}, \gamma_{32}, \gamma_{33}\)。我们不妨猜测 \(\mu_1=100, \mu_2=140, \mu_3=170\)。
\[ \text{Score}_1 = \exp\left( -\frac{(145 - 100)^2}{200} \right) = \exp\left( -\frac{2025}{200} \right) = e^{-10.125} \approx \mathbf{0.00004} \]
\[ \text{Score}_2 = \exp\left( -\frac{(145 - 140)^2}{200} \right) = \exp\left( -\frac{25}{200} \right) = e^{-0.125} \approx \mathbf{0.88250} \]
\[ \text{Score}_3 = \exp\left( -\frac{(145 - 170)^2}{200} \right) = \exp\left( -\frac{625}{200} \right) = e^{-3.125} \approx \mathbf{0.04394} \]
\[ \begin{aligned} \text{Sum} &= \text{Score}_1 + \text{Score}_2 + \text{Score}_3 \\ &= 0.00004 + 0.88250 + 0.04394 \\ &\approx \mathbf{0.92648} \end{aligned} \]
于是 \[ \gamma_{31} = \frac{0.00004}{0.92648} \approx 0.00 \]
\[ \gamma_{32} = \frac{0.88250}{0.92648} \approx 0.95 \]
\[ \gamma_{33} = \frac{0.04394}{0.92648} \approx 0.05 \]
对所有样本应用上述计算,我们得到全部样本的隶属度:
| 数据 \(X_i\) | \(\mu_1=100\) (幼儿) | \(\mu_2=140\) (小学) | \(\mu_3=170\) (大学) | 计算结果解读 |
|---|---|---|---|---|
| 85 | 0.99 | 0.01 | 0.00 | 毫无悬念,肯定是幼儿 |
| 95 | 0.99 | 0.01 | 0.00 | 毫无悬念,肯定还是幼儿 |
| 145 | 0.00 | 0.95 | 0.05 | 极大概率是小学,有微小可能是“矮个大学生” |
| 175 | 0.00 | 0.05 | 0.95 | 有微小可能是“发育极好的小学生”,主要是大学 |
| 185 | 0.00 | 0.00 | 1.00 | 毫无悬念,肯定是大学生 |
6.1.3 更新参数
算了大半天的隶属度有什么用?用来更新参数。
\[ \mu_k^{new} = \frac{\sum\limits_{i=1}^{n} \gamma_{ik} \cdot x_i}{\sum\limits_{i=1}^{n} \gamma_{ik}} \]
这个公式其实比较直观,说的就是“新的中心 = 加权总身高 / 总权重”。
于是我们可以计算 \(\mu_1^{new}, \mu_2^{new}, \mu_3^{new}\): \[ \begin{aligned} \mu_1^{new} &= \frac{\sum\limits_{i=1}^{5} \gamma_{i1} \cdot x_i}{\sum\limits_{i=1}^{5} \gamma_{i1}} \\[1em] &= \frac{0.99 \times 85 + 0.99 \times 95 + 0.00 \times 145 + 0.00 \times 175 + 0.00 \times 185}{0.99 + 0.99 + 0.00 + 0.00 + 0.00} \\[1em] &= \frac{84.15 + 94.05 + 0 + 0 + 0}{1.98} \\[1em] &= \frac{178.2}{1.98} \\[1em] &= 90 \end{aligned} \] 初始猜测是 \(100\),一轮迭代后迅速修正为 \(90\),完美符合真实数据。
\[ \begin{aligned} \mu_2^{new} &= \frac{\sum\limits_{i=1}^{5} \gamma_{i2} \cdot x_i}{\sum\limits_{i=1}^{5} \gamma_{i2}} \\[1em] &= \frac{0.01 \times 85 + 0.01 \times 95 + 0.95 \times 145 + 0.05 \times 175 + 0.00 \times 185}{0.01 + 0.01 + 0.95 + 0.05 + 0.00} \\[1em] &= \frac{0.85 + 0.95 + 137.75 + 8.75 + 0}{1.02} \\[1em] &= \frac{148.3}{1.02} \\[1em] &\approx 145.39 \end{aligned} \] 初始猜测是 \(140\),真实值是 \(145\)。由于受到右侧 \(175\) cm数据(权重 \(0.05\))的拉动,新均值略高于 \(145\),变为 \(145.39\)。随着后续迭代,均值会进一步逼近 \(145\)。
\[ \begin{aligned} \mu_3^{new} &= \frac{\sum\limits_{i=1}^{5} \gamma_{i3} \cdot x_i}{\sum\limits_{i=1}^{5} \gamma_{i3}} \\[1em] &= \frac{0.00 \times 85 + 0.00 \times 95 + 0.05 \times 145 + 0.95 \times 175 + 1.00 \times 185}{0.00 + 0.00 + 0.05 + 0.95 + 1.00} \\[1em] &= \frac{0 + 0 + 7.25 + 166.25 + 185}{2.00} \\[1em] &= \frac{358.5}{2.00} \\[1em] &= 179.25 \end{aligned} \] 初始猜测是 \(170\),真实均值是 \(\frac{175+185}{2} = 180\)。计算结果 \(179.25\) 非常接近真实值。
多迭代几轮,三个均值会逐步收敛,收敛的结果即可作为三个类别的均值。以后,如果有新的数据进来,只需要计算它和这三个类别的隶属度(或者score,省得归一化),哪个隶属度最大,这个样本就属于哪一类。
例如,学校来了一位新同学,测量身高为 \(x_{new} = 160\) cm。我们需要判断他最可能属于哪个类别。
\[ \text{Score}_1 \propto \exp(-70^2 / 200) = e^{-24.5} \approx 0 \]
\[ \text{Score}_2 \propto \exp(-15^2 / 200) = e^{-1.125} \approx 0.324 \]
\[ \text{Score}_3 \propto \exp(-20^2 / 200) = e^{-2.0} \approx 0.135 \]
虽然 \(160\) cm 介于小学生(\(145\))和大学生(\(180\))之间,但数学告诉我们,它离小学生更近。 因此我们将这位同学归类为小学组。
6.2 混合模型与EM算法
在上一节中,我们通过一个简单的例子,初步了解了混合模型与EM算法的基本思想。本节将通过严格的数学推导,给出混合模型与EM算法的一般形式。
6.2.1 混合模型
混合模型的定义源于概率论中的全概率公式。假如我们观察到的数据 \(X\)(如身高)看起来很复杂,单用一个分布无法描述(比如身高有90、145、180三个峰值,不能用一个正态分布描述)。但在其内部,数据其实是由 \(K\) 个简单的基础分布混合而成的。
混合模型的数学定义如下: \[ f_X(x) = \sum_{k=1}^K \underbrace{P(Z=z_k)}_{\text{混合系数}} \cdot \underbrace{f_{X|Z}(x|z_k)}_{\text{成分分布}} \]
下面解释一下公式里的参数。
隐变量 \(Z\) 是一个离散型随机变量,取值为 \(\{1, 2, ..., K\}\)。它指示观测数据 \(x\) 具体来自哪一个成分。因为我们在收集数据时通常不知道它,所以叫“隐”变量。在 6.1 的聚类问题中,每个样本的类别(幼儿组、小学组、大学组)就是隐变量,\(Z\) 的取值为 \(\{1,2,3\}\)。
成分分布 \(f_{X|Z}(x|z_k)\) 是第 \(k\) 个成分内部的数据分布规律,在 6.1 中即为每个类别内部的身高分布。通常假设所有子群体服从同一种分布形式(例如都是高斯分布),但参数不同。
混合系数/先验概率 \(P(Z=z_k)\) 也常记作 \(\pi_k\) 或 \(w_k\),表示第 \(k\) 个成分在总体中占的比例(权重)。在 6.1 节中,它对应各类别学生的人数比例。混合系数必须满足非负且和为1,即 \(\sum_{k=1}^K P(Z=z_k) = 1\)。
6.2.2 EM 算法的数学推导
这一部分比较复杂,但考试不考,可以跳过,但建议还是看一看。
设 \(X=\{X_1, X_2, ..., X_n\}\) 为观测到的独立同分布的样本。\(Z=\{Z_1, Z_2, ..., Z_n\}\) 为隐变量,其中 \(Z_i\) 为 \(X_i\) 对应的隐变量。\(Z_i \in \{1,2,3,...,k\} = K\),\(K\) 是隐变量的取值范围。 设 \(\theta\) 为需要估计的参数,它在 \(X_i\) 的概率密度函数中。
下面通过极大似然估计(MLE)来估计 \(\theta\)。 设 \[L(X;\theta)=P(X_1;\theta)P(X_2;\theta)...P(X_n;\theta)\] 其中 \(P(X_i; \theta)\) 为 \(X_i\)的概率密度函数。
对似然函数取对数 \[ LL(X; \theta)=\ln L(X;\theta)=\sum \limits_{i=1}^{n} \ln P(X_i;\theta)=\sum \limits_{i=1}^{n}\ln \sum \limits_{Z_i \in K} P(X_i, Z_i; \theta) \]
设隐变量 \(Z_i\) 满足分布 \(Q_i(Z_i)\)。对上式进行变形,可得 \[ LL(X; \theta)=\sum \limits_{i=1}^{n} \ln \sum \limits_{Z_i \in K} Q_i(Z_i) \frac{P(X_i, Z_i; \theta)}{Q_i(Z_i)} \]
式中 \(\sum \limits_{Z_i \in K} Q_i(Z_i) \frac{P(X_i, Z_i; \theta)}{Q_i(Z_i)}\) 即为 \(\frac{P(X_i, Z_i; \theta)}{Q_i(Z_i)}\) 的期望。因此
\[ LL(X;\theta)=\sum \limits_{i=1}^{n} \ln E_{Z_i}(\frac{P(X_i, Z_i; \theta)}{Q_i(Z_i)}) \]
\(y=\ln(x)\) 在 \((0, + \inf)\) 上为凹函数。由 Jensen 不等式,可知 \[ LL(X;\theta)=\sum \limits_{i=1}^{n} \ln E_{Z_i}(\frac{P(X_i, Z_i; \theta)}{Q_i(Z_i)}) ≥ \sum \limits_{i=1}^{n} E_{Z_i}(\ln\frac{P(X_i, Z_i; \theta)}{Q_i(Z_i)}) \]
将 \(E_{Z_i}\) 展开,可得 \[ LL(X;\theta)≥\sum \limits_{i=1}^{n} \sum \limits_{Z_i \in K} Q_i(Z_i) \ln \frac{P(X_i, Z_i; \theta)}{Q_i(Z_i)} ① \]
故原始问题转化为:寻找合适的 \(Q_i\) 使该下界变紧(等号成立),以及寻找 \(\theta\) 最大化该下界。
等号成立条件为 \[\frac{P(X_i, Z_i; \theta)}{Q_i(Z_i)}=C, \forall i=1,2,...,n\] 其中 \(C\) 为常数。 于是 \[P(X_i, Z_i; \theta)=C \cdot Q_i(Z_i), \forall i=1,2,...,n \] 两边对 \(Z_i\) 求和得 \[ \sum \limits_{Z_i \in K}P(X_i, Z_i;\theta)=C \cdot \sum \limits_{Z_i \in K} Q_i(Z_i)=C \]
故 \[ Q_i(Z_i)=\frac{P(X_i, Z_i; \theta)}{C}=\frac{P(X_i, Z_i; \theta)}{\sum \limits_{Z_i \in K}P(X_i, Z_i; \theta)}=\frac{P(X_i, Z_i; \theta)}{P(X_i;\theta)}=P(Z_i|X_i;\theta) \] 事实上,这就是隶属度 \(\gamma_{ik}=P(Z_i=k|X_i;\theta)\)。因此 \(\gamma_{ik}=Q_i(Z_i)|_{Z_i=k}=Q_i(k)\)。
把这一结果代回①式,得 \[ \begin{align*} &\sum_{i=1}^{n} \sum_{Z_i \in K} Q_i(Z_i) \ln \frac{P(X_i, Z_i; \theta)}{Q_i(Z_i)} \\ &= \sum_{i=1}^{n} \sum_{k \in K} \gamma_{ik} \ln \frac{P(X_i, Z_i=k;\theta)}{\gamma_{ik}} \\ &= \sum_{i=1}^{n} \sum_{k \in K} \left( \gamma_{ik} \ln P(X_i, Z_i=k;\theta) - \gamma_{ik} \ln \gamma_{ik} \right) \end{align*} \]
令 \[ Q(\theta,\theta^{(t)})=\sum_{i=1}^{n} \sum_{k \in K} \gamma_{ik} \ln P(X_i, Z_i=k;\theta) \]
\[ H(Z|X, \theta^{(t)}) = - \sum_{i=1}^{n} \sum_{k \in K} \gamma_{ik} \ln \gamma_{ik} \]
则
\[ LL(X, \theta) ≥Q(\theta, \theta^{(t)})+H(Z|X, \theta^{(t)}) \]
而理想状态下
\[ LL(X, \theta^{(t)})=Q(\theta^{(t)}, \theta^{(t)})+H(Z|X, \theta^{(t)}) \]
两式相减得
\[ LL(X, \theta)-LL(X, \theta^{(t)}) ≥ Q(\theta, \theta^{(t)})-Q(\theta^{(t)}, \theta^{(t)}) \]
也就是说,选择 \(\theta\) 使 \(Q\) 增大,至少能让 \(LL\) 增大同样大小。
因此,最终目标变成了 \[ \mathop{\text{argmax}}\limits_{\theta} Q(\theta, \theta^{(t)}) \]
最终,EM算法可表达为
E步:
\[ \gamma_{ik}=P(Z_i=k|X_i;\theta)=\frac{P(Z_i=k,X_i;\theta)}{\sum \limits_{l \in K} P(Z_i=l,X_i;\theta)} \] \[Q(\theta, \theta^{(t)})=\sum \limits_{i=1}^{n} \sum \limits_{k \in K} \gamma_{ik} \ln P(X_i, Z_i=k;\theta)\]
M步:
\[ \theta^{(t+1)}=\mathop{\text{argmax}}\limits_{\theta} Q(\theta, \theta^{(t)})\]
6.3 例子
EM 算法不仅仅可以用于聚类问题。本节将介绍三硬币模型和高斯混合模型这两个经典模型,解释EM算法的完整流程。
6.3.1 三硬币模型
三硬币模型由两个不同的伯努利分布混合而成,本质上是一个伯努利混合模型。
假设有三枚硬币,分别记作 \(A, B, C\)。硬币 \(A, B, C\) 正面朝上的概率分别为 \(\pi, p, q\)。规则如下:先掷硬币 \(A\)。若 \(A\) 出现正面,则选择硬币 \(B\) 掷出;若 \(A\) 出现反面,则选择硬币 \(C\) 掷出。记录第 2 次掷出的结果(正面记为 \(1\),反面记为 \(0\))。
在这个问题中,观测数据集合为 \(X = \{x_1, x_2, ..., x_n\}\),其中 \(x_i \in \{0, 1\}\)。\(Z = \{z_1, z_2, ..., z_n\}\) 是隐变量,指示观测数据来源于哪枚硬币。\(z_i \in \{0,1\}\)。我们规定 \(z_i = 1\) 表示选择了硬币 \(B\),则硬币 \(A\) 是正面;\(z_i = 0\) 表示选择了硬币 \(C\),则硬币 \(A\) 是反面。需要估计的参数 \(\theta = \{\pi, p, q\}\)。
先做一些准备工作。观测变量 \(x_i\) 的概率分布为 \[ P(X=x_i; \theta) = \sum_{z_i \in \{0, 1\}} P(Z=z_i)P(X=x_i|Z=z_i) \] 即 \[ P(X=x_i; \theta) = \pi p^{x_i}(1-p)^{1-x_i} + (1-\pi) q^{x_i}(1-q)^{1-x_i} \]
选取参数的初始值 \(\theta^{(0)} = \{\pi^{(0)}, p^{(0)}, q^{(0)}\}\)。
1. E步:计算隶属度和 Q 函数
设观测数据 \(x_i\) 来自硬币 \(B\)(即 \(z_i=1\))的隶属度为 \(\gamma_{i1}^{(t)}\),上标 \((t)\) 表示第 \(t\) 次迭代中隶属度的值,而非次方。
根据贝叶斯公式 \[ \begin{aligned} \gamma_{i1}^{(t)} &= P(z_i=1 | x_i; \theta^{(t)}) \\[1em] &= \frac{P(z_i=1; \theta^{(t)}) P(x_i | z_i=1; \theta^{(t)})}{P(x_i; \theta^{(t)})} \\[1em] &= \frac{P(z_i=1; \theta^{(t)}) P(x_i | z_i=1; \theta^{(t)})}{P(z_i=1; \theta^{(t)}) P(x_i | z_i=1; \theta^{(t)}) + P(z_i=0; \theta^{(t)}) P(x_i | z_i=0; \theta^{(t)})} \end{aligned} \]
代入具体的概率公式: \[ \gamma_{i1}^{(t)} = \frac{\pi^{(t)} (p^{(t)})^{x_i} (1-p^{(t)})^{1-x_i}}{\pi^{(t)} (p^{(t)})^{x_i} (1-p^{(t)})^{1-x_i} + (1-\pi^{(t)}) (q^{(t)})^{x_i} (1-q^{(t)})^{1-x_i}} \]
同理可得 \[ \gamma_{i0}^{(t)} = \frac{(1-\pi^{(t)}) (q^{(t)})^{x_i} (1-q^{(t)})^{1-x_i}}{\pi^{(t)} (p^{(t)})^{x_i} (1-p^{(t)})^{1-x_i} + (1-\pi^{(t)}) (q^{(t)})^{x_i} (1-q^{(t)})^{1-x_i}} \]
根据上面两条公式,或根据隶属度的定义可知 \(\gamma_{i0} + \gamma_{i1}=1\)。 于是 \(Q\) 函数为 \[ \begin{aligned} Q(\theta, \theta^{(t)}) &= \sum_{i=1}^n \sum_{k \in \{0,1\}} \gamma_{ik}^{(t)} \ln P(x_i, z_i=k; \theta) \\ &= \sum_{i=1}^n \left[ \gamma_{i1}^{(t)} \ln P(x_i, z_i=1; \theta) + \gamma_{i0}^{(t)} \ln P(x_i, z_i=0; \theta) \right] \\ &= \sum_{i=1}^n \Big\{ \gamma_{i1}^{(t)} \big[ \ln \pi + x_i \ln p + (1-x_i) \ln(1-p) \big] + (1-\gamma_{i1}^{(t)}) \big[ \ln (1-\pi) + x_i \ln q + (1-x_i) \ln(1-q) \big] \Big\} \end{aligned} \]
2. M步:最大化 Q 函数(更新参数)
我们需要分别对 \(\pi, p, q\) 求偏导并令其为 0。
\[ \frac{\partial Q}{\partial \pi} = \sum_{i=1}^n \left[ \frac{\gamma_{i1}^{(t)}}{\pi} - \frac{1-\gamma_{i1}^{(t)}}{1-\pi} \right] = 0 \] 解得: \[ \pi^{(t+1)} = \frac{1}{n} \sum_{i=1}^n \gamma_{i1}^{(t)} \] 即新的 \(\pi\) 是所有样本属于硬币 \(B\) 的概率的平均值。
\[ \frac{\partial Q}{\partial p} = \sum_{i=1}^n \gamma_{i1}^{(t)} \left[ \frac{x_i}{p} - \frac{1-x_i}{1-p} \right] = 0 \] 解得: \[ p^{(t+1)} = \frac{\sum \limits_{i=1}^n \gamma_{i1}^{(t)} x_i}{\sum \limits_{i=1}^n \gamma_{i1}^{(t)}} \] 即新的 \(p\) 是硬币 \(B\) 产生正面的加权比例,权重为样本属于 \(B\) 的概率。
\[ \frac{\partial Q}{\partial q} = \sum \limits_{i=1}^n (1-\gamma_{i1}^{(t)}) \left[ \frac{x_i}{q} - \frac{1-x_i}{1-q} \right] = 0 \] 解得: \[ q^{(t+1)} = \frac{\sum \limits_{i=1}^n (1-\gamma_{i1}^{(t)}) x_i}{\sum \limits_{i=1}^n (1-\gamma_{i1}^{(t)})} \]
其实际意义同 \(p^{(t+1)}\)。
3. 代码实现
1 | import numpy as np |
1 | # 数据生成函数与生成过程 |
生成样本数量: 1000
观测数据均值 (正面频率): 0.4330
理论均值 (pi*p + (1-pi)*q): 0.4400
1 | # EM 算法实现 (增加了历史记录功能) |
1 | # 可视化绘图函数 |
<>:10: SyntaxWarning: invalid escape sequence '\p'
<>:15: SyntaxWarning: invalid escape sequence '\p'
<>:10: SyntaxWarning: invalid escape sequence '\p'
<>:15: SyntaxWarning: invalid escape sequence '\p'
C:\Users\24930\AppData\Local\Temp\ipykernel_60784\4213694819.py:10: SyntaxWarning: invalid escape sequence '\p'
  ax1.plot(iterations, history['pi'], 'r-o', label='Estimated $\pi$', markersize=4)
C:\Users\24930\AppData\Local\Temp\ipykernel_60784\4213694819.py:15: SyntaxWarning: invalid escape sequence '\p'
  ax1.axhline(true_pi, color='r', linestyle='--', alpha=0.5, label='True $\pi$')
1 | # 运行并展示结果 |
算法在第 2 次迭代收敛。

--- 最终估计结果 ---
pi: 0.5268 (True: 0.4)
p : 0.2466  (True: 0.8)
q : 0.6405  (True: 0.2)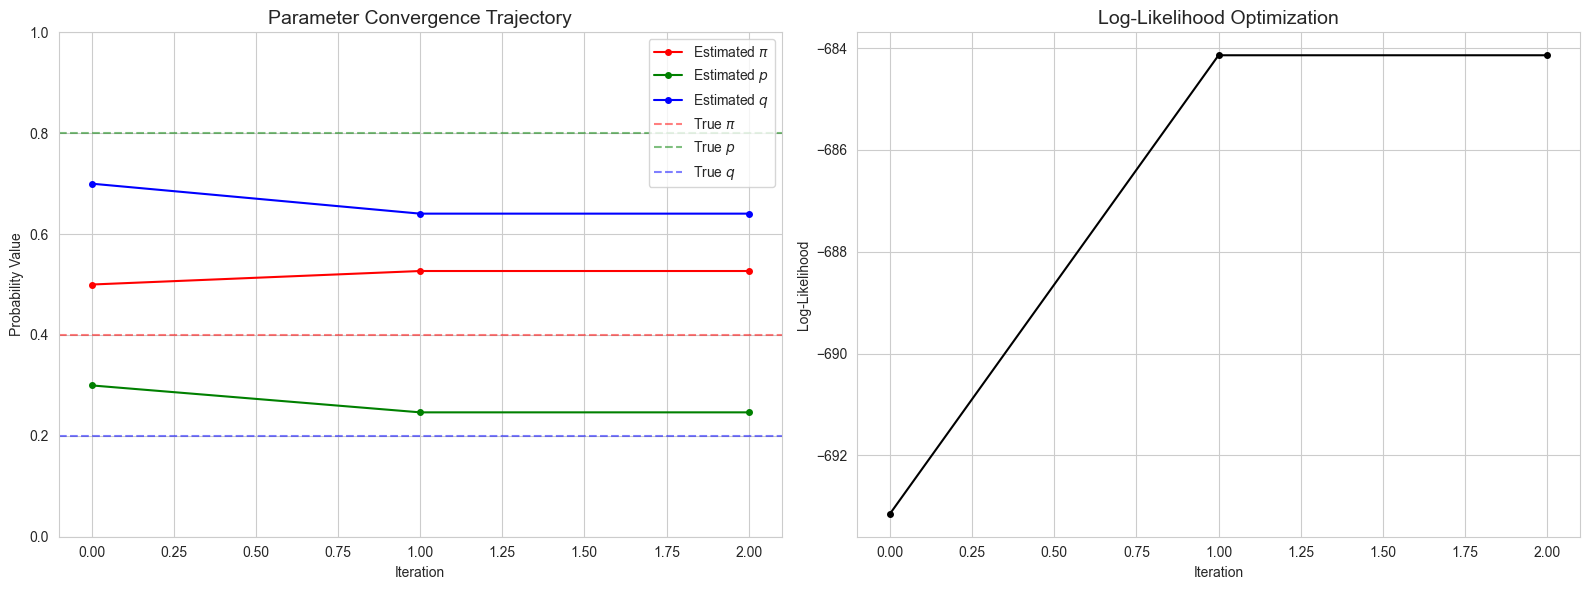
经实验,如果 init_params = [0.5, 0.7, 0.3],似乎效果还可以;但如果 init_params = [0.5, 0.3, 0.7],反而估计值与实际值相去甚远(左图中蓝色实线与蓝色虚线距离很远,绿色实线与绿色虚线距离很远)。这说明三硬币模型(伯努利混合模型)对初始值极其敏感,很容易陷入局部最优解。
这并非 EM 算法本身无能,而是数据类型限制了算法的发挥。在三硬币模型中,观测数据是离散的 0 或 1。一个“正面(1)”,除此之外没有更多信息,它无法告诉我们它是“很强的正面”还是“勉强的正面”。此外,当 \(\pi, p, q\) 的参数设置得稍有不慎(比如 \(p\) 和 \(q\) 接近),算法很难区分一个“1”到底更像来自于硬币 B 还是硬币 C。在算法眼中,B 和 C 的分布重叠度太高,难以剥离。
相比之下,高斯混合模型 (GMM) 处理的是连续型数据,连续数据蕴含了丰富的距离信息。在三硬币模型中,1 和 1 是完全一样的。但在身高聚类中,175cm 和 185cm 虽然都属于“高个子”,但它们在坐标轴上的位置不同。此外,EM 算法在计算隶属度时,利用了高斯分布的尾部衰减特性(距离越远,概率指数级下降)。这种显著差异使得 EM 算法能迅速把混在一起的数据拉开。
因此,在实际应用中,处理连续数据的 高斯混合模型 (GMM) 才是 EM 算法真正大展拳脚的舞台。接下来,我们将推导 GMM 的参数更新公式。虽然数学推导变复杂了(引入了高斯公式),但算法的收敛稳定性却变强了。
6.3.2 高斯混合模型
设观测变量 \(X = \{x_1, x_2, ..., x_n\}\),其中 \(x_i \in \mathbb{R}\) 为连续值(例如身高)。隐变量 \(Z=\{z_1, z_2, ..., z_n\}\)。\(z_i \in \{1, 2, ..., K\}\)。\(z_i = k\),表示第 \(i\) 个样本来自第 \(k\) 个高斯成分。
模型参数为 \(K\) 个三元组:\(\theta = \{ w_k, \mu_k, \sigma_k^2 \}_{k=1}^K\)。
\(w_k\):第 \(k\) 个成分的混合系数(权重),即先验概率 \(P(z_i=k)\)。满足 \(\sum \limits_{k=1}^K w_k = 1\)。
\(\mu_k\):第 \(k\) 个成分的均值。
\(\sigma_k^2\):第 \(k\) 个成分的方差。
下面做一些准备工作。观测数据 \(x_i\) 的概率密度函数为: \[ P(x_i ; \theta) = \sum_{k=1}^K P(z_i=k) P(x_i | z_i=k) = \sum_{k=1}^K w_k \cdot \mathcal{N}(x_i; \mu_k, \sigma_k^2) \]
其中高斯分布的概率密度函数为: \[ \mathcal{N}(x_i; \mu_k, \sigma_k^2) = \frac{1}{\sqrt{2\pi}\sigma_k} \exp\left( -\frac{(x_i - \mu_k)^2}{2\sigma_k^2} \right) \]
1. E步:计算隶属度和 Q 函数
根据贝叶斯公式 \[ \begin{aligned} \gamma_{ik}^{(t)} &= P(z_i=k | x_i; \theta^{(t)}) \\[1em] &= \frac{w_k^{(t)} \cdot \mathcal{N}(x_i; \mu_k^{(t)}, (\sigma_k^2)^{(t)})}{\sum \limits_{j=1}^K w_j^{(t)} \cdot \mathcal{N}(x_i; \mu_j^{(t)}, (\sigma_j^2)^{(t)})} \end{aligned} \]
\(Q\) 函数为 \[ \begin{aligned} Q(\theta, \theta^{(t)}) &= \sum_{i=1}^n E_{z_i} [\ln P(x_i, z_i; \theta)] \\ &= \sum_{i=1}^n \sum_{k=1}^K \gamma_{ik}^{(t)} \ln \left[ w_k \cdot \mathcal{N}(x_i; \mu_k, \sigma_k^2) \right] \\ &= \sum_{i=1}^n \sum_{k=1}^K \gamma_{ik}^{(t)} \big( \ln w_k + \ln \mathcal{N}(x_i; \mu_k, \sigma_k^2) \big) \end{aligned} \]
2. M步:最大化 Q 函数(更新参数)
我们将 Q 函数拆解为两部分,分别优化。
包含 \(w_k\) 的项:\(\sum \limits_{i=1}^n \sum \limits_{k=1}^K \gamma_{ik}^{(t)} \ln w_k\)
包含高斯参数(均值 \(\mu_k\) 和方差 \(\sigma_k^2\))的项:\(\sum \limits_{i=1}^n \sum \limits_{k=1}^K \gamma_{ik}^{(t)} \left[ -\ln(\sqrt{2\pi}\sigma_k) - \frac{(x_i - \mu_k)^2}{2\sigma_k^2} \right]\)
推导 1:更新混合系数 \(w_k\)
这是一个带约束的优化问题,约束条件为 \(\sum \limits_{k=1}^K w_k = 1\)。我们需要使用 Lagrange 乘子法。
构造拉格朗日函数: \[ \mathcal{L}(w, \lambda) = \sum_{i=1}^n \sum_{k=1}^K \gamma_{ik}^{(t)} \ln w_k + \lambda \left( \sum_{k=1}^K w_k - 1 \right) \]
对 \(w_k\) 求偏导并令其为 0: \[ \frac{\partial \mathcal{L}}{\partial w_k} = \sum_{i=1}^n \frac{\gamma_{ik}^{(t)}}{w_k} + \lambda = 0 \quad \Longrightarrow \quad w_k = -\frac{\sum \limits_{i=1}^n \gamma_{ik}^{(t)}}{\lambda} \]
为了求 \(\lambda\),对上式两边关于 \(k\) 求和: \[ \sum_{k=1}^K w_k = \sum_{k=1}^K \left( -\frac{\sum \limits_{i=1}^n \gamma_{ik}^{(t)}}{\lambda} \right) \] 利用 \(\sum \limits_{k=1}^K w_k = 1\) 和 \(\sum \limits_{k=1}^K \gamma_{ik}^{(t)} = 1\): \[ 1 = -\frac{1}{\lambda} \sum_{i=1}^n \underbrace{\sum \limits_{k=1}^K \gamma_{ik}^{(t)}}_{1} = -\frac{n}{\lambda} \quad \Longrightarrow \quad \lambda = -n \]
代回原式,得到更新公式: \[ w_k^{(t+1)} = \frac{\sum \limits_{i=1}^n \gamma_{ik}^{(t)}}{n} \] 实际意义:第 \(k\) 个成分的权重 = 该成分所有隶属度之和 / 样本总数。即“属于该类的平均人数比例”。
推导 2:更新均值 \(\mu_k\)
我们只关注 \(Q\) 函数中包含 \(\mu_k\) 的项: \[ \mathcal{J}(\mu_k) = \sum_{i=1}^n \gamma_{ik}^{(t)} \left( -\frac{(x_i - \mu_k)^2}{2\sigma_k^2} \right) \]
对 \(\mu_k\) 求偏导并令其为 0: \[ \frac{\partial \mathcal{J}}{\partial \mu_k} = \sum_{i=1}^n \gamma_{ik}^{(t)} \frac{2(x_i - \mu_k)}{2\sigma_k^2} = 0 \] 消去常数 \(\sigma_k^2\),整理方程: \[ \sum_{i=1}^n \gamma_{ik}^{(t)} x_i - \sum_{i=1}^n \gamma_{ik}^{(t)} \mu_k = 0 \] \[ \mu_k \sum_{i=1}^n \gamma_{ik}^{(t)} = \sum_{i=1}^n \gamma_{ik}^{(t)} x_i \]
得到更新公式: \[ \mu_k^{(t+1)} = \frac{\sum \limits_{i=1}^n \gamma_{ik}^{(t)} x_i}{\sum \limits_{i=1}^n \gamma_{ik}^{(t)}} \] 实际意义:第 \(k\) 个成分的均值等于所有样本的加权平均值,每个样本的权重就是它属于该类的隶属度。这与 6.1 节中给出的更新公式完全一致。
推导 3:更新方差 \(\sigma_k^2\)
我们只关注 Q 函数中包含 \(\sigma_k^2\) 的项(注意 \(\ln(\sqrt{2\pi}\sigma_k) = \frac{1}{2}\ln(2\pi) + \frac{1}{2}\ln(\sigma_k^2)\)): \[ \mathcal{J}(\sigma_k^2) = \sum_{i=1}^n \gamma_{ik}^{(t)} \left( -\frac{1}{2}\ln(\sigma_k^2) - \frac{(x_i - \mu_k)^2}{2\sigma_k^2} \right) \]
令 \(V = \sigma_k^2\),对 \(V\) 求偏导并令其为 0: \[ \frac{\partial \mathcal{J}}{\partial V} = \sum_{i=1}^n \gamma_{ik}^{(t)} \left( -\frac{1}{2V} + \frac{(x_i - \mu_k)^2}{2V^2} \right) = 0 \] 两边同乘 \(2V^2\): \[ \sum_{i=1}^n \gamma_{ik}^{(t)} \left( -V + (x_i - \mu_k)^2 \right) = 0 \] \[ -V \sum_{i=1}^n \gamma_{ik}^{(t)} + \sum_{i=1}^n \gamma_{ik}^{(t)} (x_i - \mu_k)^2 = 0 \]
得到更新公式: \[ (\sigma_k^2)^{(t+1)} = \frac{\sum \limits_{i=1}^n \gamma_{ik}^{(t)} (x_i - \mu_k^{(t+1)})^2}{\sum \limits_{i=1}^n \gamma_{ik}^{(t)}} \] 物理意义:第 \(k\) 个成分的方差等于每个样本偏离中心距离的加权平方和,权重还是隶属度。
注意公式里的均值是 \(\mu_k^{(t+1)}\) 而不是 \(\mu_k^{(t)}\)。方差的定义是数据偏离中心的距离平方的期望;对于第 \(t+1\) 轮迭代,最能代表这组数据中心的,显然是刚刚求出来的最新均值 \(\mu_k^{(t+1)}\),而不是上一轮的旧均值 \(\mu_k^{(t)}\)。
3. 算法流程总结
高斯混合模型的参数估计流程如下:
初始化:随机选取 \(w_k, \mu_k, \sigma_k^2\) 的初值。
E步:根据公式计算隶属度 \(\gamma_{ik}^{(t)}\)。
M步:
\(w_k^{(t+1)} = \frac{\sum \limits_{i=1}^n \gamma_{ik}^{(t)}}{n}\)
\(\mu_k^{(t+1)} = \frac{\sum \limits_{i=1}^n \gamma_{ik}^{(t)} x_i}{\sum \limits_{i=1}^n \gamma_{ik}^{(t)}}\)
\((\sigma_k^2)^{(t+1)} = \frac{\sum \limits_{i=1}^n \gamma_{ik}^{(t)} (x_i - \mu_k^{(t+1)})^2}{\sum \limits_{i=1}^n \gamma_{ik}^{(t)}}\)
循环,直至收敛。
下面用代码实现这一算法。
4. 代码实现
1 | import numpy as np |
1 | # 生成模拟数据 |
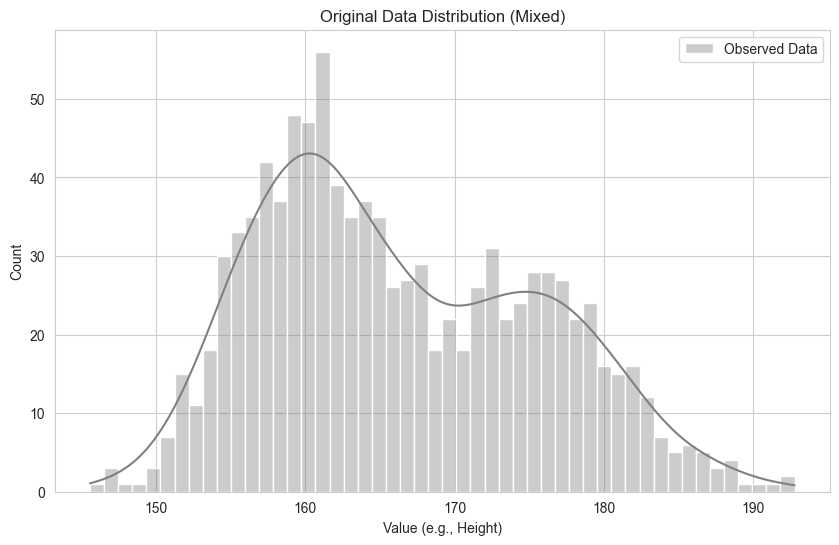
1 | # 定义高斯公式与初始化函数 |
初始参数: {'mu': array([174.8142505 , 161.95126634]), 'sigma_sq': array([42.93554301, 42.93554301]), 'weights': array([0.5, 0.5])}1 | # EM 算法核心步骤 |
1 | # 可视化绘制函数 |
这里我们把所有东西串起来,并展示第 0, 1, 3, 10 次迭代的结果。
1 | # 运行主循环并绘图 |
开始 EM 迭代...
Iteration 0: Log-Likelihood = -3685.33
Iteration 1: Log-Likelihood = -3610.01
Iteration 3: Log-Likelihood = -3589.98
Iteration 10: Log-Likelihood = -3571.32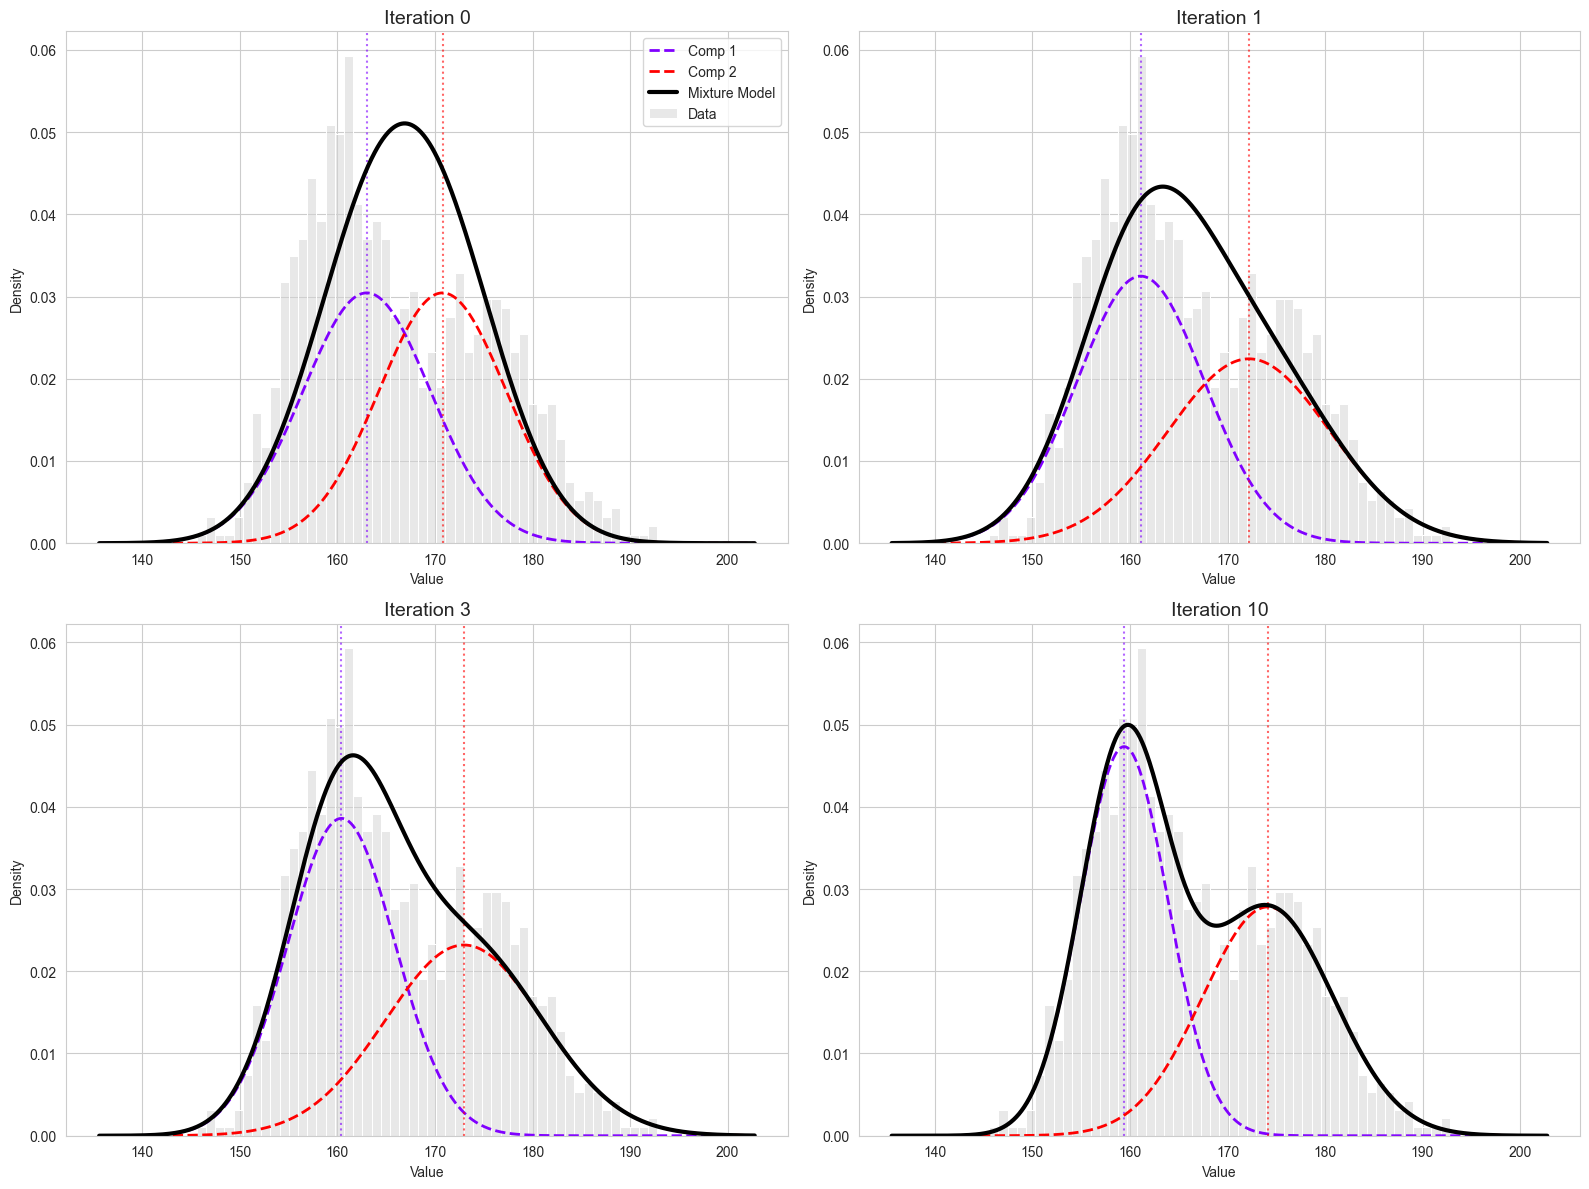
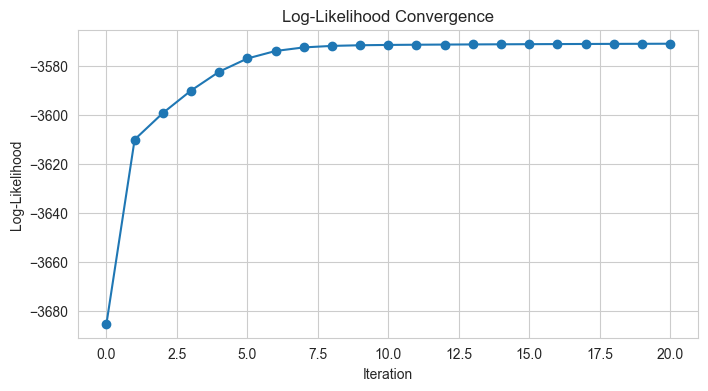
最终收敛参数:
均值: [159.53631918 174.56978659]
方差: [20.58644282 41.38855796]
权重: [0.55028945 0.44971054]
通过运行上述代码,我们可以清晰地观察到 EM 算法的迭代过程。 * 在初始阶段(Iter 0),高斯曲线可能完全偏离数据中心。但仅经过一次迭代(Iter 1),两条曲线就迅速跳到了两个波峰附近。这说明EM 算法在初期具有极高的收敛效率。 * 随后的迭代中,曲线不再大幅移动,而是进行微调。方差和权重在不断调整,直到黑色实线(混合分布)完美贴合灰色直方图(真实数据分布)。 * 观察 Log-Likelihood Convergence 图,曲线始终单调上升,最终趋于平缓。这完美验证了 6.2 节中的数学推导:EM 算法保证每一步迭代都能使似然函数增加(或至少不减少),直至收敛到局部最优。
GMM 处理的都是连续型数值数据(如身高)。但在人工智能领域,还有一类极重要的数据是离散且稀疏的,比如文本。
试想这样一个场景:
GMM 场景:全校混杂了不同年级(隐变量)的学生,表现为不同的身高分布(观测值)。
文本场景:图书馆混杂了不同话题(隐变量)的文章,表现为不同的单词分布(观测值)。
如果我们把“身高数值”换成“单词计数”,把“高斯分布”换成“多项分布”,能不能用 EM 算法来自动把文章分类?
答案是肯定的。这就是著名的 概率潜在语义分析 (PLSA),也就是我们下一节要介绍的话题模型。它本质上就是离散版本、高维版本的混合模型。
6.4 话题模型
话题模型在机器学习和自然语言处理等领域是用来在一系列文档中发现抽象主题的一种统计模型。直观来讲,如果一篇文章有一个中心思想,那么一些特定词语会更频繁的出现。比方说,如果一篇文章是在讲狗的,那“狗”和“骨头”等词出现的频率会高些。如果一篇文章是在讲猫的,那“猫”和“鱼”等词出现的频率会高些。而有些词例如“这个”、“和”大概在两篇文章中出现的频率会大致相等。但真实的情况是,一篇文章通常包含多种主题,而且每个主题所占比例各不相同。因此,如果一篇文章10%和猫有关,90%和狗有关,那么和狗相关的关键字出现的次数大概会是和猫相关的关键字出现次数的9倍。
一个话题模型试图用数学框架来体现文档的这种特点。主题模型自动分析每个文档,统计文档内的词语,根据统计的信息来断定当前文档含有哪些主题,以及每个主题所占的比例各为多少。(复制自维基百科)
6.4.1 问题定义
1. 参数定义
- \(D = \{d_1, ..., d_M\}\):文档集合(\(M\) 篇文档)。
- \(W = \{w_1, ..., w_N\}\):词表集合(\(N\) 个单词)。
- \(Z = \{z_1, ..., z_K\}\):话题集合(\(K\) 个话题,隐变量)。
- \(\#(d_m, w_n)\):观测数据。单词 \(w_n\) 在文档 \(d_m\) 中出现的次数。
- \(P(z_k | d_m)\):文档-话题分布,即文档 \(d_m\) 中包含话题 \(z_k\) 的概率,也记作 \(q_{m,k}\)。
- \(P(w_n | z_k)\):话题-单词分布,即给定话题 \(z_k\),生成单词 \(w_n\) 的概率,也记作 \(p_{k,n}\)。
- \(\gamma_{m,n,k}\):单词 \(w_n\) 出现在文档 \(d_m\) 中时,它是由话题 \(z_k\) 生成的概率,也就是隶属度。
2. 生成模型
我们观测到的样本是共现矩阵 \(\mathbf{X} \in \mathbb{N}^{M \times N}\),其中 \(x_{mn} = \#(d_m, w_n)\)。 PLSA 假设文档和单词的生成过程如下(本质上还是全概率公式): \[ P(d, w) = P(d) \sum_{k=1}^K P(w|z_k) P(z_k|d) \]
6.4.2 EM 算法推导
1. E步:计算隶属度和 Q 函数
根据贝叶斯公式
\[ \gamma_{m,n,k} = P(z_k | d_m, w_n) =
\frac{P(w_n | z_k) P(z_k | d_m)}{\sum \limits_{j=1}^K P(w_n | z_j) P(z_j
| d_m)} \]
即 \[ \gamma_{m,n,k}^{(t)} = \frac{p_{k,n}^{(t)} q_{m,k}^{(t)}}{\sum \limits_{j=1}^K p_{j,n}^{(t)} q_{m,j}^{(t)}} \]
我们的目标是最大化 Q 函数 \[ \begin{aligned} Q &= \sum_{m=1}^M \sum_{n=1}^N \#(d_m, w_n) \sum_{k=1}^K \gamma_{m,n,k} \ln ( P(w_n|z_k) P(z_k|d_m)) \\ &= \sum_{m=1}^M \sum_{n=1}^N \#(d_m, w_n) \sum_{k=1}^K \gamma_{m,n,k} \ln (p_{k,n} \cdot q_{m,k} \big) \end{aligned} \] 这里之所以要乘上 \(\#(d_m, w_n)\),是因为极大似然估计本质上是对每一个观测到的样本求积(取 \(\ln\) 后变成求和)。而为了计算方便,我们把相同的样本合并了。
2. M步:更新参数
这一步和 GMM 的 M 步类似,需要利用 ${n=1}^{N} p{k,n}=1 和 $ 构造 Lagrange 函数,然后求偏导。这里不再给出具体过程,直接给出结论。
\[ p_{k,n}^{(t+1)} = \frac{\sum \limits_{m=1}^M \#(d_m, w_n) \cdot \gamma_{m,n,k}^{(t)}}{\sum \limits_{n'=1}^N \sum \limits_{m=1}^M \#(d_m, w_{n'}) \cdot \gamma_{m,n',k}^{(t)}} \]
分子:所有文档中,被判定为属于话题 \(k\) 的单词 \(n\) 的“期望频次”。
分母:话题 \(k\) 下所有单词的总期望频次(归一化)。
\[ q_{m,k}^{(t+1)} = \frac{\sum \limits_{n=1}^N \#(d_m, w_n) \cdot \gamma_{m,n,k}^{(t)}}{\sum \limits_{n=1}^N \#(d_m, w_n)} \] * 分子:文档 \(d_m\) 中,被判定为属于话题 \(k\) 的所有单词的总份量。
- 分母:文档 \(d_m\) 的总词数(归一化)。
6.4.3 代码实现
在这个例子中,我们将模拟一个简单的场景:
词表:10个词(前5个是“食物”相关,后5个是“科技”相关)。
文档:10篇文档(前5篇主要讲吃,后5篇主要讲技术)。
任务:看 PLSA 能否自动把这 2 个话题(隐变量)找出来。
1 | import numpy as np |
1 | # 词表 (Vocab) |
文档-单词共现矩阵 X (前5行):
[[8. 6. 8. 8. 9. 1. 0. 0. 0. 0.]
 [8. 8. 7. 9. 5. 0. 1. 1. 1. 1.]
 [6. 8. 6. 5. 6. 1. 1. 1. 0. 1.]
 [5. 7. 8. 5. 6. 0. 0. 1. 0. 0.]
 [8. 7. 8. 5. 7. 0. 0. 1. 1. 1.]]
1 | # PLSA 核心算法 |
1 | # 设定寻找 2 个话题 |
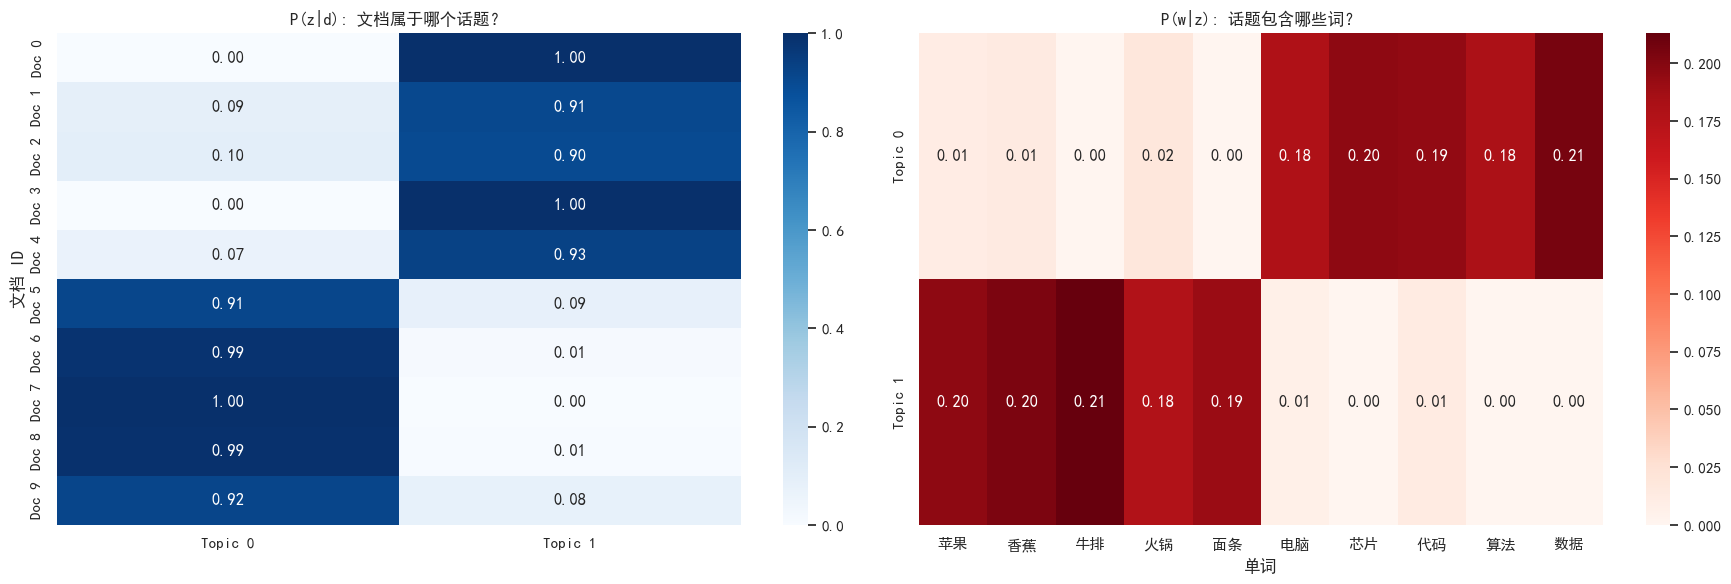
运行这段代码,你会看到非常漂亮的结果:
- 左边的蓝图 \((P(z|d))\):
- 矩阵呈现出明显的分块结构。
- Doc 0-4 在某一列(比如 Topic 0)数值接近 1.0。
- Doc 5-9 在另一列(比如 Topic 1)数值接近 1.0。
- 结论:模型成功发现了前5篇是一类,后5篇是另一类。
- 右边的红图 \((P(w|z))\):
- Topic 0 对应的行,在“苹果、香蕉…”等食物词上颜色很深。
- Topic 1 对应的行,在“电脑、芯片…”等科技词上颜色很深。
- 结论:模型成功提取出了“食物”和“科技”两个语义概念,尽管我们从未告诉它这些词是什么意思。
这就是 EM 算法在无监督学习中的强大之处:从杂乱的共现数据中,自动发现潜在的语义结构。
6.5 总结
至此,我们完成了对 EM 算法的深度探索。我们从一个简单的“身高之谜”出发,最终构建出了能够自动理解文本语义的“话题模型”。
EM 算法解决的是统计学中著名的 “鸡生蛋,蛋生鸡” 难题——当数据缺失(隐变量)时,我们无法直接估计参数;而没有参数,我们又无法填补缺失的数据。而 EM 算法给出的答案是:不要试图一步到位,而是交替迭代。E步进行软性猜测,在当前参数下,计算隐变量的后验概率(隶属度 \(\gamma\))。M步进行加权更新,基于这些软性猜测,用加权极大似然估计来更新模型参数。这种“软分类 \(\leftrightarrow\) 重估参数”的循环,将一个无法求解的非凸优化问题,拆解成了两个易于求解的子问题。
我们通过三个经典案例展示了 EM 算法的通用性。三硬币模型是 EM 的“Hello World”,揭示了离散数据的混合估计逻辑。高斯混合模型 (GMM)利用连续数据的距离信息,实现了比 K-Means 更细腻的“软聚类”。话题模型 (PLSA) 在稀疏的高维文本数据中,成功挖掘出了潜在的语义结构。
在代码实践环节,我们也看到了 EM 算法的局限性。EM 算法对初值敏感,不同的初始值很可能导致收敛到不同的局部最优点。此外,EM 算法很容易陷入局部最优点,而错失全局最优点。
因此,在实际使用 EM 算法时,多次随机初始化和结合其他算法(如先用 K-Means 初始化)是打破僵局、提升效果的标准范式。