目录
- ILP的基本概念与“拦路虎”
- 软件的智慧:基本流水线调度与循环展开
- 预测未来的魔法:高级分支预测
- 硬件的智慧:Tomasulo动态调度算法
- 硬件推测执行(ROB)与多发射(超标量/VLIW)
- 指令提取带宽与BTB技术
- 压榨CPU的极限:多线程技术与真实CPU案例
1 ILP的基本概念与“拦路虎”
1.1 什么是指令级并行
程序里的指令原本是一条一条排队执行的。但是CPU觉得这样太慢了,指令级并行(ILP)就是让多条指令在流水线中“重叠”执行。实现ILP宏观上有两种方式:
- 软件派(编译器): 在程序运行前(静态),把代码重新排版,让指令更好并行。
- 硬件派(CPU硬件): 在程序运行中(动态),CPU自己发现哪些指令可以一起执行。
1.2 谁在阻挡指令级并行
要想让指令并行,最大的阻碍就是指令之间有“关系”。相关可以分为三种:
- 数据相关(真相关)。例如指令 \(i\) 计算出一个结果,但指令 \(i+1\) 要用到这个结果。
- 名称相关(假相关)。它是指两条指令其实没有任何数据交流,只是碰巧用到了同一个寄存器。名称相关又可细分为以下两种:
- 反相关。例如指令 \(i+1\) 写了一个寄存器,而指令 \(i\) 正好要读它。(先读再写)
- 输出相关。例如指令 \(i\) 和指令 \(i+1\) 都要写同一个寄存器。
- 控制相关。这由分支指令(比如 if-else)引起。在判断条件没出来之前,CPU不知道接下来该执行哪条指令。
1.3 数据冒险
如果一段汇编代码发生了相关,就会在流水线中引发冲突,导致流水线停顿,这就是冒险。针对数据流(数据相关+名称相关),有三种冒险:
- RAW(写后读): 对应数据真相关。
- WAW(写后写): 对应输出相关。
- WAR(读后写): 对应反相关。
在最基础的5级流水线中,只有RAW会发生;但是当我们允许指令“乱序执行”来提高性能时,就会出现WAW和WAR。
1.4 例子
1 | 1. ADD.D F2, F4, F6 // 把F4和F6相加,结果写入F2 |
- 指令1和指令2之间是数据相关,对应写后读;
- 指令1和指令3之间是输出相关,对应写后写;
- 指令2和指令3之间是反相关,对应读后写。
如果要消除指令2和指令3之间的冲突,可以使用寄存器换名的策略。例如,把指令3的F2换成F20,它和指令2就不存在任何冲突了。
2 软件的智慧:基本流水线调度与循环展开
这一节要解决的问题是,编译器如何在软件层面(静态)实现指令级并行?
本节将会以一个浮点数计算的循环体为例,介绍基本流水线调度与循环展开。规定处理器的浮点延迟如下:
| 产生结果的指令 | 使用结果的指令 | 延迟(时钟周期数) |
|---|---|---|
| 浮点计算 | 浮点计算 | 3 |
| 浮点计算 | 浮点store | 2 |
| 浮点load | 浮点计算 | 1 |
| 浮点load | 浮点store | 0 |
2.1 原始代码
下面是一段经典的循环代码,把数组元素加上标量 s:
1 | Loop: L.D F0, 0(R1) // 取数组元素到F0 |
由于上述的流水线延迟,在 L.D 和 ADD.D 之间会产生1个 Stall,在 ADD.D 和 S.D 之间会产生2个 Stall。加上两条循环控制指令,处理1个数组元素总共需要 9 个时钟周期,性能极其低下。
1 | Loop: L.D F0, 0(R1) ; 指令流出时钟 1 |
2.2 初级优化:指令调度
编译器的第一步优化,是把毫无关联的指令“塞”进这些停顿(Stall)中。例如,编译器发现 DADDIU R1, R1, -8 和浮点计算完全没有数据相关,可以把它提前到 L.D 和 ADD.D 之间。但是因为 R1 提前减去了8,后面的 S.D 如果还是用 0(R1) 就会存错地址。所以编译器必须同时补偿偏移量,将 S.D 修改为 S.D F4, 8(R1)。最终得到的汇编代码如下:
1 | Loop: L.D F0, 0(R1) |
此时周期数从9降到了7个周期,但依然存在2个停顿周期无法消除。
2.3 中级优化:循环展开
单次循环内的指令太少,调度空间见底了。怎么办?
编译器采用循环展开技术,直接把循环体复制多次。这里展开了4次,即把4次小的迭代合并成1次大的迭代。
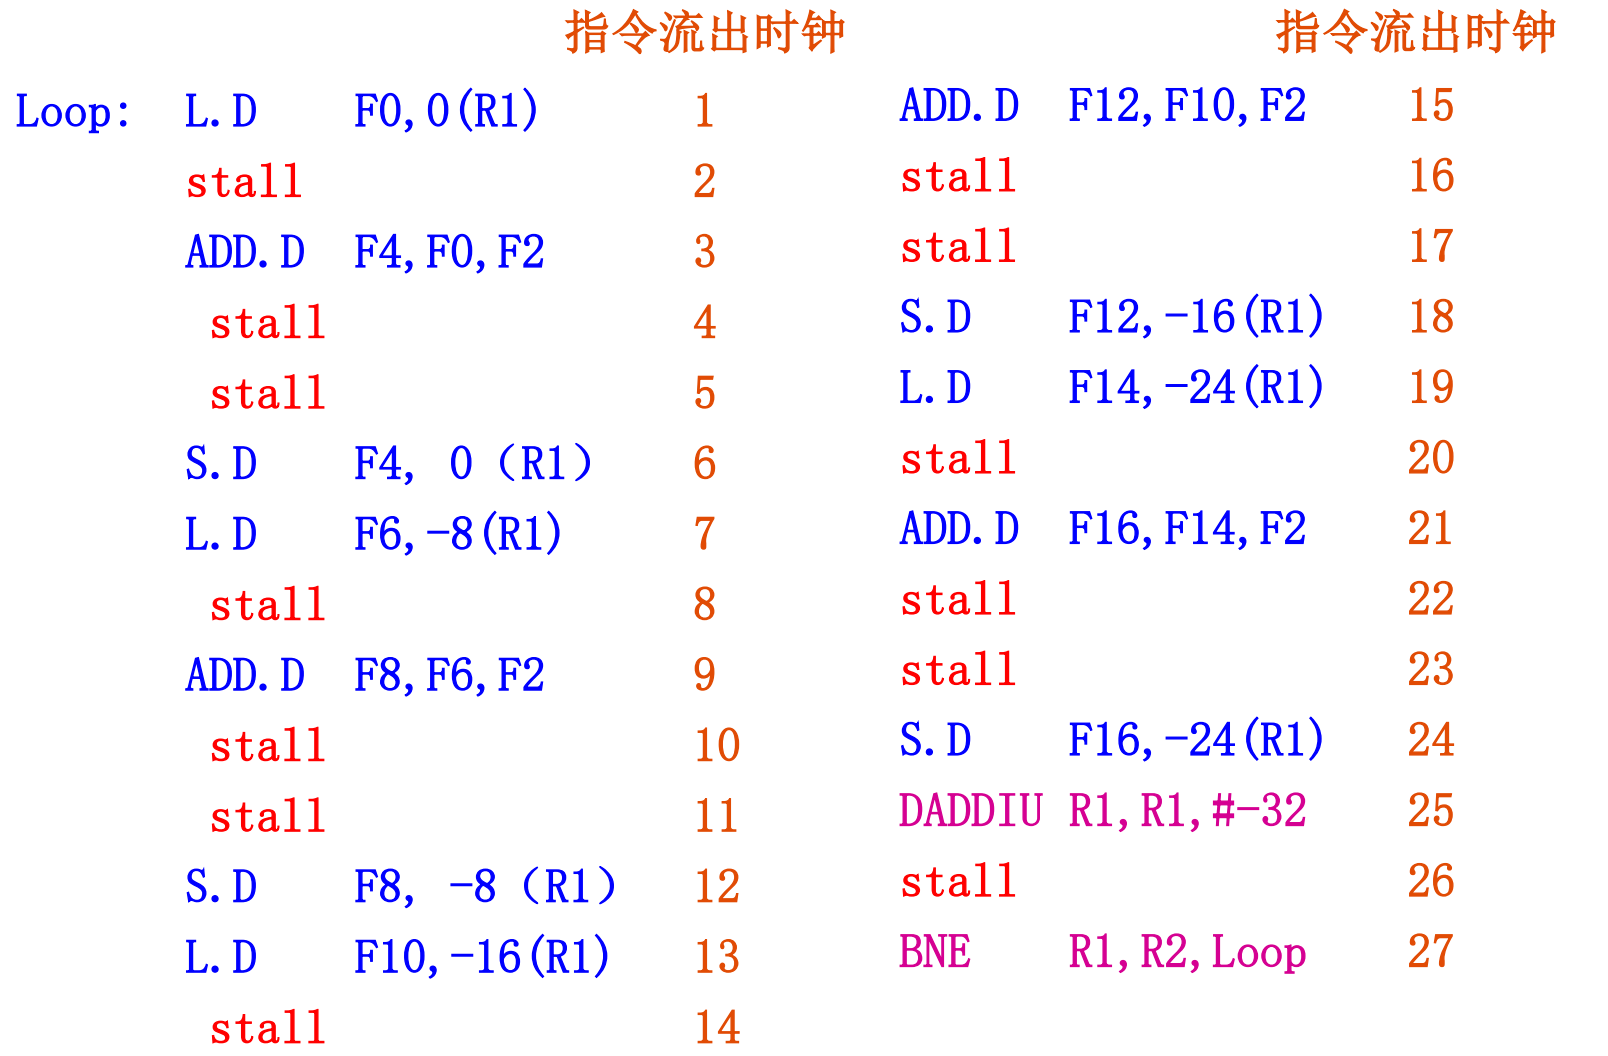
把【L.D, ADD.D, S.D】的组合复制4次。原本需要4次 DADDIU 和4次 BNE,现在只需要在最末尾保留1次即可,极大地消除了循环控制开销。
如果4个循环体中的寄存器全用 F0 和 F4,会产生严重的写后写(WAW)和读后写(WAR)冒险。因此编译器给第1个元素用 F0/F4,第2个用 F6/F8,第3个用 F10/F12,第4个用 F14/F16。
现在我们有了4条 L.D,4条 ADD.D,4条 S.D,且它们之间完全没有数据相关。编译器把所有的 L.D 排在一起,接着排所有的 ADD.D,最后排所有的 S.D。
这个循环每遍共使用了27个时钟周期,平均每个元素使用27/4=6.75个时钟周期,小于原来的9个时钟周期。
Q:循环展开把 L.D, ADD.D, S.D 的组合复制4次,但如果循环次数不是四的倍数怎么办?
A:在编译器优化中,通常使用条带开采(Strip Mining)技术解决这一问题。假设我们要循环 \(N\) 次,展开因子是 \(K\)(比如 \(K=4\))。编译器会把代码分成两个循环来生成:
- 主体展开循环: 每次处理 \(K\) 个元素,总共执行 \(\lfloor N/K \rfloor\) 次。
- 尾部清理循环: 这是一个没有展开的普通循环,用来处理剩下除不尽的 \(N \bmod K\) 个元素。
2.4 终极优化:循环展开+指令调度
对循环展开后的指令序列还可以进行优化调度,以减少空转周期:
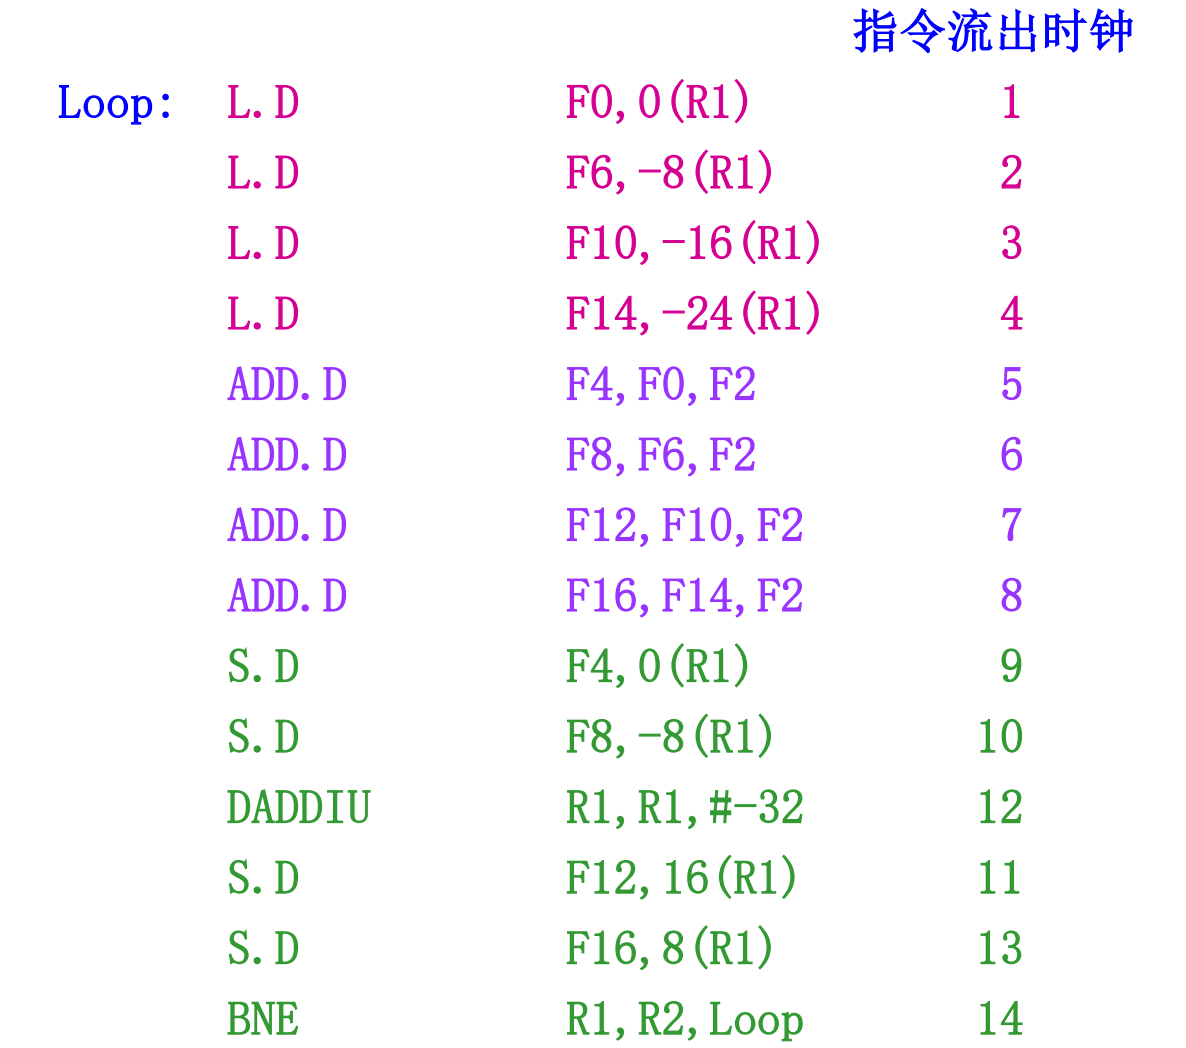
整个循环仅仅使用了14个时钟周期,平均每个循环仅使用14/4=3.5个时钟周期。
3 预测未来的魔法:高级分支预测
控制相关会阻碍流水线。为了不让流水线等,CPU只能“猜”分支往哪走。
3.1 传统预测的局限
传统的2位预测器只看单个分支自身的历史记录。比如一个 for 循环的条件判断,它自己跳了99次,第100次大概率还是跳。但这有局限性:有些分支的结果,根本不是由它自己决定的,而是由它前面的其他分支决定的。
例如以下代码:
1 | /* 分支 b1 */ if (aa == 2) aa = 0; |
如果分支b1和b2的条件都成立,那么此时 aa 必然等于0,bb 也必然等于0。这就意味着,到达第三个分支(b3)时,aa != bb 这个条件绝对不可能成立。
如果使用基础的局部预测器,b3 只会傻傻地看自己过去的记录。
如果使用相关预测(也叫全局历史预测),硬件会记录一条全局历史移位寄存器(Global History Register, GHR)。当CPU看到全局历史是“b1成立,b2成立”时,它能直接推断出“b3绝对不成立”。
3.2 常用的分支预测器
3.2.1 局部预测器
在局部预测器中,每一条分支指令都有自己的历史记录,记录该分支最近几次是跳转还是不跳转,从而用这个历史去预测下一次是否跳转。
例如,有一个分支指令 if (i % 2 == 0),这个分支过去几次的跳转情况为 T, T, T, N, T, T …,那么下一次大概率跳转。
硬件结构
第一级:局部历史表(Local History Table, LHT)
- key:一条分支指令(用 PC 地址的低位索引)
- value:一个 k 位移位寄存器,记录该指令最近 k 次的结果,例如
110表示最近三次:跳、跳、不跳
第二级:模式历史表(Pattern History Table, PHT)
key:第一级输出的局部历史记录(k 位)
value:一个饱和计数器数组(通常是 2-bit),共 \(2^k\) 个条目。计数器计的“数”的含义是,
00=强不跳,01=弱不跳,10=弱跳,11=强跳,相当于一个状态机
预测流程:
1 | PC低位 |
这种结构擅长捕捉有规律的局部模式,比如循环内”T T T T N”的规律跳转。
3.2.2 全局预测器
全局预测器使用一个全局历史寄存器(GHR, Global History Register)记录最近 N 条分支的结果(例如:TNTTNT…),用这串历史去预测当前分支指令是否需要跳转。
硬件结构
第一级:全局历史寄存器(Global History Register, GHR)
- 一个 k 位移位寄存器,记录最近 k 条分支(不管是哪条指令)的结果
- 每执行一条分支,就将结果移入 GHR,最旧的移出
第二级:模式历史表(PHT)
- key:第一级输出的全局历史记录(k位)
- value:一个饱和计数器数组(通常是 2-bit),共 \(2^k\)
个条目。计数器计的“数”的含义是,
00=强不跳,01=弱不跳,10=弱跳,11=强跳,相当于一个状态机
预测流程:
1 | ┌─────────┐ |
全局预测器擅长捕捉跨分支的相关性,例如”如果前面的 if 条件成立,后面的 if 也很可能成立”。
3.2.3 竞赛预测器
局部预测器对某些分支有效,全局预测器对另一些分支有效。既然各有千秋,硬件设计师决定把这两个东西结合起来,就变成了竞赛预测器。
硬件结构
部件 A: 局部预测器(Local Predictor),同上
部件 B: 全局预测器(Global Predictor),同上
部件 C: 选择器(Selector / Choice Predictor)
- key:分支指令的地址
- value:2位计数器,具体含义见下面
选择器不是用来预测分支跳还是不跳,而是用来预测“这次我该信A还是信B”。对于每一条分支指令,选择器里都有一个专用的 2位饱和计数器(2-bit Saturating Counter)。它的状态机如下:
- 状态 00 (0): 强烈倾向使用 A(局部预测器)。
- 状态 01 (1): 较弱倾向使用 A(局部预测器)。
- 状态 10 (2): 较弱倾向使用 B(全局预测器)。
- 状态 11 (3): 强烈倾向使用 B(全局预测器)。
也就是说,数值越小越相信 A,数值越大越相信 B:
1 | 相信A 相信B |
当一条分支指令实际执行完毕,
- 如果 A猜对了,B猜错了:选择器的计数器减1(状态向 0 移动,变得更信任 A)。
- 如果 B猜对了,A猜错了:选择器的计数器加1(状态向 3 移动,变得更信任 B)。
- 如果 A和B都猜对,或者都猜错:没分出胜负,计数器状态保持不变。
例如,对于一条给定的分支指令,如果在最近的运行中,全局预测(B)总是比局部预测(A)准,选择器就会被训练到状态 3。下次遇到这条指令,无论 A 怎么说,CPU都直接采纳 B 的预测结果。
3.3 局限性
假设程序里有一个非常随机的数据序列(比如伪随机数生成器产生的一千万个0和1),然后代码是:
1 | if (random_array[i] == 1) { |
无论是局部预测器、全局预测器还是竞赛预测器,面对这段代码时,它们的预测准确率大概是50%。
- 对局部预测器而言: 它通过 PC 地址查到了这条 if 指令专属的 2 位计数器。但是数据是随机的,导致上一次跳了,这一次可能不跳。计数器的值在 0、1、2、3 之间毫无规律地随机震荡(专业术语叫 Thrashing 颠簸)。预测结果完全是随机瞎蒙(50%)。
- 对全局预测器而言: GHR 里记录的历史(比如最近5次分支的结果 01101)也是由随机数据产生的随机噪声。用一个随机噪声去查表,查出来的计数器状态同样是噪音,预测率依然是 50%。
- 对竞赛选择器而言: A 和 B 都在瞎蒙,所以 A 和 B 猜对的概率都是 50%。选择器的计数器也失去了方向,在 A 和 B 之间随机横跳。
这揭示了分支预测的根本局限性:分支预测的本质是利用程序运行中的“数据相关性规律”和“代码结构模式规律”。如果输入数据具有极高的信息熵(Entropy,即纯随机),硬件预测逻辑将彻底失效。
在真实的工业界开发中,如果程序员写出了这种针对高频随机数据的分支,会导致 CPU 流水线因为疯狂预测错误而反复清空,性能极速下降。这也是为什么资深的 C++ 工程师在处理这种核心代码时,会刻意使用 无分支编程(Branchless Programming) 或者 条件传送指令(如 x86 的 CMOV,ARM 的 CSEL) 来消除分支指令,从而避开分支预测器的软肋。
3.4 Intel Core i7 使用的分支预测技术
Intel Core i7 将竞赛预测器的思想发扬光大。它的分支预测器包含:
- 局部预测器
- 全局预测器
- 循环退出预测器(专门针对for/while循环结束的那一次跳跃进行特化识别)
然后通过复杂的选择器网络(融合了竞赛机制),把这三个预测器的结果进行整合决策。这就使得 Core i7 能够将分支预测准确率推高到 95% 以上。
4 硬件的智慧:Tomasulo动态调度算法
4.1 动态调度的思想与困难
经典的5级流水线是按序发射、按序执行的。一旦某条指令因为数据没准备好(数据冒险)而停顿(Stall),它后面的所有指令,哪怕是不相关的指令,也全都被堵在后面。
为了实现乱序执行(Out-of-Order Execution),可以把经典的译码段(ID)拆成两半:
- 发射(Issue, IS): 这一步依然是按序的。指令在这里译码,并检查有没有结构冒险(比如加法器够不够用)。
- 读操作数(Read Operands, RO): 这一步开始乱序!如果指令需要的数据还没算出来(数据冒险),它就在这儿等。但关键是,它等它的,不妨碍后面的指令先去读操作数并执行。
但一旦允许乱序执行,就会出现WAR冒险和WAW冒险。例如
1 | DIV.D F0, F2, F4 |
如果 SUB.D 跑得比 ADD.D 快,它先去把 F8 给写了,那后面 ADD.D 读到的 F8 就是错的!这就是反相关引起的 WAR 冒险。
而动态调度还有一大麻烦:不精确异常。精确异常是指,假设程序按顺序跑,在指令 \(i\) 发生除零错误(异常)时,前面的指令全执行完了,\(i\) 后面的指令都没产生任何影响。现场保护得清清楚楚。而因为乱序,当指令 \(i\) 发生异常时,它后面的指令 \(i+1\) 可能已经跑完了并且把结果写进了寄存器。这时候你再去捕捉异常状态,现场已经被破坏了,这叫不精确异常。
4.2 Tomasulo 算法
见【Tomasulo-原始例子-来自b站】
5 硬件推测执行(ROB)与多发射(超标量/VLIW)
在原始的 Tomasulo 算法中,虽然实现了乱序执行,但存在一个致命的体系结构缺陷:指令乱序完成(Out-of-order Completion)。当功能部件计算完毕后,结果通过 CDB 直接写入了物理寄存器或存储器。
如果发生分支预测错误或异常(Exception),由于后续的指令可能已经提前算完并修改了寄存器,处理器的真实状态(体系结构状态)已经被破坏,无法回滚到异常发生或分支跳转前的精确状态(即不精确异常)。
为了解决这个问题并支持推测执行,现代体系结构在Tomasulo算法的基础上引入了重排序缓冲区(Reorder Buffer, ROB)。
5.1 ROB:重排序缓冲区
ROB是一个先进先出(FIFO)的环形队列,用于临时存放乱序执行产生的结果。引入ROB后,处理器的执行逻辑被严格定义为:乱序执行,按序提交(Out-of-order Execution, In-order Commit)。
在引入ROB的架构中,原有的硬件机制发生了重要改变:
- 寄存器重命名主体的转移: 在原始Tomasulo中,寄存器重命名(消除WAR/WAW冒险)是通过保留站(RS)的站号完成的。在推测架构中,寄存器换名由ROB的编号(Tag)来完成。
- 寄存器状态表(Qi)的改变: 状态表不再记录保留站的编号,而是记录即将写入该寄存器的指令在ROB中的项号。
5.2 加入ROB后的Tomasulo算法
5.2.1 算法步骤
两个关键点:
写回之后就可以广播
提交之后才可以修改寄存器状态
引入ROB后,指令的执行周期从原始Tomasulo的3步扩展为4步:
1.发射/流出:从浮点指令队列的头部取一条指令。如果有空闲的保留站(设为r)且有空闲的ROB项(设为b),就流出该指令,并把相应的信息放入保留站r和ROB项b。如果保留站或ROB全满,便停止流出指令,直到它们都有空闲的项。
2.执行:如果有操作数尚未就绪,就等待,并不断地监测CDB。(这一步检测RAW冒险)当两个操作数都已在保留站中就绪后,就可以执行该指令的操作。
3.写结果:当结果产生后,将该结果连同本指令在流出段所分配到的ROB项的编号放到CDB上,经CDB写到ROB以及所有等待该结果的保留站。(广播)然后释放产生该结果的保留站。
store指令在本阶段执行的操作为:
如果要写入存储器的数据已经就绪,就把该数据写入分配给该store指令的ROB项(value字段)。
否则,就监测CDB,直到那个数据在CDB上播送出来,这时才将之写入分配给该store指令的ROB项(value字段)。
4.提交
对分支指令、 store指令以及其他指令的处理不同:
其他指令(除分支指令和store指令):当该指令到达 ROB 队列的头部而且其结果已经就绪时,就把该结果写入该指令的目标寄存器,并从ROB中删除该指令。
store指令:处理与上面类似,只是它把结果写入存储器。
分支指令:
- 当预测错误的分支指令到达ROB队列的头部时,清空ROB,并从分支指令的另一个分支重新开始执行。(错误的推测执行)
- 当预测正确的分支指令到达ROB队列的头部时,该指令执行完毕。
5.2.2 例子
见【加入ROB的Tomasulo例子-来自cc】
总之,加入ROB后的Tomasulo算法通过ROB将“执行”与“提交”解耦。Tomasulo算法负责在前端和中端最大化乱序执行的吞吐量,而ROB负责在后端把关,确保体系结构状态的更新严格遵循程序原本的串行语义。这是现代高性能处理器(如Intel Core、ARM Cortex-A系列)实现精确异常和高效分支推测的核心基石。
5.3 多发射技术
在前面的学习中,无论是基础的5级流水线,还是Tomasulo动态调度,处理器的发射宽度始终是 1(即每个时钟周期最多只能从指令队列中提取并发射一条指令)。因此,其理想 CPI(每指令周期数)的极限只能趋近于 1。
为了打破这个理论极限,实现 CPI < 1(或者说 IPC,每周期指令数 > 1),体系结构引入了多发射技术,即在一个时钟周期内向执行部件发射多条指令。根据依赖检测是由硬件动态完成还是编译器静态完成,多发射技术主要分为两大流派:超标量(Superscalar) 和 超长指令字(VLIW)。
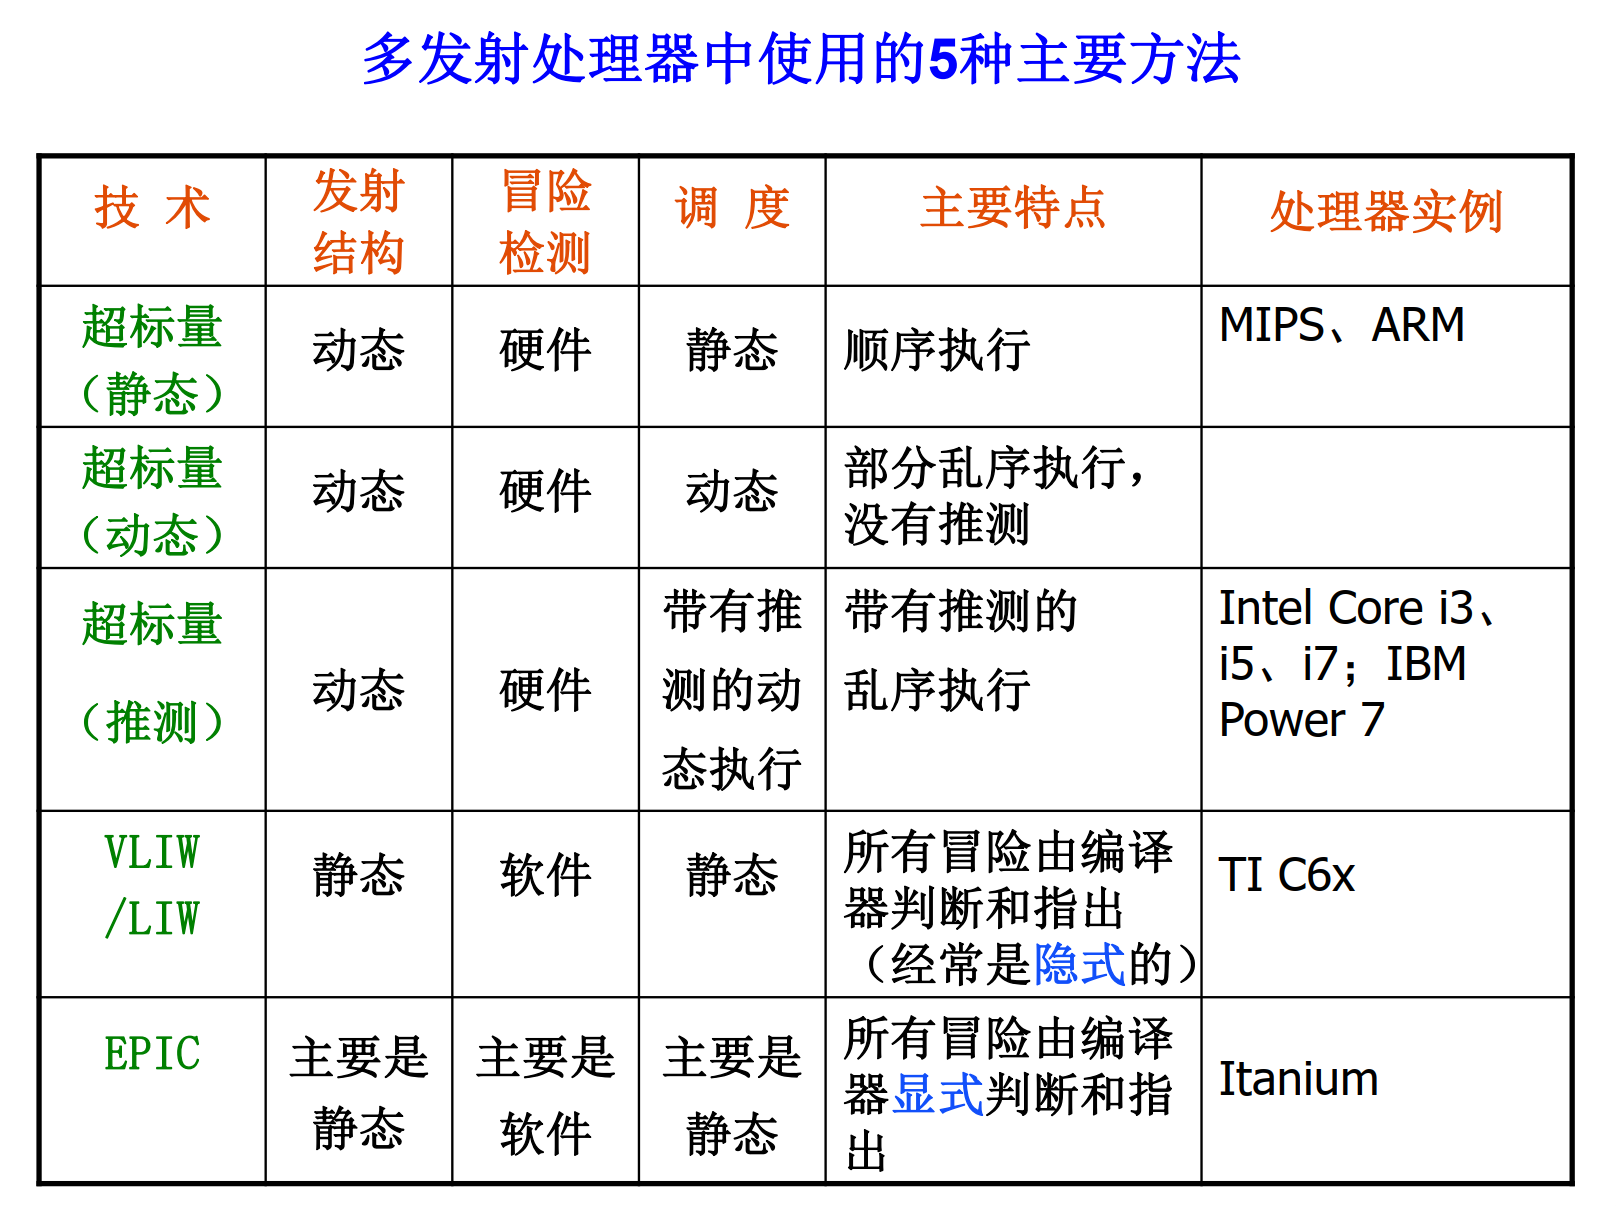
5.3.1 超标量架构
超标量处理器的核心特征是:硬件在每个时钟周期内动态地决定能发射多少条指令。发射的指令条数是不固定的(受限于硬件的最大发射宽度,如4发射或8发射),具体取决于当前的指令序列是否存在冒险。下面介绍静态的超标量架构。
以一个4发射的静态调度超标量处理器为例,其发射逻辑极其复杂。在取指阶段,流水线一次性提取1~4条指令,构成一个发射包(Issue Packet)。为了确保按序发射且无数据/结构冒险,发射部件必须在一个时钟周期内完成两阶段的冒险检测逻辑:
- 第一阶段(包内冒险检测 / Intra-packet Detection): 检查发射包内部的这几条指令之间是否存在数据依赖。例如,包内第2条指令是否使用了包内第1条指令的结果;同时还要检查包内的指令是否请求了相同的物理功能单元(结构冒险)。
- 第二阶段(包间冒险检测 / Inter-packet Detection): 将当前发射包中初步判定无内部冲突的指令,与流水线中正在执行的指令进行比对,检查是否存在 RAW 等数据冒险。
只有同时通过这两阶段检测的指令才能在当前周期被真正发射。如果包中第 \(n\) 条指令存在冒险,则只能发射前 \(n-1\) 条指令,剩余指令必须停顿到下一个周期重新尝试。
5.3.2 超长指令字(VLIW)
超标量架构的硬件冒险检测逻辑极其复杂,随着发射宽度的增加,硬件开销和功耗呈指数级上升。为了降低硬件复杂度,VLIW 架构将寻找指令级并行性(ILP)的重任完全交给了编译器(软件)。
1.VLIW的指令结构
在传统的MIPS架构中,一条指令是 32 位,只包含一个操作(比如一次加法)。在 VLIW 架构中,一条指令可能长达 128 位甚至 256 位以上。
这条极长的指令字并不是漫无目的的比特流,它在物理上被严格划分为多个固定的“操作槽(Operation Slots)”。假设一个处理器有 5 个物理功能部件(2个访存部件、2个浮点部件、1个整数部件),那么它的 VLIW 指令结构就严格包含 5 个对应的槽位:
1 | [ 访存槽1 | 访存槽2 | 浮点槽1 | 浮点槽2 | 整数/分支槽 ] |
当处理器取到这一条 VLIW 长指令时,硬件不做任何冒险检测,直接进行物理线路的“硬连线”分发——把访存槽1的控制信号直接送给访存部件1,把浮点槽1的控制信号直接送给浮点部件1。这就强制这 5 个部件在同一个时钟周期内严格并行执行。
2.如何生成VLIW指令
因为硬件不负责检测冲突,如果放在同一个 VLIW 指令里的操作有数据依赖(比如访存槽1要 Load 数据,浮点槽1就要 Add 这个数据),程序直接算错。因此,编译器的任务是:在编译代码时,找到完全没有依赖关系的指令,把它们硬塞进同一个 VLIW 指令的各个槽位中。
例如,对于目标循环 x[i] = x[i] + s,可以将其展开为
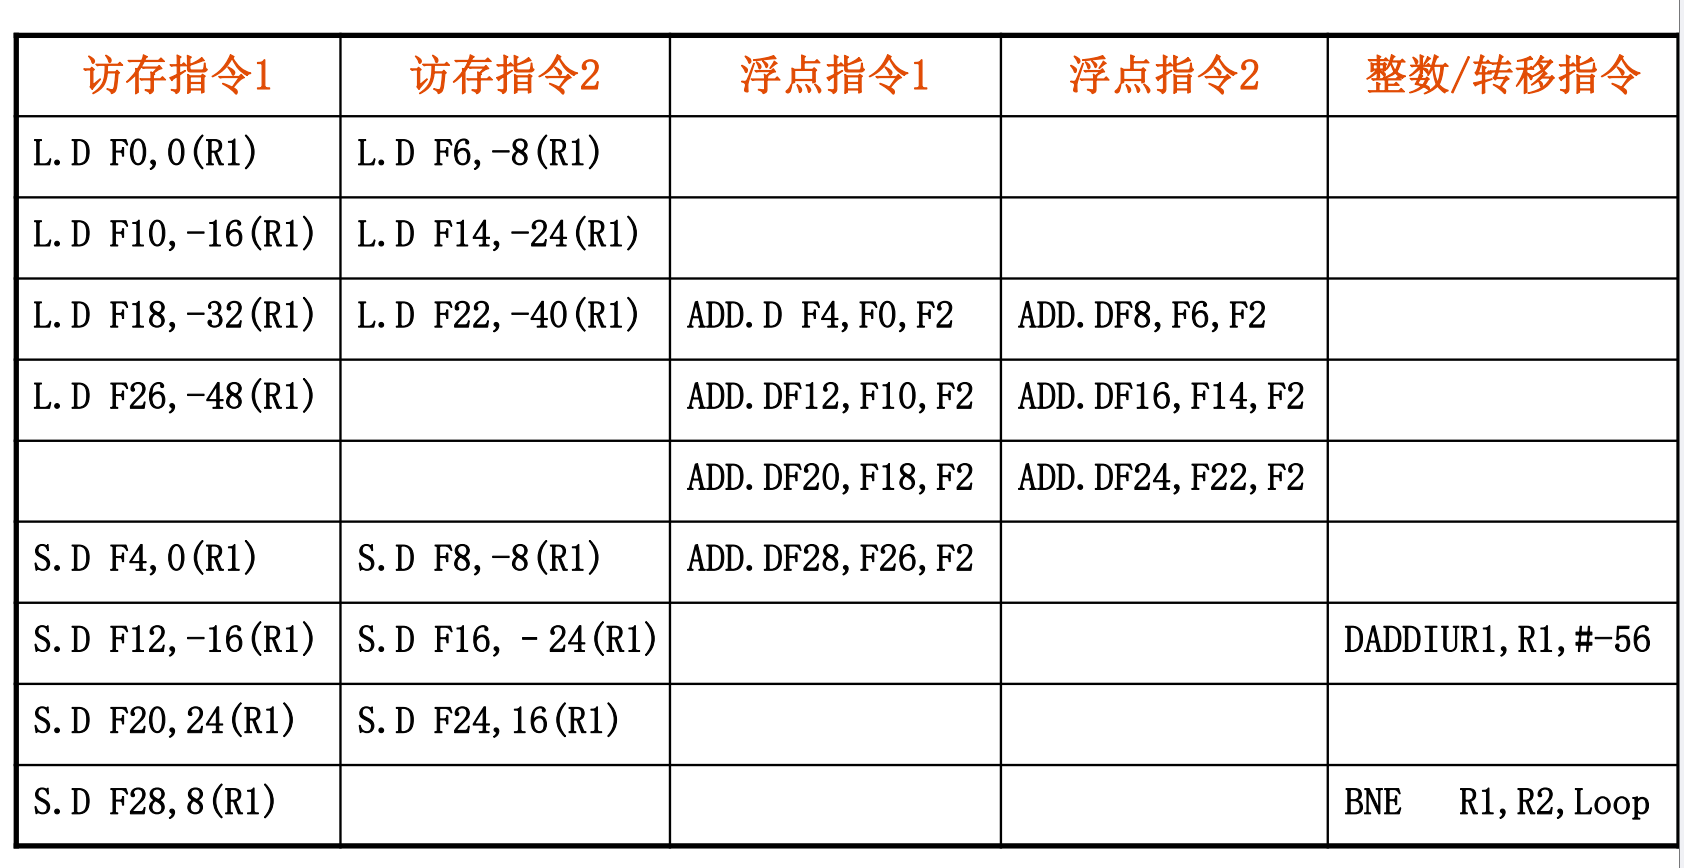
经过编译器的精妙编排,这 9 行代码(9 个时钟周期)完成了 7 次原始循环的工作,总共发射了 23 个有效子指令,期间没有发生任何数据冲突,极其高效地压榨了硬件的并发能力。
3.VLIW的缺陷
看起来 VLIW 既省了复杂的 Tomasulo 硬件调度电路,又能达到极高的并行度,为什么现在除了部分 DSP(数字信号处理器),主流的 CPU 都不用纯 VLIW 了呢?
- 代码长度暴增:正如刚才的例子,为了让 VLIW 的槽填满,编译器必须做大规模的循环展开。原本几行代码的循环,展开后变成了几十行。这导致编译出来的二进制文件体积巨大,极易耗尽指令 Cache 的容量,引发频繁的 Cache Miss,反而拉低了性能。
- 多余的位浪费:并不是所有代码都像科学计算那样有规律。如果某段代码中,无论编译器怎么努力,当前周期只能找到 1 个加法可以执行,那么 VLIW 的其他 4 个槽位就必须填入全 0 的无用编码(NOP,空操作)。这不仅浪费了宝贵的内存和缓存空间,还增加了取指令的带宽压力。一个现代的解决办法是:在内存中压缩存储,剔除 NOP,取到 CPU 译码阶段时再由硬件展开恢复。
- 死板的锁步机制:VLIW 强调同生共死。在一条 VLIW 指令中,如果“访存槽1”的 Load 操作遭遇了 Cache Miss,需要去主存拿数据(可能要停顿 100 个周期),那么即便是完全不依赖该数据的“浮点槽1”的指令,也必须陪着一起停顿。整个处理器会完全冻结。它没有动态调度那种“你卡住我先执行别人”的灵活性。
- 机器代码的向下/向上不兼容(最致命):假设第一代芯片 A 有 5 个槽。它的 VLIW 代码是按照 5 个槽的格式编译的。过了两年,芯片公司升级了架构,推出了有 8 个槽的芯片 B。此时,旧芯片 A 的二进制程序完全无法在芯片 B 上运行。因为机器码的物理位宽和字段定义彻底变了。所有的软件生态必须由开发者使用新编译器重新编译一次。这在通用计算机市场(如 Windows/PC 生态)是绝对无法被容忍的。
5.4 动态调度+多发射+推测
可以把动态调度、多发射和推测的思想结合起来,实现 ILP。
5.4.1 前提条件
假设处理器的硬件规则如下:
每个时钟周期,处理器最多只能从队列提取并发射(Issue)2条指令进入保留站。
必须严格按照代码写的顺序发射。
所有的计算(地址计算、加法、分支比较)都有独立的硬件,不会发生结构冲突。
5.4.2 要执行的指令
1 | Loop: LD R2, 0(R1) |
5.4.3 无推测VS有推测
无推测
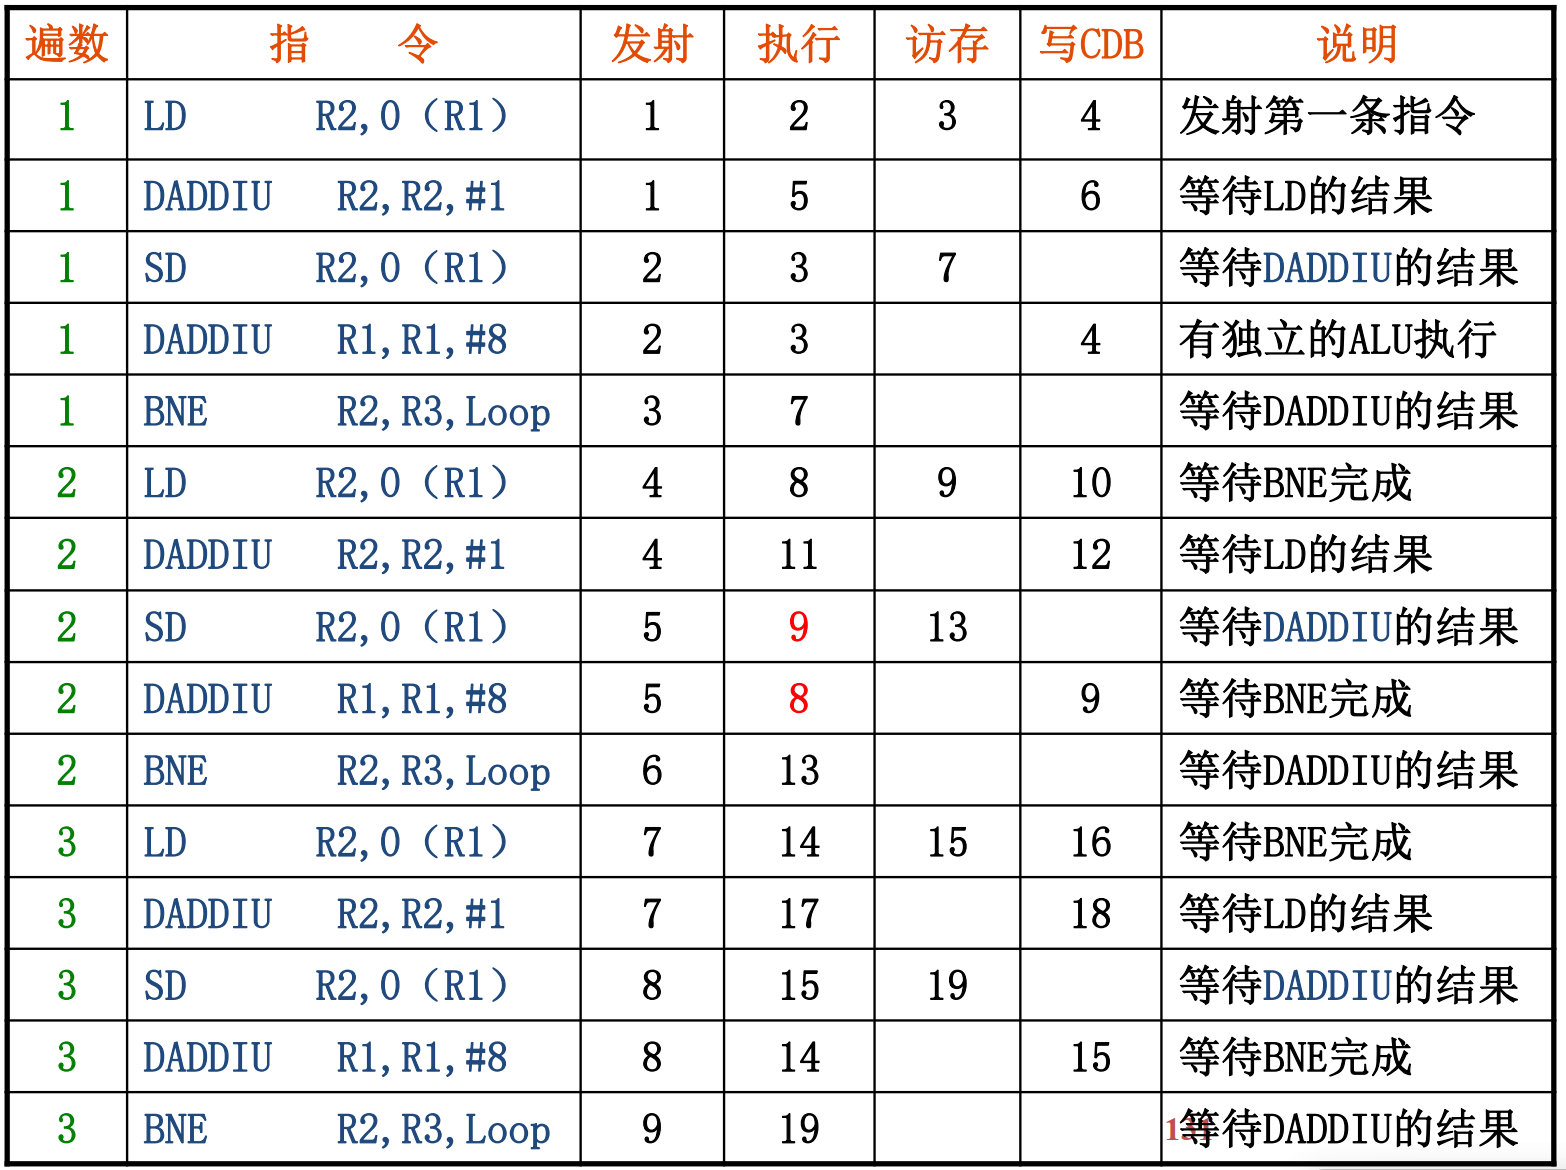
周期 4,第2次迭代的 LD 被发射进入保留站,但是直到周期 8 才能进入执行阶段。这是因为在没有推测的架构下,跨基本块的控制依赖是绝对的物理隔离墙。第 1 次迭代的 BNE 在 周期 7 才执行完毕,得出到底跳不跳转的结论(这里是需要跳转的),因此第 2 次迭代的 LD 才开始执行,即使所需的数据(R1)早就准备好了。
在没有推测的机器上,控制依赖导致了严重的流水线气泡。在周期 5、6、7 这三个周期里,后端的功能部件几乎都在闲置等待。
有推测
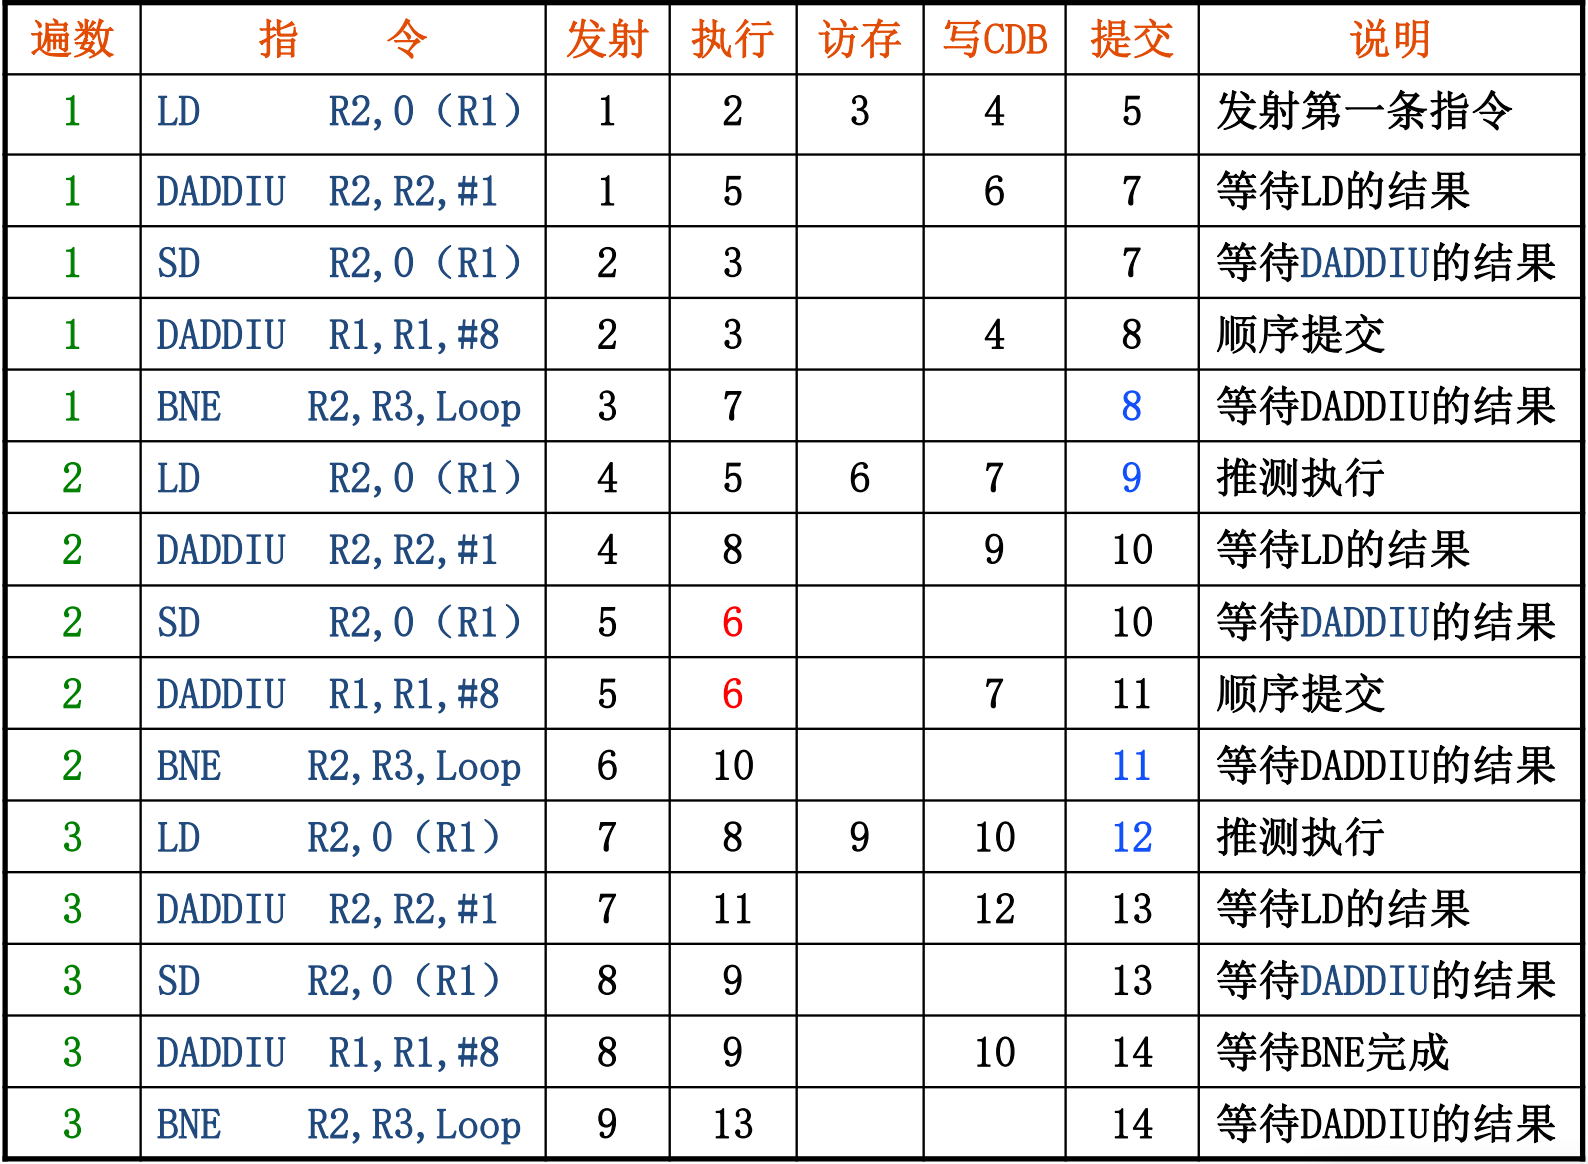
引入ROB后,
- 周期 4: 第2次迭代的 LD 被发射进入保留站和 ROB。
- 周期 5: 第2次迭代的 LD 直接开始执行,因为硬件启动了分支预测,假设 BNE 会跳转。它所需的操作数是 R1;第 1 遍的 DADDIU R1 在周期 4 已经把新 R1 写到了 CDB 上。所以,它在周期 5 立刻抓取 R1 开始计算内存地址,周期 6 访存,周期 7 写 CDB。
- 周期 5: 第2次迭代的 DADDIU R1 被发射。
- 周期 6: 第2次迭代的 DADDIU R1 直接开始执行!(因为上一次的 R1 在周期 4 就好了)。
不过,虽然第 2 次迭代在周期 5、6 就乱序执行完了,但推测可能是错的,所以结果只暂存在 ROB 中,绝对不写入真实寄存器。此时,流水线必须遵循按序提交规则。在表格的“提交”列中,
周期 5-7: 第 1 次迭代的 LD、DADDIU R2 依次安全提交。
周期 8: 第 1 次迭代的 DADDIU R1 和 BNE 提交。在这一刻,硬件最终确认分支预测是正确的!
周期 9: 既然周期 8 确认了预测正确,那么一直在 ROB 里憋着、早在周期 7 就已经算完并把结果放在 CDB 上的第 2 次迭代的 LD,终于在周期 9 被允许提交(将其临时结果正式写入物理寄存器 R2)。
6 指令提取带宽与BTB技术
6.1 痛点
在多发射超标量架构中,处理器每周期需要从指令Cache中提取4到8条指令。由于基本块(Basic Block)的平均长度通常只有5到6条指令,这意味着在每一个取指周期内,处理器几乎必然会遇到至少一条分支指令。
只要遇到分支指令,下一条该取什么指令就成了未知数。如果等待分支方向和目标地址在后续流水级(如EX段或ID段)计算出来,取指阶段将出现严重的阻塞(Fetch Stall),导致后端强大的多发射功能部件无指令可执行(Starvation)。
因此,必须在取指(IF)的同一周期,不仅预测出分支是否跳转,还要直接提供跳转的目标PC值,实现“零周期延迟”的指令流拼接。
6.2 BTB:分支目标缓冲区
为了实现“零周期延迟”的跳转,体系结构引入了专门的硬件结构——分支目标缓冲区(Branch-Target Buffer, BTB 或 Branch-Target Cache)。
6.2.1 BTB 的物理结构
BTB 本质上是一个采用硬件关联查找的高速缓存表,其每一项至少包含两个关键字段:
- 地址标识(Tag): 记录曾经执行过且发生过跳转(Taken)的分支指令的PC地址。
- 预测的分支目标地址(Target PC): 记录该分支指令上一次跳转的目标地址。
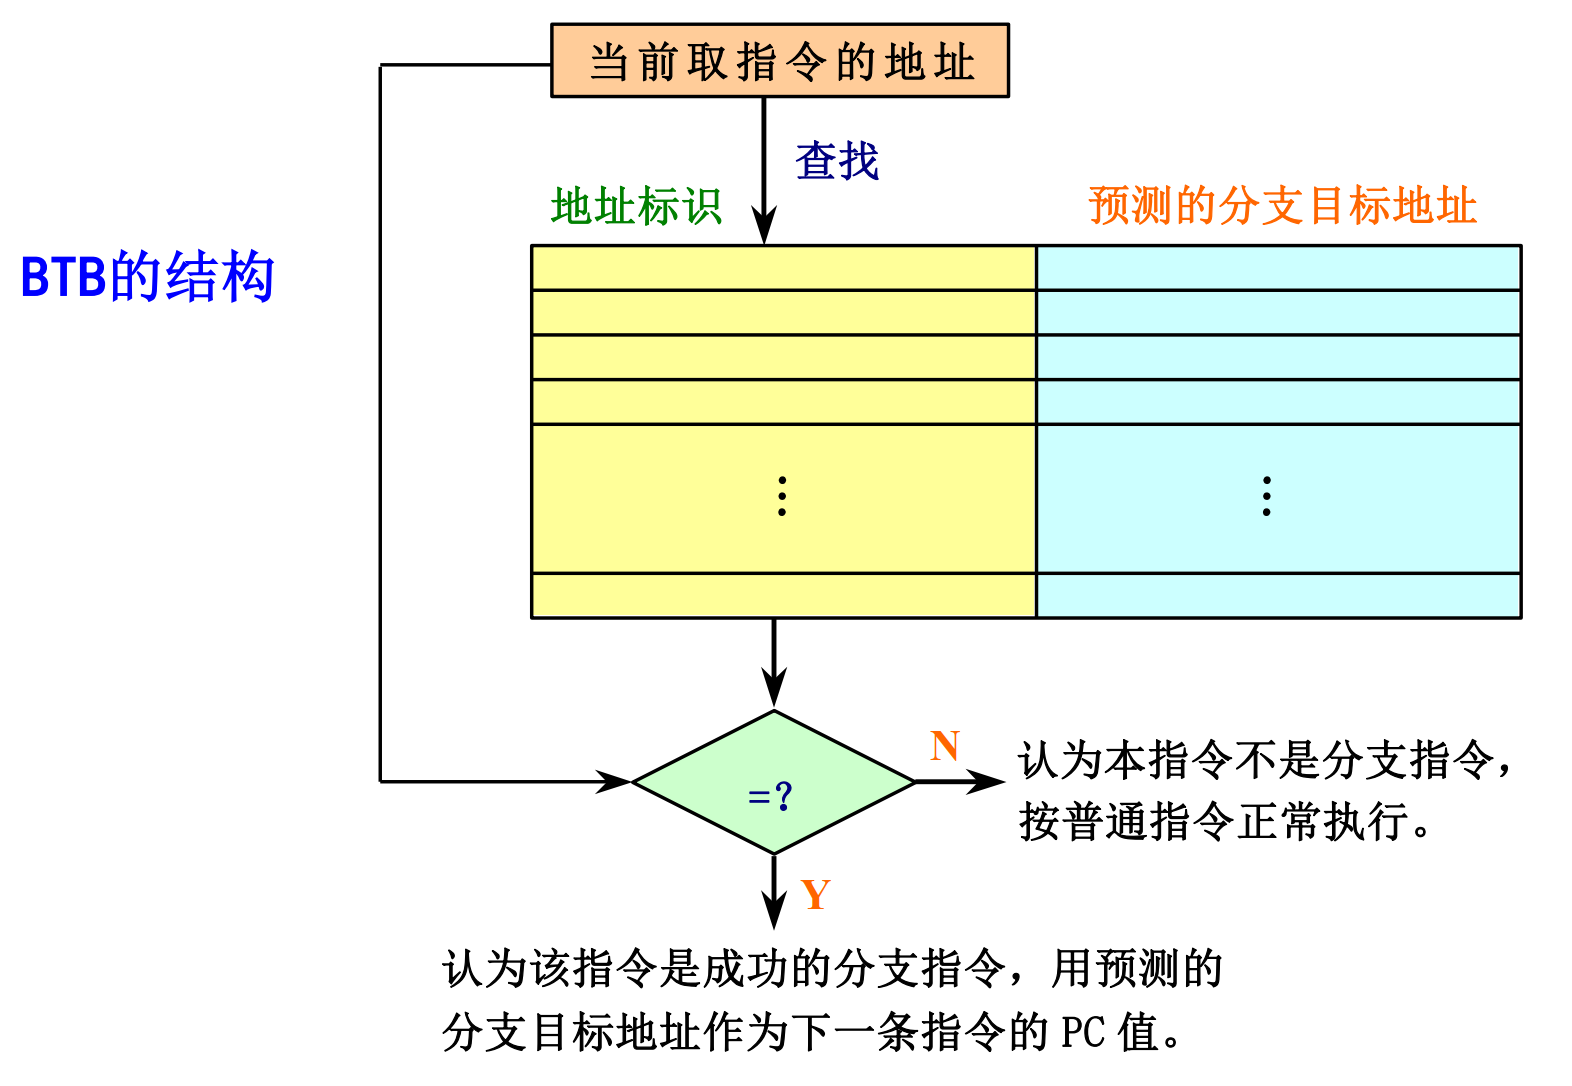
6.2.2 BTB 的工作机制
- 在IF(取指)阶段,处理器用当前的PC值去取指令Cache的同时,并行地将该PC值送入BTB进行匹配。
- 如果匹配命中(Hit): 硬件假定当前正在提取的这条指令是一条分支指令,且预测它会跳转。BTB直接将其记录的“预测目标地址”送入PC寄存器。这样,在下一个时钟周期,处理器就可以直接从目标地址继续取指。
- 如果未命中(Miss): 硬件将其视为普通顺序指令(或预测不跳转的分支),PC正常递增(PC + 4),按顺序提取下一条指令。
6.3 BTB 在五级流水线中的流转
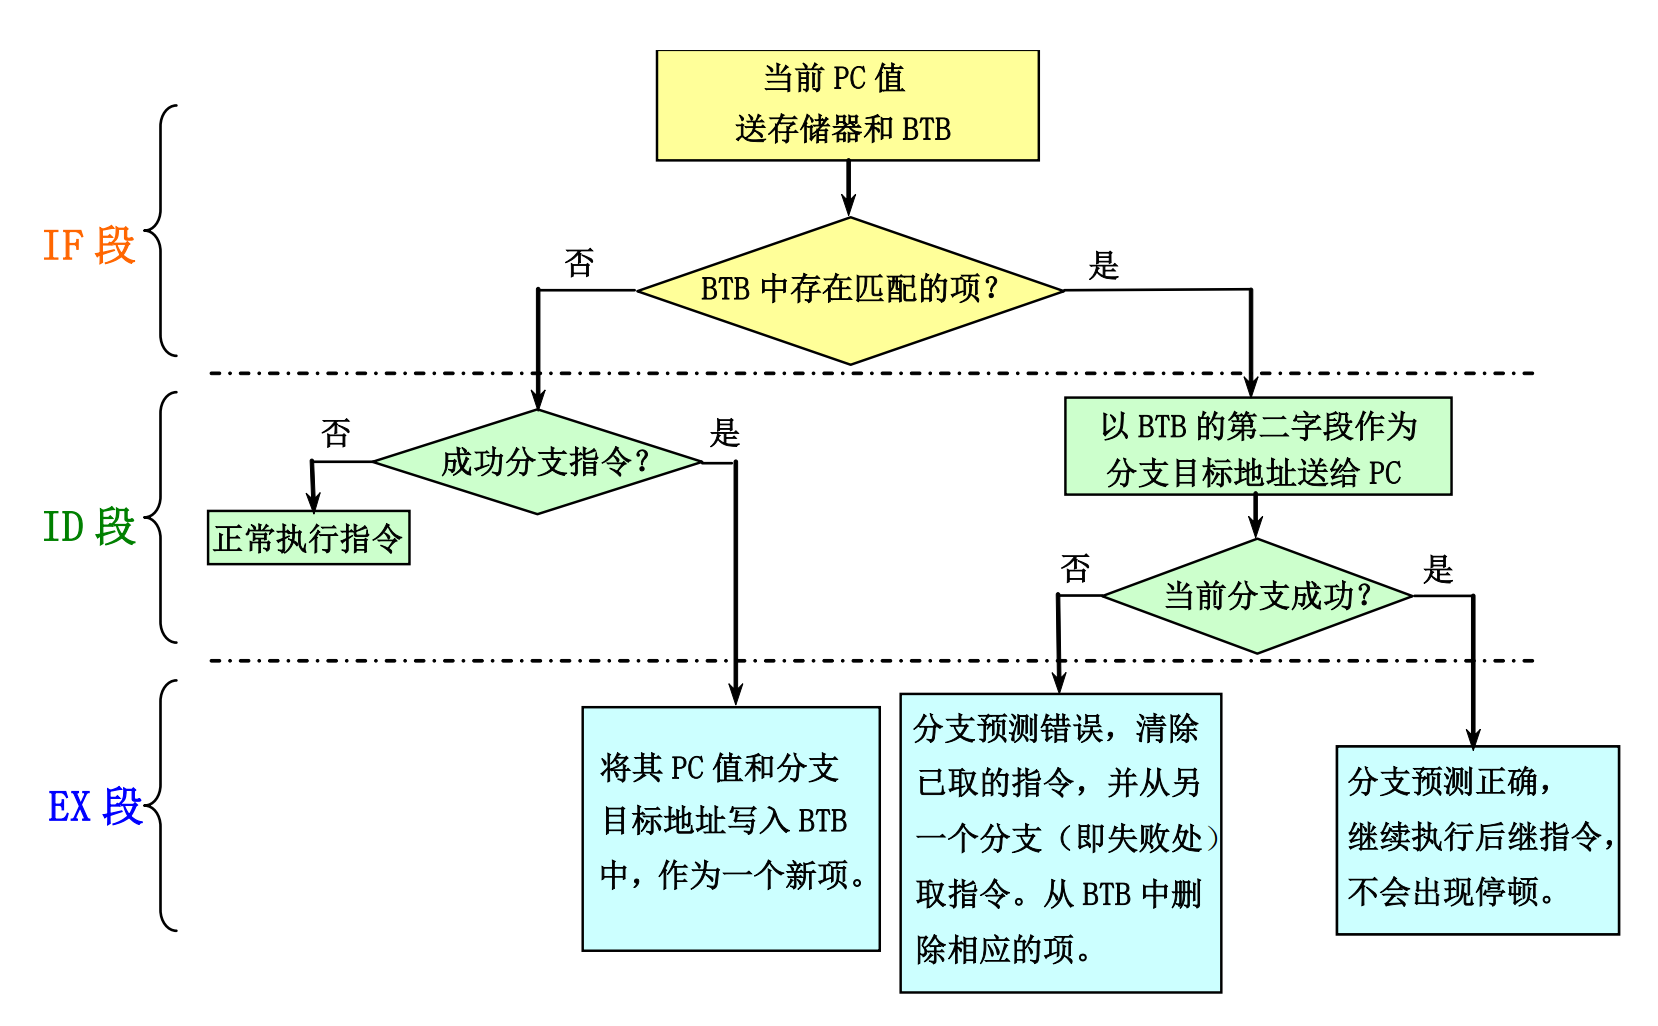
因为BTB的预测是在 IF 段极早期进行的,此时处理器甚至还没对指令进行译码(不知道它到底是不是分支指令),所以必须在后续流水级进行验证与修正。
- IF 段(推测发起): PC送入BTB。若命中,更新PC为目标地址;若未命中,PC正常递增。
- ID 段(指令验证): 对取到的指令进行译码。
- 如果此前BTB命中了,但译码发现这根本不是一条分支指令(只是普通指令的PC碰巧和BTB里的残留Tag撞车了),硬件将取消推测,恢复PC,并正常执行。
- EX 段(结果决议与BTB更新):
实际计算分支条件和目标地址。
- 预测正确: 流水线无缝继续执行,零周期停顿。
- 预测错误: 清除由于错误预测而提前提取入流水线的指令。将正确的PC送入取指段重新取指。同时,更新BTB(修改目标地址,或从BTB中删除该项)。
- 未命中但实际发生跳转: 说明遇到了一个新的跳转分支,硬件会将其PC和计算出的目标地址作为一个新项写入BTB。
7 压榨CPU的极限:多线程技术与真实CPU案例
在此之前,我们所有的努力(流水线、分支预测、动态调度、多发射)都是为了最大程度地让指令并行。但到了2000年左右(如Pentium 4时代),ILP的开发遭遇了瓶颈。为了进一步提升性能,体系结构引入了线程级并行(TLP, Thread-Level Parallelism)技术。
7.1 线程的好处
进程切换需要陷入操作系统内核,保存大量的内存管理单元(MMU)状态,通常消耗成百上千个处理器周期。而硬件线程仅包含少量的处理器状态(程序计数器PC、一组物理寄存器集、栈指针等)。在处理器内部实现硬件级别的线程切换,只需要切换PC和对应的寄存器映射关系,开销可以降低到几个甚至零个时钟周期。
7.2 实现多线程的三种主要硬件方法
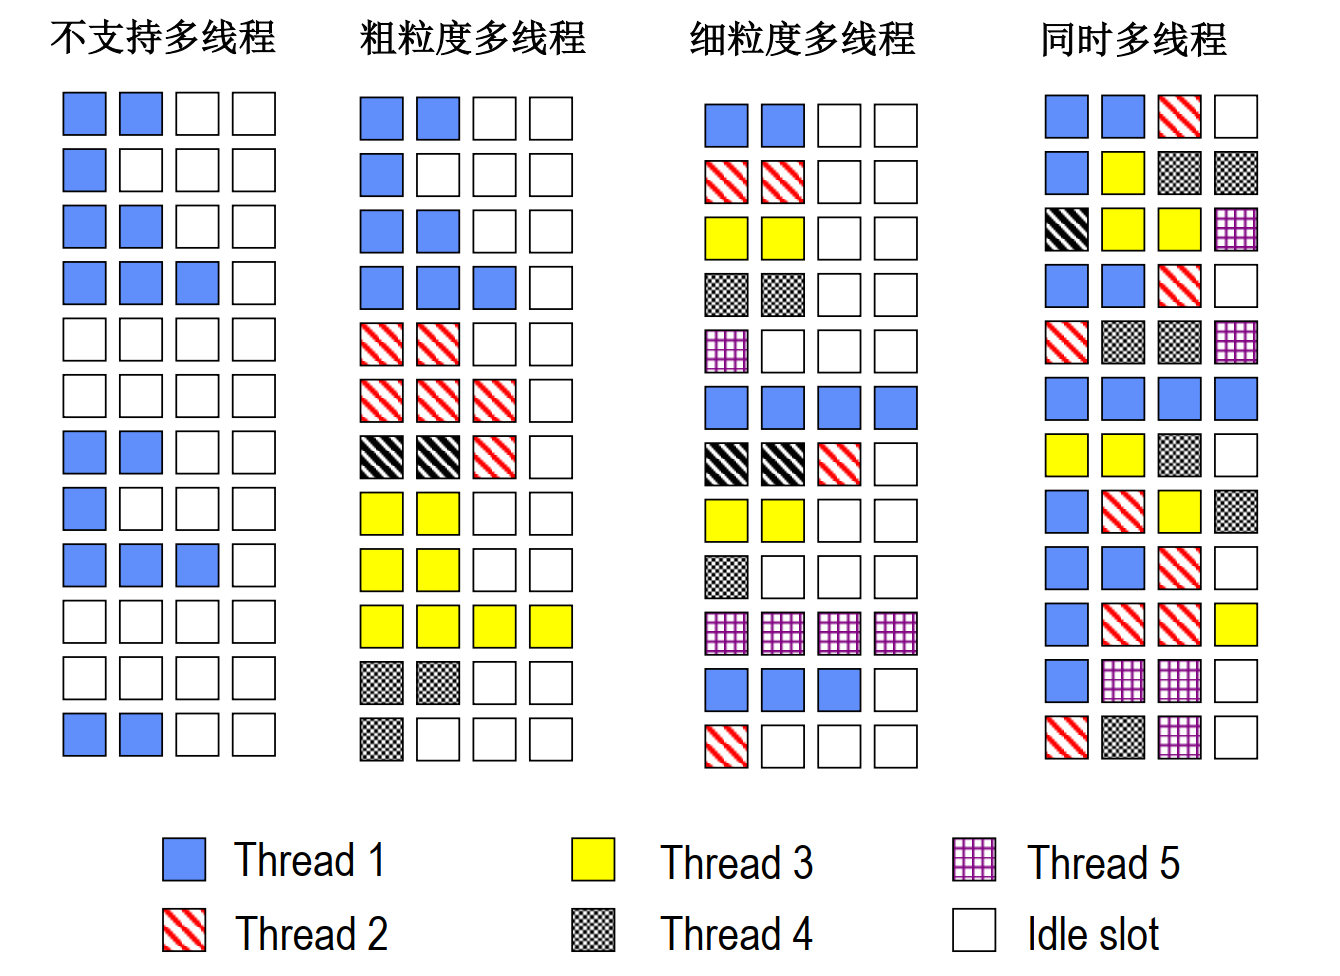
7.2.1 细粒度多线程(Fine-Grained Multithreading)
- 机制: 处理器在每个时钟周期强制进行线程切换(通常基于时间片轮转调度算法)。如果某个线程遇到停顿(如Cache Miss或数据依赖),硬件调度器会直接跳过该线程。
- 优点: 能够彻底掩盖长周期停顿(访存延迟)和短周期停顿(指令间数据冒险)导致的吞吐率损失。
- 缺点: 严重牺牲了单线程的执行延迟(Latency)。因为即便某个线程完全没有停顿,它也必须等待其他线程轮转完毕后才能再次获得发射权,导致单个线程的完成时间被大幅拉长。
7.2.2 粗粒度多线程(Coarse-Grained Multithreading)
- 机制: 处理器默认连续执行同一个线程,只有当当前线程遭遇长延迟事件(如L2 Cache Miss)时,才会触发线程切换。
- 优点: 不会降低单线程在无停顿状态下的执行速度。
- 缺点: 无法掩盖短周期的流水线停顿。更致命的是流水线排空开销(Pipeline Drain Overhead):当发生线程切换时,处理器必须排空或暂停当前流水线中残留的旧线程指令,新线程需要重新填充流水线建立执行流,这会导致若干个完全空闲的时钟周期。
7.2.3 同时多线程(Simultaneous Multithreading, SMT)
- 机制: 这是多发射超标量架构与多线程技术的终极融合(Intel称之为超线程 Hyper-Threading)。它允许在同一个时钟周期内,将来自多个不同线程的指令同时发射到处理器的流出槽(Issue Slots)中。
- 底层支撑: SMT 强依赖于我们之前学习的寄存器重命名和动态调度(Tomasulo)机制。硬件通过为不同线程分配独立的逻辑寄存器堆,并映射到共享的庞大物理寄存器池中,使得多线程指令可以混合进入保留站,由动态调度硬件统一进行无冲突的数据流分发。
7.2.4 发射槽利用率对比
我们可以用垂直浪费(Vertical Waste)和水平浪费(Horizontal Waste)来严谨地评估发射槽的使用效率。
- 垂直浪费: 若干个时钟周期没有任何指令发射
- 水平浪费: 在一个时钟周期内,多发射能力(如4发射)没有被填满
8 总结与未来
理想情况下的研究表明,如果有无限的寄存器、完美的预测和缓存,ILP可以达到单周期发射18-150条指令。但在真实的受限硬件模型(有限ROB、物理寄存器和有限预测率)下,大幅增加发射宽度(如超过4发射或8发射),硬件的复杂度、功耗和时钟周期延迟将呈现非线性爆炸式增长,而性能的提升幅度却微乎其微。
在开发ILP的道路走到尽头后(以高功耗、低能效的 Pentium 4 为标志结束),从 2005 年开始,主流处理器制造商全面转向了多核架构(Multicore),将设计重点从“压榨单线程指令级并行(ILP)”彻底转向了“开发多线程/任务级并行(TLP)”。