数据级并行-量化第4章
0. 内容概览
0.1 章节结构
第 1 节:数据级并行的研究动机:ILP 的瓶颈、DLP 的应用背景、SIMD 的基本思想。
第 2 节:向量体系结构:向量处理模型、标量/向量处理区别、向量超级计算机、向量处理机组成。
第 3 节:向量执行、链接与性能评估:多体交叉存储、链接技术、护航指令组、钟鸣、启动时间。
第 4 节:向量体系结构中的关键优化问题:多车道、VLR、条带挖掘、向量遮罩、步幅访问、集中-分散访问、性能指标。
第 5 节:面向多媒体应用的 SIMD 指令集扩展:MMX、SSE、AVX、AVX-512,以及 DXPY/DAXPY 类例子。
第 6 节:Roofline 可视化性能模型:运算密度、存储器带宽上限、峰值浮点性能上限。
第 7 节:图形处理器 GPU 与 SIMT:CPU/GPU 差异、SISD/SIMD/SPMD、CUDA 编程模型。
第 8 节:GPU 条件分支与分支发散:warp、mask、SIMT stack、branch divergence、reconvergence。
第 9 节:检测与增强循环级并行:循环间相关、仿射下标、GCD 测试、约简。
第 10 节:交叉问题:DLP 能耗优势、显存带宽、步幅访问与 TLB 缺失。
第 11 节:补充资料来源:CUDA、GPU 访存、RISC-V Vector 等补充资料。 ## 0.2 基本术语
- DLP:数据级并行,即同一种计算对大量数据同时做。
- SIMD:一条指令处理多个数据元素。
- SIMT:程序员写线程,GPU 硬件把线程组成 warp,以类似 SIMD 的方式执行。
- 车道 lane:并行处理向量/SIMD 元素的一条硬件通道。
- VLR:向量长度寄存器,控制本次向量操作实际处理多少元素。
- MVL:最大向量长度,硬件一次最多能处理的向量元素数。
- 链接 chaining:相关向量指令之间按元素流水重叠执行。
- 分支发散:同一 warp 内线程走不同分支,GPU 只能用 mask 分批执行,导致部分 lane 空闲。
- 循环间相关:后一次迭代依赖前一次迭代产生的数据,是循环并行化的主要障碍。
1. 数据级并行的研究动机
1.1 传统指令级并行(ILP)的瓶颈
传统提高性能的方法主要依靠挖掘指令级并行,例如更深流水线、超标量发射、乱序执行、分支预测、提高主频、提高 Cache 命中率等。但这些方法存在明显限制:
- 程序本身未必有足够的指令级并行。
- 主频提高会加重分支、数据冒险和结构冒险带来的 CPI 损失。
- 每周期取出并译码多条复杂指令并不容易。
- 科学计算、图像/视频/语音、机器学习等应用往往处理大规模数组或连续媒体流,数据局部性不一定好,单靠 Cache 难以充分提升性能。
因此,体系结构开始更重视数据级并行(Data-Level Parallelism, DLP),即对许多不同数据执行相同或相似操作。
1.2 数据级并行适合的应用
数据级并行适合图形处理、机器视觉、语音识别、机器学习、矩阵计算、天气预报、工业仿真、生物信息学等应用。它们的典型特点:
- 数据量大。
- 单个数据元素之间相关性弱。
- 同一条计算规则可以作用在很多数据元素上。
- 计算密度高时,特别适合使用向量处理器、SIMD 扩展或 GPU。
1.3 SIMD 的基本思想与优势
SIMD(Single Instruction, Multiple Data)表示“单指令,多数据”:一条指令同时作用于多个数据元素。其主要优势:
- 每组数据操作只需取指一次,降低取指和译码能耗。
- 同一控制流驱动多个执行部件,硬件控制开销小。
- 程序员或编译器可以保持类似顺序程序的思维,同时获得并行加速。
- 对移动设备和高性能计算都具有较高能效。
这里涉及 SIMD 的三种主要形态: - 向量体系结构。 - 面向多媒体应用的 SIMD 指令集扩展。 - 图形处理单元 GPU,其执行模型常称为 SIMT。
2. 向量体系结构
2.1 向量处理模型
向量体系结构从存储器中取出一组数据元素,将它们放入大型顺序向量寄存器中,再对向量寄存器中的元素执行操作,最后将结果写回存储器。
一条向量指令可以表示几十个甚至上百个“寄存器-寄存器”元素操作。
向量寄存器相当于由编译器控制的高速缓冲区:
- 可以隐藏存储器访问延迟。
- 可以集中利用存储器带宽。
- 可以明确告诉硬件这些元素之间通常互不相关。
2.2 标量处理与向量处理的区别
- 标量指令一次只处理一个或一对操作数,例如
add r3, r1, r2。 - 向量指令一次处理 N 个或 N 对操作数,例如
add.vv v3, v1, v2,表示对两个向量中对应位置的元素逐个相加。 - 向量处理机的核心思想是:用更高层次的指令表达更多计算,减少指令数量,并让硬件流水线持续处理元素流。
2.3 向量超级计算机的发展
- 20 世纪 70-80 年代,超级计算机几乎等同于向量机。
- CDC 6600 通常被认为是第一台超级计算机:60 位字长;多个功能部件;使用记分牌进行动态调度;主要面向科学计算和大型数值任务。
- Cray-1(1976)是典型向量超级计算机:标量单元加向量扩展;Load/Store 结构;向量寄存器;向量指令;深度流水化功能部件;多体交叉存储系统;没有数据 Cache,也不支持虚拟存储器。
- NEC SX 系列代表现代向量超级计算机:具有标量乱序/超标量单元;具有多个向量寄存器、向量功能部件和高带宽存储系统;通过多车道和共享内存结构提升峰值性能。
2.4 向量处理机的基本特性
- 一条向量指令包含多个元素操作,因此减少指令取指次数。
- 同一向量中各元素的结果通常相互独立,适合深流水线执行。
- 编译器负责保证向量内部操作之间没有相关性,硬件主要检测不同向量指令之间的相关性。
- 向量指令往往按照已知模式访问存储器:
- 连续访问(unit-stride)。例如
A[0], A[1], A[2], A[3]。 - 固定步幅访问(strided access)。例如
A[0], A[2], A[4], A[6]。 - 索引访问(gather/scatter)。访问地址不是简单连续,也不是固定间隔,而是由另一个索引数组决定。例如
A[K[0]], A[K[1]], A[K[2]], A[K[3]],而K = [3, 10, 2, 99]。
- 连续访问(unit-stride)。例如
- 已知访问模式可以更好地发挥多体交叉存储器带宽,并减少控制相关。
2.5 存储器-存储器型与寄存器型向量机
- 存储器-存储器型向量机。所有向量操作的操作数都来自存储器,结果也直接写回存储器。早期机器如 CDC Star-100、TI ASC 属于此类。缺点是需要极高存储器带宽,多个向量操作之间重叠困难,而且启动时间较长。
- 寄存器型向量机。除 Load/Store 外,向量操作在向量寄存器之间进行。Cray-1 是第一台典型寄存器型向量机,1980 年以后主流向量处理机多采用这种结构。
对于 C=A+B 这个运算,存储器-存储器型可用
ADDV C,A,B 直接计算 C=A+B,但寄存器型需要
LV V1,A、LV V2,B、ADDV V3,V1,V2、SV V3,C四条指令。虽然寄存器型指令数可能更多,但能复用已经装入寄存器的数据,降低存储器压力。
2.6 向量指令集的优势
- 格式紧凑。一条指令表达 N 个操作。
- 表达能力强。向量指令告诉硬件:
- 元素操作之间无相关。
- 使用同类功能部件。
- 访问不相交寄存器或规律存储器地址。
- 可使用连续、步幅或索引访问方式。
- 可扩展性好。同一段向量代码可以运行在不同数量的并行流水线或车道(lanes)上。
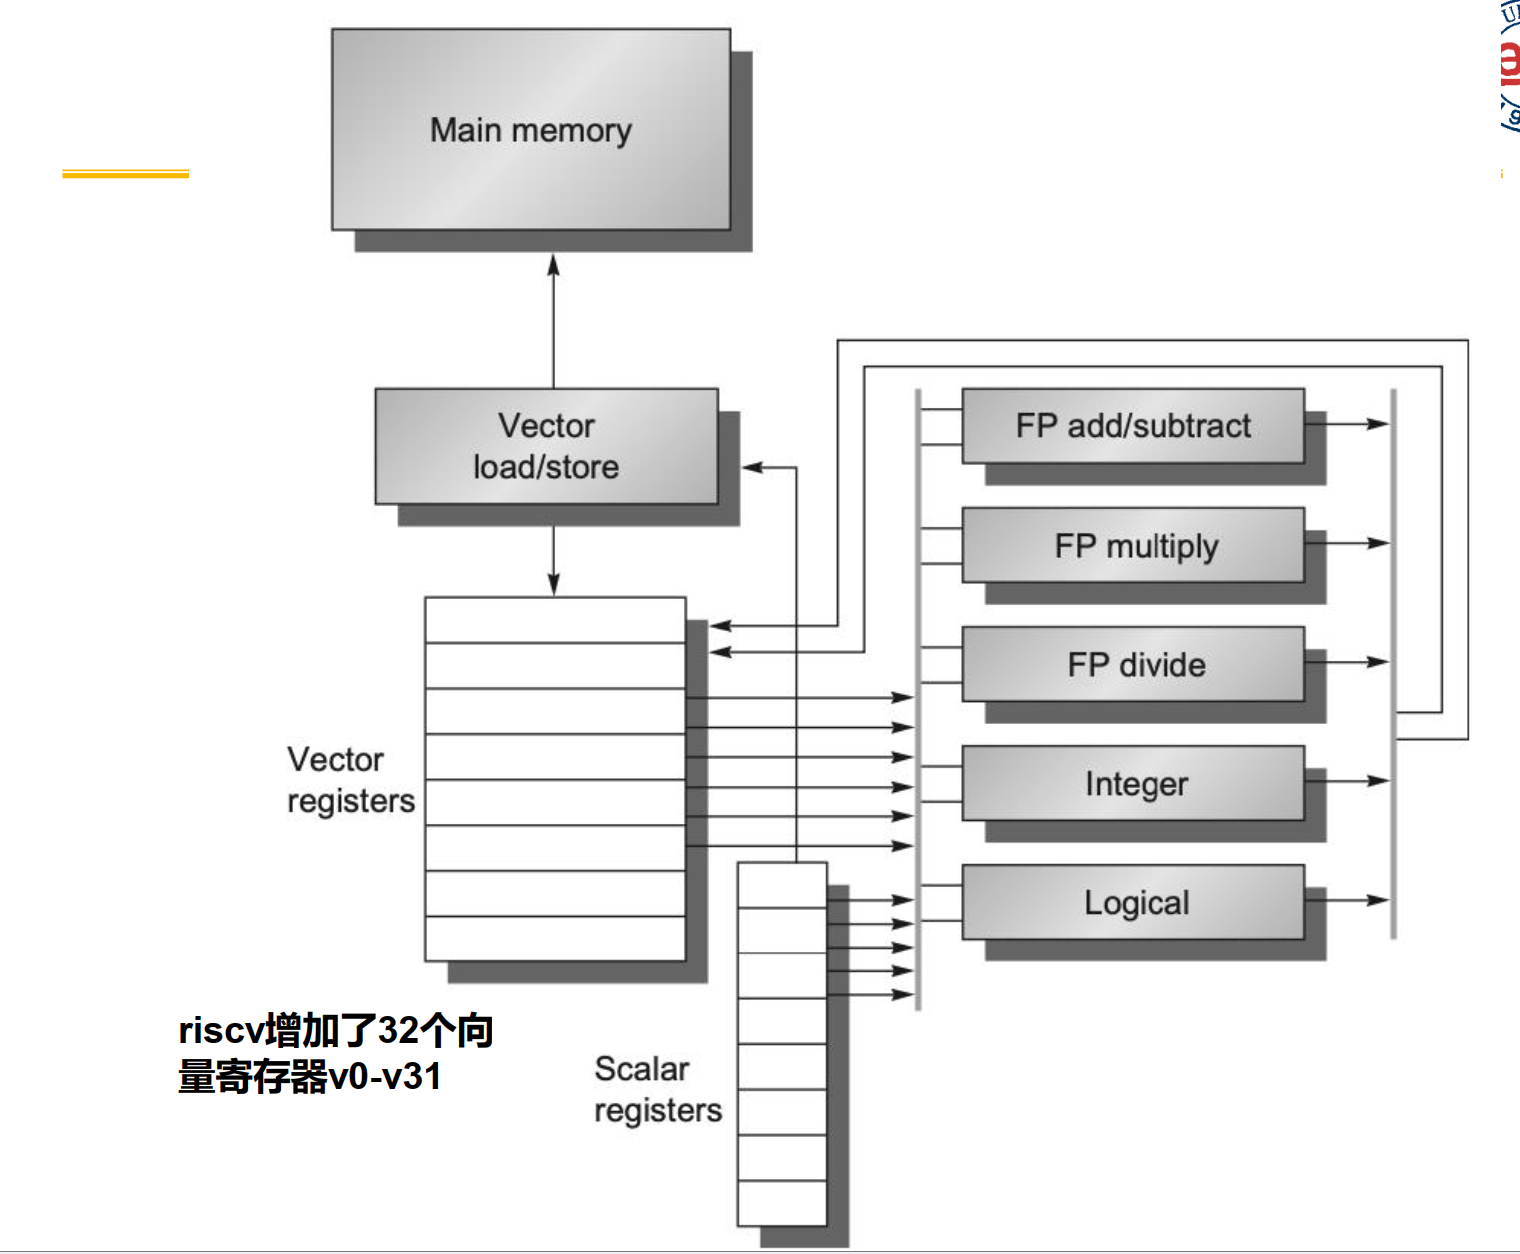
RISC-V 向量扩展也采用向量寄存器思想,提供 32 个向量寄存器
v0-v31,并通过vl等配置控制本次向量操作的实际元素数。
2.7 向量处理机的基本组成
向量寄存器(Vector Register)。是一个长度固定的区域,用于存放一个向量,通常有多个读端口和写端口。例如,VMIPS 有 8 个向量寄存器,每个寄存器包含 64 个 64 位元素。
向量功能部件(Vector Functional Units, FUs)。是全流水化的,每个时钟周期可以启动一个新元素操作。常见功能包括浮点加、浮点乘、倒数、整数加、逻辑、移位等。一般会有 4-8 个 FU,包含浮点加法、浮点乘法、浮点倒数(1/X)、整数加法、整数逻辑运算、整数移位运算等功能。
向量 Load/Store 单元(LSUs)。负责全流水化地装入或存储向量,高性能机器可能配置多个 LSU。
标量寄存器(Scalar Register)。存放单个元素、常数或地址。用于向量-标量操作,例如
Y = a * X + Y中的标量a。互连结构。常用交叉开关连接功能部件、Load/Store 单元和寄存器堆。交叉开关就是向量处理机内部连接寄存器、功能部件和访存单元的数据交换网络,用来灵活搬运操作数和运算结果。比如有两条指令
V3 = V1 + V2,V5 = V4 * V6,交叉开关可以把 V1 送到加法器输入端 1,把 V2 送到加法器输入端 2,加法器输出送回 V3;同时把 V4、V6 接到乘法器,把乘法结果送回 V5。1
2
3
4
5
6
7
8
9+-------- 加法器
V0 -----------|
V1 -----------|-------- 乘法器
V2 -----------|
V3 -----------|-------- Load/Store 单元
V4 -----------|
V5 -----------|-------- 写回寄存器
|
交叉开关
下面是一个典型的向量处理机的示意图:
3. 向量执行、链接与性能评估
3.1 向量算术执行:车道(Lane)
向量功能部件常采用深流水线,启动延迟较长。但一旦流水线填满,可以每个周期产生一个元素结果。
因为元素之间独立,向量流水线控制比普通标量深流水线简单。
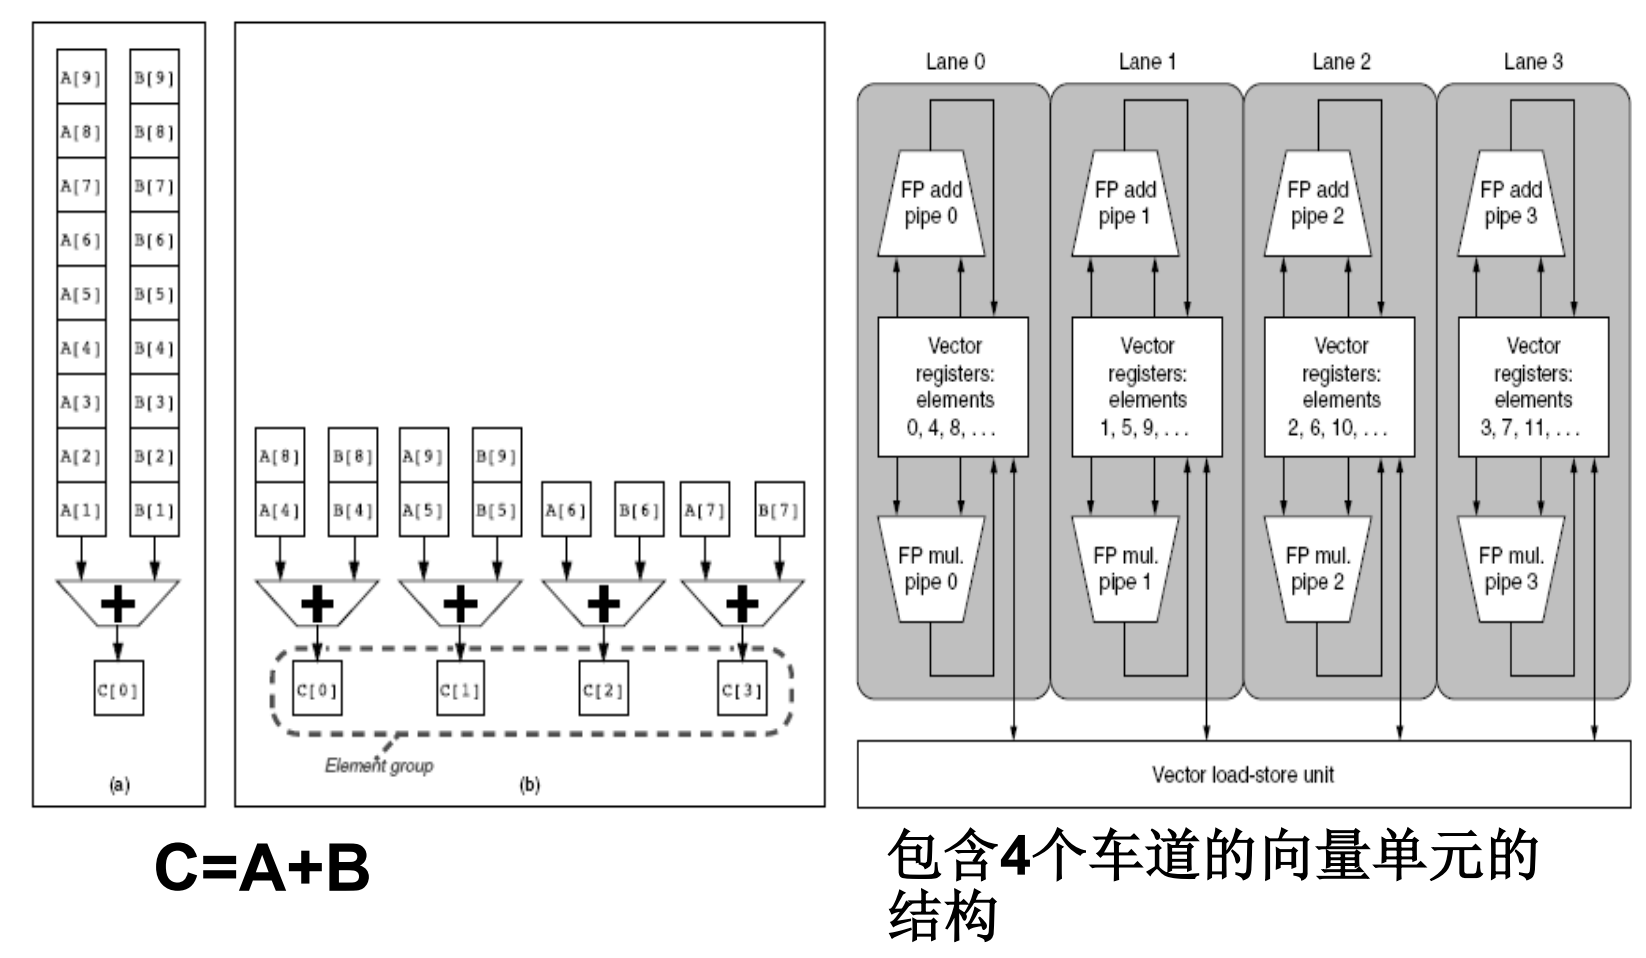
多车道结构可以在同一周期处理多个元素,例如 4 条车道可以同时处理 4 个元素。向量寄存器中的元素按车道交错分布,例如元素 0、4、8 在同一车道。
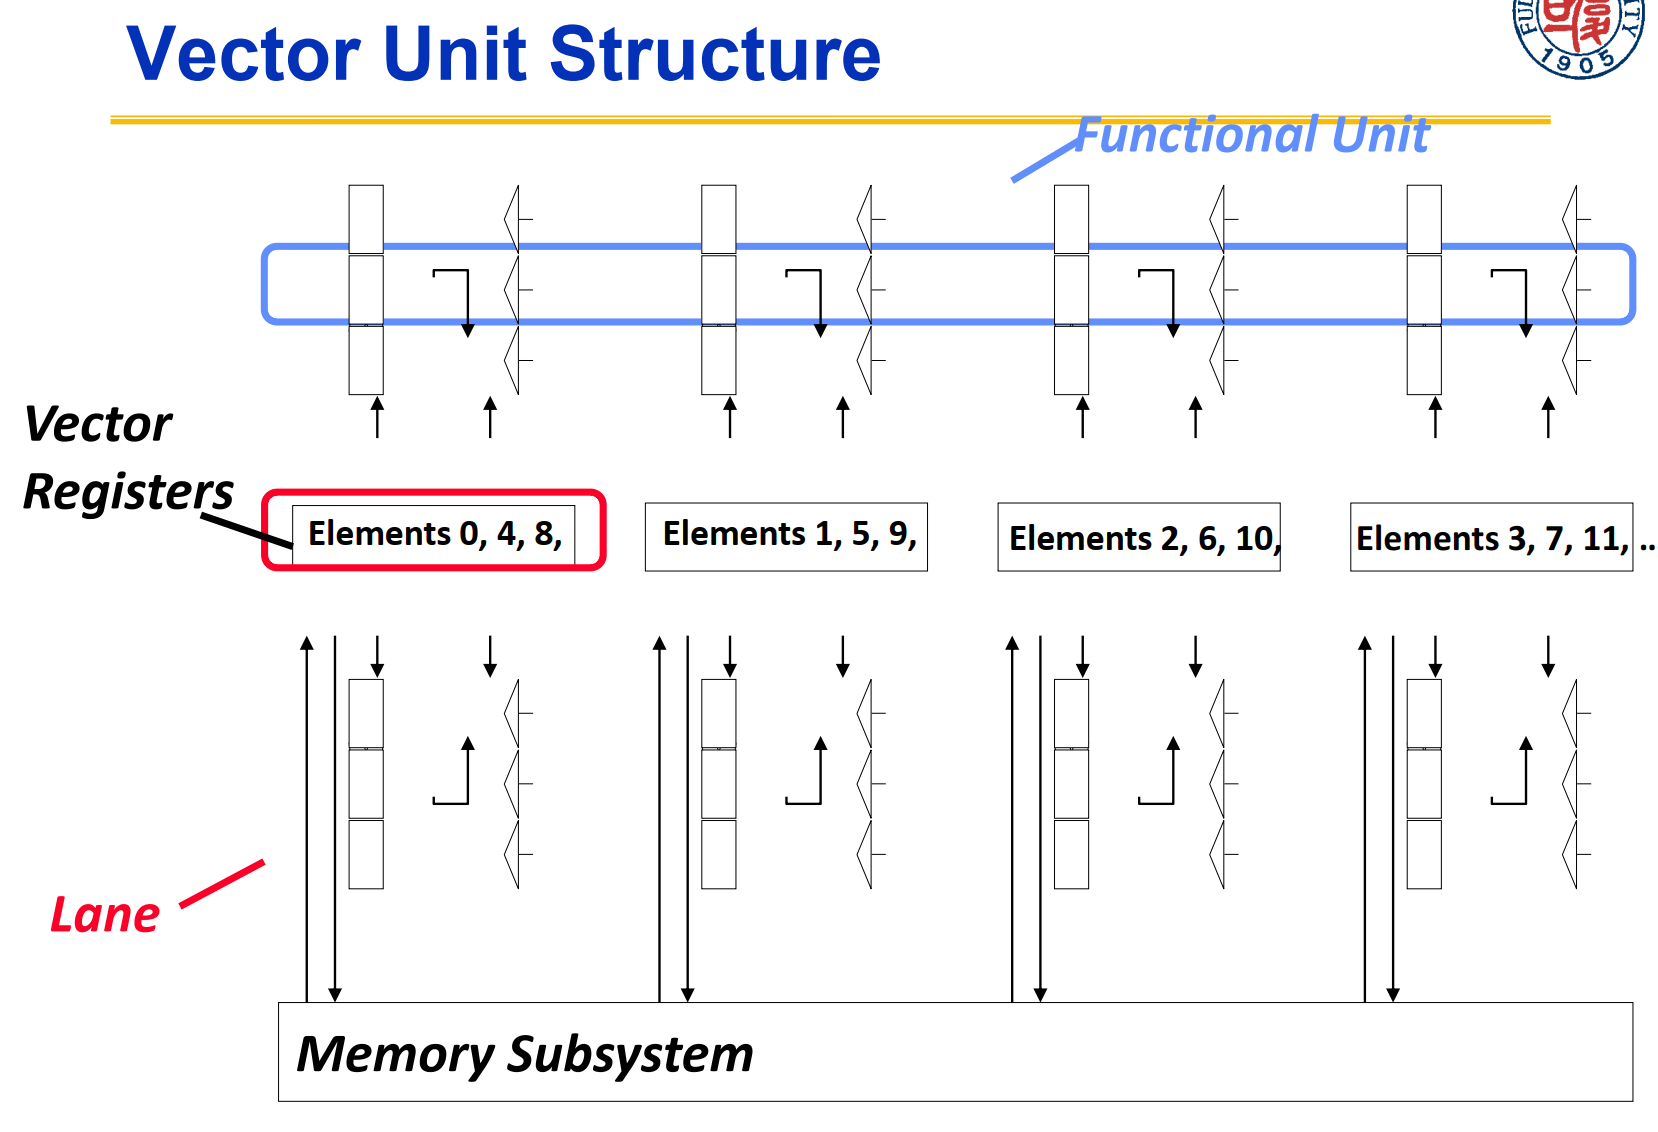
“车道”(lane)就是向量处理机 / SIMD / GPU 里并行处理向量元素的一条硬件执行通路。
可以把一条向量指令想成一批任务:
2
3
4
5
6
7
>C[0] = A[0] + B[0]
>C[1] = A[1] + B[1]
>C[2] = A[2] + B[2]
>C[3] = A[3] + B[3]
>...如果只有 1 条车道,硬件每个周期大致只能启动/处理 1 个元素:
2
3
4
>第2周期:算 C[1]
>第3周期:算 C[2]
>第4周期:算 C[3]如果有 4 条车道,就像一条公路有 4 个车道,可以同时处理 4 个元素:
2
3
4
5
6
7
8
9
10
11
>车道0:算 C[0]
>车道1:算 C[1]
>车道2:算 C[2]
>车道3:算 C[3]
>第2周期:
>车道0:算 C[4]
>车道1:算 C[5]
>车道2:算 C[6]
>车道3:算 C[7]所以,车道越多,同一条向量指令每个周期能处理的元素越多,吞吐量越高。
在向量机里,车道通常包括:
2
3
>一条或一组功能部件流水线
>到存储系统的数据通路比如这里的 “8 lanes” 可以理解为:同一条向量指令最多可以让 8 个元素并行向前流动。
一句话记忆:车道就是执行同一条向量/SIMD 指令时,用来并行处理不同数据元素的硬件通道。
3.2 多体交叉存储系统:存储体(Bank)
向量处理器需要高带宽存储系统,以支持连续的向量读写。多体交叉存储系统将存储器划分为多个 bank,不同 bank 可以并行服务访问。假设有 4 个存储体:Bank0 Bank1 Bank2 Bank3。连续地址可以交错放进去:
1 | A[0] -> Bank0 |
这样读取连续向量时,访问会轮流落到不同 bank:
1 | 第1拍:访问 Bank0 的 A[0] |
轮流访问。如果每个 bank 需要几拍才能再次接受访问,只要 bank 数足够多,就能保证流水线几乎每拍都有数据。例如 Cray-1 有 16 个 bank,bank busy time 为 4 个周期,访存延迟为 12 个周期。因为有 16 个 bank,而一个 bank 忙 4 个周期,所以连续访问时可以轮流访问不同 bank。等再次访问 Bank0 时,它已经恢复好了。
Bank conflict。当访问步幅与 bank 数存在不利关系时,可能频繁访问同一 bank,造成冲突。比如有 4 个 bank,按地址对 4 取模分配:
1 | A[0] -> Bank0 |
如果访问步幅是 4:
1 | A[0], A[4], A[8], A[12] |
它们全都落在 Bank0。这样虽然有 4 个 bank,但实际只用了 1 个,其他 bank 空着,性能会很差。
3.3 链接技术:Chaining
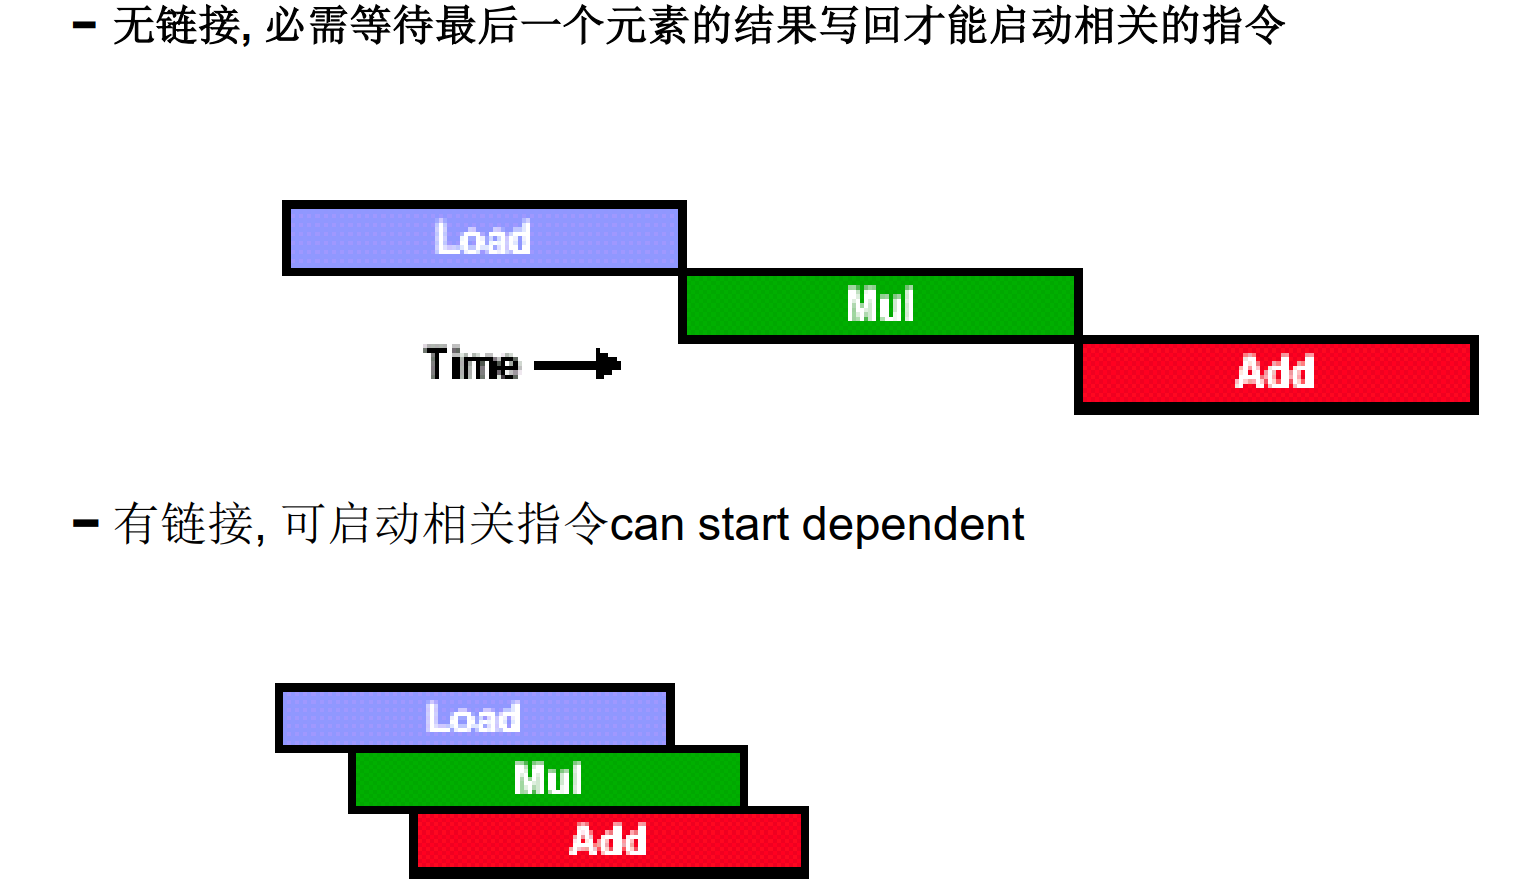
链接技术用于具有先写后读(RAW)相关的两条向量指令。其本质在于把标量流水线中的 forward 思想引入向量执行。
无链接时,后一条相关向量指令必须等待前一条向量指令最后一个元素写回。而有链接时,当前一条指令产生第一个元素结果后,后一条指令即可对该元素开始处理,从而显著缩短整个向量序列的完成时间。
3.4 链接示例
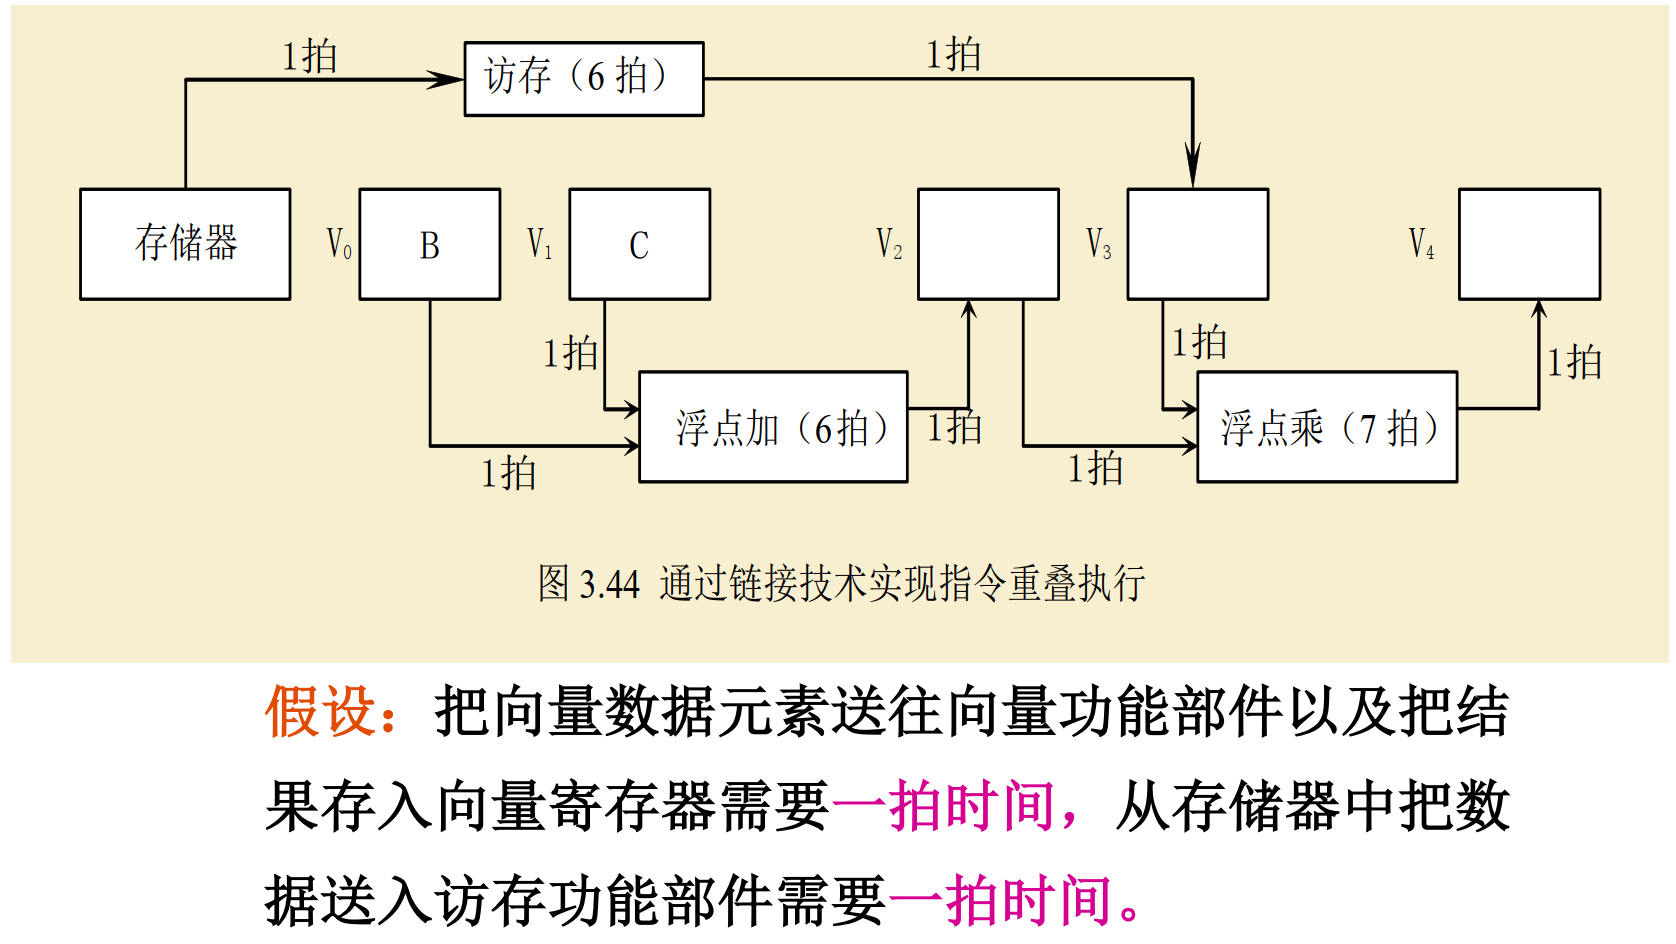
假设要计算 D = A × (B + C)。向量长度
N <= 64,B 和 C 已在
V0 和 V1 中。指令序列为:
1 | V3 <- 存储器 // 取向量 A |
下面给出三种执行方式的执行时间。
- 三条指令完全串行:\([(1+ 6+ 1)+ N- 1]+ [(1+ 6+ 1)+N- 1] + [( 1+ 7+ 1)+ N- 1] = 3N + 22\) 拍。
- 前两条并行,第三条串行:\([(1+ 6+ 1)+ N- 1] + [(1+ 7+ 1)+ N- 1]= 2N + 15\) 拍。
- 前两条并行且第三条链接执行:\([(1+6+1)] + [(1+7+1)]+(N - 1)=N + 16\) 拍。
链接执行时,第三条乘法不用等 V2 和 V3 的所有元素都算完。只要第一个 V2[0] 和第一个 V3[0] 准备好,乘法就可以开始处理第一个元素。
3.5 护航指令组与钟鸣
护航指令组(convoy)是一组可以一起执行的向量指令,组内不能有结构冒险。若存在写后读相关,通常应分到不同护航组;但如果能链接,则可以放在同一护航组中。
钟鸣(chime)是执行一个护航指令组所花费的时间单位。若向量序列由
m 个护航组组成,向量长度为
n(一次钟鸣≈n个时钟周期),在 VMIPS 中大约需要
m × n 个时钟周期(不计启动开销)。
例如计算 Y[i] = a * X[i] + Y[i],指令为:
1 | VLD V1,Rx // load vector X |
护航组排列: - 第 1 组:LV 与
MULVS.D(即前两条指令,此护航组内使用了链接技术) - 第 2
组:LV 与
ADDVV.D(即后两条指令,此护航组内使用了链接技术) - 第 3
组:SV
共 3 次钟鸣。对每个 i 来说,要做 2 次浮点运算:
1 | 第 1 次浮点运算:a * X[i] // 浮点乘法 |
所以每个结果元素包含 2 次 FLOP。总周期数 = 护航组数 * 向量长度 = 3n,总 FLOP = 2n,所以每个 FLOP 的周期数 = 3n / 2n = 1.5。
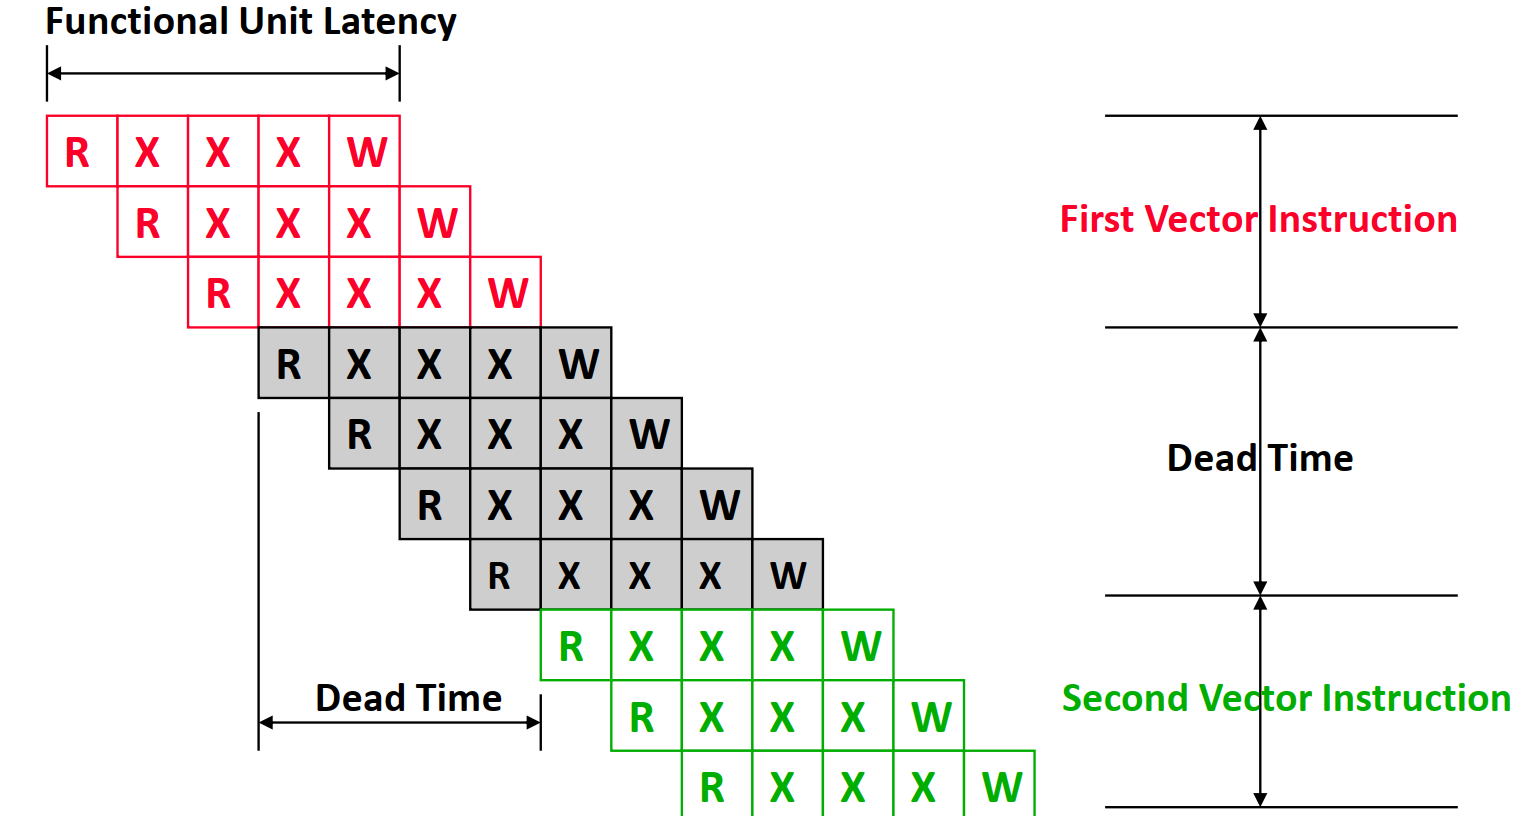
3.6 向量启动时间
向量启动时间由两部分构成: - 功能部件延时:元素通过功能部件流水线所需时间,是主要因素。 - 截止/恢复时间:下一条向量指令启动前的间隔。
启动时间使短向量性能较差;向量越长,启动开销摊得越薄。
4. 向量体系结构中的关键优化问题
4.1 多条车道(Multiple Lanes)
单个向量功能部件每周期通常只能处理一个元素。为了快于“每周期一个元素”,可以复制流水线形成多条车道。每条车道处理向量中的一部分元素,从而提高吞吐量。
多车道结构要求:向量寄存器端口足够、存储系统带宽足够、互连结构能支持多路并发传输。
4.2 向量长度寄存器(VLR)与条带挖掘
普通向量寄存器的长度通常是固定的,但程序中的向量长度通常运行时才知道,且可能大于硬件最大向量长度(MVL)。因此向量长度寄存器(VLR)被发明了出来。它控制着当前向量操作实际处理的元素数,且VLR <= MVL。Load/Store
和算术向量操作都受 VLR 控制。
条带挖掘(Strip
Mining)将任意长度向量拆成多个长度不超过 MVL
的片段。第一个片段常处理余数部分,后续片段按 MVL 满长度处理。例如:
1
2
3
4
5
6
7
8low = 0;
VL = (n % MVL); /* find odd-size piece using modulo op % */
for (j = 0; j <= (n / MVL); j = j + 1) { /* outer loop */
for (i = low; i < (low + VL); i = i + 1) /* runs for length VL */
Y[i] = a * X[i] + Y[i]; /* main operation */
low = low + VL; /* start of next vector */
VL = MVL; /* reset the length to maximum vector length */
}
执行时间计算公式:处理长度为 n 的向量,总共需要多少时间/时钟周期?
- \(T_n = ceil (\frac{n}{MVL}) × (T_{loop} + T_{start}) + n × T_{chime}\)
- \(T_n\):处理长度为 \(n\) 的整个向量所需的总时间。
- \(MVL\):最大向量长度,即硬件一次向量操作最多能处理多少个元素。
- \(T_{loop}\):每处理一个条带时,循环控制本身带来的开销。
- \(T_{start}\):每处理一个条带时,向量指令启动开销的总和。
- \(T_{chime}\):每个元素在稳定流水状态下的执行时间。如果一个向量循环需要若干个护航组,每个护航组大致每个元素 1 拍,那么 \(T_{chime}\) = 护航组数量。
示例:A = B × s - A、B 长度为
200,即 \(n=200\)。s
是标量。
向量寄存器长度 64,即 \(MVL=64\)。
Tloop = 15。Tstart = 12 + 7 + 12 = 31。假设load启动时间=12周期,store启动时间=12周期,惩罚启动时间为7周期。Tchime=3。1
2
3LV V1, B ; 读 B
MULVS V2, V1, s ; V2 = B × s
SV A, V2 ; 写回 AT200 = ceil(200/64) * (15+31) + 200 * 3 = 784。每元素执行时间约
784/200 = 3.9周期。
4.3 向量遮罩寄存器
向量代码中可能包含 if
条件,不能简单地让所有元素都执行写回。例如:
1 | for (i = 0; i < 64; i++) |
于是人们发明了向量遮罩寄存器,用于控制一条向量指令中每个元素是否真正执行或提交结果。对于上面的代码,利用向量遮罩寄存器,生成的指令为:
1 | LV V1, Rx ; load vector X into V1 |
遮罩能处理条件执行,但被遮蔽的元素仍可能占用部分执行资源。此外,若条件分布很不均匀,实际 SIMD 利用率会下降。
4.4 步幅访问与多维数组
多维数组按行或列访问时,内存地址可能不是连续的。向量机通过带步幅的向量 Load/Store 处理非单位步幅访问。例如,VMIPS 中有这两条指令:
LVWS:带步幅向量装入。也就是把这些地址的数据装进向量寄存器:1
2
3
4
5base
base + stride
base + 2 × stride
base + 3 × stride
...SVWS:带步幅向量存储。
矩阵乘法中访问 D[k][j] 时,如果数组按行存放,而
k 变化、j
固定,通常形成非单位步幅访问。其风险在于,步幅与 bank
数不匹配时容易造成存储器组冲突。比如 4 个 bank,访问步幅是 4:
1 | A[0], A[4], A[8], A[12] |
它们可能都落到 Bank0。结果是:4 个 bank 只用了 1 个 bank。此外,大步幅还可能导致 TLB 缺失频繁。
4.5 集中-分散访问与稀疏向量
稀疏向量是指 0 元素很多、非 0 元素很少的向量。为节省空间,稀疏向量通常采用压缩存储。
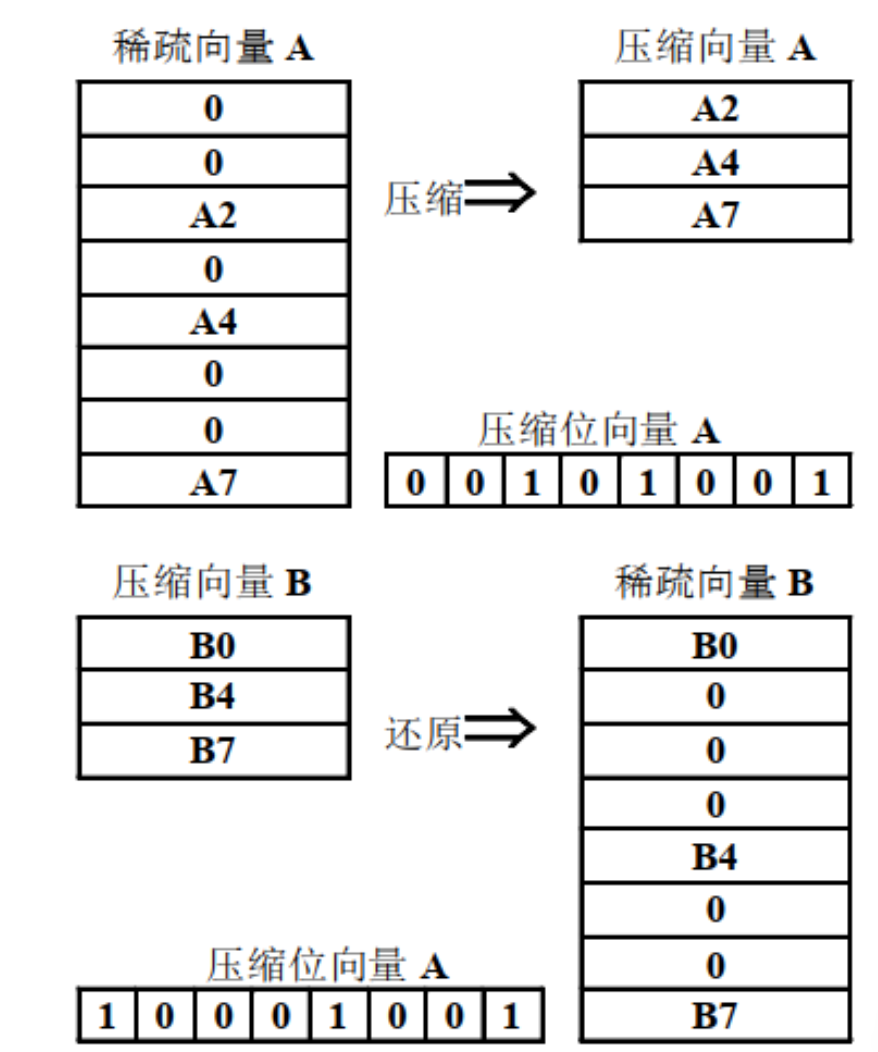
对稀疏访问,向量机提供集中-分散(gather-scatter)操作: - 集中(gather):根据索引向量从不连续地址取数据。 - 分散(scatter):根据索引向量把结果写到不连续地址。
例如: 1
2for (i = 0; i < n; i++)
A[K[i]] = A[K[i]] + C[M[i]];
1 | LV Vk, Rk ;load 索引K |
4.6 向量性能指标
- \(R_∞\):向量长度趋于无穷大时的最大向量流水线性能。常用于评价峰值性能,单位通常为 MFLOPS。
- \(R_n\):向量长度为 \(n\) 时的实际性能。
- \(N_{1/2}\):达到 \(R_∞\) 一半性能所需的向量长度。用于衡量启动时间对性能的影响。
- \(N_V\):向量方式开始快于标量串行方式所需的临界向量长度。反映启动开销和标量/向量速度比。
5. 面向多媒体应用的 SIMD 指令集扩展
5.1 SIMD 扩展与传统向量机的区别
多媒体应用常处理 8 位、16 位、32 位等较窄数据类型。SIMD 指令集扩展把一个较宽寄存器划分为多个子字,同时执行多份相同操作。与完整向量体系结构相比,SIMD 扩展有三点简化:
- 操作数个数固定,通常由寄存器宽度和元素宽度决定。
- 不提供复杂向量寻址方式,如步幅访问、集中-分散访问。
- 早期 SIMD 扩展通常没有完整的向量遮罩寄存器。
5.2 x86 SIMD 扩展发展
- Intel MMX(1996):复用 64 位浮点寄存器。可同时执行 8 个 8 位或 4 个 16 位运算。
- SSE(1999):引入 128 位独立寄存器。可同时执行 16 个 8 位、8 个 16 位或 4 个 32 位运算。
- AVX(2010):寄存器宽度扩展到 256 位。
- AVX-512(2017):可支持 8 个 64 位整数/浮点运算。引入更强的掩码执行能力。
注意:多媒体 SIMD 对内存访问通常要求连续并对齐,否则性能会下降或需要额外处理。
5.3 DAXPY 例子的 SIMD 化思路
题目标题写作 DXPY;但从代码看,它实际对应经典 DAXPY
形式:Y = a × X + Y。SIMD
版本每次循环处理多个元素,例如一次处理 4 个 double:
1 | L.D F0, a ; load scalar a |
与向量机相比,SIMD 扩展更像“短向量”,需要软件循环控制多次执行。
6. Roofline 可视化性能模型
6.1 基本概念
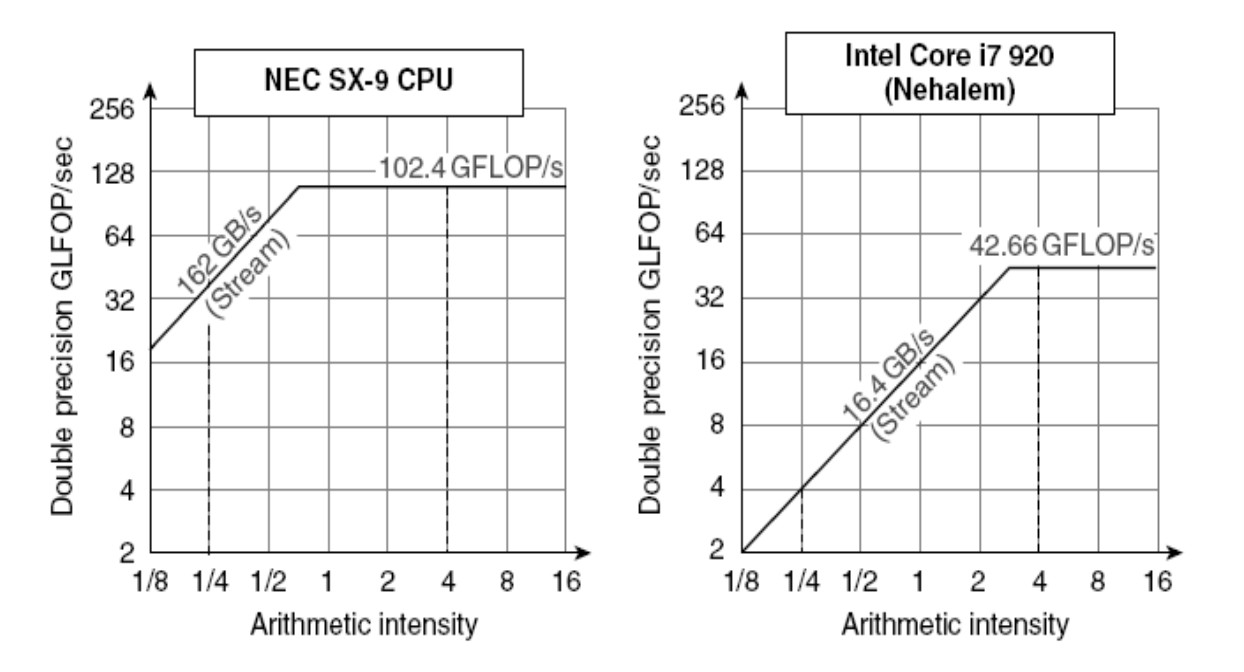
Roofline 模型把浮点性能、存储器带宽和程序运算密度放到同一张二维图中。
运算密度(Operational Intensity)= 程序执行的浮点运算数 / 从主存访问的字节数,单位通常为 FLOPs/Byte。
可获得的GFLOP/s = min(峰值存储器带宽 × 运算密度, 峰值浮点性能)。
6.2 如何理解 Roofline
- 当运算密度低时,性能受存储器带宽限制。增加计算单元未必有效,关键是减少访存或提高带宽利用率。
- 当运算密度高时,性能受峰值计算能力限制。关键是提高向量化、SIMD 利用率和指令吞吐。
7. 图形处理器 GPU 与 SIMT
7.1 GPU 适合的任务
GPU 适合对大量数据使用同一计算方法进行并行处理。适合条件:数据相关度低、可产生大量线程、计算密度较高、计算时间相对数据搬运时间足够大。
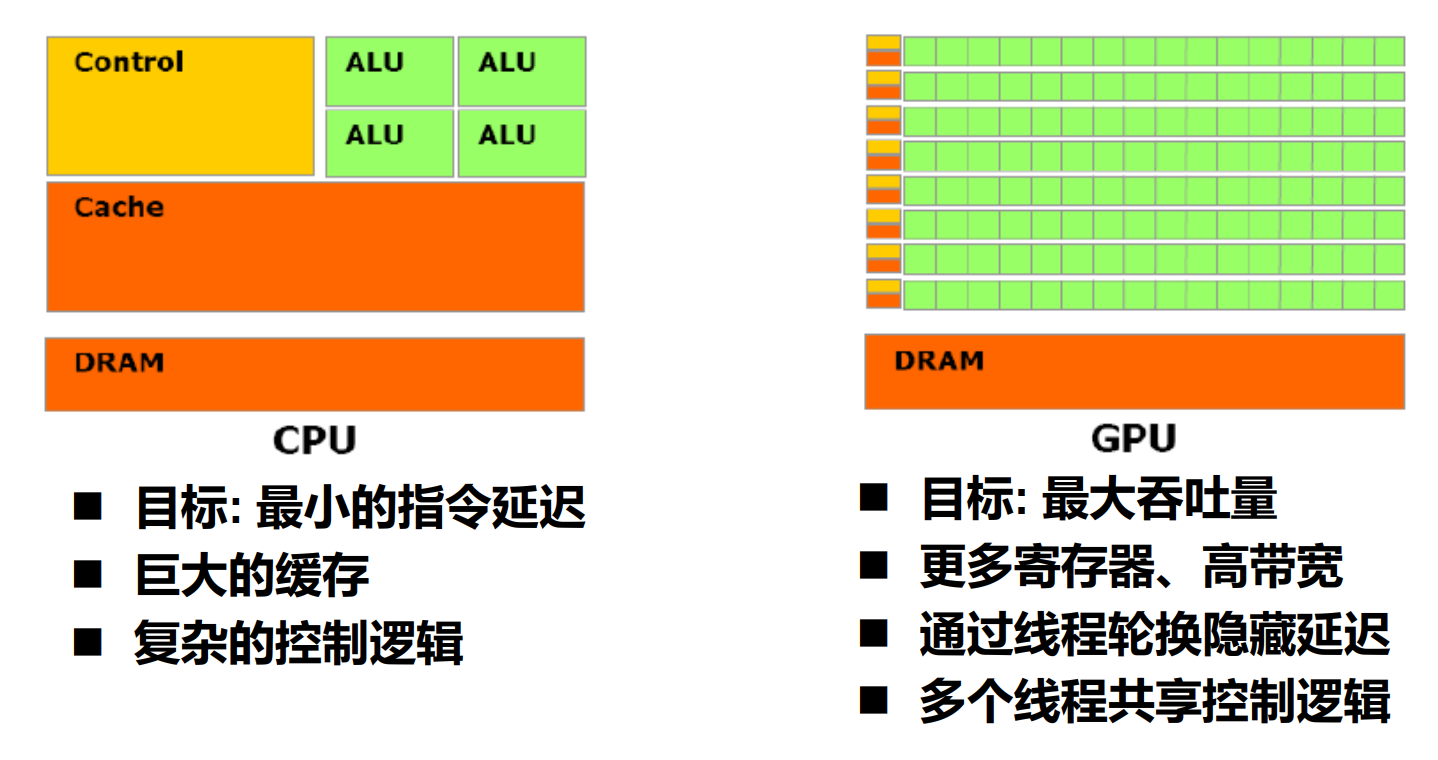
7.2 CPU 与 GPU 的体系结构差异
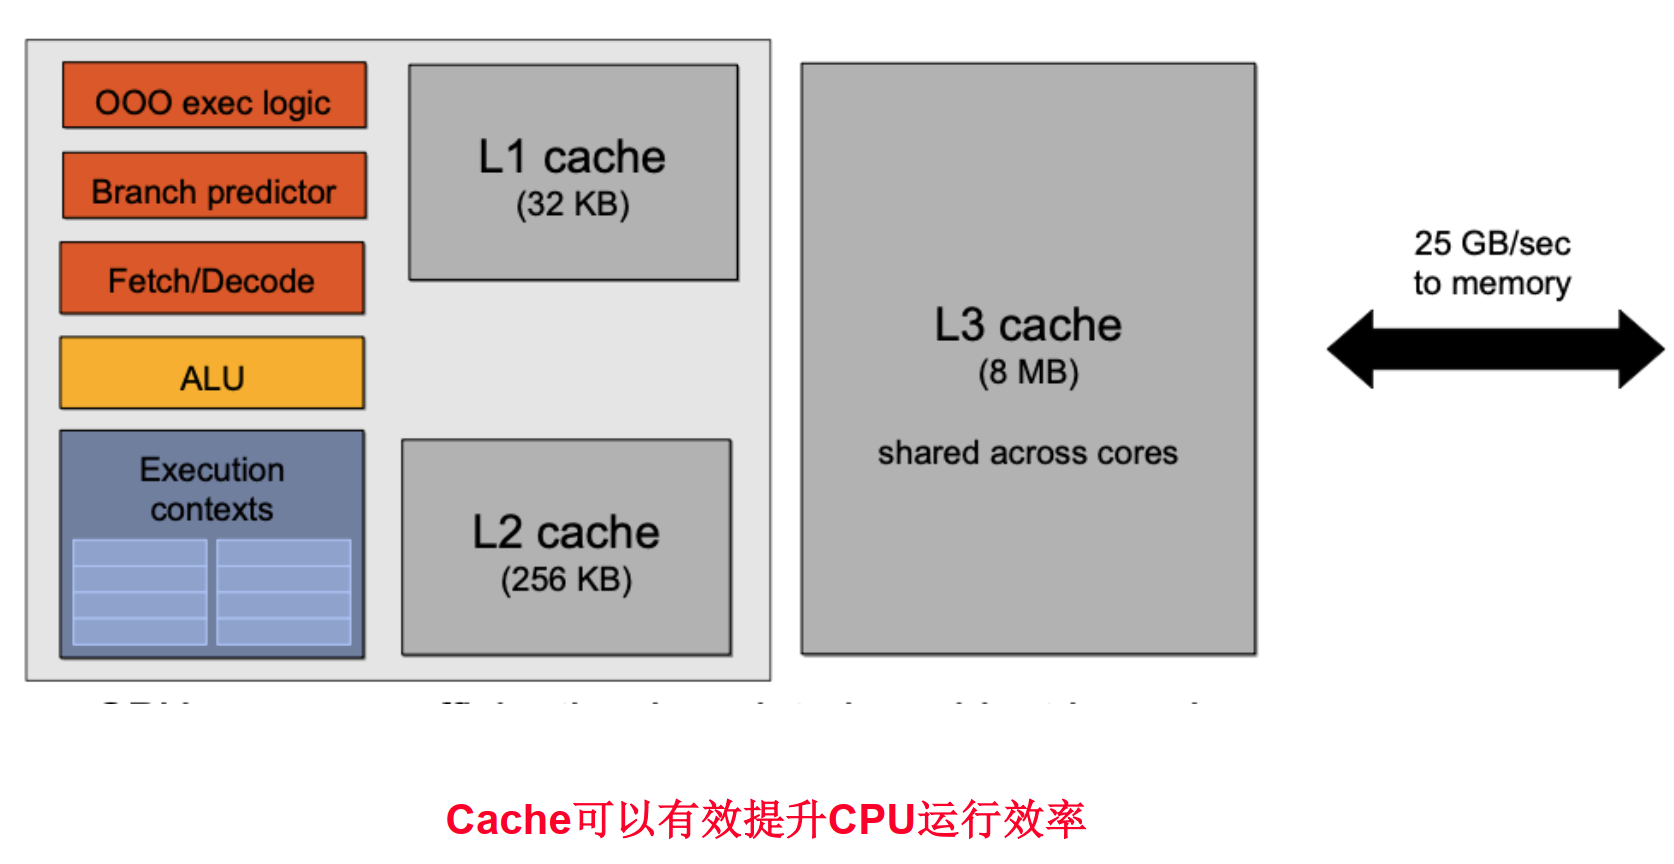
- CPU 目标:降低单线程指令延迟。大 Cache。复杂控制逻辑。分支预测、乱序执行、推测执行。
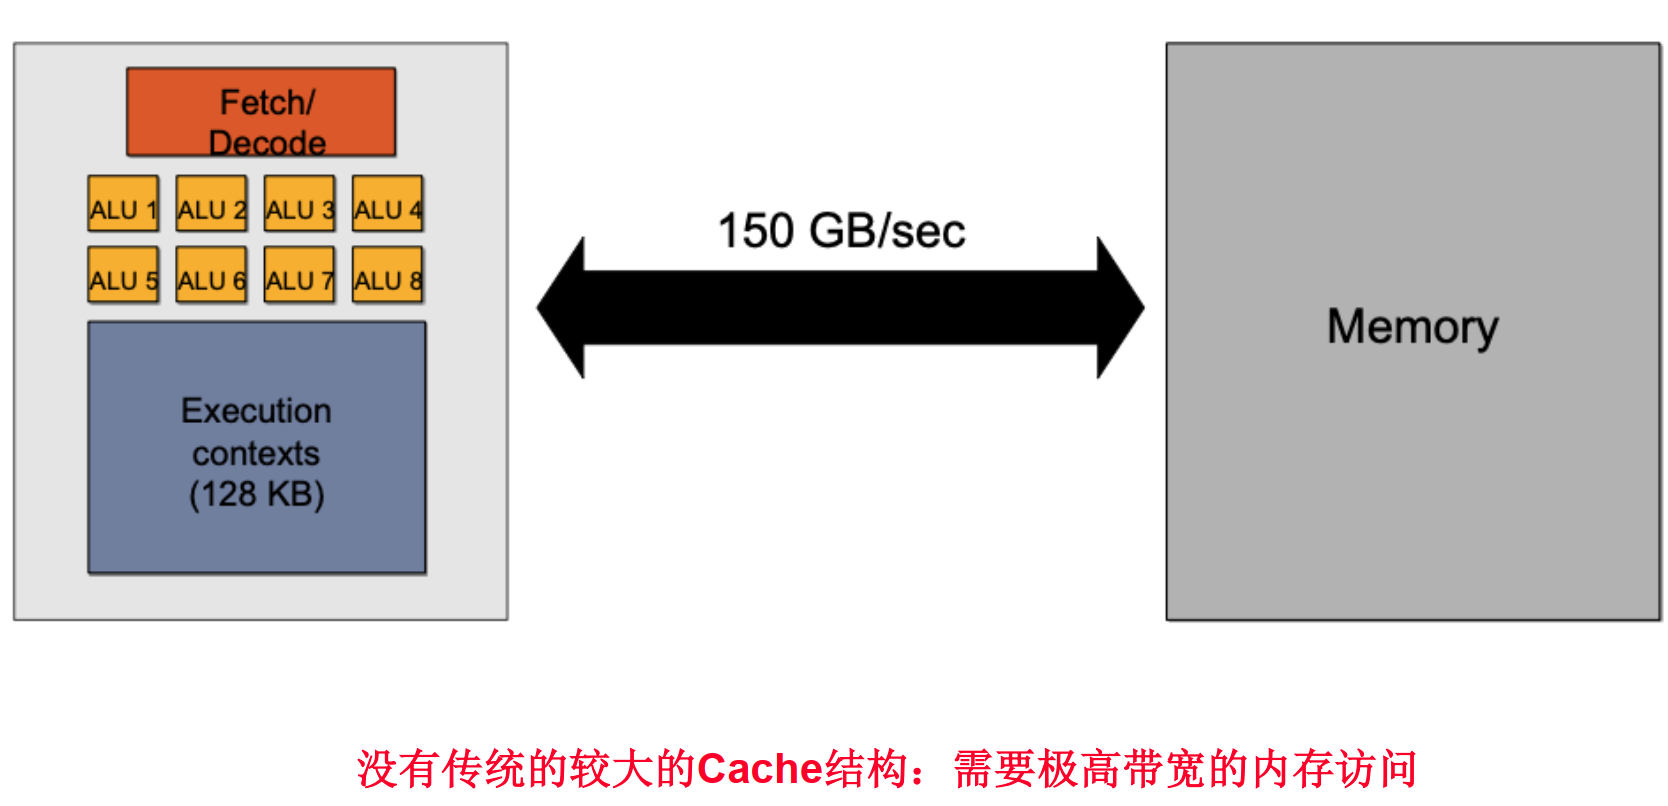
- GPU 目标:提高总体吞吐量。更多执行单元和寄存器。高带宽显存。多线程轮换隐藏访存和功能部件延迟。多个线程共享控制逻辑。
- 因此,CPU 更像“少量复杂核心”,GPU 更像“大量简单执行资源加高带宽存储”。
7.3 三种并行编程模型对比
- SISD 顺序模型:普通标量循环由流水线、乱序执行、超标量等硬件动态挖掘并行。并行性由硬件在指令窗口中发现。
- SIMD 数据并行模型:程序员或编译器生成向量/SIMD 指令。一条指令处理多个循环迭代的数据。最适合向量机或数组处理器。
- 多线程模型:程序员或编译器为每个迭代生成线程。每个线程执行相同代码,但处理不同数据。可在 MIMD 或 GPU SIMT 机器上运行。
下面用一个例子说明三种模型的区别:
1 | for (i = 0; i < 8; i++) |
也就是做 8 个加法:
1 | C[0]=A[0]+B[0] |
1. SISD:顺序执行
SISD 是 Single Instruction, Single Data,单指令单数据。普通 CPU 顺序程序就是这种写法:
1 | for (i = 0; i < 8; i++) |
执行过程大致是:
1 | 第1次循环:算 C[0] |
特点:只有一个指令流;一次主要处理一个数据元素;靠流水线、乱序执行、超标量等 CPU 技术偷偷加速。
2. SIMD:一条指令处理多个数据
SIMD 是 Single Instruction, Multiple Data,单指令多数据。向量化后可以写成类似:
1 | VLD V1, A ; 一次装入 A[0..7] |
执行过程是:
1 | 一条 VADD 指令同时做: |
特点:只有一个指令流;一次处理多个数据元素;所有数据执行同一个操作。
3. 多线程/SPMD:多个线程各算一个元素
SPMD 是 Single Program, Multiple Data,单程序多数据。GPU 常用这种模式。程序员会写一个“单个线程要做什么”的程序:
1 | __global__ void vecAdd(double *A, double *B, double *C) { |
看起来每个线程只做一个元素:
1 | 线程0:C[0] = A[0] + B[0] |
特点:多个线程,每个线程运行同一份程序,每个线程处理不同数据。
在 GPU 里,硬件会把一组线程,比如 32 个线程,组成一个 warp。如果这些线程刚好执行同一条语句,硬件就像 SIMD 一样一起执行它们。
| 模型 | 程序看起来 | 谁表达并行 | 执行方式 |
|---|---|---|---|
| SISD | 一个普通循环 | 主要靠 CPU 硬件动态挖掘 | 一个接一个算,内部可能偷偷重叠 |
| SIMD | 一条向量/SIMD 指令 | 编译器或程序员显式向量化 | 一条指令同时处理多个元素 |
| SPMD/SIMT | 很多线程运行同一程序 | 程序员创建大量线程 | 每个线程处理一个数据,GPU 再把线程组成 warp 执行 |
7.4 SIMT:GPU 的执行模型
GPU 面向线程编程,程序员通常写标量线程代码,而不是直接写 SIMD 指令。每个线程有自己的上下文,可以独立执行或重新调度。硬件把执行相同指令的一组线程动态组成 warp。Warp 本质上是硬件形成的一次 SIMD 操作。
SIMT 的优势: - 可把每个线程当作独立标量线程处理,具有一定 MIMD 灵活性。 - 可把执行同一指令的线程组成 warp,获得 SIMD 的能效和吞吐优势。
7.5 CUDA 编程模型
1. 核心思想
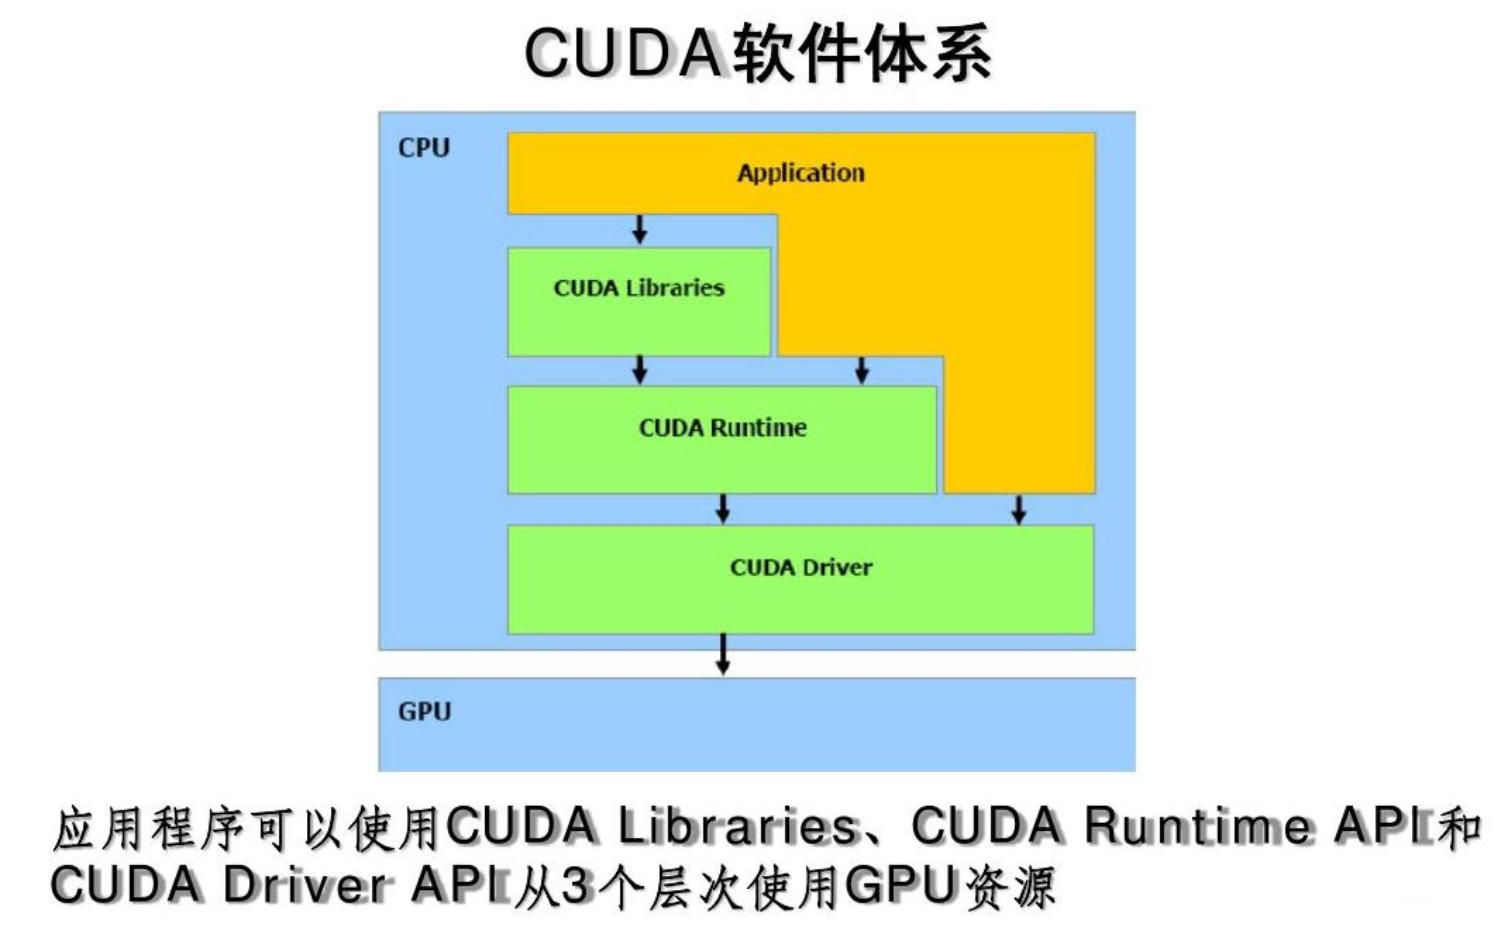
CUDA 的核心思想是,程序员编写一个由单个线程执行的函数,GPU
启动大量线程,让每个线程处理不同数据。这个由 GPU 上大量线程执行的函数叫
kernel,用 __global__
声明。下面是一个向量加法例子:
| 对比项 | 普通 CPU 写法 | CUDA 写法 |
|---|---|---|
| 程序形式 | 一个循环顺序遍历数组 | 一个 kernel 被大量线程并行执行 |
| 代码示例 | for (int i = 0; i < 100000; i++) C[i] = A[i] + B[i]; |
每个线程用自己的 tid 计算
C[tid] = A[tid] + B[tid]; |
| 执行主体 | 一个或少量 CPU 线程 | 成千上万个 GPU thread |
| 每个执行单位负责的工作 | 一个线程反复处理很多个 i |
一个 GPU thread 通常处理一个或少量元素 |
| 并行表达方式 | 循环写成顺序形式,并行主要依靠 CPU 或编译器优化 | 程序员显式启动大量线程 |
| 适合场景 | 控制复杂、分支多、数据规模不大或串行依赖强 | 数据量大、同一操作作用于大量元素、线程之间依赖少 |
1 | __global__ void KernelFunction(...) { |
KernelFunction是 GPU kernel。- 每个线程都会执行同一份 kernel 代码。
- 每个线程计算出自己的全局编号
tid。 - 线程
tid负责计算C[tid] = aa[tid] + bb[tid]。
| CUDA 变量 | 含义 | 例子:每个 block 有 256 个线程 |
|---|---|---|
threadIdx.x |
当前线程在本 block 内的编号 | 取值 0~255 |
blockIdx.x |
当前 block 在 grid 中的编号 | 第 0 个 block 为 0,第 1 个 block 为 1 |
blockDim.x |
每个 block 中的线程数 | 256 |
tid = blockDim.x * blockIdx.x + threadIdx.x |
当前线程对应的全局数组下标 | block 1 的 thread 3 对应 256*1+3=259 |
如果有 100000 个元素、每个 block 256 个线程,则大约需要 ceil(100000 / 256) = 391 个 block
2. CUDA的层级结构
CUDA 可分为 grid,block和thread三个层次:
1 | Grid |
| 层级 | 中文名 | 软件含义 | 硬件对应 | 通信/同步特点 |
|---|---|---|---|---|
| Thread | 线程 | 最小执行单位,通常负责一个或少量数据元素 | SP / CUDA core 上的执行上下文。SP 可粗略理解为 GPU
里的小计算核心。 |
线程自己有私有寄存器 |
| Block | 线程块 | 一组 thread 的集合 | 通常调度到一个 SM 上执行。SM 是 Streaming
Multiprocessor,可理解为包含许多执行资源的“大计算单元”。 |
同一 block 内线程可通过 shared memory 通信,可使用同步 |
| Grid | 网格 | 一次 kernel 启动的所有 block | 整个 GPU 执行 | 不同 block 不能直接同步,通常通过 global memory 间接交换数据 |
映射关系可以这样记:
1 | Thread -> SP |
3. CUDA的存储器模型
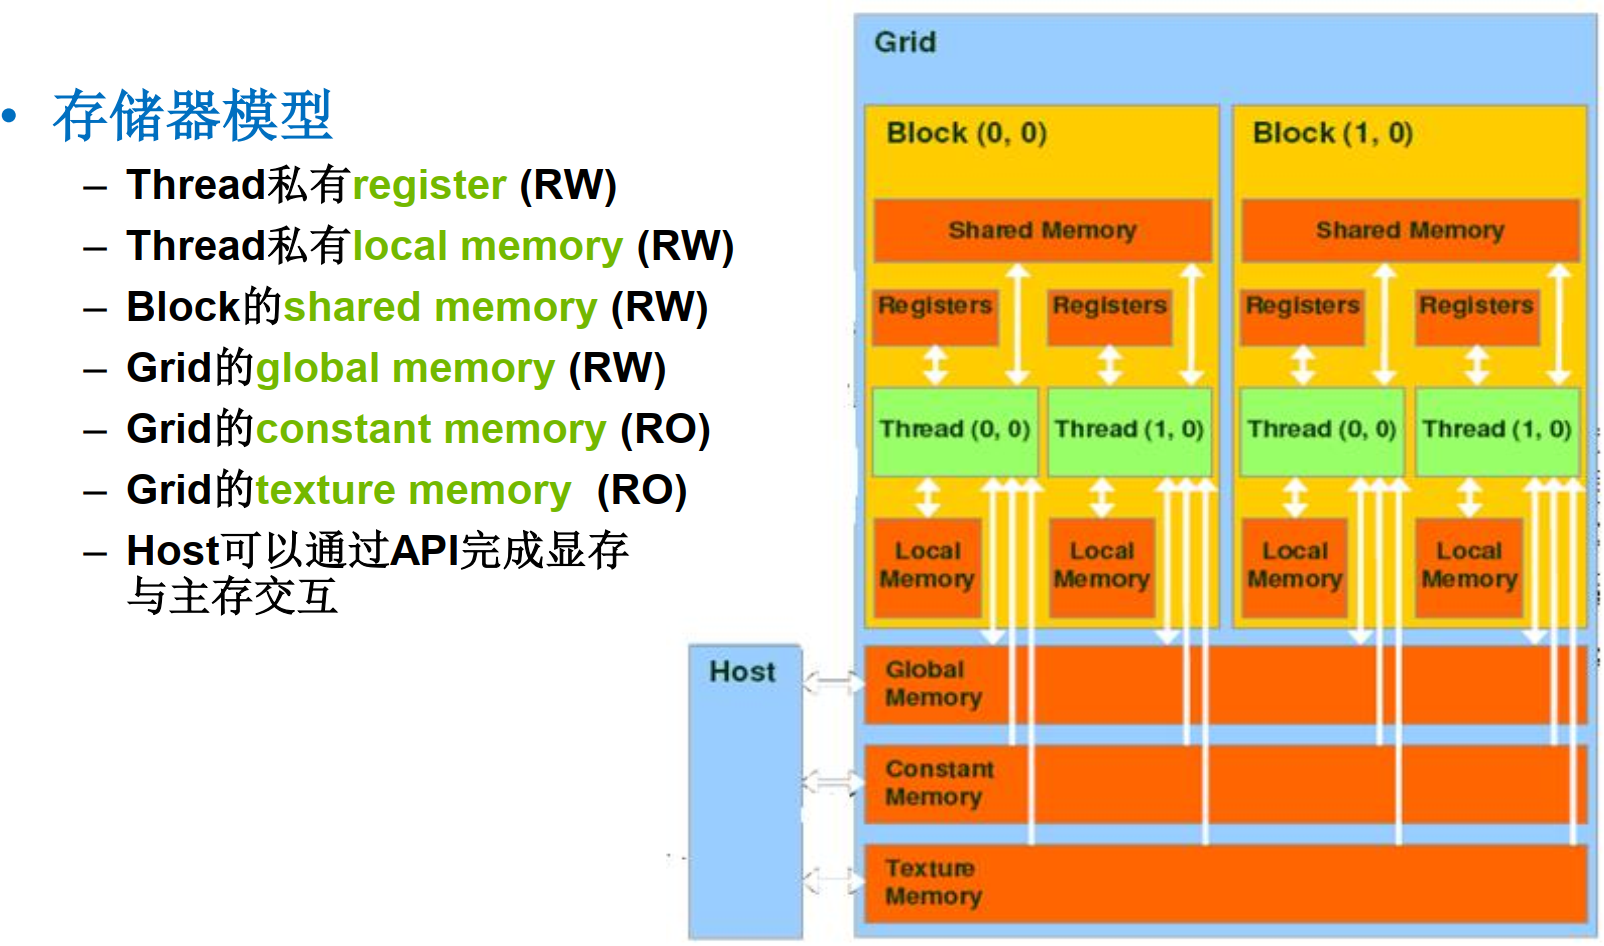
| 存储类型 | 访问范围/权限 | 速度 | 典型用途 | 备注 |
|---|---|---|---|---|
| Register | thread 私有,读写 | 最快 | 线程内部临时变量、循环变量、中间结果 | 数量有限;寄存器不够可能溢出到 local memory |
| Local memory | thread 私有,读写 | 慢,通常在显存中 | 过大的局部数组、寄存器溢出数据 | 名字叫 local,但不代表快 |
| Shared memory | 同一 block 内线程共享,读写 | 很快,接近片上存储速度 | block 内线程协作、数据复用、矩阵分块 | 不同 block 不能访问彼此的 shared memory |
| Global memory | grid 中所有线程可读写 | 慢,但容量大 | 输入数组、输出数组、不同 block 间间接交换数据 | A、B、C
这类大数组通常在这里 |
| Constant memory | grid 中线程只读 | 命中时较快 | 所有线程都读取的常量 | 适合广播式读取 |
| Texture memory | grid 中线程只读 | 对特定空间局部性访问较友好 | 图像、纹理、特殊只读访问 | 主要服务图形/空间局部访问模式 |
| Host memory | CPU 端内存 | GPU 直接访问通常较慢 | CPU 准备输入数据、接收结果 | Host 通过 API 与 GPU 显存交换数据 |
Block 之间不能直接通信的原因: - GPU 为了高吞吐,会把不同 block 调度到不同 SM 上。 - 不同 block 的执行先后顺序通常不由程序员控制。 - CUDA 因此只保证同一 block 内线程可以通过 shared memory 和同步指令协作。 - 不同 block 若要交换数据,一般通过 global memory,并常常需要分成多个 kernel 阶段。
| 并行粒度 | 通信方式 | 适合描述 |
|---|---|---|
| block 内 thread | shared memory + 同步指令 | 细粒度并行 |
| block 与 block 之间 | global memory,通常不能在同一 kernel 内直接同步 | 粗粒度并行 |
补充:NVIDIA 官方 CUDA 文档说明,kernel 启动时会指定 grid 与 thread block 维度;同一 block 内线程可通过 shared memory 协作,并可使用同步操作协调访存。
8. GPU 条件分支与分支发散
8.1 Warp 与多线程隐藏延迟
GPU 不是一个线程一个线程单独跑,而是把一组线程打包成一个 warp一起跑。一个 NVIDIA warp 通常由 32 个线程组成。多个 warp 在同一核心/SM 上交错运行,当某个 warp 等待访存或功能部件时,调度器切换到其他可执行 warp,这样可以隐藏高延迟操作。
一个线程块可包含多个 warp,这些 warp 映射到同一个 SM 上。多个线程块也可能同时驻留在同一 SM 上,取决于寄存器、shared memory 和硬件资源。
8.2 条件执行机制
GPU 使用多种机制处理条件分支: - 内部 mask。原理与向量遮罩寄存器相同。 - 分支同步栈(SIMT stack)。 代码中经常会出现嵌套的 if-else,为了管理这种复杂的分支层级,GPU硬件中引入了分支同步栈。当遇到一个分支时,GPU会将当前的“状态”(包括即将前往的另一个分支的地址、以及对应的 mask)压入栈中。然后拿着新的 mask 去执行当前分支。当当前分支执行完毕时,再从栈中弹出之前的状态,去执行另一个分支。这就保证了多重嵌套的条件语句能够正确无误地按顺序执行。 - 指令标记。在汇编指令级别使用的特殊标记,用来告诉硬件当前分支控制流的状态。由于GPU把 if 和 else 都走了一遍,硬件需要知道这些分开走的线程在什么时候需要重新汇合。编译器会在指令序列中插入特殊的标记(比如同步指令或重聚点标记)。当硬件遇到这些标记时,就知道一个分支块结束了,可以去栈里取下一个分支来执行,或者恢复所有线程的统一执行。 - 显式谓词寄存器。这是一种将“控制流”(跳转)转化为“数据流”(条件执行)的技术。谓词寄存器是一种只存 1 bit(真/假)的特殊寄存器。对于只有几条指令的极短分支,使用上述的“压栈/出栈/遮罩”机制开销太大了。此时,编译器会使用谓词指令。它会先计算条件,将 True 或 False 存入谓词寄存器(例如 @P1)。之后的指令都会带上这个前缀(比如 @P1 ADD R1, R2, R3)。这句话的意思是:“如果 P1 为真,则执行加法并写回;如果为假,则这当作一条空指令(NOP)”。这避免了真正的指令跳转,非常高效。
8.3 分支发散(Branch Divergence)
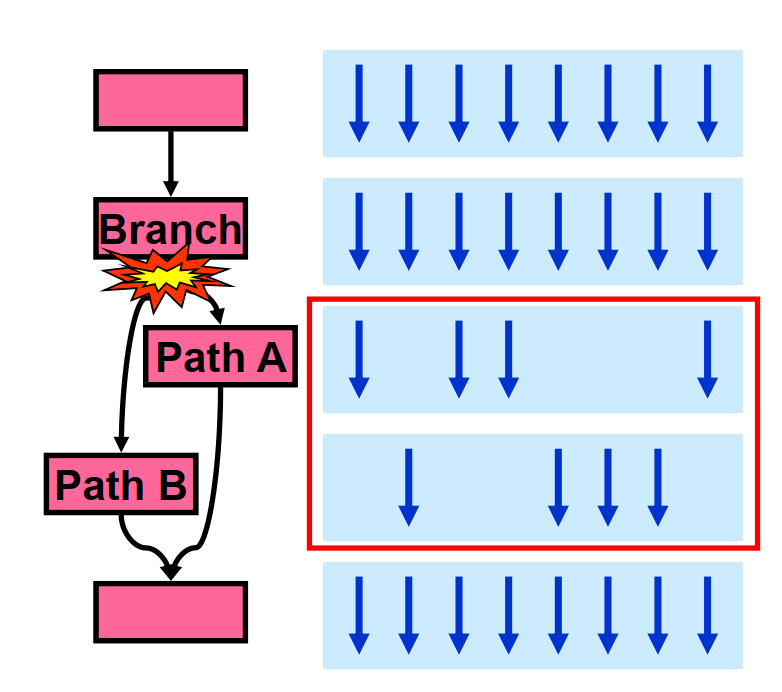
当同一 warp 内的线程走不同控制流路径时,会产生分支发散。假设代码是:
1 | if (A[i] > 0) { |
假设判断结果是:
1 | 线程0:true 走 if |
同一个 warp 里面,有的线程要执行加法,有的线程要执行减法。但 warp 的特点是:同一时刻只能执行同一条指令。它不能在同一拍里让线程0、1执行加法,同时让线程2、3执行减法。所以 GPU 只能分两步:
1 | 第1步:执行 if 路径 |
这就叫分支发散。(下图与示例无关)
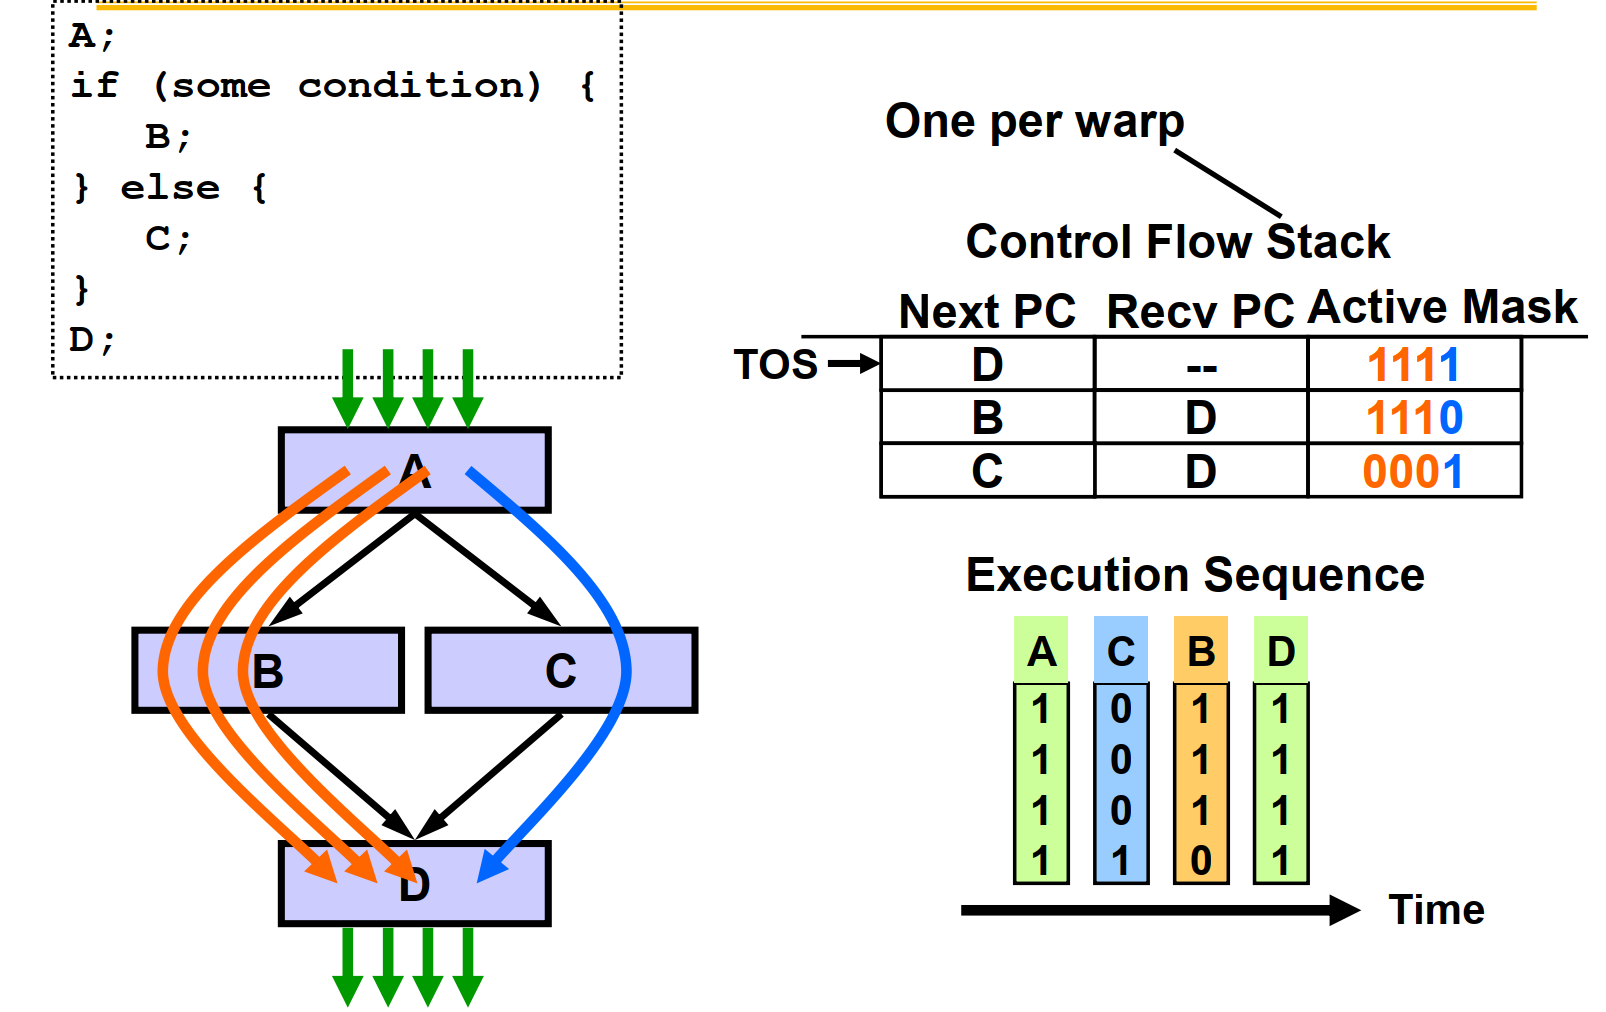
如果所有线程走同一路径,warp 可以保持高效 SIMD 执行。如果线程方向不一致,硬件会生成 mask,表示哪些线程走哪条路径。例如上面的 if 路径,mask = 1100;else 路径,mask = 0011。
具体的执行过程是,先执行其中一条路径,另一条路径及其 mask 压入分支同步栈,后续通过 pop 恢复另一路径执行。各路径执行完后在汇合点 reconverge。
对 IF-THEN-ELSE 且两条路径长度相近的情况,平均 SIMD 利用率可能接近 50%。
分支发散不一定导致错误,但会降低吞吐率。
优化 GPU 程序时,应尽量让同一 warp 中线程走相同控制流。
8.4 动态 Warp 形成与存储发散
每个 warp 中可能有些线程现在执行,有些线程待会执行,效率有点低下。动态 warp 的思想是,分支发散后,把来自不同 warp、但即将执行相同指令路径的线程重新组合成新 warp。从而提高 SIMD lane 利用率。
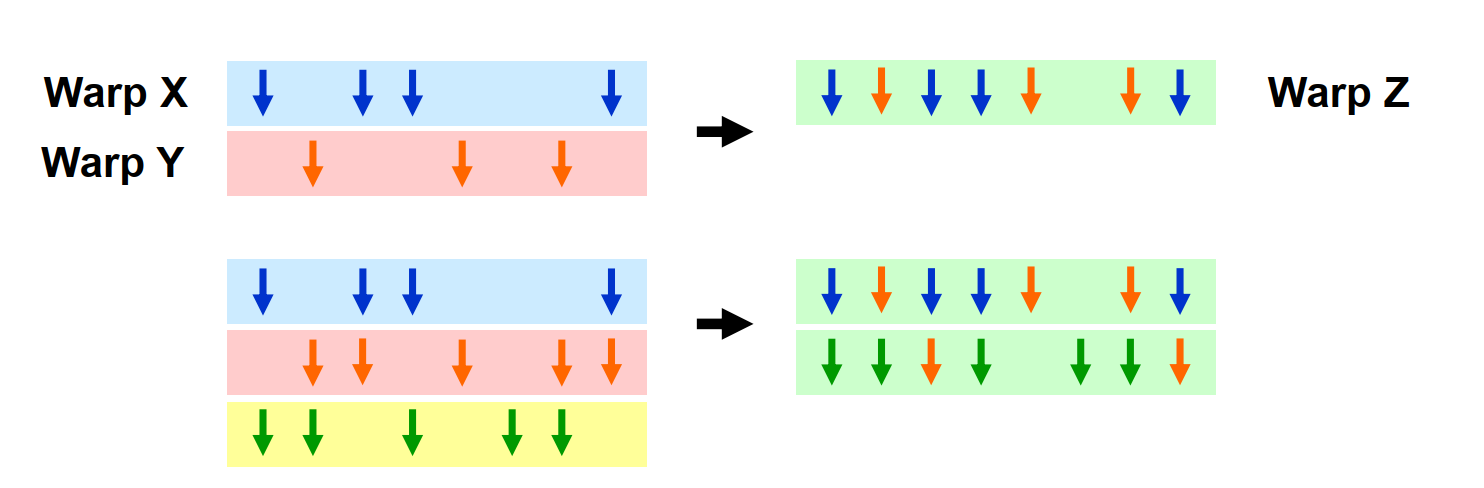
Warp X 和 Warp Y 可以合并成 Warp Z
三个 Warp 也可以合并成两个 Warp
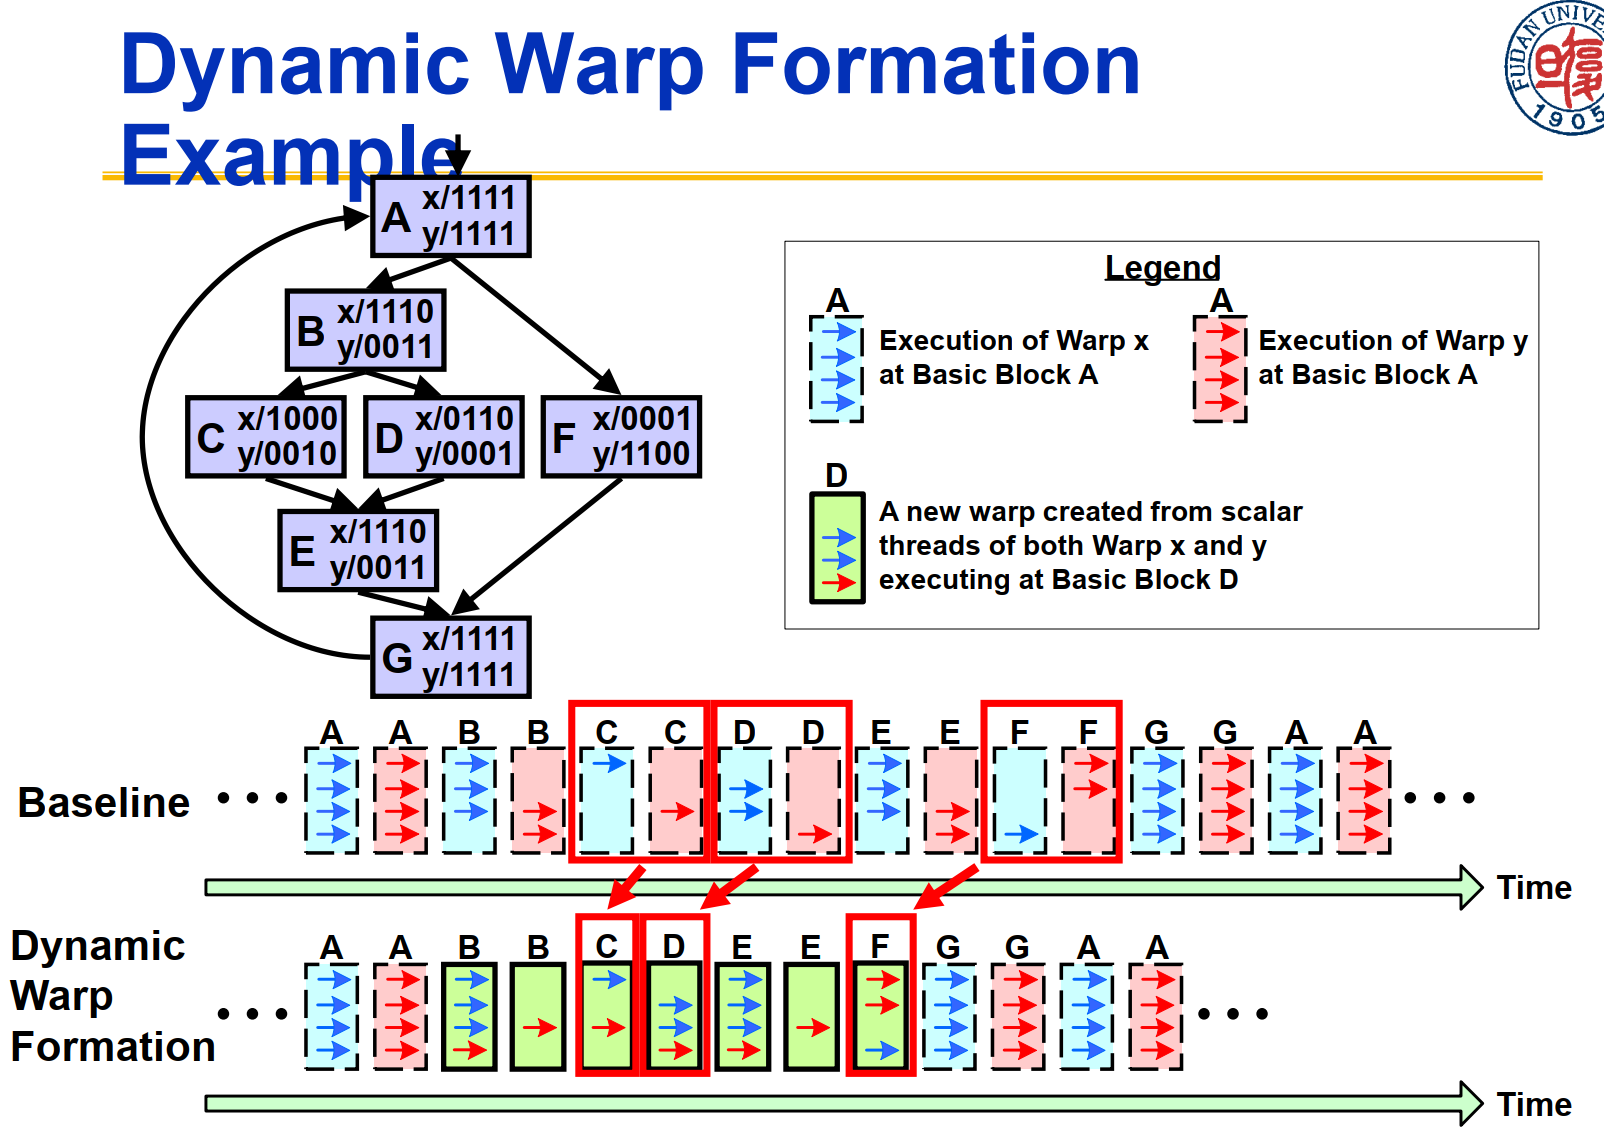
动态 Warp 的局限在于:
硬件寄存器和 lane 映射并非完全自由。
动态组合可能破坏原本规则的内存访问模式。
存储发散问题。理想情况是 warp 中线程访存都命中,且访问能合并。若部分命中、部分未命中,或访问地址随机,一个线程的 stall 可能影响整个 warp。现代 GPU 使用缓存、访存合并等技术缓解,但不规则访问仍是性能风险。
9. 检测与增强循环级并行
9.1 循环级并行与循环间相关
- 循环级并行通常在源代码级别分析。
- 循环间相关(loop-carried dependence):后续迭代的数据访问是否依赖前面迭代生成的值。
9.2 示例分析
例 1: 1
2for (i = 999; i >= 0; i--)
x[i] = x[i] + s;x[i],通常可并行。
例 2: 1
2
3
4for (i = 0; i < 100; i++) {
A[i+1] = A[i] + C[i];
B[i+1] = B[i] + A[i+1];
}A[i+1] 依赖上一迭代的
A[i];B[i+1] 依赖上一迭代的
B[i];B[i+1] 使用同一迭代中刚算出的
A[i+1],这是循环内相关,不是循环间相关。
例 3: 1
2
3
4for (i = 0; i < 100; i++) {
A[i] = A[i] + B[i];
B[i+1] = C[i] + D[i];
}A[i] 可能使用上一迭代生成的
B[i],存在循环间相关。可通过调整语句顺序和边界处理,把相关变成循环内相关,从而并行化主体循环。
例 4: 1
2
3
4for (i = 0; i < 100; i++) {
A[i] = B[i] + C[i];
D[i] = A[i] * E[i];
}D[i] 依赖同一迭代中的
A[i],不是循环间相关。
例 5: 1
2for (i = 1; i < 100; i++)
Y[i] = Y[i-1] + Y[i];
9.3 查找相关:仿射下标与 GCD 测试
相关分析常假设数组索引是仿射形式:a × i + b。若在索引
a × j + b 存储数组元素,又在索引 c × k + d
读取同一数组元素,并且 j、k
都在循环范围内,则可能存在相关。如果存在循环间相关,那么
GCD(a,c) 必须能整除 d-b。
示例: 1
2for (i = 0; i < 100; i++)
X[2*i+3] = X[2*i] * 5.0;2i+3,读取下标
2i。 - a=2, b=3, c=2, d=0。 -
GCD(2,2)=2,d-b=-3。 - 2 不能整除
-3,因此不存在循环间相关。
注意:GCD 测试通常是保守测试,能排除一些不可能相关的情况,但不能解决所有复杂情况。
9.4 消除相关计算:约简
递归/累加是最常见的相关计算之一: 1
2
3sum = 0;
for (i = 9999; i >= 0; i--)
sum = sum + x[i] * y[i];sum
每次迭代都依赖上次迭代结果,存在循环间相关。改进思路是,先并行计算各元素乘积:sum[i] = x[i] * y[i]。再进行约简(reduction)求最终和:finalsum = finalsum + sum[i]。
在向量机、SIMD 和 GPU 中,约简常由特殊指令、库函数或并行树形归约实现。
10. 交叉问题:能耗、显存与虚拟存储
10.1 能耗与 DLP
如果将 DLP(数据级并行)体系结构的时钟频率减半,同时执行资源加倍,理论吞吐量可保持相近。此外,降低频率往往可以配合降低电压,从而显著降低功耗。因此,DLP 处理器通常以较低频率、更多并行资源获得高能效。这也是 GPU 和 SIMD 在高性能计算、移动计算中重要的原因。
10.2 图形存储器与高带宽
GPU 需要极高存储器带宽。典型显存技术有 HBM/HBM2、GDDR 等。其中 HBM 的数据线非常宽,常见数量级为 1024 到 4096 条,能提供极高带宽。
面对大量不相关请求,控制器可能等待足够通信量后再打开一行并传输数据。这样带宽利用率高,但单次访问延迟可能增加。GPU 依靠大量线程隐藏延迟,避免执行单元等待数据。 ## 10.3 步幅访问与 TLB 缺失
向量机和 GPU 都可能支持虚拟存储。大步幅访问可能导致每次访问落在不同页面上,从而频繁触发 TLB 缺失。这对性能造成了影响,即使存储带宽很高,地址转换开销也可能成为瓶颈。而且多维数组和稀疏数据结构尤其容易出现此问题。
优化方向有三:改善数据布局、使用分块/tiling 提高局部性、尽量让 warp 或向量访问连续地址。 # 11. 补充资料来源
- NVIDIA CUDA C++ Programming Guide:用于补充 CUDA grid/block/thread、SIMT、shared memory、global memory 等概念。
- NVIDIA Technical Blog: Global Memory Access in CUDA:用于补充 CUDA 全局内存访问、warp 大小和访存合并背景。
- RISC-V
Vector Extension 说明:用于补充 RISC-V 向量寄存器
v0-v31、vl和动态向量长度思想。