神经元
人工神经元
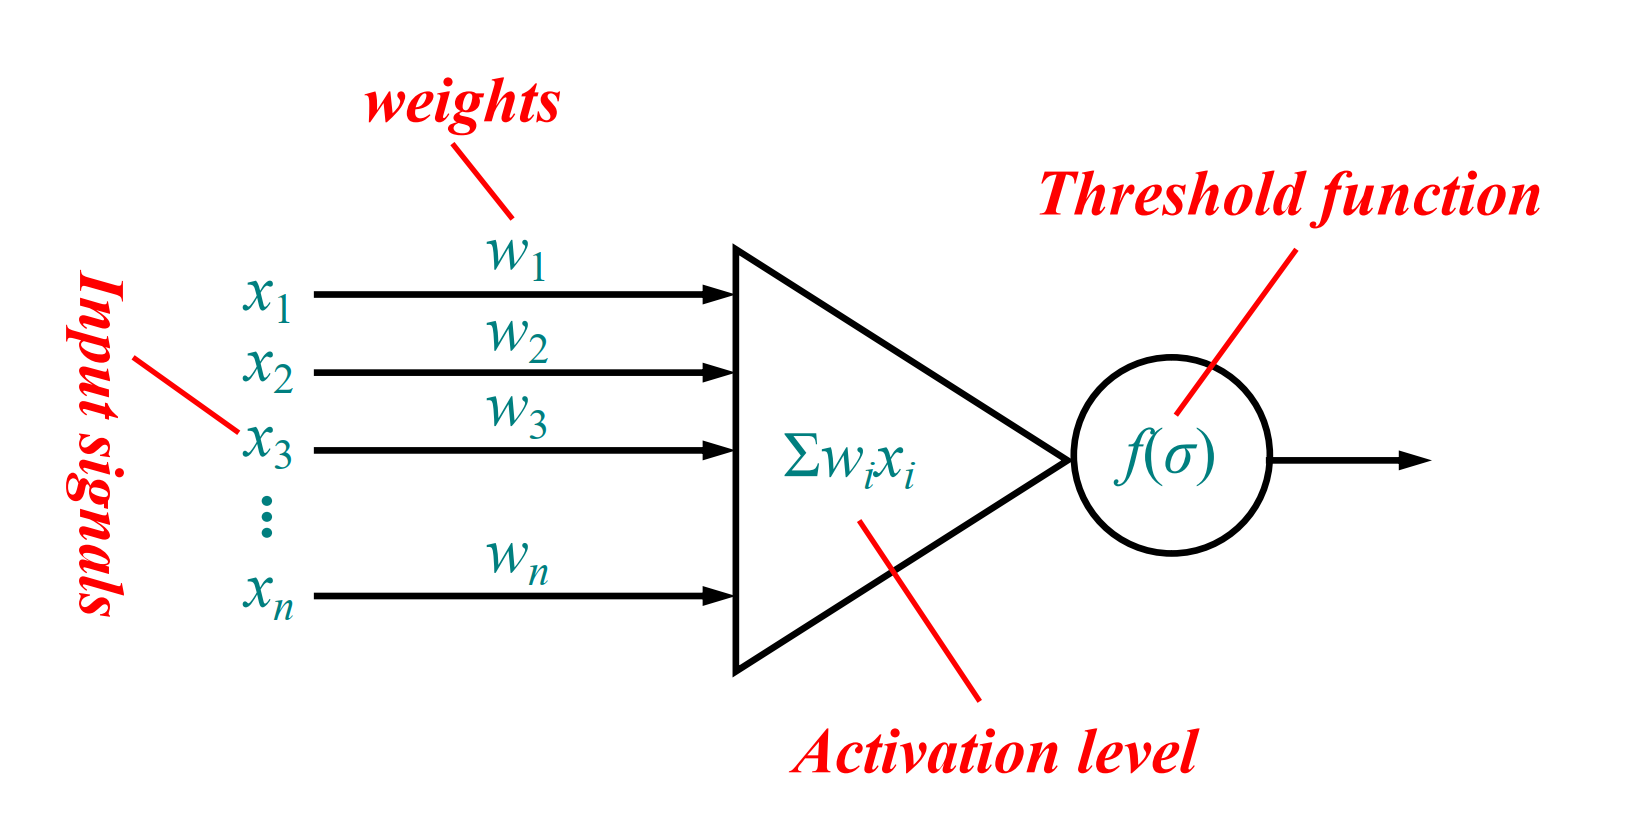
\(\sigma = \sum \limits_{i=1}^n w_i x_i\)
\(y = f(\sigma)\)
其中 \(f\) 是一个阈值函数,大于等于阈值取1,小于阈值取-1。
这里的符号定义比较奇怪,\(\sigma=\sum \limits_{i=1}^n w_i x_i\), \(f\) 是激活函数
McCulloch-Pitts模型
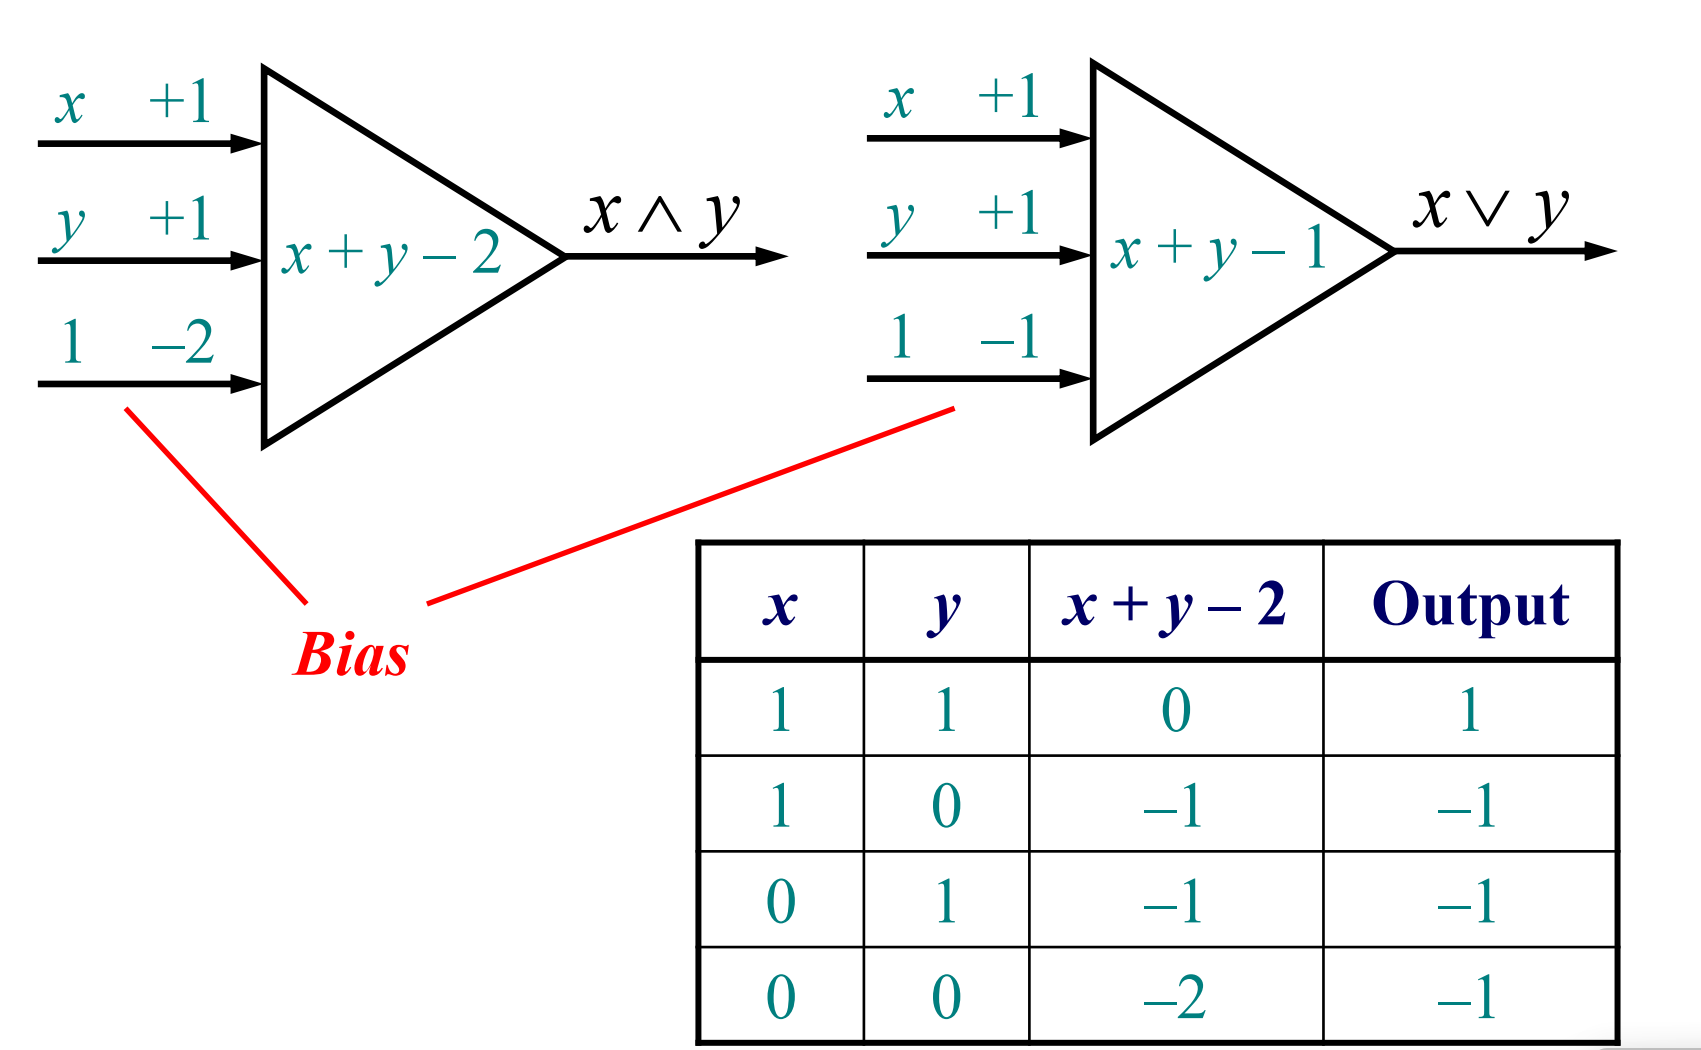
$$
感知机
上面两个神经元的局限性在于,权重都是人工设定的,而无法通过大量的数据学习出来(自动调整)。Rosenblatt感知机解决了权重“自动调整”的问题。
Rosenblatt感知机
我们有一个训练样本 \((x, d)\),其中 \(d\) 是期望输出(target),取值 \(+1\) 或 \(-1\)。 当前感知机输出是 \(y\)。如果 \(y = d\),说明分类正确,不需要调整权重;如果 \(y \neq d\),说明分类错误,需要调整权重。我们希望调整权重,使得下次遇到同样输入时,\(y\) 更接近 \(d\)。
情况 1:\(d = +1\),但 \(y = -1\)
- 当前 \(\sum \limits_{i=1}^n w_i x_i < 0\),我们希望它变大,变成 \(\geq 0\)。
- 增加权重的方向是:如果 \(x_i > 0\),就增加 \(w_i\);如果 \(x_i < 0\),就减少 \(w_i\)(因为负的输入乘负的权重会使总和变小)。
- 统一表达:\(\Delta w_i \propto (+1) \cdot x_i\),即 \(\Delta w_i = \eta \cdot x_i\)。
情况 2:\(d = -1\),但 \(y = +1\)
- 当前 \(\sum \limits_{i=1}^n w_i x_i \geq 0\),我们希望它变小,变成 \(< 0\)。
- 减少权重的方向是:如果 \(x_i > 0\),就减少 \(w_i\);如果 \(x_i < 0\),就增加 \(w_i\)。
- 统一表达:\(\Delta w_i \propto (-1) \cdot x_i\),即 \(\Delta w_i = -\eta \cdot x_i\)。
Rosenblatt 用的公式是:
\[ \Delta w_i = r \cdot (d - \text{sign}(\sum \limits_{i=1}^n w_i x_i)) \cdot x_i \] 这里 \(d - y\) 取值可能是 \(-2, 0, +2\),所以实际上相当于:
\[ \Delta w_i = \begin{cases} 0 & \text{if } d = y \\ +2r x_i & \text{if } d = +1, y = -1 \\ -2r x_i & \text{if } d = -1, y = +1 \end{cases} \] 常系数 2 可以并入学习率 \(r\),所以通常写作:
\[ \Delta w_i = r (d - y) x_i \] 其中 \(y = \text{sign}(\sum \limits_{i=1}^n w_i x_i)\)。
这个更新规则的直觉是:
- 如果输出太小(应该 \(+1\) 却得到 \(-1\)),就加大权重,方向与输入相同;
- 如果输出太大(应该 \(-1\) 却得到 \(+1\)),就减小权重,方向与输入相反;
- 权重调整的大小与输入值成正比(输入越大,影响越大)。
感知机的局限性
| \(x_1\) | \(x_2\) | 输出 |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 0 |
这是异或逻辑的真值表。如果用感知机来建模,会得到: \[ w_1 \times0+w_2 \times 0 < t\\ w_1 \times0+w_2 \times 1 > t\\ w_1 \times1+w_2 \times 0 > t\\ w_1 \times1+w_2 \times 1 < t \] 其中 \(t\) 是符号函数的阈值。显然这个不等式组是无解的。
事实上,单个感知机本质上是一个线性分类器。在二维特征空间中,它的决策边界是一条直线;在 \(D\) 维特征空间中,则表现为 \(D - 1\) 维的线性超平面。单个感知机只能处理线性可分问题,无法解决异或等线性不可分问题。
多层感知机
为了克服线性不可分的限制,引入了sigmoid函数和隐藏层。一般而言,隐藏层神经元个数=输入层神经元个数的 1.2-1.5 倍
sigmoid函数
\[ f(x)=\frac{1}{1+e^{-x}} \]
性质:\(f'(x)=f(x)(1-f(x))\),便于求导
隐藏层的本质
在传统的线性模型中,如果你发现数据不是线性的,你必须手动去构建特征(特征工程)。例如想预测房价,但房价和面积是平方关系,你得手动在模型里加一个 \(x^2\)。这里的 \(x^2\) 就是基函数 \(\phi\)。
但这种基函数是人工硬编码进去的。如果问题很复杂(比如识别人脸),人类根本不知道该写出什么样的数学公式来表达“眼睛”或“鼻子”的特征。
而神经网络将把隐藏层看作是基函数。每个神经元都在尝试对原始输入进行某种变换。因为权重 \(w\) 是可以学习的,神经网络会根据数据自己去调整这些变换方案。它会自己学会:第一层提取线条,第二层组合成形状,第三层组合成五官。
痛点
数学上可以证明,如果隐藏层的神经元足够多,就可以拟合任何函数(通用近似定理)。但问题在于,“拟合任何函数”当且仅当“学习到最合适的权重”。但“学习到最合适的权重”是一种奢望,因为梯度下降法对初始值敏感,且很容易陷入局部最小值,更会受到鞍点的影响。
神经网络的数学性质
神经网络的对称性
假设一个隐藏层有两个神经元:A 和 B。如果我们把指向 A 的所有权重和从 A 发出的权重,与 B 的权重完全交换,神经网络输出的结果不变,因为计算的逻辑是一模一样的。
为什么损失函数大都是非凸的
这里我们采用反证法,从直觉上说明这一问题。
设原始神经网络为 \(N_1\),交换中间两个神经元后为 \(N_2\)。由对称性可知 \(N_1\) 和 \(N_2\) 等价。\(N_1\) 和 \(N_2\) 两个网络参数取平均值得到 \(N_3\)。
直观上 \(N_3\) 的建模能力比 \(N_1\) 和 \(N_2\) 都差。例如,在 \(N_1\) 中,神经元 A 负责识别“横线”,神经元 B 负责识别“竖线”。在 \(N_2\) 中,变成 A 识别“竖线”,B 识别“横线”。在 \(N_3\) 中,现在的 A 变成了“(横线+竖线)/ 2”,B 也变成了“(横线+竖线)/ 2”。原本两个分工明确的专家(一个看横,一个看竖),变成了两个“平庸”的神经元(两个都看模糊的斜线或十字)。这种由于参数平均化导致的“特征模糊”,会让网络失去原有的判别能力。所以,\(N_3\) 的预测效果大概率会变差,导致它的损失函数 \(L(N_3)\) 变得很大。
因此,存在 \(N_1\) 和 \(N_2\) 的中间点 \(N_3\),使得 \(L(N_3)>L(N_2)=L(N_1)\),违背凸函数的定义。
经典应用
NETtalk
每个字母的读音可能随着上下文的变化而变化,例如apple和cake中a的读音不一样。NETtalk 构建了一个神经网络,解决了这一问题。
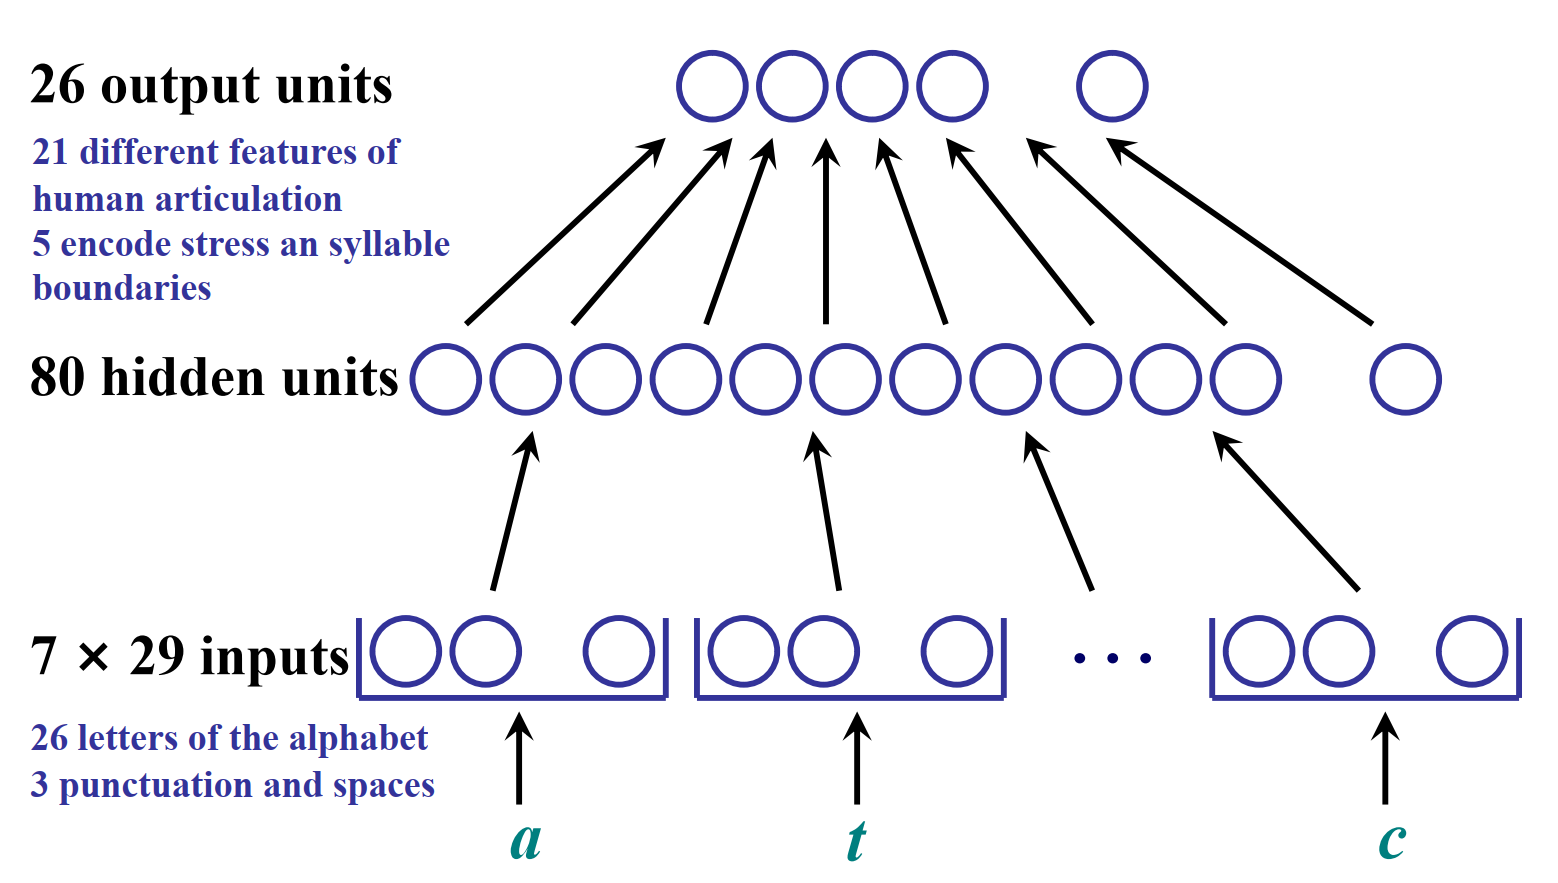
- 输入:7*29,29=26个字母+逗号+句号+空格,7=前三个字母+当前字母+后三个字母
- 输出:当前字母的读音。
- 21个发音特征单元代表人类产生声音时的生理特征,例如舌头的位置、嘴唇的形状、声带是否振动(清音 vs 浊音)
- 5个重音和音节边界单元处理语音的韵律信息,例如哪个音节需要重读
解决异或问题
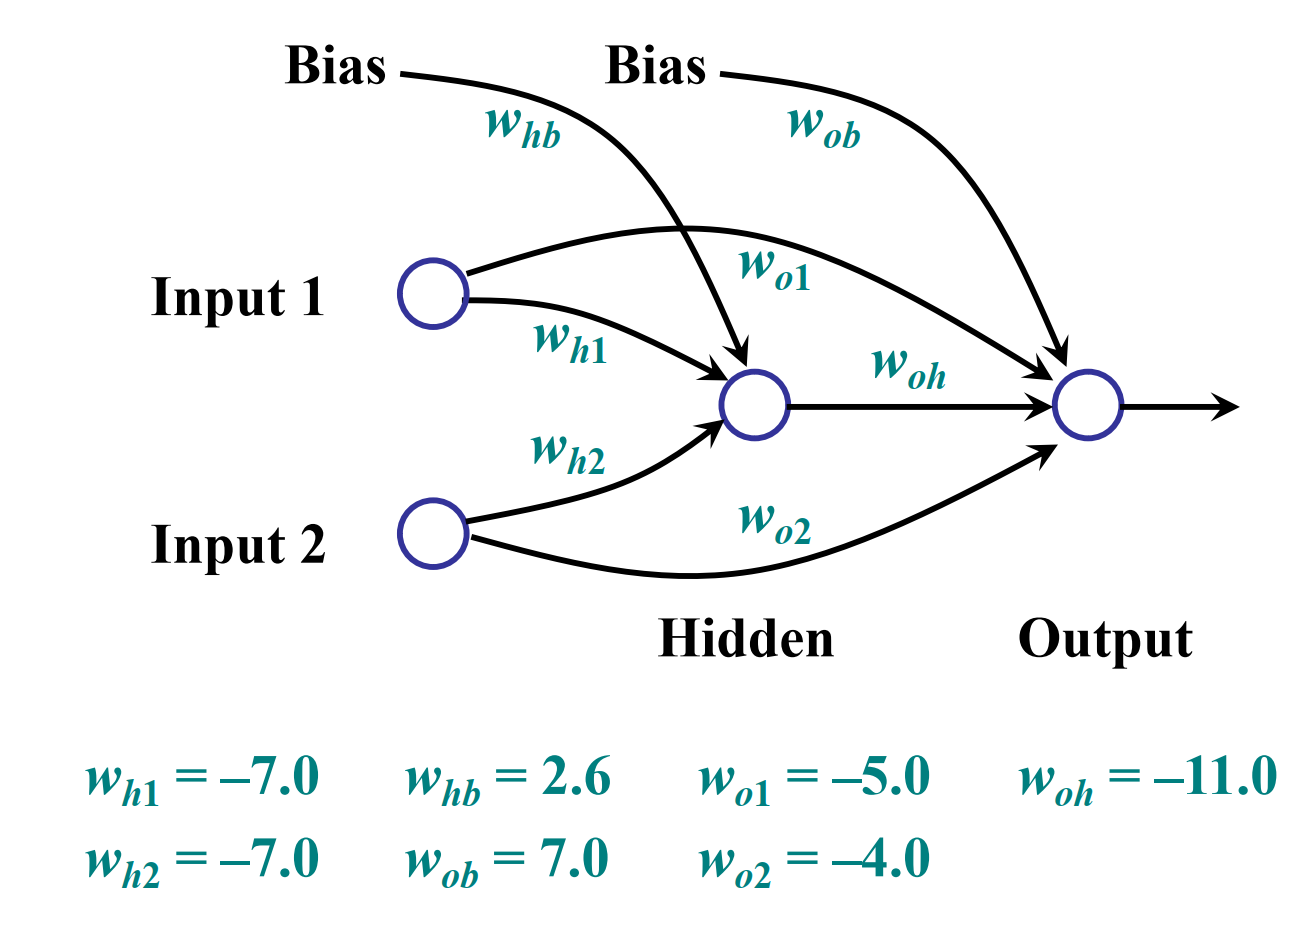
这里用了残差连接(类似于何恺明的那个残差连接的思想),使得模型更容易学习到恒等映射,从数学上简化了非线性曲面的优化难度。
反向传播算法
见笔记本
为什么梯度下降法能够下降
设损失函数为 \(L\),它在 \(\theta\) 处的一阶 Taylor 展开为: \[ L(\theta+\Delta \theta)=L(\theta)+\nabla L(\theta) \Delta \theta+o(||\Delta \theta||) \] 令 \(\Delta \theta=- \eta \nabla L(\theta)\),得 \(L(\theta+\Delta \theta)=L(\theta)-\eta ||\nabla L(\theta)||^2 < L(\theta)\)。当然我们把 \(o(||\Delta \theta||)\) 省略了; 只要步长 \(η\) 足够小,高阶无穷小项就可以忽略。