目录
- I/O 系统概述:性能、功能与操作系统角色
- I/O 设备模型与磁盘存储器
- 磁盘性能、DMA 读盘流程与 RAID
- 总线、系统互连与 I/O 接口
- I/O 端口与设备寻址
- I/O 传输方式:轮询、中断、DMA
- I/O 子系统的软件层次与驱动程序
- 总结与对比
1 I/O 系统概述
1.1 I/O 系统的性能指标
I/O 系统讨论的是计算机怎样与外部世界交换信息。这里的“外部世界”既包括键盘、鼠标、显示器、打印机等人机交互设备,也包括磁盘、网卡、声卡、A/D、D/A 等机器可读设备。衡量 I/O 系统时,需要关注两个核心性能指标:吞吐率和响应时间。
吞吐率(Throughput, I/O bandwidth)表示单位时间内系统完成了多少数据传输,或单位时间内完成了多少次 I/O 操作。视频播放、文件服务器、Web 服务器等场景很重视吞吐率,因为系统要持续不断地搬运大量数据。
响应时间(Response time, latency)表示一次 I/O 请求从发出到完成所经历的时间。事务处理系统、交互式终端、银行存取款等更关心响应时间,因为用户感受到的是“等了多久”。
这两个指标不是完全独立的。某些设计提高吞吐率时,可能会牺牲单个请求的等待时间;而过分追求短延迟,也可能降低批量传输效率。需要能根据应用场景判断主要矛盾:多媒体连续流更看重带宽,交互事务更看重延迟,服务器通常两者都要兼顾。
1.2 I/O 系统的功能
输入/输出系统的基本功能是:解决各种形式信息在主机与外设之间的输入和输出问题。用户输入文字、图像、声音、视频,计算机处理后再输出显示、打印、声音或网络数据,这些都要依靠 I/O 系统完成。
为了实现这个功能,计算机系统必须解决一组具体问题:
- 怎样在 CPU、主存和外设之间建立高效的信息传输通路。
- 怎样把用户或程序提出的 I/O 请求转换成设备能够理解的命令。
- 怎样给外设或 I/O 端口编址,使 CPU 能找到要访问的设备。
- 怎样读取设备状态,判断设备是否就绪、是否出错。
- I/O 硬件和操作系统如何协同完成数据传送。
因此,本章不是单纯讲“外设有哪些”,而是围绕三条主线展开:设备如何连接、设备如何寻址、数据如何传输。
1.3 操作系统在 I/O 系统中的角色
需要强调:I/O 系统不能只靠用户程序直接控制,操作系统(Operating System, OS)在其中非常关键。原因主要有三个。
第一,I/O 设备具有共享性。多个进程可能同时请求同一块磁盘、同一台打印机或同一个网络接口,必须由 OS 统一调度和管理,否则会造成冲突。
第二,I/O 设备具有复杂性。不同设备的控制寄存器、状态位、命令格式、错误处理方式各不相同。用户程序不应该直接面对这些细节,而应通过 OS 提供的设备驱动程序访问设备。
第三,I/O 常常依赖中断机制。外设完成任务或发生异常时,会通过外部中断请求 CPU 处理。中断会导致处理器进入内核态,因此必须由操作系统中的中断服务程序处理。
OS 在 I/O 中的职责可以概括为:权限管理、设备驱动、I/O
中断处理、共享资源调度。从用户程序角度看,调用
printf()、scanf()、read()、write()
等函数似乎很简单;但底层会经历用户态到内核态的切换、设备驱动程序执行、中断或
DMA 配合等一系列过程。
2 I/O 设备模型与磁盘存储器
2.1 外设分类
从交互方式看,外设可分为两类。
| 分类 | 含义 | 例子 |
|---|---|---|
| 人机交互设备 | 输入/输出信息是人可直接理解的 | 键盘、鼠标、扫描仪、显示器、打印机 |
| 机器可读设备 | 信息主要供机器处理,人不能直接读取 | 网络接口、Modem、D/A、A/D、磁盘、声音输入设备 |
从功能行为看,也可分为两类。
| 分类 | 主要作用 | 典型特点 |
|---|---|---|
| 输入/输出设备 | 完成信息输入或输出 | 多数是字符型设备,如键盘、打印机 |
| 外部存储设备 | 保存大量信息 | 多数按块传送,如磁盘、磁带、光盘 |
字符型设备通常一次传输一个字符或少量数据,速度较慢,适合轮询或中断方式。块设备通常一次传输一个扇区或一批数据,速度较快,适合 DMA 方式。
2.2 外部设备的通用模型
虽然外设种类很多,但 可以用一个统一抽象模型来描述。一个外设通常包含以下部分:
- I/O 接口或电缆:在设备和主机之间传送控制、状态、数据信号。
- 控制逻辑:根据主机给出的控制信息驱动设备动作,并检测设备状态。
- 缓冲器:暂存主机与设备之间交换的数据,用来缓和速度不匹配。
- 变换器:在计算机内部电信号与设备实际信号之间转换,例如磁盘中的磁-电、电-磁转换。
- 设备本体与环境:真正执行输入、输出或存储动作的物理设备。
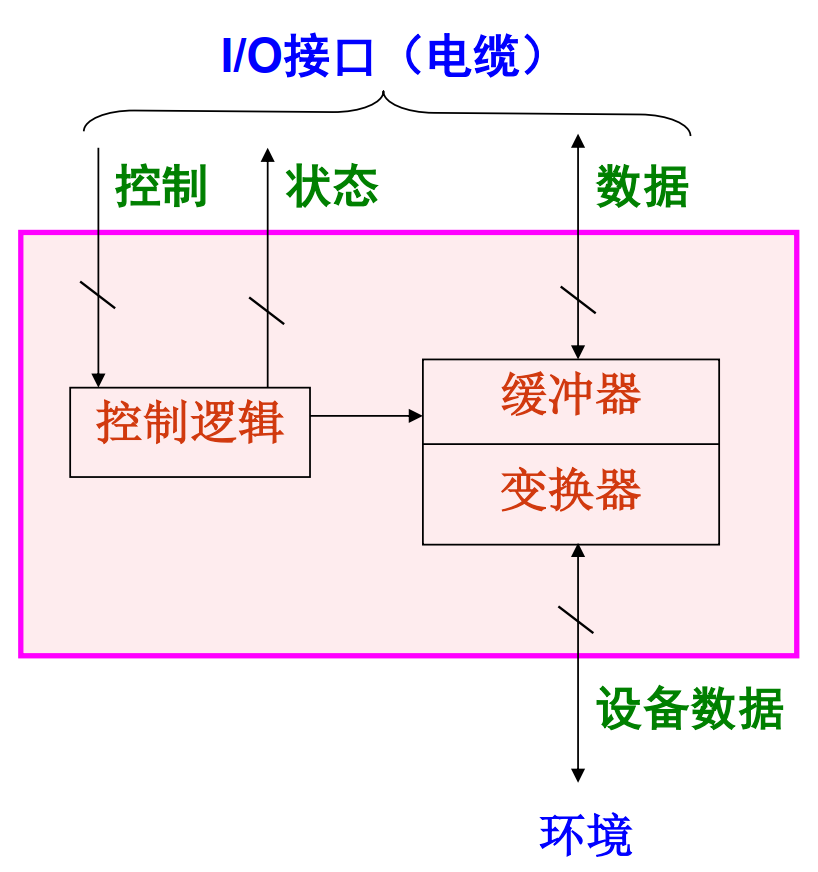
所有设备传输的信息都可以抽象为三类:控制信息、状态信息、数据信息。CPU 向设备发控制命令,设备向 CPU 返回状态,双方再通过数据缓冲完成数据交换。后面讲 I/O 控制器、I/O 端口、轮询、中断和 DMA 时,本质上都围绕这三类信息展开。
2.3 磁盘的信息存储原理
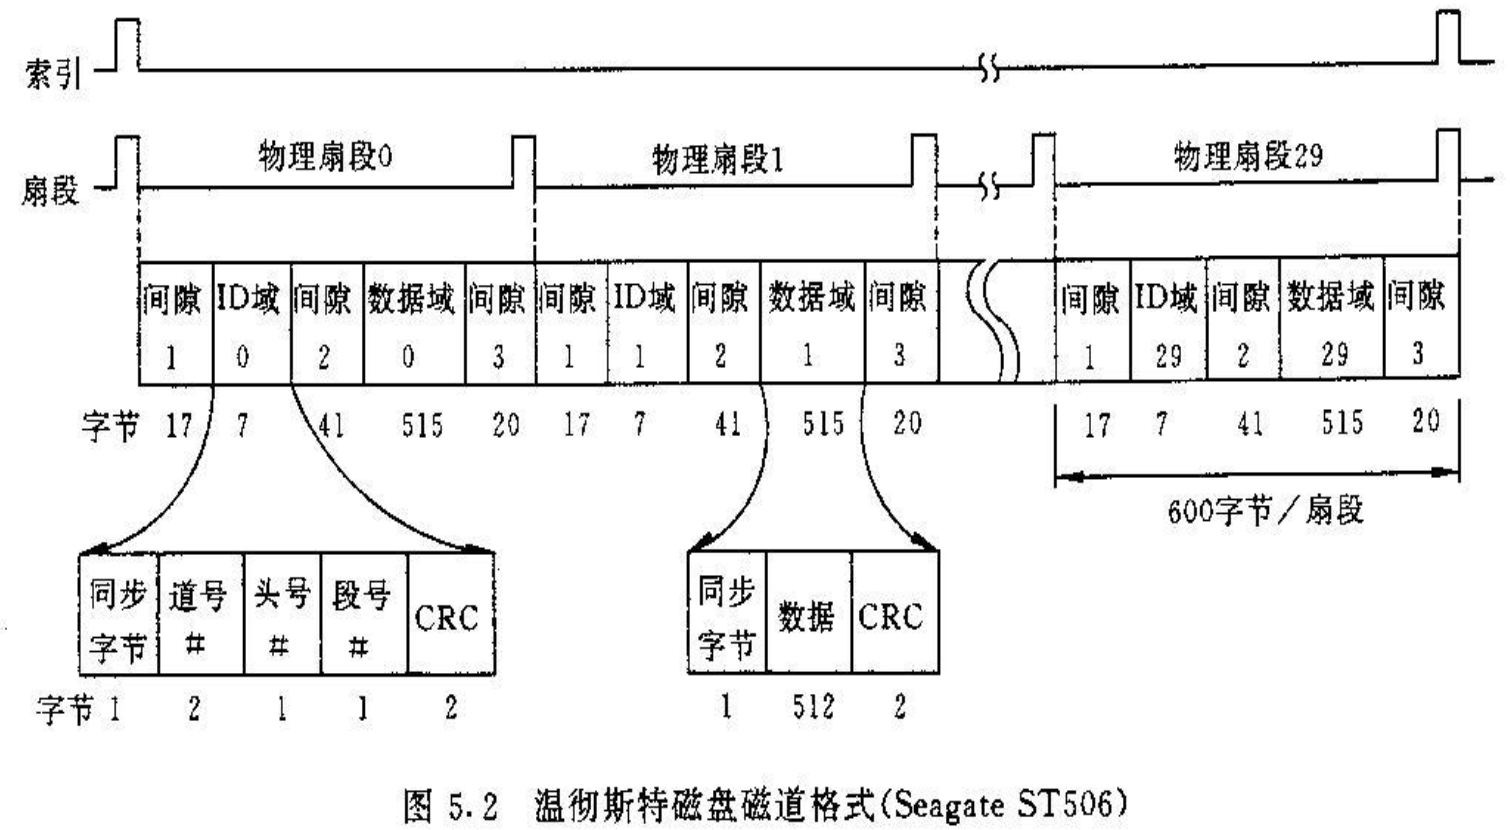
磁盘是一种典型的外部存储设备。磁盘片表面被划分为许多同心圆,每个同心圆称为磁道;每个磁道又被划分为若干段,每段称为扇区。传统扇区大小长期为 512 字节,后来逐渐迁移到 4096 字节的高级格式化扇区。
磁盘读写依赖磁头与盘片表面的磁化状态。写入时,线圈通以不同方向的电流,使磁介质呈现不同磁化状态,用来表示二进制 \(0\) 和 \(1\)。读取时,盘片旋转,磁化单元经过磁头,在磁头线圈中产生不同极性的感应电压,从而判断读出的比特。
磁盘地址通常由三部分组成:柱面号或磁道号、磁头号或盘面号、扇区号。读写一个扇区时,硬盘的大致流程是:
- 所有磁头同步寻道,移动到指定柱面。
- 选择目标磁头,即确定盘面。
- 等待目标扇区旋转到磁头下方。
- 对该扇区进行读或写。
这也解释了为什么磁盘访问比主存访问慢得多:磁盘不仅要传输数据,还要等待机械寻道和盘片旋转。
2.4 如何提高磁盘容量
提高磁盘片容量的核心是提高信息记录密度。主要有两个方向:
- 增加磁道数目,即提高磁道密度。
- 增加扇区数目,即提高位密度,并采用可变扇区数。
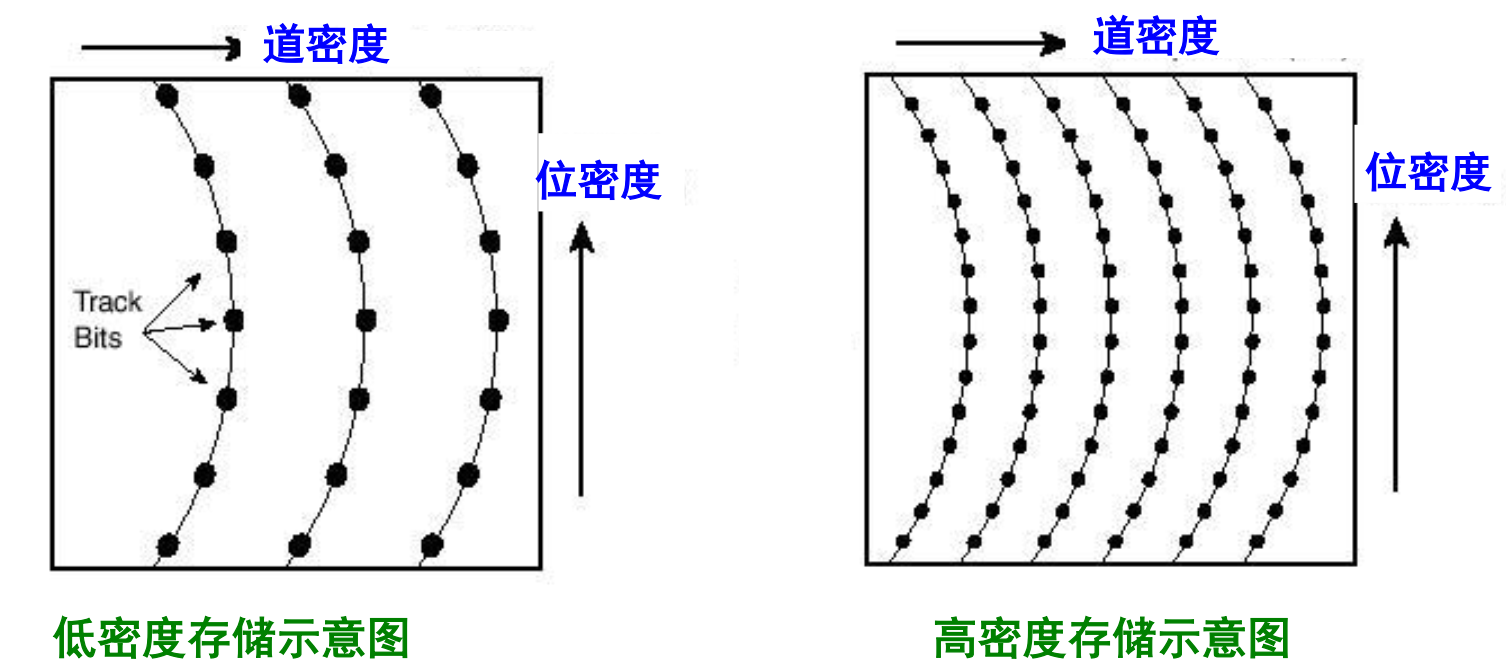
早期磁盘所有磁道扇区数相同,这会导致内圈与外圈记录密度不均。现代磁盘通常使不同磁道上的位密度更接近一致,因此外圈磁道可以放更多扇区,从而提高整个盘片容量。
3 磁盘性能、DMA 读盘流程与 RAID
3.1 磁盘平均存取时间
磁盘以扇区为单位读写。平均存取时间通常写为:
\[ T = \text{平均寻道时间} + \text{平均旋转等待时间} + \text{数据传输时间} \]
其中,平均寻道时间是磁头移动到指定磁道所需的平均时间,典型数量级约为 \(5\text{ ms}\)。平均旋转等待时间是目标扇区转到磁头下方所需的平均时间,典型值约为 \(4\sim 6\text{ ms}\)。数据传输时间通常远小于前两项,例如每扇区约 \(0.01\text{ ms}\),所以很多估算中可以近似忽略。
如果转速为 \(5400\text{ RPM}\),则每秒转数为:
\[ 5400 / 60 = 90\text{ RPS} \]
平均旋转等待时间约为半圈时间:
\[ \frac{0.5}{90}\text{ s} \approx 5.5\text{ ms} \]
假设寻道时间为 \(12\text{ ms}\),数据传输率为 \(4\text{ MB/s}\),扇区大小为 \(512\text{ B}\),控制器开销为 \(1\text{ ms}\),不考虑排队时间,则:
\[ \begin{aligned} T &= 12\text{ ms} + 5.5\text{ ms} + 0.1\text{ ms} + 1\text{ ms} \\ &= 18.6\text{ ms} \end{aligned} \]
如果实际寻道时间因访问局部性降为 \(12/3=4\text{ ms}\),总时间约为 \(10.6\text{ ms}\),此时旋转等待占比接近一半。因此,磁盘转速对机械硬盘性能非常重要。
3.2 硬盘存储器的组成
硬盘存储器主要由三部分组成:
- 磁记录介质:保存信息的盘片表面。
- 磁盘驱动器:包含读写电路、读写转换开关、读写磁头、磁头定位伺服系统等。
- 磁盘控制器:连接主机与磁盘驱动器,包含控制逻辑、时序电路、并串/串并转换、数据缓存器、控制寄存器和状态寄存器等。
磁盘控制器通常连接在 I/O 总线上,I/O 总线再通过桥接器与系统总线、存储器总线相连。由于磁盘按扇区成批读写,且数据量较大,所以磁盘通常采用 DMA(Direct Memory Access,直接存储器访问)方式在外设与主存之间传输数据。
3.3 读一个磁盘扇区的三步过程
读一个磁盘扇区的典型流程可以概括为:
- CPU 初始化磁盘控制器:CPU 向磁盘控制器写入读命令、磁盘逻辑块号、主存起始地址等参数,然后启动磁盘驱动器工作。
- 磁盘控制器读取扇区并 DMA 送主存:磁盘控制器找到相应扇区后,按 DMA 方式把数据直接送入主存,数据不经过 CPU 寄存器搬运。
- DMA 结束中断:传输完成后,磁盘控制器向 CPU 发出 DMA 结束中断请求,CPU 再执行后处理,例如检查状态、校验数据、唤醒等待进程。
这里要抓住一个关键点:CPU 负责发起和收尾,真正的大批量数据搬运由 DMA 控制器完成。
3.4 RAID 的基本思想
RAID(Redundant Arrays of Inexpensive Disk,冗余磁盘阵列)的背景是:处理器和主存性能提升很快,而单个磁盘性能提升较慢,成为系统瓶颈。RAID 的基本思想是把多个独立磁盘组织成一个磁盘阵列,在操作系统看来像一个逻辑磁盘。
RAID 通过三种方式改善系统:
- 提高容量:多个物理磁盘组合成更大的逻辑存储空间。
- 提高性能:把数据分布在多个磁盘上,多盘并行读写,类似主存多体交叉。
- 提高可靠性:用冗余校验或镜像技术,在磁盘损坏时恢复数据。
RAID 的共同特性是:一组物理磁盘在 OS 下被视为一个逻辑驱动器;数据分布在多个物理盘上;部分 RAID 级别使用冗余信息恢复故障数据。注意 RAID 0 不具备冗余,不满足第三个特性。
3.5 RAID 级别对比
| RAID 级别 | 组织方式 | 优点 | 缺点或适用场景 |
|---|---|---|---|
| RAID 0 | 数据条带化,无冗余 | 容量利用率高,读写性能好 | 无容错能力,适合非关键高速数据,如视频编辑 |
| RAID 1 | 镜像盘,一对一冗余 | 可靠性高,恢复简单;读可选更快磁盘 | 成本高,写性能受较慢盘限制 |
| RAID 2 | 小条区交叉,海明码校验 | 多盘并行,读性能高 | 校验盘数量与数据盘成比例,开销大,已基本不用 |
| RAID 3 | 小条区交叉,单独奇偶校验盘 | 大容量连续 I/O 传输率高 | 小请求响应差,校验盘参与频繁 |
| RAID 4 | 块级交叉,独立访问,单独校验盘 | 可同时响应多个读请求 | 写操作会使校验盘成为瓶颈 |
| RAID 5 | 块级交叉,校验块分布在各盘 | 避免单校验盘瓶颈,成本和性能平衡,应用广 | 小写仍有校验更新开销 |
| RAID 6 | 类似 RAID 5,但有两种冗余校验 | 可容忍双盘故障,可靠性更高 | 控制器复杂,写入速度较慢 |
| RAID 7 | 在 RAID 基础上结合 Cache | 传输率和响应速度提高 | 依赖缓存与控制器设计 |
3.5.1 RAID 4 的少量写损失
RAID 4 的典型要点是少量写的校验更新。设四个数据盘上的对应位为 \(X_0(i),X_1(i),X_2(i),X_3(i)\),校验位为:
\[ p(i)=X_3(i)\oplus X_2(i)\oplus X_1(i)\oplus X_0(i) \]
如果只把 \(X_0(i)\) 改成 \(X'_0(i)\),新校验位为:
\[ p'(i)=X_3(i)\oplus X_2(i)\oplus X_1(i)\oplus X'_0(i) \]
由于 \(X_0(i)\oplus X_0(i)=0\),可化简为:
\[ p'(i)=p(i)\oplus X_0(i)\oplus X'_0(i) \]
因此,更新一个小数据块时必须先读旧校验 \(p(i)\) 和旧数据 \(X_0(i)\),再写新数据 \(X'_0(i)\) 和新校验 \(p'(i)\)。也就是一次少量写包含两次读和两次写,这就是写损失。
3.6 固态硬盘 SSD
SSD(Solid State Disk,固态硬盘)不是磁表面存储器,而是基于 NAND 闪存的外部存储系统。它与 U 盘在原理上类似,但容量更大、性能更好。SSD 使用区块写入和擦除方式,读操作通常快于写操作;由于没有机械寻道和旋转等待,其内部传输速率远高于传统机械硬盘。
SSD 在接口规范和使用方法上与传统硬盘类似,可通过 USB、SATA、IDE 等标准磁盘接口与 I/O 总线互连。SSD 内部有闪存翻译层,把 CPU 发出的逻辑块读写请求转换为底层闪存物理操作。这个翻译层在功能上相当于磁盘控制器。
需要注意的是,闪存擦写次数有限,频繁写入会影响使用寿命。
4 总线、系统互连与 I/O 接口
4.1 总线的分类
总线是在计算机系统不同层次上提供部件连接和信息交换的通路。总线可分为三类:
| 总线类型 | 连接对象 | 特点与例子 |
|---|---|---|
| 芯片内总线 | CPU 芯片内部部件 | 连接寄存器、ALU、指令部件等 |
| 系统总线 | CPU、主存、I/O 控制器等主要部件 | 可为单总线或多总线结构 |
| 通信总线 | 主机与 I/O 设备之间,或计算机系统之间 | 多为电缆式总线,如 SCSI、RS-232、USB、PS/2 |
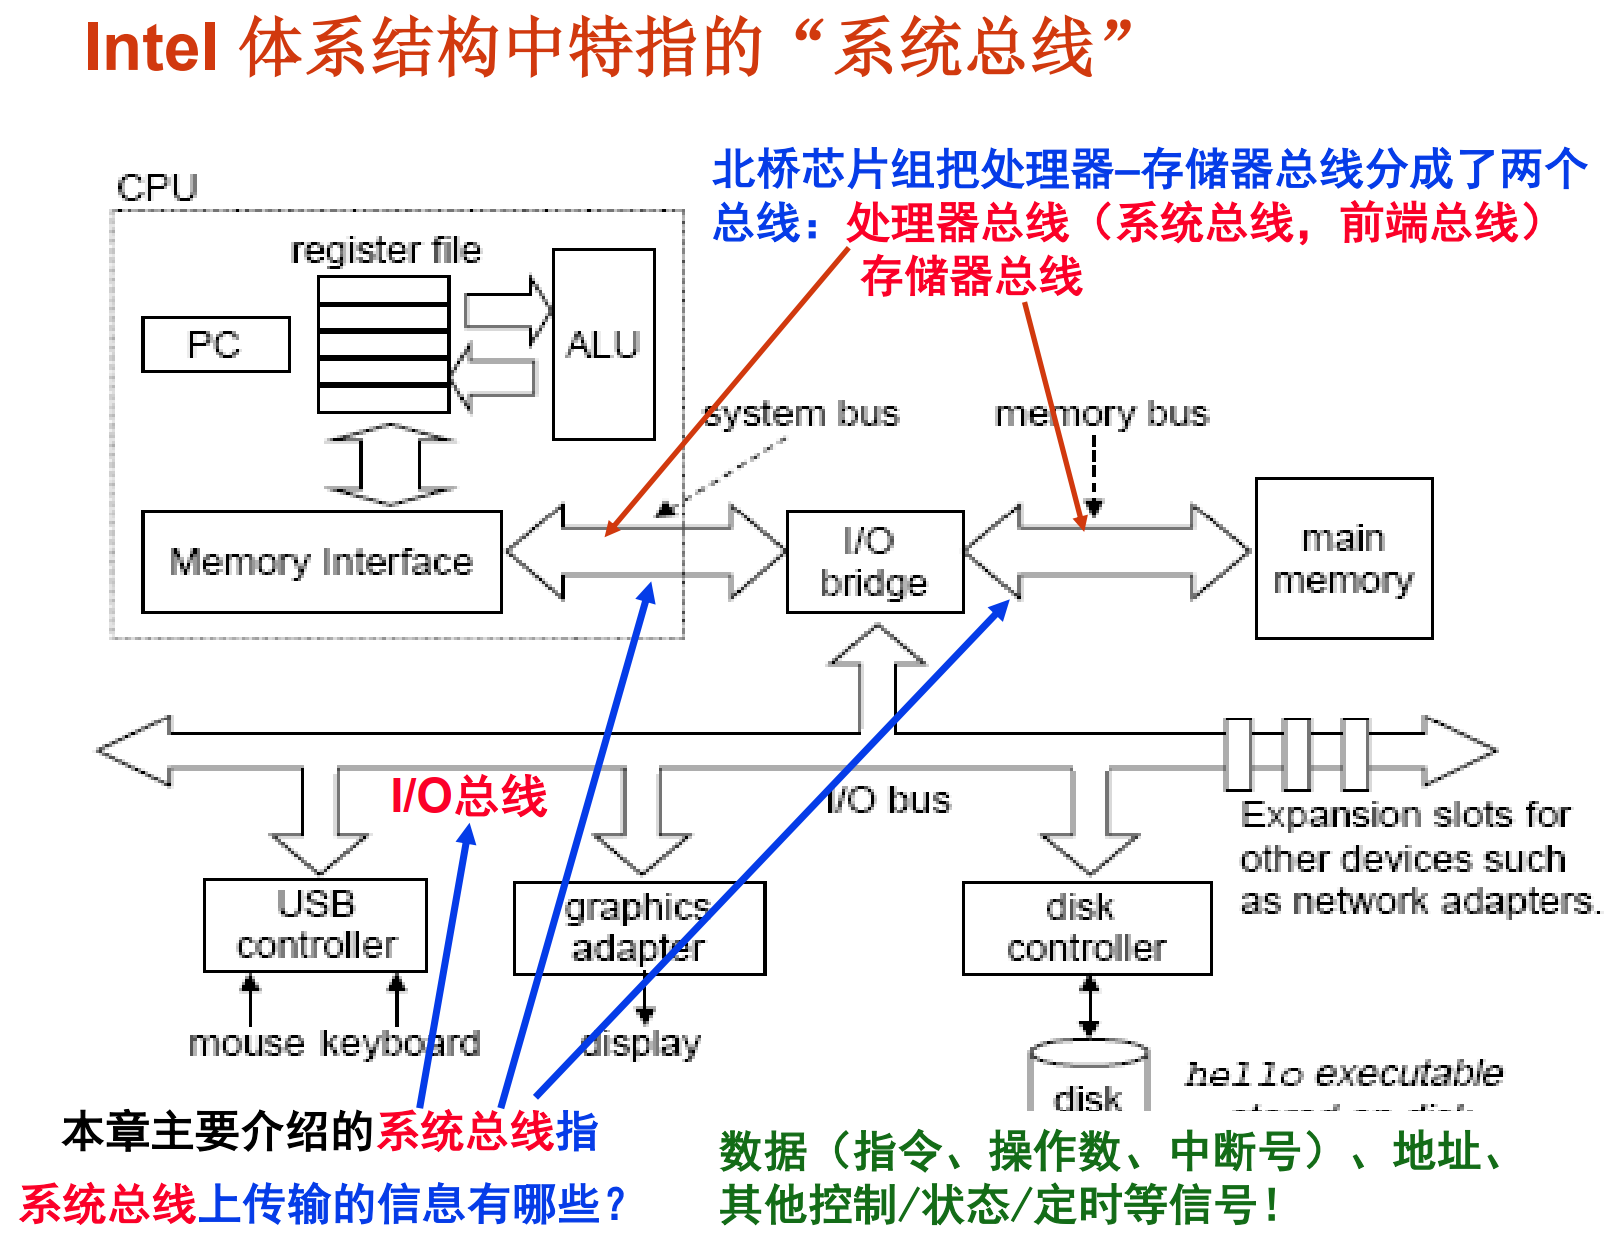
系统总线中,又可以区分处理器-存储器总线和 I/O 总线。处理器-存储器总线通常短而快,只需匹配 CPU 与内存;I/O 总线通常长而慢,要适应多种设备和标准接口。
4.2 系统总线的组成
系统总线通常由三组信号线构成:
- 数据线(Data Bus):承载源部件与目的部件之间传送的信息,宽度决定一次能传送多少位。
- 地址线(Address Bus):给出主存单元或 I/O 端口地址,宽度决定最大寻址空间。
- 控制线(Control Bus):传递定时信号和命令信息,控制数据线和地址线的使用。
典型控制信号包括时钟、复位、总线请求、总线允许、中断请求、中断回答、存储器读写、I/O 读写、传输确认等。
有些总线没有单独地址线,而是让地址和数据共享同一组线,这称为地址/数据复用。
4.3 总线的基本概念
总线裁决解决的是多个设备同时想使用共享总线时,谁先使用的问题。早期共享总线需要裁决;现代高速互连多采用点对点传输,裁决问题相对弱化。
总线定时定义总线事务中每一步何时开始、何时结束。同步总线用统一时钟控制;异步总线用握手信号控制;半同步总线结合二者。
并行传输一次在多个数据线上传多位,但位与位之间要保持同步,高速时困难较大。串行传输一次只传一位,不需要多位之间同步,现代高速总线反而常采用串行方式。发展趋势是:点对点、异步、串行。
4.4 总线性能指标
总线性能主要看三个指标:
- 总线宽度:数据线条数,决定每次传输的信息位数。
- 总线工作频率:单位时间内完成数据传送的次数。现代总线可能一个时钟周期传送 2 次或 4 次数据。
- 总线带宽:最大数据传输率。
对于同步总线,带宽公式为:
\[ B = W \times F / N \]
其中 \(W\) 是总线宽度,\(F\) 是总线时钟频率,\(N\) 是完成一次数据传送所需的时钟周期数。\(F/N\) 实际上就是总线工作频率。
总线传送方式分为非突发传送和突发传送。非突发传送每个事务都传地址,一个地址对应一次数据传送;突发传送先传一个地址,之后连续传多个数据,后续地址默认自动递增,适合成块数据传输。
4.5 处理器总线、存储器总线与 I/O 总线
早期 Intel 架构中,前端总线(Front Side Bus, FSB)位于 CPU 与北桥芯片之间,采用并行、同步传输。从 Pentium Pro 起,FSB 使用 quad pumped 技术,即一个总线时钟周期传送 4 次数据。例如工作频率 \(1333\text{ MT/s}\)、宽度 64 位时,带宽为:
\[ 1333\text{ MT/s}\times 8\text{ B}\approx 10.5\text{ GB/s} \]
QPI(Quick Path Interconnect)是高速点对点串行互连。它基于包交换,可用于 CPU 核之间、CPU 芯片之间、CPU 与 I/O Hub 之间互连。若 QPI 速度为 \(4.8\text{ GT/s}\),每次有效数据宽度约 \(2\text{ B}\),双向传输,则带宽为:
\[ 4.8\text{ G}\times 2\text{ B}\times 2 = 19.2\text{ GB/s} \]
I/O 总线为系统中各种 I/O 设备提供输入输出通道。主板扩展槽可看作 I/O 总线的物理形式。I/O 总线的发展大致为:
- 第一代:ISA/EISA、VESA,已淘汰。
- 第二代:PCI、AGP、PCI-X,逐渐淘汰。
- 第三代:PCI-Express,串行总线,主流。
PCI-Express 使用链路(link)连接设备,每个链路含多条通路(lane)。PCIe \(\times n\) 表示有 \(n\) 条通路。以 PCIe 1.0 为例,每条通路发送和接收速率均为 \(2.5\text{ Gb/s}\),每个数据字节编码为 10 位传输,因此带宽为:
\[ 2.5\text{ Gb/s}\times 2\times n / 10 = 0.5\text{ GB/s}\times n \]
所以 PCIe \(\times 16\) 的双向总带宽可达 \(8\text{ GB/s}\)。
4.6 I/O 总线、I/O 控制器与 I/O 设备的关系
这些关系可以概括为:
- I/O 设备通常通过通信总线或电缆连接到 I/O 控制器。
- I/O 控制器,也称 I/O 接口,可通过扩展卡或南桥芯片连接到 I/O 总线。
- I/O 总线再通过桥接芯片与 CPU、内存所在的更高速互连结构相连。
因此要区分两个“连接层次”:主板内部的 PCIe 等是 I/O 总线;设备外部的 USB、SATA、PS/2、网线等常体现为设备侧通信总线或连接接口。
5 I/O 接口、端口与设备寻址
5.1 I/O 接口的含义与分类
这里把 I/O 控制器和插座合起来称为 I/O 接口。例如网卡、显卡、键盘适配器、磁盘控制器,以及它们对应的连接器,都可视为 I/O 接口的一部分。I/O 接口包括插头/插座形式、通信规程、电气特性和控制逻辑。
I/O 接口可按多个角度分类:
| 分类角度 | 类型 |
|---|---|
| 数据传输方式 | 串行接口(一次只传输1位)、并行接口(多位一起进行传输) |
| 是否能连接多个设备 | 总线式接口(可连接多个设备)、独占式接口(只能连接1个设备) |
| 是否符合标准 | 标准接口、专用接口 |
| 功能是否可灵活选择 | 可编程接口、不可编程接口 |
5.2 I/O 控制器的职能
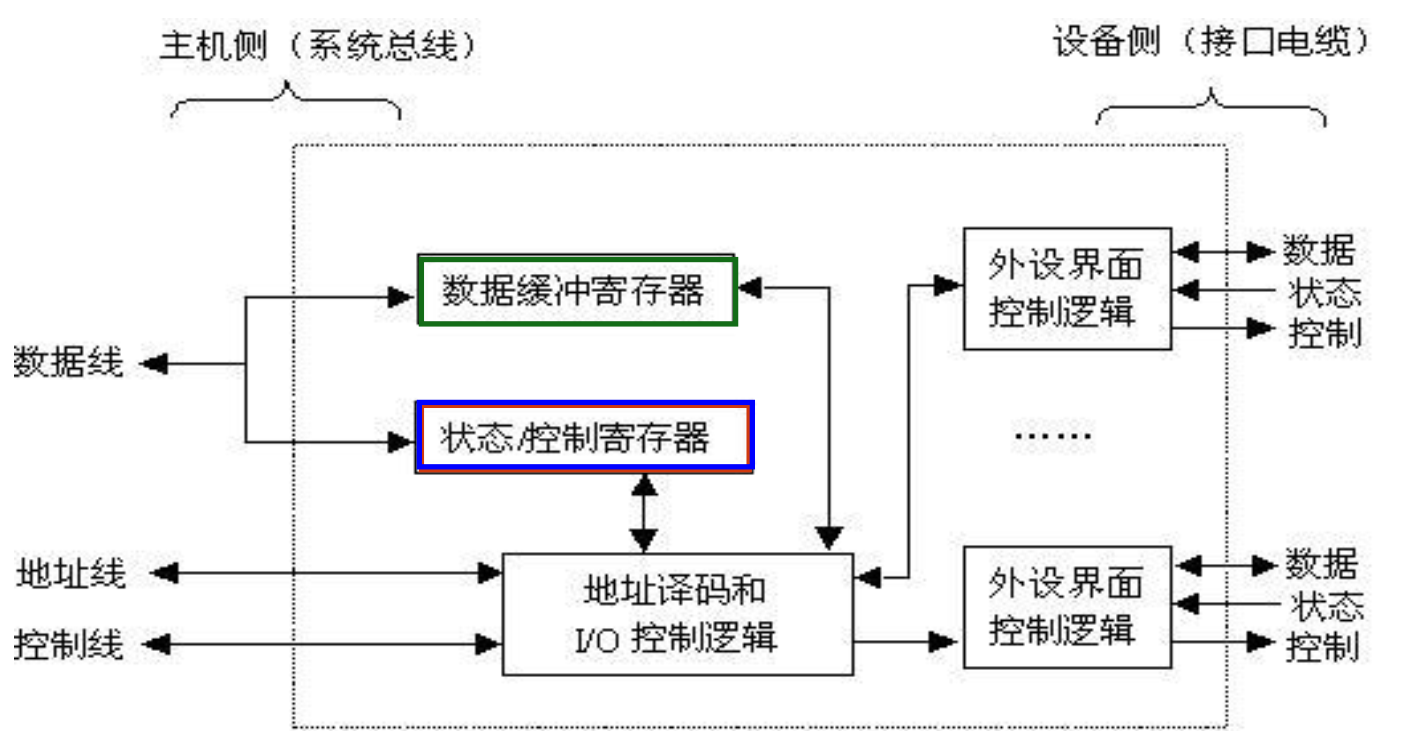
I/O 控制器承担主机与设备之间的转换、缓冲和控制工作。它的主要职能包括:
- 数据缓冲:用数据缓冲寄存器匹配主机和外设速度。
- 状态或错误检测:用状态寄存器保存就绪、忙、出错等信息。
- 控制和定时:接受系统总线来的控制定时信号,并按设备要求产生控制动作。
- 数据格式转换:例如串并转换、并串转换、电平或编码转换。
- 主机与设备通信:在主机侧接收 CPU 命令,在设备侧驱动外设动作。
CPU 通过写控制寄存器向设备发命令,通过读状态寄存器了解设备状态,通过读写数据寄存器交换数据。
5.3 I/O 端口的概念
I/O 控制器中 CPU 能够访问的各类寄存器称为 I/O 端口。常见端口包括:
- 数据端口:用于读写设备数据。
- 状态端口:用于读取设备状态和错误标志。
- 控制端口:用于写入命令或控制字。
对外设的访问,本质上就是对这些 I/O 端口进行读写:向端口发命令、读状态、读数据或写数据。一个 I/O 控制器可能占有多个端口地址,因此必须给 I/O 端口编号,CPU 才能访问它们。
5.4 I/O 设备寻址方式
I/O 设备寻址方式就是 I/O 端口的编号方式。有两种基本方案:统一编址和独立编址。
| 方式 | 又称 | 地址空间 | 指令特点 | 例子 |
|---|---|---|---|---|
| 统一编址 | 内存映射 I/O | I/O 端口与主存统一编址 | 用普通访存指令访问 I/O 端口 | RISC 机器、Motorola 处理器等 |
| 独立编址 | 特殊 I/O 指令方式 | I/O 端口有独立地址空间 | 需要专门 I/O 指令,如
IN、OUT |
Intel、Zilog 处理器 |
统一编址方式下,I/O 端口被映射到主存地址空间的一部分。CPU 不需要专门 I/O 指令,只要用普通读写内存指令访问特定地址范围,就能读写 I/O 端口。它的优点是指令系统简单,访存机制统一;缺点是会占用部分主存地址空间,且需要通过地址范围区分访问对象。
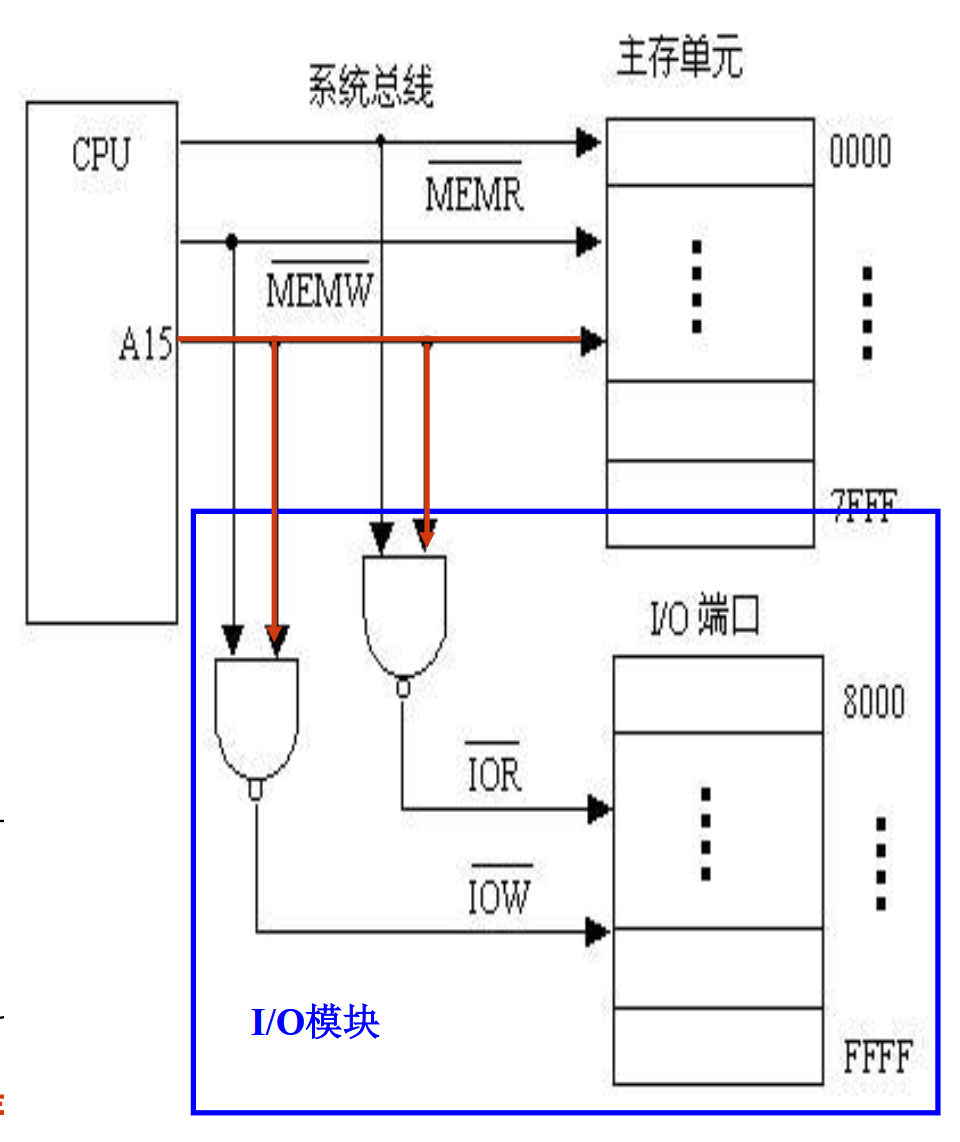
独立编址方式下,I/O 地址空间与主存地址空间分开。CPU 通过不同控制信号区分 I/O 读写和存储器读写,例如 IOR、IOW 与 MEMR、MEMW。由于 I/O 端口数量通常远少于存储器单元,端口寻址只需较少地址线。缺点是指令系统必须提供专门 I/O 指令。
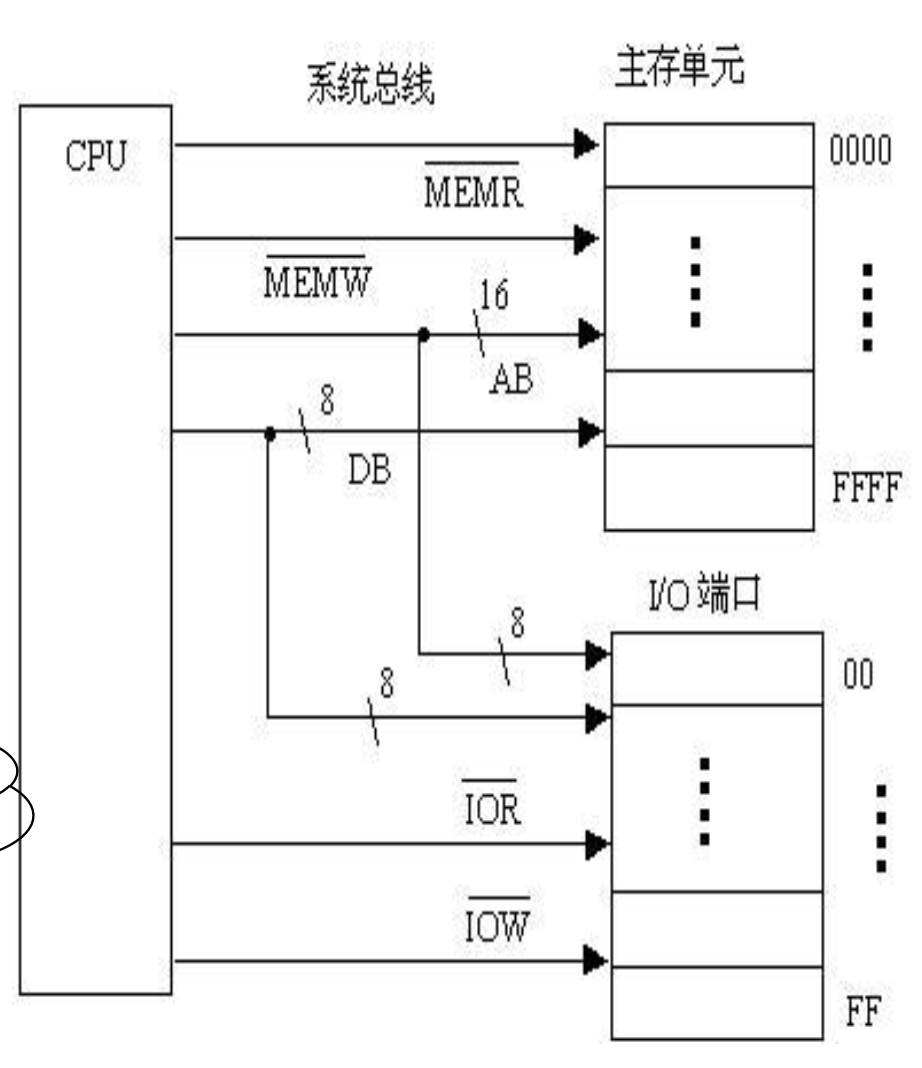
奔腾机采用独立编址方式,I/O 地址空间由 \(2^{16}\) 个 8 位端口组成,即 64K 个端口。两个连续 8 位端口可组成 16 位端口,四个连续 8 位端口可组成 32 位端口。
6 I/O 传输方式
6.1 三种基本数据交换方式
I/O 设备与主机之间的数据交换有三种基本方式:
| 方式 | 核心机制 | CPU 参与程度 | 适用设备 |
|---|---|---|---|
| 程序直接控制方式 | CPU 主动查询或按时序传送 | 很高,CPU 常处于等待状态 | 简单慢速设备 |
| 中断 I/O 方式 | 外设完成或需要服务时主动中断 CPU | 中等,CPU 执行中断服务程序传数据 | 低速或中速设备 |
| DMA 方式 | DMA 控制器控制总线,外设与主存直接传送 | 很低,CPU 主要负责初始化和结束处理 | 磁盘等高速块设备 |
这三种方式的根本区别是:数据传送由谁完成,以及 CPU 是否需要持续等待。
6.2 程序直接控制或轮询方式
程序直接控制方式是最简单的 I/O 方式。它可以是无条件传送,也可以是条件传送。条件传送又称 轮询(Polling)或程序查询方式。
轮询的基本思想是:I/O 设备把自己的状态放到状态寄存器中,OS 或驱动程序反复读取状态寄存器,检查特定位是否表示“就绪”。如果未就绪,就继续查询;如果就绪,就进行下一步数据传送或发送控制命令。
以打印机为例,“就绪”通常表示打印控制器的数据缓冲区已经空,可以接受新的打印字符。CPU 执行 I/O 指令把字符送到数据端口,再检查状态位、发送启动信号。
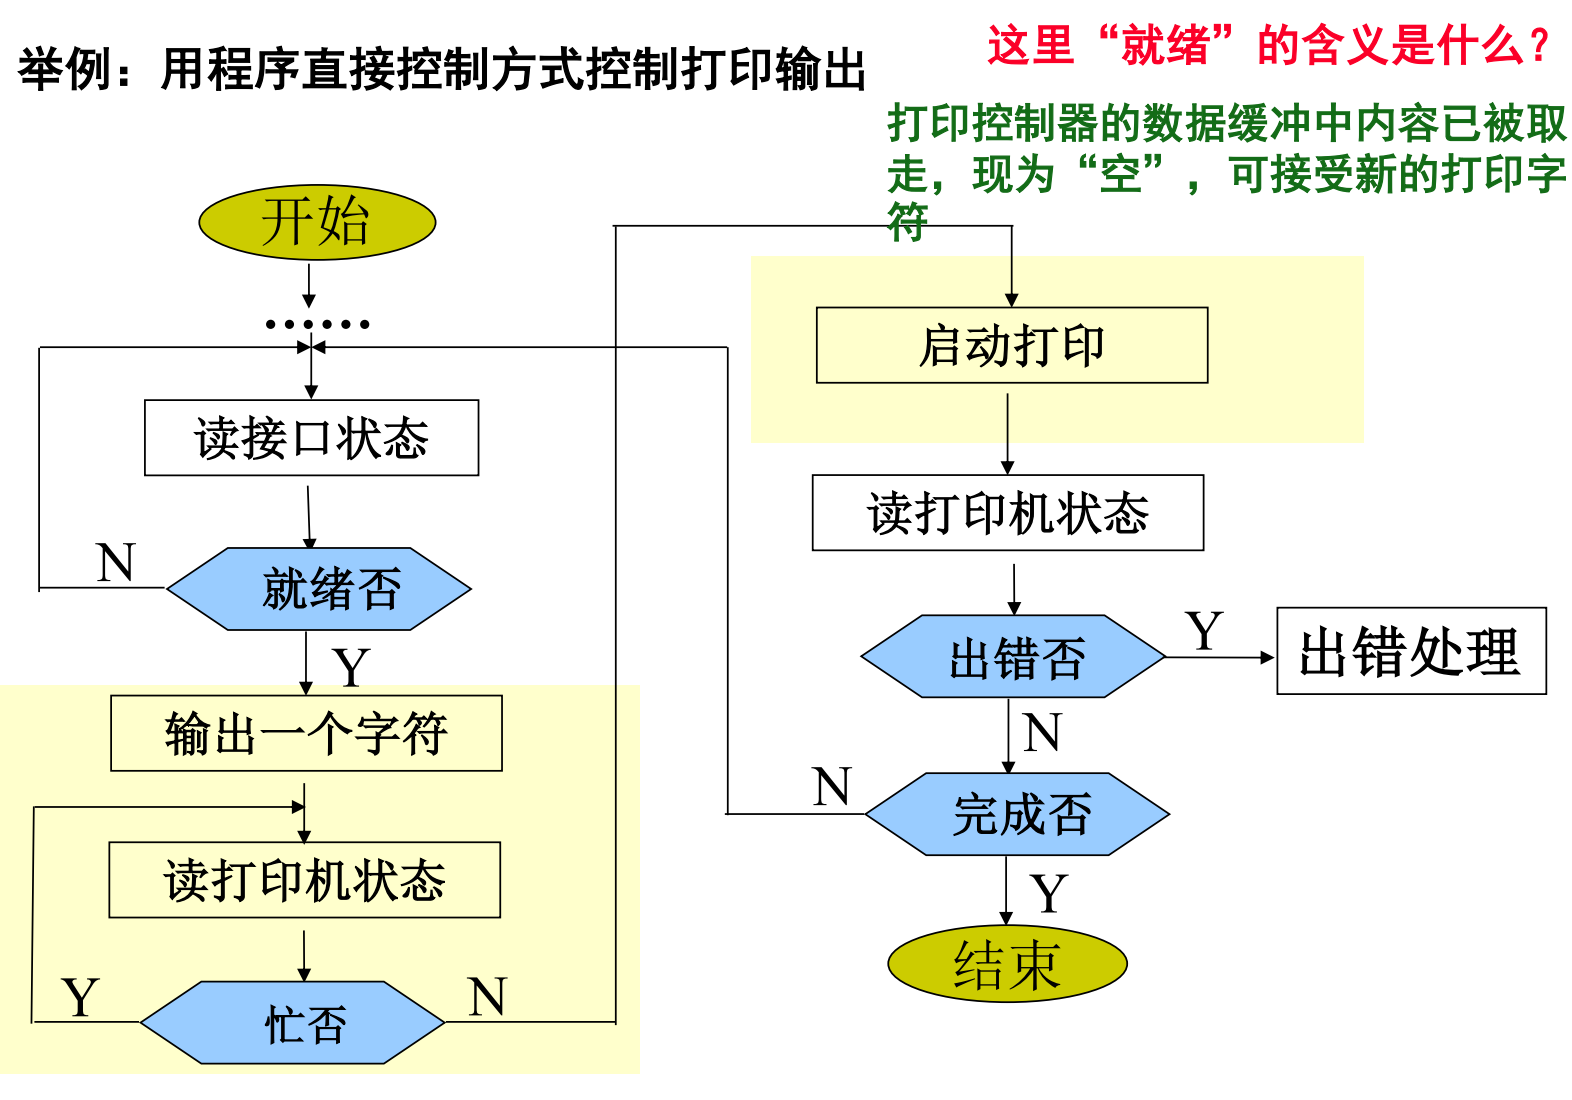
6.2.1 打印输出标准子程序例子
下面这个采用程序查询方式打印 AL 寄存器中字符的 8086
风格子程序,很好地说明了轮询 I/O
的三个动作:写数据端口、读状态端口、写控制端口启动设备。
1 | PRINT PROC NEAR |
这段程序开始用 PUSH AX 和 PUSH DX
保护现场,因为子程序会改写 AX 和 DX。随后
MOV DX, 378H
把打印机数据锁存器端口地址送入
DX,OUT DX, AL
将待打印字符写入数据端口。这里的 OUT 就是访问 I/O
端口的输出指令。
接着程序把 DX 改为
379H,这是打印机状态寄存器端口地址。标号
WAIT 处反复执行 IN AL, DX 和
TEST AL, 80H:前者从状态端口读入打印机状态,后者检查状态字中的忙碌位。如果检测结果表示打印机仍忙,JE WAIT
就跳回继续查询;只有状态满足要求时,程序才退出等待循环。因此,这几条指令正体现了程序查询方式的“踏步”特征:CPU
没有停机,但它一直在执行读状态、测试、条件跳转。
最后程序把 DX 改为
37AH,即控制寄存器端口地址,先输出
0DH 使选通位置 1,再输出 0CH 使选通位置
0。这个 1 到 0
的变化相当于向打印控制器发出一次启动或选通信号,通知设备开始处理刚才写入的数据。末尾用
POP DX、POP AX 恢复现场并返回。
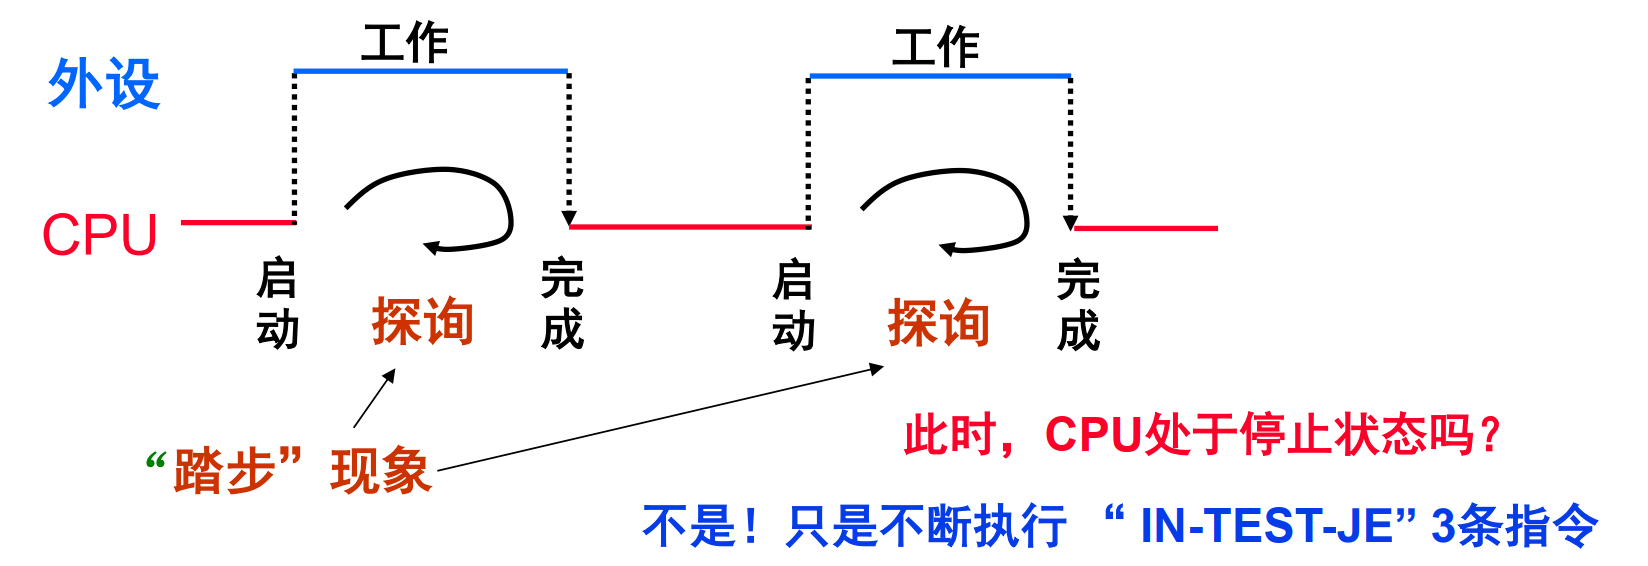
程序直接控制方式的优点是简单、控制容易、接口硬件少。缺点也很明显:CPU 与外设串行工作,效率低;查询期间 CPU 不停执行类似“读状态、测试、跳转”的指令,形成所谓的踏步现象。如果一直独占查询,CPU 几乎 100% 时间都在为 I/O 服务。
6.3 中断 I/O 方式
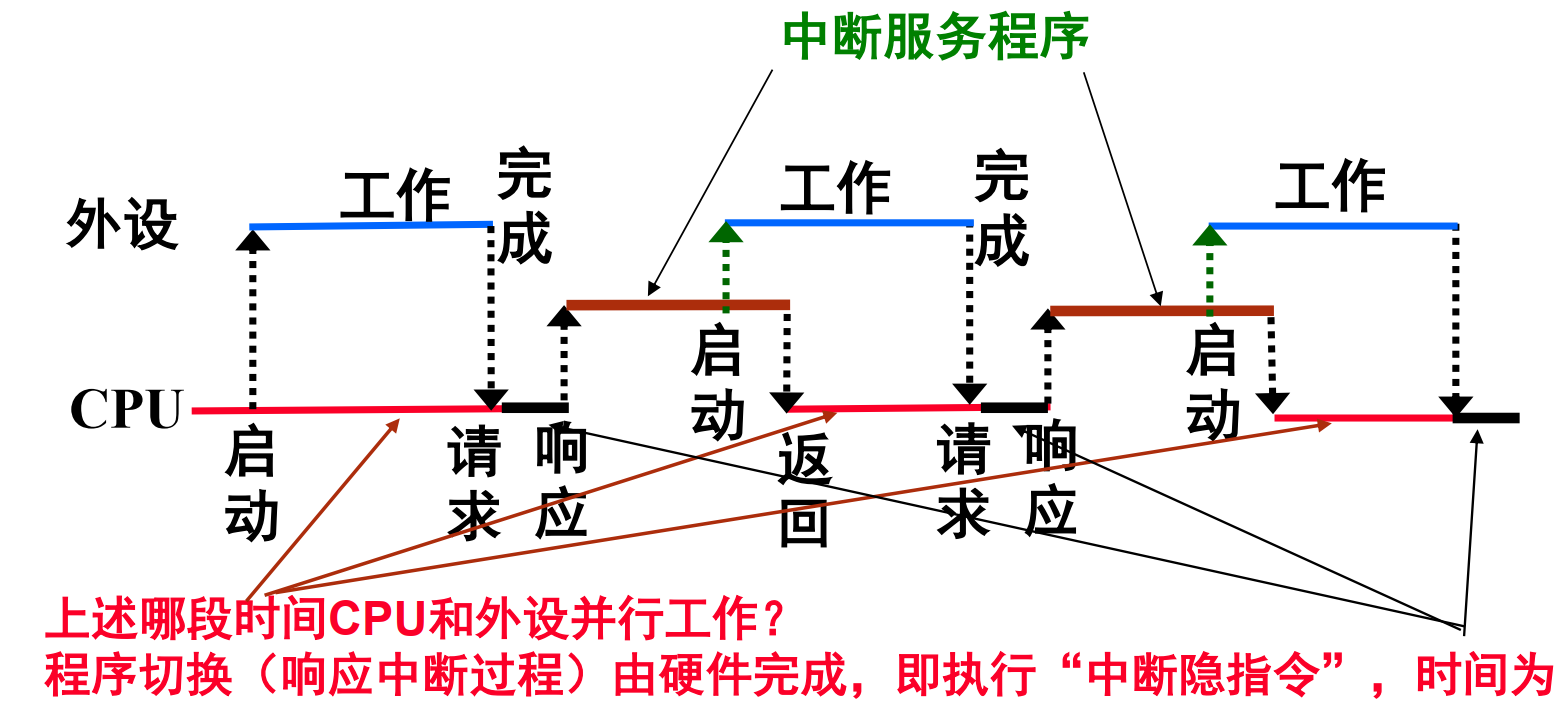
中断 I/O 的基本思想是:CPU 启动外设后,不必一直等待。外设完成任务或需要 CPU 干预时,主动向 CPU 发中断请求。CPU 响应后暂停当前程序,转入操作系统中的中断服务程序;处理结束后,再返回被中断程序继续执行。
中断方式下,外设工作期间 CPU 可以执行其他程序,所以 CPU 与外设具有一定并行性。与轮询相比,它显著降低了 CPU 无意义等待的时间。
6.3.1 中断响应条件
中断响应是硬件过程,指 CPU 发现外部中断请求、中止现行程序并调出中断服务程序。需要满足三个条件:
- CPU 处于开中断状态。
- 当前指令执行完毕。
- 至少存在一个未被屏蔽的中断请求。
外部中断通常在指令执行结束时响应;而内部异常发生在指令执行过程中,不能简单等到指令结束后再处理。这是中断与异常处理时点的重要区别。
6.3.2 中断响应过程
中断响应由处理器硬件完成,可看作执行一条“中断隐指令”。它主要完成三件事:
- 关中断:清除中断允许标志,防止响应过程本身被打断。
- 保护断点和程序状态:保存 PC 和 PSW,常保存到堆栈或特殊寄存器,如 EPC、EPSWR。
- 识别中断源并转入服务程序:获得中断服务程序入口地址和初始状态,装入 PC 和 PSW。
识别中断源有两种方法:
- 软件识别:进入统一异常/中断处理入口后,由 OS 查询异常原因寄存器或中断请求状态。例如 MIPS 可通过 Cause 寄存器识别异常原因。
- 硬件识别或向量中断:中断控制器通过优先级电路得到中断类型号,CPU 根据中断类型号查中断向量表,取得服务程序入口地址。例如 8086/8088 的中断向量表有 256 项,每项 4 字节,向量地址为“中断类型号 \(\times 4\)”。
以 8086/8088
为例,中断向量表也称中断入口地址表或异常表,位于物理地址
0000H~03FFH。这段空间一共 \(1024\) 字节,被划分为 \(256\) 组,每组占 \(4\)
字节,用来保存一个中断服务程序的入口地址。8086/8088 的程序入口地址由
CS:IP 表示,因此每个中断向量表项保存的就是对应服务程序的
CS:IP。
中断类型号和中断向量表地址之间的关系非常直接:
\[ \text{向量地址}=\text{中断类型号}\times 4 \]
例如,除法错的中断类型号为 \(0\),所以它的向量地址为 \(0\times4=0\),对应中断向量表的
00H~03H。单步中断类型号为 \(1\),对应 04H~07H。NMI
的中断类型号为 \(2\),所以向量地址为
\(2\times4=8\),对应
08H~0BH。
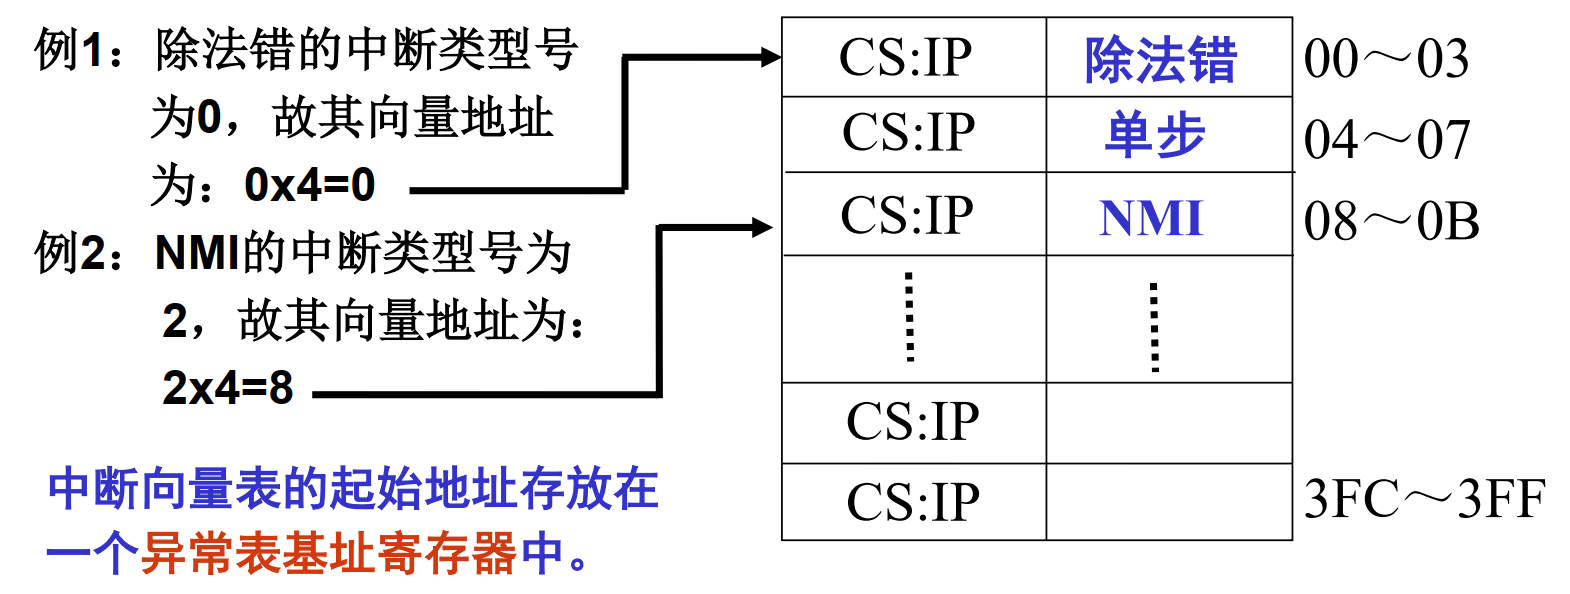
因此,向量中断的完整思路是:硬件先得到中断类型号,再用“类型号
\(\times 4\)”查中断向量表,取出
CS:IP,最后转到相应中断服务程序执行。进一步的问题是“中断类型号怎么得到”。这正好引出后面的中断控制器:中断控制器通过请求锁存、屏蔽和优先级编码,向
CPU 提供中断类型号。
6.4 中断控制器与 8259A
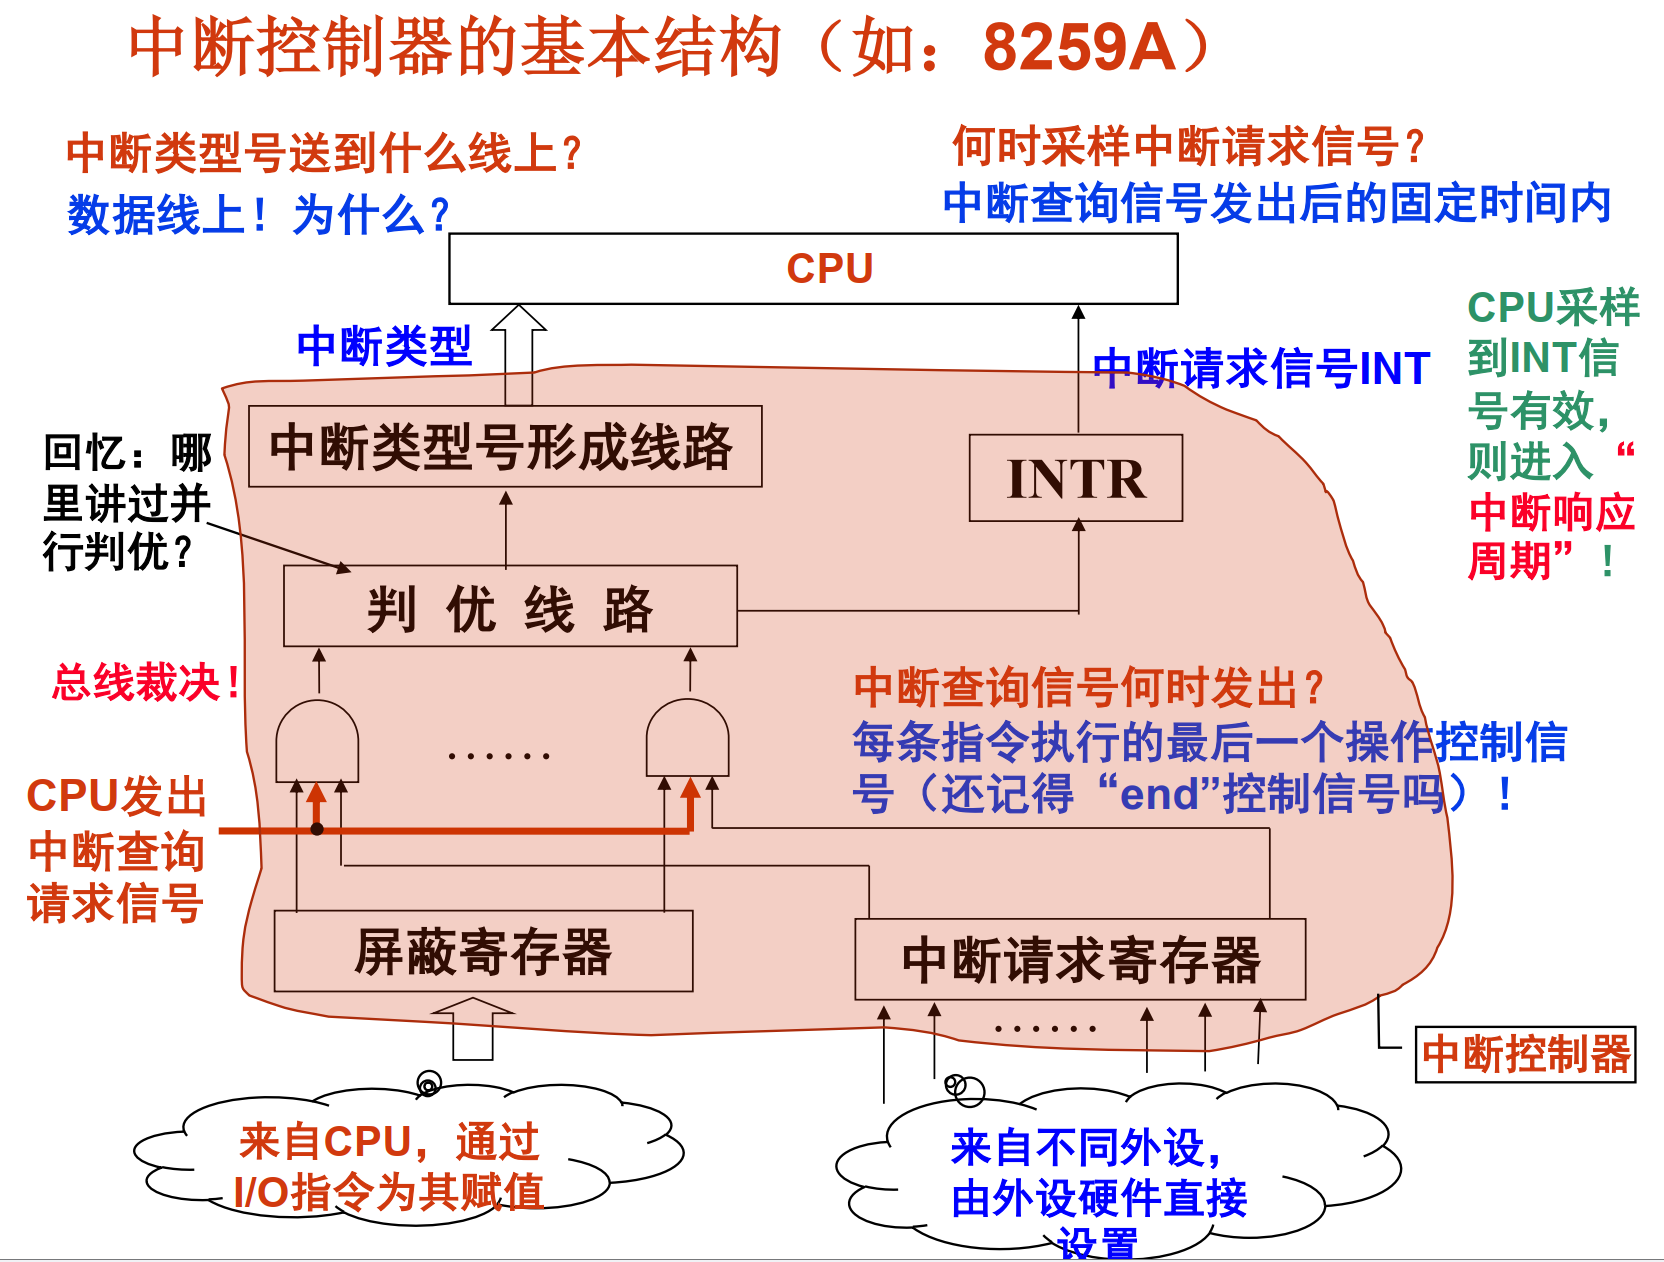
中断控制器负责接收多个外设的中断请求,进行屏蔽和优先级判断,并向 CPU 提供最高优先级中断的信息。其基本部件包括:
- 中断请求寄存器:记录来自不同外设的请求。
- 屏蔽寄存器:由 CPU 通过 I/O 指令设置,用来屏蔽部分中断。
- 判优线路:从未屏蔽请求中选择优先级最高者。
- 中断类型号形成线路:生成中断类型号并送到数据线上。
8259A 是典型可编程中断控制器。它支持中断请求锁存、中断屏蔽、优先级排队、中断优先权编码;既支持程序查询式中断,也支持向量式中断;单片支持 8 级中断,多片级联最多可构成 64 级中断。
6.5 中断处理过程与多重中断
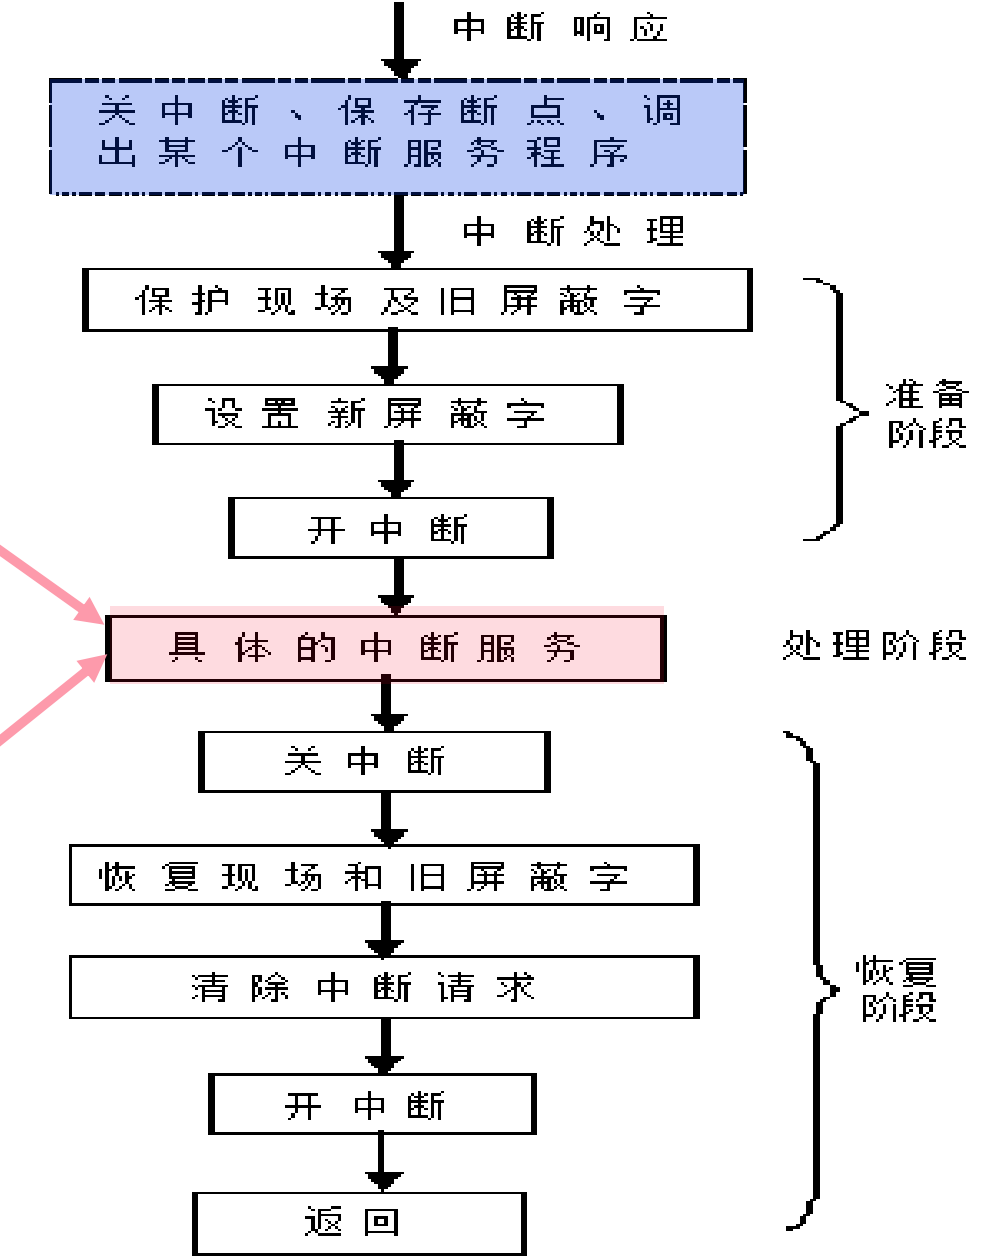
中断全过程可分为中断响应和中断处理。中断响应由硬件完成;中断处理是执行中断服务程序,由软件完成。
典型多重中断服务程序可分为三段:
- 先行段或准备阶段:保护现场和旧屏蔽字,查明原因,设置新屏蔽字,开中断。该阶段通常禁止被打断。
- 本体段:进行具体 I/O 处理。此时可允许更高处理优先级的中断打断。
- 结束段或恢复阶段:关中断,恢复现场和旧屏蔽字,清除中断请求,开中断并中断返回。该阶段也不允许被打断。
多重中断指在处理某个中断时,又发生新的更高优先级中断请求,CPU 暂停当前中断服务程序,转去处理新中断,处理完后再返回原中断服务程序。
这里要区分两个优先级:
- 中断响应优先级:多个中断同时请求时,硬件或查询程序先响应谁。
- 中断处理优先级:通过中断屏蔽字动态设定,决定一个中断服务程序执行期间允许哪些中断打断它。
响应优先级是“同时来时先接谁”,处理优先级是“正在处理时谁能插队”。
6.6 示例:中断优先权的动态分配
一个典型示例可以用来说明响应优先级和处理优先级不是同一件事。
题设如下:某中断系统有四个中断源,响应优先级固定为:
\[ 1>2>3>4 \]
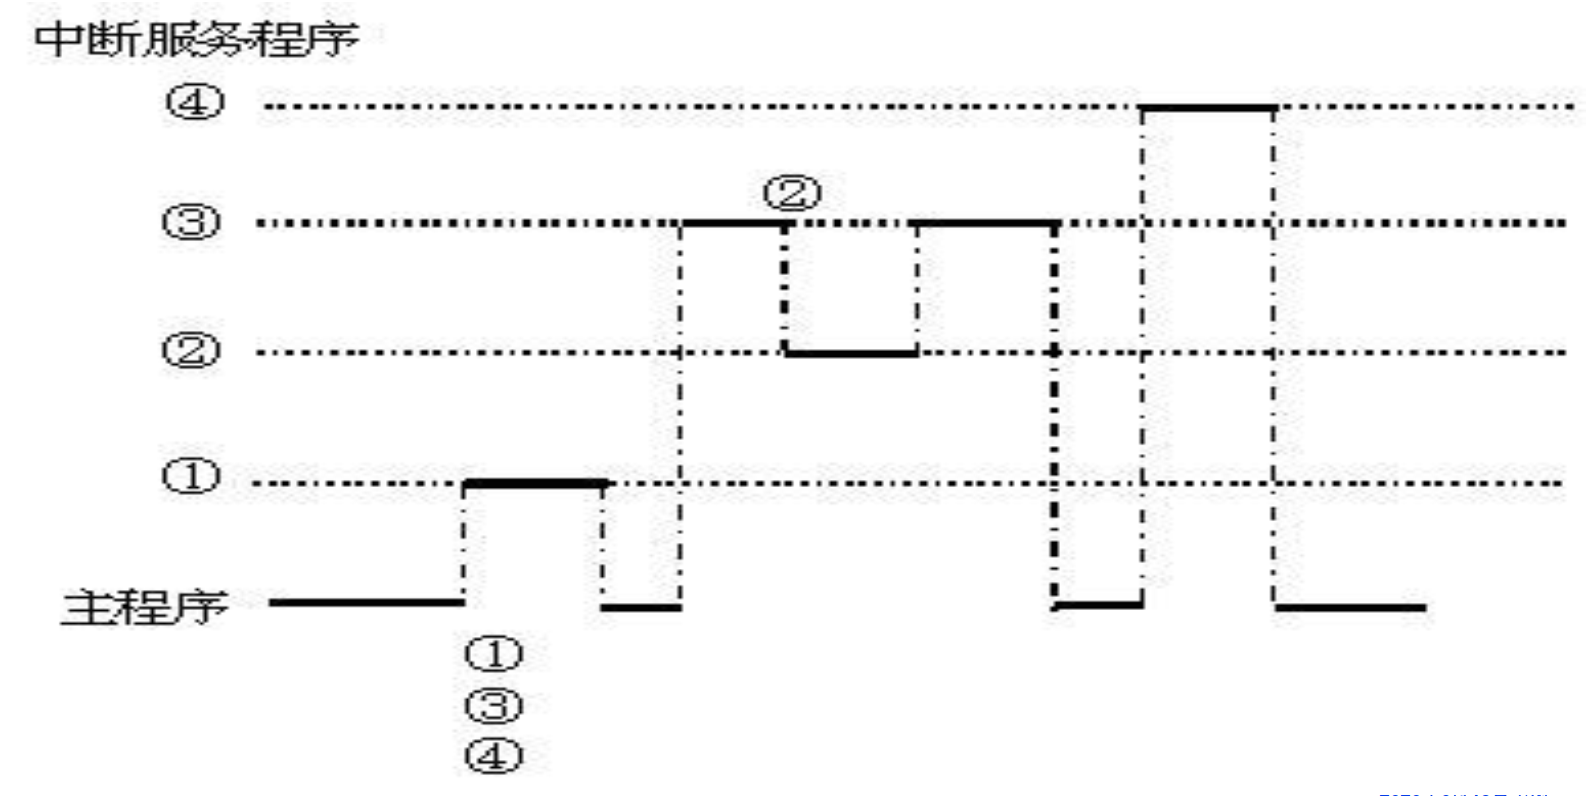
在用户程序执行时,\(1\)、\(3\)、\(4\) 级中断请求同时发生;当 CPU 正在执行 \(3\) 级中断服务程序时,又发生 \(2\) 级中断请求。要求分别写出处理优先级为 \(1>2>3>4\) 和 \(1>4>3>2\) 时,各中断的屏蔽字以及 CPU 完成中断处理的过程。
这里约定:屏蔽字中 1 表示屏蔽,0 表示开放。某一级中断服务程序开始执行后,会设置本级对应的屏蔽字;若某个新中断源对应位为 0,并且系统处于开中断状态,它就可能打断当前中断服务程序。
6.6.1 处理优先级为 \(1>2>3>4\)
当处理优先级与响应优先级相同,即:
\[ 1>2>3>4 \]
屏蔽字可写为:
| 正在执行的中断服务程序级别 | 1 级 | 2 级 | 3 级 | 4 级 |
|---|---|---|---|---|
| 第 1 级 | 1 | 1 | 1 | 1 |
| 第 2 级 | 0 | 1 | 1 | 1 |
| 第 3 级 | 0 | 0 | 1 | 1 |
| 第 4 级 | 0 | 0 | 0 | 1 |
这张表的含义是:正在处理某一级中断时,比它优先级更高的中断开放,比它优先级相同或更低的中断屏蔽。例如执行 3 级中断服务程序时,1 级和 2 级开放,3 级和 4 级屏蔽,所以 2 级中断可以打断 3 级中断。
CPU 的处理过程如下:
- 用户程序执行时,1、3、4 级中断同时请求。由于响应优先级为 \(1>2>3>4\),CPU 首先响应 1 级中断。
- 1 级中断服务程序的屏蔽字为
1111,执行期间屏蔽所有中断,故 3、4 级只能等待。 - 1 级中断处理结束后,待处理请求中还有 3、4 级。按响应优先级,CPU 响应 3 级中断。
- 执行 3 级中断服务程序时,屏蔽字为
0011,即 1、2 级开放,3、4 级屏蔽。此时发生 2 级中断请求,由于 2 级开放且处理优先级高于 3 级,所以 2 级中断打断 3 级中断。 - 2 级中断服务程序执行完后,CPU 返回被打断的 3 级中断服务程序继续执行。
- 3 级中断结束后,最后处理等待中的 4 级中断。
因此,这种情况下的主要处理顺序可概括为:
\[ \text{主程序}\rightarrow 1 \rightarrow 3 \rightarrow 2 \rightarrow 3 \rightarrow 4 \rightarrow \text{主程序} \]
如果只看各级中断完成的先后顺序,则是:
\[ 1,\ 2,\ 3,\ 4 \]
6.6.2 处理优先级为 \(1>4>3>2\)
第二种情况中,响应优先级仍然是:
\[ 1>2>3>4 \]
但处理优先级被动态设置为:
\[ 1>4>3>2 \]
此时屏蔽字变为:
| 正在执行的中断服务程序级别 | 1 级 | 2 级 | 3 级 | 4 级 |
|---|---|---|---|---|
| 第 1 级 | 1 | 1 | 1 | 1 |
| 第 2 级 | 0 | 1 | 0 | 0 |
| 第 3 级 | 0 | 1 | 1 | 0 |
| 第 4 级 | 0 | 1 | 1 | 1 |
这张表要按处理优先级来读。例如执行 3 级中断服务程序时,1 级和 4 级比 3 级处理优先级高,所以开放;2 级比 3 级处理优先级低,所以屏蔽。这正是动态分配中断处理优先权的意义:响应优先级决定先响应谁,但进入某个服务程序后,能不能被打断由屏蔽字决定。
CPU 的处理过程如下:
- 用户程序执行时,1、3、4 级中断同时请求。由于响应优先级固定为 \(1>2>3>4\),CPU 仍然首先响应 1 级中断。
- 1 级中断服务程序屏蔽所有中断,处理结束后返回。
- 待处理请求中还有 3、4 级。虽然处理优先级中 4 高于 3,但此时 CPU 选择响应哪个未处理请求仍按响应优先级,所以先响应 3 级中断。
- 进入 3 级中断服务程序后,屏蔽字为
0110,即 1、4 级开放,2、3 级屏蔽。因此原本等待的 4 级中断可以打断 3 级中断。 - CPU 转去执行 4 级中断服务程序。4 级的屏蔽字为
0111,只开放 1 级,屏蔽 2、3、4 级。 - 4 级中断结束后,CPU 返回 3 级中断服务程序继续执行。执行 3 级服务程序期间发生的 2 级中断因被屏蔽,不能打断 3 级,只能等待。
- 3 级中断结束后,CPU 再处理等待中的 2 级中断。
因此,这种情况下的主要处理顺序可概括为:
\[ \text{主程序}\rightarrow 1 \rightarrow 3 \rightarrow 4 \rightarrow 3 \rightarrow 2 \rightarrow \text{主程序} \]
如果只看各级中断完成的先后顺序,则是:
\[ 1,\ 4,\ 3,\ 2 \]
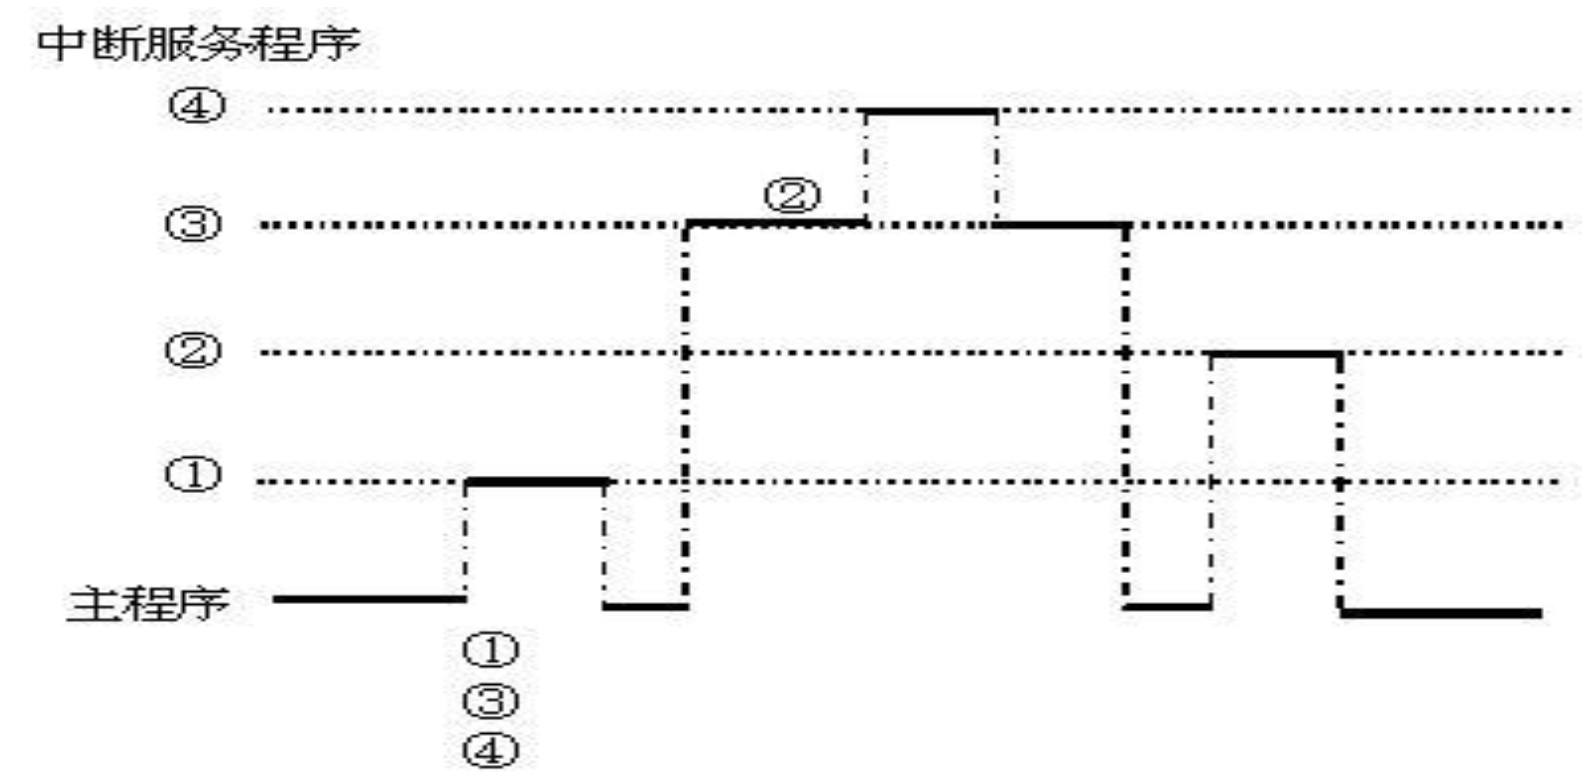
这道题的分析关键是:响应优先级决定“多个请求同时出现时先响应谁”,处理优先级通过屏蔽字决定“服务程序执行过程中谁能打断谁”。所以第二种情况下,3 级会先于 4 级被响应,但 4 级又会在 3 级执行期间打断 3 级;2 级虽然响应优先级高于 3、4,但处理优先级最低,若在 3 级服务程序中出现,会被屏蔽到后面再处理。
6.7 轮询方式与中断方式比较
设某设备输出一批数据:主机把一个数据送到接口输出缓冲 OBR 需 \(1\mu s\),OBR 输出到设备需 \(1\text{ ms}\),每条指令 \(1\mu s\)。
程序直接控制方式中,若查询程序有 10 条,第 5 条为启动设备指令,则每个数据周期约:
\[ 1000\mu s + 5\mu s = 1005\mu s \]
数据传输率约为:
\[ \frac{1}{1005\mu s}\approx 995\text{ 个数据/秒} \]
但 CPU 一直查询,主机占用率为 \(100\%\)。
中断方式中,若中断服务程序有 30 条,第 20 条启动设备,则数据传输率约为:
\[ \frac{1}{1000+1+20}\mu s \approx 979\text{ 个数据/秒} \]
主机占用率为:
\[ \frac{1+30}{1000+1+20}\approx 3\% \]
所以中断方式的传输率可能略低,因为中断服务程序有保存现场、设置屏蔽字等额外开销;但 CPU 占用率大幅下降,系统整体效率更高。
7 DMA 方式
7.1 为什么引入 DMA
DMA(Direct Memory Access,直接存储器访问)用于解决高速设备与主存之间的大批量数据传送问题。
程序直接控制方式受踏步现象限制,CPU 等待严重,不适合高速设备。中断方式虽然让 CPU 与外设部分并行,但每传一个数据都可能需要一次中断,存在中断响应、保护现场、恢复现场等开销,且数据传送由 CPU 执行软件完成,速度仍然不够。
DMA 的基本思想是:高速外设和主存之间直接传送数据,由专门硬件 DMA 控制器控制总线,CPU 不参与逐字节或逐字的数据搬运。
DMA 适合高速设备和成批数据交换,例如磁盘、光盘等。一旦启动,数据会连续读写,数据间隔时间短,必须及时传送,否则可能丢失。
7.2 DMA 与中断的配合
DMA 并不是完全不需要中断,而是与中断配合使用。以磁盘为例:
- 寻道阶段:可用中断通知 CPU 操作完成。
- 旋转查找扇区阶段:可用中断通知 CPU。
- 连续读写阶段:使用 DMA 方式传送数据。
- 结束和校验阶段:用 DMA 结束中断通知 CPU 后处理。
因此,DMA 的含义不是“没有中断”,而是大批量数据传送期间 CPU 不搬运数据。
7.3 DMA 数据传送的三种控制方式
DMA 传送时,真正搬运数据的是 DMA 控制器,但数据最终要进出主存。问题在于:CPU 执行程序也要访问主存,DMA 控制器传数据也要访问主存。两者共享主存和系统总线,就可能出现争用。三种控制方式本质上是在回答同一个问题:当 DMA 要访问主存时,CPU 应该怎样让出主存和总线。
| 方式 | 做法 | 优点 | 缺点或适用场景 |
|---|---|---|---|
| CPU 停止法 | DMA 传输一块数据期间,CPU 脱离总线,停止访问主存 | 控制简单,适合很高速外设成组传送 | CPU 基本停止,主存周期利用不充分 |
| 周期挪用法 | DMA 每次只窃取一个总线或存储周期,传一个数据后释放总线 | 能及时响应 I/O,又较好发挥 CPU 和主存效率 | 每次传送都要申请和释放总线,控制开销较大 |
| 交替分时访问法 | 每个存储周期分成两个时间片,一个给 CPU,一个给 DMA | CPU 与 DMA 可规则交替访问 | 需要存储系统支持固定分时 |
7.3.1 CPU 停止法:一次让出一整块传输时间
CPU 停止法也叫成组传送方式。当 DMA 开始传输一块数据时,CPU 脱离总线,停止访问主存;DMA 控制器独占总线和主存,把这一整块数据传完后,CPU 才重新取得总线控制权。
可以把它理解成:CPU 对 DMA 说“这一段时间总线都归你,你把这一块数据一次搬完”。因此它的控制逻辑最简单,DMA 不需要每传一个字都重新申请总线。
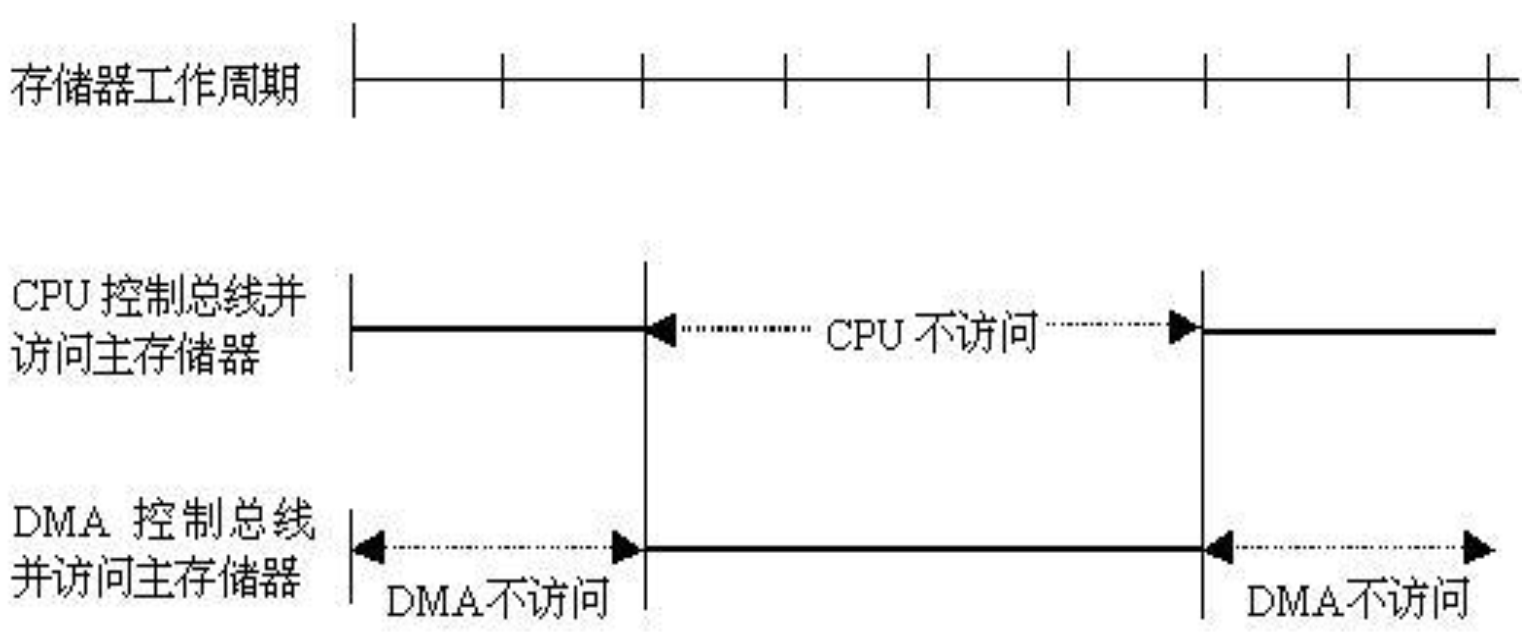
这种方式的优点是控制简单,适合传输率很高的外设进行成组数据传送。缺点是 CPU 受影响很大:DMA 访存期间 CPU 基本不能访问主存,很多情况下只能等待。更细一点说,即使 I/O 设备已经算“高速”,两个数据准备好之间通常仍会有间隔,而这个间隔往往大于一个主存周期;如果 CPU 被整块暂停,就会导致一些主存周期空闲,主存没有被充分利用。
有两种弥补 CPU 停止法缺点的思路:
- 在 DMA 接口中引入缓冲器:让外设先和 DMA 接口里的小容量半导体缓冲器交换数据,再由缓冲器与主存成批交换。这样 DMA 真正占用系统总线的时间变短,CPU 等待时间也会减少。
- 改用周期挪用法:DMA 不再一次占住总线直到一整块传完,而是每次只挪用一个存储周期,传完一个数据就释放总线。
7.3.2 周期挪用法:一次只抢一个主存周期
周期挪用法也叫周期窃取法或单字传送方式。当外设准备好一个数据时,DMA 控制器向 CPU 请求总线;CPU 让出一个总线事务周期,由 DMA 控制器访问主存,传送一个字或一个数据单位。传完后,DMA 立即释放总线,CPU 可以继续访存。等外设准备好下一个数据时,DMA 再发起下一次请求。
它的关键思想是:不让 DMA 长时间霸占总线,而是在 CPU 执行过程中“插空”拿走一个主存周期。
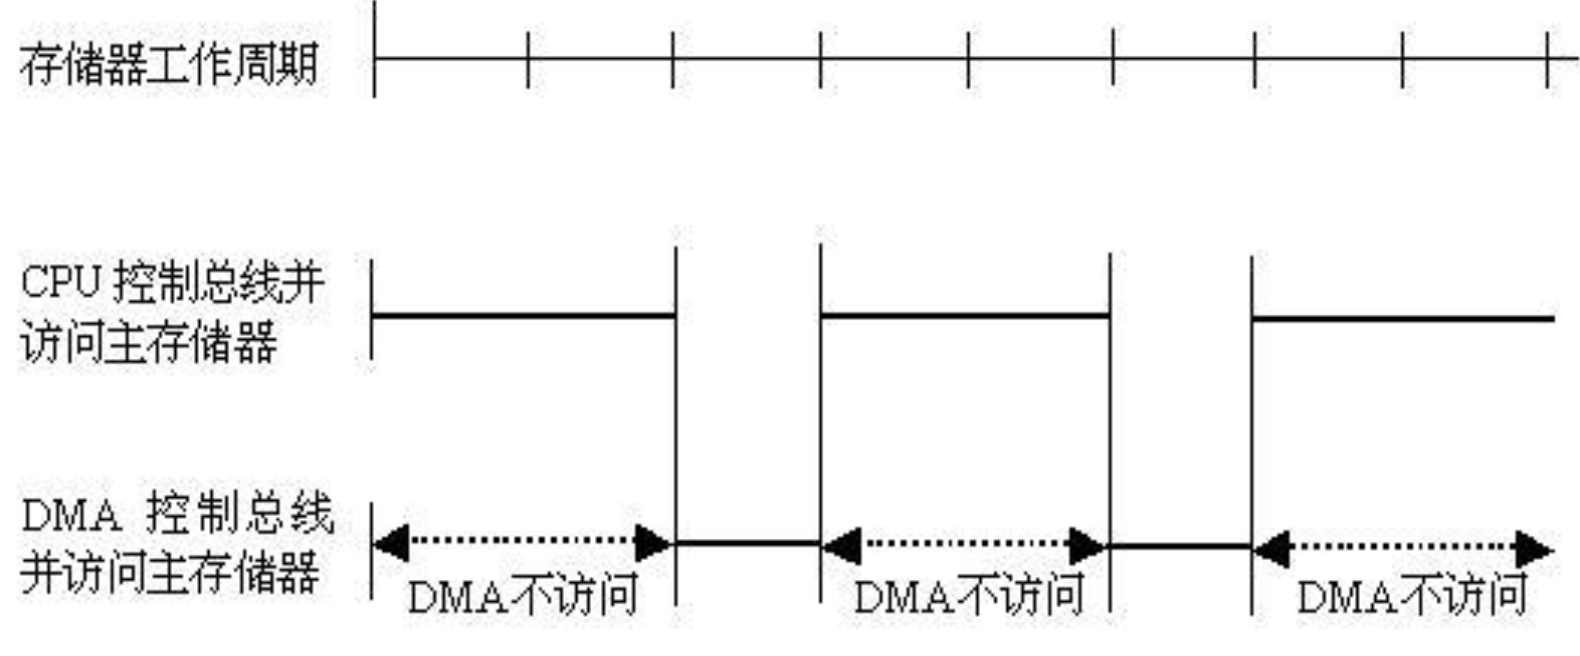
周期挪用法的优点是:既能及时响应 I/O 请求,又能较好发挥 CPU 和主存效率。外设准备下一个数据时,CPU 可以继续使用主存;只有真正要传送一个数据时,DMA 才短暂占用一个周期。因此,它适合 I/O 设备读写周期大于主存周期的情况。换句话说,外设并不是每个主存周期都能给出数据,CPU 可以利用外设准备数据的空隙继续执行程序。
它的缺点是控制开销比 CPU 停止法大。因为每传一个数据,DMA 都要经历申请总线、获得总线、传送数据、释放总线这一小轮流程。如果数据量很大、每个数据都这么申请,控制过程本身也会消耗时间。
周期挪用法需要区分三种可能情况:
| DMA 请求发生时的 CPU 状态 | 是否冲突 | 处理方式 |
|---|---|---|
| CPU 暂时不需要访问主存 | 不冲突 | DMA 可直接访问主存,两者在功能上并行 |
| CPU 正在访问主存 | 暂时冲突 | 等当前存储周期结束后,CPU 让出总线,DMA 再访存 |
| CPU 也正准备访问主存 | 发生访存竞争 | DMA 优先,先窃取一个主存周期,CPU 延迟访存 |
第三种情况最能体现“周期挪用”的名字:DMA 像是从 CPU 手里临时借走一个主存周期。为什么 DMA 优先?因为高速外设的数据缓冲可能很小,如果不及时传送,后续数据到来时可能覆盖旧数据,造成数据丢失;CPU 延迟一个主存周期通常只是性能下降,不会直接丢数据。
7.3.3 交替分时访问法:把每个存储周期分成两份
交替分时访问法的思想更规则:把每个存储周期划分成两个时间片,一个固定给 CPU,一个固定给 DMA。这样在每个存储周期内,CPU 和 DMA 都有自己的访问机会,不需要每次都临时争抢。
可以理解成:CPU 和 DMA 不是“谁急谁抢”,而是事先约定好轮流使用主存。例如一个周期的前半段 CPU 访问主存,后半段 DMA 访问主存;或者按硬件规定的节拍交替进行。这样 CPU 不会像 CPU 停止法中那样长时间被停住,DMA 也不必像周期挪用法那样每次都重新申请总线。
它的优点是访问节奏稳定,CPU 和 DMA 都能规律地使用主存;缺点是对硬件时序要求较高,需要存储系统支持这种固定分时安排。如果某一方暂时不需要访存,它分到的时间片可能浪费;如果某一方特别急,也不能随意多占时间片。
7.3.4 三种方式的对比
可以按“DMA 一次占用主存多久”来记:
| 控制方式 | DMA 一次占用粒度 | CPU 受影响程度 | 总线控制开销 | 适合场景 |
|---|---|---|---|---|
| CPU 停止法 | 一整块数据传送期间 | 最大,CPU 基本停止访存 | 最小 | 传输率很高、适合成组传送,且允许 CPU 短暂停顿 |
| 周期挪用法 | 一个主存周期或一个数据单位 | 中等,只延迟部分访存周期 | 较大 | 外设读写周期大于主存周期,常见 DMA 方式 |
| 交替分时访问法 | 固定时间片 | 较稳定,不长时间阻塞 | 中等,依赖硬件时序 | CPU 与 DMA 都需要规律访存、硬件支持分时 |
一句话总结:CPU 停止法是“整块让路”,周期挪用法是“临时借一个周期”,交替分时访问法是“预先排班轮流用”。
7.4 DMA 控制器的功能
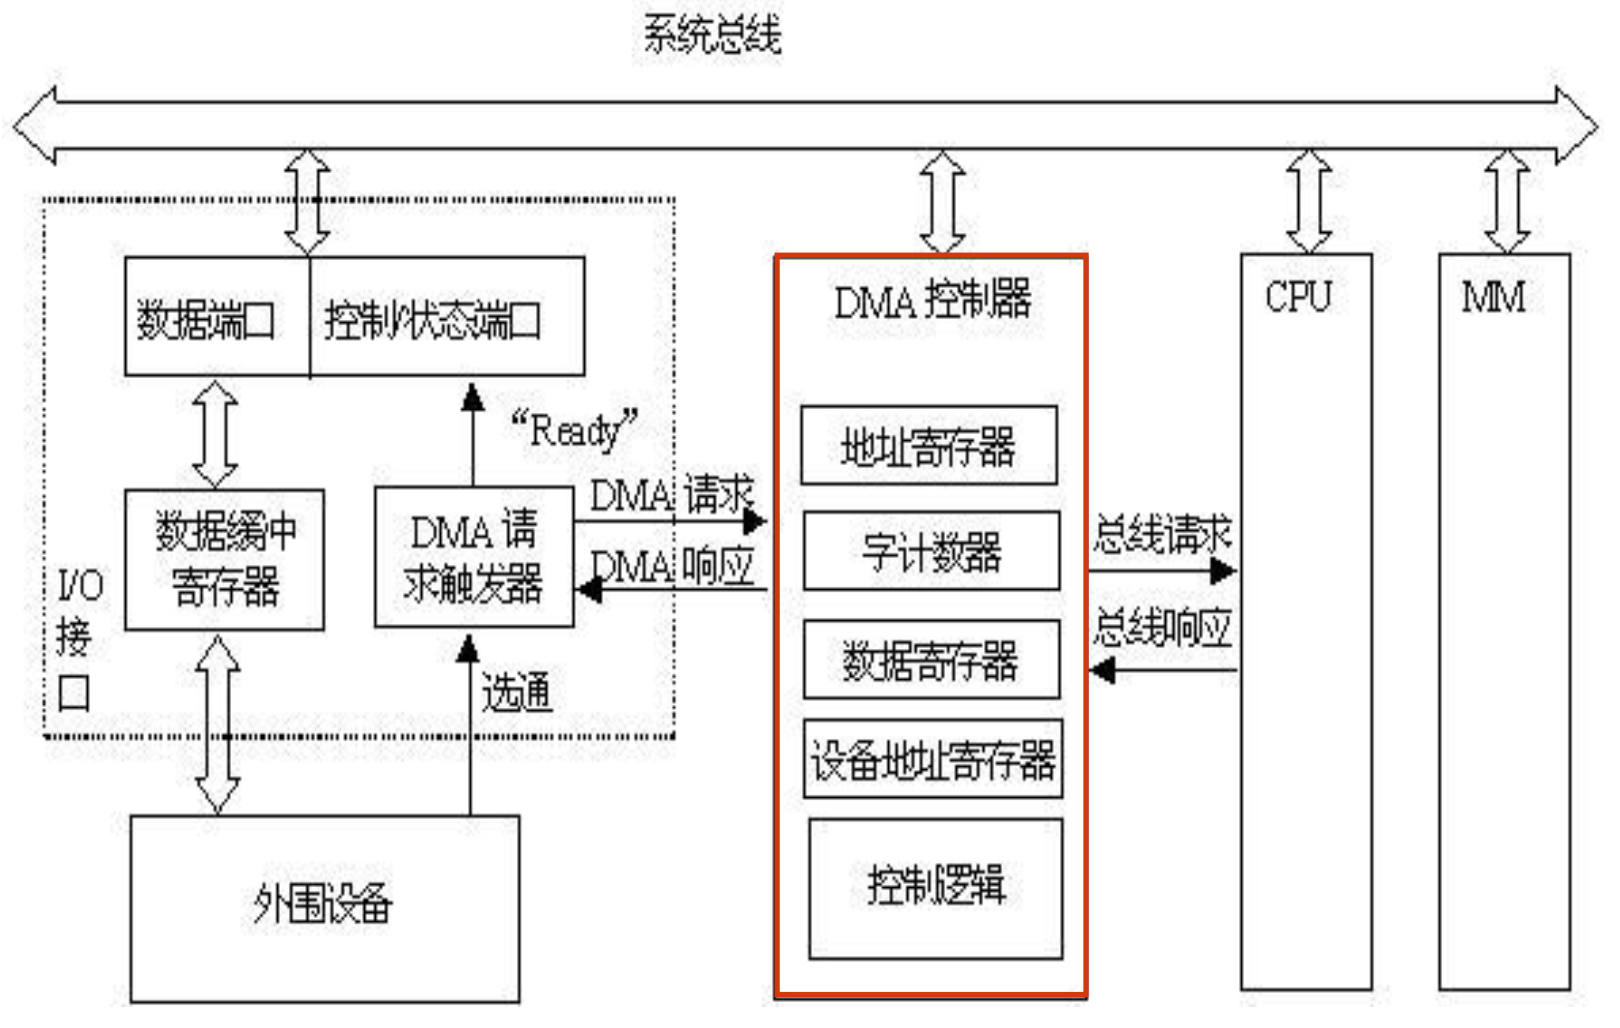
DMA 接口也称 DMA 控制器。它要能完成以下功能:
- 接收外设发来的 DMA 请求,并向 CPU 发总线请求。
- 在 CPU 发出总线响应后,接管总线控制权。
- 在地址线上给出主存地址,并自动修改主存地址。
- 根据传送方向在控制线上给出正确读写控制信号。
- 记录和判断传送数据个数。
- 传送结束时发出 DMA 结束信号,引起 DMA 中断,进入后处理。
典型 DMA 控制器中会有地址寄存器、字计数器、设备地址寄存器、控制寄存器、状态逻辑和总线控制逻辑等。
7.5 DMA 操作步骤
DMA 操作可分为三个阶段:
- DMA 控制器初始化,由软件实现
OS 或设备驱动准备内存缓冲区,设置内存首址、字计数值、传送方向、设备地址等参数,并启动外设。 - DMA 数据传送,由硬件实现
外设准备好数据或准备好接收数据后发出 DMA 请求;DMA 控制器向 CPU 申请总线;CPU 完成当前机器周期后让出总线;DMA 控制器控制总线完成读写,自动修改地址并递减计数。 - DMA 结束处理,由软件实现
当计数值为 0 时,DMA 控制器发出 DMA 结束信号,引起中断。CPU 执行中断服务程序,完成数据校验、状态检查、唤醒进程等后处理。
7.5.1 DMA 控制器初始化的详细步骤
DMA 初始化也叫 DMA 控制器预置,由软件完成,通常是操作系统中的设备驱动程序执行。它的目的不是传数据本身,而是先把 DMA 控制器“配置好”,让它后面能独立完成硬件传输。
第一步是准备内存区。如果是输入操作,例如从磁盘读数据到主存,驱动程序要先在主存中准备好接收数据的缓冲区;如果是输出操作,例如把主存中的一块数据写到外设,驱动程序要先把待输出数据放到内存缓冲区中。也就是说,DMA 传输前必须先明确:数据要从哪里来、要到哪里去。
第二步是设置传送参数。驱动程序通过 I/O 指令访问 DMA 控制器的端口,先测试外设状态,再把关键参数写入 DMA 控制器内部寄存器:
| 参数 | 写入位置 | 作用 |
|---|---|---|
| 内存首址 | 地址寄存器 | 指出 DMA 传输在主存中的起始地址 |
| 字计数值 | 字计数器 | 指出本次要传送多少个字、字节或数据单位 |
| 传送方向 | 控制寄存器 | 指出是外设到主存,还是主存到外设 |
| 设备地址 | 设备地址寄存器 | 指出要与哪个外设或哪个设备端口交换数据 |
这些参数对应 DMA 控制器后续硬件动作:地址寄存器决定每次访问主存的位置,字计数器决定何时结束,控制寄存器决定发读命令还是写命令,设备地址寄存器决定连接哪个外设。
第三步是启动外设。驱动程序向设备或 DMA 控制器发送启动命令后,CPU 不再逐字搬运数据,而是可以去执行其他程序。之后等外设准备好数据,DMA 控制器就会进入“DMA 请求、总线请求、总线响应、DMA 传送”的硬件流程。
7.6 DMA 传输过程细化
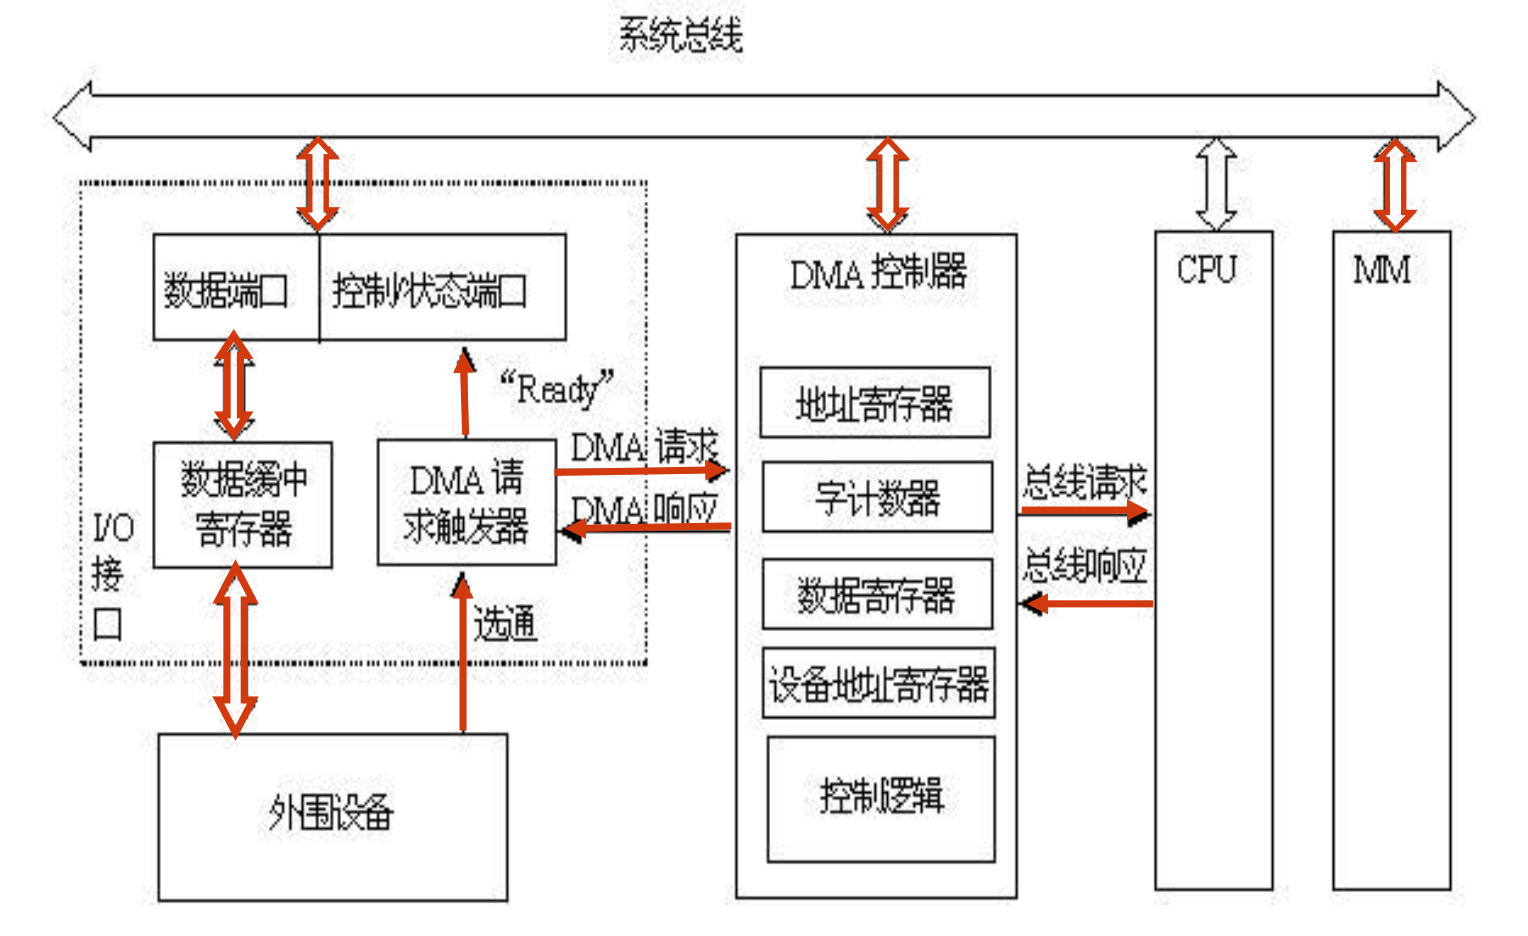
DMA 传输过程可整理为:
- 外设准备好数据或准备好接收数据,发出选通信号,使数据进入数据缓冲寄存器,同时 DMA 请求触发器置 1。
- DMA 请求触发器向控制/状态端口发 Ready 信号,并向 DMA 控制器发 DMA 请求。
- DMA 控制器向 CPU 发总线请求。
- CPU 完成当前机器周期后响应 DMA 请求,发出总线响应。DMA 控制器发 DMA 响应,使请求触发器复位,CPU 浮动总线并让出控制权。
- DMA 控制器给出内存地址和读写命令,在数据总线上完成数据传输。
- DMA 控制器修改主存地址、计数值减 1。若采用 CPU 停止法,则循环传到计数为 0;若采用周期挪用法,则传一个数据后释放总线,下一次再重新请求。
7.7 DMA 与中断方式的区别
| 对比点 | 中断方式 | DMA 方式 |
|---|---|---|
| 数据传送者 | CPU 执行中断服务程序,用软件传送 | DMA 控制器用硬件传送 |
| 请求含义 | 请求 CPU 暂停当前程序并执行服务程序 | 请求总线控制权或主存访问权 |
| 是否中止现行程序 | 需要保存断点和现场 | 数据传送期间通常不需中止程序 |
| 能否处理异常 | 可以处理外设事件和异常情况 | 不能处理异常,只负责数据搬运 |
| 响应时点 | 一条指令周期结束后 | 一个总线周期或机器周期后 |
| 适用设备 | 低速、慢速或中速设备 | 高速块设备 |
| 并行度 | 外设与 CPU 有一定并行性,但数据传送仍由 CPU 做 | 外设与 CPU 并行度高,CPU 开销小 |
7.8 中断与 DMA 的 CPU 开销示例
题设:CPU 频率 \(500\text{ MHz}\),硬盘控制器数据缓存 \(16\text{ B}\),磁盘传输率 \(4\text{ MB/s}\),忽略 CPU 访存和 DMA 访存冲突。
7.8.1 中断方式
硬盘每次中断传 \(16\text{ B}\),若磁盘以 \(4\text{ MB/s}\) 传输,则每秒中断次数为:
\[ 4\text{ MB/s}/16\text{ B}=250\text{ k 次/s} \]
每次中断开销 500 个时钟周期,则每秒用于中断的时钟周期数为:
\[ 250\text{ k}\times 500=125\times 10^6 \]
CPU 每秒总时钟周期为:
\[ 500\times 10^6 \]
若硬盘一直传输,则 CPU 用在 I/O 上的比例为:
\[ \frac{125\times 10^6}{500\times 10^6}=25\% \]
若硬盘只有 5% 时间在传输,则 CPU 用在 I/O 上的比例为:
\[ 25\%\times 5\%=1.25\% \]
7.8.2 DMA 方式
每次 DMA 传送 \(8000\text{ B}\),传输时间为:
\[ 8000\text{ B}/(4\text{ MB/s})\approx 2\times 10^{-3}\text{ s} \]
所以每秒约有:
\[ 1/(2\times 10^{-3})=500 \]
次 DMA 传送。每次 DMA 初始化 1000 个时钟,结束中断处理 500 个时钟,每秒 CPU 开销为:
\[ (1000+500)\times 500=750\times 10^3 \]
CPU 占用率为:
\[ \frac{750\times 10^3}{500\times 10^6}=1.5\times 10^{-3}=0.15\% \]
这个例子说明:DMA 的核心优势不是让设备本身变快,而是显著减少 CPU 为 I/O 付出的时间。
8 I/O 子系统的软件层次与驱动程序
8.1 I/O 子系统的层次结构
高级语言运行时通常提供 I/O 函数,例如 C 的
printf()、scanf(),C++
的输入输出操作符。用户程序通过这些函数提出 I/O 请求,但真正完成 I/O
需要多层软件和硬件协同。
I/O 软件从高到低可分为四层:
- 用户层 I/O 软件:如标准库函数、运行时库。
- 与设备无关的操作系统 I/O 软件:提供统一文件、缓冲、权限、调度等抽象。
- 设备驱动程序:直接控制具体设备控制器,访问 I/O 端口。
- I/O 中断处理程序:响应外设中断或 DMA 完成中断。
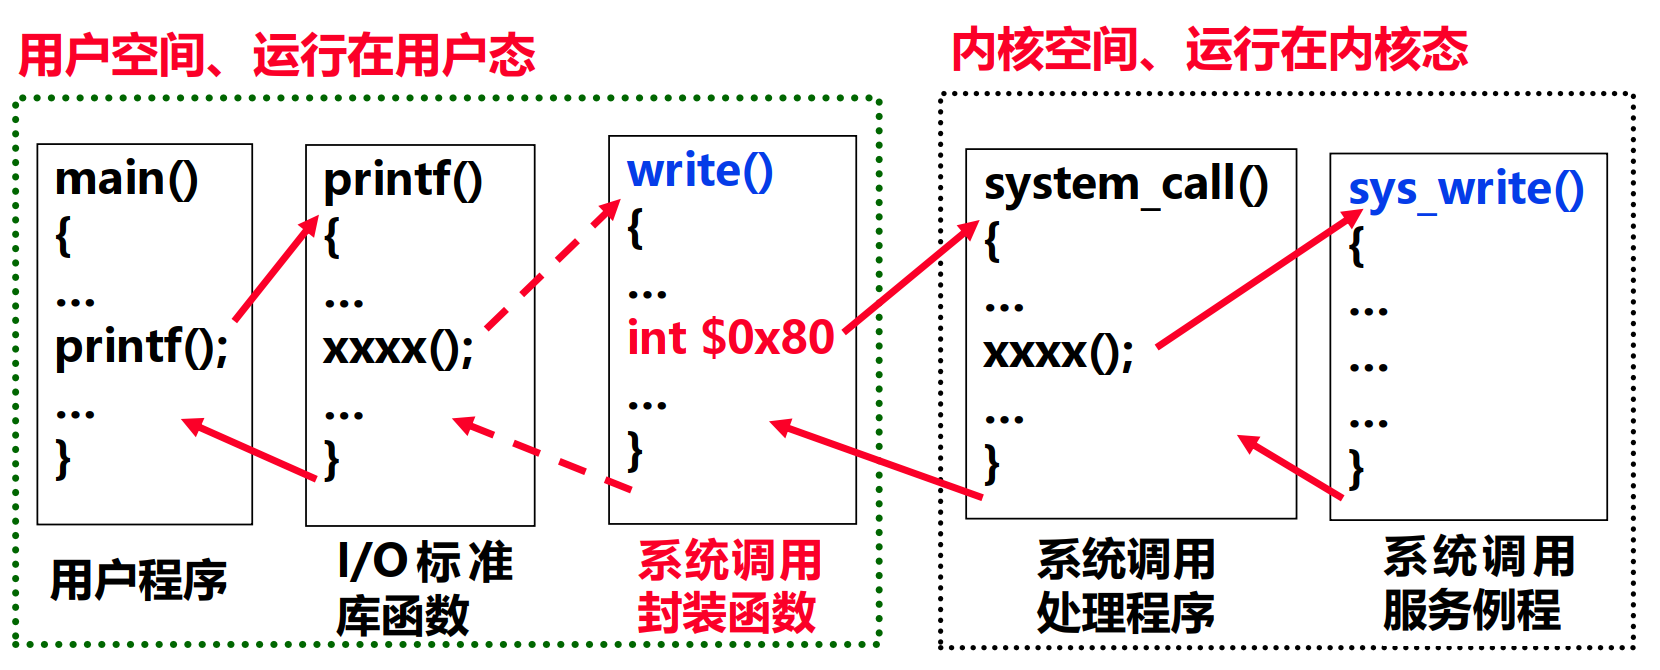
层次越低,越接近设备,越远离用户程序。大部分 I/O 软件属于操作系统内核态程序,但最初 I/O 请求来自用户态。
从用户态切换到内核态的关键机制是异常机制中的系统调用或自陷。例如
Linux 中,printf() 最终会调用
write(),再通过系统调用入口进入内核,找到
sys_write()
服务例程执行。系统调用处理程序根据系统调用号决定转向哪个内核服务例程。
8.2 三种方式在驱动程序中的体现
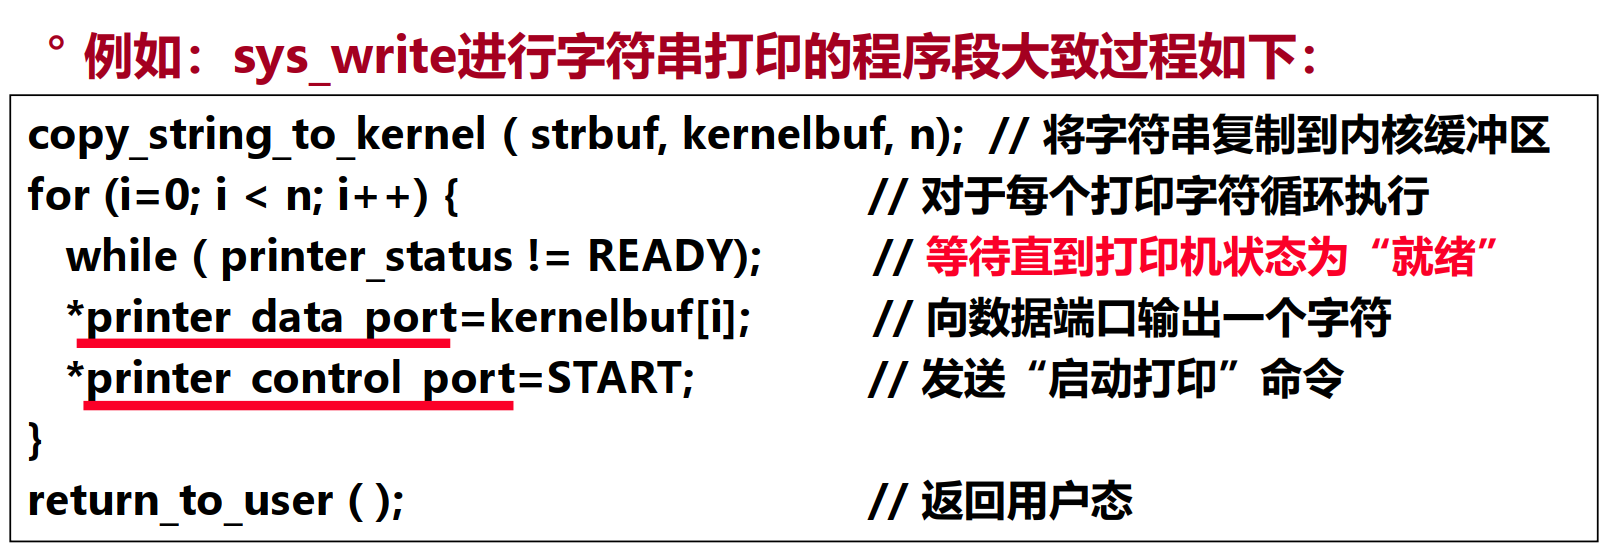
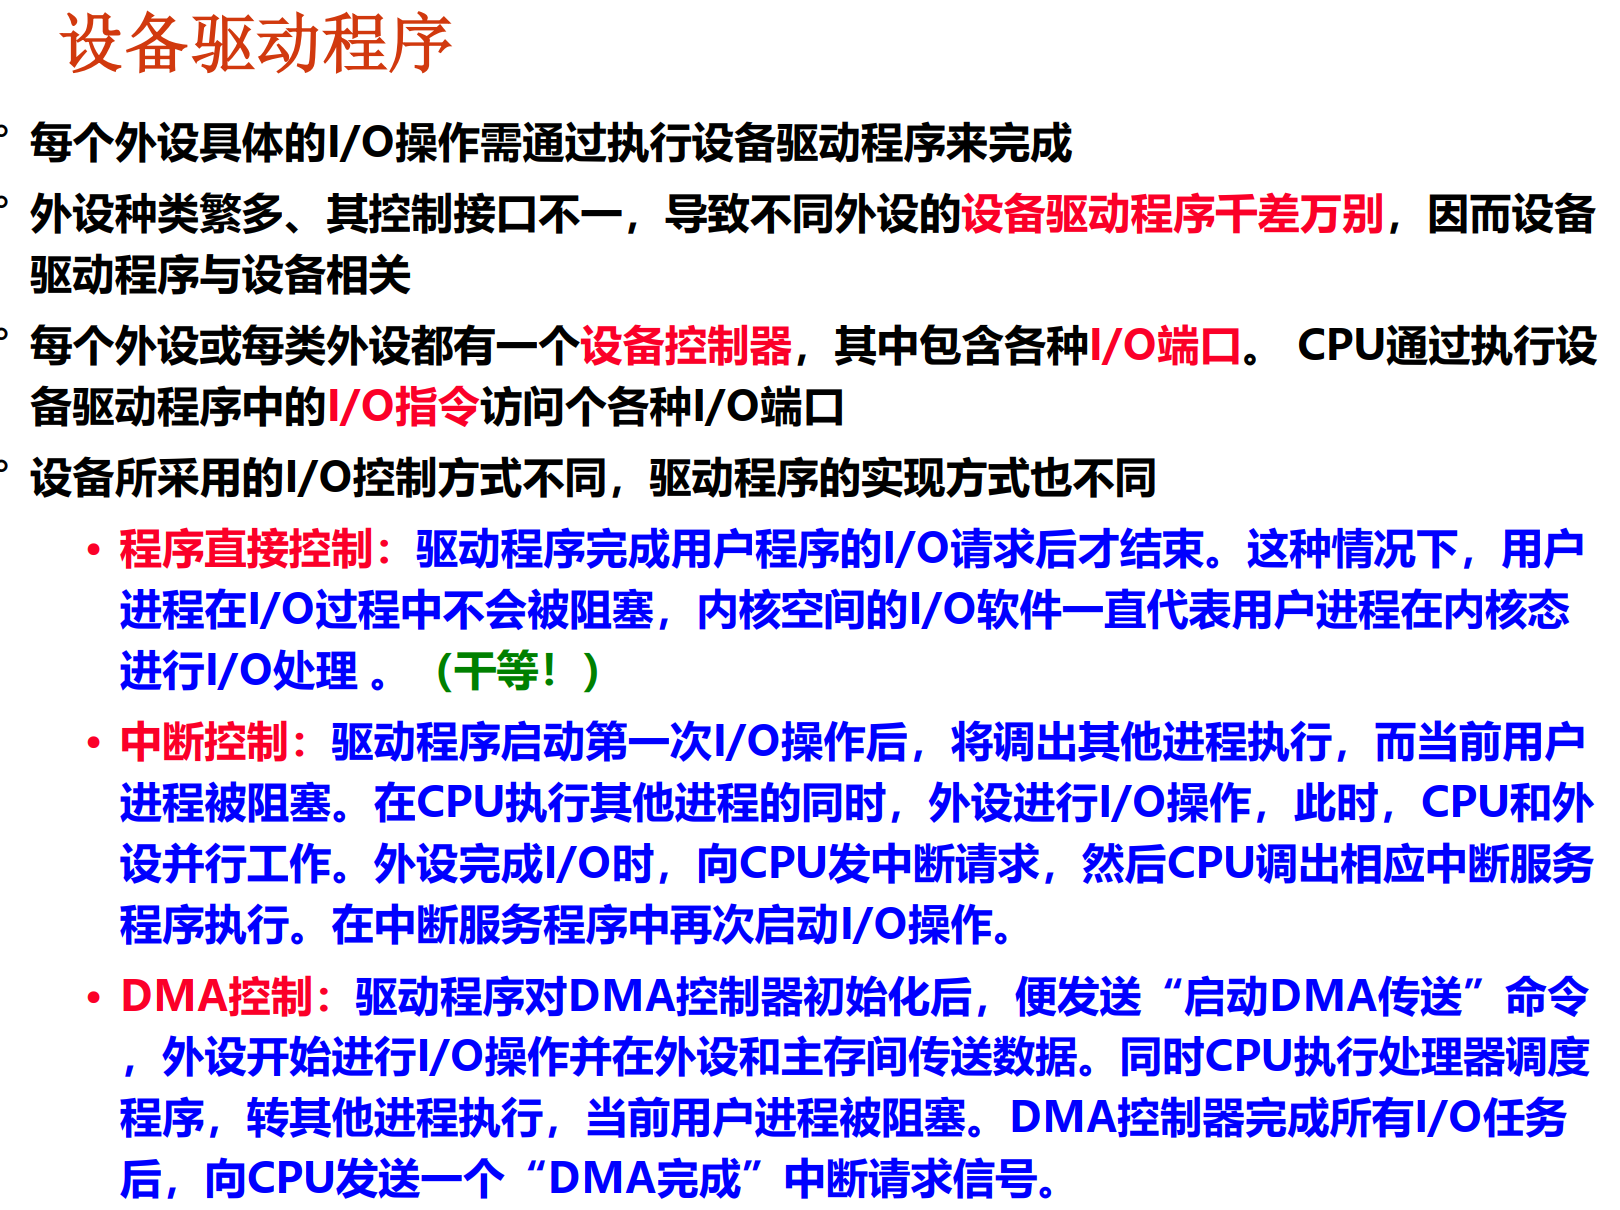
程序查询方式下,驱动程序把用户数据复制到内核缓冲区后,对每个字符循环执行:读状态端口,等待设备 Ready;写数据端口;写控制端口启动设备。当前进程在内核态“干等”,CPU 被持续占用。
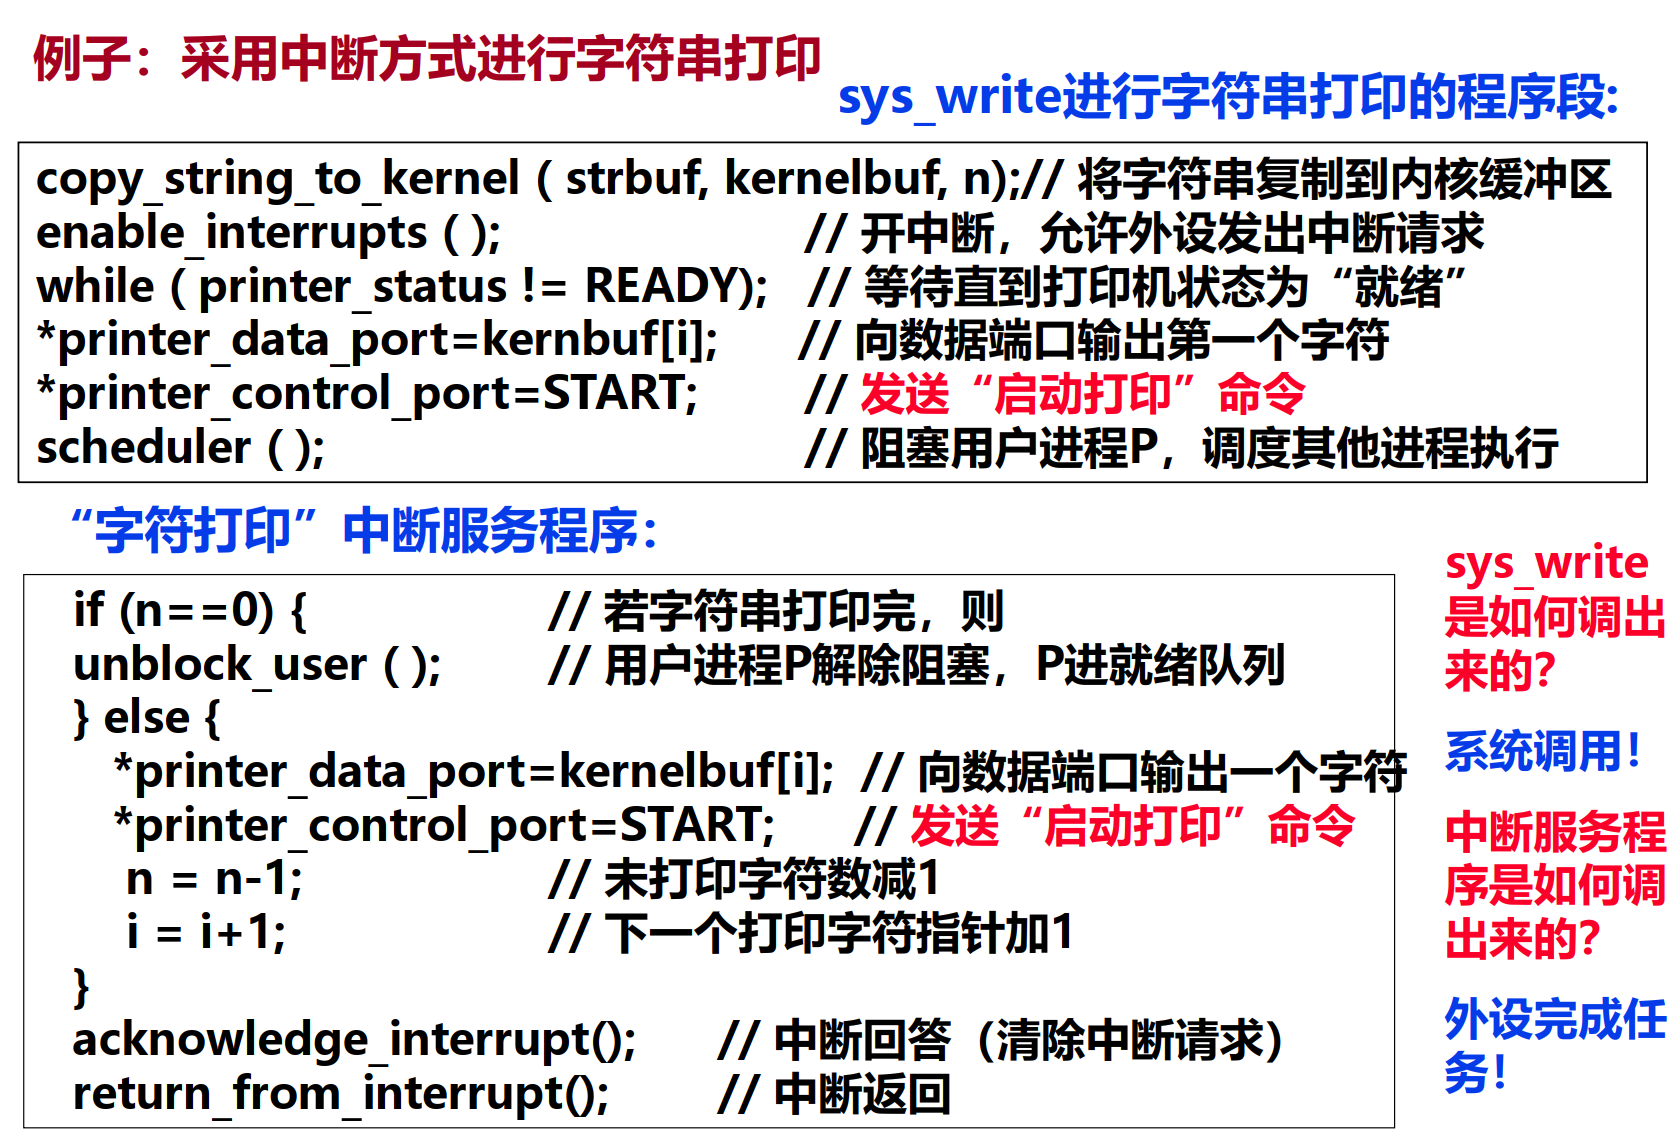
中断方式下,驱动程序启动第一次 I/O 后阻塞当前用户进程,调度其他进程运行。设备完成一个字符或一段任务后发中断,中断服务程序继续送下一个字符或做相应处理。CPU 与外设可并行工作。
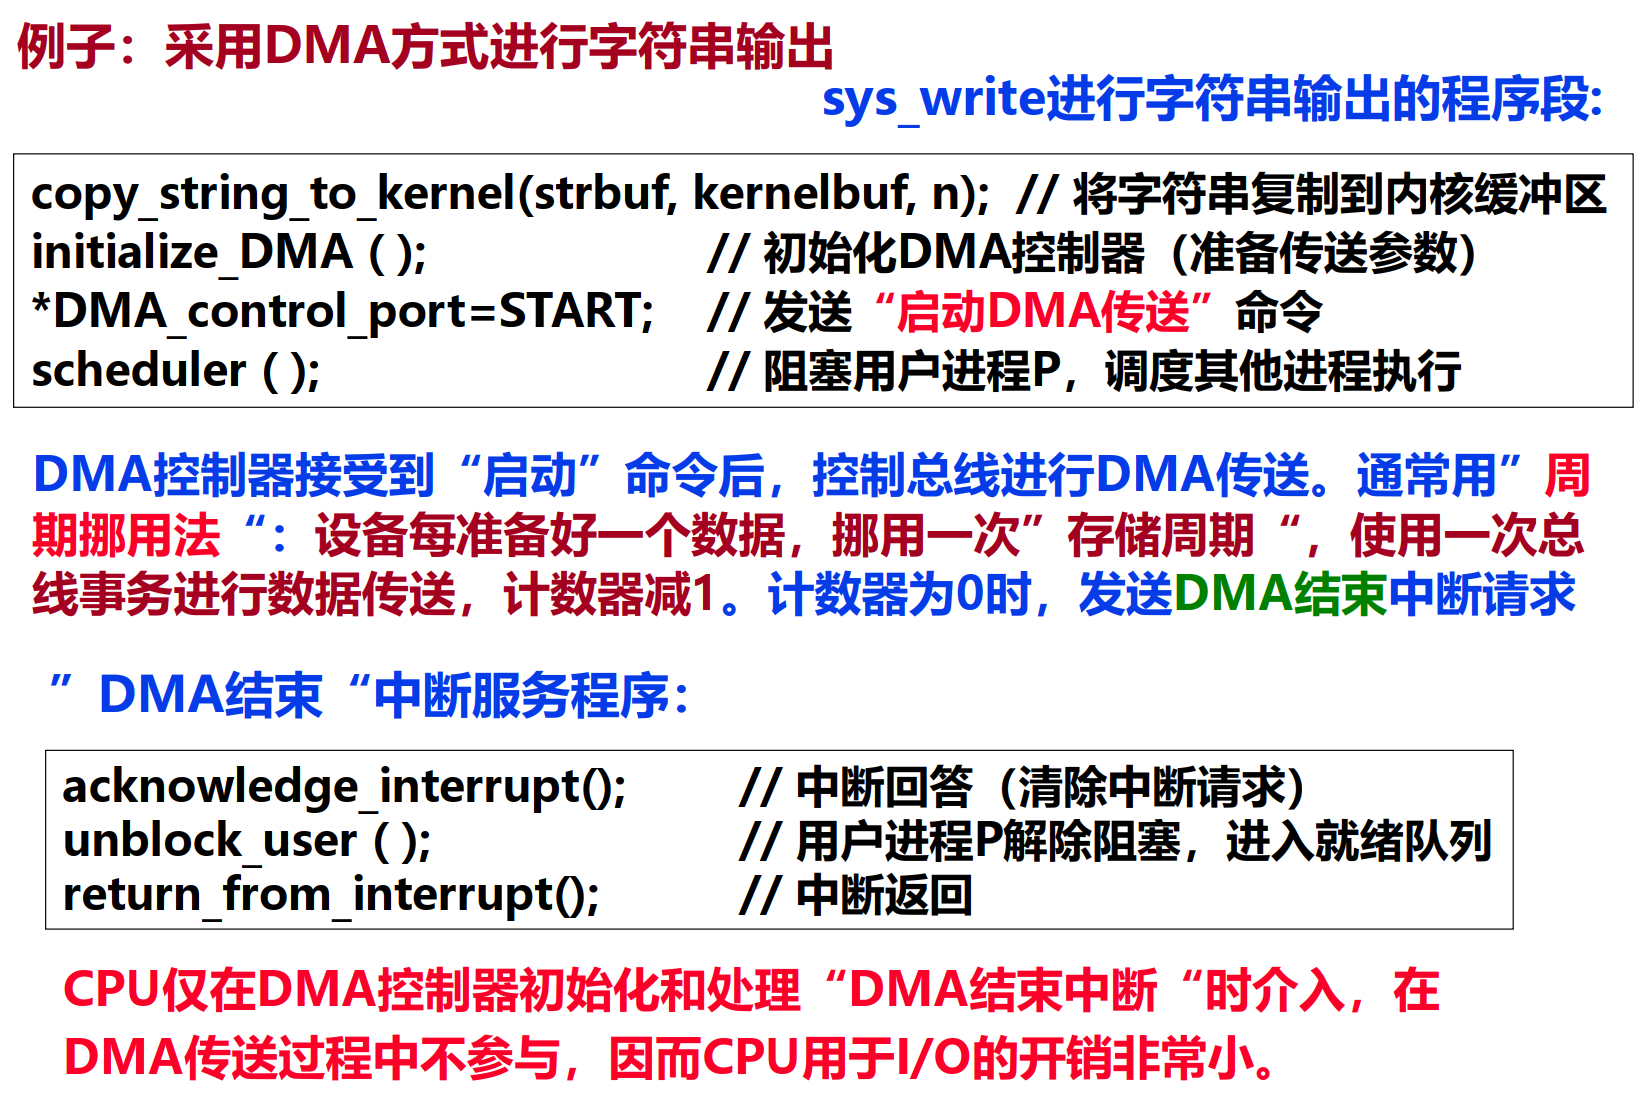
DMA 方式下,驱动程序初始化 DMA 控制器,设置缓冲区地址、长度、方向等参数,然后启动 DMA 传送并阻塞当前进程。DMA 控制器完成全部数据传输后发 DMA 结束中断,中断服务程序做校验、清除中断、唤醒进程等后处理。
8.3 中断服务程序在不同方式中的任务
中断控制方式和 DMA 控制方式都需要中断服务程序,但任务不同:
- 在中断 I/O 中,中断服务程序通常要执行实际数据传送,例如从数据缓冲器取数或把数据写入数据缓冲器,并再次启动外设。
- 在 DMA I/O 中,中断服务程序主要做结束处理,例如数据校验、清除中断请求、唤醒等待进程;实际数据搬运已经由 DMA 控制器完成。
I/O 指令、开中断、关中断等都是特权指令,只能在操作系统内核程序中使用。这也是用户程序不能随意直接控制硬件设备的重要原因。
9 总结
9.1 本章核心概念
- I/O 系统性能:吞吐率看单位时间传多少,响应时间看一次请求等多久。
- I/O 系统任务:建立通路、设备寻址、发送命令、读取状态、传输数据。
- 外设通用模型:控制信息、状态信息、数据信息三类信号。
- 磁盘访问时间:寻道时间 + 旋转等待时间 + 数据传输时间。
- RAID:多个物理盘组成一个逻辑盘,通过条带化提高性能,通过冗余提高可靠性。
- 总线组成:数据线、地址线、控制线。
- 总线趋势:点对点、异步、串行。
- I/O 控制器:主机与外设之间的缓冲、控制、状态检测、格式转换部件。
- I/O 端口:I/O 控制器中 CPU 可访问的寄存器。
- I/O 寻址:统一编址用普通访存指令,独立编址用专门 I/O 指令。
- 三种 I/O 传输方式:轮询靠 CPU 查,中断靠外设通知,DMA 靠硬件搬数据。
9.2 概念对比
| 易混概念 | 区别 |
|---|---|
| I/O 总线 vs 通信总线 | I/O 总线通常在主板内部连接 I/O 控制器;通信总线常连接 I/O 控制器和外部设备 |
| I/O 控制器 vs I/O 接口 | 有些语境会把控制器和插座合称 I/O 接口;严格说控制器偏逻辑,接口还包括连接器、电气规范等 |
| 响应优先级 vs 处理优先级 | 响应优先级决定多个请求同时来时先响应谁;处理优先级由屏蔽字动态决定谁能打断谁 |
| 中断方式 vs DMA 方式 | 中断方式由 CPU 执行服务程序传数据;DMA 方式由 DMA 控制器硬件传数据 |
| DMA 请求 vs 中断请求 | DMA 请求要总线或主存访问权;中断请求要 CPU 转去执行服务程序 |
| RAID 4 vs RAID 5 | RAID 4 有专门校验盘,写时易成瓶颈;RAID 5 校验块分布在各盘 |
9.3 常考公式与计算
磁盘平均访问时间:
\[ T = T_{\text{seek}} + T_{\text{rotation}} + T_{\text{transfer}} + T_{\text{controller}} + T_{\text{queue}} \]
平均旋转等待时间:
\[ T_{\text{rotation}}=\frac{0.5}{\text{RPS}} \]
同步总线带宽:
\[ B=W\times F/N \]
PCIe 1.0 \(\times n\) 双向带宽:
\[ B=2.5\text{ Gb/s}\times 2\times n/10=0.5\text{ GB/s}\times n \]
RAID 4 少量写校验更新:
\[ p'(i)=p(i)\oplus X_0(i)\oplus X'_0(i) \]
CPU 占用率常用思路:
\[ \text{CPU 占用率}=\frac{\text{单位时间用于 I/O 的 CPU 周期数}}{\text{单位时间 CPU 总周期数}} \]
9.4 学习建议
学习本章时,可以按“谁控制数据传输”来串起来:
- 轮询:CPU 一直主动查状态,最简单但最浪费 CPU。
- 中断:外设完成后通知 CPU,CPU 通过服务程序处理,减少等待。
- DMA:CPU 设置参数,DMA 控制器直接在外设和主存间搬数据,CPU 开销最低。
再按“设备如何被找到”理解 I/O 端口和编址:CPU 并不是直接“找到打印机”,而是访问打印机控制器中的数据端口、状态端口、控制端口。统一编址把这些端口放进主存地址空间,独立编址则给它们单独的 I/O 地址空间。
最后按“通路如何构成”理解总线:CPU、主存、I/O 控制器通过不同层次的总线和桥接器连接;高速互连越来越倾向于点对点、串行、异步;低层设备还会通过 USB、SATA、PS/2、网线等通信接口连接到具体外设。