目录
- 知识表示为什么重要:从专家系统说起
- 语义网络:把知识组织成概念层级
- 框架表示法:用对象模板组织常识
- 概念图:用图结构表达句子的语义
- 知识图谱:RDF 三元组与 SPARQL 查询
- 从自然语言到知识表示
- 其他知识表示方法概览
- 本章方法对比与总结
1 知识表示为什么重要:从专家系统说起
1.1 普通程序与专家系统的差异
知识表示的核心问题可以先通过两个公式看出来。普通程序可以粗略写成:
\[ \text{Programs}=\text{Algorithms}+\text{Data Structures} \]
也就是说,传统程序更关心“用什么算法处理什么数据结构”。例如排序程序的核心是排序算法,数据库索引的核心是数据结构设计。只要问题规则明确、流程固定,算法和数据结构就能很好地解决问题。
但专家系统面对的是另一类问题。医生诊断、设备故障排查、法律咨询、配置推荐等任务,并不只是把一批数据喂给一个固定算法,而是要用大量领域知识进行判断。因此专家系统可以概括为:
\[ \text{Expert Systems}=\text{Knowledge}+\text{Inference} \]
这里的 Knowledge 指专家经验、事实、规则、概念关系和默认常识;Inference 指系统根据已有知识推出新结论的过程。换句话说,专家系统的重点不是“算得快”,而是“知道什么,并且能根据这些知识推出什么”。
一个典型专家系统通常包含知识库、推理机、工作记忆和解释模块。知识库存放领域事实和规则,推理机负责根据当前事实进行推理,工作记忆保存当前问题的具体信息,解释模块则回答“为什么系统会这样判断”。这也解释了为什么本章要讲知识表示:如果知识没有被清楚地表示出来,推理机就无从使用它。
1.2 知识表示、知识获取与知识使用
人工智能中围绕知识的研究大致有三个方面:知识表示、知识获取和知识使用。三者不是并列孤立的关系,而是有先后依赖的关系。
知识获取解决“知识从哪里来”的问题,例如从专家访谈、数据库、文本、传感器或互联网中获得知识。知识使用解决“知识如何发挥作用”的问题,例如检索、问答、分类、诊断和规划。而知识表示处在二者中间,它负责把获得的知识变成机器能够保存、组织和推理的形式。
例如,人可以自然地说“金丝雀是鸟,鸟通常会飞”。但机器不能直接理解自然语言中的“是”“通常”和“会”。如果我们把它表示为概念层级和属性继承,机器就可以沿着层级推出“金丝雀通常会飞”。因此,知识表示的本质就是把人类知识翻译成机器可操作的结构。
1.3 知识表示需要解决什么问题
好的知识表示方法至少要解决四类问题。第一是表达能力,也就是它能不能表示对象、属性、关系、事件、规则、默认值和例外情况。第二是推理能力,也就是系统能不能基于表示出来的知识推出新结论。第三是组织能力,也就是知识之间能不能形成层次、分类、继承和组合关系。第四是可维护性,也就是新增知识时不会轻易破坏已有结构。
本章后面的语义网络、框架、概念图和知识图谱,都可以看成对这些问题的不同回答。语义网络擅长表达概念层级,框架擅长表达典型对象或场景,概念图擅长表达自然语言语义结构,知识图谱则适合大规模组织实体及其关系。
2 语义网络:把知识组织成概念层级
2.1 心理学证据:人类知识可能按层级组织
人类记忆中的知识往往具有层级结构。例如
ANIMAL、BIRD、CANARY、OSTRICH、FISH
等概念可以组织成上下位关系:CANARY 是 BIRD
的一种,BIRD 又是 ANIMAL
的一种。属性也可以放在不同层级上,例如 ANIMAL 具有
can breathe、has skin、can move
属性,而 BIRD 具有
can fly、has wings、has feathers
属性。
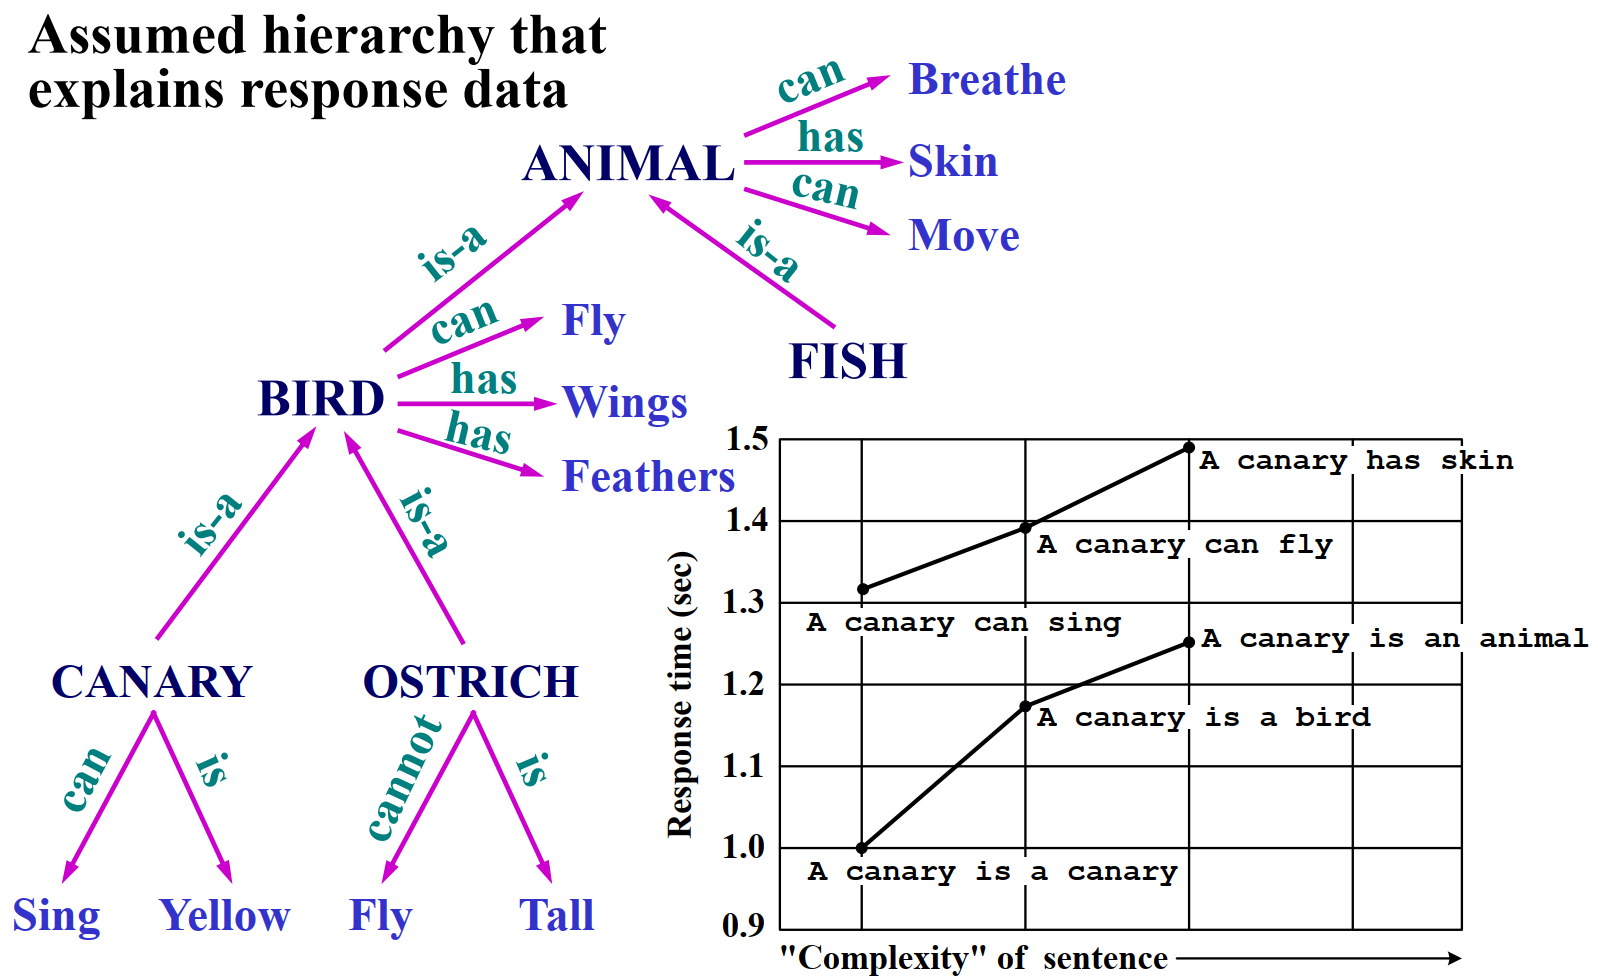
这个实验关注的是人判断句子真假的反应时间。判断 “A canary is a canary”
最快,因为它几乎不需要跨层级查找;判断 “A canary is a bird”
稍慢,因为要从 CANARY 往上一层找到 BIRD;判断
“A canary is an animal” 更慢,因为要继续往上找到
ANIMAL。同理,“A canary has skin” 也比较慢,因为
has skin 这个属性存放在 ANIMAL
层级,需要通过继承得到。
这个例子说明,概念层级不仅能节省存储,还能解释某些认知现象。我们不需要在
CANARY、OSTRICH、FISH
等每一个概念下面重复写“会呼吸、有皮肤、会移动”,只要把这些属性放在更高层的
ANIMAL 上,子类就可以继承它们。
不过,这个例子也埋下了一个重要问题:继承并不总是无条件正确。图中
OSTRICH(鸵鸟) 是
BIRD,但鸵鸟不会飞。如果系统只知道“鸟会飞”和“鸵鸟是鸟”,就会推出错误结论“鸵鸟会飞”。因此,语义网络必须处理默认属性和例外之间的冲突。
2.2 语义网络的基本结构
语义网络(Semantic Network)
是一种图形化知识表示方法。它通常用节点表示概念、实例或属性值,用边表示节点之间的关系。常见关系包括
is-a、part-of、has、can、property、color、owns
等。
在语义网络中,最重要的边之一是
is-a。它表示“某个概念属于另一个更一般的概念”,例如
CANARY is-a BIRD。这种关系使网络形成层级结构,也让属性继承成为可能。
这里的推理例子如下:
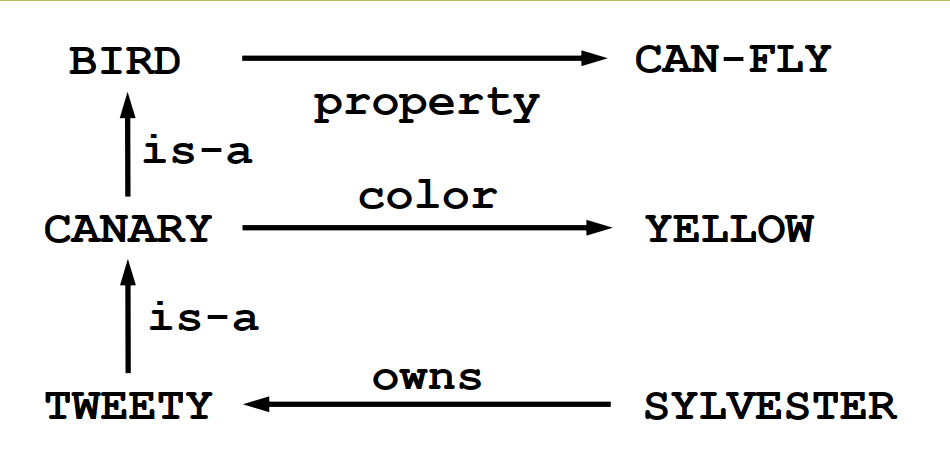
图里有几个基本事实:TWEETY is-a CANARY,CANARY is-a BIRD,CANARY property CAN-FLY,CANARY color YELLOW,并且
SYLVESTER owns TWEETY。这些事实本身很简单,但它们组合起来之后就能产生新的结论。
2.3 语义网络中的继承推理
语义网络推理的核心是沿着图中的边进行搜索,尤其是沿着
is-a 边向上查找父类,然后继承父类或类别上的属性。
例如,图中明确写着
CANARY is-a BIRD,BIRD property CAN-FLY,所以可以得到
CAN-FLY(CANARY)。又因为
TWEETY is-a CANARY,所以 Tweety
继承金丝雀的属性,系统可以推出 CAN-FLY(TWEETY) 和
TWEETY is YELLOW。再结合
SYLVESTER owns TWEETY,系统还能进一步推出 Sylvester
拥有一只金丝雀,拥有一只鸟,并且拥有某个会飞的东西。
这个推理过程的逻辑是连续的:先确定 Tweety 的类别,再继承类别属性,最后把“拥有 Tweety”这个关系推广为“拥有一只具有这些类别和属性的东西”。因此,语义网络不只是画图工具,它可以支持基于路径和继承的推理。
2.4 语义网络的优点与局限
语义网络最大的优点是直观。它把知识画成图,很适合表示“谁属于谁”“谁拥有什么属性”“谁和谁有关系”。对于概念层级、分类体系和对象关系,语义网络尤其自然。
但它的局限也很明显。首先,复杂逻辑表达能力有限。例如“所有鸟都会飞,除非它是鸵鸟或它受伤了”这类带例外和条件的知识,用普通边很难清楚表示。其次,如果没有严格形式语义,不同人可能对同一种边有不同理解。最后,继承冲突需要额外规则处理。比如某节点从父类继承“会飞”,又从自身属性得到“不会飞”,系统必须知道哪个结论优先。
3 框架表示法:用对象模板组织常识
3.1 Frame 的基本思想
Frame(框架) 是一种以对象、概念或场景为中心的知识表示方法。它有点像 UML 中的类图,也像一个对象模板。一个框架描述“这个东西通常有什么属性、和什么东西有关、默认情况下是什么样子”。
框架内部由许多 slot(槽) 构成。每个槽可以存放属性值、关系、默认值、约束,甚至可以存放过程性信息。与语义网络相比,框架不是把所有知识都摊成节点和边,而是把关于同一个对象或场景的知识收拢到一个结构中。
以 hotel room 为例:
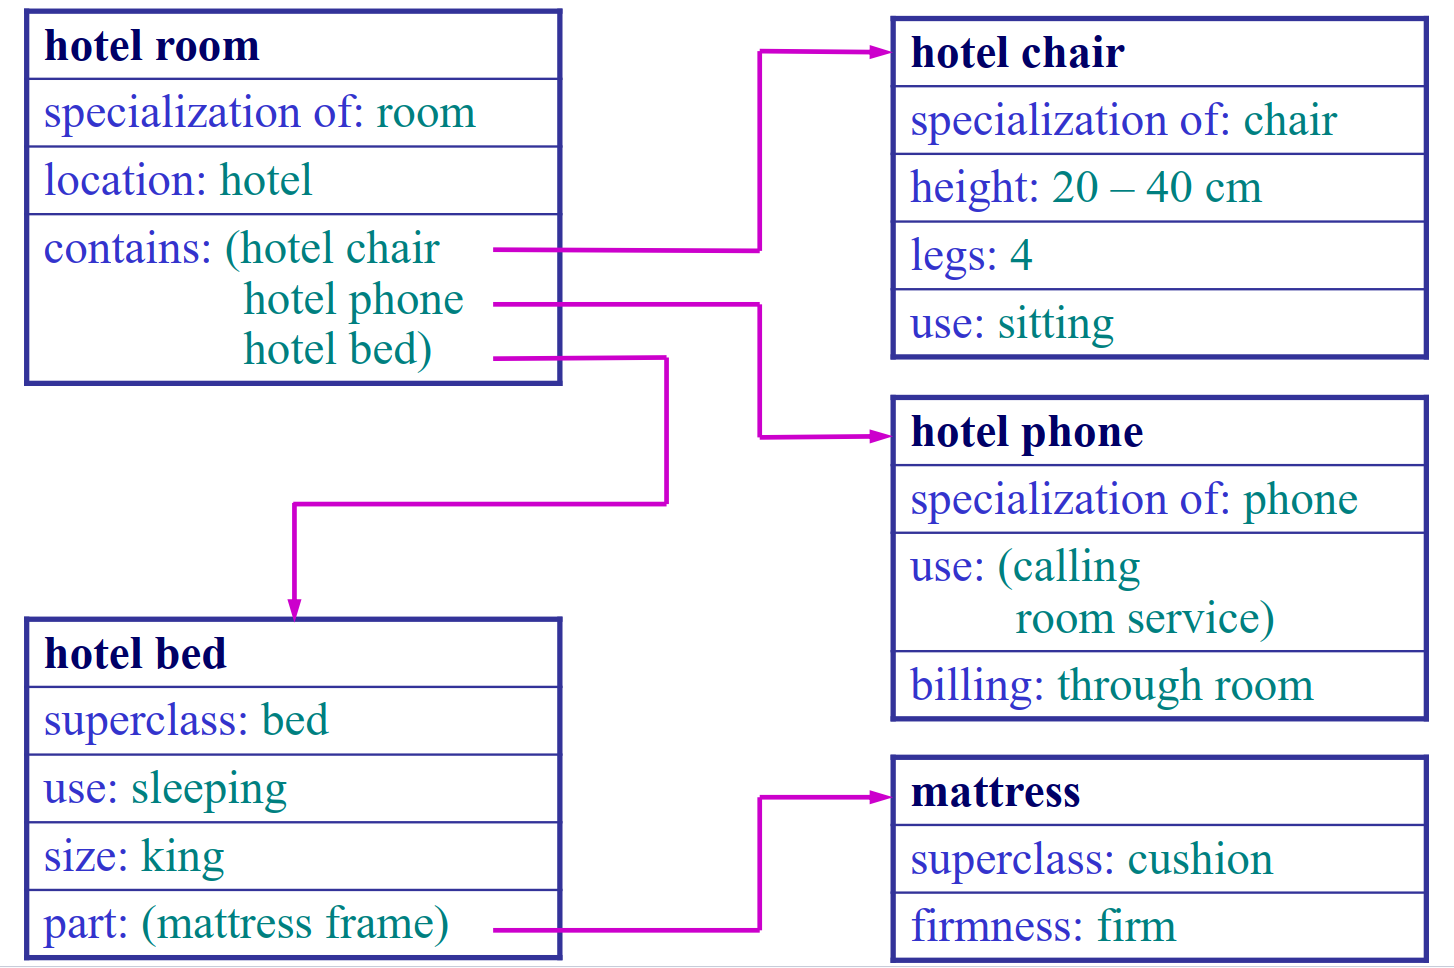
hotel room 这个框架可以有
specialization of: room、location: hotel、contains: hotel chair, hotel phone, hotel bed
等槽。hotel bed 又可以有
use: sleeping、size: king、part: mattress, frame
等槽。这样一来,“酒店房间”不再只是一个孤立概念,而是一个由位置、组成部分、用途和默认属性构成的知识结构。
框架特别适合表示具有稳定结构的对象或场景,例如房间、课堂、餐厅、车辆、病例、会议流程等。它的优势在于人类看到一个场景时,常常会自动填补默认信息。例如听到“酒店房间”,我们通常会默认里面有床、椅子、电话或类似设备。框架正是用来表示这种“典型结构”的。
3.2 Slot 的类型与作用
框架中常见的 slot 类型包括:
| Slot 类型 | 作用 | 例子 |
|---|---|---|
| Frame identification information | 标识这个框架是什么 | hotel room、hotel bed |
| Relationship of this frame to other frames | 表示与其他框架的继承、包含、组成关系 | specialization of: room、part: mattress |
| Descriptors of requirements for a frame | 描述该框架必须满足的属性或约束 | 椅子有 4 条腿,床用于 sleeping |
| Procedural information | 访问或修改槽时触发某些过程 | 查询价格时自动计算费用 |
| Frame default information | 没有明确值时使用的默认信息 | 酒店床默认可供 sleeping |
| New instance information | 记录具体实例的新信息或覆盖默认值 | 某个房间的床不是 king size |
这些槽说明,框架不是简单的属性表。它既可以表达静态事实,也可以表达默认假设、继承关系、约束条件和过程。比如某个
hotel chair 默认高度是 \(20\) 到 \(40\) cm,如果具体房间中的椅子高度被测量为
\(45\)
cm,那么实例信息就可以覆盖默认信息。
3.3 框架系统中的推理
框架推理通常围绕槽值展开。最常见的是继承推理:子框架可以继承父框架的槽。例如
hotel chair 是 chair
的特殊形式,因此它可以继承椅子的一般属性,再增加酒店场景下的特殊属性。
第二种常见推理是默认值填充。当系统没有得到某个槽的明确值时,可以使用框架中的默认值。比如只说“酒店房间里有一张床”,如果没有更多信息,系统可以默认这张床用于睡觉、有床垫和床架。默认值让系统能够在信息不完整时继续推理。
第三种是实例覆盖。默认值并不等于永远正确,具体实例的信息通常优先级更高。比如酒店床默认是 king size,但某个具体房间可能是 twin bed,那么具体实例的槽值应该覆盖默认值。
3.4 “John is like a fire engine” 例子到底想说明什么
这里有一个看起来很怪的例子:John like a fire engine.
更自然地说应该是 John is like a fire engine.,意思是 John
像一辆消防车。
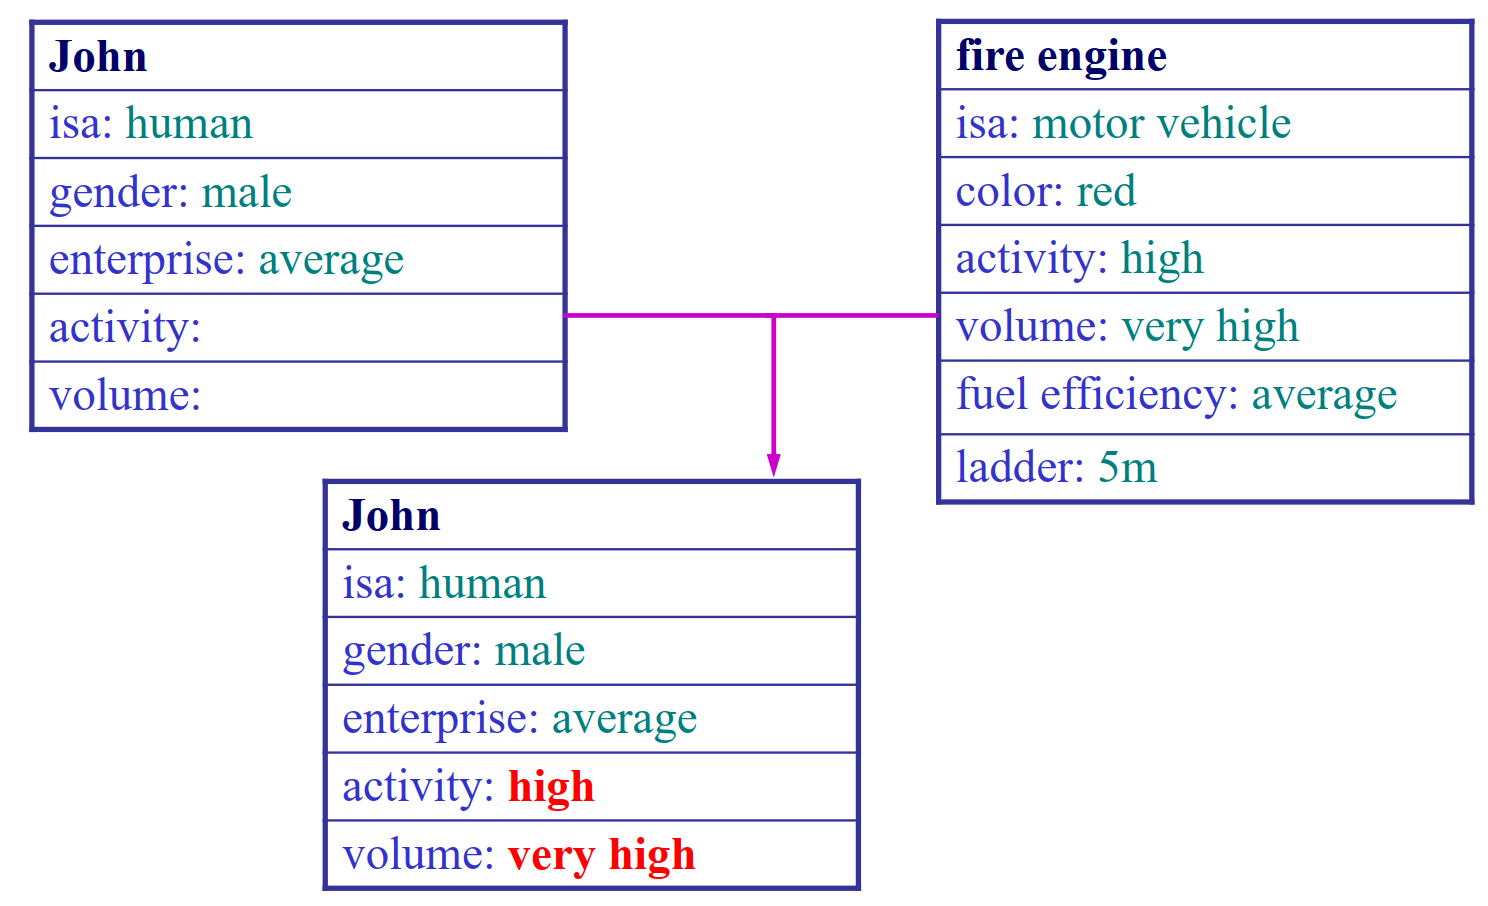
消防车框架中有很多槽,例如
isa: motor vehicle、color: red、activity: high、volume: very high、fuel efficiency: average、ladder: 5m。如果系统听到“John
像消防车”,它不能把消防车的所有槽都复制给 John。否则会推出 John
是机动车、John 是红色、John 有 \(5\)
米梯子,这显然荒唐。
这个例子真正想说明的是:框架推理必须根据关系的语义选择相关槽,而不是机械复制所有槽。
在 “like” 这个关系下,合理迁移的是 activity: high 和
volume: very high,也就是 John
可能很活跃、声音很大、动静很大;不应该迁移的是类别、颜色、燃油效率和梯子。
因此,这个例子是框架系统中“选择性继承”或“类比推理”的示意。它提醒我们,知识表示不仅要保存属性,还要知道哪些属性在当前语境下 relevant。
4 概念图:用图结构表达句子的语义
4.1 概念图的基本组成
Conceptual Graph(概念图) 是一种图形化知识表示方法,常用于表达自然语言句子的语义结构。它通常包含两类节点:概念节点(concept nodes) 和 关系节点(relation nodes)。概念节点表示实体、类别、属性值或命题中的对象;关系节点表示概念之间的语义关系。
概念图和语义网络很像,但二者有一个重要区别:语义网络常把关系画成边,而概念图通常把关系也画成节点。这样做的好处是,关系可以明确连接一个、两个或多个概念,从而表示不同元数的关系。
4.2 关系的元数:一元、二元和三元关系
关系的元数可以通过几个简单例子理解:
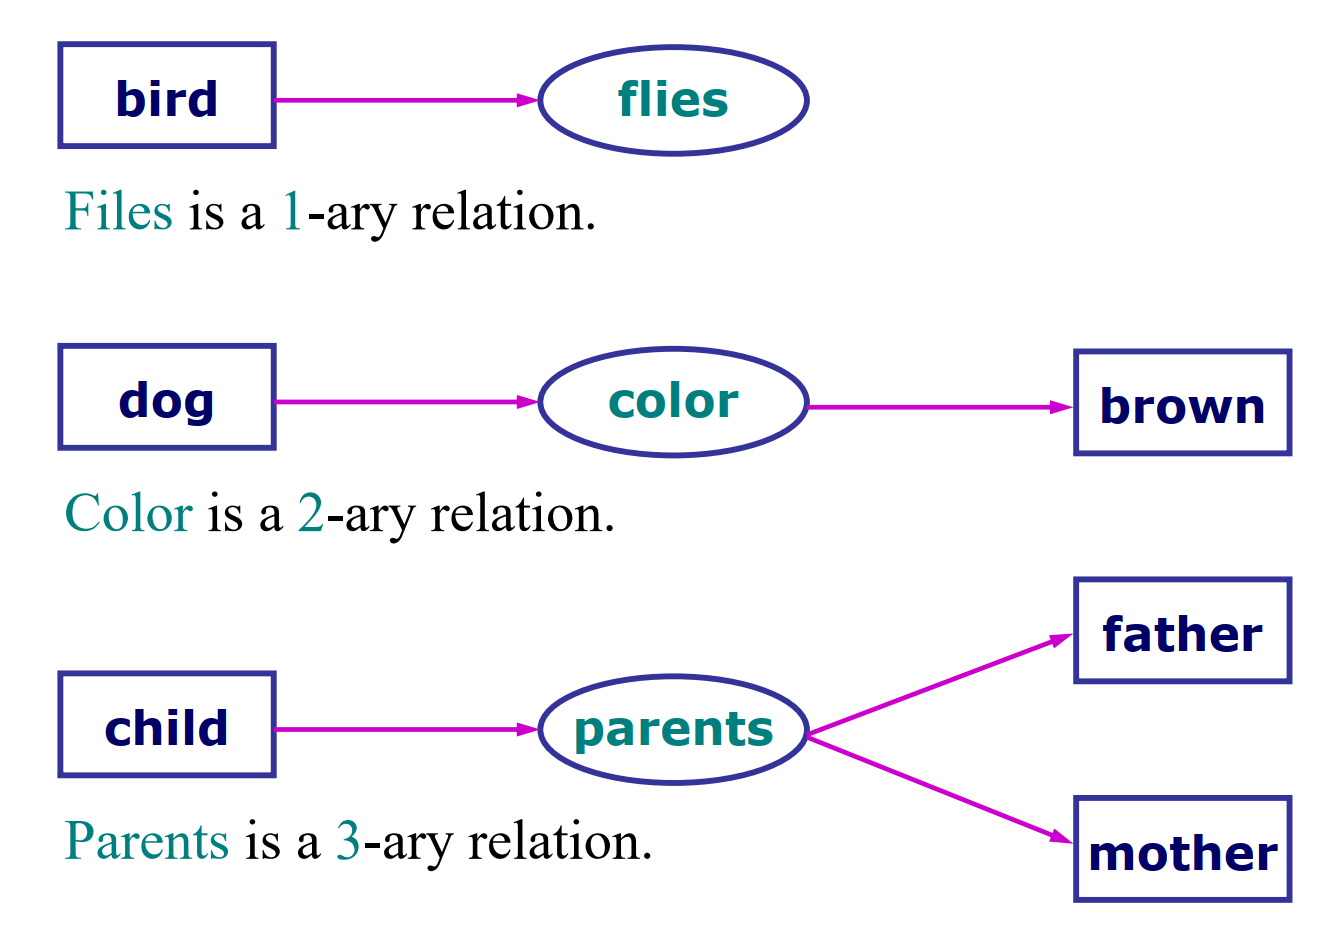
如果关系只连接一个概念,它就是一元关系。例如
bird - flies 表示鸟会飞,flies 是一个 \(1\) 元关系。
如果关系连接两个概念,它就是二元关系。例如
dog - color - brown 表示狗的颜色是棕色,color
是一个 \(2\)
元关系。这里的两个参与者分别是“被描述的对象”和“属性值”。
如果关系连接三个概念,它就是三元关系。例如
father, child, mother - parents
表达父亲、母亲和孩子之间的亲子关系,parents 是一个 \(3\)
元关系。这个例子说明,概念图不局限于二元关系,它可以比较自然地表达多参与者关系。
4.3 Marker:唯一标记与通用标记
概念图需要区分类别、具体个体和变量,因此引入了 marker。
Unique marker(唯一标记)
用于标识某个具体个体。这里的 dog:#007 表示“编号为 #007
的那只狗”。它不是泛泛地说狗这个类别,而是在说某个唯一确定的对象。
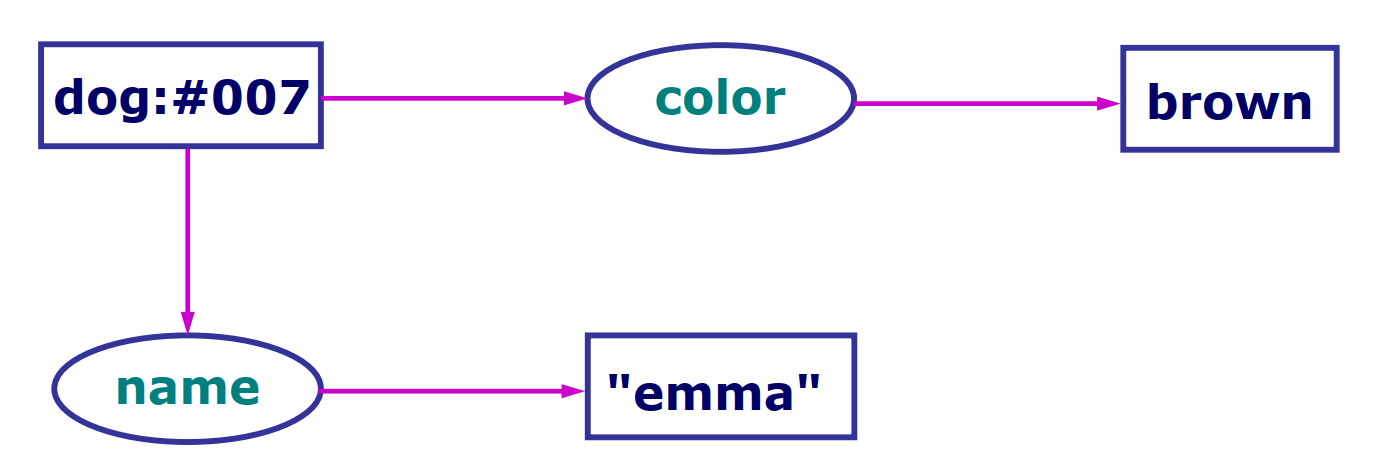
这个图表达的意思是:有一只唯一编号为 #007
的狗,它的名字是 Emma,颜色是
brown。这里需要唯一标记,是因为现实世界里可能有很多只叫 Emma
的狗。系统如果只根据名字识别对象,就可能把不同实体混淆。
Generic marker(通用标记)
用于表示某个未特指的个体或变量。这里的 dog:*X
表示“某只狗”,但不指定它的唯一编号。它和数学中的变量有点像:虽然不知道具体是哪一只狗,但图中所有连接到
dog:*X 的关系都指向同一个对象。
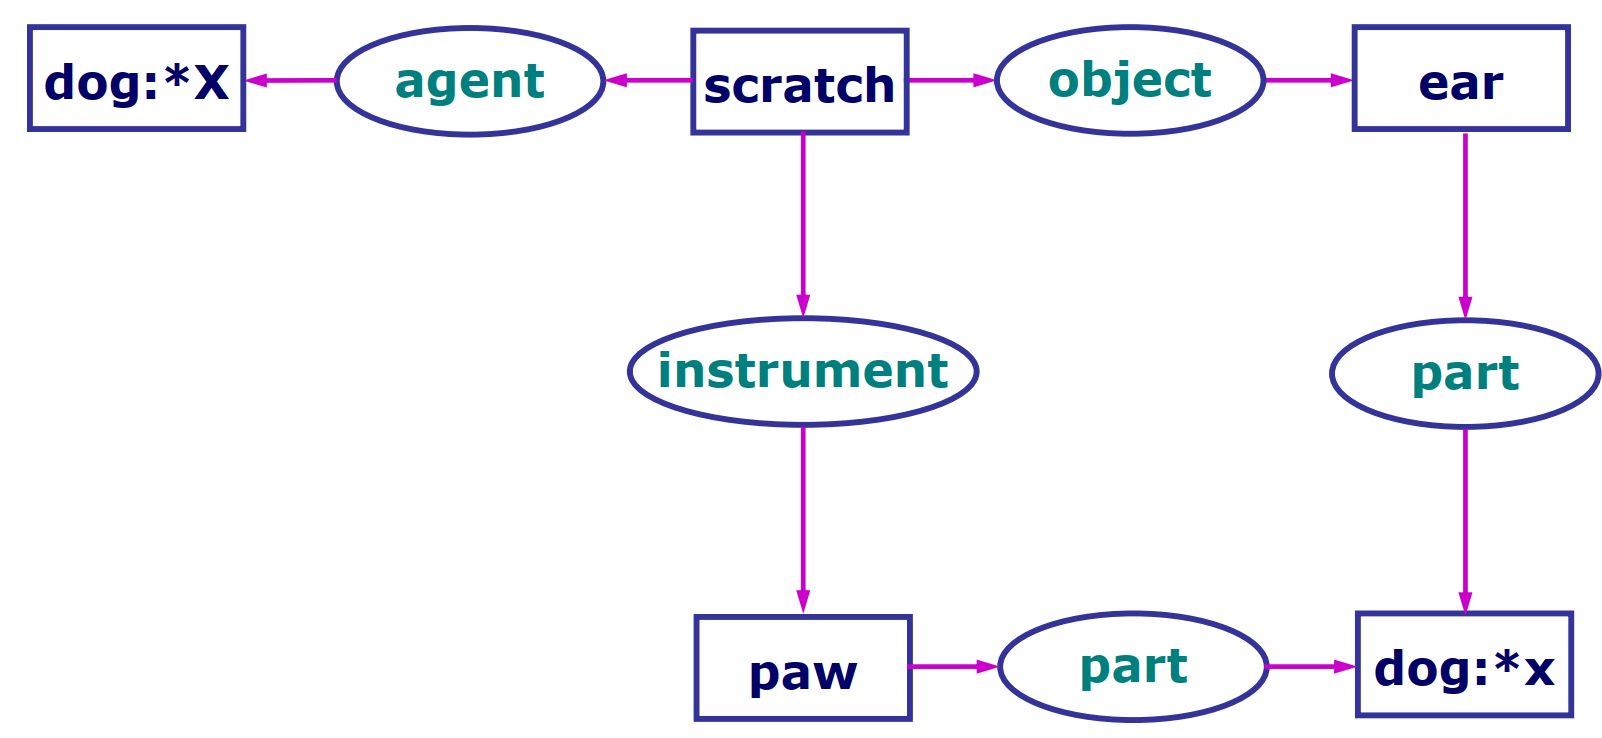
这个图表达句子 The dog scratches its ear with its paw.
难点在于 its。英语里的 its ear 和
its paw 都指同一只狗的身体部分。概念图通过
part 关系把 ear 和 paw
都连接回同一个 dog:*X,从而说明耳朵和爪子属于这只狗。
可以用下表快速区分:
| 表达 | 含义 | 例子 |
|---|---|---|
dog |
狗这个概念或类别 | 泛指 dog |
dog:#007 |
某个唯一确定的狗 | 编号为 #007 的狗 |
dog:*X |
某个未特指的狗,类似变量 | 某只狗抓自己的耳朵 |
4.4 命题概念:把一句话当作对象
自然语言中经常出现“相信、知道、认为、希望、说”等动词。这些动词的宾语往往不是一个普通对象,而是一整个命题。例如
Tom believes that Jane likes pizza. 中,Tom
相信的不是某个普通名词对象,而是 “Jane likes pizza” 这个完整命题。
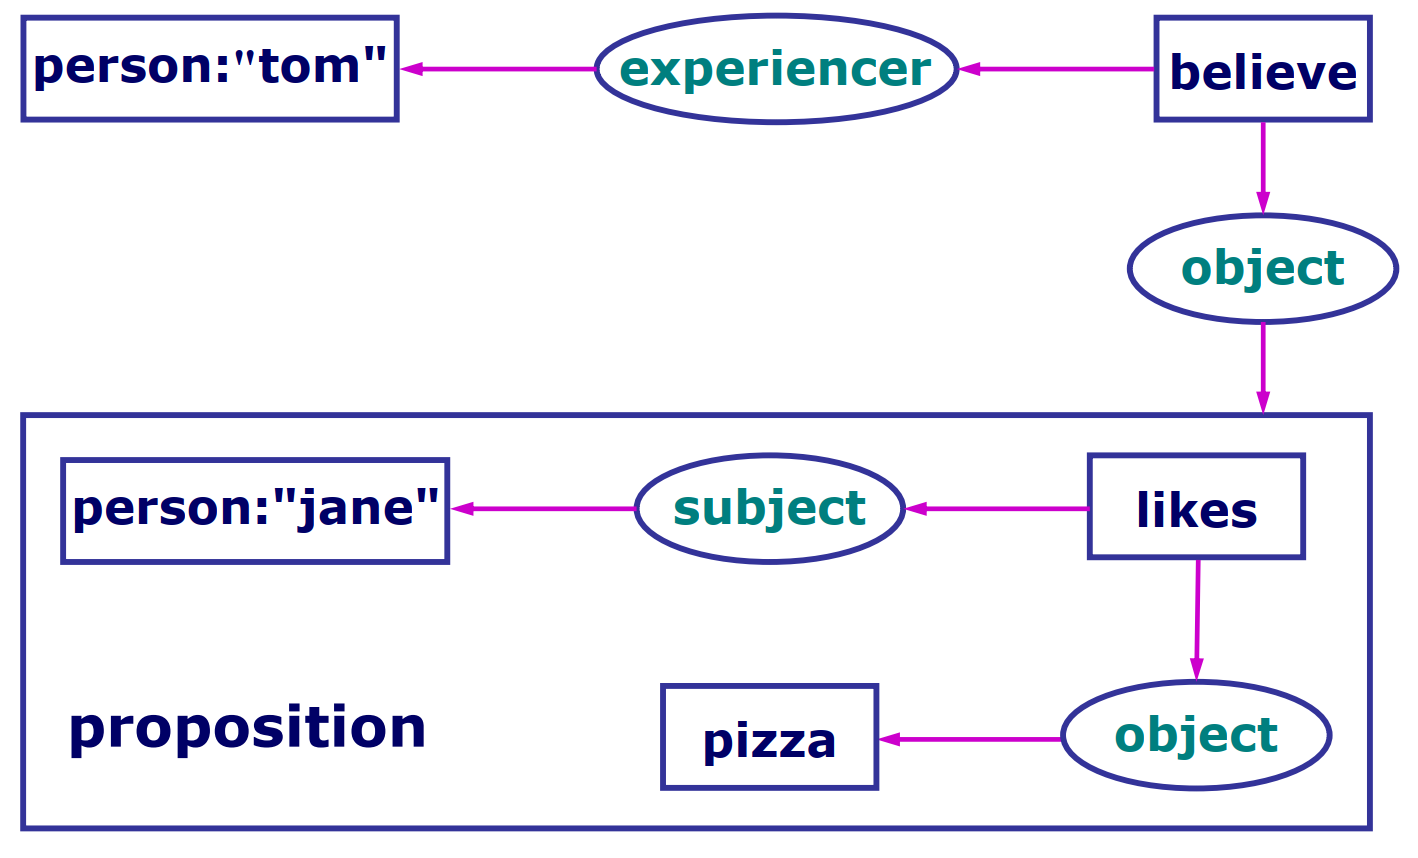
这句话的主干是 Tom believes something,但这个 something 不是
pizza,也不是 Jane,而是完整命题 “Jane likes pizza”。因此概念图中需要把
Jane likes pizza 包装成一个
proposition(命题概念),再作为 believe 的
object。
这和语法中的宾语从句很像。关键是要区分两个层次:第一层是 “Tom believes P”,第二层是命题 \(P=\) “Jane likes pizza”。Tom 相信 \(P\),并不自动意味着 \(P\) 一定为真。也就是说,“某人相信一件事”和“这件事本身是真的”是两个不同问题。知识表示如果不能区分这两层,就会把信念误当事实。
4.5 概念图推理:Restriction、Join、Simplify
概念图有三种基本操作:restriction、join 和 simplify。它们的作用分别是细化概念、合并图和删除冗余。
G1 表示某只狗作为 agent 执行 eat,object 是
bone。G2 表示 animal:"emma" 的颜色是
brown,并且位置在 porch。
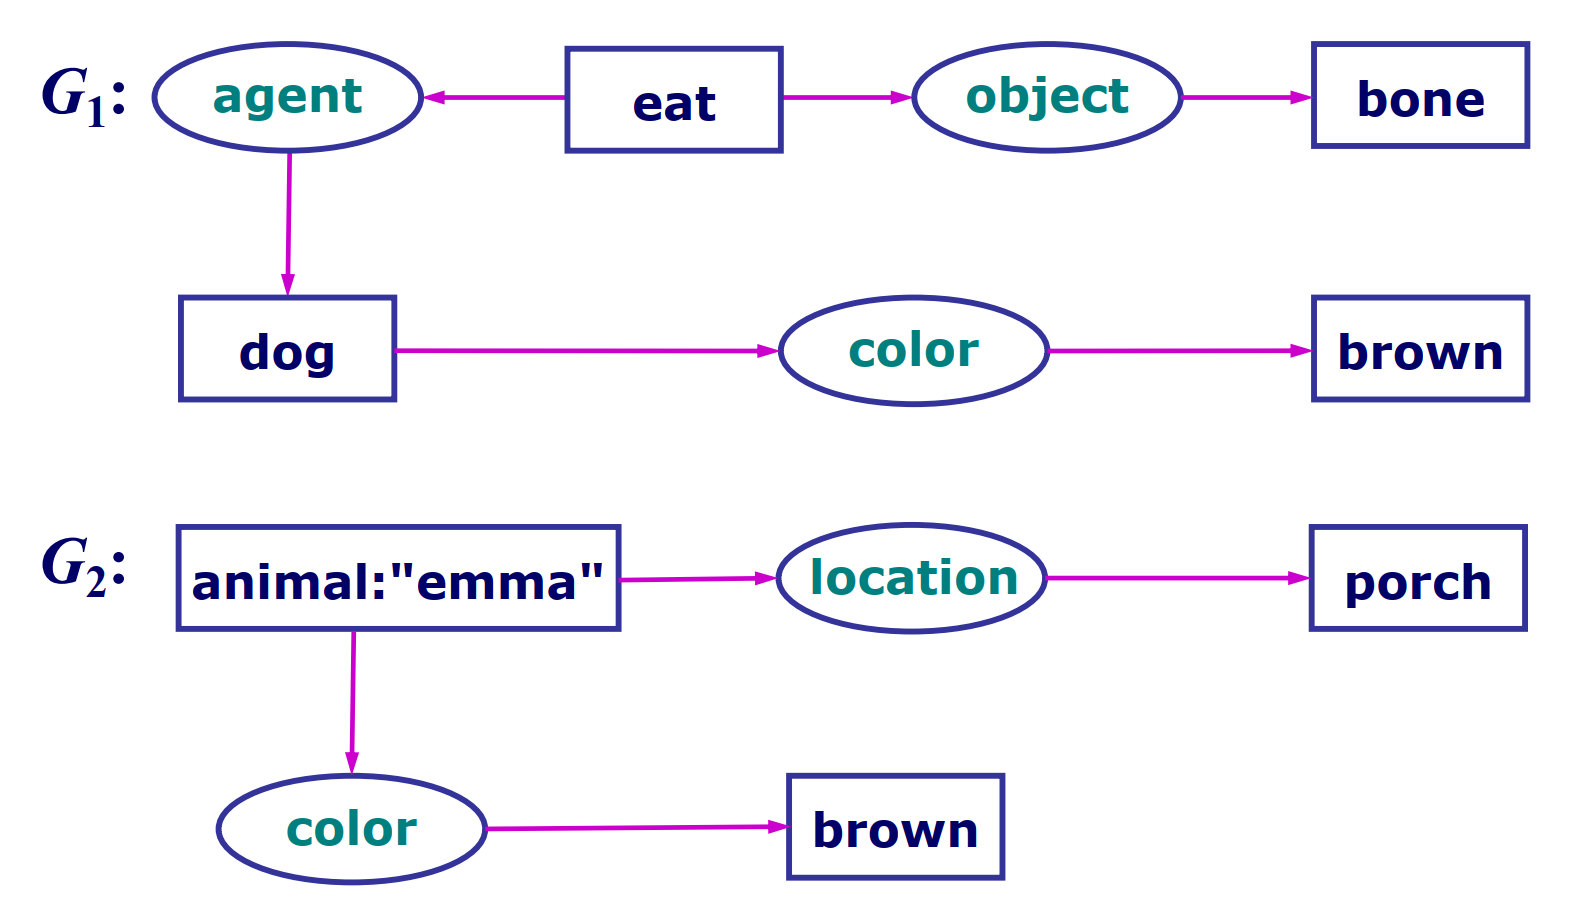
Restriction operation,限制操作
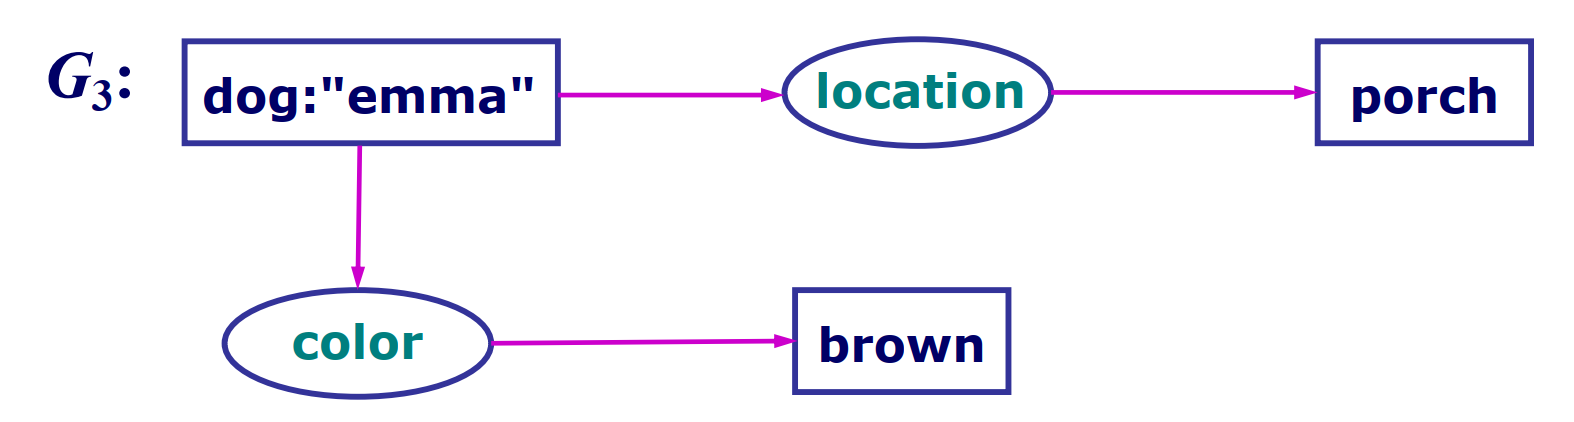
是把更一般的概念限制为更具体的概念。这里 G3 把
animal:"emma" 限制为
dog:"emma"。这背后的逻辑是,dog 是 animal
的子类,因此如果我们知道 Emma 是狗,就能把原来较泛的 animal 类型具体化为
dog。
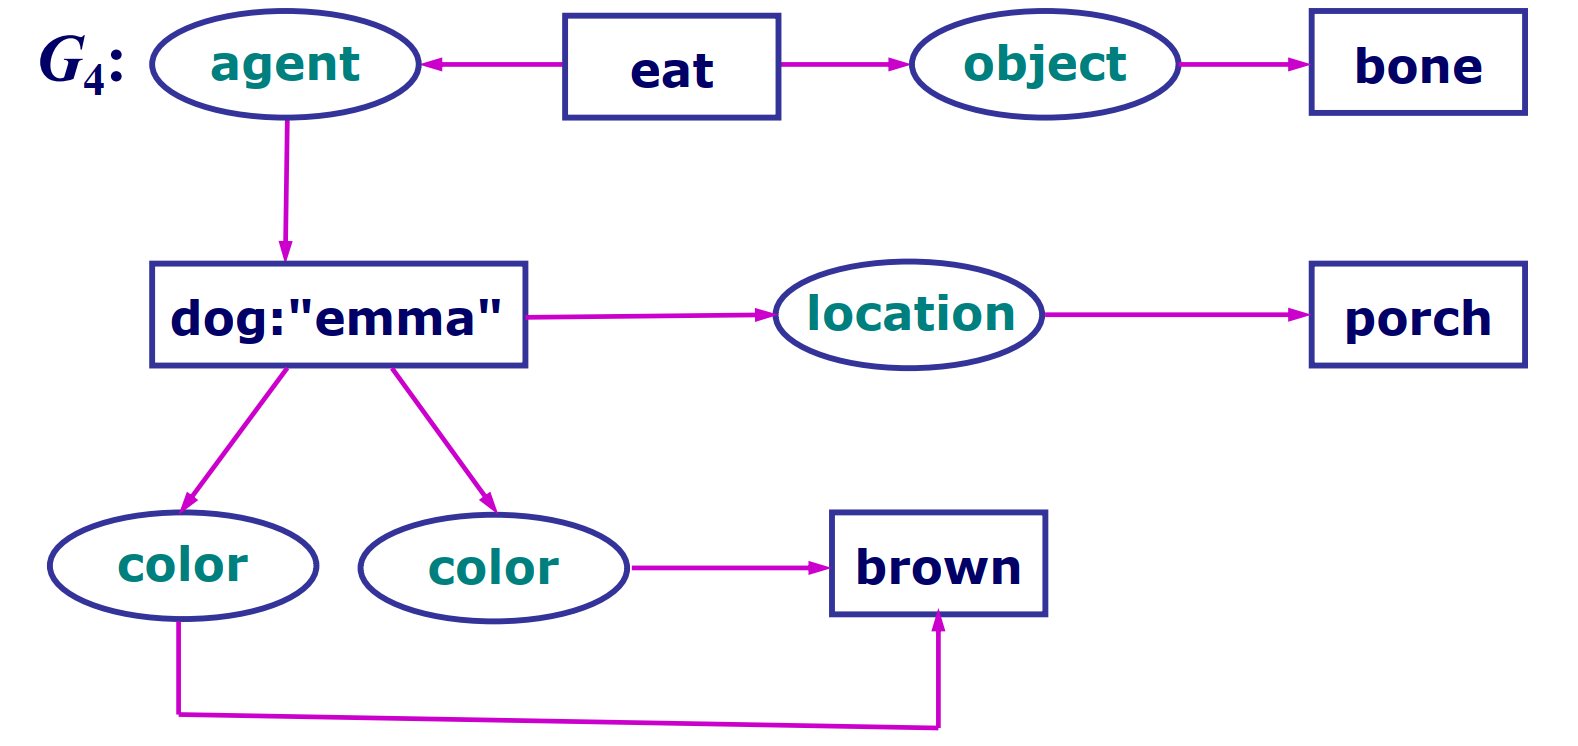
Join operation,连接操作 是把两个或多个图中可对应的节点合并,形成更大的图。这里 G4 把关于 Emma 的吃骨头信息、颜色信息和位置信息合并到同一个实体上。
Simplify operation,简化操作 是删除 join 后产生的重复节点或冗余结构,得到更紧凑的图 G5。
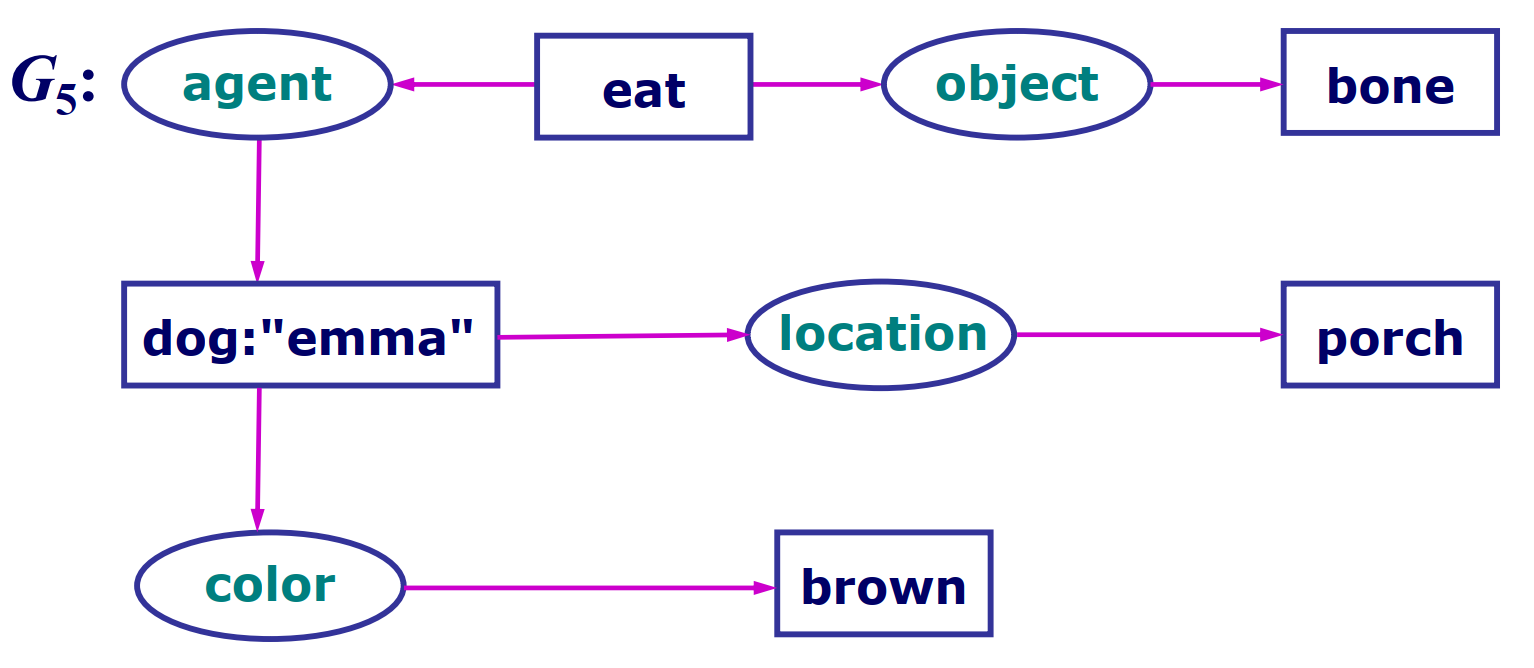
最终,系统可以得到一组连贯知识:Emma 是一只狗,Emma 是棕色的,Emma 在 porch,Emma 正在吃 bone。这个例子说明,概念图推理不是靠单条规则完成的,而是通过图结构的细化、合并和化简逐步得到更完整的表示。
5 知识图谱:RDF 三元组与 SPARQL 查询
5.1 三元组:知识图谱的基本事实单位
Sean Penn 这个例子可以用来说明知识图谱中的三元组。知识图谱通常把事实表示为:
\[ (\text{subject},\text{predicate},\text{object}) \]
也就是“主语、谓语、宾语”。例如:
\[ (\text{Sean Penn},\text{occupation},\text{Actor}) \]
这条三元组表达的意思是:Sean Penn 的职业是演员。
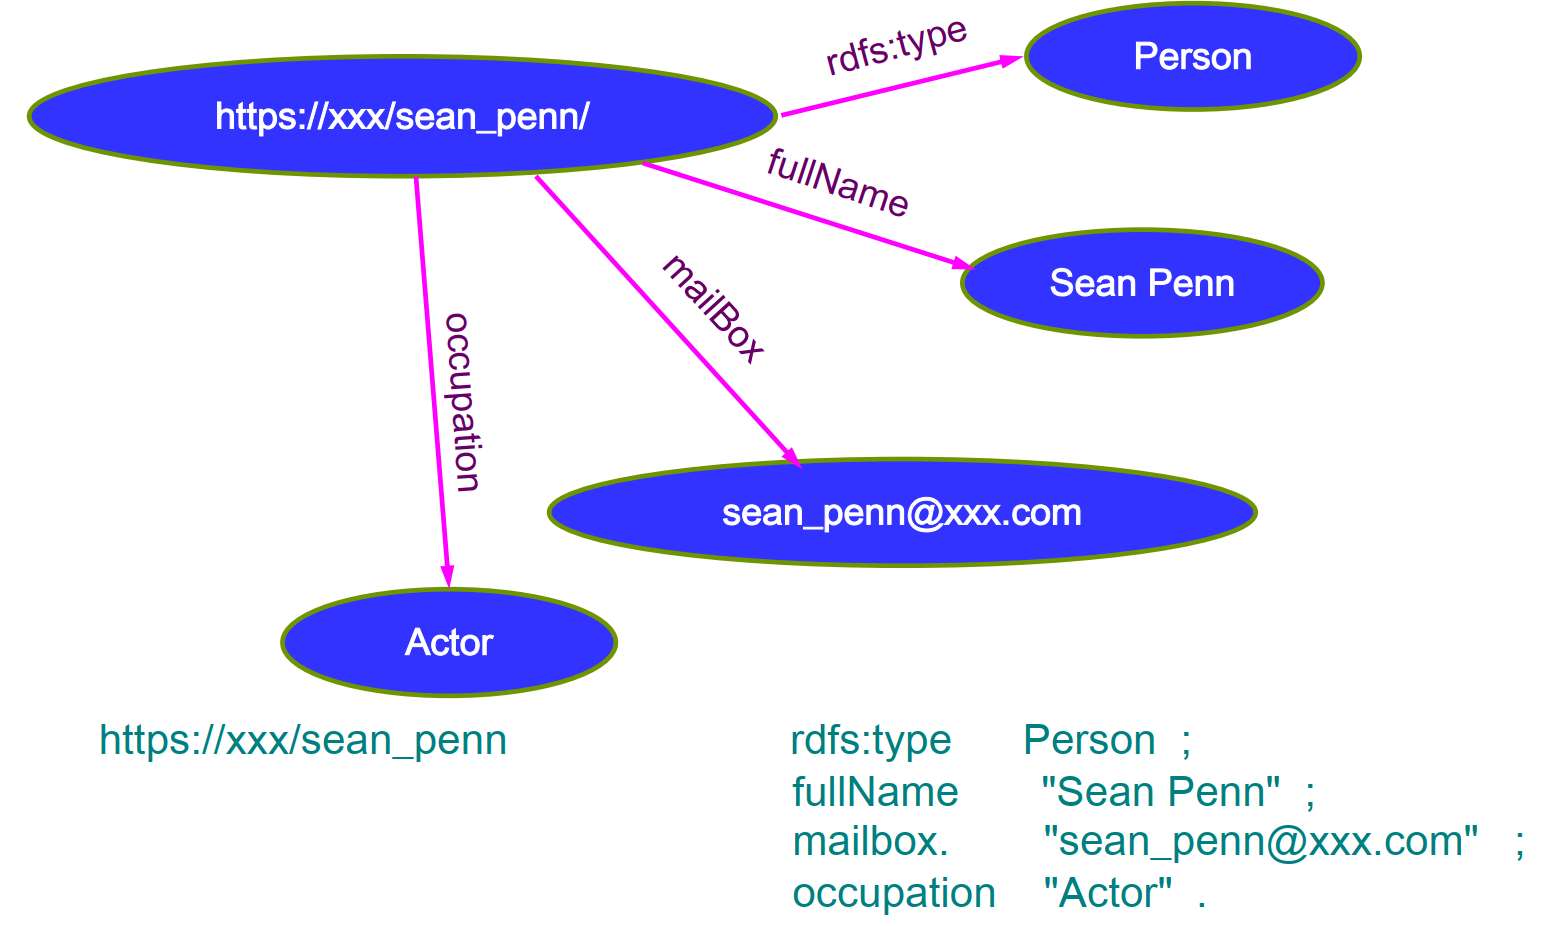
这里的例子可以整理为:
| Subject | Predicate | Object |
|---|---|---|
https://xxx/sean_penn/ |
rdfs:type |
Person |
https://xxx/sean_penn/ |
fullName |
"Sean Penn" |
https://xxx/sean_penn/ |
mailbox |
"sean_penn@xxx.com" |
https://xxx/sean_penn/ |
occupation |
"Actor" |
这些三元组共同描述了一个实体:它是一个人,名字叫 Sean Penn,有邮箱,有职业。每条三元组都很小,但大量三元组连接起来,就能形成知识图谱。
5.2 RDF:资源描述框架
RDF,Resource Description Framework,资源描述框架,是 Web 语义网和知识图谱中常用的一种标准数据模型。根据 W3C 的定义,RDF 的核心思想就是用三元组描述资源之间的关系。
在 RDF 中,subject 通常是一个资源 URI 或空白节点,predicate
通常是表示属性或关系的 URI,object
可以是另一个资源、空白节点,也可以是字符串、数字等字面量。这里
https://xxx/sean_penn/ 就是一个资源标识符,它比直接写 “Sean
Penn” 更适合机器处理,因为 URI 可以尽量指向唯一资源。
Sean Penn 是一个真实人物,中文通常译作西恩·潘,是美国演员和导演。这里关注的不是他的生平,而是如何把他作为知识图谱中的一个 entity,并用 RDF 三元组描述现实世界中的人。
RDF 与前面的语义网络、概念图有明显联系。它们都在表达“实体之间有什么关系”。区别在于,RDF 是更工程化、标准化的数据模型,适合在 Web 和数据库中大规模存储、交换和查询。
5.3 SPARQL:查询 RDF 图的语言
如果 RDF 用来存储知识图谱,那么 SPARQL 就是用来查询 RDF 图的语言。这里出现了:
1 | SELECT ?author ?titre ?homepage |
这表示查询结果希望返回三个变量:作者、标题和主页。SPARQL 查询的基本思想是写出一组图模式,让系统在 RDF 图中寻找匹配的三元组,并把匹配到的资源绑定到变量上。
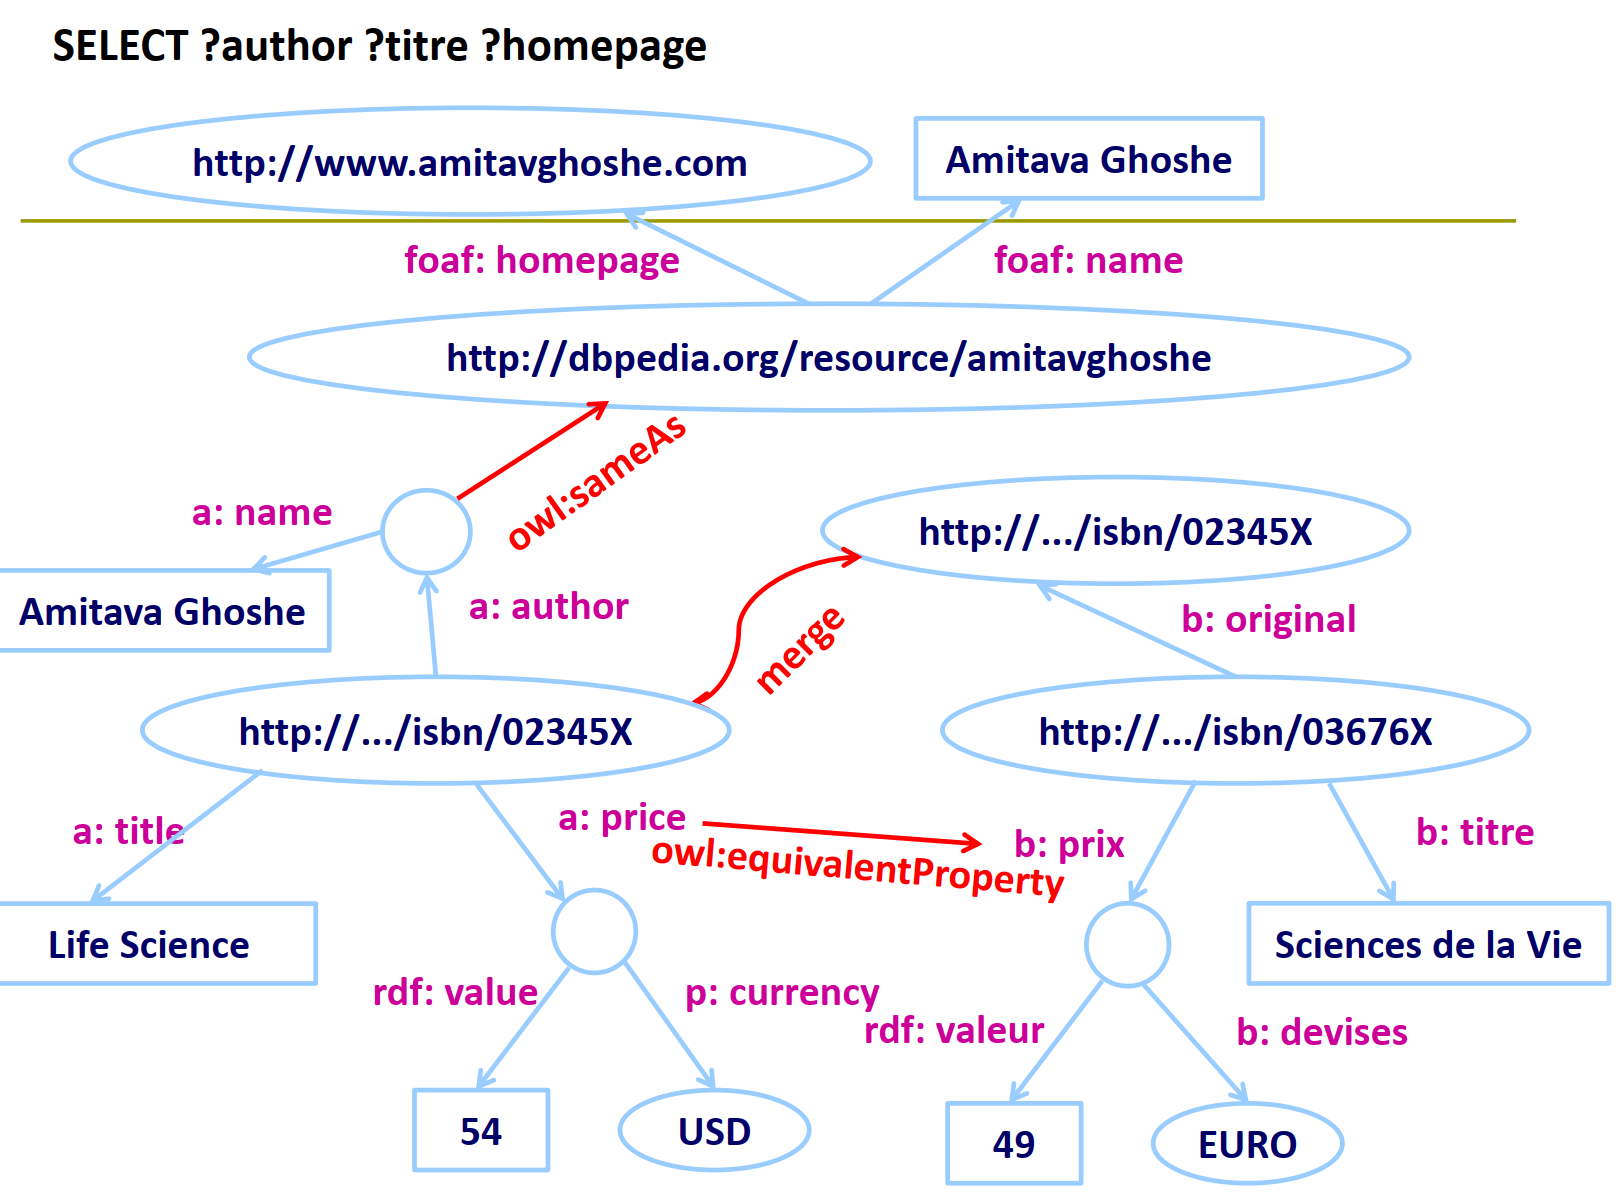
可以把它类比为数据库中的 SQL,但 SPARQL 面向的是图结构数据。SQL 常在表中查行列,而 SPARQL 常在三元组图中查节点和边的匹配关系。
5.4 本体映射:owl:sameAs 与 owl:equivalentProperty
这里的 SPARQL 例子不只是查询,还暗示了一个更重要的问题:不同数据源可能用不同名字描述同一件事。
例如,一个英文数据源可能用 a:title
表示书名,另一个法文数据源可能用 b:titre
表示书名。它们名字不同,但语义相同。此时可以用
owl:equivalentProperty 表示两个属性等价。类似地,如果两个
URI 指向同一个真实作者,可以用 owl:sameAs
表示它们其实是同一个实体。
这类映射对知识图谱非常重要。没有映射时,系统可能把同一个作者看成两个人,把同一种属性看成两种关系;有了映射后,系统就能跨数据源合并信息。例如,一个数据源知道作者主页,另一个数据源知道作者写了哪本书,系统通过
owl:sameAs 就能把这些事实连起来。
6 从自然语言到知识表示
6.1 输入与句法分析
Tarzan kissed Jane.
可以用来展示自然语言理解如何一步步转成知识表示。第一步是输入原始句子,第二步是
parsing,也就是句法分析。
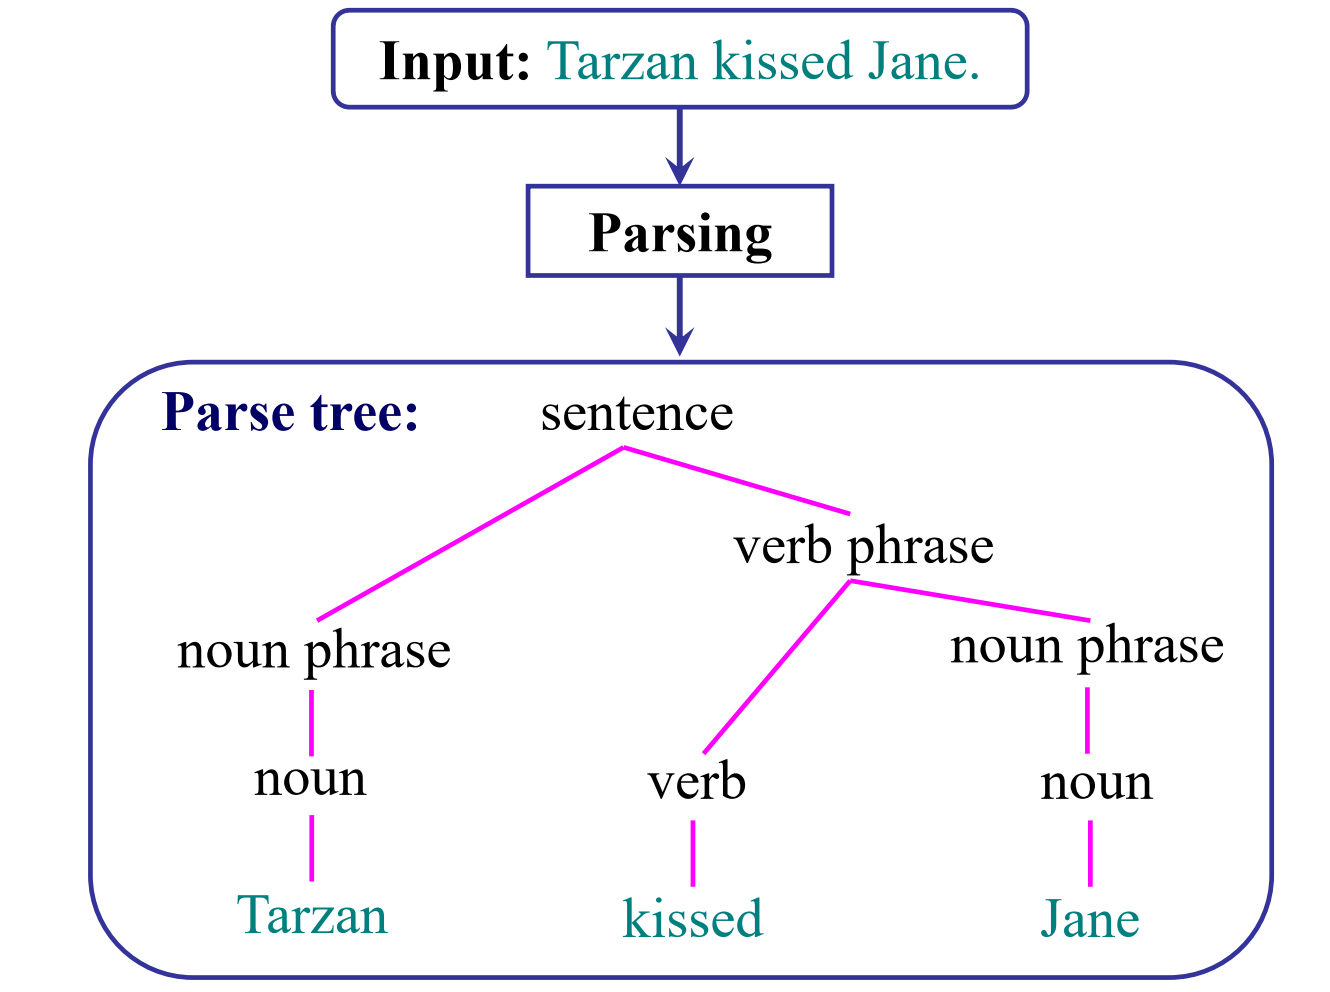
句法分析要回答的是“这个句子的语法结构是什么”。在这个例子中,整个句子可以分成名词短语
Tarzan 和动词短语
kissed Jane;动词短语中又包含动词 kissed
和名词短语
Jane。这一步还没有真正理解世界意义,只是在确定词语如何组成句子。
6.2 语义解释:从语法结构到内部表示
第三步是 semantic interpretation,也就是把句法结构转成内部语义表示。
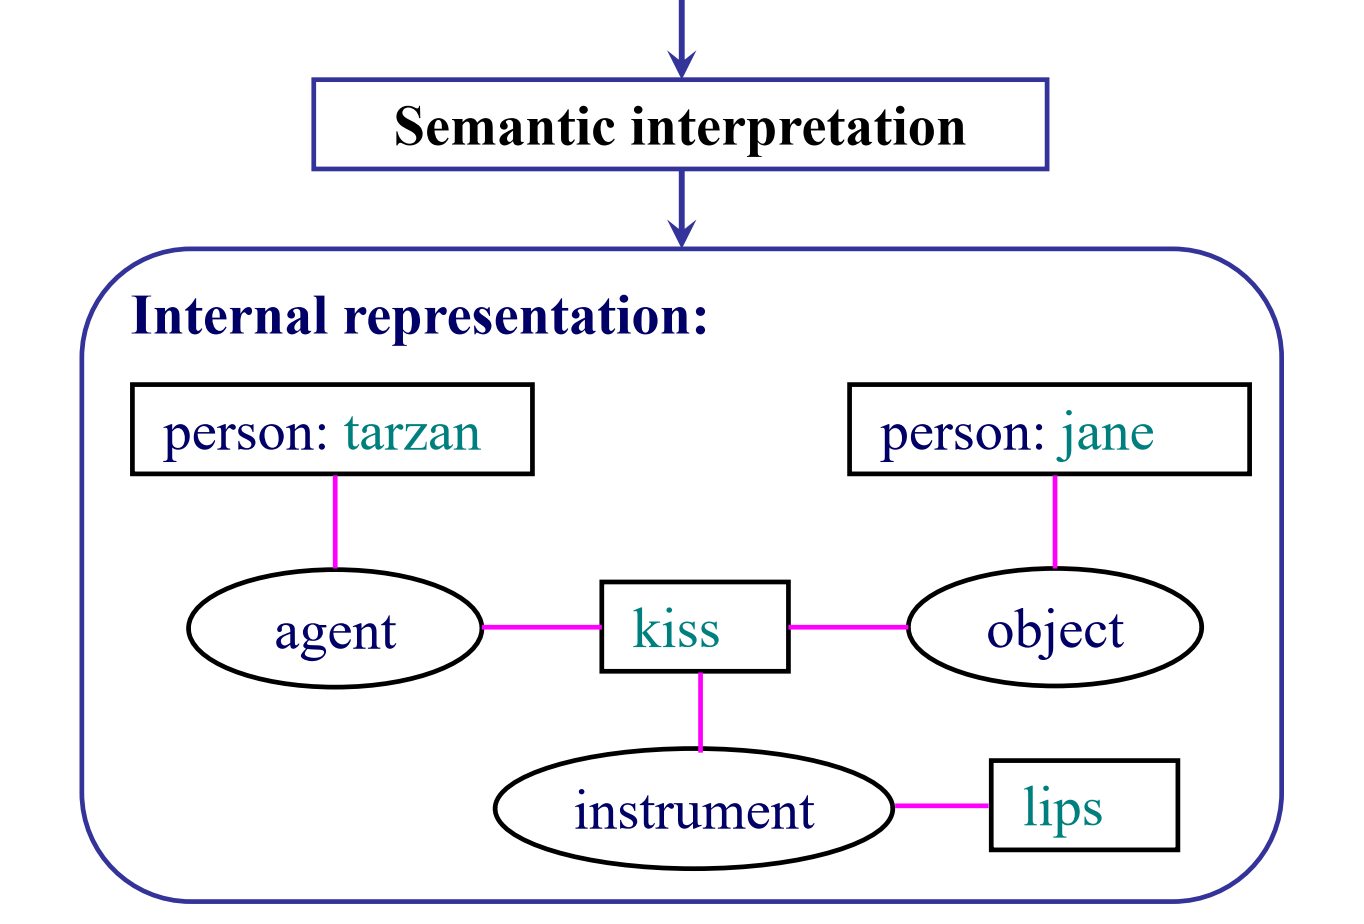
在这个内部表示中,person: tarzan 是 kiss
这个动作的 agent,person: jane 是 object,lips
是
instrument。这里的重点是,系统不只是知道句子里有三个词,而是知道“谁对谁做了什么,用什么做”。
这个过程体现了概念图和语义角色的作用。自然语言中的主语、宾语和介词短语,最终要转化为 agent、object、instrument、location 等语义角色。只有完成这一步,系统才可能回答问题或进一步推理。
6.3 上下文与世界知识解释
第四步是 contextual / world knowledge interpretation,也就是结合上下文和世界知识扩展表示。
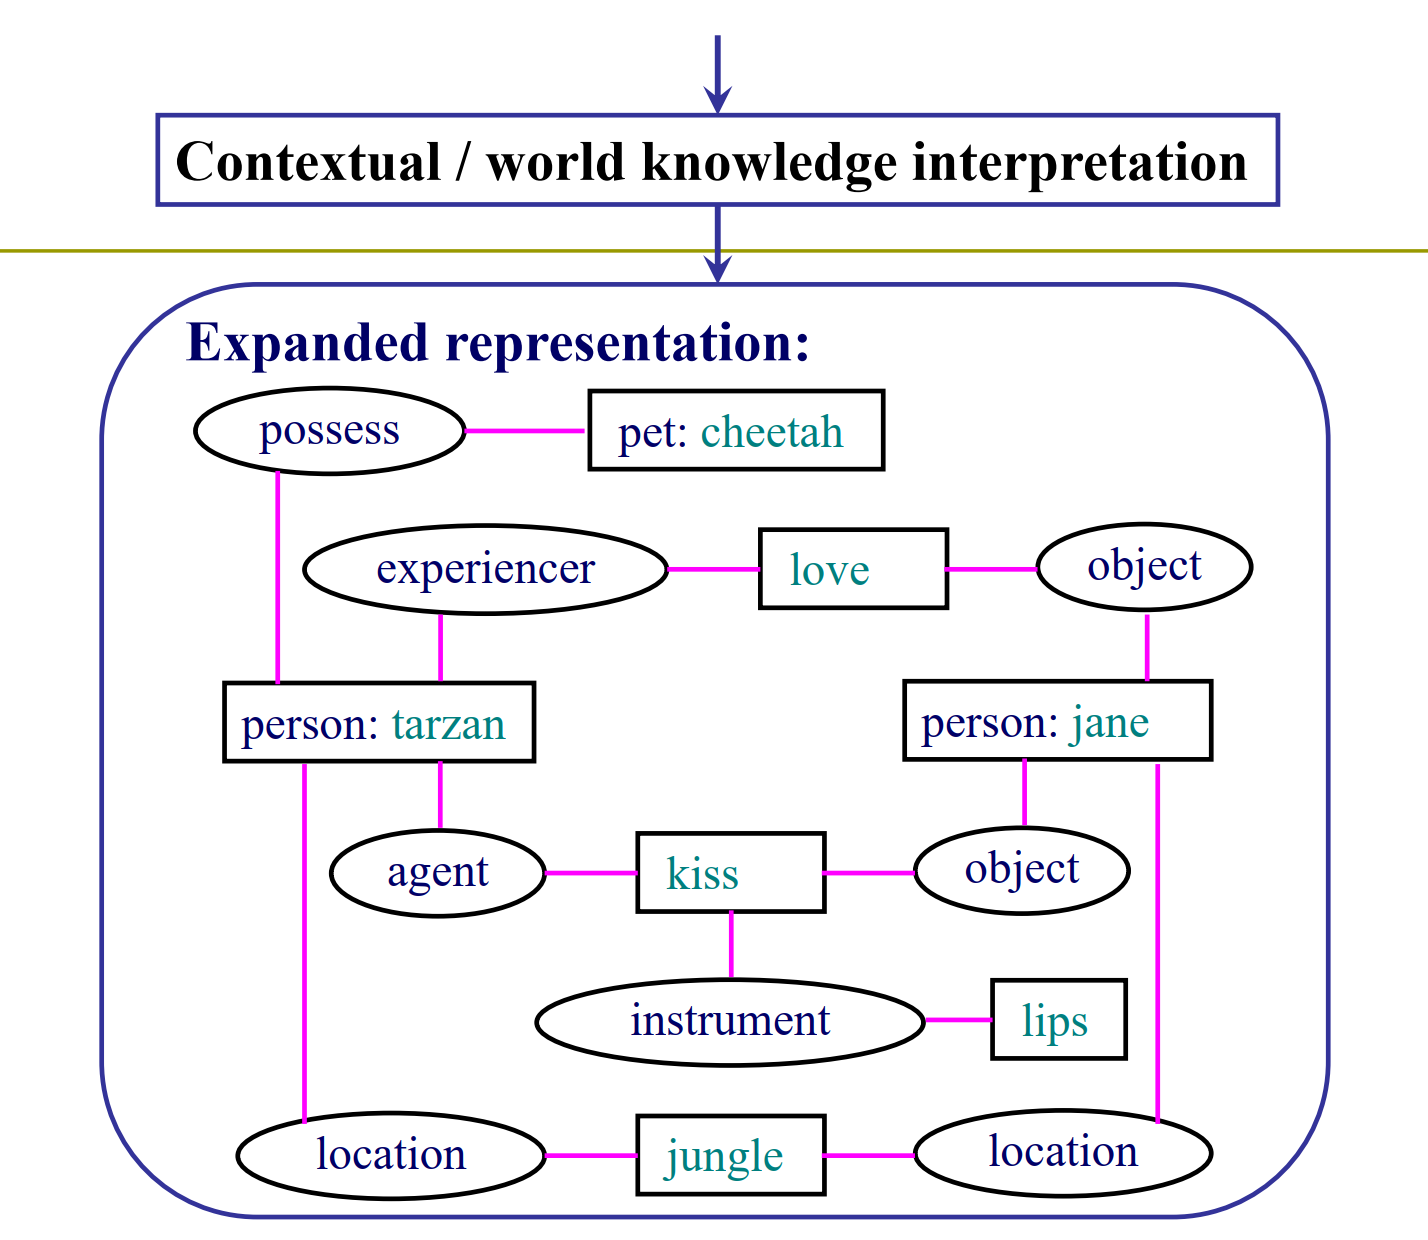
扩展图中加入了 Tarzan 的宠物 Cheetah、Jane 与 love 的关系、jungle 作为 location 等背景信息。也就是说,系统不只处理句子字面信息,还把它放进更大的世界知识中解释。
这一步很重要,因为自然语言常常省略大量常识。比如人类看到 “Tarzan kissed Jane” 可能会自动联想到 Tarzan、Jane、jungle 等背景,但机器不会自动知道这些。知识表示系统需要把这些背景知识显式组织起来,才能做更深层的理解。
6.4 下游应用:问答、查询、翻译与生成
当句子被转换成内部知识表示后,它就可以服务于 question answerer、database query handler、translator、language generator 和 speech synthesis 等应用。
这条流程可以概括为:自然语言输入先变成句法结构,再变成语义结构,再结合世界知识扩展,最后交给问答、查询、翻译或生成模块使用。也就是说,知识表示是自然语言处理系统中连接“文字表面形式”和“机器可操作意义”的桥梁。
7 其他知识表示方法概览
7.1 逻辑、产生式规则与决策表
除了前面几类方法,还有一批其他知识表示方法。它们不需要全部展开,但要知道各自适合什么问题。
逻辑表示包括命题逻辑、一阶逻辑、描述逻辑和模态逻辑。逻辑的优点是形式严谨,适合表达精确规则和进行严格推理。例如一阶逻辑可以写出“所有人都会死亡”这类带量词的命题。但逻辑表示的缺点是常识知识很庞杂,例外和不确定性处理起来不轻松。
产生式规则通常写成:
\[ \text{IF 条件 THEN 结论或动作} \]
它在专家系统中非常常见。例如“如果病人发烧且咳嗽,那么怀疑呼吸道感染”。这种表示容易理解、容易维护,但当规则数量很多时,规则之间可能冲突,系统也可能难以解释复杂链式推理。
决策表适合把条件组合和对应动作整理成表格。它常用于业务规则、测试用例和诊断流程。相比产生式规则,决策表更适合系统检查“各种条件组合是否都覆盖到了”。
7.2 神经网络、贝叶斯网络与不确定性表示
人工神经网络用大量参数表示知识。它不像语义网络或框架那样把知识显式写成节点、边和槽,而是通过训练把模式分布在权重中。它的优点是擅长从数据中学习复杂模式,缺点是可解释性较弱。
贝叶斯网络用有向无环图表示随机变量之间的条件依赖,适合处理不确定性推理。例如疾病、症状、检测结果之间不是简单的必然关系,而是概率关系,贝叶斯网络就能表达“某症状在某疾病下出现的概率”。
Neurules 可以理解为神经网络和规则方法的结合方向,目标是在学习能力和可解释性之间取得折中。它不像单纯神经网络那样完全黑箱,也不像传统规则那样完全依赖人工编写。
7.3 Script、Petri Net、OAV triples 等方法
Script,脚本 用于表示典型事件序列。例如“去餐厅吃饭”通常包括进入餐厅、入座、点餐、用餐、付款、离开。脚本适合表达常识场景和事件流程。
Knowledge Petri net,知识 Petri 网 借助 Petri 网表达状态、变迁和流程,适合描述并发、资源流动和状态变化。
Object-attribute-value triples,对象-属性-值三元组 的形式是:
\[ (\text{object},\text{attribute},\text{value}) \]
例如 (dog, color, brown)。它和 RDF
三元组很接近,但通常更强调对象属性描述,而 RDF 更强调 Web
资源及其关系。
Language field theory,语言场论 在 这里只列出名称,可以理解为从语言结构或语义场角度组织知识的一类理论。本章不要求深入展开,学习时知道它属于其他知识表示方向即可。
8 方法对比与学习主线
8.1 四种方法对比
| 方法 | 核心表示 | 最适合表达 | 主要推理方式 | 典型问题 |
|---|---|---|---|---|
| 语义网络 | 节点 + 关系边 | 概念层级、属性继承、对象关系 | 路径搜索、继承、关系组合 | 例外和继承冲突 |
| 框架 | 对象/场景 + slot | 典型对象、场景结构、默认属性 | 槽值继承、默认值填充、实例覆盖 | 多重继承、默认值冲突 |
| 概念图 | 概念节点 + 关系节点 | 自然语言语义、事件角色、多元关系 | restriction、join、simplify | 大规模使用时需要标准化工具 |
| 知识图谱 | RDF 三元组 | 大规模实体关系、Web 数据集成 | 类型推理、属性映射、SPARQL 查询 | 实体消歧、关系对齐、数据质量 |
这四种方法不是互相替代的关系,而是面向不同任务。语义网络强调层级和继承,框架强调对象内部结构,概念图强调句子和事件语义,知识图谱强调大规模实体关系数据。练习如果让比较它们,不要只背定义,要说清楚“它们各自把知识组织成什么形式,以及这种形式适合做什么推理”。
8.2 学习主线
理解这些知识表示方法时,不要把每个知识点孤立看待。可以按照“知识如何被组织、如何被推理、适合解决什么问题”这条线串起来。语义网络和框架都关心常识结构,但一个偏图,一个偏对象模板;概念图和自然语言理解联系紧密,因为它能表示动作、角色和命题;RDF 和 SPARQL 则把知识表示推进到工程层面,用标准三元组和查询语言支持大规模知识图谱。
四个例子可以把本章核心思想串起来:金丝雀语义网络说明继承,hotel room 说明框架和 slot,Tom believes that Jane likes pizza 说明命题概念,Sean Penn 说明 RDF 三元组。
9 参考资料与补充来源
- W3C RDF 1.1 Concepts and Abstract Syntax:RDF 以三元组形式表达资源之间的关系,三元组由 subject、predicate、object 组成。参考:https://www.w3.org/TR/rdf11-concepts/
- W3C SPARQL 1.1 Query Language:SPARQL 使用图模式匹配 RDF
数据,并可通过
SELECT返回变量绑定。参考:https://www.w3.org/TR/sparql11-query/ - John F. Sowa, Conceptual Graphs:概念图用于以图结构表示概念与概念关系,可与逻辑形式对应。参考:https://www.jfsowa.com/cg/
- Marvin Minsky, A Framework for Representing Knowledge:框架理论强调用结构化槽位表示典型对象和场景。参考:https://web.media.mit.edu/~minsky/papers/Frames/frames.html
- Semantic network 补充:语义网络通常用图表示概念间关系,并支持继承式推理。参考:https://www.britannica.com/technology/semantic-network