目录
- 不确定性、错误类型与归纳推理
- 非单调推理:为什么新信息会推翻旧结论
- 经典概率与假设检验的局限
- 贝叶斯定理与贝叶斯决策
- 贝叶斯方法的困难与贝叶斯网络
- MYCIN、信任/不信任与确定性因子
- 时间推理、随机过程与马尔可夫链
- 模糊集、语言变量与模糊推理
- 方法总结:概念区分与计算流程
1 不确定性、错误类型与归纳推理
1.1 什么是不确定性
本章讨论的核心问题是:智能系统在信息不完整、不精确甚至互相冲突的情况下,应该如何推理和决策。不确定性可以理解为“缺少足够信息来做出完全确定的判断”。在现实任务中,系统很少能拿到完美事实。例如医疗诊断中症状可能不典型,矿产勘探中测试结果可能误报,控制系统中传感器读数可能有误差。因此,人工智能不能只依赖经典逻辑中“真或假”的推理方式,还需要处理概率、置信度、时间变化和模糊概念。
这也是本章从逻辑推理过渡到概率推理、确定性因子和模糊推理的原因:现实中的智能决策不是只问结论是否必然为真,而是要问结论有多可信、采取某个行动是否划算、证据之间如何组合。
1.2 常见错误类型
阀门控制例子可以说明错误来源。错误不只是“结论错了”这么简单,它可能来自指令表达、测量过程、设备可靠性,也可能来自推理方式本身。
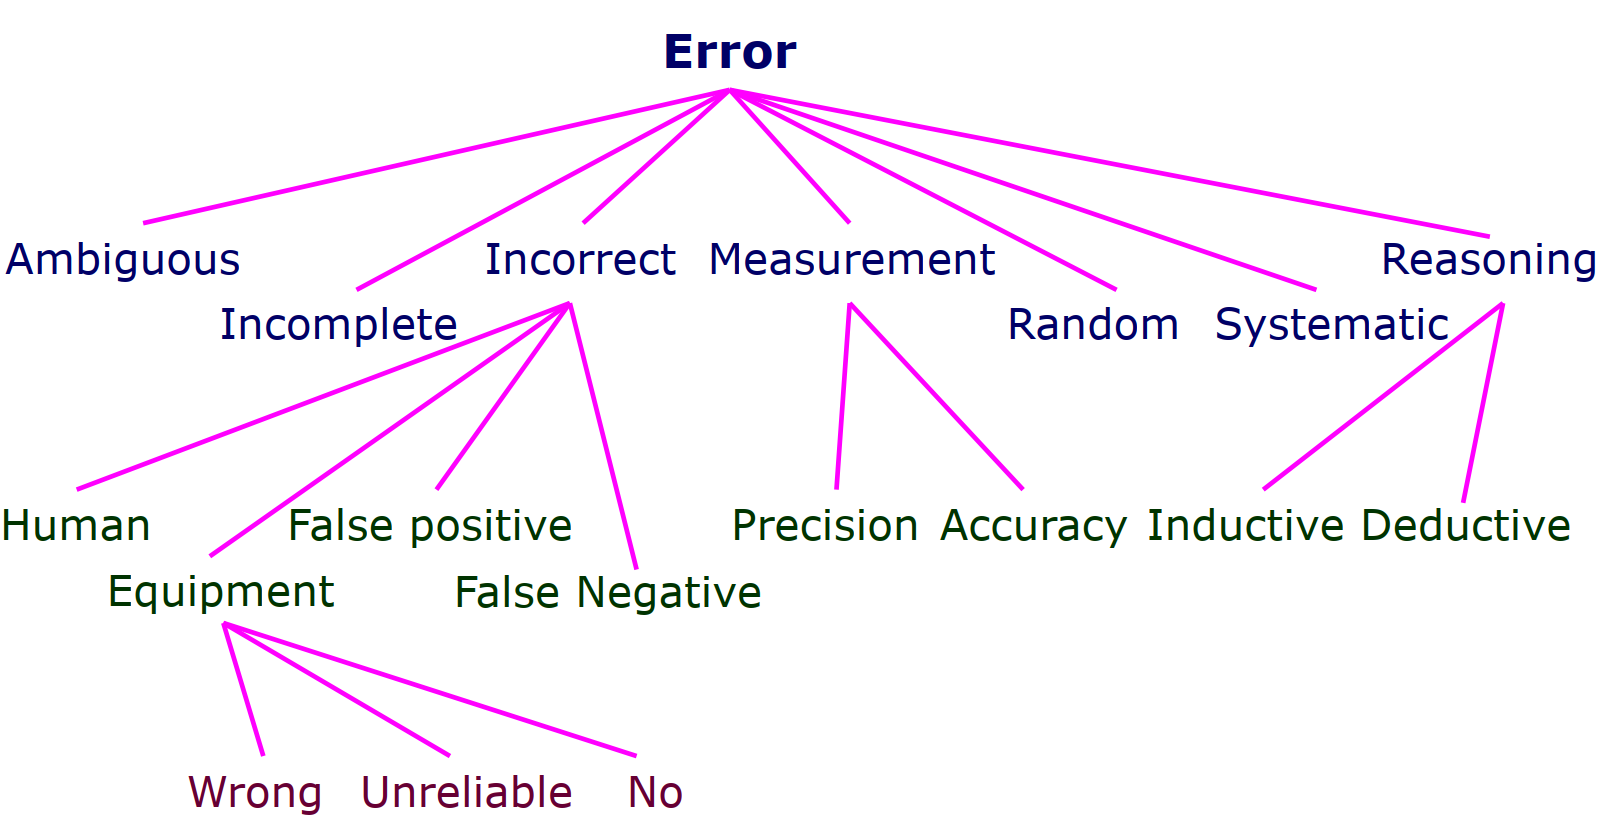
| 错误类型 | 含义 | 这里的直观例子 | 理解 |
|---|---|---|---|
| Ambiguous | 信息有歧义 | “Turn the valve off” | 没说哪个阀门,接收者无法唯一理解。 |
| Incomplete | 信息不完整 | “Turn valve-1” | 只说对象,没说操作方向。 |
| Incorrect | 信息本身错误 | “Turn valve-1 off”,但正确应为 on | 指令明确但内容错。 |
| False positive, Type I | 假阳性 | 判断阀门卡住,但实际上没卡住 | 把不存在的问题判断为存在。 |
| False negative, Type II | 假阴性 | 判断阀门没卡住,但实际上卡住 | 把存在的问题判断为不存在。 |
| Imprecise | 精度不足 | 要调到 \(5\),但正确值是 \(5.4\) | 给出的值太粗。 |
| Inaccurate | 不准确 | 指示 \(5.4\),但正确值是 \(9.2\) | 给得很精细但离真值远。 |
| Unreliable | 不可靠 | 多个读数互相冲突 | 设备或信息源不稳定。 |
| Random error | 随机误差 | 阀门读数在 \(5.4,5.5,5.1\) 间波动 | 由统计波动导致。 |
| Invalid induction | 无效归纳 | “以前没卡住过,所以现在也不会卡住” | 过去经验不能保证未来。 |
| Invalid deduction | 无效演绎 | “输出正常,所以阀门一定良好” | 可能有其他原因导致输出正常。 |
1.3 演绎推理与归纳推理
可以用两个例子区分演绎和归纳。
演绎推理是从一般规律和具体事实推出必然结论。例如:
\[ \text{All men are mortal},\quad \text{Socrates is a man} \Rightarrow \text{Socrates is mortal} \]
只要前提为真且推理形式有效,演绎结论就是必然正确的。
归纳推理则不同。比如“我的硬盘从来没有坏过,所以它永远不会坏”,这个结论并不是必然成立。归纳推理只能给出某种置信程度,它的本质是从过去经验推测未来或从部分样本推测总体。人工智能系统处理现实问题时大量依赖归纳,因此必须承认结论可能被新证据推翻。
1.4 形式谬误:肯定后件
经典错误形式是:
\[ \begin{aligned} p &\to q\\ q &\\ \therefore p& \end{aligned} \]
这个推理是错误的。以阀门为例,“如果阀门状态良好,那么输出正常”并不意味着“输出正常,所以阀门一定状态良好”。因为输出正常可能由其他原因造成,例如阀门卡在打开位置时,某些输出也可能暂时正常。
这说明一个重要思想:在不确定环境下,一个观察结果往往可以由多个原因解释。后面贝叶斯推理正是要比较不同原因在给定证据下的可能性。
2 非单调推理:为什么新信息会推翻旧结论
2.1 非单调推理的基本思想
经典逻辑通常是单调的:如果某个结论能从已有知识推出,那么增加新知识后,这个结论仍然成立。但现实推理常常不是这样。非单调推理指的是:随着新信息加入,原本合理的结论可能被撤销。
例如:
\[ x\ \text{looks red}\Rightarrow x\ \text{is red} \]
如果只知道物体看起来是红的,我们可能暂时相信它是红的。但如果后来知道它被红光照着,而红光会让非红色物体看起来像红色,那么“它是红的”这个结论就被削弱甚至推翻。
2.2 非单调推理中的典型难题
非单调推理中有几个典型问题。
Buridan’s ass 描述的是两个选择完全对称时主体无法决策的问题。它说明单靠“哪边更好”有时不足以行动,因为两个选项可能在可用信息下没有差别。
彩票悖论的直觉是:每一张彩票中奖概率都极低,因此对每一张彩票都可以说“它大概率不会中奖”;但如果整个彩票系统保证会有一张中奖,那么把这些单个信念合起来就会得到矛盾。这反映了个体置信与整体一致性之间的冲突。
序言悖论讲的是作者相信书中每个具体论断,但也承认一本很长的书几乎必然至少有一个错误。于是,“相信每个命题”和“相信至少一个命题为假”会同时出现。它提醒我们:很多单独看来合理的信念,合在一起可能不再合理。
defeat cycle 则是证据相互攻击形成循环。例如 Smith 说 Peter 不可靠,Peter 说 Jones 不可靠,Jones 又说 Smith 不可靠。这类循环会导致系统难以稳定地决定谁可信。
这些问题共同说明:AI 不仅要能推出结论,还要能处理证据冲突、置信削弱和集体不一致。
3 经典概率与假设检验的局限
3.1 经典概率在本章中的位置
进入贝叶斯推理前,需要先回顾经典概率中的几个主题:实验概率、主观概率、复合概率、条件概率和假设检验。它们的共同任务是量化不确定性,但不同方法回答的问题不同。经典假设检验更常问“在某个原假设为真时,观察到当前数据有多罕见”;贝叶斯决策则更关心“给定证据后,各个假设有多可信,以及应该采取什么行动”。
3.2 三个统计实验与原假设
考虑三个实验:女士判断一杯奶茶茶和牛奶谁先倒,音乐专家判断乐谱来自 Haydn 还是 Mozart,醉酒朋友预测公平硬币正反。三个人都进行了 \(10\) 次实验且全部正确。
设 \(\theta\) 表示“该人回答正确的概率”,经典显著性检验可设置原假设:
\[ H_0:\theta=0.5 \]
如果一个人只是随机猜测,连续 \(10\) 次全对的概率是:
\[ 2^{-10}=\frac{1}{1024} \]
这个概率很小,因此在单尾显著性水平 \(2^{-10}\) 下,三个实验都会拒绝原假设。
3.3 为什么这会有问题
这三个实验的统计形式相同,但我们的直觉判断并不相同。女士可能真的能分辨茶和牛奶的顺序,音乐专家也可能确实有能力,而醉酒朋友连续猜中硬币则更像巧合。仅靠“拒绝 \(H_0\)”无法充分表达这些背景差异。
经典假设检验还有两个问题。
第一,点零假设几乎不可能严格为真。现实中某个参数刚好等于 \(0.5\) 的可能性很低,样本足够大时,极小差异也会变得显著。
第二,拟合检验也容易在大样本下拒绝模型。任何模型都是现实的近似,样本足够大时,模型和现实之间的微小偏差也会被检测出来。
因此,本章希望引出一种更适合 AI 决策的理论:它既要连接“应该相信什么”的认识推理,也要连接“应该做什么”的实践推理,还要考虑个体偏好和行动后果。
4 贝叶斯定理与贝叶斯决策
4.1 贝叶斯思想:从先验到后验
贝叶斯方法的基本思想是:系统在观察证据之前已有先验判断,观察证据之后根据条件概率更新为后验判断。一般形式为:
\[ P(H_i\mid E)=\frac{P(E\mid H_i)P(H_i)}{P(E)} \]
如果有多个互斥且穷尽的假设 \(H_1,H_2,\ldots,H_n\),则:
\[ P(H_i\mid E)= \frac{P(E\mid H_i)P(H_i)} {\sum_j P(E\mid H_j)P(H_j)} \]
这里 \(P(H_i)\) 是先验概率,\(P(E\mid H_i)\) 是似然,\(P(H_i\mid E)\) 是后验概率。学习时可以把贝叶斯公式理解成一句话:后验可信度 \(\propto\) 先验可信度 \(\times\) 证据对该假设的支持程度。
4.2 PROSPECTOR 石油勘探例子
PROSPECTOR 专家系统可以用来说明贝叶斯决策。系统要判断某地点是否适合勘探石油。设 \(O\) 表示有油,\(O'\) 表示无油。地震勘探测试结果有阳性 \(+\) 和阴性 \(-\):阳性表示测试更支持“可能有油”,阴性表示测试更支持“可能无油”。
已知先验概率与条件概率:
\[ \begin{aligned} P(O)&=0.6,& P(O')&=0.4\\ P(+\mid O)&=0.8,& P(-\mid O)&=0.2\\ P(+\mid O')&=0.1,& P(-\mid O')&=0.9 \end{aligned} \]
先算联合概率:
\[ \begin{aligned} P(-\cap O')&=P(-\mid O')P(O')=0.9\times0.4=0.36\\ P(+\cap O')&=P(+\mid O')P(O')=0.1\times0.4=0.04\\ P(-\cap O)&=P(-\mid O)P(O)=0.2\times0.6=0.12\\ P(+\cap O)&=P(+\mid O)P(O)=0.8\times0.6=0.48 \end{aligned} \]
于是测试结果的总概率为:
\[ P(-)=0.36+0.12=0.48,\qquad P(+)=0.04+0.48=0.52 \]
后验概率为:
\[ \begin{aligned} P(O'\mid -)&=\frac{0.36}{0.48}=\frac{3}{4},& P(O\mid -)&=\frac{0.12}{0.48}=\frac{1}{4}\\ P(O'\mid +)&=\frac{0.04}{0.52}=\frac{1}{13},& P(O\mid +)&=\frac{0.48}{0.52}=\frac{12}{13} \end{aligned} \]
这组计算的含义非常清楚:阴性结果并不意味着一定没油,只是把“有油”的概率降到了 \(\frac{1}{4}\);阳性结果也不意味着一定有油,而是把“有油”的概率升到了 \(\frac{12}{13}\)。
4.3 从后验概率到决策
贝叶斯决策不仅要问“有油的概率是多少”,还要问“钻井或退出哪个期望收益更高”。收益信息如下:
\[ \begin{aligned} \text{successful oil lease} &= \$1{,}250{,}000\\ \text{drilling expense} &= -\$200{,}000\\ \text{seismic survey} &= -\$50{,}000 \end{aligned} \]
如果钻井且有油,净收益可理解为:
\[ 1{,}250{,}000-200{,}000-50{,}000=1{,}000{,}000 \]
如果钻井但无油,则损失为:
\[ -200{,}000-50{,}000=-250{,}000 \]
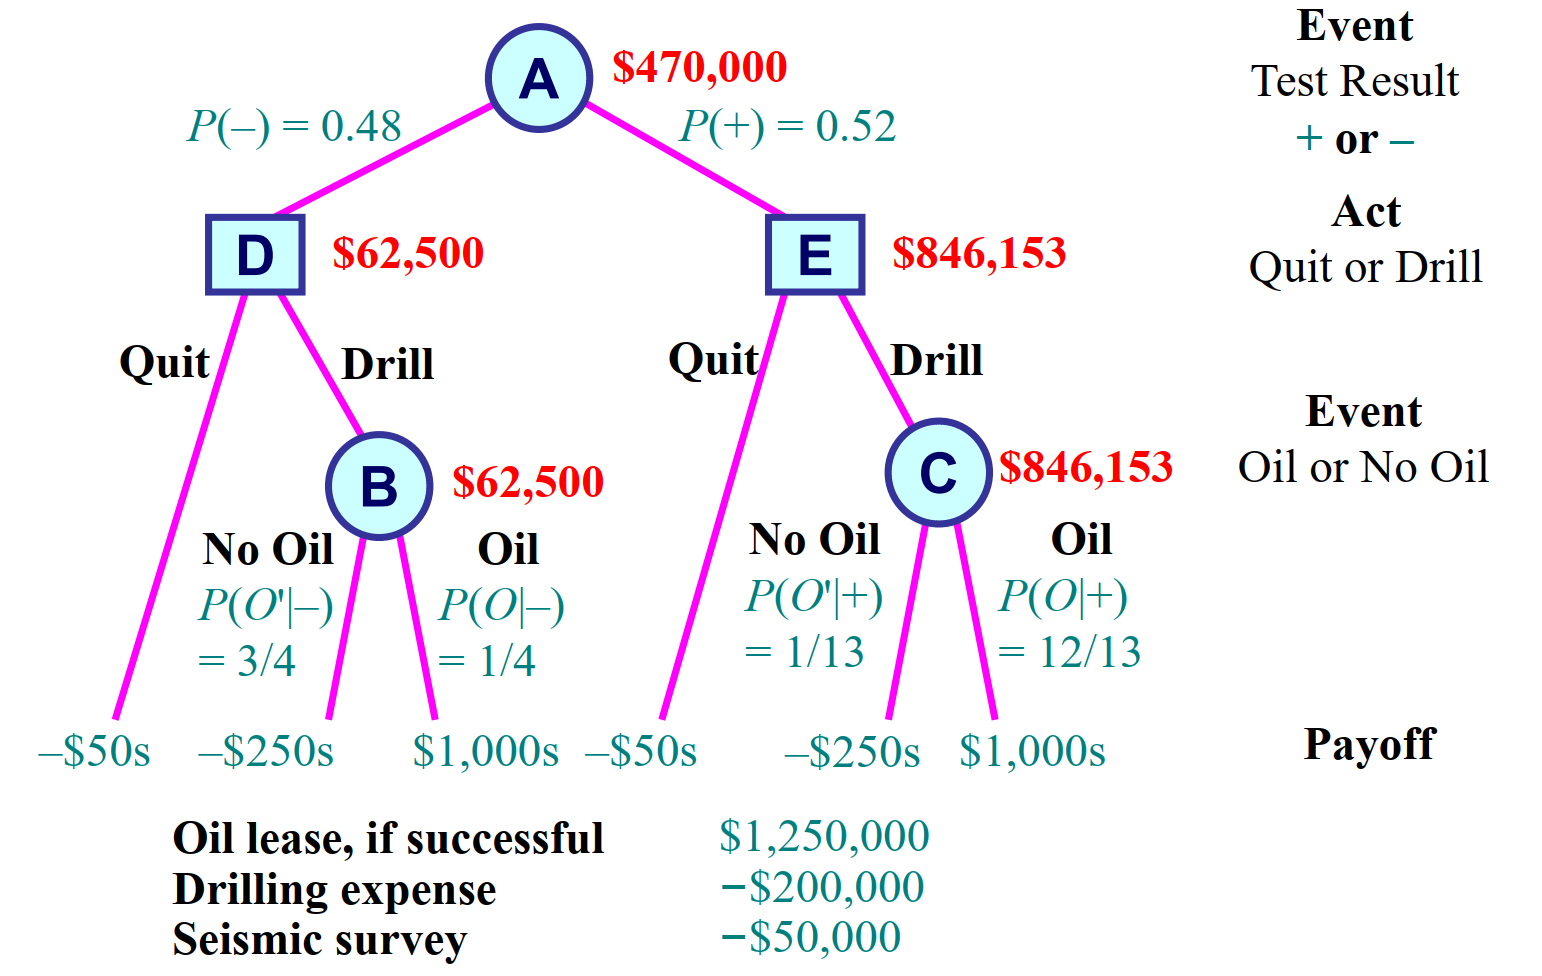
如果看到阴性结果后仍选择钻井,则期望收益为: \[ \begin{aligned} EV(\text{drill}\mid -) &=P(O\mid -)\cdot1{,}000{,}000+P(O'\mid -)\cdot(-250{,}000)\\ &=\frac{1}{4}\cdot1{,}000{,}000+\frac{3}{4}\cdot(-250{,}000)\\ &=62{,}500 \end{aligned} \]
这说明即使测试为阴性,只要成功收益足够高,钻井仍可能比直接退出更划算。阳性结果下,由于 \(P(O\mid +)=\frac{12}{13}\),钻井的期望收益更高。对应节点约为 \(\$846{,}153\),测试前总体期望约为 \(\$470{,}000\)。
学习时要抓住这条逻辑链:先用贝叶斯公式更新概率,再用收益/损失计算期望值,最后选择期望收益更高或期望损失更低的行动。
4.4 农夫种作物的贝叶斯分析
第二个例子是农夫根据天气预报决定种什么作物。设 \(a\) 为农民第二年的行为,可以旋转:\(a_1\) 为种抗旱作物,\(a_2\) 为种高产作物,\(\theta\) 表示下一年的真实降水量,\(x\) 表示天气预报的下一年降水量。损失函数为:
\[ l(\theta,a)= \begin{cases} 200-2\theta,& a=a_1\\ 3000-10\theta,& a=a_2 \end{cases} \]
农夫的决策规则是:如果天气预报的降水量小于 \(400\text{mm}\),就选择抗旱作物;否则选择高产作物。也就是:
\[ \delta(x)= \begin{cases} a_1,& x<400\\ a_2,& x\ge 400 \end{cases} \]
天气预报的误差用一个 Cauchy 型密度表示:
\[ f(x\mid\theta)= \begin{cases} \dfrac{1}{\pi}\dfrac{400}{400^2+(x-\theta)^2},& x\ge0\\ 0,& x<0 \end{cases} \]
于是该决策规则在真实降水量为 \(\theta\) 时的风险为:
\[ R(\theta,\delta) =\int_0^{400}f(x\mid\theta)(200-2\theta)\,dx +\int_{400}^{\infty}f(x\mid\theta)(3000-10\theta)\,dx \]
农夫根据经验给出了 \(\theta\) 的先验分布:
| \(\theta\) | \(0\) | \(100\) | \(200\) | \(300\) | \(400\) | \(500\) | \(600\) | \(700\) | \(800\) |
|---|---|---|---|---|---|---|---|---|---|
| \(\pi(\theta)\) | \(0\) | \(0.052\) | \(0.104\) | \(0.153\) | \(0.178\) | \(0.204\) | \(0.153\) | \(0.104\) | \(0.052\) |
Bayes risk 是对所有可能 \(\theta\) 的风险加权平均:
\[ r(\pi,\delta)=\sum_{\theta}R(\theta,\delta)\pi(\theta)=-1176 \]
也就是说风险的期望为负,收益的期望为正。因此 “The farmer is smart” 的意思不是说该规则必然正确,而是说在给定先验经验和损失函数下,这个决策规则的贝叶斯风险表现不错。
5 贝叶斯方法的困难与贝叶斯网络
5.1 多证据下的概率数量爆炸
在医学诊断中,设 \(D_i\) 表示第 \(i\) 种疾病,\(E\) 表示某个证据或症状。贝叶斯公式可写为:
\[ P(D_i\mid E)= \frac{P(E\mid D_i)P(D_i)} {\sum_j P(E\mid D_j)P(D_j)} \]
如果系统不断加入新证据,例如已有证据 \(E_1\),现在又加入新证据 \(E_2\),则递推形式为:
\[ P(D_i\mid E_1,E_2)= \frac{P(E_2\mid D_i\cap E_1)P(D_i\mid E_1)} {\sum_j P(E_2\mid D_j\cap E_1)P(D_j\mid E_1)} \]
问题在于:证据越多,系统需要的条件概率越复杂。医生或专家很难准确给出所有形如 \(P(E_2\mid D_i\cap E_1)\) 的概率;如果有很多疾病和很多症状,完整概率表会迅速变得不可管理。
5.2 贝叶斯网络的意义
贝叶斯网络的价值在于,它用图结构表达变量之间的条件依赖关系,从而避免直接枚举所有联合概率。每个节点代表一个随机变量,边表示直接依赖。只要图中体现了合理的条件独立性,系统就可以用较少的局部条件概率进行推理。
贝叶斯网络可以在医学诊断中把概率方法与神经计算等方法结合起来,在计算开销和结论准确性之间取得实用平衡。
这一节不要求展开贝叶斯网络算法,但要理解它为什么出现:完整贝叶斯方法理论上优美,但实际需要的概率太多;贝叶斯网络用结构化依赖关系降低建模成本。
6 MYCIN、信任/不信任与确定性因子
6.1 MYCIN 规则为什么不用纯概率表达
MYCIN 是早期医疗专家系统。它的规则可以写成:如果微生物染色为 gram positive,形态为 coccus,生长排列为 chains,那么有 \(0.7\) 的 suggestive evidence 支持该微生物是 streptococcus。
如果用概率语言写,可以写成:
\[ P(H\mid E_1\cap E_2\cap E_3)=0.7 \]
这里 \(H\) 是“该微生物是 streptococcus”,\(E_1,E_2,E_3\) 分别是三个前提证据。专家通常愿意接受这个表达,但不愿意马上接受:
\[ P(H'\mid E_1\cap E_2\cap E_3)=0.3 \]
原因是专家的“支持程度”并不总是严格概率意义上的互补。比如某个证据支持 streptococcus 的程度是 \(0.7\),并不意味着剩下的 \(0.3\) 都明确支持“不是 streptococcus”。可能还有未知信息、未考虑疾病、证据质量问题等。
6.2 Belief 与 disbelief
毕业例子可以说明 belief 和 disbelief 不一定简单互补。如果知道“这门课拿 A”,那么学生毕业概率可能是:
\[ P(\text{graduating}\mid A\ \text{in this course})=0.70 \]
但这并不直观地等价于:
\[ P(\text{not graduating}\mid A\ \text{in this course})=0.30 \]
因为不毕业可能来自很多额外原因:课程目录变化、忘修必修课、转学分不被承认、欠费、GPA 估计错误等。这个例子想说明:在专家系统中,支持某个结论的证据和反对某个结论的证据最好分开建模。
6.3 确定性因子的定义
确定性因子 Certainty Factor, 简称 CF,用来描述证据 \(E\) 对假设 \(H\) 的支持或反对程度。MYCIN 将其定义为:
\[ CF(H,E)=MB(H,E)-MD(H,E) \]
其中 \(MB(H,E)\) 表示证据 \(E\) 对假设 \(H\) 增加的信任程度,\(MD(H,E)\) 表示证据 \(E\) 对假设 \(H\) 增加的不信任程度。范围为:
\[ 0\le MB\le1,\qquad 0\le MD\le1,\qquad -1\le CF\le1 \]
如果 \(CF>0\),证据支持假设;如果 \(CF<0\),证据反对假设;如果 \(CF=0\),证据没有提供有效倾向。
\(MB\) 和 \(MD\) 的概率定义为:
\[ MB(H,E)= \begin{cases} 1,& P(H)=1\\ \dfrac{\max(P(H\mid E),P(H))-P(H)}{1-P(H)},& \text{otherwise} \end{cases} \]
\[ MD(H,E)= \begin{cases} 1,& P(H)=0\\ \dfrac{\min(P(H\mid E),P(H))-P(H)}{0-P(H)},& \text{otherwise} \end{cases} \]
可以把它理解为:如果证据让 \(P(H)\) 上升,就体现为 belief 增加;如果证据让 \(P(H)\) 下降,就体现为 disbelief 增加。
6.4 证据组合:AND、OR、NOT
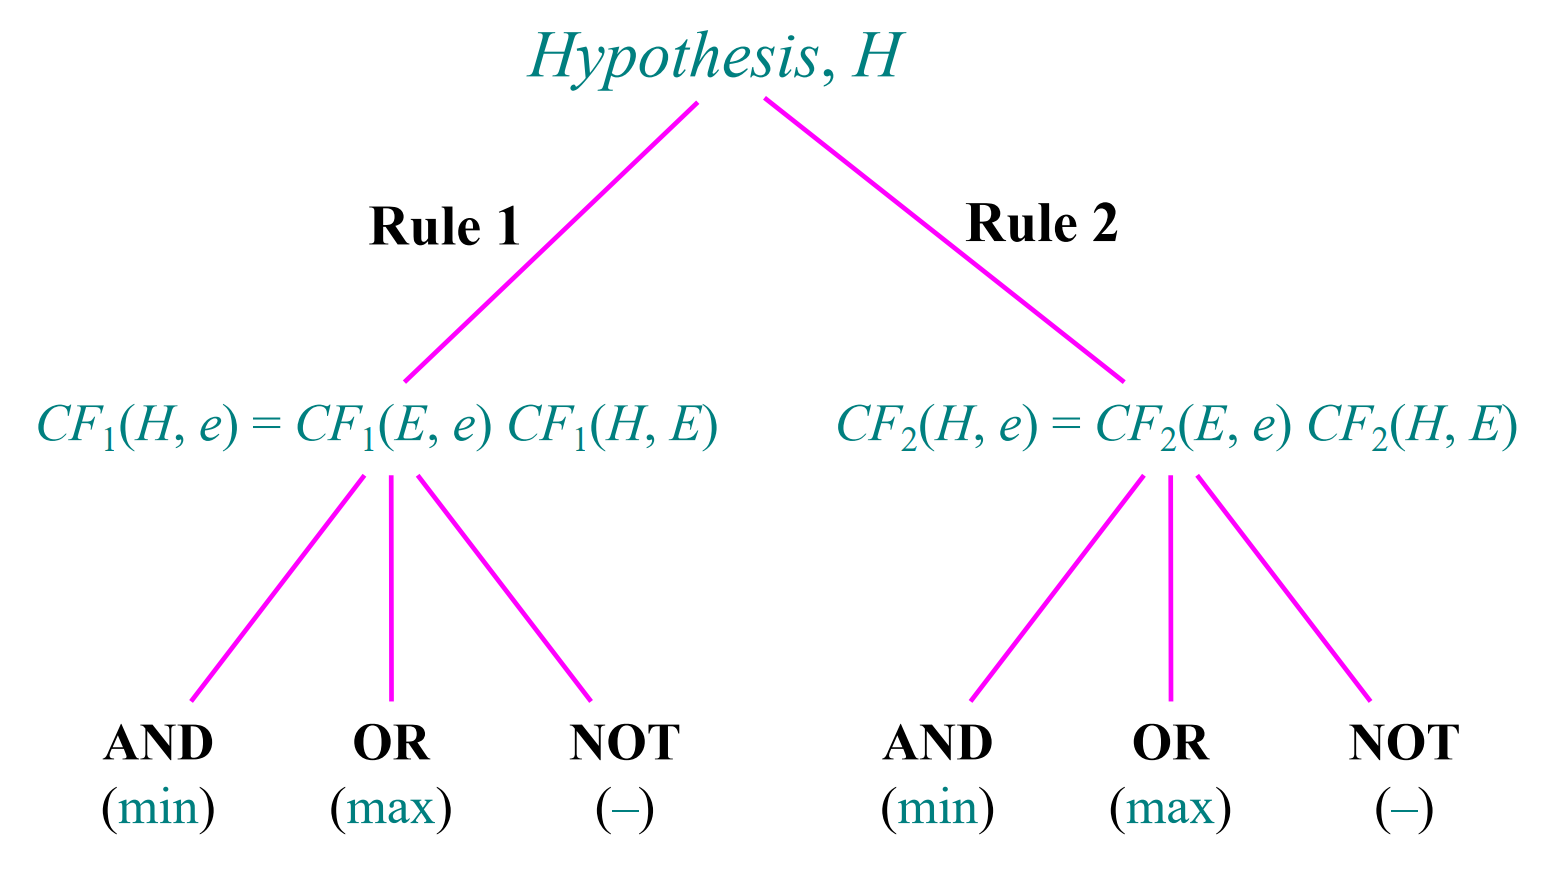
当规则前提由多个证据组合而成时,MYCIN 使用简单的组合规则:
\[ \begin{aligned} E_1\land E_2 &: \min(CF(E_1,e),CF(E_2,e))\\ E_1\lor E_2 &: \max(CF(E_1,e),CF(E_2,e))\\ \lnot E &: -CF(E,e) \end{aligned} \]
这里要特别区分 \(E\) 和 \(e\)。\(E\) 是规则里的证据命题或证据表达式,例如 \(E_1\land E_2\land E_3\);\(e\) 是当前实际观察到的所有事实背景。例如在一次诊断中,实验室观察结果使得 \(CF(E_1,e)=0.5\),这表示“在当前观察资料 \(e\) 下,命题 \(E_1\) 的可信度是 \(0.5\)”。
如果:
\[ E=(E_1\land E_2\land E_3)\lor(E_4\land\lnot E_5) \]
则:
\[ CF(E,e)=\max\{\min(CF(E_1,e),CF(E_2,e),CF(E_3,e)),\min(CF(E_4,e),-CF(E_5,e))\} \]
6.5 streptococcus 规则的 CF 计算
对 MYCIN 规则,设:
\[ CF(H,E)=CF(H,E_1\cap E_2\cap E_3)=0.7 \]
如果当前观察资料 \(e\) 下:
\[ CF(E_1,e)=0.5,\qquad CF(E_2,e)=0.6,\qquad CF(E_3,e)=0.3 \]
由于前提是 AND 关系,所以整体前提可信度为:
\[ CF(E,e)=\min(0.5,0.6,0.3)=0.3 \]
规则结论的 CF 为:
\[ CF(H,e)=CF(E,e)CF(H,E)=0.3\times0.7=0.21 \]
这个例子很适合练习。它体现了三层含义:先算当前证据对规则前提 \(E\) 的支持程度,再乘以规则本身 \(E\Rightarrow H\) 的强度,最后得到当前证据背景 \(e\) 下对结论 \(H\) 的支持程度。
6.6 多条规则支持同一假设时的合成
如果两条规则都推出同一个假设 \(H\),先分别计算:
\[ CF_1=CF(H,e_1)=CF(E_1,e_1)CF(H,E_1),\qquad CF_2=CF(H,e_2)=CF(E_2,e_2)CF(H,E_2) \]
然后用组合函数:
\[ CF_{\mathrm{COMB}}(CF_1,CF_2)= \begin{cases} CF_1+CF_2(1-CF_1),& CF_1>0,\ CF_2>0\\ \dfrac{CF_1+CF_2}{1-\min(|CF_1|,|CF_2|)},& \text{one positive and one negative}\\ CF_1+CF_2(1+CF_1),& CF_1<0,\ CF_2<0 \end{cases} \]
该函数满足交换性:
\[ CF_{\mathrm{COMB}}(X,Y)=CF_{\mathrm{COMB}}(Y,X) \]
6.7 确定性因子的局限
CF 的第一个问题是,它可能与条件概率的排序相反。例如:
\[ P(H_1)=0.8,\quad P(H_2)=0.2,\quad P(H_1\mid E)=0.9,\quad P(H_2\mid E)=0.8 \]
计算得到:
\[ CF(H_1,E)=0.5,\qquad CF(H_2,E)=0.75 \]
虽然 \(P(H_1\mid E)>P(H_2\mid E)\),但 \(CF(H_1,E)<CF(H_2,E)\)。如果系统用 CF 对疾病可能性排序,就可能出现与后验概率不一致的结果。
第二个问题是,规则链中简单相乘并不等价于一般概率推理。一般情况下:
\[ P(H\mid e)\ne P(H\mid i)P(i\mid e) \]
但 CF 链式推理使用:
\[ CF(H,e)=CF(E,e)CF(H,E) \]
这说明 CF 是一种工程上方便的启发式方法,而不是严格概率论的完整替代品。
7 时间推理、随机过程与马尔可夫链
7.1 时间推理的基本任务
时间推理 temporal reasoning 研究的是随时间变化的事件。例如航空交通控制需要根据飞机位置随时间的变化进行判断,医学专家系统也可能要根据病情发展过程进行推理。随机过程和马尔可夫链提供了一种处理时间变化的方法。
7.2 随机过程与转移矩阵
转移矩阵描述系统从当前状态转移到未来状态的概率。若有两个状态 \(S_1,S_2\),转移矩阵可写成:
\[ P= \begin{bmatrix} P_{11} & P_{12}\\ P_{21} & P_{22} \end{bmatrix} \]
其中 \(P_{mn}\) 表示从状态 \(m\) 转移到状态 \(n\) 的概率。
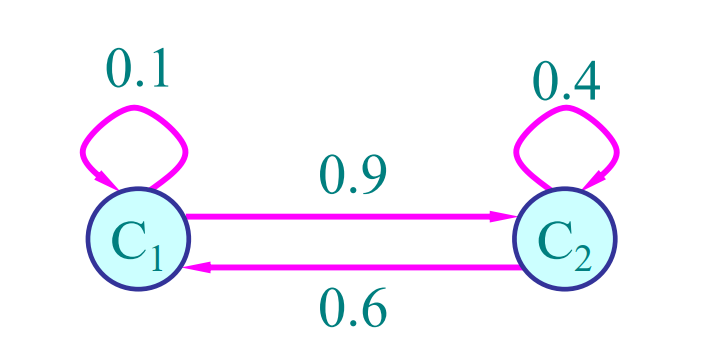
以电脑品牌选择为例。设 \(C_1\) 表示购买 Lenovo,\(C_2\) 表示购买 Apple,转移矩阵为:
\[ P= \begin{bmatrix} 0.1 & 0.9\\ 0.6 & 0.4 \end{bmatrix} \]
这表示当前买 Lenovo 的人下一次继续买 Lenovo 的概率是 \(0.1\),转去买 Apple 的概率是 \(0.9\);当前买 Apple 的人下一次买 Lenovo 的概率是 \(0.6\),继续买 Apple 的概率是 \(0.4\)。
7.3 状态矩阵更新与稳态
设当前用户分布为:
\[ S_1=[0.8,0.2] \]
即 \(80\%\) 的人买 Lenovo,\(20\%\) 的人买 Apple。下一期状态为:
\[ S_2=S_1P=[0.8,0.2] \begin{bmatrix} 0.1 & 0.9\\ 0.6 & 0.4 \end{bmatrix} =[0.2,0.8] \]
继续迭代会得到:
\[ \begin{aligned} S_3&=[0.5,0.5],& S_4&=[0.35,0.65]\\ S_5&=[0.425,0.575],& S_6&=[0.3875,0.6125]\\ S_7&=[0.40625,0.59375],& S_8&=[0.396875,0.602125] \end{aligned} \]
可以看到状态逐渐靠近:
\[ S_n=[0.4,0.6] \]
如果转移矩阵是 regular,也就是某个幂矩阵的所有元素都为正,则存在唯一稳态。
7.4 马尔可夫链与稳态求解
马尔可夫链满足四个条件:状态数有限;任一时刻只能处于一个状态;系统随时间一步步转移;下一步只依赖当前状态,而不依赖更早历史。这最后一点称为马尔可夫性。
稳态向量 \([P_1,P_2]\) 满足:
\[ [P_1\ P_2]P=[P_1\ P_2] \]
对 这里的矩阵,有:
\[ \begin{cases} 0.1P_1+0.6P_2=P_1\\ 0.9P_1+0.4P_2=P_2\\ P_1+P_2=1 \end{cases} \]
由第一式得:
\[ P_1=\frac{2}{3}P_2 \]
代入 \(P_1+P_2=1\):
\[ \frac{2}{3}P_2+P_2=1 \]
因此:
\[ P_2=0.6,\qquad P_1=0.4 \]
稳态为:
\[ [0.4,0.6] \]
7.5 PageRank 的基本原理
7.5.1 PageRank 与马尔可夫链的关系
PageRank 本质上可以看成马尔可夫链稳态分布的一个经典应用。它最初用于衡量网页的重要性:一个网页越容易被“随机浏览者”长期访问到,它的 PageRank 就越高。
PageRank 的直觉有两层。第一,被很多网页指向的网页通常更重要。如果很多页面都链接到页面 \(A\),说明 \(A\) 可能有较高价值。第二,来自重要网页的链接更有分量。如果一个很重要的网页链接到 \(A\),这个链接带来的权重应该比普通网页的链接更大。
7.5.2 随机浏览者模型
为了把这个直觉变成数学模型,可以把整个互联网看成一个有向图。每个网页是一个状态,网页之间的超链接是状态转移。假设某个用户正在网页 \(j\),如果该网页有 \(L(j)\) 个出链,并且其中一个链接指向网页 \(i\),那么用户从 \(j\) 跳到 \(i\) 的概率可以设为:
\[ P_{ji}=\frac{1}{L(j)} \]
如果网页 \(j\) 没有链接到 \(i\),则:
\[ P_{ji}=0 \]
这样,网页跳转就形成了一个转移矩阵 \(P\)。不断点击链接相当于不断做马尔可夫链状态更新:
\[ r_{t+1}=r_tP \]
其中 \(r_t\) 是第 \(t\) 步时随机浏览者位于各网页的概率分布。当这个分布收敛后,得到的稳态向量 \(r\) 满足:
\[ r=rP \]
这个稳态向量中的每个分量就是对应网页的 PageRank。也就是说,PageRank 不是简单数入链数量,而是计算随机浏览者长期停留在每个网页上的概率。
7.5.3 阻尼因子与 PageRank 公式
不过,真实网页图会出现两个问题。第一,有些网页没有出链,随机浏览者到了那里就“卡住”了;第二,有些网页群可能只在内部互相链接,使随机浏览者困在小圈子里。为了解决这个问题,PageRank 引入阻尼因子 \(d\)。常见取值是 \(d=0.85\)。其含义是:用户有 \(d\) 的概率沿着当前网页的链接继续点击,有 \(1-d\) 的概率随机跳转到任意网页。
若总共有 \(N\) 个网页,则 PageRank 常写为:
\[ PR(i)=\frac{1-d}{N} +d\sum_{j\in In(i)}\frac{PR(j)}{L(j)} \]
其中 \(In(i)\) 表示所有链接到网页 \(i\) 的网页集合,\(L(j)\) 表示网页 \(j\) 的出链数量,\(PR(i)\) 表示网页的重要性。这个公式可以这样读:网页 \(i\) 的重要性来自两部分,一部分是随机跳转给所有网页的基础分数 \(\frac{1-d}{N}\),另一部分是所有指向 \(i\) 的网页传递过来的重要性。
7.5.4 所有网页的 PageRank 如何迭代计算
由于 \(PR(i)\) 的定义右边又包含其他网页的 \(PR(j)\),所以 PageRank 不是直接代入一次就能算出的公式,而是一个递归定义。实际计算时通常使用迭代法。最常见的初始值是让所有网页一开始同等重要:
\[ PR_0(i)=\frac{1}{N} \]
这里 \(N\) 是网页总数,\(PR_0(i)\) 表示第 \(0\) 轮时网页 \(i\) 的 PageRank。这样初始化的含义是:在还没有利用链接结构之前,先假设随机浏览者均匀分布在所有网页上。
初始化后,每一轮都用上一轮的 PageRank 计算下一轮:
\[ PR_{t+1}(i)=\frac{1-d}{N} +d\sum_{j\in In(i)}\frac{PR_t(j)}{L(j)} \]
这个公式必须对所有网页同时更新。也就是说,第 \(t+1\) 轮的每个网页分数都由第 \(t\) 轮的分数算出,不能先更新网页 \(A\),再拿新的 \(PR_{t+1}(A)\) 去更新网页 \(B\)。从概率角度看,每一轮都表示随机浏览者又点击了一次链接或发生了一次随机跳转。
迭代会一直进行到前后两轮变化足够小。例如可以设一个很小的阈值 \(\epsilon\),当所有网页都满足:
\[ |PR_{t+1}(i)-PR_t(i)|<\epsilon \]
就认为 PageRank 已经收敛。收敛后的向量就是各网页的最终 PageRank。换成马尔可夫链语言,就是我们通过反复计算:
\[ r_{t+1}=r_tP \]
逐步逼近稳态分布 \(r\)。
7.5.5 一个三网页计算例子
假设有三个网页 \(A,B,C\),链接关系如下:
- \(A\) 链接到 \(B,C\),所以 \(L(A)=2\);
- \(B\) 链接到 \(C\),所以 \(L(B)=1\);
- \(C\) 链接到 \(A\),所以 \(L(C)=1\)。
一开始令三个网页同等重要:
\[ PR_0(A)=PR_0(B)=PR_0(C)=\frac{1}{3} \]
取阻尼因子 \(d=0.85\)。第一轮计算时,\(A\) 只有来自 \(C\) 的入链,\(B\) 只有来自 \(A\) 的入链,\(C\) 有来自 \(A\) 和 \(B\) 的入链,所以:
\[ \begin{aligned} PR_1(A)&=\frac{0.15}{3}+0.85\cdot\frac{PR_0(C)}{1}\\ PR_1(B)&=\frac{0.15}{3}+0.85\cdot\frac{PR_0(A)}{2}\\ PR_1(C)&=\frac{0.15}{3}+0.85\left(\frac{PR_0(A)}{2}+\frac{PR_0(B)}{1}\right) \end{aligned} \]
代入 \(PR_0(A)=PR_0(B)=PR_0(C)=\frac{1}{3}\),得到:
\[ \begin{aligned} PR_1(A)&=0.05+0.85\times\frac{1}{3}=0.3333\\ PR_1(B)&=0.05+0.85\times\frac{1}{6}=0.1917\\ PR_1(C)&=0.05+0.85\times\left(\frac{1}{6}+\frac{1}{3}\right)=0.475 \end{aligned} \]
这说明第一轮后 \(C\) 的 PageRank 最高,因为它同时收到 \(A\) 和 \(B\) 的链接,其中 \(B\) 只有一个出链,会把自己的权重全部传给 \(C\)。后续继续用 \(PR_1\) 计算 \(PR_2\),再用 \(PR_2\) 计算 \(PR_3\),直到分数稳定。
8 模糊集、语言变量与模糊推理
8.1 为什么需要模糊集
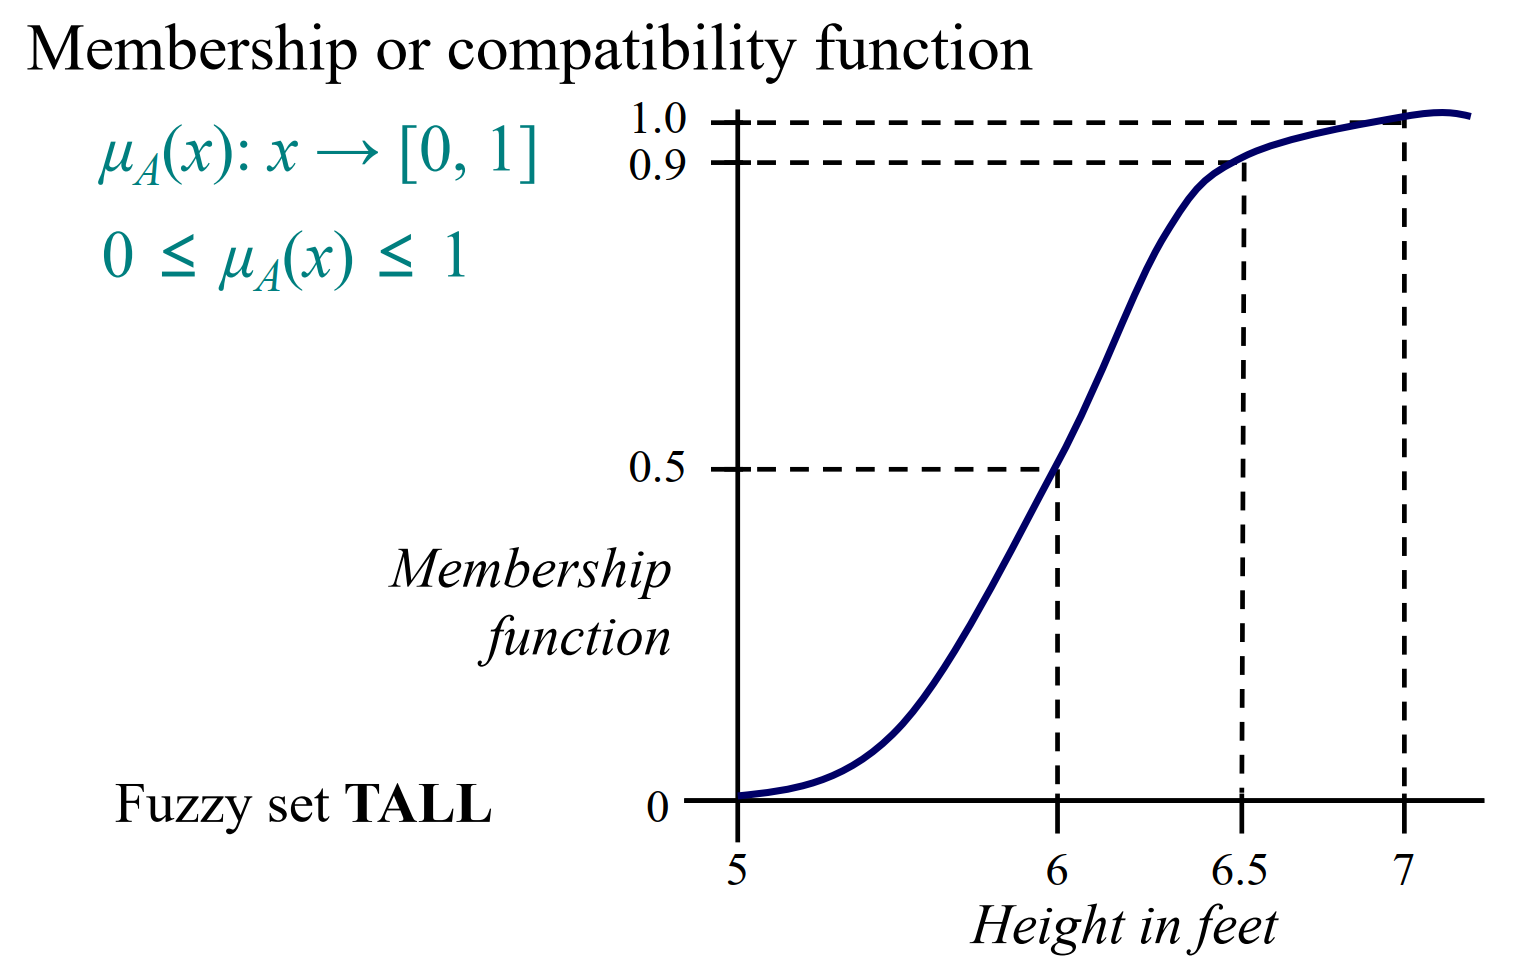
概率处理的是事件发生的不确定性,而模糊集处理的是概念边界的不清晰。例如 tall、hot、dangerous、a little 这些自然语言词语没有明确边界。一个人 \(1.80\text{m}\) 是否算高,不是简单的是或否,而是“多大程度上算高”。
经典集合使用二值逻辑:
\[ x\in A\quad\text{or}\quad x\notin A \]
模糊集则允许元素以某个程度属于集合:
\[ \mu_A(x):x\to[0,1],\qquad 0\le\mu_A(x)\le1 \]
这里 \(\mu_A(x)\) 称为隶属函数或兼容函数。\(\mu_A(x)=1\) 表示完全属于,\(\mu_A(x)=0\) 表示完全不属于,中间值表示部分符合。
下面是一个隶属函数:
8.2 语言变量
语言变量的取值不是普通数字,而是自然语言词。例如:
| 语言变量 | 典型取值 |
|---|---|
| height | dwarf, short, average, tall, giant |
| number | almost none, several, few, many |
| stage of life | infant, toddler, child, teenager, adult |
| color | red, blue, green, yellow, orange |
| light | dim, faint, normal, bright, intense |
语言变量的意义在于,它让系统可以用接近人类表达的方式建立规则。例如“如果电视太暗,就调高亮度”比精确写出某个亮度阈值更自然。
8.3 模糊规则与 linguistic hedges
模糊规则通常写成:
\[ \text{IF condition THEN conclusion/action} \]
例如:如果温度太高,就加入冷水;如果压力太高,就打开泄压阀;如果利率上升,就买债券。这些规则中的 too hot、too high、going up 都可以由模糊集合描述。
linguistic hedges 也就是修饰词,它们通过运算改变隶属度:
| Hedge | 运算 |
|---|---|
| Very \(F\) | \(CON(F)=F^2\) |
| More or Less \(F\) | \(DIL(F)=F^{0.5}\) |
| Plus \(F\) | \(F^{1.25}\) |
| Not \(F\) | \(1-F\) |
| Not Very \(F\) | \(1-F^2\) |
例如:
\[ TALL=\{0.125/5.5,\ 0.5/6,\ 0.875/6.5,\ 1/7\} \]
这里 \(0.125/5.5\) 是指 \(5.5\) feet 有 \(0.125\) 的程度属于 \(TALL\),其它同理。则:
\[ VERY\ TALL =\{0.0156/5.5,\ 0.25/6,\ 0.7656/6.5,\ 1/7\} \]
每个隶属度都被平方。相反:
\[ NOT\ TALL=\{0.875/5.5,\ 0.5/6,\ 0.125/6.5,\ 0/7\} \]
每个隶属度都变成 \(1-\mu\)。
8.4 模糊关系与合成
体重近似相等可以表示成一个模糊关系:
\[ R_2(x,y)=\text{APPROXIMATELY EQUAL} \]
| \(x\backslash y\) | \(120\) | \(130\) | \(140\) | \(150\) | \(160\) |
|---|---|---|---|---|---|
| \(120\) | \(1.0\) | \(0.7\) | \(0.4\) | \(0.2\) | \(0.0\) |
| \(130\) | \(0.7\) | \(1.0\) | \(0.6\) | \(0.5\) | \(0.2\) |
| \(140\) | \(0.4\) | \(0.6\) | \(1.0\) | \(0.8\) | \(0.5\) |
| \(150\) | \(0.2\) | \(0.5\) | \(0.8\) | \(1.0\) | \(0.8\) |
| \(160\) | \(0.0\) | \(0.2\) | \(0.5\) | \(0.8\) | \(1.0\) |
这个表的含义是:两个体重越接近,它们“approximately equal”的隶属度越高。
若:
\[ R_1(x)=HEAVY=\{0.6/140,\ 0.8/150,\ 1/160\} \]
并用 \(R_2(x,y)\) 表示 approximately equal,则通过 max-min 合成得到:
\[ \mu_{R_3}(y)=\max_x\min(\mu_{R_1}(x),\mu_{R_2}(x,y)) \]
\(R_3(y)\) 表示 more or less heavy。如果一个体重本身很 heavy,或者它和某个 heavy 的体重很接近,那么它就可以算 more or less heavy。也就是:“不一定严格重,但差不多算重”。
下面是 max-min 的计算过程。因为 \(R_1\) 只明确给出了 \(140,150,160\) 的 heavy 程度,所以先把 \(120,130\) 的 heavy 程度补成 \(0\): \[ R_1=[0.0,\ 0.0,\ 0.6,\ 0.8,\ 1.0] \]
它对应的 \(x\) 顺序是:
\[ x=[120,\ 130,\ 140,\ 150,\ 160] \]
于是 这里的合成可以写成:
\[ R_3 = [0.0,\ 0.0,\ 0.6,\ 0.8,\ 1.0] \circ \begin{bmatrix} 1.0 & 0.7 & 0.4 & 0.2 & 0.0\\ 0.7 & 1.0 & 0.6 & 0.5 & 0.2\\ 0.4 & 0.6 & 1.0 & 0.8 & 0.5\\ 0.2 & 0.5 & 0.8 & 1.0 & 0.8\\ 0.0 & 0.2 & 0.5 & 0.8 & 1.0 \end{bmatrix} \]
这里的 \(\circ\) 不是普通矩阵乘法,而是 max-min composition。普通矩阵乘法是“乘完再相加”,而这里是“先取 \(\min\),再取 \(\max\)”。也就是说,对每一个目标体重 \(y\),都要拿 \(R_1\) 和关系矩阵中 \(y\) 对应的那一列逐项取 \(\min\),最后再取最大值。
例如计算 \(y=120\) 时,取关系矩阵中 \(120\) 这一列:
\[ [1.0,\ 0.7,\ 0.4,\ 0.2,\ 0.0]^T \]
逐项取 \(\min\):
\[ \begin{aligned} \mu_{R_3}(120) &=\max\{\min(0.0,1.0),\min(0.0,0.7),\min(0.6,0.4),\min(0.8,0.2),\min(1.0,0.0)\}\\ &=\max\{0.0,0.0,0.4,0.2,0.0\}\\ &=0.4 \end{aligned} \]
计算 \(y=130\) 时,取 \(130\) 这一列:
\[ \begin{aligned} \mu_{R_3}(130) &=\max\{\min(0.0,0.7),\min(0.0,1.0),\min(0.6,0.6),\min(0.8,0.5),\min(1.0,0.2)\}\\ &=\max\{0.0,0.0,0.6,0.5,0.2\}\\ &=0.6 \end{aligned} \]
同理,剩下三列为:
\[ \begin{aligned} \mu_{R_3}(140) &=\max\{\min(0.0,0.4),\min(0.0,0.6),\min(0.6,1.0),\min(0.8,0.8),\min(1.0,0.5)\}\\ &=\max\{0.0,0.0,0.6,0.8,0.5\}=0.8\\ \mu_{R_3}(150) &=\max\{\min(0.0,0.2),\min(0.0,0.5),\min(0.6,0.8),\min(0.8,1.0),\min(1.0,0.8)\}\\ &=\max\{0.0,0.0,0.6,0.8,0.8\}=0.8\\ \mu_{R_3}(160) &=\max\{\min(0.0,0.0),\min(0.0,0.2),\min(0.6,0.5),\min(0.8,0.8),\min(1.0,1.0)\}\\ &=\max\{0.0,0.0,0.5,0.8,1.0\}=1.0 \end{aligned} \]
于是:
\[ R_3=\{0.4/120,\ 0.6/130,\ 0.8/140,\ 0.8/150,\ 1/160\} \]
Min-max 到底在干什么?
对某个目标体重 \(y\),比如 \(y=130\),我们想判断:130 有多大程度算 more or less heavy?
我们会拿它和所有可能的 heavy 体重比较:
参考体重 \(x\) \(x\) 本身有多 heavy \(x\) 和 \(130\) 有多接近 \(120\) \(0.0\) \(0.7\) \(130\) \(0.0\) \(1.0\) \(140\) \(0.6\) \(0.6\) \(150\) \(0.8\) \(0.5\) \(160\) \(1.0\) \(0.2\) 现在问题是:每个参考体重 \(x\) 能给 \(130\) 提供多强的支持?
它必须同时满足两个条件:
- \(x\) 自己要 heavy;
- \(x\) 要和 \(130\) 接近。
只要其中一个条件很弱,支持力度就不能很强。所以用:
\[ \min(\text{x 有多 heavy},\text{x 和 y 有多接近}) \]
这就是 min 的作用:取短板。比如 \(x=160\),160本身 heavy 程度=1.0,但:160 和 130 接近程度=0.2,所以它对“130 算 more or less heavy”的支持最多只有 \(\min(1.0,0.2)=0.2\), 因为 160 虽然很重,但离 130 太远。
算完所有参考体重后,我们有一堆“支持理由”:
\[ 0.0,\ 0.0,\ 0.6,\ 0.5,\ 0.2 \]
现在问:最终 \(130\) 算 more or less heavy 的程度是多少?只要有一个理由足够强,就可以支持它。所以取最大:
\[ \max(0.0,0.0,0.6,0.5,0.2)=0.6 \]
这就是 max 的作用:取最强支持。
所以 min-max 公式:
\[ \mu_{R_3}(y)=\max_x\min(\mu_{R_1}(x),\mu_{R_2}(x,y)) \]
可以翻译成:
对于目标体重 \(y\),找所有参考体重 \(x\)。每个 \(x\) 对 \(y\) 的支持力度等于“\(x\) 有多 heavy”和“\(x\) 与 \(y\) 有多接近”二者中的较小值。最后从所有 \(x\) 的支持力度里取最大值,作为 \(y\) 属于 more or less heavy 的程度。
8.5 飞机识别中的模糊推理
以飞机图像识别为例,每张图像对 Missile、Fighter、Airliner 都有不同隶属度。例如 IMAGE4 对三类目标的隶属度为:
\[ TARGET_4=0.2/M+0.3/F+0.5/A \]
IMAGE6 为:
\[ TARGET_6=0.1/M+0.6/F+0.4/A \]
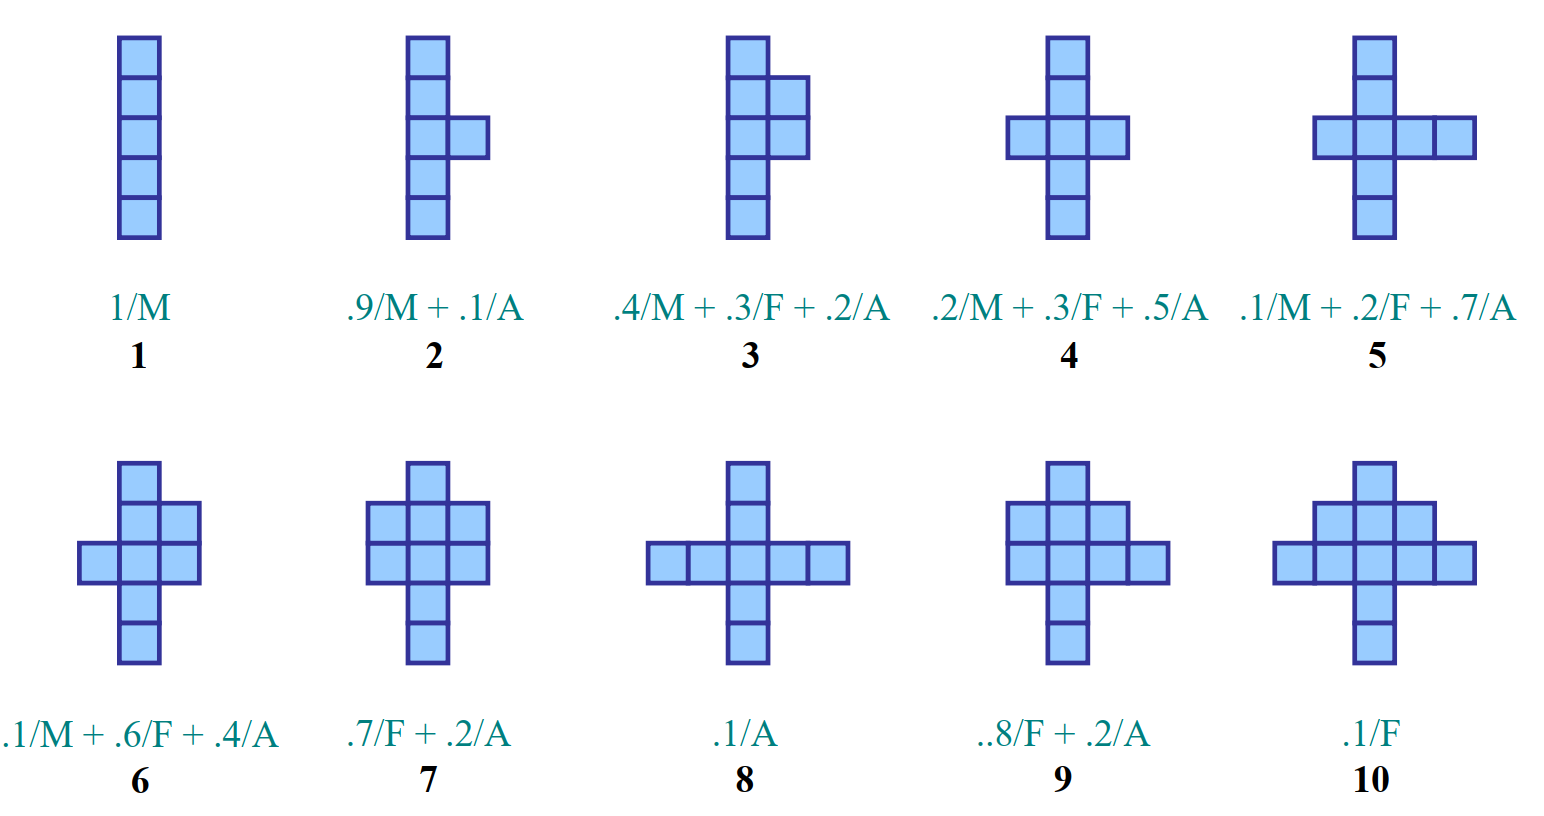
如果两个规则都触发(即系统当前识别到的输入里,既包含或匹配了 IMAGE4,又包含或匹配了 IMAGE6),则合并时对同一元素取最大隶属度: \[ \begin{aligned} TARGET&=TARGET_4+TARGET_6\\ &=0.2/M+0.3/F+0.5/A+0.1/M+0.6/F+0.4/A\\ &=0.2/M+0.6/F+0.5/A \end{aligned} \]
这里的 \(+\) 不是普通加法,而是模糊集合的并:相同元素保留最大隶属度。类似地,模糊集合的交是取 \(\min\)。
8.6 一般模糊推理形式
一般地,如果有 \(n\) 条规则:
\[ \text{IF }E_i\text{ THEN }H_i,\qquad i=1,2,\ldots,n \]
则总体结论可以由各规则结论的最大值合成:
\[ \mu_H=\max(\mu_{H_1},\mu_{H_2},\ldots,\mu_{H_n}) \]
如果前提本身是复合表达式,例如:
\[ E_1=E_A\land(E_B\lor\lnot E_C) \]
则:
\[ \mu_{E_1}=\min\{\mu_{E_A},\max(\mu_{E_B},1-\mu_{E_C})\} \]
这与 CF 中 AND 用 \(\min\)、OR 用 \(\max\)、NOT 用取反很相似,但模糊推理处理的是“概念隶属度”,而 CF 处理的是“证据对假设的确定性支持”。
9 方法总结
9.1 概念区分
概率和模糊隶属度不要混淆。概率表示事件发生的不确定性,例如明天下雨的概率是 \(0.6\);模糊隶属度表示对象符合某个概念的程度,例如一个人属于 tall 的程度是 \(0.6\)。
CF 不是后验概率。后验概率 \(P(H\mid E)\) 是严格概率意义上的条件概率,而 \(CF(H,E)\) 是 MYCIN 中为了表达专家信任和不信任而设计的启发式指标。
\(E\) 和 \(e\) 的区别要清楚。在 CF 中,\(E\) 是规则前提里的证据表达式,\(e\) 是当前真实观察到的证据背景。\(CF(E,e)\) 表示在当前观察背景下,规则前提 \(E\) 的可信度。
贝叶斯决策不只算概率。贝叶斯更新解决“哪个假设更可信”,而决策还要考虑收益和损失。
9.2 贝叶斯决策计算流程
贝叶斯决策可以按以下顺序计算:
- 写出假设 \(H_i\) 和先验 \(P(H_i)\)。
- 写出证据 \(E\) 下的条件概率 \(P(E\mid H_i)\)。
- 计算联合概率 \(P(E\cap H_i)=P(E\mid H_i)P(H_i)\)。
- 计算证据总概率 \(P(E)=\sum_iP(E\cap H_i)\)。
- 计算后验概率 \(P(H_i\mid E)=\dfrac{P(E\cap H_i)}{P(E)}\)。
- 如果是决策题,再用后验概率乘以收益或损失,比较期望值。
9.3 CF 计算流程
CF 计算通常分三步。第一步先算复合前提:
\[ AND\to\min,\qquad OR\to\max,\qquad NOT\to- \]
第二步算规则结论:
\[ CF(H,e)=CF(E,e)CF(H,E) \]
第三步如果多条规则都推出同一假设,就使用 \(CF_{\mathrm{COMB}}\) 合成。
9.4 马尔可夫链计算流程
马尔可夫链计算一般先写状态向量 \(S_t\) 和转移矩阵 \(P\),再做状态更新:
\[ S_{t+1}=S_tP \]
如果要求稳态,就设:
\[ SP=S,\qquad \sum_i S_i=1 \]
然后解线性方程组。
9.5 模糊推理计算流程
模糊推理首先把每个自然语言条件转成隶属度。复合条件按:
\[ AND\to\min,\qquad OR\to\max,\qquad NOT\to 1-\mu \]
如果有 linguistic hedge,要先变换隶属度,例如 very 对应平方,more or less 对应开方。若是模糊关系合成,则使用:
\[ \mu_{R_3}(y)=\max_x\min(\mu_{R_1}(x),\mu_{R_2}(x,y)) \]
如果多个模糊结论合并,同一元素取最大隶属度。