遗传算法(Genetic Algorithm, GA)是一类受生物进化启发的随机搜索与优化方法。本文从一个最大化函数的例子出发,依次介绍遗传算法的基本流程、选择/交叉/变异等遗传算子、背包问题、CNF 可满足性问题、旅行商问题、PLA 进化硬件应用中的编码方式,以及用于解释遗传算法有效性的 Schema Theorem(模式定理)。
0. 概念与公式概览
核心概念
| 概念 | 含义 |
|---|---|
| Genetic Algorithm | 模拟“适者生存”和“遗传变异”的启发式优化算法,适合在巨大搜索空间中寻找近似最优解。 |
| Individual / Chromosome | 个体或染色体,表示一个候选解。它通常被编码成二进制串、排列、实数向量等形式。 |
| Gene | 染色体上的一个基本位置,例如二进制串中的某一位。 |
| Population | 种群,即同一代中的一组候选解。 |
| Fitness | 适应度,用来评价一个个体作为解的好坏。适应度越高,越可能被选择繁殖。 |
| Selection | 选择算子,根据适应度从当前种群中选出父代。轮盘赌选择是经典方法。 |
| Crossover | 交叉算子,把两个父代的部分结构重新组合,产生子代。 |
| Mutation | 变异算子,以较小概率随机改变个体的局部结构,防止搜索过早收敛。 |
| Encoding | 编码方式,即如何把实际问题的一个解表示为遗传算法可以操作的染色体。 |
| Evolutionary Hardware | 进化硬件,用遗传算法自动搜索硬件结构或可编程器件配置。PLA 是其中一种典型示例。 |
| Schema | 模式,用带通配符的模板表示一类相似染色体,例如 \((1**0*1)\)。 |
| Schema Theorem | 短、低阶、适应度高于平均水平的模式,会在后续世代中呈指数增长。 |
基本公式
轮盘赌选择概率
若个体 \(i\) 的适应度为 \(f(i)\),种群大小为 \(n\),则它被选中的概率为:
\[ p_i=\frac{f(i)}{\sum_{j=1}^{n}f(j)} \]
平均适应度
\[ \bar f=\frac{1}{n}\sum_{j=1}^{n}f(j) \]
只考虑选择时,模式数量的期望
若 \(m(s,t)\) 表示第 \(t\) 代中属于模式 \(s\) 的个体数量,\(f(s)\) 表示模式 \(s\) 中个体的平均适应度,则:
\[ E[m(s,t+1)] = m(s,t)\cdot \frac{f(s)}{\bar f} \]
如果 \(f(s)=(1+c)\bar f\),即模式 \(s\) 的适应度比平均水平高 \(c\),则:
\[ E[m(s,t+1)] = m(s,t)(1+c) \]
连续迭代后,高于平均适应度的模式会呈指数趋势增加。
考虑单点交叉对模式的破坏
设染色体长度为 \(l\),交叉概率为 \(p_c\),模式 \(s\) 的定义长度为 \(\delta(s)\),则模式在交叉中不被破坏的概率至少为:
\[ p_s \ge 1-p_c\cdot \frac{\delta(s)}{l-1} \]
考虑变异对模式的破坏
设变异概率为 \(p_m\),模式阶数为 \(O(s)\),且 \(p_m \ll 1\),则模式不被变异破坏的概率近似为:
\[ p_s=(1-p_m)^{O(s)}\approx 1-O(s)p_m \]
完整模式定理的常见近似形式
\[ E[m(s,t+1)] \ge m(s,t)\cdot \frac{f(s)}{\bar f} \cdot \left[ 1-p_c\cdot \frac{\delta(s)}{l-1}-O(s)p_m \right] \]
这个公式的含义是:一个模式能否保留下来并增长,主要取决于三件事:它的平均适应度是否高、定义长度是否短、固定位置是否少。
1. 遗传算法的基本思想:把优化问题看成“进化”
遗传算法的出发点来自达尔文进化论:在自然界中,个体之间存在差异;环境会选择更适应的个体;被选择的个体通过繁殖把有利结构传递给下一代;同时,变异又会不断产生新的可能性。遗传算法把这个思想搬到计算问题中:一个候选解对应一个“个体”,一组候选解构成“种群”,评价函数对应“适应度”,算法不断让较好的候选解更容易繁殖,并通过交叉和变异生成新的候选解。
它与穷举搜索的区别在于,遗传算法并不逐个检查所有可能解,而是维护一个种群,让搜索方向逐渐向高适应度区域集中。它与普通随机搜索的区别在于,随机搜索每次几乎重新开始,而遗传算法会保留和重组历史上已经发现的有用结构。因此,遗传算法特别适合搜索空间很大、目标函数复杂、无法轻易求导或没有精确多项式算法的问题。
需要注意的是,遗传算法通常求的是近似最优解,不是严格保证的全局最优解。它的优势是通用、鲁棒、容易并行;它的弱点是参数敏感、可能早熟收敛,而且计算成本不一定低。
2. 从 \(f(x)=x^2\) 的例子理解遗传算法
可以用一个很小的最大化问题观察遗传算法如何运行:
\[ \max f(x)=x^2,\quad x\in[1,31] \]
因为 \(x\) 的取值范围是 \(1\) 到 \(31\),可以用 5 位二进制串表示一个候选解。例如:
| 二进制染色体 | 十进制 | 适应度 \(f(x)=x^2\) |
|---|---|---|
01101 |
\(13\) | \(169\) |
11000 |
\(24\) | \(576\) |
01000 |
\(8\) | \(64\) |
10011 |
\(19\) | \(361\) |
这一步体现了遗传算法的第一件事:表示(representation)。算法无法直接理解“求函数最大值”这个问题,它只能操作编码后的个体。因此,我们要先把问题中的解映射为染色体,再通过适应度函数评价染色体的好坏。
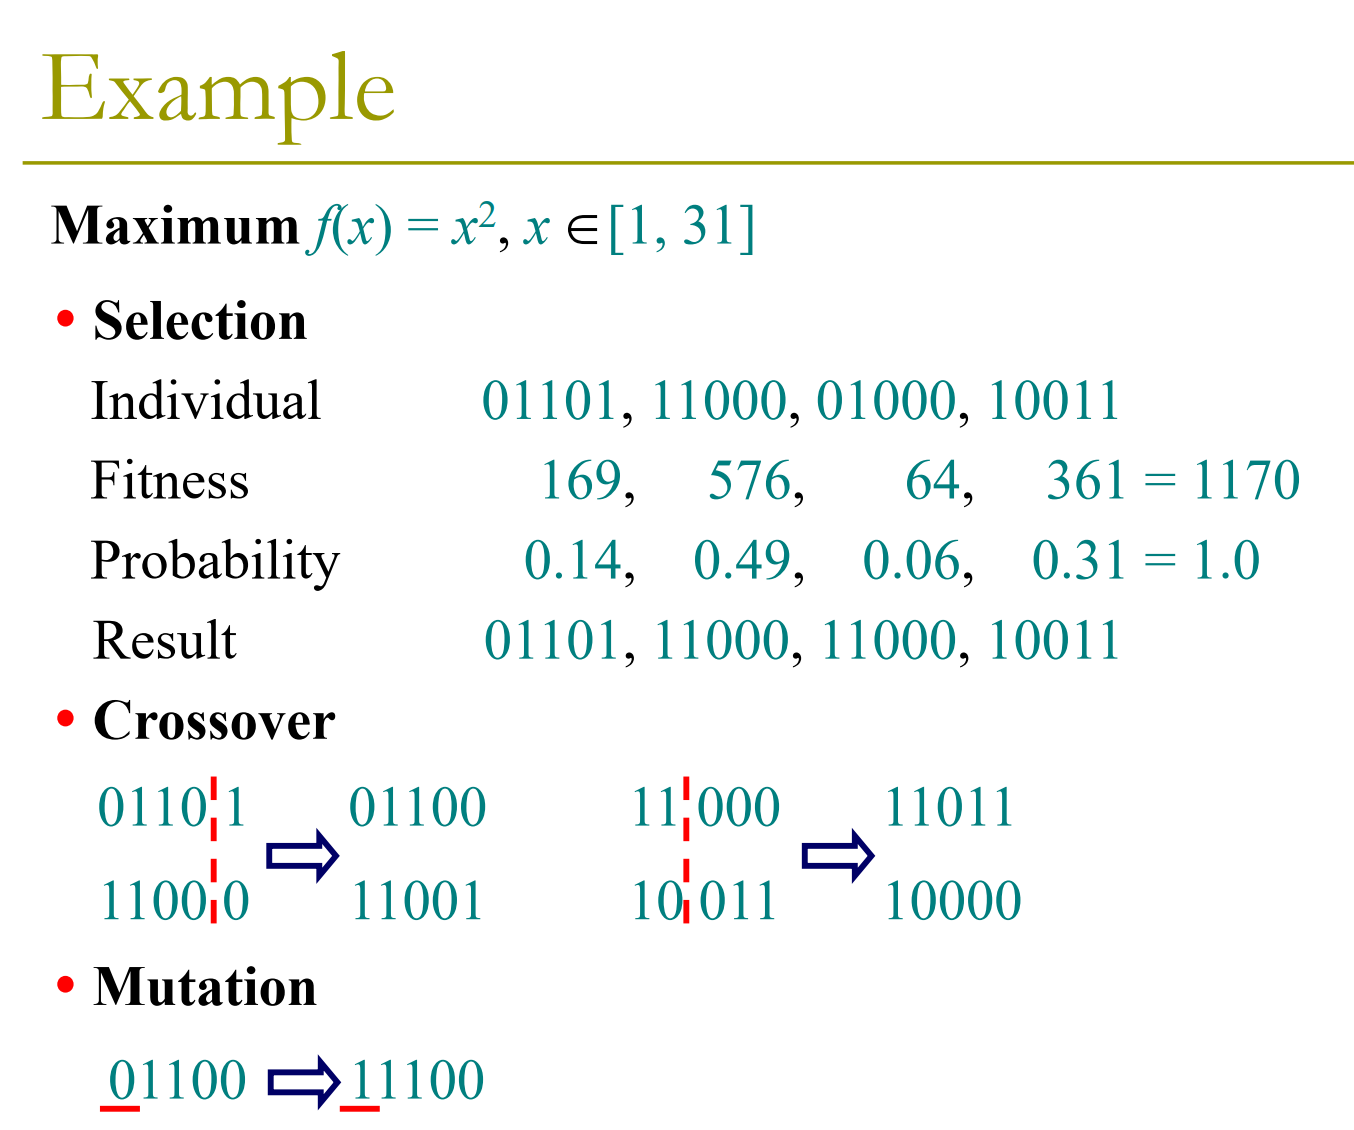
在这个例子中,初始种群为:
\[ P(0)=\{01101,11000,01000,10011\} \]
它们的适应度总和为:
\[ 169+576+64+361=1170 \]
于是每个个体在轮盘赌选择中的概率为:
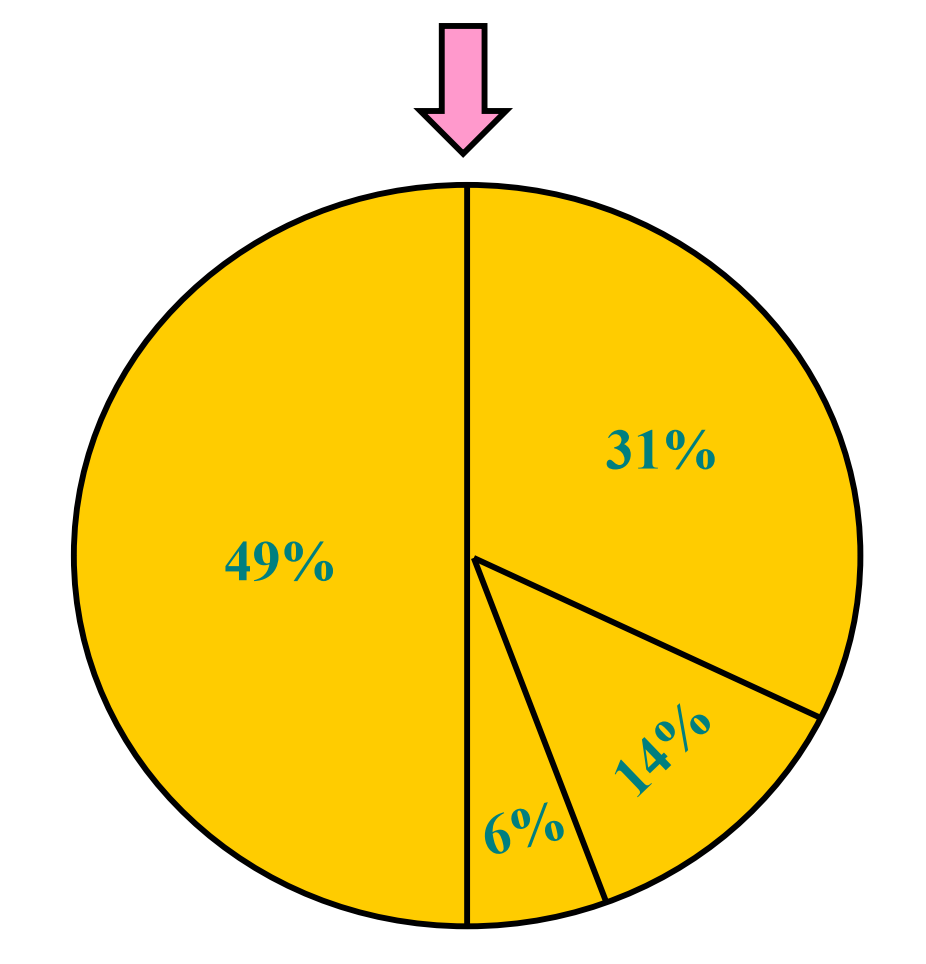
\[ \begin{aligned} P(01101)&=\frac{169}{1170}\approx0.14\\ P(11000)&=\frac{576}{1170}\approx0.49\\ P(01000)&=\frac{64}{1170}\approx0.06\\ P(10011)&=\frac{361}{1170}\approx0.31 \end{aligned} \]
可以看到,11000 对应的 \(x=24\)
适应度最高,所以它占据了轮盘上最大的区域,被抽中的概率也最大。这里下一代选择结果为:
\[ 01101,\ 11000,\ 11000,\ 10011 \]
这说明高适应度个体可能被复制多次,而低适应度个体可能被淘汰。这个过程类似自然选择,但它不是完全确定的:适应度高只是概率更大,并不意味着一定被选中;适应度低也仍然保留少量机会。
2.1 轮盘赌选择的直观理解
轮盘赌选择(Russian roulette / roulette wheel selection)可以理解为把每个个体按照适应度大小分配一个扇形区域,然后随机转动指针。适应度越高,扇形区域越大,被选中的概率越高。这里四个个体的概率分别是 \(14\%\)、\(49\%\)、\(6\%\)、\(31\%\),其中 \(49\%\) 的个体最容易被选中。
这种方法的优点是简单,并且能保留随机性;缺点是当某个个体适应度远高于其他个体时,它可能过快支配种群,使算法陷入局部最优。实际应用中常会使用锦标赛选择、排序选择、精英保留等策略来调节选择压力。
2.2 交叉:重组已有的好结构
选择之后,算法通常把选出的个体两两配对,通过交叉产生子代。以单点交叉为例,若两个父代为:\(01101, 11000\),选择某个切分点后,可以把两个父代的前后片段交换,得到新的子代 \(01100,11001\)。
交叉的核心意义不是随机乱改,而是把不同个体中可能有用的局部结构重新组合。如果一个父代在前半部分编码了好的特征,另一个父代在后半部分编码了好的特征,交叉就可能把它们组合到同一个子代中。
不过,交叉也可能破坏已经形成的好结构。模式定理中“定义长度越短越容易保留”这一点,正是因为短结构被单点交叉切断的概率较小。
2.3 变异:维持多样性,避免早熟收敛
变异通常以较小概率随机翻转二进制串中的某一位。例如:
\[ 01100 \rightarrow 01101 \]
在二进制编码中,变异就是把某位从 \(0\) 改成 \(1\),或从 \(1\) 改成 \(0\)。变异的作用是给种群引入新基因,使算法有机会跳出当前搜索区域。若没有变异,种群中不存在的某些位值可能永远不会再出现;若变异概率过高,算法又会退化成接近随机搜索。因此,变异率一般较小。
3. 遗传算法的一般流程
遗传算法的伪代码可以整理为以下步骤:
- 设定时间/代数 \(t=0\)。
- 初始化种群 \(P(t)\)。
- 如果终止条件尚未满足,就重复以下过程。
- 计算种群 \(P(t)\) 中每个个体的适应度。
- 根据适应度从 \(P(t)\) 中选择个体作为父代。
- 对父代使用遗传算子,例如交叉和变异,生成子代。
- 用子代替换当前种群中的部分或全部候选个体。
- 令 \(t=t+1\),进入下一代。
对应的逻辑可以写成:
1 | begin |
这里最重要的是理解“评价、选择、生成、替换”四个环节的闭环。评价决定谁更好,选择决定谁更有繁殖机会,交叉和变异决定下一代会出现什么新解,替换策略决定旧解和新解如何共存。
常见终止条件包括:达到最大代数、适应度达到预设阈值、连续多代没有明显改进,或者计算时间用尽。这里需要特别注意:遗传算法不是单个解在移动,而是一群解在演化,这也是它区别于许多局部搜索算法的重要特征。
4. 编码与适应度:遗传算法成败的关键
遗传算法本身只提供一种通用搜索框架,真正决定它能否解决问题的是编码方式和适应度函数。如果编码不能正确表达可行解,或者适应度函数不能反映解的质量,那么选择、交叉、变异再精巧也很难得到好结果。
4.1 二进制编码
二进制编码是最经典的表示方法。它把一个候选解表示为固定长度的 \(0/1\) 字符串,适合整数参数、布尔变量、子集选择等问题。例如 \(x\in[1,31]\) 可以用 5 位二进制表示,CNF-SAT 中每个布尔变量的真假也可以用一位表示。
二进制编码的优点是结构简单,交叉和变异操作非常自然;缺点是不同问题的语义可能不适合简单位串。例如旅行商问题中,一个解必须是城市排列,若直接用二进制串交叉,可能产生重复城市或遗漏城市,从而得到非法路线。
4.2 排列编码
旅行商问题(TSP)常使用排列编码。一个染色体就是访问城市的顺序,例如:
\[ (1,9,2,4,6,5,7,8,3) \]
这表示从城市 \(1\) 出发,依次访问 \(9,2,4,\dots,3\),最后回到起点。排列编码的关键约束是:每个城市必须出现且只出现一次。因此,TSP 的交叉和变异不能随便按二进制串处理,而必须保证子代仍然是合法排列。
4.3 格雷编码
二进制编码和格雷编码(Gray
coding)的差异在于:格雷编码让相邻数值的编码只相差一位。例如普通二进制中
\(7\) 到 \(8\) 会从 0111 变成
1000,四位全部改变;而在格雷编码中,相邻数通常只改变一位。
格雷编码在遗传算法中的意义是改善“编码空间”和“问题空间”之间的连续性。如果两个数值上非常接近的解,在编码上却相差很多位,那么一次小变异可能造成很大的语义变化,搜索会变得不平滑。格雷编码通过让相邻数值具有更小的汉明距离,使局部搜索更稳定。
普通二进制转格雷码的常见公式为:
\[ g=b\oplus (b >> 1) \]
其中 \(\oplus\) 表示按位异或,\(>>1\) 表示右移一位。学习时不一定要记住所有转换表,但要理解它为什么有助于遗传算法:好的编码应该让“相似的染色体”尽量对应“相似的解”。
5. 典型应用问题
5.1 背包问题
背包问题可以这样描述:小偷抢劫商店时有 \(n\) 个物品,第 \(i\) 个物品价值为 \(v_i\),重量为 \(w_i\),背包最多承重 \(W\)。问题是选择哪些物品,使总价值尽可能大,同时总重量不超过 \(W\)。
它可以形式化为:
\[ \max \sum_{i=1}^{n}v_i x_i \]
约束为:
\[ \sum_{i=1}^{n}w_i x_i \le W,\quad x_i\in\{0,1\} \]
其中 \(x_i=1\) 表示选择第 \(i\) 个物品,\(x_i=0\) 表示不选择。这个问题天然适合二进制编码:一个长度为 \(n\) 的染色体就表示一组物品选择方案。例如:
\[ 10110 \]
表示选择第 \(1\)、第 \(3\)、第 \(4\) 个物品,不选择第 \(2\)、第 \(5\) 个物品。
背包问题中的难点是约束处理。若某个染色体对应的总重量超过 \(W\),它就是不可行解。常见处理方式有三种:第一,把不可行解的适应度设为很低;第二,在适应度中加入惩罚项,例如超重越多惩罚越大;第三,对不可行解进行修复,删除部分物品直到满足约束。因此,带约束优化问题不能只看目标函数,还要处理可行性。
5.2 CNF 可满足性问题
CNF-satisfaction problem 指的是判断一个合取范式公式是否存在一组布尔变量赋值,使整个公式为真。合取范式(Conjunctive Normal Form, CNF)由多个子句用 AND 连接,每个子句内部由文字用 OR 连接。这里的例子类似:
\[ (\lnot a\lor c)\land(\lnot a\lor c\lor \lnot e)\land (\lnot b\lor c\lor d\lor \lnot e)\land (a\lor \lnot b\lor c)\land(\lnot e\lor v) \]
在 CNF-SAT 中,一个染色体可以表示所有变量的一组真假赋值。例如变量为 \(a,b,c,d,e,v\) 时,可以用 6 位二进制串表示:
\[ 101001 \]
如果约定 \(1\) 表示真、\(0\) 表示假,那么它对应一组具体赋值。适应度函数可以设计为“被满足的子句数量”。例如共有 5 个子句,某个赋值满足 4 个子句,那么适应度可以是 \(4\);如果满足全部子句,说明找到了一个可满足解。
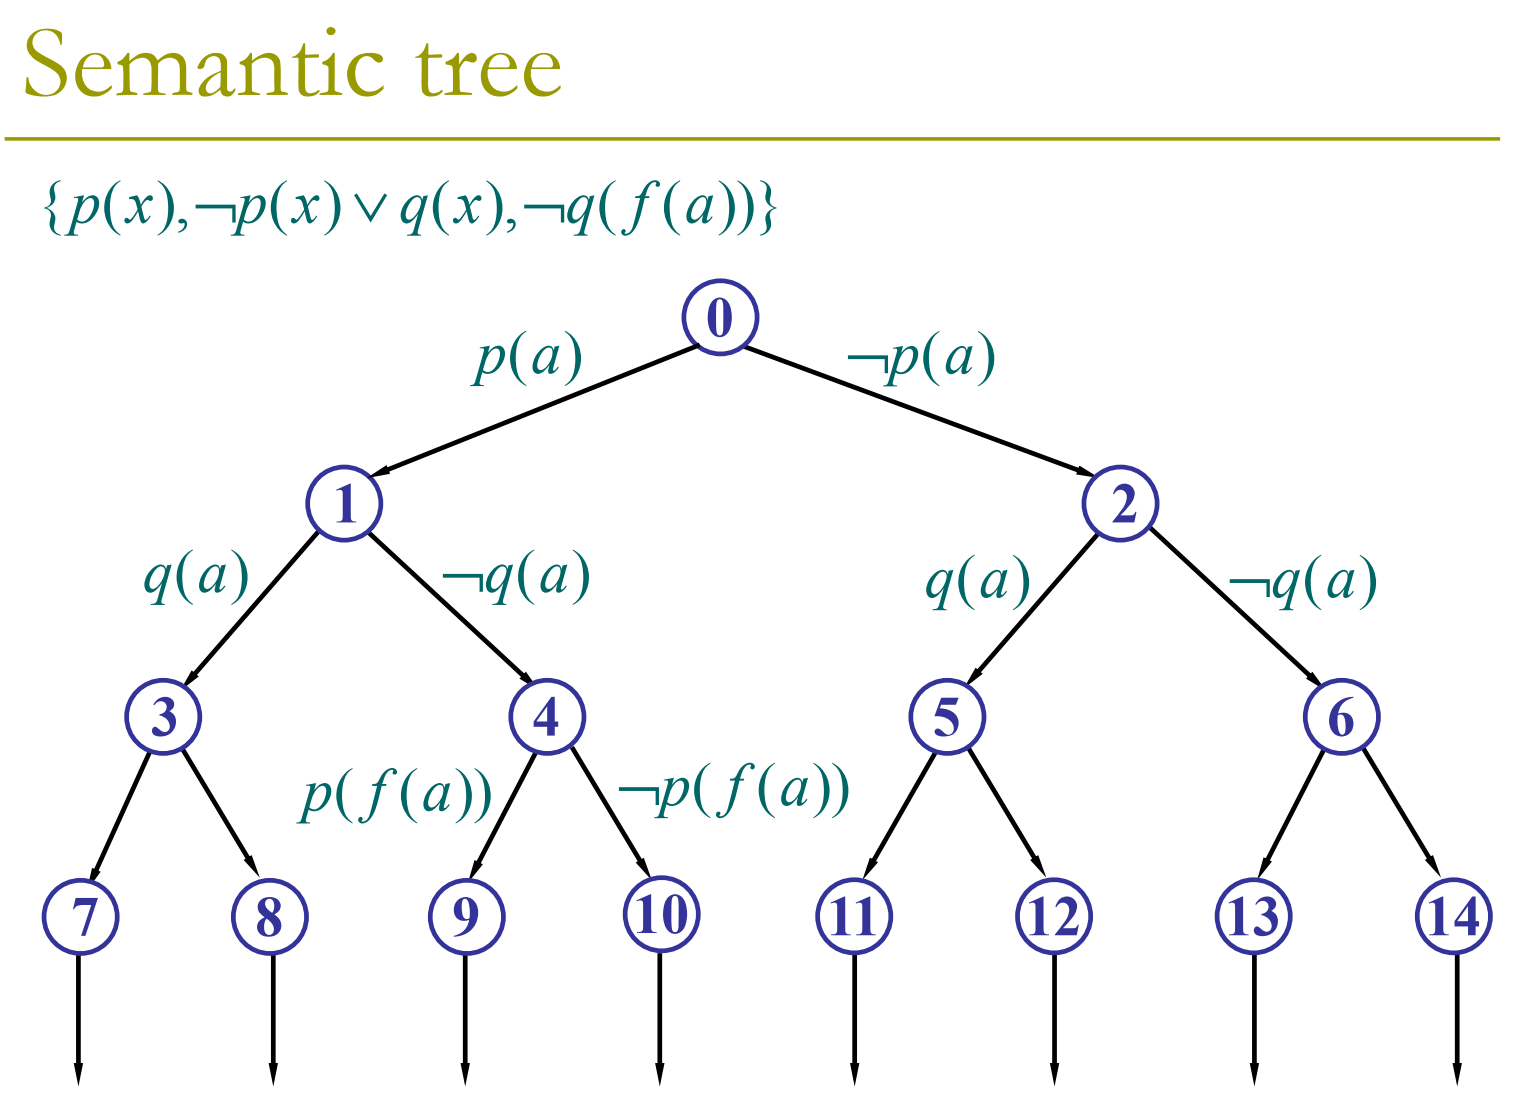
语义树体现了逻辑赋值的搜索树思想:每一层为某个命题或项选择真假,沿着树的一条路径就得到一个完整赋值。遗传算法与语义树的区别在于,语义树更像系统枚举或回溯搜索,而遗传算法维护多个赋值候选,并通过适应度引导搜索。
5.3 旅行商问题
旅行商问题(Traveling Salesman Problem, TSP)要求在给定若干城市及两两旅行成本的情况下,找出一条总成本最低的路线,使旅行商从某城市出发,每个城市恰好访问一次,最后回到出发城市。
如果有 19 个城市,并固定起点,那么可能路线数量约为:
\[ 18! = 6.40237\times 10^{15} \]
这个数字说明穷举搜索不可行。即使一台计算机每秒检查 \(10000\) 条路线,人的一生约为:
\[ 80\times 365\times 24\times 60\times 60 =2.52288\times 10^9\ \text{seconds} \]
穷举所有路线所需时间也远远超过可接受范围。因此,TSP 是说明遗传算法价值的典型例子:我们不追求枚举所有路线,而是在巨大排列空间中寻找足够好的路线。
5.3.1 TSP 的交叉
设两个父代排列为:
\[ p_1=(1 \ 9 \ 2 \ |\ 4 \ 6 \ 5 \ 7\ | \ 8 \ 3) \]
\[ p_2=(4 \ 5 \ 9 \ |\ 1 \ 8 \ 7 \ 6\ | \ 2 \ 3) \]
TSP 的交叉需要保持“每个城市出现一次”。一种常用方法类似顺序交叉(Order Crossover, OX):先在一个父代中保留两个切点之间的片段,然后从另一个父代的第二个切点之后开始,按顺序复制尚未出现的城市;到末尾后再从开头继续。
这个例子相当于保留第 4 位到第 7 位这一段。先看 \(c_1\) 的产生过程:从 \(p_1\) 中复制中间片段:
\[ p_1=(1,9,2,\boxed{4,6,5,7},8,3) \]
因此 \(c_1\) 先变成:
\[ c_1=(*,*,*,4,6,5,7,*,*) \]
接着从另一个父代 \(p_2\) 的第二个切点后开始读,读到末尾后再绕回开头,可以得到顺序:
\[ 2,3,4,5,9,1,8,7,6 \]
但是 \(c_1\) 里已经有 \(4,6,5,7\),所以这些城市不能再填一次。也就是说,在序列 \(2,3,4,5,9,1,8,7,6\) 中跳过 \(4,5,7,6\),剩下的城市是:
\[ 2,3,9,1,8 \]
把它们依次填入 \(c_1\) 的空位,就得到:
\[ c_1=(2,3,9,4,6,5,7,1,8) \]
\(c_2\) 的产生过程是对称的。先从 \(p_2\) 中复制同样位置的片段: \[ p_2=(4,5,9,\boxed{1,8,7,6},2,3) \]
因此:
\[ c_2=(*,*,*,1,8,7,6,*,*) \]
然后从 \(p_1\) 的第二个切点后开始读,绕回开头得到:
\[ 8,3,1,9,2,4,6,5,7 \]
删去 \(c_2\) 中已经出现的 \(1,8,7,6\)。也就是说,在序列 \(8,3,1,9,2,4,6,5,7\) 中跳过 \(8,1,6,7\),剩下:
\[ 3,9,2,4,5 \]
依次填入空位,就得到:
\[ c_2=(3,9,2,1,8,7,6,4,5) \]
所以,顺序交叉的核心规则是:一个父代贡献固定片段,另一个父代贡献剩余城市的相对顺序,已经出现过的城市全部跳过。
5.3.2 TSP 的变异:反转变异
这里的 TSP 变异使用了 inversion(反转)。例如:
\[ c_1=(2,3,9,4,6,5,7,1,8) \]
经过反转后得到:
\[ c_1'=(2,3,9,7,5,6,4,1,8) \]
也就是说,中间某一段排列被反向。反转变异非常适合 TSP,因为它不会改变城市集合,只会改变访问顺序,因此一定保持可行性。它还有明确的路径意义:反转某一段路线,相当于在路径中进行局部重连,可能明显缩短路程。
5.4 遗传算法在 PLA 中的应用
Evolutionary Hardware(进化硬件)说明遗传算法不只可以求函数最大值、背包问题或 TSP,也可以用于自动设计硬件电路。这里的 PLA 指 Programmable Logic Array(可编程逻辑阵列),它是一种可以通过配置连接关系来实现组合逻辑函数的硬件结构。
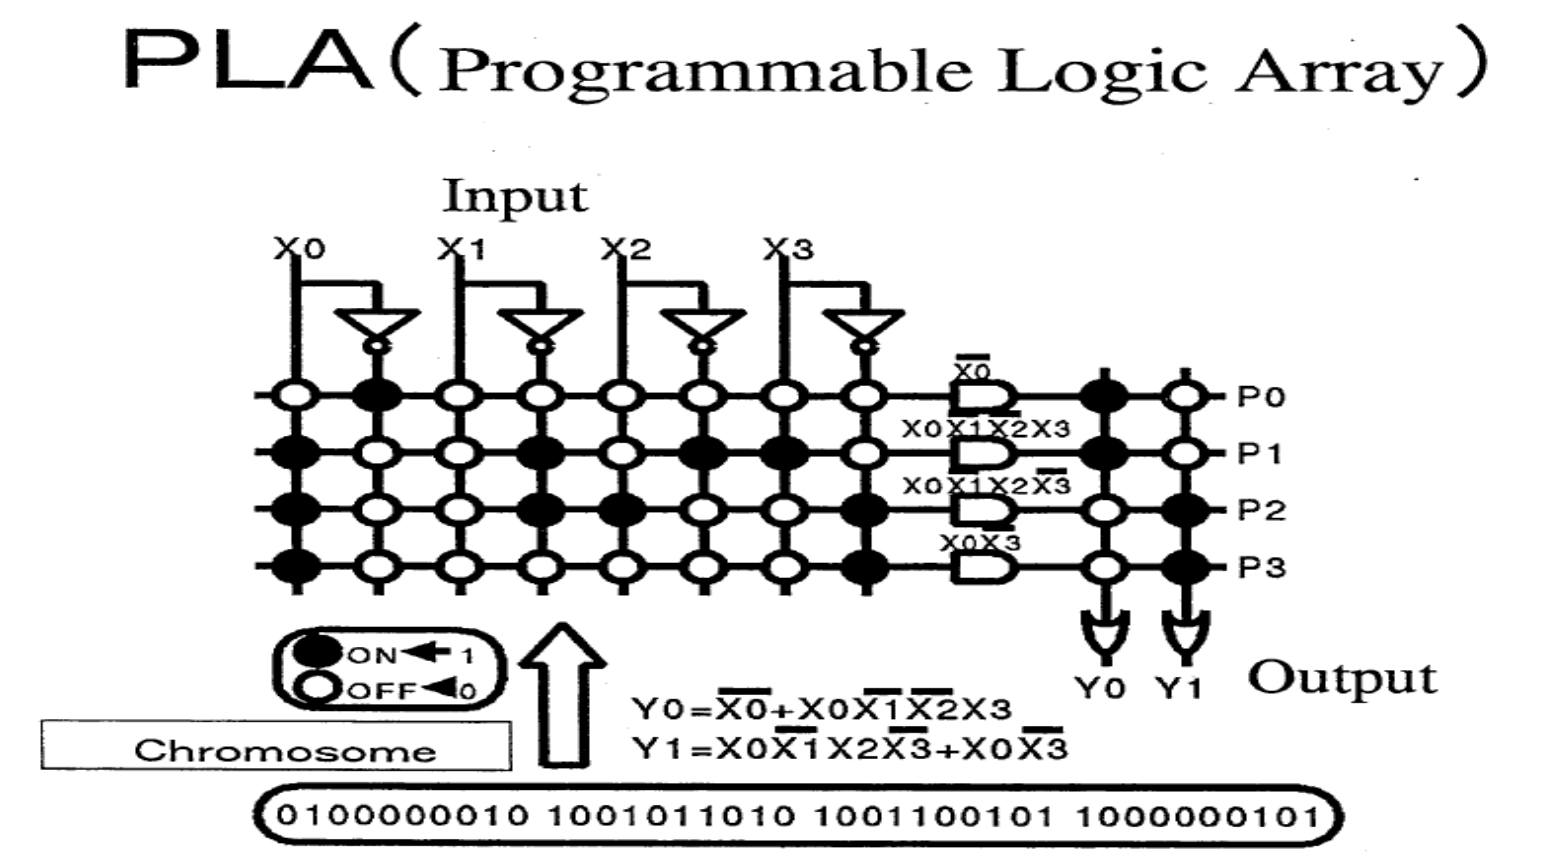
PLA 通常可以理解成两级逻辑阵列:前一级是可编程 AND 阵列,用来形成若干乘积项;后一级是可编程 OR 阵列,用来把这些乘积项组合成输出函数。对于一个布尔函数,例如:
\[ F(A,B,C)=\overline A B + A C \]
PLA 的任务就是通过配置输入信号、反相信号、中间乘积项和输出连接,让硬件最终实现目标逻辑函数。传统方法需要人工或逻辑综合工具设计连接方式,而进化硬件的思路是:把 PLA 的连接配置编码成染色体,让遗传算法自动搜索更好的电路配置。
在这个场景中,遗传算法各部分可以对应如下:
| 遗传算法概念 | PLA 中的含义 |
|---|---|
| 个体 / 染色体 | 一种 PLA 配置方案,例如哪些输入接入 AND 阵列、哪些乘积项接入 OR 阵列。 |
| 基因 | 某一个可编程连接点的状态,例如连接为 \(1\)、不连接为 \(0\)。 |
| 种群 | 多个候选 PLA 配置方案。 |
| 适应度 | 电路输出与目标真值表的匹配程度,也可以同时考虑面积、延迟、功耗等指标。 |
| 选择 | 保留更接近目标逻辑函数的配置。 |
| 交叉 | 把两个较好 PLA 配置的一部分连接结构重新组合。 |
| 变异 | 随机打开或关闭某些连接点,产生新的电路结构。 |
如果把 PLA 中所有可编程连接点按固定顺序排成一个二进制串,那么一个染色体就可以写成:
\[ 1010010110\dots \]
其中每一位表示一个连接点是否被启用。遗传算法首先随机生成一批这样的配置,然后把每个配置加载到 PLA 模型中,测试它对所有输入组合产生的输出是否符合目标真值表。若目标函数有 \(k\) 个输入,就有 \(2^k\) 种输入组合;适应度可以简单设计为:
\[ fitness=\frac{\text{输出正确的输入组合数}}{2^k} \]
如果还希望电路更简单,可以加入惩罚项,例如连接点越多、乘积项越多,适应度越低:
\[ fitness=\alpha\cdot accuracy-\beta\cdot complexity \]
其中 \(accuracy\) 表示逻辑正确率,\(complexity\) 表示电路复杂度,\(\alpha\) 和 \(\beta\) 用来调节“正确性”和“简洁性”的权重。
这个例子的重点是:硬件设计也可以被看成搜索问题。只要能把一种硬件结构表示成染色体,并能用适应度函数评价它是否接近目标功能,遗传算法就可以通过选择、交叉和变异逐步改进硬件配置。PLA 示例体现的正是这种思想:遗传算法不是直接“理解电路”,而是在大量可编程连接方案中搜索能实现目标逻辑的那一种。
6. 遗传算法为什么有效:从搜索空间到模式定理
6.1 从“随机搜索”到“有方向的随机搜索”
遗传算法在搜索空间中的作用可以这样理解:初始种群通常只是搜索空间中的一批随机点,因此一开始解的质量可能参差不齐。随着选择、交叉和变异不断进行,高适应度个体更可能留下来,优秀结构更可能被组合,种群会逐渐向较好的区域移动。
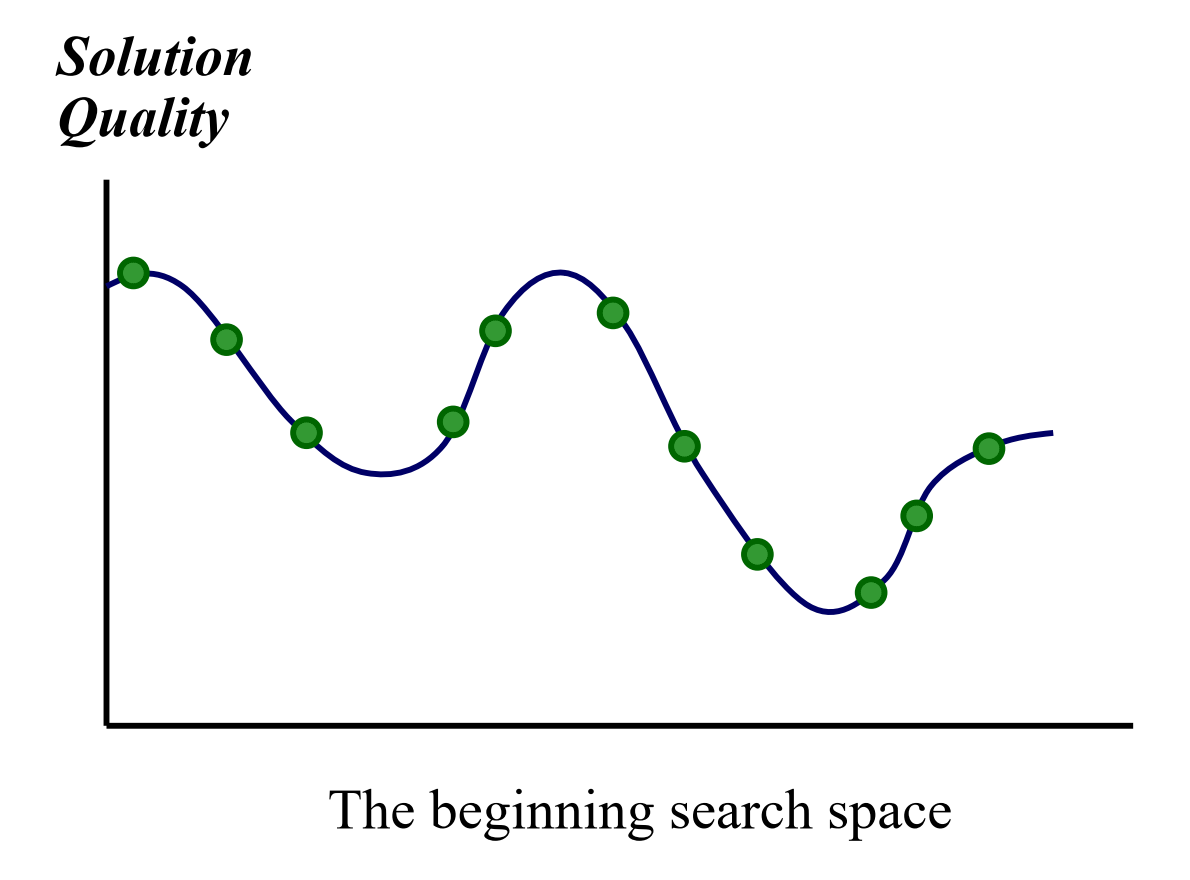
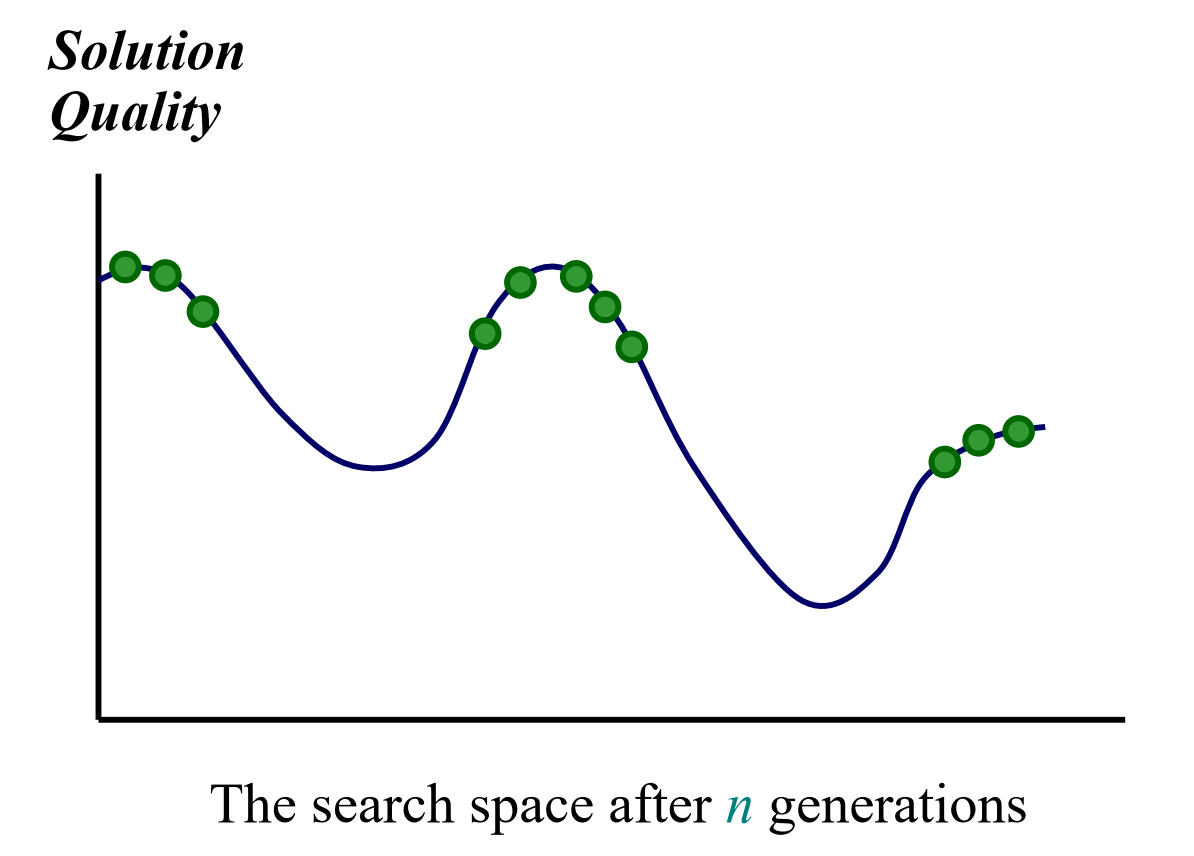
这说明遗传算法不是完全随机搜索。随机搜索每次抽样相互独立,前一次发现的好解不会对下一次产生结构性影响;遗传算法则会利用历史信息,让较好的结构拥有更高的复制概率。因此,它是一种带有选择压力的随机优化方法。
不过,搜索空间被压缩到高适应度区域并不总是好事。如果种群过早集中在某个局部区域,算法可能失去多样性,无法发现更好的区域。这就是所谓早熟收敛。交叉、变异、较大的种群、多样性维护策略,都可以在一定程度上缓解这个问题。
7. Schema:遗传算法中的“有用结构”
模式(schema)是遗传算法理论中非常重要的概念。一个模式不是单个染色体,而是一类染色体的模板。它由固定符号和通配符组成。通配符 \(*\) 表示该位置可以是 \(0\) 或 \(1\)。
例如这里的模式:
\[ (1** \ 0*1) \]
它描述所有长度为 6,并且第 1 位为 \(1\)、第 4 位为 \(0\)、第 6 位为 \(1\) 的二进制串。第 2、3、5 位是通配符,因此可以任意取值。这个模式对应的具体染色体包括:
\[ 100001,\ 100011,\ 101001,\ 101011,\ 110001,\dots \]
理解 schema 的关键是:遗传算法并不只是在复制完整染色体,它也在隐含地复制某些局部结构。例如一个高适应度个体可能好,是因为它包含某个有用片段;交叉和选择会让这些片段在种群中越来越常见。
7.1 模式阶数 \(O(s)\)
模式阶数 \(O(s)\) 定义为模板中固定位置的数量。对模式:
\[ s=(1** \ 0*1) \]
固定位置为第 1 位、第 4 位、第 6 位,所以:
\[ O(s)=3 \]
阶数越高,说明模式约束越多,也越容易被变异破坏。因为只要固定位置中的某一位发生变异,个体就可能不再属于该模式。
7.2 定义长度 \(\delta(s)\)
定义长度 \(\delta(s)\) 是第一个固定位置和最后一个固定位置之间的距离。对:
\[ s=(1** \ 0*1) \]
第一个固定位置是第 1 位,最后一个固定位置是第 6 位,因此:
\[ \delta(s)=6-1=5 \]
定义长度越大,模式跨越的范围越长,单点交叉越容易切断它。反过来,短模式更容易在交叉中被完整保留下来。
7.3 模式适应度 \(f(s)\)
模式适应度是所有匹配该模式的染色体的平均适应度。它不评价某一个具体个体,而是评价一类相似结构整体上是否有优势。若某个模式的平均适应度高于种群平均水平,那么选择会让它在后续世代中更常出现。
这也是遗传算法理论解释中的核心直觉:遗传算法通过选择让优秀个体增多,同时也隐含地让优秀个体所包含的高质量模式增多。
8. Schema Theorem:短、低阶、高适应度模式会增长
Schema Theorem(模式定理)通常被视为解释遗传算法能力的基础。它研究的是:某个模式 \(s\) 在第 \(t\) 代出现了 \(m(s,t)\) 次,那么在第 \(t+1\) 代中,它期望会出现多少次?
8.1 只考虑选择
设种群中个体 \(i\) 的选择概率为:
\[ p_i=\frac{f(i)}{\sum \limits_{j=1}^{n}f(j)} \]
若模式 \(s\) 的平均适应度为 \(f(s)\),种群平均适应度为 \(\bar f\),则只考虑选择时:
\[ E[m(s,t+1)] = m(s,t)\cdot \frac{f(s)}{\bar f} \]
这个公式非常直观:如果 \(f(s)>\bar f\),则 \(\frac{f(s)}{\bar f}>1\),该模式数量期望增加;如果 \(f(s)<\bar f\),则该模式数量期望减少。
进一步,如果:
\[ f(s)=(1+c)\bar f \]
则:
\[ E[m(s,t+1)] = m(s,t)(1+c) \]
持续多代后,模式数量会近似按指数增长:
\[ m(s,t)\approx m(s,0)(1+c)^t \]
这说明选择会放大高适应度模式。
8.2 加入交叉影响
交叉虽然能组合好结构,但也可能破坏一个模式。对长度为 \(l\) 的染色体,单点交叉的切点有 \(l-1\) 个。如果模式 \(s\) 的定义长度为 \(\delta(s)\),那么落在模式内部的切点越多,模式越容易被破坏。因此模式不被交叉破坏的概率至少为:
\[ p_s\ge 1-p_c\cdot \frac{\delta(s)}{l-1} \]
其中 \(p_c\) 是交叉概率。加入交叉后,模式数量期望为:
\[ E[m(s,t+1)] \ge m(s,t)\cdot \frac{f(s)}{\bar f} \cdot \left[ 1-p_c\cdot \frac{\delta(s)}{l-1} \right] \]
这个式子告诉我们:即使一个模式适应度高,如果它定义长度太长,也容易被交叉破坏;短模式更容易保留。
8.3 加入变异影响
变异会随机改变基因位。对模式 \(s\) 来说,只有固定位置需要保持不变,通配符位置怎么变都不影响是否属于该模式。如果模式阶数为 \(O(s)\),每个基因位变异概率为 \(p_m\),则模式不被变异破坏的概率是:
\[ p_s=(1-p_m)^{O(s)} \]
当 \(p_m\) 很小时,可以近似为:
\[ (1-p_m)^{O(s)}\approx 1-O(s)p_m \]
加入变异后得到模式定理的近似形式:
\[ E[m(s,t+1)] \ge m(s,t)\cdot \frac{f(s)}{\bar f} \cdot \left[ 1-p_c\cdot \frac{\delta(s)}{l-1}-O(s)p_m \right] \]
因此,能够在遗传算法中快速增长的模式通常具有三个特点:
- 适应度高于平均水平,这样选择会放大它。
- 定义长度短,这样交叉不容易切断它。
- 阶数低,这样变异不容易破坏它。
Schema Theorem 的核心结论是:short, low-order schemata with above-average fitness increase exponentially in successive generations。这句话是理论部分最重要的结论。
9. 概念辨析
9.1 适应度函数不一定等于目标函数
在简单问题中,适应度函数可以直接等于目标函数,例如最大化 \(f(x)=x^2\) 时,适应度就是 \(x^2\)。但在实际问题中,适应度函数往往还需要处理约束、惩罚、归一化或多目标权衡。例如背包问题中,如果某个方案超重,即使价值很高,也不能简单给它很高适应度。
9.2 交叉不是总能产生更好解
交叉只是重组父代结构,它可能产生更好子代,也可能产生更差子代。遗传算法依靠“生成大量候选 + 选择压力”来保留好的结果,而不是保证每次交叉都改进。
9.3 变异率不是越大越好
变异太小会导致多样性不足,算法可能早熟收敛;变异太大则会破坏选择和交叉积累的结构,使搜索接近随机抽样。因此,变异率通常设置得较小,并与种群大小、编码方式、问题复杂度一起调节。
9.4 编码方式要保持可行性
背包问题可以直接用二进制串,因为每一位自然表示“选或不选”。TSP 则更适合排列编码,因为路线必须包含每个城市且只包含一次。学习应用题时,首先要问:一个染色体如何对应一个合法解?遗传算子是否会破坏合法性?
9.5 模式定理解释的是趋势,不是精确预测
模式定理给的是期望意义上的增长趋势,而且依赖一些简化假设。它不能保证某个具体运行一定找到全局最优解,但它解释了遗传算法为什么倾向于保留并组合短的、有用的局部结构。
10. 总结
遗传算法是一种基于种群的随机优化方法,它通过选择、交叉和变异模拟自然进化。一个完整遗传算法必须明确四件事:如何编码候选解,如何初始化种群,如何计算适应度,以及如何通过遗传算子生成下一代。
\(f(x)=x^2\) 例子展示了遗传算法最基本的运行过程:先把 \(x\) 编码为二进制染色体,再计算每个个体的适应度,接着用轮盘赌选择让高适应度个体更容易进入下一代,最后通过交叉和变异产生新的候选解。
背包问题、CNF-SAT、TSP 和 PLA 进化硬件展示了遗传算法在不同问题中的表示方法。背包问题适合二进制选择编码;CNF-SAT 可以用布尔变量赋值编码,并用满足子句数作为适应度;TSP 使用排列编码,并需要专门的交叉和变异算子保证路线合法;PLA 可以把可编程连接点编码成二进制串,并用电路输出与目标真值表的匹配程度作为适应度。
理论上,Schema Theorem 说明遗传算法会放大那些短、低阶、适应度高于平均水平的模式。这个定理抓住了遗传算法的核心:算法表面上在进化完整个体,实际上也在隐含地发现、保留和组合有用的局部结构。