目录
- 逻辑在知识表示中的位置
- 命题逻辑:用真假命题描述世界
- 一阶谓词逻辑:表示对象、关系与量词
- 语义、模型与逻辑蕴含
- 推理规则与合一
- 逻辑推理案例:金融投资顾问
- 归结反证:把证明问题变成矛盾检测
- 子句形转换:归结推理的标准输入格式
- 归结推理的典型示例与答案抽取
- 归结策略、Herbrand 结构与语义树
- 其他逻辑系统:默认推理、模态逻辑与真值维护
- Horn 子句与 Prolog 的逻辑基础
- Prolog 程序执行:合一、回溯与搜索顺序
- Prolog 数据结构与典型程序
- 总结与参考
1 逻辑在知识表示中的位置
1.1 为什么知识表示需要逻辑
逻辑属于“知识表示基础”(Foundation of Knowledge Representation)的一部分。知识表示的基础可以分成三类:逻辑(Logics)、本体(Ontology)和计算理论(Theory of Computation)。其中逻辑负责回答一个最根本的问题:如果系统已经知道一些事实和规则,它怎样才能严格地推出新的结论?
例如,一个专家系统知道“所有人都会死”和“苏格拉底是人”,它应该能够推出“苏格拉底会死”。这个过程看似符合常识,但对于机器来说必须被形式化,否则系统就无法判断哪些结论是可靠的、哪些结论只是猜测。因此,逻辑在人工智能中的作用可以概括为两点:第一,它提供一种精确表示知识的语言;第二,它提供一套从已有知识推出新知识的推理规则。
1.2 逻辑学系统的五要素
“逻辑学系统五要素”可以看成理解这一部分的总纲。一个逻辑系统要能工作,必须先规定能用哪些记号写东西,再规定哪些表达式能表示对象、哪些表达式能判断真假,然后规定这些真假句子在什么情况下成立,最后规定怎样从已有句子推出新句子。这五个要素分别是:符号、项、语句、语义、推理。
| 要素 | 英文 | 作用 | 简单理解 |
|---|---|---|---|
| 符号 | Symbols | 提供逻辑语言的基本记号 | 逻辑系统的“字母表” |
| 项 | Terms | 表示论域中的对象 | 能指向某个东西的表达式 |
| 语句 | Sentences | 表示可以判真假的命题 | 能说“真/假”的完整表达式 |
| 语义 | Semantics | 解释符号和语句的含义 | 规定一个语句什么时候为真 |
| 推理 | Inference | 从已有语句推出新语句 | 规定怎样合法地证明结论 |
符号(Symbols)是逻辑系统允许使用的基本材料。在一阶逻辑中,符号包括常量符号 \(john,socrates,0\),变量符号 \(x,y,z\),函数符号 \(father,sum\),谓词符号 \(man,parent,greater\),逻辑符号 \(\land,\lor,\neg,\rightarrow,\forall,\exists\),以及括号、逗号等辅助符号。符号本身还不一定构成完整意义,它们更像搭建逻辑表达式的零件。
项(Terms)是用来指称对象的表达式。常量是项,变量是项,函数作用在项上得到的结果也是项。例如 \(john\)、\(x\)、\(father(john)\) 都是项。项本身不能判断真假,因为它只是表示“某个东西”。比如 \(father(john)\) 表示 John 的父亲这个对象,但它还不是一句命题。
语句(Sentences)是可以判断真假的完整表达式。比如 \(man(socrates)\) 表示“苏格拉底是人”,\(parent(john,mary)\) 表示“John 是 Mary 的父母”,它们都可以在某个解释下判定为真或假。语句还可以通过联结词和量词构成更复杂的表达式,例如:
\[ \forall x(man(x)\rightarrow mortal(x)) \]
这句话表示“所有人都会死”。因此,项和语句的区别非常关键:\(john\) 和 \(father(john)\) 是对象表达式,不能直接说真假;\(man(john)\) 和 \(parent(john,mary)\) 是语句,可以判断真假。
语义(Semantics)负责解释这些符号到底代表什么,以及语句什么时候为真。例如公式 \(parent(john,mary)\) 光看符号无法知道真假,必须给出解释:\(john\) 指哪个对象,\(mary\) 指哪个对象,\(parent(x,y)\) 表示什么关系。如果在这个解释下 John 确实是 Mary 的父母,那么该语句为真;否则为假。对于带量词的语句,语义还要规定变量在什么论域中取值。
推理(Inference)规定怎样从已有语句推出新语句。例如已知:
\[ \forall x(man(x)\rightarrow mortal(x)) \]
以及:
\[ man(socrates) \]
可以先通过全称实例化得到:
\[ man(socrates)\rightarrow mortal(socrates) \]
再通过假言推理推出:
\[ mortal(socrates) \]
这就是推理。后面的合一、归结反证和 Prolog,本质上都是在研究怎样把这种推理过程机械化。
一句话总结:符号规定能写什么,项表示对象,语句表示真假命题,语义规定命题什么时候为真,推理规定怎样从已有真命题推出新命题。
1.3 本章主线
本章的主线可以理解为从“表达能力较弱但简单”的逻辑,逐步走向“表达能力更强、并能用于程序执行”的逻辑系统。
| 层次 | 核心问题 | 代表内容 |
|---|---|---|
| 命题逻辑(Propositional Logic) | 命题整体是真是假 | 命题符号、联结词、真值表、等价式 |
| 一阶谓词逻辑(First-Order Logic) | 对象之间有什么关系 | 常量、变量、函数、谓词、量词、解释 |
| 自动推理(Automated Reasoning) | 怎样机械地证明结论 | 合一、子句形、归结反证 |
| 逻辑程序设计(Logic Programming) | 让逻辑规则直接作为程序运行 | Horn 子句、Prolog、回溯、cut |
阅读这一部分时,不应把这些内容看成孤立概念。命题逻辑提供基本真值语义,一阶谓词逻辑增加对象和量词,归结推理把一阶逻辑证明转化为可机械执行的步骤,而 Prolog 则把 Horn 子句上的归结推理实现成一种编程语言。
2 命题逻辑:用真假命题描述世界
2.1 命题逻辑的基本符号
命题逻辑(Propositional Logic)把世界描述为一组可以判定真假的命题。命题符号通常写作 \(P,Q,R,S,\dots\),每个符号代表一个完整陈述,例如“今天下雨”“地面是湿的”“灯是亮的”。命题逻辑不关心命题内部结构,只关心整个命题的真假。
命题逻辑中常用的符号如下。
| 符号 | 英文 | 中文含义 | 直观解释 |
|---|---|---|---|
| \(true,false\) | truth symbols | 真值符号 | 表示真或假 |
| \(\land\) | conjunction | 合取/与 | 两边都真才真 |
| \(\lor\) | disjunction | 析取/或 | 至少一边真就真 |
| \(\neg\) | negation | 否定/非 | 真变假,假变真 |
| \(\rightarrow\) | implication | 蕴含/如果则 | 前件真而后件假时才假 |
| \(\equiv\) | equivalence | 等价 | 两边在所有解释下真值相同 |
这里的“命题演算句子”(propositional calculus sentences)其实就是合法公式。合法公式也称为合式公式(well-formed formula, WFF)。例如 \(P\)、\(\neg P\)、\(P\land Q\)、\(P\lor \neg Q\)、\(P\rightarrow Q\) 都是合式公式;而 \(P\land\) 或 \(\rightarrow Q\) 不是合式公式,因为符号组合不完整。
2.2 命题逻辑的语义
命题逻辑的语义来自解释(interpretation)。一个解释就是给每个命题符号分配一个真值。例如,如果 \(P\) 表示“下雨”,\(Q\) 表示“地面湿”,那么一个解释可以是 \(P=true,Q=false\),表示“下雨但地面不湿”。
在给定解释之后,复合公式的真假由联结词决定。否定 \(\neg P\) 的真值与 \(P\) 相反;合取 \(P\land Q\) 只有在 \(P\) 和 \(Q\) 都为真时才为真;析取 \(P\lor Q\) 只有在 \(P\) 和 \(Q\) 都为假时才为假;蕴含 \(P\rightarrow Q\) 只有在 \(P\) 为真且 \(Q\) 为假时才为假。
蕴含最容易混淆。\(P\rightarrow Q\) 读作“如果 \(P\),那么 \(Q\)”。它不是说 \(P\) 一定发生,也不是说 \(Q\) 一定由 \(P\) 造成,而是说“不允许出现 \(P\) 真而 \(Q\) 假的情况”。例如:
\[ \text{It has rained}\rightarrow \text{Ground is wet} \]
这个公式在“下雨且地面不湿”时为假,在其他情况下都为真。特别是如果没有下雨,无论地面是否湿,整个蕴含式在经典逻辑中都为真。这种现象叫作空真(vacuous truth),是理解蕴含真值表时的关键。
2.3 常用逻辑等价式
逻辑等价表示两个公式在所有可能解释下真值都相同。常用等价式如下,它们在后面“化为子句形”时会反复使用。
| 等价式 | 名称 | 用途 |
|---|---|---|
| \(\neg(\neg P)\equiv P\) | 双重否定律 | 消去连续否定 |
| \(P\lor Q\equiv \neg P\rightarrow Q\) | 蕴含与析取转换 | 把蕴含改写为析取 |
| \(P\rightarrow Q\equiv \neg Q\rightarrow \neg P\) | 逆否律(Contrapositive Law) | 证明蕴含时常用 |
| \(\neg(P\lor Q)\equiv \neg P\land \neg Q\) | 德摩根律(De Morgan’s Law) | 将否定向内推进 |
| \(\neg(P\land Q)\equiv \neg P\lor \neg Q\) | 德摩根律 | 将否定向内推进 |
| \(P\lor Q\equiv Q\lor P\) | 交换律 | 调整公式顺序 |
| \(P\land Q\equiv Q\land P\) | 交换律 | 调整公式顺序 |
| \((P\lor Q)\lor R\equiv P\lor(Q\lor R)\) | 结合律 | 去掉括号、重组表达式 |
| \((P\land Q)\land R\equiv P\land(Q\land R)\) | 结合律 | 去掉括号、重组表达式 |
| \(P\lor(Q\land R)\equiv(P\lor Q)\land(P\lor R)\) | 分配律 | 转换为合取范式 |
| \(P\land(Q\lor R)\equiv(P\land Q)\lor(P\land R)\) | 分配律 | 转换为析取范式 |
例如,可以证明:
\[ (\neg P\lor Q)\equiv(P\rightarrow Q) \]
这说明“如果 \(P\) 则 \(Q\)”可以等价改写成“不是 \(P\),或者 \(Q\)”。后面做归结时必须把蕴含 \(\rightarrow\) 消掉,所以这个等价式非常重要。
3 一阶谓词逻辑:表示对象、关系与量词
3.1 为什么命题逻辑不够用
命题逻辑只能把整句话当成一个不可拆分的符号。比如“苏格拉底是人”和“苏格拉底会死”可以分别写成 \(P\) 和 \(Q\),但命题逻辑看不出“苏格拉底”是对象,看不出“人”是一个集合,看不出“苏格拉底”属于“人”这个集合;也看不出“是人”和“会死”是性质。这样一来,系统就很难表达“所有人都会死”这种带变量的通用规则。
一阶谓词逻辑(First-Order Logic, FOL)正是为了解决这个问题。它允许我们表示对象、对象属性、对象之间的关系,以及“所有”“存在”这样的量词。例如:
\[ \forall x(man(x)\rightarrow mortal(x)) \]
表示“对所有对象 \(x\),如果 \(x\) 是人,那么 \(x\) 会死”。再加上事实:
\[ man(Socrates) \]
系统就可以推出:
\[ mortal(Socrates) \]
3.2 一阶逻辑的符号与项
一阶逻辑的基本元素包括常量、变量、函数、谓词和逻辑联结词。
| 元素 | 英文 | 示例 | 作用 |
|---|---|---|---|
| 常量/常元(constant) | constant symbol | \(Socrates, John, 0,\pi\) | 表示领域中的具体对象 |
| 变量/变元(variable) | variable symbol | \(x,y,z\) | 表示可被对象替换的位置 |
| 函数/函元(function) | function symbol | \(father(x), sum(x,y)\) | 从对象映射到对象 |
| 谓词(predicate) | predicate symbol | \(man(x), parent(x,y)\) | 表示性质或关系,真值为真或假 |
| 项(term) | term | \(John, x, 0, father(John)\) | 能指称对象的表达式 |
zxq:更专业的叫法应该是“常元”“变元”“函元”
常元、变元、函元都可以是项
在这里,函数和谓词都带有元数(arity)。元数表示它需要几个参数。例如 \(father(x)\) 是一元函数,\(sum(x,y)\) 是二元函数;\(man(x)\) 是一元谓词,\(parent(x,y)\) 是二元谓词。
需要注意的是,函数和谓词虽然长得很像,但语义完全不同。函数返回一个对象,例如 \(mother(bill)\) 可以表示“Bill 的母亲”这个对象;谓词返回真假,例如 \(mother(eve,abel)\) 表示“Eve 是 Abel 的母亲”这个关系是否成立。
3.3 原子句子与复合句子
原子句子(atomic sentence)是最小的可判真假的句子,通常由一个谓词加若干项构成。例如:
\[ father(adam,abel) \]
表示 “Adam 是 Abel 的父亲”。如果谓词元数为 \(n\),那么它后面必须跟 \(n\) 个项,例如 \(p(t_1,t_2,\dots,t_n)\)。真值符号 \(true\) 和 \(false\) 也可以看成原子句子。
复合句子由原子句子通过联结词和量词组合而来。构造规则可以总结为:原子句子是句子;如果 \(s\) 是句子,则 \(\neg s\) 是句子;如果 \(s_1,s_2\) 是句子,则 \(s_1\land s_2\)、\(s_1\lor s_2\)、\(s_1\rightarrow s_2\)、\(s_1\equiv s_2\) 都是句子;如果 \(x\) 是变量且 \(s\) 是句子,则 \(\forall x\,s\) 和 \(\exists x\,s\) 也是句子。
3.4 量词:全称与存在
一阶逻辑最重要的扩展是量词。
全称量词(universal quantifier)\(\forall\) 表示“对所有对象都成立”。例如: \[ \forall x(basketball\_player(x)\rightarrow tall(x)) \]
表示“所有篮球运动员都高”。这个句子要用蕴含而不是合取,因为我们并不是说“所有对象都是篮球运动员且都高”,而是说“只要某个对象是篮球运动员,它就高”。
存在量词(existential quantifier)\(\exists\) 表示“至少存在一个对象使句子成立”。例如: \[ \exists x(person(x)\land likes(x,anchovies)) \]
表示“有些人喜欢凤尾鱼”。这个句子要用合取而不是蕴含,因为我们要断言存在某个对象同时满足“是人”和“喜欢凤尾鱼”。如果写成 \(\exists x(person(x)\rightarrow likes(x,anchovies))\),在许多解释下会因为 \(person(x)\) 为假而空真,不能正确表达“有人喜欢凤尾鱼”。
3.5 一阶逻辑表达实例
自然语言到谓词逻辑的翻译例子,可以用来检查自己是否真正理解量词和联结词的搭配。
| 自然语言 | 谓词逻辑表达 | 说明 |
|---|---|---|
| 如果星期一不下雨,Tom 会去山里 | \(\neg weather(rain,monday)\rightarrow go(tom,mountains)\) | 条件规则用蕴含 |
| Emma 是杜宾犬并且是好狗 | \(gooddog(emma)\land isa(emma,doberman)\) | 同时满足两个性质用合取 |
| 所有篮球运动员都高 | \(\forall x(basketball\_player(x)\rightarrow tall(x))\) | 全称规则常用蕴含 |
| 有些人喜欢凤尾鱼 | \(\exists x(person(x)\land likes(x,anchovies))\) | 存在对象常用合取 |
| 没有人喜欢税 | \(\neg\exists x(likes(x,taxes))\) | “没有”可表示为“不存在” |
3.6 一阶与高阶的区别
一阶谓词逻辑只允许量词作用于论域中的对象,而不能作用于谓词或函数。例如:
\[ \forall x(man(x)\rightarrow mortal(x)) \]
这里 \(x\) 表示对象,所以是一阶逻辑。相反,如果写成:
\[ \forall P\,P(george,kate) \]
其中 \(P\) 是谓词变量,这就进入了高阶谓词逻辑(Higher-Order Predicate Logic)。高阶逻辑表达能力更强,但自动推理通常更困难,很多性质不再像一阶逻辑那样可控。
4 语义、模型与逻辑蕴含
4.1 解释:符号如何获得意义
一阶逻辑公式本身只是符号串。要判断它是真是假,必须给这些符号指定含义,这就是解释(interpretation)。这里定义:给定一个非空论域 \(D\),解释会把常量、变量、函数和谓词都映射到 \(D\) 或 \(D\) 上的结构。
更具体地说,常量被指定为 \(D\) 中的某个元素;变量的取值来自 \(D\);\(m\) 元函数被解释为从 \(D^m\) 到 \(D\) 的映射;\(n\) 元谓词被解释为从 \(D^n\) 到 \(\{true,false\}\) 的映射。这个定义非常重要,因为它说明逻辑公式的真假不是由符号名字决定的,而是由解释决定的。
例如,\(parent(adam,cain)\) 是否为真,取决于解释中 \(adam\) 和 \(cain\) 分别指向谁,以及 \(parent\) 这个二元谓词被解释成什么关系。如果解释把 \(parent\) 定义为“亲生父母关系”,且 Adam 确实是 Cain 的父亲,那么该原子句子为真。
4.2 满足、模型、可满足、有效与不一致
几个语义概念很容易混淆,需要放在一起区分。
| 概念 | 英文 | 含义 |
|---|---|---|
| 满足 | satisfy | 如果公式 \(x\) 在解释 \(I\) 和某个变量赋值下为真,则 \(I\) 满足 \(x\) |
| 模型 | model | 如果解释 \(I\) 在所有相关变量赋值下都满足公式或公式集,则 \(I\) 是其模型 |
| 可满足 | satisfiable | 存在至少一个解释和变量赋值使公式或公式集为真 |
| 不可满足 | unsatisfiable | 不存在任何解释和变量赋值使其为真 |
| 不一致 | inconsistent | 一个公式集不可满足,即无法同时为真 |
| 有效 | valid | 对所有可能解释都为真 |
下面用一组简单例子把这些概念区分开。假设论域:
\[ D=\{john,mary\} \]
并且解释 \(I\) 中,\(john\) 表示 John,\(mary\) 表示 Mary,谓词 \(Student(x)\) 表示“\(x\) 是学生”。在这个解释下,如果 John 是学生,那么:
\[ Student(john) \]
为真。此时可以说解释 \(I\) 满足(satisfy)公式 \(Student(john)\)。满足强调的是:在某个解释和变量赋值下,这个公式被判定为真。
如果在同一个解释 \(I\) 中,论域里的所有人都是学生,也就是 John 和 Mary 都是学生,那么:
\[ \forall x\,Student(x) \]
在 \(I\) 下为真。此时 \(I\) 就是公式 \(\forall x\,Student(x)\) 的一个模型(model)。模型比满足更强一些,它通常强调某个解释能让一个公式或一个公式集整体成立。对于带自由变量的公式,还要考虑相关变量赋值;对于闭合语句,则直接看该解释下是否为真。
可满足(satisfiable)表示至少存在一个解释能让公式为真。例如:
\[ \exists x\,Student(x) \]
是可满足的,因为只要存在某个解释使论域中至少一个对象是学生,它就为真。比如上面的解释里 John 是学生,那么这个公式就成立。注意,可满足不要求公式在所有解释下都真,只要求“有一种世界能让它真”。
不可满足(unsatisfiable)表示无论怎么解释都不可能为真。例如:
\[ \exists x(Student(x)\land \neg Student(x)) \]
不可满足,因为它要求某个对象同时是学生且不是学生,这在经典逻辑中不可能成立。
不一致(inconsistent)通常用于公式集。如果一个公式集无法在任何解释下同时为真,就说它不一致。例如公式集:
\[ \{Student(john),\neg Student(john)\} \]
是不一致的,因为它同时要求 \(Student(john)\) 为真和为假。也就是说,不一致可以理解为“整个知识库内部发生矛盾”。
有效(valid)表示公式在所有可能解释下都为真。例如:
\[ Student(john)\lor \neg Student(john) \]
是有效式,因为无论 John 是不是学生,这个析取式都为真。有效比可满足强得多:可满足只要求至少有一个解释为真,而有效要求每一个解释都为真。
这几个概念可以用一句话串起来:有效公式一定可满足,但可满足公式不一定有效;不可满足公式没有任何模型;如果一个公式集不可满足,就称为不一致。
4.2.1 例子
下面两个公式可以说明“解释、模型和推理”之间的关系:
\[ \neg A(x)\lor B(x) \]
\[ \neg B(x)\lor C(x) \]
它们分别等价于:
\[ A(x)\rightarrow B(x) \]
\[ B(x)\rightarrow C(x) \]
也就是说,第一个公式表示“如果某个对象满足 \(A\),那么它也满足 \(B\)”;第二个公式表示“如果某个对象满足 \(B\),那么它也满足 \(C\)”。把它们连起来,直觉上可以推出:
\[ A(x)\rightarrow C(x) \]
因为 \(A\) 会推出 \(B\),而 \(B\) 又会推出 \(C\)。
可以列出三个解释来练习判断。按这种列举式写法理解:列出的正文字表示为真,列出的负文字表示为假,未列出的相关基原子通常按“不成立/假”来检查(封闭世界假设)。
| 解释 | 给出的事实 | 是否能作为两个公式的模型 |
|---|---|---|
| Interpretation 1 | \(A(a),A(b),B(b),\neg C(a)\) | 不能。因为若 \(A(a)\) 为真,则按第一条应有 \(B(a)\);若 \(B(b)\) 为真,则按第二条应有 \(C(b)\)。在列举式解释下,\(B(a)\) 和 \(C(b)\) 不成立,因此它违反规则。 |
| Interpretation 2 | \(A(a),A(b),B(a),\neg B(b),\neg C(a),\neg C(b)\) | 不能。因为 \(A(b)\) 为真但 \(B(b)\) 为假,直接违反 \(A(x)\rightarrow B(x)\);同时 \(B(a)\) 为真但 \(C(a)\) 为假,违反 \(B(x)\rightarrow C(x)\)。 |
| Interpretation 3 | \(A(a),B(a),C(a)\) | 可以看成一个满足规则链的解释。对于对象 \(a\),\(A(a)\)、\(B(a)\)、\(C(a)\) 都成立,因此 \(A(a)\rightarrow B(a)\) 和 \(B(a)\rightarrow C(a)\) 都成立。 |
这个例子的重点不是记住三个 interpretation,而是理解判断模型的方法:把变量 \(x\) 替换成论域中的对象,然后检查每条规则有没有被违反。 对于 \(A(x)\rightarrow B(x)\),唯一会违反它的情况是 \(A(x)\) 为真但 \(B(x)\) 为假;对于 \(B(x)\rightarrow C(x)\),唯一会违反它的情况是 \(B(x)\) 为真但 \(C(x)\) 为假。
4.2.2 The Oedipus
The Oedipus 的人物关系图可以把“解释”和“推理”放到一个具体场景中理解。图中涉及的人物可以看成论域中的对象:
\[ D=\{Iokaste,Oedipus,Polyneikes,Thersandros\} \]
图中的关系和性质可以表示为:
\[ hasChild(Iokaste,Oedipus) \]
\[ hasChild(Oedipus,Polyneikes) \]
\[ hasChild(Polyneikes,Thersandros) \]
\[ Patricide(Oedipus) \]
\[ \neg Patricide(Thersandros) \]
其中 \(hasChild(x,y)\) 是二元谓词,表示“\(x\) 有孩子 \(y\)”;\(Patricide(x)\) 是一元谓词,表示“\(x\) 是弑父者”。这个例子说明,解释 \(I\) 会把常元 \(Iokaste,Oedipus,Polyneikes,Thersandros\) 指向论域中的具体对象,把 \(hasChild\) 解释为论域上的二元关系,把 \(Patricide\) 解释为论域上的一元性质集合。
【图片占位:这里的 The Oedipus 人物关系图,可替换为 这里对应图片。】
需要注意的是,仅有上面这些事实时,我们只能知道图中明确给出的关系,例如 Oedipus 是弑父者、Thersandros 不是弑父者。不能仅凭血缘关系自动推出 Polyneikes 或 Thersandros 是否是弑父者,因为这需要额外规则。例如如果人为加入规则:
\[ \forall x\forall y(hasChild(x,y)\land Patricide(x)\rightarrow Patricide(y)) \]
才表示“弑父者的孩子也是弑父者”。但这条规则显然不符合常识,而且会和 \(\neg Patricide(Thersandros)\) 这类事实产生潜在冲突。因此,The Oedipus 图的重点是提醒我们:事实、解释和推理规则是不同层面的东西;图中有事实,不等于系统可以随意继承性质或推出新事实。
4.3 逻辑蕴含
逻辑蕴含(logical consequence / logically follows)描述的是“结论是否必然由前提推出”。如果每一个满足公式集 \(S\) 的解释也满足公式 \(x\),那么就说 \(x\) 从 \(S\) 逻辑推出,记作:
\[ S\models x \]
这里的重点是“每一个模型”。如果只是在某个解释下 \(S\) 和 \(x\) 都为真,这还不够。只有当所有使 \(S\) 为真的世界都使 \(x\) 为真时,\(x\) 才是 \(S\) 的必然结论。
例如,给定:
\[ \forall x(man(x)\rightarrow mortal(x)) \]
以及:
\[ man(Socrates) \]
在任何满足这两个前提的解释中,\(mortal(Socrates)\) 都必须为真。因此:
\[ \{\forall x(man(x)\rightarrow mortal(x)),man(Socrates)\}\models mortal(Socrates) \]
5 推理规则与合一
5.1 证明过程、可靠性与完备性
证明过程(proof procedure)可以理解为“推理规则 + 应用该规则的算法”。推理规则告诉我们什么形式的句子可以推出什么形式的新句子;算法则决定在大量句子中按什么顺序应用这些规则。
评价一个推理过程有两个核心标准:可靠性(soundness)和完备性(completeness)。可靠性表示推理规则不会推出不该推出的结论,也就是说,如果规则从 \(S\) 推出 \(x\),那么 \(S\models x\)。完备性表示凡是逻辑上能推出的结论,规则最终都能推出,也就是说,如果 \(S\models x\),那么推理过程有能力得到 \(x\)。
一句话记忆:可靠性防止“乱推出”,完备性防止“漏推出”。
5.2 常用推理规则
一组基础推理规则如下,它们是理解自动推理的入口。
| 推理规则 | 形式 | 解释 |
|---|---|---|
| 假言推理(Modus Ponens) | \(P,\;P\rightarrow Q\vdash Q\) | 如果 \(P\) 真且 \(P\) 蕴含 \(Q\),则 \(Q\) 真 |
| 拒取式(Modus Tollens) | \(P\rightarrow Q,\;\neg Q\vdash \neg P\) | 如果 \(P\) 会导致 \(Q\),但 \(Q\) 不真,则 \(P\) 不真 |
| 合取消去(Elimination) | \(P\land Q\vdash P\),\(P\land Q\vdash Q\) | 从合取式中取出任一部分 |
| 合取引入(Introduction) | \(P,Q\vdash P\land Q\) | 两个事实都真时,可合成合取式 |
| 全称实例化(Universal Instantiation) | \(\forall xP(x)\vdash P(a)\) | 全称命题可替换为任意具体对象 |
这里 \(\vdash\) 是推导出 / 可证明的意思。例如,苏格拉底例子的推理过程是:先用全称实例化把 \(\forall x(man(x)\rightarrow mortal(x))\) 中的 \(x\) 替换成 \(Socrates\),得到:
\[ man(Socrates)\rightarrow mortal(Socrates) \]
再结合事实 \(man(Socrates)\),用假言推理推出:
\[ mortal(Socrates) \]
5.3 合一:让两个表达式匹配
在一阶逻辑推理中,规则往往带变量,而事实往往带具体对象。为了让它们能够匹配,需要使用合一(Unification)。合一的目标是找到一组替换,使两个表达式变成相同形式。
例如:
\[ man(x) \]
与:
\[ man(Socrates) \]
可以通过替换 \(\{Socrates/x\}\) 合一。这里 \(\{Socrates/x\}\) 表示把变量 \(x\) 替换成常量 \(Socrates\)。
合一中最重要的是最一般合一(most general unifier, MGU)。MGU 是“最不具体、保留最大自由度”的替换。这里的定义可以理解为:如果 \(g\) 是 MGU,那么任何其他能让表达式合一的替换 \(s\),都可以看成先应用 \(g\),再额外应用某个更具体的替换 \(s'\)。
合一有几条关键约束。常量是基实例(ground instance),不能被替换;同一个变量在所有出现位置必须一致替换;一个变量不能与包含自身的项合一,例如 \(x\) 不能与 \(f(x)\) 合一,否则会产生无限结构;两个不同常量不能合一,例如 \(john\) 和 \(mary\) 不能合一。
5.4 合一例子
一个合一例子是:
\[ parents(x,father(x),mother(bill)) \]
和:
\[ parents(bill,father(bill),y) \]
要让两个表达式相同,首先第一个参数要求 \(x=bill\),因此得到替换 \(\{bill/x\}\)。替换后左式变为:
\[ parents(bill,father(bill),mother(bill)) \]
此时第三个参数要求 \(y=mother(bill)\),于是得到:
\[ \{mother(bill)/y\} \]
最终的 MGU 为:
\[ \{bill/x,\;mother(bill)/y\} \]
这个例子说明,合一不是简单地逐字符比较,而是在保持变量一致性的前提下寻找最一般替换。
6 逻辑推理案例:金融投资顾问
6.1 问题设定
逻辑金融顾问(logic-based financial advisor)可以说明一阶逻辑如何支持专家系统推理。系统要根据用户储蓄、收入和家庭负担,判断用户应该把资金投入储蓄账户、股票市场,还是二者组合。
规则的直觉如下:如果一个人的储蓄不足,应优先增加储蓄;如果储蓄充足且收入充足,可以考虑股票;如果储蓄充足但收入不足,可以考虑把剩余收入分配到储蓄和股票之间。
6.2 规则形式化
这里的高层投资建议规则可以写成:
\[ savings\_account(inadequate)\rightarrow investment(savings) \]
\[ savings\_account(adequate)\land income(adequate)\rightarrow investment(stocks) \]
\[ savings\_account(adequate)\land income(inadequate)\rightarrow investment(combination) \]
判断储蓄是否充足和收入是否充足,还需要更底层规则。设 \(minsavings(y)=5000\times y\),\(minincome(y)=15000+4000\times y\),其中 \(y\) 是赡养人数。若已存金额 \(x\) 大于最低储蓄需求,则储蓄充足;若稳定收入 \(x\) 大于最低收入需求,则收入充足;否则收入或储蓄不足。
6.3 推理过程
已知事实是:
\[ amount\_saved(22000) \]
\[ earnings(25000,steady) \]
\[ dependents(3) \]
先判断收入。对于 \(3\) 个赡养者:
\[ minincome(3)=15000+4000\times3=27000 \]
由于 \(25000<27000\),所以收入不足,可推出:
\[ income(inadequate) \]
再判断储蓄:
\[ minsavings(3)=5000\times3=15000 \]
由于 \(22000>15000\),所以储蓄充足,可推出:
\[ savings\_account(adequate) \]
最后使用投资建议规则:
\[ savings\_account(adequate)\land income(inadequate)\rightarrow investment(combination) \]
得到:
\[ investment(combination) \]
这个例子体现了专家系统推理的典型结构:底层事实先触发中间判断,中间判断再触发最终建议。逻辑表示的好处是每一步推理都有明确依据,系统可以解释“为什么建议组合投资”。
7 归结反证:把证明问题变成矛盾检测
7.1 归结反证的基本思想
归结反证(resolution refutation)是一种非常重要的自动推理方法。它不直接证明目标 \(G\),而是把目标的否定 \(\neg G\) 加入知识库,然后尝试推出矛盾。如果知识库 \(S\) 加上 \(\neg G\) 不可满足,就说明 \(S\) 必然推出 \(G\)。
其逻辑依据是:
\[ S\models G \quad \text{当且仅当} \quad S\cup\{\neg G\}\text{ 不可满足} \]
因此,归结证明的目标是推出空子句(empty clause),通常写作 \(\square\)。空子句表示矛盾,因为它不包含任何可满足的文字。
7.2 归结反证步骤
归结反证流程可以整理为:
- 将前提或公理转化为子句形(clause form)。
- 将待证明目标取反,也转化为子句形,并加入子句集合。
- 在子句之间进行归结,产生新的逻辑后承子句。
- 如果最终产生空子句 \(\square\),说明出现矛盾,目标得证。
- 若目标含变量,归结过程中使用的替换可以用于抽取答案。
归结规则的核心是消去一对互补文字。例如两个子句:
\[ P\lor A \]
和:
\[ \neg P\lor B \]
可以归结得到:
\[ A\lor B \]
在一阶逻辑中,\(P\) 和 \(\neg P\) 不必字面完全相同,只要它们能通过合一变成互补形式即可。
7.3 狗与死亡例子
这里的例子是:
所有狗都是动物:
\[ \forall x(dog(x)\rightarrow animal(x)) \]
所有动物都会死:
\[ \forall y(animal(y)\rightarrow die(y)) \]
Fido 是狗:
\[ dog(fido) \]
问题是 Fido 是否会死,即证明:
\[ die(fido) \]
先转为子句形:
\[ \neg dog(x)\lor animal(x) \]
\[ \neg animal(y)\lor die(y) \]
\[ dog(fido) \]
再加入目标否定:
\[ \neg die(fido) \]
归结过程可以理解为:第一条和第二条归结(正文字和负文字可以消掉),得到 \(\neg dog(y)\lor die(y)\);再与 \(dog(fido)\) 归结,得到 \(die(fido)\);最后与 \(\neg die(fido)\) 归结,得到空子句 \(\square\)。因此,Fido 会死。
这个例子展示了归结反证的本质:证明目标等价于证明“目标不成立”会导致矛盾。
8 子句形转换:归结推理的标准输入格式
8.1 什么是子句形
归结推理要求输入是子句(clause),也就是若干文字的析取。文字(literal)是原子公式或其否定。例如:
\[ \neg dog(x)\lor animal(x) \]
就是一个子句。多个子句的集合整体可以看成合取范式(conjunctive normal form, CNF),即“多个析取子句的合取”。
可以用一个复杂公式演示如何把任意一阶逻辑公式转成子句形。重点不是记住该公式本身,而是理解转换步骤。
8.2 子句形转换步骤
子句形转换一般分九步。下面这个公式可以贯穿演示整个过程:
\[ \forall x\Big(([a(x)\land b(x)]\rightarrow[c(x,i)\land \exists y\exists z(c(y,z)\rightarrow d(x,y))])\Big)\lor \forall x\,e(x) \]
这个公式看起来很复杂,但转换目标很明确:把它变成“若干个子句的集合”。也就是说,最后每个子句都只是一串文字的析取,方便后续做归结推理。
第一步:消去蕴含
归结推理不直接处理 \(\rightarrow\),所以第一步要把所有蕴含消掉。使用的等价式是:
\[ a\rightarrow b\equiv \neg a\lor b \]
本例中有两个蕴含:外层的 \([a(x)\land b(x)]\rightarrow[\cdots]\),以及内层的 \(c(y,z)\rightarrow d(x,y)\)。消去后得到:
\[ \forall x\Big(\neg[a(x)\land b(x)]\lor[c(x,i)\land \exists y\exists z(\neg c(y,z)\lor d(x,y))]\Big)\lor \forall x\,e(x) \]
第二步:将否定向内推进
第二步要把否定号推到最里面,使 \(\neg\) 只作用于原子公式。常用规则包括:
\[ \neg\neg a\equiv a \]
\[ \neg\exists x\,a(x)\equiv \forall x\,\neg a(x) \]
\[ \neg\forall x\,a(x)\equiv \exists x\,\neg a(x) \]
\[ \neg(a\land b)\equiv \neg a\lor \neg b \]
\[ \neg(a\lor b)\equiv \neg a\land \neg b \]
本例中主要用到的是德摩根律:
\[ \neg[a(x)\land b(x)]\equiv \neg a(x)\lor \neg b(x) \]
因此公式变为:
\[ \forall x\Big((\neg a(x)\lor \neg b(x))\lor[c(x,i)\land \exists y\exists z(\neg c(y,z)\lor d(x,y))]\Big)\lor \forall x\,e(x) \]
第三步:变量标准化
不同量词绑定的变量即使名字相同,也应改成不同名字。例如:
\[ \forall x\,a(x)\lor \forall x\,b(x) \]
应改写为:
\[ \forall x\,a(x)\lor \forall y\,b(y) \]
这样可以避免后续移动量词时发生变量名冲突。
本例中,左边公式已经有一个 \(\forall x\),右边又有一个 \(\forall x\,e(x)\)。这两个 \(x\) 不是同一个变量,只是名字撞了,所以要把右边的 \(x\) 改名为 \(w\):
\[ \forall x\Big((\neg a(x)\lor \neg b(x))\lor[c(x,i)\land \exists y\exists z(\neg c(y,z)\lor d(x,y))]\Big)\lor \forall w\,e(w) \]
第四步:前束化
前束化(prenex form)就是把所有量词移动到公式最左侧,同时保持它们相对顺序不变。移动后,公式主体里不再夹杂量词:
\[ \forall x\exists y\exists z\forall w\Big((\neg a(x)\lor \neg b(x))\lor[c(x,i)\land(\neg c(y,z)\lor d(x,y))]\lor e(w)\Big) \]
第五步:Skolem 化,消去存在量词
Skolem 化(Skolemization)用于消去存在量词。如果存在变量不依赖任何全称变量,就用新的 Skolem 常量替代;如果它出现在某些全称变量作用域内,就用这些全称变量的 Skolem 函数替代。例如:
\[ \forall x\exists y\,mother(x,y) \]
可以变成:
\[ \forall x\,mother(x,m(x)) \]
这里 \(m(x)\) 表示“与 \(x\) 有关的某个母亲对象”。再如:
\[ \forall x\forall y\exists z\forall w\,foo(x,y,z,w) \]
可以变成:
\[ \forall x\forall y\forall w\,foo(x,y,f(x,y),w) \]
在本例中,\(\exists y\) 和 \(\exists z\) 都出现在 \(\forall x\) 之后、\(\forall w\) 之前,因此 \(y,z\) 只依赖于 \(x\),不依赖于 \(w\)。所以可以用两个 Skolem 函数 \(f(x)\) 和 \(g(x)\) 替换它们:
\[ \forall x\forall w\Big((\neg a(x)\lor \neg b(x))\lor[c(x,i)\land(\neg c(f(x),g(x))\lor d(x,f(x)))]\lor e(w)\Big) \]
这里 \(f(x)\) 表示“对每个 \(x\) 存在的某个 \(y\)”,\(g(x)\) 表示“对每个 \(x\) 存在的某个 \(z\)”。它们不是原本就存在的函数,而是 Skolem 化时引入的新符号。
第六步:删除全称量词
经过 Skolem 化后只剩全称变量。在子句形中,所有变量默认都是全称量化的,所以可以直接删除 \(\forall x\forall w\):
\[ (\neg a(x)\lor \neg b(x))\lor[c(x,i)\land(\neg c(f(x),g(x))\lor d(x,f(x)))]\lor e(w) \]
第七步:转成合取范式
第七步利用结合律和分配律,把公式转成合取范式(CNF),也就是“若干析取式之间用 \(\land\) 连接”。核心规则是:
\[ a\lor(b\land c)\equiv(a\lor b)\land(a\lor c) \]
本例中,令:
\[ A=\neg a(x)\lor \neg b(x) \]
则公式可以看成:
\[ A\lor[c(x,i)\land(\neg c(f(x),g(x))\lor d(x,f(x)))]\lor e(w) \]
把 \(\lor\) 分配到 \(\land\) 里面,得到:
\[ [\neg a(x)\lor \neg b(x)\lor c(x,i)\lor e(w)]\land [\neg a(x)\lor \neg b(x)\lor \neg c(f(x),g(x))\lor d(x,f(x))\lor e(w)] \]
第八步:拆成单独子句
合取范式中的每个合取项都可以单独看成一个子句。因此本例得到两个子句:
\[ \neg a(x)\lor \neg b(x)\lor c(x,i)\lor e(w) \]
\[ \neg a(x)\lor \neg b(x)\lor \neg c(f(x),g(x))\lor d(x,f(x))\lor e(w) \]
第九步:再次标准化变量
不同子句中的变量默认是相互独立的,因此应把不同子句中的变量改成不同名字,以免归结时错误地把它们当成同一个变量。本例中可以保留第一个子句的 \(x,w\),把第二个子句的 \(x,w\) 改成 \(u,v\):
\[ \neg a(x)\lor \neg b(x)\lor c(x,i)\lor e(w) \]
\[ \neg a(u)\lor \neg b(u)\lor \neg c(f(u),g(u))\lor d(u,f(u))\lor e(v) \]
这两个子句就是原公式转换后的子句形。后续归结推理就可以在这些子句之间寻找互补文字,并通过合一消去它们。
8.3 Skolem 化的理解
Skolem 化容易被误解为“随便造一个函数”。更准确地说,它是在保持可满足性意义下,用一个新符号代表“存在的某个对象”。如果公式是 \(\exists x\,P(x)\),可以用一个新常量 \(c\) 表示那个存在对象,得到 \(P(c)\)。如果公式是 \(\forall x\exists y\,P(x,y)\),\(y\) 可能随 \(x\) 不同而不同,所以不能用固定常量,而要用函数 \(f(x)\) 表示“由 \(x\) 决定的某个 \(y\)”,得到 \(\forall x\,P(x,f(x))\)。
因此,Skolem 化通常不保持原公式的逻辑等价,但保持可满足性。这对归结反证足够,因为归结关心的是公式集是否不可满足。
9 归结推理的典型示例与答案抽取
9.1 快乐学生例子
这里的故事是:任何通过历史练习并中彩票的人是快乐的;任何学习或幸运的人都能通过所有练习;John 没有学习但很幸运;任何幸运的人都会中彩票。问题是 John 是否快乐。
形式化后,关键子句包括:
\[ \neg pass(x,history)\lor \neg win(x,lottery)\lor happy(x) \]
\[ \neg study(y)\lor pass(y,z) \]
\[ \neg lucky(w)\lor pass(w,v) \]
\[ \neg study(john) \]
\[ lucky(john) \]
\[ \neg lucky(u)\lor win(u,lottery) \]
目标是证明 \(happy(john)\),所以加入:
\[ \neg happy(john) \]
归结过程:由 \(lucky(john)\) 和 \(\neg lucky(u)\lor win(u,lottery)\) 得到 \(win(john,lottery)\);由 \(lucky(john)\) 和 \(\neg lucky(w)\lor pass(w,v)\) 得到 \(pass(john,history)\);再结合“通过历史练习且中彩票则快乐”,推出 \(happy(john)\);最后与 \(\neg happy(john)\) 矛盾。因此 John 快乐。
9.2 精彩人生例子
另一个故事是:不穷且聪明的人是快乐的;会阅读的人不笨,也就是聪明;John 会阅读且富有,即不穷;快乐的人有精彩人生。问题是能否找到某个人有精彩人生。
目标含变量:
\[ \exists w\,exciting(w) \]
归结反证时加入其否定:
\[ \neg\exists w\,exciting(w) \]
等价于:
\[ \forall w\,\neg exciting(w) \]
子句形式可写为:
\[ \neg exciting(w) \]
通过归结可以推出 \(exciting(john)\),并与 \(\neg exciting(w)\) 在替换 \(\{john/w\}\) 下产生空子句。因此答案不仅是“存在”,还可以抽取为:
\[ exciting(john) \]
这个例子说明,当问题是“是否存在某个对象满足性质”时,归结过程中的合一替换可以告诉我们这个对象是谁。
9.3 祖父母例子
“每个人都有父母,父母的父母是祖父母”这个例子可以说明 Skolem 函数和答案抽取。
规则为:
\[ \forall x\exists y\,parent(x,y) \]
\[ \forall x\forall y\forall z(parent(x,y)\land parent(y,z)\rightarrow grandparent(x,z)) \]
问题是 John 是否有祖父母:
\[ \exists w\,grandparent(john,w) \]
第一条经过 Skolem 化变成:
\[ parent(x,pa(x)) \]
表示“每个人 \(x\) 都有一个父母 \(pa(x)\)”。由于 \(pa(john)\) 也有父母,所以还能得到:
\[ parent(pa(john),pa(pa(john))) \]
结合祖父母规则,可以推出:
\[ grandparent(john,pa(pa(john))) \]
因此答案是:
\[ grandparent(john,pa(pa(john))) \]
这里的 \(pa(pa(john))\) 不是一个已知姓名,而是由 Skolem 函数构造出来的对象,表示“John 的某个父母的某个父母”。
10 归结策略、Herbrand 结构与语义树
10.1 归结策略
归结规则本身很简单,但在实际自动推理中,子句数量可能迅速爆炸。因此需要策略控制“先归结哪些子句”。常见策略有四类:
| 策略 | 含义 | 特点 |
|---|---|---|
| 广度优先策略(breadth-first strategy) | 按层次生成所有可能归结结果 | 完整性较好,但空间开销大 |
| 支持集策略(set of support strategy) | 优先使用与目标否定有关的子句 | 常用于反证,减少无关推理 |
| 单元优先策略(unit preference strategy) | 优先选择只有一个文字的单元子句 | 可快速简化子句 |
| 线性输入策略(linear input form strategy) | 每次归结至少使用一个原始输入子句 | 简单高效,但一般不完备 |
线性输入策略不是完备的。也就是说,它可能在某些子句集确实不可满足时,仍然无法找到空子句。学习时要把“策略效率”和“策略完备性”区分开:高效策略可能剪掉太多路径,从而失去完备性。
一个反例由下面四个子句构成:
\[ \neg a\lor \neg b \]
\[ a\lor \neg b \]
\[ \neg a\lor b \]
\[ a\lor b \]
这个子句集本身是不可满足的。可以直观地按 \(a,b\) 的真假来看:如果 \(a=true,b=true\),第一个子句 \(\neg a\lor \neg b\) 为假;如果 \(a=true,b=false\),第三个子句 \(\neg a\lor b\) 为假;如果 \(a=false,b=true\),第二个子句 \(a\lor \neg b\) 为假;如果 \(a=false,b=false\),第四个子句 \(a\lor b\) 为假。四种赋值全部失败,所以整个子句集没有模型。
用普通归结可以推出矛盾。例如:
\[ (\neg a\lor \neg b)\quad\text{和}\quad(a\lor \neg b) \]
对 \(a\) 归结,得到:
\[ \neg b \]
再由:
\[ (\neg a\lor b)\quad\text{和}\quad(a\lor b) \]
对 \(a\) 归结,得到:
\[ b \]
最后 \(b\) 和 \(\neg b\) 归结,得到空子句:
\[ \square \]
问题在于,线性输入策略要求每一步归结都至少使用一个原始输入子句。但上面的最后一步需要把两个中间推出的子句 \(b\) 和 \(\neg b\) 拿来归结,而它们都不是原始输入子句。线性输入策略不允许这一步,因此即使原子句集确实不可满足,它也可能无法推出空子句。这就是“线性输入策略不完备”的含义。
10.2 Herbrand 论域
10.2.1 先把它理解成“符号世界”
Herbrand 论域(Herbrand Domain)可以先理解成一句话:它是只用公式里出现过的常量和函数,能够“造”出来的所有对象名字。它不是在描述真实世界中到底有哪些对象,而是在给自动推理构造一个只由符号组成的世界。这个符号世界的作用是告诉机器:公式里的变量可以尝试替换成哪些对象名字。
10.2.2 没有函数时:论域就是已有常量
例如,知识库里只有:
\[ parent(john,mary) \]
这里出现的常量是 \(john\) 和 \(mary\),没有函数符号。因此 Herbrand 论域就是:
\[ H=\{john,mary\} \]
这表示在当前符号世界里,变量暂时只需要考虑替换成 \(john\) 或 \(mary\)。
10.2.3 有函数时:不断构造新对象
如果知识库中出现函数,Herbrand 论域就会从常量出发,不断用函数构造新对象。例如有常量 \(john\),还有一元函数 \(father(x)\),那么第一层是:
\[ H_0=\{john\} \]
下一层把 \(john\) 放进函数里,得到:
\[ H_1=\{john,father(john)\} \]
再下一层继续把已有对象放进函数里:
\[ H_2=\{john,father(john),father(father(john))\} \]
所以最终 Herbrand 论域是:
\[ H=\{john,father(john),father(father(john)),\dots\} \]
直观地说,它包含 John、John 的父亲、John 的父亲的父亲,依此类推。只要函数可以继续嵌套,Herbrand 论域就可能无限大。
10.2.4 正式定义:从 \(H_0\) 一层层生成
更一般地,Herbrand 论域是由子句集中出现的常量和函数符号构造出的所有基项集合。这里的基项(ground term)指不含变量的项,例如 \(john\)、\(father(john)\)、\(f(a)\) 都是基项,而 \(father(x)\) 不是基项。
构造方式可以整理为:
\[ H=\bigcup_{i=0}^{\infty}H_i \]
如果子句集 \(S\) 中没有常量,则令:
\[ H_0=\{a\} \]
其中 \(a\) 是人为加入的常量;如果 \(S\) 中有常量,则:
\[ H_0=\{c\mid c\text{ 出现在 }S\text{ 中}\} \]
接着用 \(S\) 中出现的函数符号不断生成新项:
\[ H_{i+1}=H_i\cup\{f(t_1,\dots,t_n)\mid t_1,\dots,t_n\in H_i,\;f\text{ 是 }S\text{ 中出现的 }n\text{ 元函数}\} \]
这条递推公式翻译成人话就是:下一层 \(H_{i+1}\) 等于旧集合 \(H_i\),再加上“把旧集合里的对象塞进函数后造出来的新对象”。
例如,如果常量有 \(a\),函数有一元函数 \(f\),那么 Herbrand 论域包含: \[ a,\;f(a),\;f(f(a)),\;f(f(f(a))),\dots \]
如果函数是二元函数,也要把旧集合中的对象两两组合进去。例如常量为 \(a,b\),函数为 \(pair(x,y)\),那么:
\[ H_0=\{a,b\} \]
第一轮可以生成:
\[ pair(a,a),pair(a,b),pair(b,a),pair(b,b) \]
第二轮又可以继续生成 \(pair(a,pair(a,b))\)、\(pair(pair(a,a),b)\)、\(pair(pair(a,b),pair(b,a))\) 这样的更复杂项。
10.2.5 它为什么对归结推理有用
Herbrand 论域和归结推理的关系在于,它把“变量可能取什么值”限制在公式自身能够构造出的基项上。比如有子句:
\[ P(x) \]
和:
\[ \neg P(f(a)) \]
由于 \(f(a)\) 属于 Herbrand 论域,\(P(x)\) 可以用替换 \(\{f(a)/x\}\) 实例化为:
\[ P(f(a)) \]
于是它就能和 \(\neg P(f(a))\) 产生矛盾。Herbrand 理论背后的关键思想是:如果一阶子句集不可满足,那么在由 Herbrand 论域生成的某些基实例中,也能发现命题逻辑层面的矛盾。换句话说,Herbrand 论域为自动推理提供了一个可机械枚举的符号搜索空间。
10.3 语义树
语义树(semantic tree)可以看成对 Herbrand 基原子真值赋值的系统枚举。这里的例子涉及子句集:
\[ \{p(x),\neg p(x)\lor q(x),\neg q(f(a))\} \]
语义树会依次考虑 \(p(a)\)、\(q(a)\)、\(p(f(a))\)、\(q(f(a))\) 等基原子的真假分支。如果某个分支已经违反某个子句,就可以关闭该分支。若所有分支都关闭,则子句集不可满足。
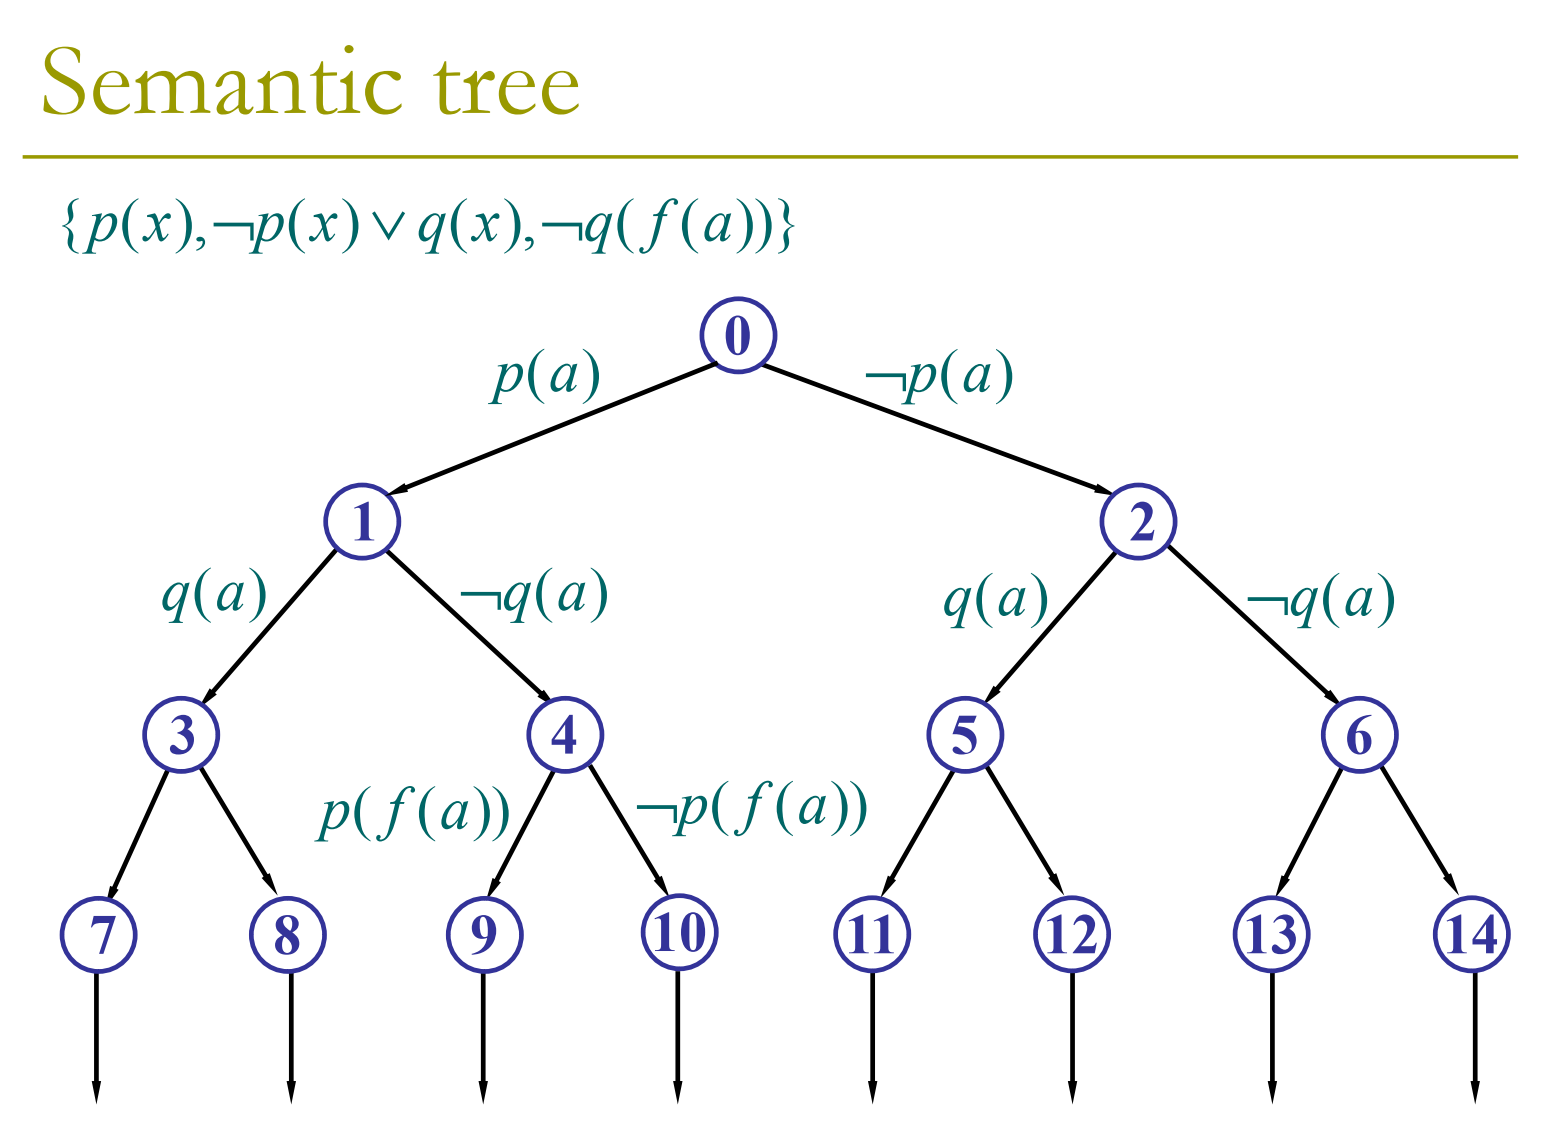
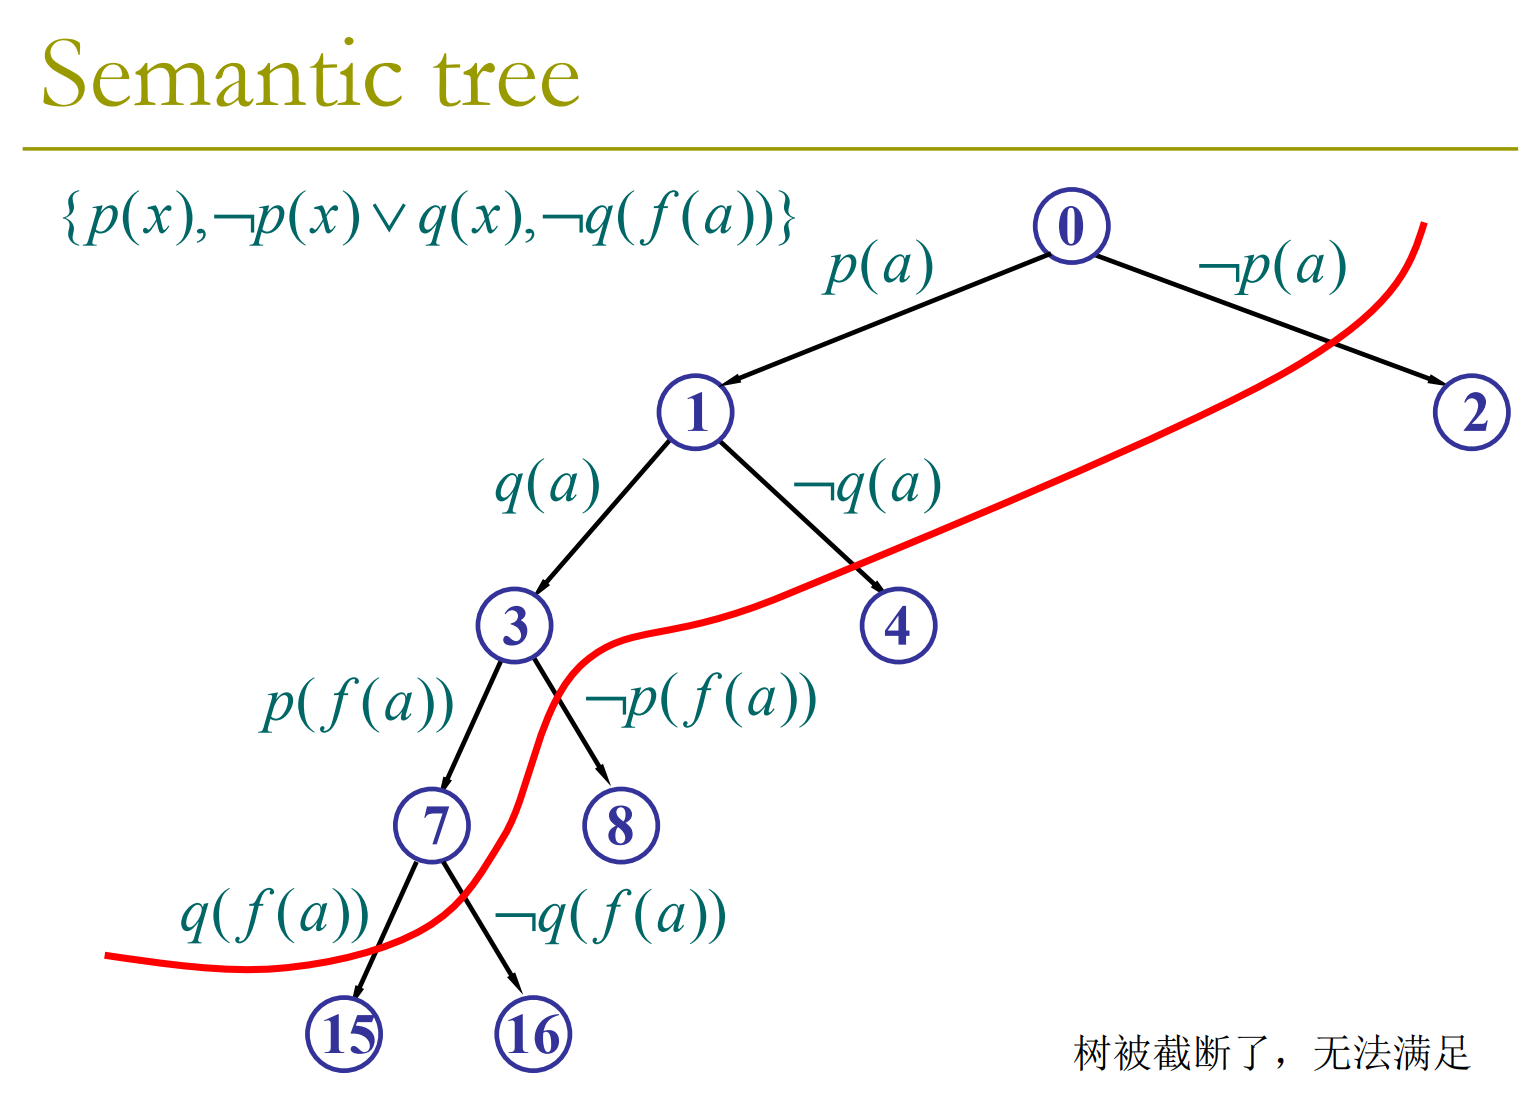
语义树与归结的关系在于:语义树从“模型搜索”角度检查可满足性,而归结从“证明矛盾”角度检查不可满足性。二者视角不同,但都服务于自动推理。
11 其他逻辑系统:默认推理、模态逻辑与真值维护
11.1 逻辑系统的分类
逻辑系统可以粗略分为三类。第一类是表达能力很强但通常不可判定的逻辑,例如一阶逻辑的某些变体和高阶逻辑。第二类是不含量词、计算复杂度较低的形式系统,例如命题逻辑及其非单调变体。第三类介于命题逻辑和一阶逻辑之间,通过限制量词获得可判定性,例如模态逻辑(Modal Logic)、描述逻辑(Description Logic)和命题时序逻辑(Propositional Temporal Logic)。
这部分的核心思想是:表达能力、推理效率和可判定性之间存在权衡。逻辑越强,能表达的知识越复杂,但自动推理往往越难。
11.2 默认推理
默认推理(Default Reasoning)处理的是“通常情况下成立,但可能有例外”的知识。例如“鸟通常会飞,但企鹅不会飞”。经典逻辑是单调的:一旦推出某结论,加入新知识不会使旧结论失效。但默认推理是非单调的,因为加入“这是企鹅”后,可能撤回“它会飞”。
默认逻辑(Default Logic)的形式为:
\[ \frac{p:\neg r_1\land\cdots\land\neg r_n}{q} \]
可以直观理解为:如果 \(p\) 成立,并且没有证据表明例外 \(r_1,\dots,r_n\) 成立,那么默认推出 \(q\)。
circumscription 可以理解为一种最小化异常情况的思想:除非能证明某对象属于异常类,否则默认它不是异常。
11.3 模态逻辑
模态逻辑(Modal Logic)在普通真假之外加入“必然”和“可能”这类模态概念。两个基本符号是:
\[ \Box p \]
表示“必然 \(p\)”;
\[ \Diamond p \]
表示“可能 \(p\)”。
二者之间有重要关系:
\[ \Box p\leftrightarrow \neg\Diamond\neg p \]
意思是“\(p\) 必然为真”等价于“不可能 \(p\) 为假”。另一个常见公理是:
\[ \Box(p\rightarrow q)\rightarrow(\Box p\rightarrow \Box q) \]
表示如果“\(p\) 蕴含 \(q\)”是必然的,并且 \(p\) 必然为真,那么 \(q\) 也必然为真。
11.4 真值维护系统
真值维护系统(Truth Maintenance System, TMS)用于在知识变化时维护结论的一致性。TMS 会为每个结论记录其理由(justification),也就是推出该结论所用的事实、规则和假设。
当系统发现矛盾时,它可以沿着理由追踪哪些假设导致了矛盾,然后撤回错误假设,并进一步撤回所有依赖这些假设的结论。这个机制特别适合默认推理和动态知识库,因为在这些场景中,后续信息可能推翻先前结论。
12 Horn 子句与 Prolog 的逻辑基础
12.1 Horn 子句
Horn 子句(Horn Clause)是至多包含一个【正文字】的子句。一般形式为: \[ a\lor \neg b_1\lor \neg b_2\lor\cdots\lor \neg b_n \]
把它改写成蕴含形式,就是:
\[ a\leftarrow b_1\land b_2\land\cdots\land b_n \]
也可以写成更常见的逻辑形式:
\[ b_1\land b_2\land\cdots\land b_n\rightarrow a \]
Prolog 正是建立在 Horn 子句之上的逻辑程序设计语言。Horn 子句限制了表达能力,但换来了更可控、更高效的推理过程。根据 SWI-Prolog 文档和经典逻辑程序设计教材,Prolog 的执行可以理解为对 Horn 子句进行一种受控的 SLD 归结(SLD Resolution)。
12.2 Horn 子句的三种形式
Horn 子句有三种形式。
| 形式 | 逻辑写法 | Prolog 直观含义 |
|---|---|---|
| 目标/无头子句(goal/headless clause) | \(\leftarrow a_1\land\cdots\land a_n\) | 要证明的查询 |
| 事实(fact) | \(a\leftarrow\) | 无条件成立的事实 |
| 规则(rule) | \(a\leftarrow b_1\land\cdots\land b_n\) | 如果条件都成立,则结论成立 |
在 Prolog 中,事实通常写成:
1 | likes(george, kate). |
规则通常写成:
1 | friends(X, Y) :- likes(X, Z), likes(Y, Z). |
查询通常写成:
1 | ?- friends(george, susie). |
其中 :- 可以读作“if”,逗号 ,
表示合取“and”。
13 Prolog 程序执行:合一、回溯与搜索顺序
13.1 Prolog 如何证明一个目标
给定目标:
\[ \leftarrow a_1\land a_2\land\cdots\land a_n \]
Prolog 解释器会从左到右选择当前最左目标 \(a_1\),然后按照程序中子句出现的顺序,寻找第一个能与 \(a_1\) 的头部合一的子句。如果找到规则:
\[ a_1\leftarrow b_1\land b_2\land\cdots\land b_m \]
并使用替换 \(\xi\) 合一,那么原目标会被改写成:
\[ \leftarrow (b_1\land b_2\land\cdots\land b_m\land a_2\land\cdots\land a_n)\xi \]
也就是说,Prolog 用规则体替换已经证明的目标,然后继续证明新的最左目标。如果所有目标都被消去,得到空目标,查询成功;若某条路径失败,Prolog 会回溯到上一个选择点,尝试其他可能子句或其他合一结果。
13.2 Prolog 语法对应关系
英语、谓词逻辑和 Prolog 的对应关系如下。
| 英语 | 谓词逻辑 | Prolog |
|---|---|---|
| and | \(\land\) | , |
| or | \(\lor\) | ; |
| only if / if | \(\rightarrow\) | :- |
| not | \(\neg\) | not 或 \+ |
需要注意,Prolog 中的 not 或 \+
通常不是经典逻辑中的严格否定,而是失败即否定(negation as
failure):如果 Prolog
无法证明某个目标,就把它当作失败,从而认为其否定成立。这个机制依赖封闭世界假设(closed
world assumption),即程序中不能推出的事实默认视为不成立。
例如,若程序中只有:
1 | likes(george, kate). |
查询:
1 | ?- likes(george, gin). |
会得到 no。这不代表现实世界中 George 一定不喜欢
gin,而是表示在当前知识库中无法证明他喜欢 gin。
13.3 查询与回溯
这里的例子:
1 | likes(george, kate). |
查询:
1 | ?- likes(george, X). |
Prolog 会依次给出:
1 | X = kate ; |
这里的分号表示用户要求 Prolog 回溯,继续寻找下一个解。Prolog 的解不是一次性全部“算出来”,而是沿着程序顺序和目标顺序逐个搜索出来。
13.4 子句顺序和目标顺序的影响
逻辑上,合取 \(A\land B\) 与 \(B\land A\) 等价;但在 Prolog
中,目标顺序会影响搜索过程、效率,甚至是否终止。predecessor
祖先关系可以展示这一点。
自然的写法是先给出基本情况,再给出递归情况:
1 | predecessor(Parent, Child) :- |
这个写法的递归是“先走一步 parent,再递归”,搜索会沿着家族关系向下推进。若把递归规则放在前面,或把递归目标放在规则体最前面,例如:
1 | predecessor(Predecessor, Successor) :- |
Prolog 可能在还没有缩小问题规模时就递归调用自己,导致深度优先搜索陷入无限递归。因此,Prolog 程序不仅要逻辑上正确,还要控制搜索过程。
14 Prolog 数据结构与典型程序
14.1 列表与模式匹配
Prolog 中列表写作:
1 | [1, 2, 3, 4] |
列表最重要的模式是 [Head | Tail],其中 Head
是第一个元素,Tail 是剩余列表。例如:
1 | [tom, dick, harry] = [X | Y] |
得到:
1 | X = tom |
再如:
1 | [tom, dick, harry] = [X, Y | Z] |
得到:
1 | X = tom |
而 [tom, dick, harry] 不能匹配
[X,Y,Z,W|U],因为后者至少需要四个元素。
14.2 member 谓词
member 定义是 Prolog 递归程序的经典例子:
1 | member(X, [X | T]). |
第一条规则表示:如果 \(X\) 是列表头部,那么 \(X\) 是该列表成员。第二条规则表示:如果 \(X\) 不是当前头部,也可以去尾部列表中继续找。
查询:
1 | ?- member(c, [a, b, c]). |
执行过程是:先尝试把 c 与头部 a
合一,失败;再递归检查 [b,c];继续尝试 c 与
b 合一,失败;递归检查 [c];最后
c 与头部 c 合一成功。因此整个查询成功。
如果查询:
1 | ?- member(X, [a, b, c]). |
Prolog 会通过回溯依次生成:
1 | X = a ; |
这里最后的 no 表示“没有更多解”,不是说 X
不是成员。前面的 \(a,b,c\) 已经是
Prolog 通过回溯找到的所有可能答案。
14.3 子句与目标重排:predecessor 例子
predecessor 例子说明:在 Prolog
中,规则顺序和规则体中目标的顺序会显著影响搜索过程。逻辑上等价的递归定义,换个顺序后可能效率不同,甚至可能陷入无限递归。
这里的事实是:
1 | parent(tom, liz). |
查询是:
1 | ?- predecessor(tom, pat). |
其中 predecessor(X, Y) 可以理解为“\(X\) 是 \(Y\)
的祖先”。父母是最直接的一代祖先,所以基本规则是:
1 | predecessor(Parent, Child) :- |
递归规则是:
1 | predecessor(Predecessor, Successor) :- |
这条规则的意思是:如果 Predecessor 是 Child
的父母,而 Child 又是 Successor 的祖先,那么
Predecessor 也是 Successor 的祖先。比如
tom 是 bob 的父母,bob 是
pat 的父母,所以可以推出
predecessor(tom, pat)。
14.3.1 原始写法
如果先写基本规则,再写递归规则:
1 | predecessor(Parent, Child) :- |
这个顺序比较自然。Prolog 查询 predecessor(tom, pat)
时,会先检查 Tom 是否直接是 Pat 的父母;若不是,再进入递归规则,沿着
parent(tom, Child) 找到 Child = liz 或
Child = bob,然后继续检查
predecessor(Child, pat)。当走到 Child = bob
时,基本规则可以直接证明
predecessor(bob, pat),于是整个查询成功。
14.3.2 Variation1
Variation 1 把递归规则放在基本规则前面:
1 | predecessor(Predecessor, Successor) :- |
这种写法通常仍然能找到答案,因为递归规则体的第一个目标是
parent(Predecessor, Child),它会先通过一个具体的父子事实缩小搜索范围,再递归调用
predecessor(Child, Successor)。不过它会优先尝试更深的递归路径,可能比原始写法多走一些搜索分支。
14.3.3 Variation2
Variation 2 保持基本规则在前,但把递归规则体中的目标顺序改了:
1 | predecessor(Parent, Child) :- |
这条递归规则的逻辑意思仍然可以读通:如果 Predecessor 是
Child 的祖先,且 Child 是
Successor 的父母,那么 Predecessor 是
Successor 的祖先。但执行上更危险,因为递归调用
predecessor(Predecessor, Child) 放在了
parent(Child, Successor) 前面。也就是说,Prolog
还没有先用一个具体的 parent 事实限制
Child,就先递归寻找祖先关系,搜索空间会变大。
14.3.4 Variation3
Variation 3 同时把递归规则放在前面,并且递归目标也放在规则体最前面:
1 | predecessor(Predecessor, Successor) :- |
这是最容易出问题的写法。查询 predecessor(tom, pat)
时,Prolog 首先匹配递归规则,于是又要证明
predecessor(tom, Child);为了证明这个新目标,它又优先匹配同一条递归规则,继续变成
predecessor(tom, Child2),如此反复。由于 Prolog
默认采用从上到下、从左到右、深度优先的搜索策略,它可能在还没来得及尝试基本规则前,就陷入无限递归。
这个例子要记住的结论是:在 Prolog
中,声明式逻辑含义和过程式执行顺序必须同时考虑。
写递归规则时,通常应先放能缩小搜索范围的目标,例如
parent(Predecessor, Child),再放递归调用;同时通常把基本情况放在递归情况之前,让程序有机会尽早停止。
14.4 骑士巡游问题:搜索、避免重复与回溯
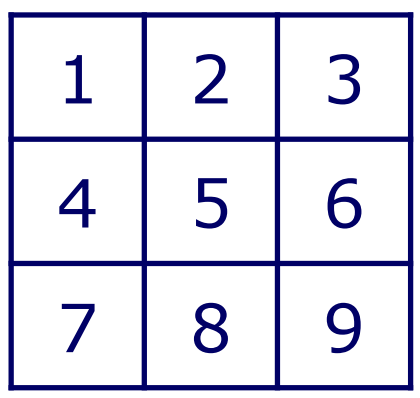
\(3\times3\) 棋盘上的骑士移动问题可以说明 Prolog 如何进行路径搜索。棋盘格编号为 \(1\) 到 \(9\)。以下是所有的合法移动:
1 | move(1, 6). move(3, 4). move(6, 7). move(8, 3). |
路径规则为:
1 | path(Z, Z, L). |
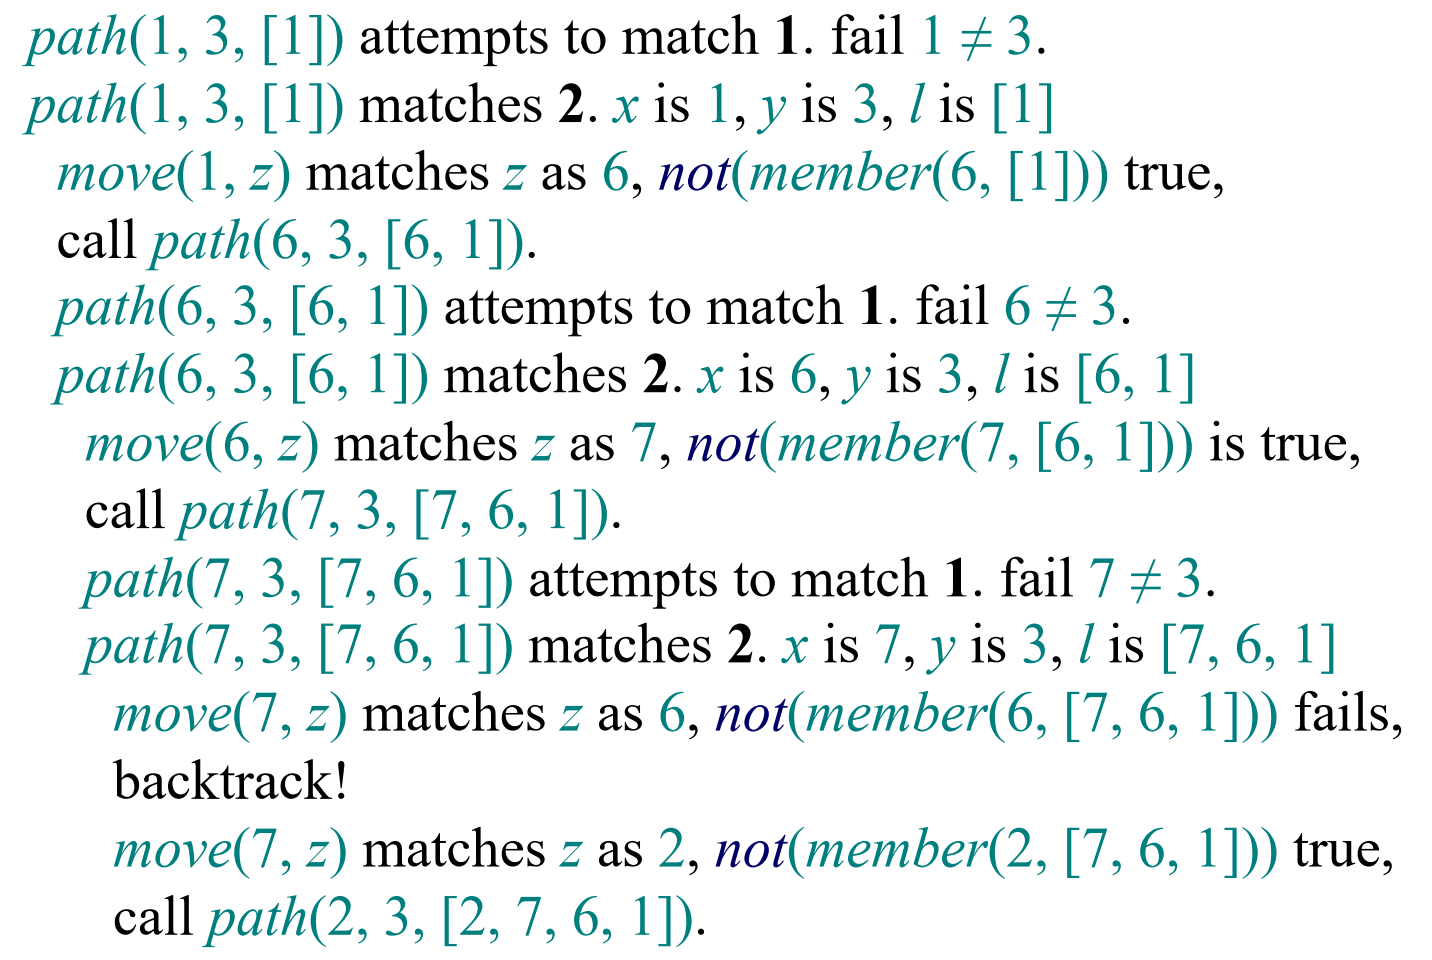
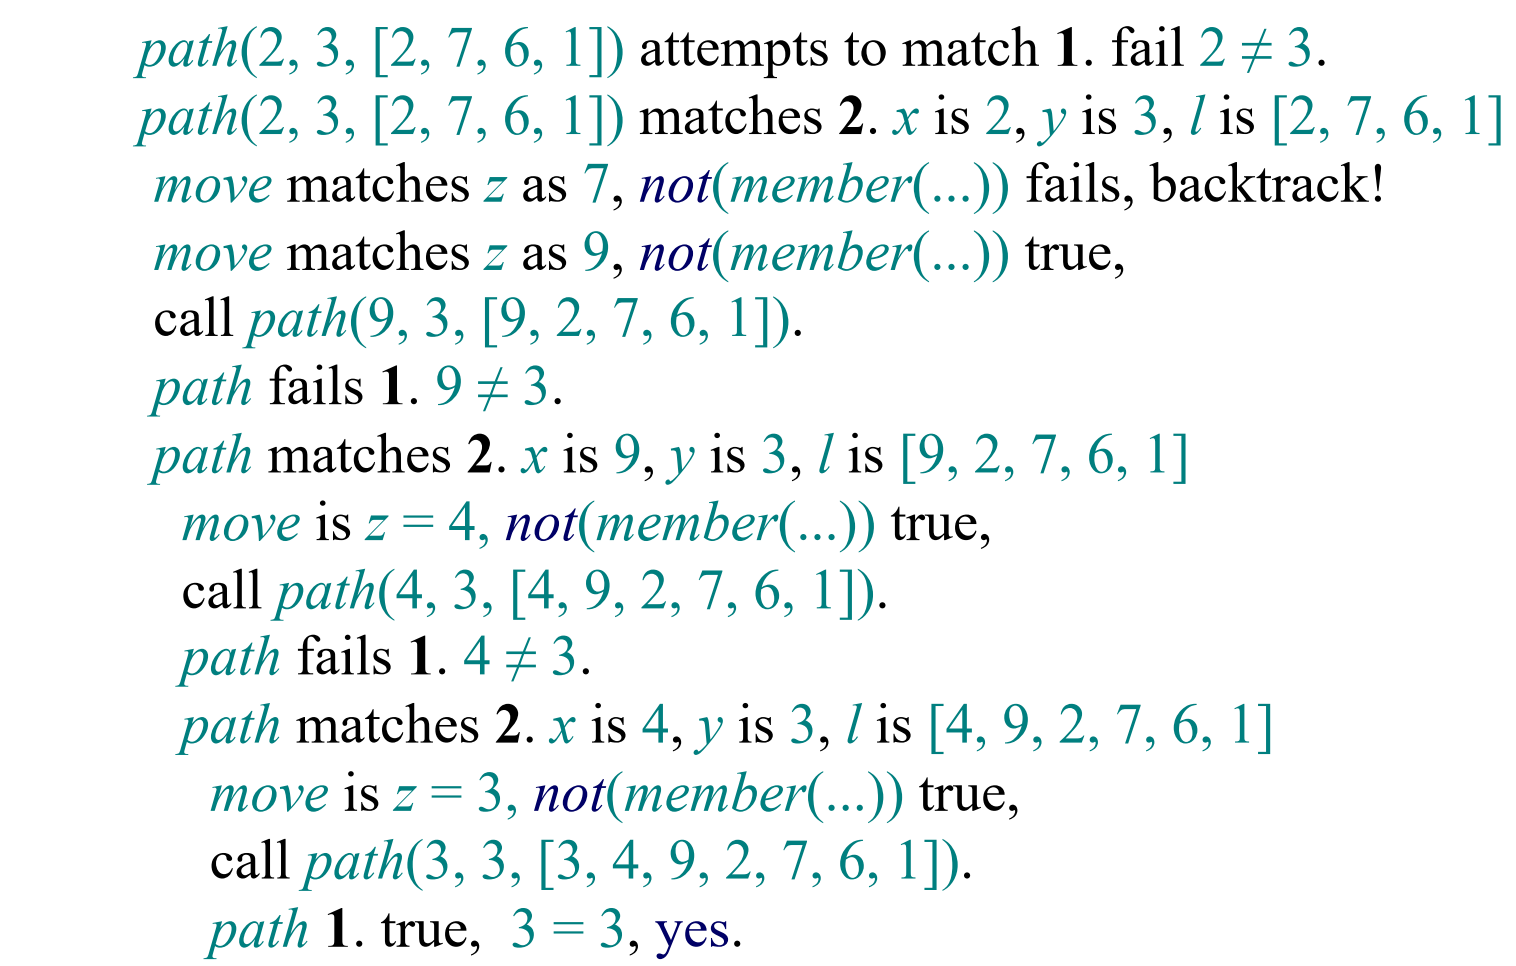
第一条是基本情况:从 \(Z\) 到 \(Z\) 的路径已经找到,已访问列表是 \(L\)。第二条是递归情况:如果可以从 \(X\) 走到 \(Z\),并且 \(Z\) 没有出现在已访问列表 \(L\) 中,那么继续从 \(Z\) 搜索到目标 \(Y\),同时把 \(Z\) 加入访问列表。
查询:
1 | ?- path(1, 3, [1]). |
推理过程:
14.5 cut:控制搜索
Prolog 的 cut 写作
!,用于剪掉当前谓词调用中已经产生的选择点。根据 SWI-Prolog
文档,!
会丢弃进入当前谓词后创建的选择点。直观地说,一旦执行到
cut,Prolog
就承诺使用当前已经做出的选择,不再回头尝试该选择之前的其他可能。
若定义:
1 | path2(X, Y) :- |
查询:
1 | ?- path2(1, W). |
会通过回溯找到多个两步可达结果:
1 | W = 7 ; |
如果加入 cut:
1 | path3(X, Y) :- |
查询:
1 | ?- path3(1, W). |
当 move(1, Z) 第一次选中 \(Z=6\) 后,cut 会阻止 Prolog 回头尝试 \(Z=8\)。因此结果只来自路径 \(1\rightarrow6\rightarrow W\):
1 | W = 7 ; |
cut 可以提高效率、避免不必要搜索,但也可能改变程序的逻辑含义。学习时可以把 cut 理解为“搜索控制工具”,而不是普通逻辑联结词。
14.6 农夫、狼、羊和白菜问题
经典的农夫过河问题可以展示 Prolog 如何解决状态空间搜索。状态写作:
1 | state(Farmer, Wolf, Goat, Cabbage) |
其中每个位置取 w 或
e,分别表示河西岸和河东岸。初始状态为:
1 | state(w, w, w, w) |
目标状态为:
1 | state(e, e, e, e) |
移动规则描述农夫带狼、带羊、带白菜或独自过河。每次移动后都要检查状态是否安全:不能让狼和羊在没有农夫时单独相处,也不能让羊和白菜在没有农夫时单独相处。
这里的程序结构大致是:move
生成合法下一状态;path
递归寻找从当前状态到目标状态的路径;been_stack
记录已经访问过的状态,避免循环;not(member_stack(...))
用失败即否定检查是否重复;最后用 cut 在找到一条解后停止继续搜索。
下面是这段程序的主体。需要先说明一个细节:为了突出状态变化,代码把变量写成了小写的
x,y,w,g,c;但在标准 Prolog
中,变量必须以大写字母或下划线开头,小写开头会被当作原子。因此理解下面代码时,应把这些小写符号看成变量。
14.6.1 四类移动规则
1 | move(state(x, x, g, c), state(y, y, g, c)) :- # 农夫带狼过河 |
14.6.2 回溯提示、路径搜索和两岸关系
1 | move(state(f, w, g, c), state(f, w, g, c)) :- |
第一条特殊的 move 规则并不是真的移动,它的作用是打印
BACKTRACK from ...,然后用 fail
强制失败,从而让 Prolog
回溯。它更像调试输出,用来展示某条搜索路径走不通。
第一条 path
是基本情况:如果当前状态已经等于目标状态,就说明找到了解,程序打印
Solution path is,并把访问过的状态栈反向输出。第二条
path 是递归搜索:先用 move(state, next_state)
生成下一状态,再用
not(member_stack(next_state, been_stack))
检查这个状态没有访问过,然后把 next_state
压入栈,继续递归搜索从 next_state 到 goal
的路径。最后的 ! 是
cut,表示一旦找到一条解,就不要再回溯寻找其他解。
opposite(e, w) 和 opposite(w, e)
定义东西两岸互为对岸。如果当前位置是 w,下一次过河后就是
e;如果当前位置是 e,下一次过河后就是
w。
14.6.3 启动程序
启动程序的入口是:
1 | go(start, goal) :- |
对应查询为:
1 | ?- go(state(w, w, w, w), state(e, e, e, e)). |
14.6.4 运行过程
1 | Process: Solution path is: |
左边 Process 是 Prolog
搜索时尝试的移动,包括失败后的回溯信息;右边
Solution path is
是最终找到的解路径。成功路径对应的状态序列是:
1 | state(w, w, w, w) |
把这些状态翻译成人话,就是:农夫先带羊过河,自己回来;带狼过河,再把羊带回来;带白菜过河,自己回来;最后再带羊过河。这个顺序保证任何时候狼都不会和羊单独留在一起,羊也不会和白菜单独留在一起。
成功路径可整理为:
- 农夫带羊过河。
- 农夫独自返回。
- 农夫带狼过河。
- 农夫带羊返回。
- 农夫带白菜过河。
- 农夫独自返回。
- 农夫带羊过河。
这个例子与骑士路径问题本质相同:都可以看成图搜索。区别在于,农夫问题的“节点”是完整状态,move
规则负责生成相邻状态,安全约束负责剪枝。
15 总结
15.1 本章最核心的概念链
本章内容很多,但可以用一条概念链串起来:
\[ \text{逻辑表示}\rightarrow \text{语义解释}\rightarrow \text{逻辑蕴含}\rightarrow \text{推理规则}\rightarrow \text{归结反证}\rightarrow \text{Horn 子句}\rightarrow \text{Prolog 执行} \]
命题逻辑解决基本真假组合,一阶谓词逻辑解决对象和关系表示,模型语义定义“什么叫真”,逻辑蕴含定义“什么叫必然推出”,归结反证提供可机械执行的证明方法,而 Prolog 把 Horn 子句上的归结搜索变成程序执行。
15.2 概念辨析
| 易混点 | 正确理解 |
|---|---|
| \(P\rightarrow Q\) | 只有 \(P=true,Q=false\) 时为假;不是因果关系本身 |
| \(\forall x(P(x)\rightarrow Q(x))\) | 表示所有 \(P\) 都是 \(Q\) |
| \(\exists x(P(x)\land Q(x))\) | 表示存在对象同时满足 \(P\) 和 \(Q\) |
| 可满足与有效 | 可满足是“至少一个解释为真”,有效是“所有解释为真” |
| 可靠与完备 | 可靠是不推出假结论,完备是不遗漏真后承 |
| 合一与匹配 | 合一要找一致替换,MGU 要尽量一般 |
| Skolem 化 | 消去存在量词,保持可满足性而不一定保持等价 |
| 空子句 | 表示矛盾,是归结反证成功的标志 |
| Prolog 的 not | 通常是失败即否定,不是经典否定 |
| cut | 控制回溯搜索,会影响程序行为 |
15.3 常见任务的分析方法
把自然语言转成逻辑表达式时,可以先找对象、关系和量词。凡是“所有……”通常用 \(\forall\) 加蕴含,凡是“有些……”通常用 \(\exists\) 加合取。遇到“没有……”可以写成 \(\neg\exists\)。
做归结证明时,先把前提转为子句形,再把目标取反加入子句集。然后寻找互补文字,必要时先做合一。证明结束的标志是推出空子句 \(\square\)。如果目标中有变量,需要沿着归结过程收集合一替换,最终可用于答案抽取。
分析 Prolog
程序时,先看事实和规则的顺序,再看每条规则体中目标的顺序。Prolog
使用从左到右、从上到下、深度优先、失败回溯的搜索策略,所以逻辑等价的写法在执行上可能完全不同。判断
member、路径搜索、祖先递归和 cut
行为时,尤其要按这个执行顺序逐步模拟。
15.4 参考资料
- Stanford Introduction to Logic: First-Order Logic,补充一阶逻辑语法、语义与解释的背景说明。
- Stanford Encyclopedia of Philosophy: Classical Logic,补充经典逻辑、模型语义和证明系统的整体背景。
- SWI-Prolog
Documentation:
!/0,补充 Prolog cut 对选择点和回溯的影响。 - SWI-Prolog
Documentation:
library(lists),补充 Prolog 列表与常用列表谓词的实现背景。