目录
- CLIPS 与基于规则的专家系统
- CLIPS 语法基础与数据类型
- 事实、模板与工作记忆
- 事实操作与初始事实集合
- 规则定义、执行与构件管理
- 变量、通配符与事实地址
- 字段约束与谓词函数
- 条件元素:or、and、not、exists、forall、logical
- 决策树专家系统案例
- 规则执行控制:显著性、阶段与模块
- 过程式函数与交互控制
- 监控系统案例:传感器、趋势与告警
- 推理引擎、模式匹配网络与效率优化
- 事实文件的加载与保存
- 总结与对比
- 参考资料
1 CLIPS 与基于规则的专家系统
1.1 CLIPS 的定位
CLIPS 是 C Language Integrated Production System 的缩写,中文可以理解为 C 语言集成产生式系统。它最初由 NASA Johnson Space Center 开发,用来构建专家系统(Expert System)。根据 CLIPS 官方介绍,CLIPS 适合那些“用启发式规则比用固定算法更容易描述和维护”的问题;这也解释了为什么 CLIPS 常出现在人工智能知识表示与推理主题中:它不是普通的过程式语言,而是一种面向知识、规则和推理的工具。
在专家系统中,知识通常不是写成一条从头到尾执行的程序,而是写成许多“如果条件满足,就执行某些动作”的规则。系统运行时会不断查看当前事实,找出可以触发的规则,并把规则的动作作用到工作记忆(Working Memory)上。这个过程叫前向推理(Forward Chaining),因为推理从已知事实出发,一步步推出新事实或执行新动作。
1.2 基于规则的专家系统结构
一个典型专家系统包括用户界面、知识获取设施、解释设施、知识库、工作记忆、议程和推理机。它们之间的关系可以理解为:知识库保存长期规则,工作记忆保存当前事实,推理机负责把规则和事实匹配起来,议程保存已经匹配成功但尚未执行的规则实例。
| 组成部分 | 英文 | 作用 |
|---|---|---|
| 用户界面 | User Interface | 让用户输入问题、查看系统输出 |
| 知识获取设施 | Knowledge Acquisition Facility | 帮助把专家经验转化为系统中的事实和规则 |
| 解释设施 | Explanation Facility | 解释系统为什么得到某个结论,体现专家系统的可解释性 |
| 知识库 | Knowledge Base | 保存规则(Rules),表示领域知识 |
| 工作记忆 | Working Memory | 保存事实(Facts),表示当前问题状态 |
| 议程 | Agenda | 保存已激活、等待执行的规则实例 |
| 推理机 | Inference Engine | 进行匹配、冲突消解和动作执行 |
这一结构的优点是模块化强、可解释性好、接近人类用规则处理问题的方式。例如在火灾应急系统中,规则可以写成“如果发生火灾,则启动喷水系统”。当工作记忆中出现火灾事实时,系统就会触发对应规则,并生成响应动作。
2 CLIPS 语法基础与数据类型
2.1 这里的记号约定
CLIPS 的语法大量使用括号,因此读代码时首先要习惯 Lisp 风格的前缀表达式。这里的记号约定是为了描述语法模板,而不是 CLIPS 程序本身。
| 记号 | 含义 | 例子 |
|---|---|---|
( ) |
CLIPS 的基本定界符 | (assert (data 3)) |
<integer> |
需要替换成一个整数 | <limit> 可以写成
10 |
[ ] |
可选部分 | [<optional-comment>]
表示注释可写可不写 |
+ |
一个或多个 | <fact>+
表示至少一个事实 |
* |
零个或多个 | <slot-definition>*
表示可以没有,也可以有多个槽定义 |
| |
多选一 | all | none | some
表示三者选一 |
2.2 原子数据类型
CLIPS 的基本数据类型包括整数、浮点数、符号和字符串。符号(Symbol)是
CLIPS 中非常常见的值,它不加引号,例如
fire、activate-sprinkler-system。字符串(String)必须加双引号,例如
"John Smith"。
| 类型 | 英文 | 示例 | 说明 |
|---|---|---|---|
| 整数 | integer | 1、+3、-1、65 |
不带小数点 |
| 浮点数 | float | 1.5、0.7、9e+1 |
可用科学计数法 |
| 符号 | symbol | fire、345B |
常用于枚举值、名字、状态 |
| 字符串 | string | "John Smith" |
可包含空格,必须加双引号 |
CLIPS
用空格、制表符、换行、双引号、括号、分号以及若干特殊字符作为分隔符。变量名以
? 或 $?
开头,因此普通符号不能以这两个前缀开头。这个细节在阅读模式匹配代码时很重要:?name
不是符号,而是一个单字段变量;$?name 是多字段变量。
2.3 前缀表达式与数学函数
CLIPS 中函数调用采用前缀形式,即函数名写在最前面。例如普通数学表达式 \(3+4\times 5\) 在 CLIPS 中写作:
1 | (+ 3 (* 4 5)) |
同理,表达式 \(\frac{y_2-y_1}{x_2-x_1}>0\) 可以写成:
1 | (> (/ (- ?y2 ?y1) (- ?x2 ?x1)) 0) |
这种写法的好处是所有函数调用都具有统一结构:(函数名 参数1 参数2 ...)。它看起来不如中缀表达式直观,但对于解释器来说更容易解析。
3 事实、模板与工作记忆
3.1 事实是 CLIPS 的“当前世界状态”
事实(Fact)表示系统当前知道的信息。工作记忆可以看成事实列表,里面既可以保存原始输入,也可以保存规则推理出的中间结果和最终结论。例如:
1 | (person (name "John Smith") |
这个事实表示一个人的姓名、年龄、眼睛颜色和头发颜色。与普通数据库记录类似,它由关系名
person 和若干字段组成。不同之处在于,CLIPS
的事实会被规则实时匹配;当事实被增加、删除或修改时,议程中的规则激活也会随之更新。
3.2 deftemplate:定义事实结构
deftemplate
用来定义模板(Template),也就是某类事实应该有哪些槽(Slot)。模板相当于数据库中的表结构或
C 语言中的结构体定义。其基本语法是:
1 | (deftemplate <relation-name> |
槽有两种:slot
表示单字段槽,只能放一个值;multislot
表示多字段槽,可以放零个或多个值。例如:
1 | (deftemplate person |
这里 name 用 multislot
是因为姓名可能由多个部分构成,例如 John Q. Smith;而
age、eye-color、hair-color
一般只需要一个值。
3.3 模板属性:类型、取值、范围、基数和默认值
模板不仅能规定槽名,还能规定槽值的合法范围。这样做的目的不是为了“写得更复杂”,而是为了让知识库更可靠:错误事实在进入工作记忆时就能被发现。
| 属性 | 语法 | 作用 |
|---|---|---|
| 类型属性 | (type <type-specification>) |
限定槽值类型,如
SYMBOL、INTEGER、FLOAT |
| 允许值属性 | (<allowed-value> <value>+) |
限定槽值必须属于某个集合 |
| 范围属性 | (range <lower-limit> <upper-limit>) |
限定数值上下界 |
| 基数属性 | (cardinality <lower-limit> <upper-limit>) |
限定多字段槽中字段个数 |
| 默认值属性 | (default <default-specification>) |
给没有显式填写的槽提供默认值 |
每一种槽属性都有对应的可选值。首先,类型属性中的
<type-specification>
用来说明槽里可以放什么类型的数据:
<type-specification> |
含义 |
|---|---|
?VARIABLE |
默认值,表示类型不受限制,可以匹配任意合法 CLIPS 值 |
SYMBOL |
符号类型,例如
fire、male、activate-sprinkler-system |
STRING |
字符串类型,例如
"John Smith" |
LEXEME |
词素类型,等价于 SYMBOL 或
STRING,即可以是符号也可以是字符串 |
INTEGER |
整数类型,例如
21、-1 |
FLOAT |
浮点数类型,例如
1.5、9e+1 |
NUMBER |
数值类型,等价于 INTEGER 或
FLOAT |
允许值属性中的 <allowed-value>
用来进一步限制槽值必须来自某个集合。它不是具体值本身,而是说明“后面这些值按什么类别解释”:
<allowed-value> |
含义 |
|---|---|
allowed-values |
允许任意类型的指定值,是最通用的取值集合限制 |
?VARIABLE |
默认值,表示不限制允许值集合 |
allowed-symbols |
后面列出的允许值必须按符号处理 |
allowed-strings |
后面列出的允许值必须按字符串处理 |
allowed-lexemes |
后面列出的允许值可以是符号或字符串 |
allowed-integers |
后面列出的允许值必须是整数 |
allowed-floats |
后面列出的允许值必须是浮点数 |
allowed-numbers |
后面列出的允许值可以是整数或浮点数 |
范围属性中的 <lower-limit> 和
<upper-limit> 可以是具体数字,也可以是
?VARIABLE。如果写具体数字,就表示对应的下界或上界;如果写
?VARIABLE,就表示这一侧没有固定边界。例如
(range 0 ?VARIABLE) 表示数值不能小于
0,但没有规定最大值。
基数属性中的 <lower-limit> 和
<upper-limit> 用来限制 multislot
中字段个数,取值可以是正整数或 ?VARIABLE。例如
(cardinality 1 6) 表示这个多字段槽至少有 1 个字段、最多有 6
个字段;如果上界写成
?VARIABLE,就表示没有固定最大个数。
默认值属性中的 <default-specification>
有三种常见情况:?DERIVE 是默认设置,表示让 CLIPS
根据类型、允许值、范围和基数等信息推导默认值;?NONE
表示没有默认值,断言事实时必须显式提供该槽值;如果写一个或多个表达式,则这些表达式就是用户指定的默认值。单字段槽只能给一个默认表达式,多字段槽可以给零个或多个默认表达式。
3.3.1 例子
例如,一个人的年龄应为整数且不能小于 0,性别只能取 male
或 female,可以写成:
1 | (deftemplate person |
其中 ?VARIABLE 在属性中表示“这一端不固定”。
这里的 default-derive-example 进一步说明了
?DERIVE 的含义:如果不显式指定默认值,CLIPS
会根据类型、允许值、范围等属性推导一个默认值。
1 | (deftemplate default-derive-example |
断言 (default-derive-example) 时没有显式填写任何槽,所以
CLIPS 会为每个槽推导默认值,结果可理解为:
1 | (default-derive-example |
这里 a 没有类型、范围或允许值限制,因此默认推导为
nil;b 被声明为整数,所以默认得到整数
0;c 的允许值是
red green blue,CLIPS 取第一个允许值
red;d
是没有基数要求的多字段槽,因此默认为空字段序列;e
是多字段槽,并且要求字段个数恰好为 2、类型为浮点数、范围为 \([3.5,10.0]\),所以 CLIPS 用下界
3.5 填满两个字段,得到
(e 3.5 3.5)。这个例子说明,?DERIVE
不是固定产生同一个值,而是会结合槽的约束条件推导一个合法默认值。
3.4 有序事实与模板事实
CLIPS 中的事实可以分为有序事实(Ordered Fact)和模板事实(Template Fact)。有序事实只有关系名和一串字段,例如:
1 | (number-list 7 9 3 4 20) |
模板事实则显式写出槽名,例如:
1 | (person (name Sean Zheng) |
有序事实适合结构简单、字段含义由位置决定的场景;模板事实适合字段较多、需要类型约束和可读性的场景。实际开发中,如果事实有明确属性,优先使用
deftemplate
定义模板,因为它能让规则更清楚,也能减少因字段顺序写错带来的错误。
3.5 各概念的关系
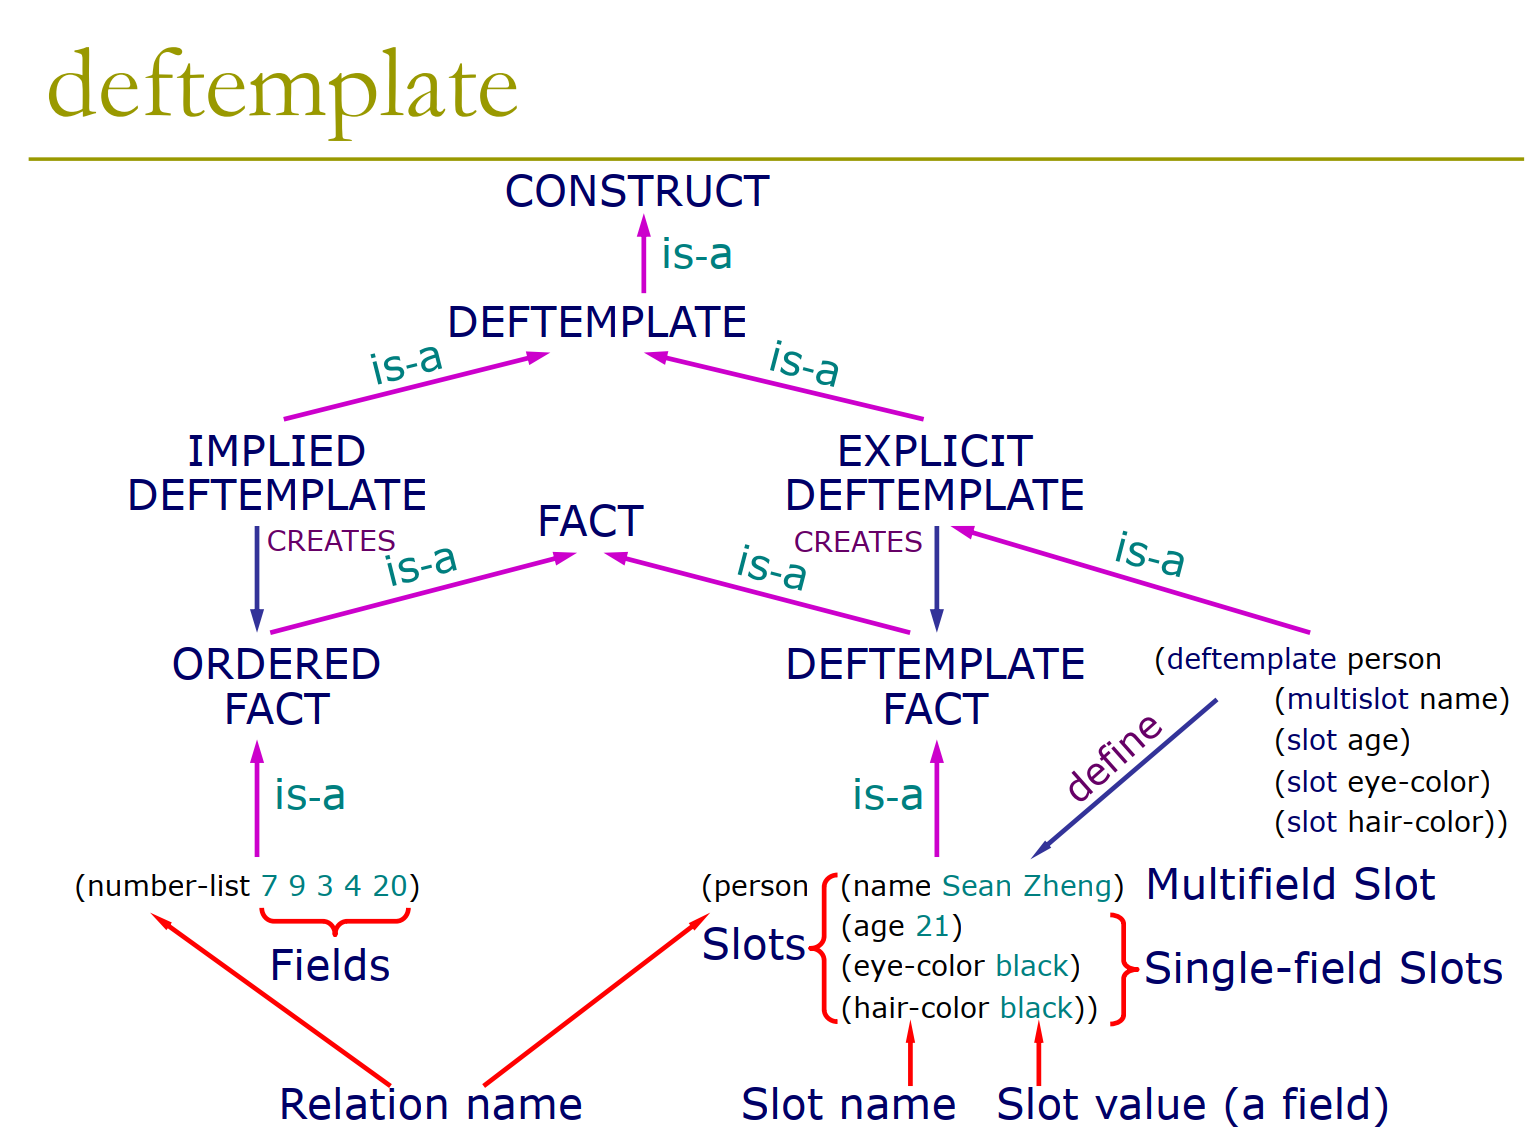
4 事实操作与初始事实集合
4.1 assert、facts、retract 与 modify
事实操作是 CLIPS 程序运行时改变工作记忆的主要方式。
| 操作 | 语法 | 作用 |
|---|---|---|
| 增加事实 | (assert <fact>+) |
向工作记忆加入一个或多个事实 |
| 显示事实 | (facts [<start> [<end> [<maximum>]]]) |
查看当前事实列表 |
| 删除事实 | (retract <fact-index>+) |
根据事实编号或事实地址删除事实 |
| 修改事实 | (modify <fact-index> <slot-modifier>+) |
修改模板事实的槽值 |
4.1.1 Assert:增
assert 的作用是把新事实加入工作记忆。例如:
1 | (assert (person (name "John Smith") |
执行后,工作记忆中会多出一个 person 事实。CLIPS
会给每条事实分配事实编号,例如可能显示为
f-1、f-2。这个编号后面可以被
retract 或 modify 使用。
4.1.2 Facts:查
facts 用来查看当前事实列表。最简单的写法是:
1 | (facts) |
如果当前工作记忆中有两个事实,输出可能类似于:
1 | f-1 (initial-fact) |
也可以指定显示范围。例如 (facts 2 5) 表示显示编号从
2 到 5
的事实;如果再加最大显示数量,则可以限制最多输出多少条事实。
4.1.3 Retract:删
retract 用来删除事实。例如,如果上面 person
事实的编号是 f-2,可以写:
1 | (retract 2) |
或者在规则中使用事实地址删除匹配到的事实:
1 | (defrule remove-moved-record |
第一种写法适合在交互环境中根据事实编号手动删除,第二种写法适合在规则执行时删除当前匹配到的事实。
4.1.4 Modify:改
modify 用来修改模板事实中的槽值。例如,如果
f-2 是一个 person 事实,现在要把年龄改成
22,可以写:
1 | (modify 2 (age 22)) |
如果在规则中修改事实,通常先用事实地址绑定它:
1 | (defrule birthday |
这条规则的意思是:匹配到某个人后,把他的年龄加
1。需要注意的是,modify
只能修改模板事实的槽值;对于有序事实,通常需要先 retract
旧事实,再 assert 新事实。
modify
本质上可以理解为“删除旧事实,再加入修改后的新事实”。因此它也会触发规则重新匹配。比如某人搬家后,可以把
person 事实中的地址更新为新的地址。
4.2 deffacts:预置一组初始事实
deffacts
用来定义一组可以在重置系统时自动加入工作记忆的事实:
1 | (deffacts people |
这类似于给系统准备测试数据或初始数据库。需要把 deffacts
和 assert 区分开:deffacts
是构件定义,描述“有哪些初始事实”;assert
是运行时动作,直接把事实放入工作记忆。
5 规则定义、执行与构件管理
5.1 defrule:把知识写成“条件到动作”
规则(Rule)是 CLIPS 的核心构件。基本语法是:
1 | (defrule <rule-name> |
=>
左边是条件部分(LHS),通常由一个或多个模式组成;右边是动作部分(RHS),可以增加事实、修改事实、打印信息或调用函数。这里的火灾规则可以解释为:如果工作记忆中存在一个
emergency 事实,并且它的 type 槽为
fire,那么系统就断言一个响应事实,表示应该启动喷水系统。
1 | (defrule fire-emergency |
这条规则并不是在定义一个函数供用户手动调用,而是在定义一个可被事实触发的知识片段。当事实满足 LHS 时,规则实例进入议程;当推理机选择它执行时,RHS 动作才真正发生。
5.2 run、printout 与 clear
run 用来启动推理过程:
1 | (run [<limit>]) |
如果指定
<limit>,系统最多触发指定次数的规则;如果不指定,则运行到没有可执行规则、遇到
halt 或用户中断为止。printout 用于输出:
1 | (printout t "Activate the sprinkler system" crlf) |
其中 t 表示标准输出,crlf
表示换行。clear
则会清空当前环境中的构件和事实,通常用于重新开始一次实验。
5.3 构件的查看、格式化输出与删除
CLIPS 把规则、模板、初始事实集合等称为构件(Construct)。常用管理命令包括:
| 功能 | 命令 |
|---|---|
| 列出规则 | (list-defrules) |
| 列出模板 | (list-deftemplates) |
| 列出初始事实集合 | (list-deffacts) |
| 美化输出规则 | (ppdefrule <defrule-name>) |
| 美化输出模板 | (ppdeftemplate <deftemplate-name>) |
| 美化输出初始事实集合 | (ppdeffacts <deffacts-name>) |
| 删除规则 | (undefrule <defrule-name>) |
| 删除模板 | (undeftemplate <deftemplate-name>) |
| 删除初始事实集合 | (undeffacts <deffacts-name>) |
这些命令的学习意义在于帮助理解 CLIPS 环境的交互式特征。CLIPS 不只是一个语言规范,它也是一个可以不断加载、查看、运行和调试规则库的开发环境。
6 变量、通配符与事实地址
6.1 单字段变量
变量以 ?
开头,用来在模式匹配时绑定事实中的字段。例如:
1 | (defrule find-blue-eyes |
当工作记忆中有 (person (name Jane) (eyes blue))
时,?name 会绑定为
Jane。如果有多个符合条件的人,这条规则会产生多个激活,每个激活对应一组不同的变量绑定。
变量还可以在多个模式之间传递约束。例如:
1 | (defrule find-eyes |
如果先断言
(find (eyes green)),那么第二个模式只会匹配眼睛为
green 的人。这里的 ?eyes
把“查询条件”和“人员事实”连接起来。
6.2 事实地址:在 RHS 中修改或删除匹配到的事实
如果规则右部需要修改或删除左部匹配到的事实,就必须保存事实地址。语法形式是:
1 | ?f <- (pattern ...) |
例如这里的搬家信息处理规则可以理解为:先匹配一个 moved
事实,再匹配同名的 person 事实,然后把 person
的地址改成新地址。
1 | (defrule process-moved-information |
?f1 和 ?f2
不是普通字段值,而是事实在工作记忆中的引用。没有事实地址,RHS
就不知道应该修改或删除哪一条具体事实。
6.3 单字段通配符与未指定槽
单字段通配符 ?
表示“这里有一个字段,但我不关心它的值”。例如要匹配姓名为“三段式结构,最后一段是某个姓”的人,可以写:
1 | (person (name ? ? ?last-name) |
这里前两个 ? 只占位,不绑定变量;?last-name
和 ?id-number 会被保存供 RHS
使用。未在模式中写出的槽并不是不存在,而是默认等价于用 ?
匹配。例如:
1 | (person (name John Q. Smith)) |
等价于:
1 | (person (name John Q. Smith) |
这说明 CLIPS 的模板模式可以只写关心的槽,从而让规则更简洁。
6.4 多字段通配符
多字段通配符 $? 可以匹配零个或多个字段。它在处理
multislot 时非常重要。例如:
1 | (person (name $?name) |
如果某人的孩子列表是 (Jane Joe Paul),并且要寻找孩子
Joe,那么 $?before 绑定为
(Jane),?child 绑定为
Joe,$?after 绑定为
(Paul)。如果列表中有多个 Joe,CLIPS
会给出多种匹配方式。这里的 Jack R. Lenny 有三个
Joe,因此会产生三种不同的“前面若干字段 + 当前 Joe +
后面若干字段”的绑定。
多字段通配符虽然灵活,但会显著增加匹配组合数。后面效率优化部分会强调:不要滥用多字段通配符和多字段变量。
7 字段约束与谓词函数
7.1 连接约束:非、或、且
CLIPS 的字段约束可以在模式内部直接表达条件。常见连接符有
~、| 和 &。
| 约束 | 含义 | 示例 |
|---|---|---|
~ |
不能等于某值 | (hair ~black)
表示头发不是黑色 |
| |
多个候选值之一 | (hair brown|black)
表示棕色或黑色 |
& |
同时满足多个约束 | ?color&brown|black
表示绑定颜色且颜色为棕色或黑色 |
例如:
1 | (defrule person-without-black-hair |
如果需要在 RHS 中输出颜色,就不能只写
(hair brown|black),而应该写成
(hair ?color&brown|black)。这样既限制了颜色范围,又把实际颜色绑定到
?color。
7.2 组合字段约束
复杂约束可以把多个变量、取值范围和否定条件结合起来。这里的例子可以解释为:第一个人眼睛为蓝色或绿色,头发不是黑色;第二个人不能与第一个人同名,眼睛颜色也不能相同,头发要么是黑色,要么与第一个人的头发颜色相同。
1 | (person (name ?name1) |
这类写法体现了 CLIPS 模式匹配的表达能力:它不仅能判断单个事实是否满足条件,还能在多个事实之间建立相等、不等和取值集合关系。
7.3 谓词函数与 test
谓词函数(Predicate Function)返回真或假,常用于更复杂的条件判断。例如:
1 | (and (> 4 3) (> 4 5)) ; FALSE |
test 条件元素可以把任意谓词表达式放入 LHS:
1 | (age ?age) |
这个模式也可以写成更紧凑的形式:
1 | (age ?age&:(> ?age 18)) |
两者含义相同:先把年龄绑定到 ?age,再检查它是否大于
18。学习时要注意,test
不是匹配一个事实,而是在当前变量绑定已经形成后,额外判断一个布尔条件是否成立。
8 条件元素:or、and、not、exists、forall、logical
8.1 or 与 and:组合多种触发条件
or
条件元素用于表达“多个条件分支满足一个即可”。例如,关电条件可以先写成两条规则:发生洪水时关电,或者喷水灭火系统开启时关电。用
or 后,可以把它们合并为一条规则:
1 | (defrule shut-off-electricity |
and 通常用于显式组合多个条件。虽然规则 LHS
中连续写多个模式本身就近似于“与”,但在嵌套结构中 and
能表达更清楚的逻辑。例如使用二氧化碳灭火器的条件可以是:发生 B
类火灾,或者发生 C 类火灾且电源已关闭。
8.2 not:用“不存在”触发规则
not
条件元素表示不存在某个匹配事实。这里的最大数规则很典型:
1 | (defrule largest-number |
这条规则不是直接排序,而是说:如果存在一个数
?x,并且不存在任何比它更大的数 ?y,那么
?x 就是最大数。这个例子体现了 not
的推理味道:它常用于表达“没有反例”。
使用 not 时要特别注意变量绑定顺序。生日例子说明,不能在
not
内部首次绑定一个后面还要使用的变量。正确写法应当先由普通模式绑定日期,再在
not 中检查当天是否无人生日:
1 | (check-for-no-birthdays (date ?date)) |
如果把 (not (person (birthday ?date)))
放在前面,?date 没有来源,规则含义就会出问题。
8.3 exists:只关心是否至少存在一个事实
如果规则只需要在“至少存在一个 emergency”时触发一次,应该使用
exists:
1 | (defrule operator-alert-for-emergency |
如果不使用 exists,而只写
(emergency),那么每一个 emergency
事实都会产生一个激活。这里的两个紧急事实会导致输出两次;使用
exists
后,只要至少有一个紧急事实,规则整体就满足,但不会因为事实个数而重复触发同一逻辑。
8.4 forall:所有对象都满足后续条件
forall
用来表达“对所有满足第一个条件的对象,后续条件都成立”。这里的例子是:所有发生火灾的建筑都已经疏散,并且消防队已到达现场。
1 | (forall |
它的逻辑含义是:对于每一个火灾地点
?where,都必须存在对应的消防队事实和疏散事实。forall
可以看成对多个对象做一致性检查,特别适合“所有任务是否都已完成”“所有故障是否都已处理”这类问题。
等价形式为:
1 | (not (and <first-CE> |
这说明 forall
的本质是“不存在一个反例”:不存在某个对象满足第一个条件,却不满足后续条件。
8.5 logical:事实的逻辑依赖与真值维护
logical
条件元素用于建立事实之间的逻辑依赖。普通规则断言出的事实一旦进入工作记忆,通常不会因为前提事实消失而自动消失;而使用
logical 时,RHS 中断言的事实会依赖于 logical
中的前提。
例如:
1 | (defrule use-oxygen-masks |
这里 use-oxygen-masks
的合理性依赖于“有毒烟雾存在”和“正在使用气体灭火器”。如果这些逻辑前提不再成立,CLIPS
的真值维护机制可以撤销由它们支持的结论。dependents 和
dependencies
命令分别用于查看某事实支持了哪些事实,以及某事实依赖于哪些事实。
9 决策树专家系统案例
9.1 用规则表示决策树
这里的动物识别决策树从一个问题开始:动物是否为温血动物?如果不是,则猜测为蛇;如果是,再问是否会发出呼噜声,进而猜测为猫或狗。
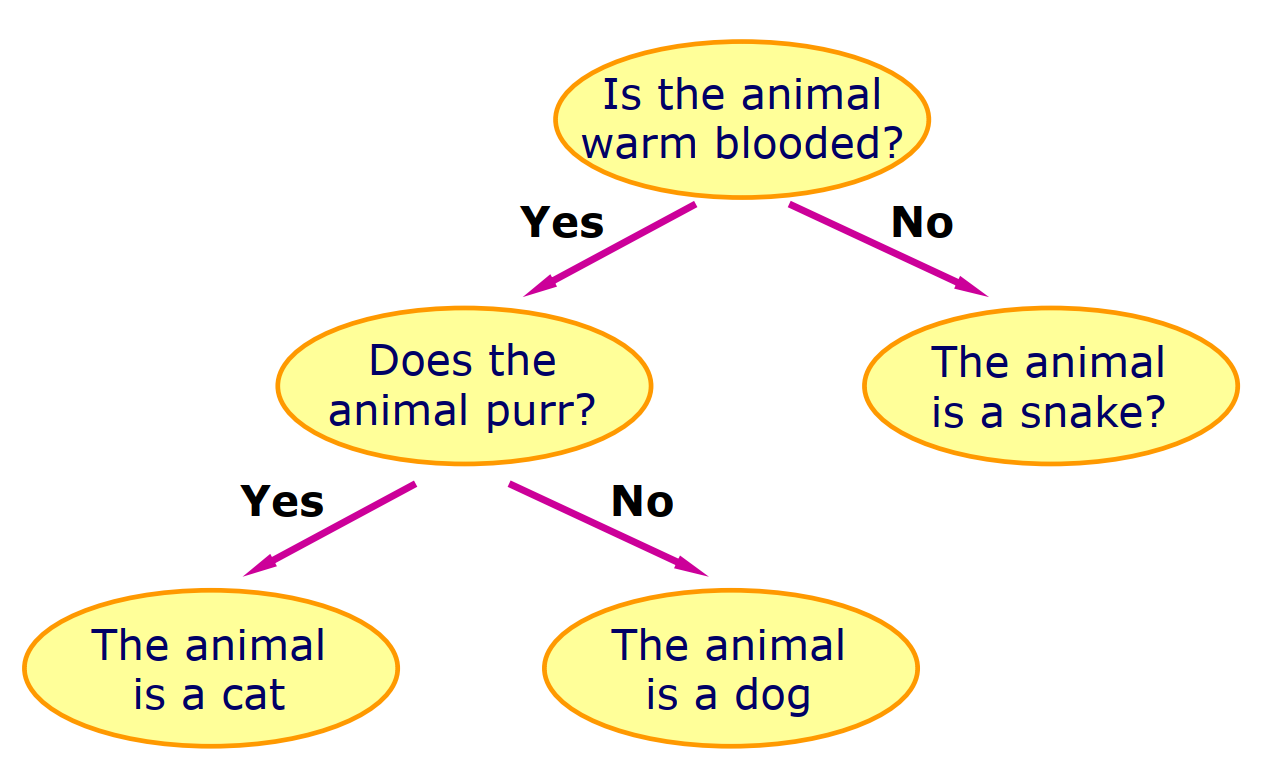
在 CLIPS 中,决策树的每个节点都可以表示成一个 node
事实:
1 | (deftemplate node |
决策节点(Decision Node)保存问题和 yes/no 分支;答案节点(Answer
Node)保存最终猜测。这样一来,程序规则不需要把树结构写死,而是通过读取
node 事实来沿树移动。
9.2 初始化与询问问题
初始化规则检查是否还没有根节点,如果没有,就从
animal.dat 加载事实,并断言当前节点为
root:
1 | (defrule initialize |
当当前节点是决策节点且尚无回答时,系统输出问题并读取用户输入:
1 | (defrule ask-decision-node-question |
如果用户输入既不是 yes 也不是
no,bad-answer
规则会撤销该回答,让系统重新提问。这个设计体现了专家系统中的交互控制:规则不仅可以推理,也可以管理对话状态。
9.3 沿 yes/no 分支前进
如果回答是
yes,系统撤销当前节点和回答事实,并断言新的当前节点为 yes
分支;如果回答是 no,则进入 no 分支。规则的核心动作是:
1 | (retract ?node ?answer) |
或:
1 | (retract ?node ?answer) |
这里的关键思想是:程序状态由事实表示,程序流程由规则改变事实来推进。这和传统程序中的循环变量、指针移动不同,但表达决策树非常自然。
9.4 猜测答案与学习新节点
当当前节点是答案节点时,系统会输出猜测,并询问用户是否正确。如果猜对,系统询问是否再来一次;如果猜错,系统进入学习流程,要求用户输入正确动物和一个能区分新旧动物的问题。
这里的学习规则会执行三步:第一,生成两个新节点名;第二,把原来的答案节点改造成决策节点;第三,断言两个新的答案节点,一个保存新动物,一个保存旧动物。其效果是把原来的一片叶子扩展成一个新的二叉分支。
这个案例的学习重点不在具体动物,而在于理解 CLIPS
如何实现“可增长的知识库”。用户纠正系统后,系统不是修改程序代码,而是修改事实文件中的决策树节点。最后通过
save-facts "animal.dat" local node
保存节点事实,下次运行时系统就拥有了新知识。
10 规则执行控制:显著性、阶段与模块
10.1 为什么需要控制规则执行顺序
在简单例子中,只要规则满足条件就执行,顺序似乎不重要。但在真实系统中,很多规则会同时被激活,例如故障检测、故障隔离、恢复处理和优先级判断可能都能匹配事实。如果不控制执行顺序,系统可能先执行恢复,再做检测,导致逻辑混乱。
这类问题可以拆成几个阶段:检测(Detection)、隔离(Isolation)、恢复(Recovery)和优先级(Priority)。执行控制的核心目标是让系统在正确阶段运行正确规则。
10.2 salience:给规则设置优先级
显著性(Salience)是规则优先级。语法是:
1 | (declare (salience <integer>)) |
取值范围通常为 \(-10000\) 到 \(10000\),默认值为 \(0\)。当议程中有多个激活时,CLIPS 会优先选择显著性更高的规则执行。
但是不要滥用 salience。错误做法是用优先级表达业务排斥关系,例如 emergency 规则 salience 为 10,important 为 5,normal 为 0。这样虽然能让 emergency 先执行,但规则之间仍然存在隐含耦合。更好的写法是在规则条件中显式写出排斥关系:
1 | (defrule situation-important |
这样规则本身就说明:只有没有 emergency 时,important 才应触发。salience 适合控制运行阶段,不适合替代业务逻辑条件。
10.3 phase 控制模式
阶段控制模式把当前阶段表示成事实,例如
(phase detection)。检测规则都要求存在
(phase detection),隔离规则要求
(phase isolation),恢复规则要求
(phase recovery):
1 | (defrule detection-rule |
阶段切换规则使用较低 salience,例如
-10,确保当前阶段的普通规则先执行完,再切换到下一阶段:
1 | (defrule detection-to-isolation |
这种设计的好处是清楚、可调试。系统为什么运行某类规则,可以从工作记忆中的
phase 事实直接看出来。
10.4 defmodule:用模块组织规则库
当规则库变大后,仅靠 phase 事实可能还不够。CLIPS
提供模块(Module)机制:
1 | (defmodule <module-name> [<comment>]) |
默认模块是 MAIN。常用命令包括:
| 命令 | 作用 |
|---|---|
(get-current-module) |
查看当前模块 |
(set-current-module <module>) |
设置当前模块 |
(focus <module-name>+) |
把模块压入焦点栈,使其规则优先执行 |
(list-focus-stack) |
查看焦点栈 |
(clear-focus-stack) |
清空焦点栈 |
(pop-focus) |
弹出当前焦点模块 |
(get-focus) |
查看当前焦点 |
这里的模块化方案定义
DETECTION、ISOLATION、RECOVERY
三个模块,并在 MAIN 中用 phase-sequence
控制焦点轮转。这样不同阶段的规则不仅在逻辑上分开,也在模块命名空间中分开。
10.5 模块间导入和导出事实模板
模块可以控制模板的可见性。一个模块可以导出模板,另一个模块可以导入模板:
1 | (defmodule DETECTION |
如果恢复模块需要读取检测模块产生的 fault
事实,就必须导入对应模板。这个机制类似编程语言中的模块接口:不是所有知识都默认全局可见,而是通过
export 和 import 明确共享边界。
10.6 initial-fact 与特殊规则
还有一种特殊规则:没有 LHS 条件,只有 RHS 动作。
1 | (defrule <rule-name> |
这类规则常用于初始化。在涉及模块时,如果规则依赖
initial-fact,需要从 MAIN
导出并在其他模块导入:
1 | (defmodule MAIN (export deftemplate initial-fact)) |
学习时不必死记所有细节,但要理解它解决的是“模块中如何触发初始化规则”的问题。
11 过程式函数与交互控制
CLIPS 虽然是规则语言,但也提供过程式函数(Procedural
Functions),例如 if 和 while。它们通常写在
RHS 中,用来处理用户交互和局部控制。
if 的基本形式是:
1 | (if <predicate-expression> |
while 的基本形式是:
1 | (while <predicate-expression> |
这里的继续检查规则可以理解为:系统进入 check-continue
阶段后,询问用户是否继续;如果输入不是 yes 或
no,就循环提问;如果回答 yes,断言
(phase continue);否则执行 halt 停止系统。
1 | (while (and (neq ?answer yes) (neq ?answer no)) |
这里 bind 用于给变量赋值,halt
用于停止推理机。它说明 CLIPS
不是纯粹的逻辑规则系统,在需要时也能写出过程式控制,但从风格上看,仍应让主要推理逻辑留在规则和事实中。
12 监控系统案例:传感器、趋势与告警
12.1 问题背景
设备监控系统可以作为执行控制的例子:多个传感器监测多个设备,每个传感器有低红线、低警戒线、高警戒线和高红线。系统根据传感器读数判断状态,并决定是否告警或关闭设备。
【图片占位:传感器与设备连接示意图】
红线和警戒线的含义可以概括为:
| 区间 | 条件 | 系统反应 |
|---|---|---|
| 低红线 | 读数小于等于低红线 | 立即关闭设备 |
| 低警戒区 | 大于低红线且小于等于低警戒线 | 发出警告;若持续一定周期则关闭 |
| 正常区 | 大于低警戒线且小于高警戒线 | 状态正常 |
| 高警戒区 | 大于等于高警戒线且小于高红线 | 发出警告;若持续一定周期则关闭 |
| 高红线 | 大于等于高红线 | 立即关闭设备 |
这个案例把前面所有知识串起来:模板定义数据结构,模块划分阶段,规则读取输入、判断趋势、产生告警,事实修改推动系统周期性运行。
12.2 设备与传感器模板
设备模板保存设备名和开关状态:
1 | (deftemplate MAIN::device |
传感器模板保存传感器名、所属设备、当前原始值、状态和四条阈值线:
1 | (deftemplate MAIN::sensor |
这里 raw-value 可以是数字,也可以是符号
none。这是一种常见的状态设计:当传感器值尚未读取或已经处理完时,用
none 表示“当前没有待处理读数”。
12.3 周期运行与模块焦点
系统用 (cycle 0)
表示当前周期,从事实数据中读取每个周期的传感器值。Begin-Next-Cycle
规则每次把周期数加 1,并把焦点设置为
INPUT、TRENDS、WARNINGS:
1 | (defrule MAIN::Begin-Next-Cycle |
这意味着每个周期中,系统先读取输入,再判断趋势,最后产生告警。模块焦点在这里承担了“调度器”的角色。
12.4 INPUT 模块:读取传感器值
INPUT 模块导入 MAIN 中的所有内容,并定义
fact-data-for-sensor 保存预置输入序列:
1 | (deftemplate INPUT::fact-data-for-sensor |
读取规则从每个传感器的数据列表中取出一个值,写入对应
sensor 的
raw-value,并从数据列表中删除该值:
1 | (modify ?s (raw-value ?raw-value)) |
如果某个传感器已经没有数据,而系统仍需要读取,No-Fact-Data-Values-Left
规则会打印提示并
halt。这体现了输入模块的职责:它不判断是否异常,只负责把原始数据放到工作记忆中。
12.5 TRENDS 模块:把原始值转化为状态
TRENDS
模块根据传感器阈值判断状态。正常状态规则可以概括为:若原始值大于低警戒线且小于高警戒线,则状态为
normal,并清空 raw-value。
1 | (test (and (> ?raw-value ?lgl) |
高警戒线状态规则则判断:
1 | (test (and (>= ?raw-value ?hgl) |
类似地,还应有高红线、低警戒线、低红线状态规则。判断完成后把
raw-value 设回
none,表示该周期读数已处理。
12.6 趋势事实:记录状态持续时间
单个周期的状态不足以决定是否关闭设备,因为警戒区通常允许短时间波动。系统使用
sensor-trend
记录某个传感器当前状态从哪个周期开始、到哪个周期结束,以及持续多少周期后应关闭设备:
1 | (deftemplate MAIN::sensor-trend |
如果新状态和趋势事实中的旧状态相同,State-Has-Not-Changed
规则只更新结束周期;如果状态变化,State-Has-Changed
规则把开始周期、结束周期和状态都改成当前周期的新状态。持续时间可以用公式理解为:
\[ \text{duration} = \text{end} - \text{start} + 1 \]
这个公式解释了为什么这里的规则写作
(+ (- ?end ?start) 1)。
12.7 WARNINGS 模块:告警与关停设备
WARNINGS
模块根据趋势事实决定输出警告还是关闭设备。红线区规则最直接:只要状态为
high-red-line 或
low-red-line,并且对应设备仍为
on,就立即打印告警并把设备状态改为 off。
警戒区规则则需要检查持续时间。如果传感器处于
high-guard-line 或
low-guard-line,且持续时间大于等于
shutdown-duration,系统关闭设备;否则只打印传感器处于警戒区的提示。
这个案例的关键不是记住每条规则,而是理解分层结构:
INPUT把外部数据变成事实。TRENDS把事实读数变成状态和趋势。WARNINGS根据趋势产生可执行动作。
这种结构让每个模块职责清楚,也让规则库更容易维护。
13 推理引擎、模式匹配网络与效率优化
13.1 识别-行动循环
CLIPS 推理机的核心过程是识别-行动循环(Recognize-Act Cycle)。每一轮大致包括四步:
- 匹配(Match):检查哪些规则的 LHS 被当前事实满足,更新议程。
- 冲突消解(Conflict Resolution):如果议程中有多个激活,选择优先级最高或符合策略的一个。
- 行动(Act):执行所选规则 RHS,随后从议程中移除该激活。
- 停止检查(Check for Halt):如果执行了
halt、用户中断或没有激活,则停止;否则进入下一轮。
这解释了为什么 CLIPS 程序看起来没有主函数。真正的“主循环”在推理机中,用户写的是事实、规则和控制策略。
13.2 模式网络与连接网络
规则匹配的关键问题是如何高效搜索事实。朴素做法是每次事实变化后重新检查所有规则和所有事实,但这会非常慢。CLIPS 使用类似 Rete 的模式匹配思想,把规则条件组织成网络,复用不同规则之间的共同匹配结果。
可以粗略区分两类网络:
- 模式网络(Pattern Network)负责判断单个事实是否满足某个模式,例如某槽是否等于常量、是否不等于某值。
- 连接网络(Join
Network)负责把多个模式的匹配结果连接起来,例如第一个模式中绑定的
?x是否等于第二个模式中的某个槽值。
这里的 sharing-1 和 sharing-2
规则展示了规则共享:两条规则有相似的前两个模式,因此匹配网络可以复用部分中间结果。理解到这一层即可,不需要手动画完整网络。
13.3 模式顺序为什么影响效率
good-match 和 bad-match
可以说明模式顺序的重要性。good-match
先匹配非常具体的事实:
1 | (find-match ?x ?y ?z ?w) |
因为 (find-match a c e g) 只有一个事实,它首先把
?x ?y ?z ?w 绑定为 a c e g,后面的
item 模式就只需要检查这些具体值是否存在。
bad-match 则先写四个宽泛的
(item ?x)、(item ?y)、(item ?z)、(item ?w),最后才写
(find-match ?x ?y ?z ?w)。如果有 7 个 item
事实,前四个模式会产生大量组合,理论上组合数可接近 \(7^4=2401\),再到最后才被
find-match 过滤。这种坏规则甚至可能耗尽内存。
因此,最具体、匹配事实最少、最能绑定变量的模式应尽量放在前面。
13.4 多字段通配符的组合爆炸
对于事实:
1 | (list (items x 5 y 9)) |
模式:
1 | (list (items $?a $?b $?c)) |
会有很多种拆分方式,因为
$?a、$?b、$?c
每个都可以匹配不同长度的字段序列。多种匹配尝试说明了多字段通配符会带来组合爆炸:字段越多,多字段变量越多,可能的拆分方式越多。
因此在规则设计中,只有当字段长度确实不确定时才使用
$?;如果能用固定字段或单字段变量表达,就不要把问题写成多字段匹配。
13.5 test 条件应尽早放置
test
可以过滤变量组合,但它只有在相关变量已绑定后才能执行。以“三个不同点”为例:如果先匹配三个
point 事实,再用一个大 test
判断三者是否不同,系统会先生成大量三元组,再过滤掉重复点。更好的写法是在第二个点匹配后立刻测试它和第一个点不同,再匹配第三个点并测试第三个点与前两个点都不同。
这种优化原则可以概括为:一旦变量足够,能过滤多少就尽早过滤多少。这会减少后续连接网络需要保存和扩展的部分匹配数量。
13.6 优先使用内建模式约束
如果一个条件可以写成内建连接约束,就不要写成复杂的谓词函数。例如判断颜色是否为三原色,可以写:
1 | (color ?x&red|green|blue) |
而不是:
1 | (color ?x&:(or (eq ?x red) |
两者逻辑上等价,但内建模式匹配约束更容易被匹配网络优化。规则优化时可以把这一点概括为:让 CLIPS 的模式匹配机制直接做过滤,而不是把所有过滤都推迟到通用函数调用中。
13.7 效率优化规则汇总
CLIPS 规则效率优化建议可以整理如下:
| 优化建议 | 原因 |
|---|---|
| 最具体的模式放前面 | 越早绑定变量,后续组合越少 |
| 匹配易变事实的模式放后面 | 易变事实频繁更新,会导致议程和部分匹配频繁变化 |
| 匹配事实最少的模式放前面 | 减少部分匹配数量 |
| 限制多字段通配符和多字段变量数量 | 避免字段拆分组合爆炸 |
test 条件尽量靠前 |
尽早过滤不合法变量组合 |
| 使用内建连接约束代替等价谓词表达式 | 让模式网络直接优化匹配 |
| 减少事实数量,只在需要时加载事实 | 工作记忆越大,匹配成本越高 |
14 事实文件的加载与保存
CLIPS 可以从外部文件加载事实,也可以把事实保存到文件中:
1 | (load-facts <file-name>) |
其中 <save-scope> 可以是 visible 或
local。事实文件的内容通常就是一行行事实,例如:
1 | (data 34) |
在决策树案例中,load-facts "animal.dat"
用来加载已有动物知识,save-facts "animal.dat" local node
用来保存学习后的节点事实。在监控系统案例中,事实文件或预置事实可以作为传感器数据来源。学习时可以把它理解为
CLIPS 与外部持久化数据之间的桥梁。
15 总结
15.1 运行主线
本章的主线是:CLIPS
用事实表示当前状态,用规则表示专家知识,用推理机把事实和规则匹配起来,并通过议程控制规则执行。
如果工作记忆发生变化,规则激活也会变化;如果规则执行了
assert、retract 或
modify,系统状态又会进一步变化。整个程序就是在这种“事实变化-规则触发-事实再变化”的循环中运行。
15.2 核心概念关系
| 概念 | 英文 | 说明 |
|---|---|---|
| 事实 | Fact | 工作记忆中的当前信息 |
| 工作记忆 | Working Memory | 保存事实的动态区域 |
| 模板 | Template | 用 deftemplate
定义事实结构 |
| 槽 | Slot | 模板事实中的字段 |
| 多字段槽 | Multislot | 可容纳多个字段的槽 |
| 规则 | Rule | 用 defrule
定义的条件-动作知识 |
| 左部 | LHS | 规则条件部分 |
| 右部 | RHS | 规则动作部分 |
| 议程 | Agenda | 已匹配、等待执行的规则激活 |
| 显著性 | Salience | 规则优先级 |
| 条件元素 | Conditional Element | or、not、exists、forall
等 LHS 结构 |
| 焦点 | Focus | 当前优先执行规则的模块 |
| 识别-行动循环 | Recognize-Act Cycle | 推理机的匹配、选择、执行循环 |
15.3 常见设计陷阱
deftemplate是定义结构,deffacts是定义初始事实集合,assert是运行时加入事实。?x匹配一个字段,$?x匹配零个或多个字段;多字段变量很强大,但容易造成匹配爆炸。- 在
not中不要首次绑定后续要用的变量,应先在普通模式中绑定,再用not检查不存在性。 exists用来避免因为多个事实而重复触发同一类存在性规则。forall的直观含义是“没有反例”,即不存在满足第一个条件但不满足后续条件的对象。- salience 是执行控制工具,不应替代业务条件;业务上的互斥最好写进 LHS。
- 规则效率很依赖模式顺序,具体模式、少匹配模式和早期过滤条件应尽量靠前。