目录
- 机器学习中的强化学习位置
- 强化学习问题建模
- 多臂老虎机问题与探索-利用
- Bellman 方程与广义策略迭代
- Monte Carlo 方法
- Temporal-Difference Learning
- SARSA 与 Q-Learning
- Model-based Methods
- Policy Gradient Methods
- n-step Bootstrapping 与 Eligibility Traces
- 深度强化学习与多智能体自课程
- 强化学习的挑战与核心内容
1 机器学习中的强化学习位置
1.1 三类机器学习任务
在机器学习的大背景下,常见任务可以粗略分为三类:监督学习(Supervised Learning)、无监督学习(Unsupervised Learning) 和 强化学习(Reinforcement Learning, RL)。
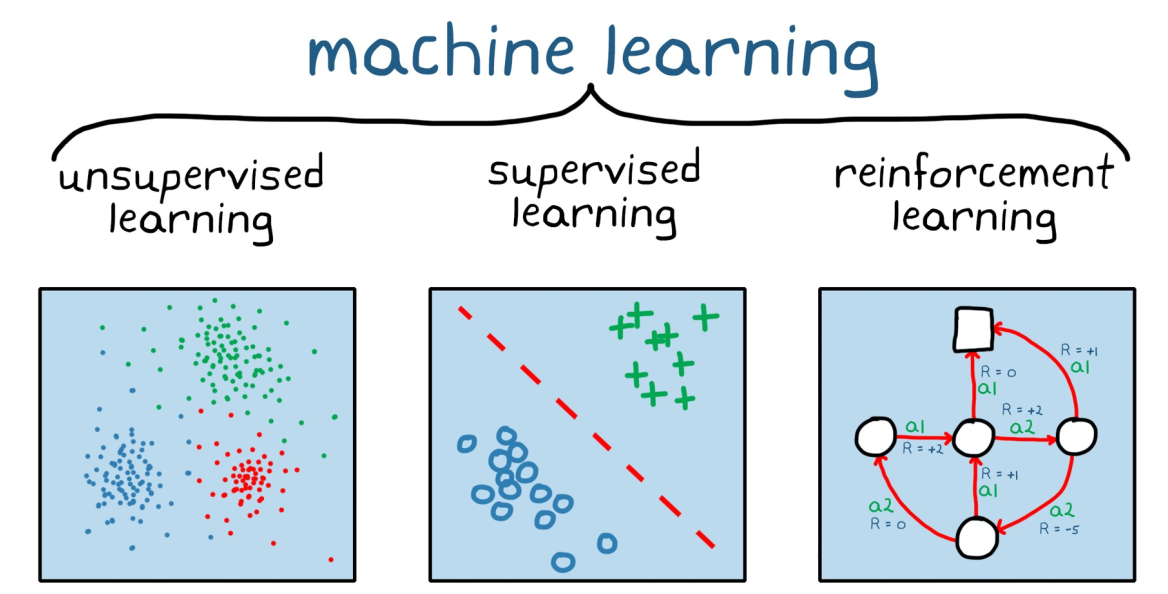
监督学习的特点是训练数据中已经有“标准答案”。例如图像分类中,每张图片都带有“猫”“狗”“车”等标签,模型学习的是从输入图片到输出标签的映射。学习过程中,如果模型预测错了,我们马上知道错在哪里,因为标签就是答案。
无监督学习没有人工给出的标签。模型面对的是一堆未标注数据,需要自己发现数据内部结构。例如把用户按购买习惯聚成几类,或者把高维数据压缩到低维空间中进行可视化。它的重点不是“预测正确标签”,而是“发现隐藏模式”。
强化学习则不同。强化学习研究的是一个智能体(agent) 如何在环境中不断行动,并根据环境返回的奖励(reward) 来学习更好的决策方式。它没有每一步的标准答案,只有行动之后得到的反馈,而且这个反馈可能很晚才出现。
| 学习方式 | 输入数据特点 | 学习目标 | 典型例子 |
|---|---|---|---|
| 监督学习 | 有标签样本 | 学会输入到标签的映射 | 图片分类、垃圾邮件识别 |
| 无监督学习 | 无标签样本 | 发现数据结构 | 聚类、降维 |
| 强化学习 | 智能体与环境交互得到经验 | 学会最大化长期奖励的策略 | 走迷宫、下棋、机器人控制 |
1.2 为什么强化学习更像“学会做事”
强化学习不是一次性判断一个样本属于什么类别,而是要在连续时间中做一串决策。一个动作的好坏不一定能立刻看出来,因为它可能影响很多步之后的结果。
例如玩迷宫游戏时,某一步向左走可能暂时没有奖励,但它可能让智能体绕开死路,最终更快到达终点;某一步向右走可能马上获得一个小奖励,但之后进入陷阱。强化学习关心的不是单步奖励最大,而是从当前开始到未来的累计收益最大。
因此,强化学习天然包含几个难点:
| 难点 | 含义 | 例子 |
|---|---|---|
| 延迟奖励 | 当前动作的后果可能以后才体现 | 现在做的选择,可能几步之后才知道好坏 |
| 连续决策 | 每一步动作会改变后续可选状态 | 下棋时一步棋会影响之后整局棋 |
| 探索与利用 | 要在尝试新动作和使用已知好动作之间平衡 | 既要试新餐厅,也不能总错过已知好餐厅 |
| 不确定性 | 同样动作不一定每次产生同样结果 | 市场、游戏对手、物理环境都可能变化 |
主线可以概括为:强化学习要解决“怎样评价状态和动作的好坏”,以及“怎样根据这些评价改进策略”。
2 强化学习问题建模
2.1 迷宫问题中的交互闭环
迷宫问题可以展示强化学习最基本的交互结构。迷宫中有一个智能体,例如老鼠或机器人。它能观察到当前处境,选择向上、向下、向左、向右等动作。环境根据动作改变状态,并返回一个奖励。例如到达奶酪位置给正奖励,撞墙给负奖励,普通移动给零奖励或小负奖励。
这个闭环可以写成:
- 智能体观察当前状态 \(S_t\)。
- 智能体根据策略选择动作 \(A_t\)。
- 环境接收动作,转移到新状态 \(S_{t+1}\)。
- 环境给出奖励 \(R_{t+1}\)。
- 智能体根据新经验更新对环境和动作的认识。
注意奖励下标常写成 \(R_{t+1}\),意思是“在时刻 \(t\) 做动作之后,于下一时刻收到的奖励”。这看起来有点绕,但它强调奖励是动作的结果。
一个 episode 可以理解为一次完整尝试。例如老鼠从起点出发,到找到奶酪或失败结束,这条完整轨迹就是一个 episode。强化学习算法会从很多 episode 中逐渐学习。
2.2 基本符号
| 符号 | 英文 | 含义 | 迷宫例子 |
|---|---|---|---|
| \(S\) | state set | 所有可能状态的集合 | 迷宫中所有格子位置,或者位置加方向、能量等信息 |
| \(A\) | action set | 所有可能动作的集合 | 上、下、左、右、停留 |
| \(R\) | reward set | 所有可能奖励的集合 | 到达终点 \(+10\),撞墙 \(-1\),普通移动 \(0\) |
| \(\pi(a\mid s)\) | policy | 在状态 \(s\) 选择动作 \(a\) 的概率 | 在某格子向右走的概率是 \(0.7\) |
| \(v_\pi(s)\) | state value | 按策略 \(\pi\) 行动时,状态 \(s\) 的长期价值 | 从这个格子出发,平均最终能得到多少奖励 |
| \(q_\pi(s,a)\) | action value | 按策略 \(\pi\) 行动时,在 \(s\) 做 \(a\) 的长期价值 | 在这个格子先向右走,后面继续按策略行动,平均能得到多少奖励 |
策略(policy) 是强化学习中最核心的对象之一。它回答的问题是:在某个状态下应该选择哪个动作。如果策略是确定性的,那么每个状态只对应一个动作;如果策略是随机的,那么每个状态对应一个动作概率分布。
例如在某个迷宫格子中:
\[ \pi(\text{右}\mid s)=0.6,\quad \pi(\text{上}\mid s)=0.2,\quad \pi(\text{左}\mid s)=0.1,\quad \pi(\text{下}\mid s)=0.1. \]
这表示智能体大多数时候向右走,但偶尔也会尝试别的方向。
2.3 状态价值与动作价值的区别
状态价值 \(v_\pi(s)\) 和动作价值 \(q_\pi(s,a)\) 很容易混淆。可以用一句话区分:
\(v_\pi(s)\) 评价“我站在这里有多好”;\(q_\pi(s,a)\) 评价“我站在这里并且先做这个动作有多好”。
假设在迷宫某个交叉路口,向右是终点方向,向左是死路。如果只看状态价值 \(v_\pi(s)\),它告诉我们这个路口整体上好不好;如果看动作价值 \(q_\pi(s,\text{右})\) 和 \(q_\pi(s,\text{左})\),它会告诉我们在这个路口右转和左转分别有多好。
为什么动作价值很重要?因为要改进策略时,智能体最终要选择动作。如果知道每个动作的 \(q_\pi(s,a)\),就可以直接选价值最大的动作:
\[ \pi'(s)=\arg\max_a q_\pi(s,a). \]
2.4 回报与折扣因子
强化学习优化的是从当前时刻开始的累计奖励,称为回报(return):
\[ G_t = R_{t+1} + \gamma R_{t+2} + \gamma^2 R_{t+3} + \cdots = \sum_{k=0}^{\infty}\gamma^k R_{t+k+1}. \]
这个公式可以逐项理解:
| 项 | 含义 |
|---|---|
| \(R_{t+1}\) | 当前动作之后马上得到的奖励 |
| \(\gamma R_{t+2}\) | 下一步奖励,乘一次折扣 |
| \(\gamma^2 R_{t+3}\) | 再下一步奖励,乘两次折扣 |
| \(\gamma^k\) | 距离现在越远,折扣次数越多 |
\(\gamma \in [0,1]\) 称为折扣因子(discount factor)。它控制智能体有多重视未来。
如果 \(\gamma=0\),则 \(G_t=R_{t+1}\),智能体只关心眼前奖励。如果 \(\gamma\) 接近 \(1\),未来奖励几乎和当前奖励同样重要。迷宫中如果只关心眼前奖励,智能体可能会原地拿小奖励;如果重视长期奖励,它更可能为了终点大奖励暂时绕路。
一个简单数值例子:假设未来三步奖励是 \(1,1,10\)。
当 \(\gamma=0.5\) 时:
\[ G_t=1+0.5\times 1+0.5^2\times 10=4. \]
当 \(\gamma=0.9\) 时:
\[ G_t=1+0.9\times 1+0.9^2\times 10=10. \]
同样的奖励序列,在更大的 \(\gamma\) 下价值更高,因为智能体更重视远期的大奖励。
3 多臂老虎机问题与探索-利用
3.1 Bandit 是最简单的强化学习问题
多臂老虎机问题(Multi-armed Bandit Problem)是强化学习的入门模型。它的名字来自赌场里的老虎机:一台机器上有一个拉杆,玩家拉一下拉杆,机器可能吐出奖励,也可能什么都没有。“多臂”指的是现在有很多个拉杆,或者很多台可选机器,每次只能选择其中一个去拉。
如果你没玩过老虎机,可以把它想成下面这个普通选择问题:桌上有四个按钮,每次你只能按一个按钮。按下按钮后,系统可能给你 \(1\) 分,也可能给你 \(0\) 分。每个按钮背后都有一个固定但你不知道的“中奖概率”。例如:
| 按钮 | 真实中奖概率 | 你一开始是否知道 |
|---|---|---|
| A | \(70\%\) | 不知道 |
| B | \(30\%\) | 不知道 |
| C | \(55\%\) | 不知道 |
| D | \(40\%\) | 不知道 |
如果你事先知道这些概率,问题就很简单:永远按 A,因为 A 的期望收益最高。但在强化学习里,智能体一开始不知道这些概率,只能通过一次次尝试来估计哪个按钮更好。
在这个问题里:
| 强化学习概念 | 多臂老虎机里的含义 |
|---|---|
| 智能体 | 做选择的人或程序 |
| 动作 | 选择哪个按钮或哪台机器 |
| 奖励 | 按下后得到的分数,例如成功为 \(1\)、失败为 \(0\) |
| 动作价值 | 某个按钮平均能带来多少奖励 |
| 策略 | 当前决定怎么选按钮的方法 |
多臂老虎机和完整强化学习问题相比,最大的简化是:它没有复杂的状态变化。在迷宫问题中,向上走会改变当前位置;但在 Bandit 问题中,每次选择后通常又回到同样的选择场景。因此可以把它看作“只有一个状态、多个动作”的强化学习问题。
Bandit 问题的目标不是每台机器都试一样多,而是尽快发现哪台机器收益高,并尽量多选择它。但是如果太早认定某台机器最好,就可能错过真正更好的机器。
例如你前两次按 A 都失败,前两次按 C 都成功,并不代表 C 一定比 A 好,因为这可能只是随机波动。智能体必须一边利用当前看起来好的动作,一边继续探索其他动作。这就是后面要讲的探索与利用的权衡。
3.2 动作价值估计:用平均奖励估计好坏
设某个动作已经被选过 \(n-1\) 次,得到的奖励分别是:
\[ R_1,R_2,\ldots,R_{n-1}. \]
那么第 \(n\) 次选择前,我们对这个动作价值的估计是:
\[ Q_n = \frac{R_1 + R_2 + \cdots + R_{n-1}}{n-1}. \]
这个公式就是样本平均。它背后的想法很朴素:如果一个动作过去平均奖励高,就认为它未来也可能奖励高。
例如某台老虎机被拉了 \(4\) 次,奖励是 \(1,0,1,1\),则估计价值为:
\[ Q_5=\frac{1+0+1+1}{4}=0.75. \]
这表示在已有经验下,我们估计这台机器成功率约为 \(75\%\)。
3.3 为什么要用增量更新
如果每次都从头计算平均值,需要保存所有历史奖励。更方便的做法是使用增量形式:
\[ Q_{n+1} = Q_n + \frac{1}{n}[R_n - Q_n]. \]
如果新奖励 \(R_n\) 比旧估计 \(Q_n\) 大,那么 \(R_n-Q_n>0\),估计值上调;如果新奖励更小,估计值下调。
例如,某动作当前估计 \(Q_4=0.6\),这是前 \(3\) 次的平均值。第 \(4\) 次得到奖励 \(R_4=1\),则:
\[ Q_5=0.6+\frac{1}{4}(1-0.6)=0.6+0.1=0.7. \]
新奖励比旧估计高,所以价值估计上升。
3.4 平稳与非平稳环境
如果每个动作的奖励分布不随时间变化,称为平稳环境(stationary environment)。在这种情况下,普通样本平均很好,因为越多历史样本通常越可靠。
但如果环境会变化,称为非平稳环境(nonstationary environment)。例如一个广告推荐系统中,用户兴趣会随时间变化;股票交易环境中,市场状态也会变。此时很久以前的数据不一定有参考价值。
常数步长更新为:
\[ Q_{n+1}=Q_n+\alpha[R_n-Q_n]. \]
与 \(\frac{1}{n}\) 不同,\(\alpha\) 是固定学习率。这样新数据永远有固定影响力,旧数据会逐渐被遗忘。
展开后:
\[ Q_{n+1} = (1-\alpha)^n Q_1 + \sum_{i=1}^{n}\alpha(1-\alpha)^{n-i}R_i. \]
这个公式说明:越新的奖励 \(R_i\),权重越大;越旧的奖励,乘上的 \((1-\alpha)\) 次数越多,影响越小。可以把它理解为“带遗忘机制的平均”。
3.5 \(\epsilon\)-greedy:探索与利用的平衡
这里的简单 Bandit 算法使用 \(\epsilon\)-greedy 策略。它的规则很直接:
- 以概率 \(1-\epsilon\) 选择当前估计价值最高的动作。
- 以概率 \(\epsilon\) 随机选择一个动作。
例如 \(\epsilon=0.1\),表示 \(90\%\) 的时候选择当前看起来最好的动作,\(10\%\) 的时候随机探索。
为什么不能永远选当前最好的动作?因为一开始的估计可能不准。假设有四台老虎机,真实成功率分别是 \(70\%\)、\(30\%\)、\(55\%\)、\(40\%\)。如果你第一次试 \(55\%\) 的机器刚好成功,而 \(70\%\) 的机器第一次刚好失败,短期数据会误导你。如果完全贪心,可能长期选择次优动作。
为什么不能一直随机探索?因为那样会浪费大量机会在低收益动作上。强化学习需要的是在学习过程中逐渐把更多选择分配给高价值动作。
3.6 Bandit 算法完整理解
Bandit 算法要做的核心事情,是通过反复尝试和观察奖励,估计每个动作 \(a\) 的价值 \(Q(a)\),也就是“选择这个动作平均能得到多少奖励”。估计出 \(Q(a)\) 后,智能体就可以更多选择价值高的动作,同时保留少量探索机会。
简单 Bandit 算法可以解释为:
- 对每个动作 \(a=1,\ldots,k\),初始化:
\[ Q(a)=0,\quad N(a)=0. \]
\(N(a)\) 表示动作 \(a\) 被选过的次数。
- 不断重复:
以概率 \(1-\epsilon\) 选择:
\[ a^*=\arg\max_a Q(a). \]
以概率 \(\epsilon\) 随机选择一个动作,并把本轮实际选中的动作也记为 \(a^*\)。
执行动作 \(a^*\),观察奖励 \(R\)。
更新选择次数:
\[ N(a^*)\leftarrow N(a^*)+1. \]
- 更新动作价值:
\[ Q(a^*)\leftarrow Q(a^*)+\frac{1}{N(a^*)}[R-Q(a^*)]. \]
这个算法体现了强化学习的一个基本范式:先根据当前估计做动作,再用反馈修正估计,之后再用新的估计做更好的动作。
4 Bellman 方程与广义策略迭代
4.1 从回报到价值函数
在这一节中,\(G_t\) 表示从时刻 \(t\) 开始往未来看的总回报(return)。它不是某一步的即时奖励,而是从当前状态出发,之后所有奖励按折扣因子 \(\gamma\) 加权求和的结果:
\[ G_t = R_{t+1}+\gamma R_{t+2}+\gamma^2R_{t+3}+\cdots =\sum_{k=0}^{\infty}\gamma^kR_{t+k+1}. \]
这里 \(R_{t+1}\) 是当前动作之后马上得到的奖励,\(R_{t+2}\) 是再下一步奖励,依此类推。\(\gamma\) 用来降低远期奖励的权重。例如 \(\gamma=0.9\) 时,两步后的奖励会乘上 \(0.9^2\)。所以 \(G_t\) 可以理解为:“如果我现在在时刻 \(t\),从现在开始一路走下去,最终累计能得到多少收益。”
有了 \(G_t\),价值函数才有定义基础。价值函数本质上就是在问:从某个状态或状态-动作对开始,未来的 \(G_t\) 平均会是多少?
状态价值函数定义为:
\[ v_\pi(s)=\mathbb{E}_\pi[G_t\mid S_t=s]. \]
这句话的意思是:如果当前处在状态 \(s\),之后一直按照策略 \(\pi\) 行动,那么从现在开始能获得多少回报。因为环境可能随机、策略也可能随机,所以要取期望。
动作价值函数定义为:
\[ q_\pi(s,a)=\mathbb{E}_\pi[G_t\mid S_t=s,A_t=a]. \]
它比状态价值多指定了第一步动作 \(a\)。第一步做完以后,后续仍然按策略 \(\pi\) 行动。
4.2 Bellman 方程的直观含义
Bellman 方程(Bellman Equation)是强化学习最重要的公式之一。它说的是:
一个状态的价值 = 当前一步能得到的奖励 + 下一状态的折扣后价值。
从回报定义出发:
\[ G_t = R_{t+1}+\gamma G_{t+1}. \]
这一步只是把“从 \(t\) 开始的总回报”拆成两部分:第一部分是下一步马上拿到的奖励 \(R_{t+1}\),第二部分是从 \(t+1\) 开始继续往后的总回报 \(G_{t+1}\),但未来回报要乘折扣因子 \(\gamma\)。
接下来从状态价值函数定义开始推导。状态价值是:
\[ v_\pi(s) = \mathbb{E}_\pi[G_t\mid S_t=s]. \]
把 \(G_t=R_{t+1}+\gamma G_{t+1}\) 代入:
\[ v_\pi(s) = \mathbb{E}_\pi[R_{t+1}+\gamma G_{t+1}\mid S_t=s]. \]
现在问题变成:当已知当前状态是 \(s\) 时,下一步会发生什么?下一步的不确定性主要来自两层:
- 智能体会按照策略 \(\pi\) 选择动作 \(a\),概率是 \(\pi(a\mid s)\)。
- 环境在收到动作 \(a\) 后,会随机给出奖励 \(r\) 并转移到下一状态 \(s'\),概率是 \(p(s',r\mid s,a)\)。
因此,要对所有可能动作求加权平均:
\[ v_\pi(s) = \sum_a \pi(a\mid s) \mathbb{E}_\pi[R_{t+1}+\gamma G_{t+1}\mid S_t=s,A_t=a]. \]
这一步的意思是:当前在状态 \(s\) 时,可能选择不同动作;每个动作对最终价值的贡献,要按该动作被策略选中的概率加权。
接着,对给定动作 \(a\) 后可能出现的下一状态 \(s'\) 和奖励 \(r\) 再展开:
\[ v_\pi(s) = \sum_a \pi(a\mid s) \sum_{s',r}p(s',r\mid s,a) \mathbb{E}_\pi[R_{t+1}+\gamma G_{t+1} \mid S_t=s,A_t=a,S_{t+1}=s',R_{t+1}=r]. \]
在这个条件下,\(R_{t+1}\) 已经确定等于 \(r\),所以可以替换:
\[ v_\pi(s) = \sum_a \pi(a\mid s) \sum_{s',r}p(s',r\mid s,a) [r+\gamma \mathbb{E}_\pi[G_{t+1}\mid S_{t+1}=s']]. \]
而根据状态价值函数的定义,从下一状态 \(s'\) 开始、继续按策略 \(\pi\) 行动的期望回报就是:
\[ \mathbb{E}_\pi[G_{t+1}\mid S_{t+1}=s']=v_\pi(s'). \]
于是得到:
\[ v_\pi(s) = \sum_a \pi(a\mid s) \sum_{s',r}p(s',r\mid s,a) [r+\gamma v_\pi(s')]. \]
这就是状态价值函数的 Bellman 方程:
\[ v_\pi(s) = \sum_a \pi(a\mid s) \sum_{s',r}p(s',r\mid s,a) [r+\gamma v_\pi(s')], \quad \forall s\in S. \]
逐项解释如下:
| 符号 | 含义 |
|---|---|
| \(\sum_a \pi(a\mid s)\) | 按策略 \(\pi\) 对所有可能动作加权平均 |
| \(p(s',r\mid s,a)\) | 执行动作 \(a\) 后到达 \(s'\) 并得到奖励 \(r\) 的概率 |
| \(r\) | 这一步的即时奖励 |
| \(\gamma v_\pi(s')\) | 下一状态未来价值的折扣 |
| \([r+\gamma v_\pi(s')]\) | 选择动作并转移后得到的一步奖励加未来价值 |
初学者可以把 Bellman 方程想成“拆账”:今天的总价值可以拆成今天马上拿到的钱,加上明天开始还能赚的钱。
4.3 为什么 Bellman 方程有用
Bellman 方程有用,是因为它把一个长远问题变成了局部递推问题。我们不必一次性看完整个未来,只要知道下一步奖励和下一状态价值,就能更新当前状态价值。
这也是后面很多算法的基础:
| 算法思想 | 和 Bellman 方程的关系 |
|---|---|
| 动态规划 | 已知环境模型时,直接用 Bellman 方程迭代求价值 |
| TD 学习 | 不知道模型时,用实际采样到的 \(R,S'\) 近似 Bellman 更新 |
| Q-Learning | 用最大下一动作价值构造最优 Bellman 目标 |
| 策略迭代 | 先用 Bellman 方程评估策略,再用价值改进策略 |
4.4 广义策略迭代
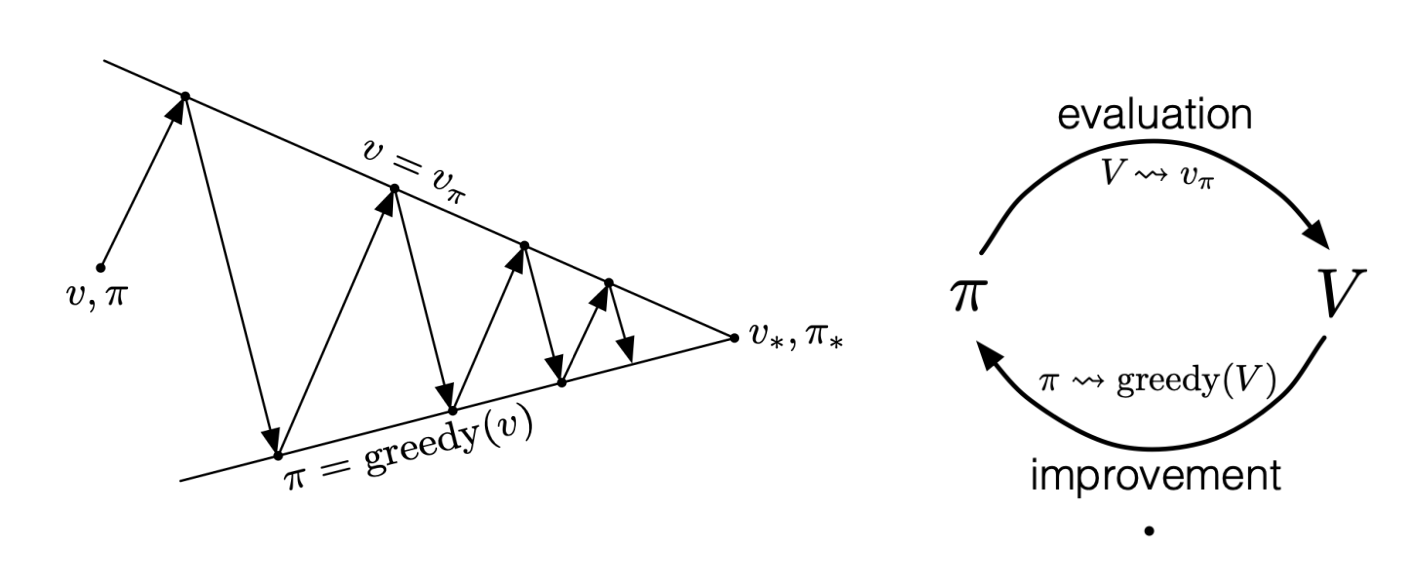
广义策略迭代(Generalized Policy Iteration, GPI)由两个交替过程组成:
| 过程 | 问的问题 | 做的事 |
|---|---|---|
| 策略评估(policy evaluation) | 当前策略好不好? | 估计 \(v_\pi\) 或 \(q_\pi\) |
| 策略改进(policy improvement) | 能不能根据价值选更好的动作? | 用价值函数产生更优策略 |
这两个过程会互相影响。策略评估让我们知道当前策略的价值;策略改进改变策略后,原来的价值估计又不完全准确,于是需要重新评估。不断交替后,希望策略和值函数一起接近最优。
可以用学习走迷宫理解:
- 先按照当前走法走很多次,估计每个位置好不好。
- 发现某些位置向右走比向左走更好,于是修改走法。
- 走法改了以后,再重新估计每个位置好不好。
- 重复直到走法稳定。
4.5 策略迭代算法
这里的策略迭代(Policy Iteration)是一种典型的动态规划方法,通常假设已知环境模型 \(p(s',r\mid s,a)\)。
4.5.1 初始化
对所有状态 \(s\) 初始化价值和策略:
\[ V(s)\in \mathbb{R},\quad \pi(s)\in A(s). \]
一开始不要求准确,可以随机设定。后续迭代会不断修正。
4.5.2 策略评估
固定当前策略 \(\pi\),反复更新:
\[ V(s) \leftarrow \sum_{s',r}p(s',r\mid s,\pi(s))[r+\gamma V(s')]. \]
这一步的意思是:假设在状态 \(s\) 一定按照当前策略选择动作 \(\pi(s)\),那么状态 \(s\) 的价值就是该动作可能导致的所有下一状态和奖励的期望。
算法中用 \(\Delta\) 记录本轮价值变化的最大值:
\[ \Delta \leftarrow \max(\Delta, |v - V(s)|). \]
当 \(\Delta < \theta\) 时,说明价值函数已经变化很小,可以认为当前策略评估得差不多了。
4.5.3 策略改进
用当前价值函数选择更好的动作:
\[ \pi(s) \leftarrow \arg\max_a \sum_{s',r}p(s',r\mid s,a)[r+\gamma V(s')]. \]
这个公式的意思是:对每个可能动作 \(a\),计算“执行它后的一步奖励加下一状态价值”的期望,然后选择最大的动作。
如果所有状态的最优动作都没有改变,则策略稳定,算法停止。此时可以认为:
\[ V\approx v_*,\quad \pi\approx \pi_*. \]
其中 \(v_*\) 是最优价值函数,\(\pi_*\) 是最优策略。
4.6 高尔夫例子
这里的高尔夫例子展示了状态价值和动作价值的区别。图中等高线表示从不同位置把球打进洞大约还需要多少杆。
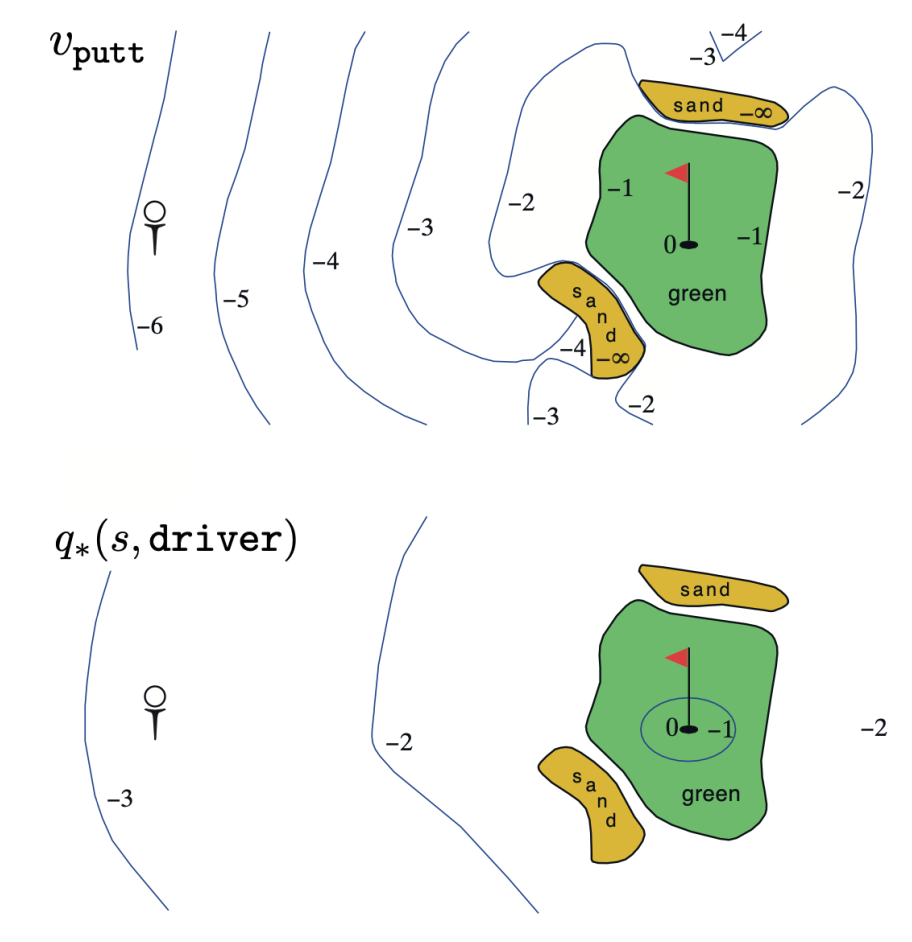
如果只看状态价值 \(v(s)\),我们知道“球在这里总体上有多好”。但真正做决策时,还要考虑动作,比如使用推杆(putt)还是开球杆(driver)。不同球杆的风险和效果不同,因此动作价值 \(q(s,a)\) 会不一样。
这个例子帮助理解:策略改进不是只看当前状态,而是比较当前状态下不同动作的后果。
4.7 RL for Optimized Execution
RL for Optimized Execution 可以理解为“用强化学习解决金融交易中的最优执行问题”。这里的 execution 指交易执行,例如一个机构想买入或卖出大量股票,但不能一次性全部成交,因为这样可能强烈影响市场价格。它需要把大订单拆成许多小订单,在一段时间内逐步执行,并尽量降低交易成本。
execution as state-based stochastic optimal control 的意思是:交易执行可以看作一个基于状态的随机最优控制问题。
这里几个词要分开理解:
| 词 | 含义 | 在交易执行中的例子 |
|---|---|---|
| state-based | 决策依赖当前状态 | 剩余时间、还剩多少股票没买/卖、当前市场价格、订单簿情况 |
| stochastic | 环境有随机性 | 同样的下单方式,在不同市场波动下可能得到不同成交结果 |
| optimal control | 目标是选择最优动作序列 | 每一步决定下多少单、挂什么价格、放在订单簿什么位置 |
这个强化学习建模可以写成:
| 强化学习元素 | 交易执行中的含义 |
|---|---|
| 状态(state) | 时间和剩余股票数量,例如“还剩 10 分钟、还有 5000 股没执行”;也可能包括价格、成交量、订单簿深度等信息 |
| 动作(actions) | 订单在订单簿中的位置,例如挂买一、买二,或者选择市价单/限价单、下单数量 |
| 奖励(rewards) | 实际成交价格或由成交价格计算出的收益/成本,例如买得越便宜奖励越高,卖得越贵奖励越高 |
| 随机性(stochastic) | 相同状态和相同动作不一定得到相同结果,因为市场中其他交易者也在变化 |
这个例子的重点不是金融细节,而是说明强化学习适合处理一种问题:当前每一步动作都会影响后续状态,而且目标不是单步最好,而是整个执行过程总体最好。
例如你要在 30 分钟内买入 10000 股。如果一开始买太快,可能把价格推高,导致后面更贵;如果买太慢,最后时间不够,只能用更差价格强行成交。强化学习可以尝试学习一种策略:在不同市场状态下,动态决定当前应该积极成交还是耐心挂单。
这是 RL 在市场微观结构(microstructure)中的大规模应用。市场微观结构研究订单簿、成交机制、买卖价差、流动性等细节,而这些细节正好会影响交易执行策略。
4.8 Challenges of RL
强化学习落地时会遇到很多挑战。RL 的数学框架看起来很清楚,但真实问题往往比迷宫和老虎机复杂得多。
状态表示与特征学习。 真实任务中的状态空间可能非常高维、连续,动作空间也可能连续。比如自动驾驶看到的不是几个离散格子,而是摄像头图像、速度、路线、障碍物位置等大量信息。此时不能只用表格记录每个状态,需要用函数近似或神经网络学习有用特征。
奖励信号设计。 奖励函数可能不明确,也可能同时包含多个目标,还可能涉及风险。例如机器人走路任务中,如果只奖励“速度快”,智能体可能学出不稳定甚至危险的动作;如果金融交易只奖励成交价格,也可能忽略风险和市场冲击。奖励设计错了,智能体就可能学到“钻空子”的行为。
带延迟的策略评估。 在真实系统中,执行器、传感器或奖励反馈都可能有延迟。也就是说,智能体做了一个动作后,可能要过一段时间才知道这个动作到底好不好。比如下棋中的一步棋,真正影响胜负可能要很多步之后才体现出来。
利用与探索的权衡。 智能体既要利用当前已经知道的好策略,也要探索还不确定的新动作。只利用会陷入局部最优,只探索又会浪费大量样本。多臂老虎机中的 \(\epsilon\)-greedy 就是在解决这个问题的最简单版本。
有限样本下的快速学习。 很多真实系统不能无限试错。机器人反复摔倒会损坏硬件,医疗决策不能随意尝试,金融交易中的错误决策会带来真实损失。因此 RL 算法需要在有限样本下尽快学到可用策略。
基于学习模型的规划。 智能体可以学习一个世界模型,再在模型中模拟未来并进行规划。但如果模型不准,规划结果也会被误导。也就是说,在错误模拟器里学出来的策略,放到真实环境中可能失败。
自动选择子问题。 复杂任务往往不能一口气学会,智能体需要知道先学什么、后学什么。例如先学会走直线,再学会转弯,最后学会避障。这类似课程学习:从简单任务逐渐过渡到复杂任务。
多智能体强化学习。 当多个智能体同时学习时,环境会因为其他智能体的策略变化而不断变化。比如游戏对手会变强,市场中的其他交易者也会调整策略。这会让学习问题更不稳定,因为智能体面对的环境不再固定。
这部分和前面的最优执行例子是连在一起的:最优执行给出一个真实复杂应用,而这些挑战解释了为什么这类真实应用很难。以交易执行为例,状态表示很复杂,奖励不仅要考虑成交价格,还要考虑风险和市场冲击;市场反馈有延迟,样本又很宝贵,而且其他交易者也在不断改变行为。这些正好对应强化学习落地时的典型困难。
5 Monte Carlo 方法
5.1 Monte Carlo 的基本思想
Monte Carlo 方法的核心是随机采样。估计圆周率 \(\pi\) 是一个直观例子:在正方形中随机撒点,统计落入四分之一圆内的比例,就可以估计圆面积,从而估计 \(\pi\)。点越多,估计越稳定。
在强化学习中,Monte Carlo 方法不用环境模型,而是通过一次次完整试验得到回报。一个完整 episode 结束后,算法知道某个状态或状态-动作对后面实际获得了多少回报,于是用这些回报的平均值估计价值。
5.2 Monte Carlo 与动态规划的区别
动态规划需要知道环境模型,例如从 \(s\) 做 \(a\) 到达每个 \(s'\) 的概率是多少、奖励是多少。Monte Carlo 不需要这些概率,只需要实际经验。
| 方法 | 是否需要模型 | 什么时候更新 | 更新依据 |
|---|---|---|---|
| 动态规划 | 需要 | 可以直接迭代 | 所有可能转移的期望 |
| Monte Carlo | 不需要 | episode 结束后 | 实际采样得到的完整回报 |
比如你不知道迷宫地图和转移概率,但你可以让机器人实际走很多次。每次走完以后,记录从某个位置开始最终得了多少分,多次平均就能估计这个位置的价值。
5.3 First-visit Monte Carlo 的直观过程
假设一个 episode 是:
\[ S_0,A_0,R_1,S_1,A_1,R_2,\ldots,S_T. \]
如果我们要估计某个状态 \(s\) 的价值,就找到这个 episode 中第一次出现 \(s\) 的时刻 \(t\),计算从那以后所有奖励的折扣和:
\[ G_t=R_{t+1}+\gamma R_{t+2}+\cdots. \]
把这个 \(G_t\) 加入 \(Returns(s)\),然后取平均:
\[ V(s)=average(Returns(s)). \]
这里的 \(Returns(s)\) 是一个记录表,专门用来保存“每次从状态 \(s\) 第一次出现后计算出来的回报”。例如状态 \(s\) 在三次 episode 中第一次出现后,对应回报分别是 \(5,7,6\),那么: \[ Returns(s)=[5,7,6], \]
于是:
\[ V(s)=average(Returns(s))=\frac{5+7+6}{3}=6. \]
所以,Monte Carlo 方法估计价值的方式很朴素:每次实际跑完一条轨迹,就把观察到的回报存起来;样本越多,平均值越接近真实价值。
这就是 first-visit Monte Carlo 的基本想法。它只使用每个 episode 中第一次访问状态 \(s\) 后的回报,避免同一个 episode 对同一状态重复计数。
5.4 Monte Carlo ES
Monte Carlo ES(Exploring Starts)可用于估计最优策略。ES 指 exploring starts,即探索性起点。
算法流程是:
- 对所有状态-动作对初始化:
\[ Q(s,a)\leftarrow \text{任意值},\quad \pi(s)\leftarrow \text{任意动作}. \]
- 对每个 \((s,a)\) 准备一个回报列表 \(Returns(s,a)\)。这里的 \(Returns(s,a)\) 和前面的 \(Returns(s)\) 类似,只不过它记录的是“从状态 \(s\) 采取动作 \(a\) 之后得到的回报样本”。
- 每次 episode 随机选择一个初始状态 \(S_0\) 和初始动作 \(A_0\),并要求所有状态-动作对都有大于 \(0\) 的概率被选为起点。
- 从 \(S_0,A_0\) 开始,之后按照当前策略 \(\pi\) 生成完整 episode。
- 对 episode 中每个首次出现的 \((s,a)\),计算其后的回报 \(G\)。
- 更新:
\[ Q(s,a)\leftarrow average(Returns(s,a)). \]
- 对出现过的状态改进策略:
\[ \pi(s)\leftarrow \arg\max_a Q(s,a). \]
这个算法体现了 GPI,也就是广义策略迭代。在 Monte Carlo ES 中,“策略评估”对应用采样回报不断更新 \(Q(s,a)\),“策略改进”对应用 \(\pi(s)\leftarrow \arg\max_a Q(s,a)\) 把策略改成当前看起来最好的动作。
5.4.1 例子
假设有一个很小的任务,包含两个非终止状态 \(s_1,s_2\),每个状态下都有两个动作 \(a_1,a_2\)。我们想估计四个状态-动作对的价值:
\[ Q(s_1,a_1),\quad Q(s_1,a_2),\quad Q(s_2,a_1),\quad Q(s_2,a_2). \]
一开始还不知道哪个状态下哪个动作更好,所以为每个状态-动作对准备一个回报列表:
\[ Returns(s_1,a_1)=[],\quad Returns(s_1,a_2)=[], \]
\[ Returns(s_2,a_1)=[],\quad Returns(s_2,a_2)=[]. \]
假设折扣因子为:
\[ \gamma=0.9. \]
现在通过 Monte Carlo 采样得到几条完整 episode。因为是 first-visit 的思想,所以每条 episode 中某个 \((s,a)\) 第一次出现时,才把从那里开始的回报加入对应的 \(Returns(s,a)\)。
第一条 episode 是:
\[ s_1,a_1,R_1=2,\ s_2,a_2,R_2=4,\ terminal. \]
对第一次出现的 \((s_1,a_1)\),从它开始的回报是:
\[ G=R_1+\gamma R_2=2+0.9\times 4=5.6. \]
所以:
\[ Returns(s_1,a_1)=[5.6],\quad Q(s_1,a_1)=5.6. \]
对第一次出现的 \((s_2,a_2)\),它后面只剩奖励 \(R_2=4\),所以:
\[ G=4. \]
因此:
\[ Returns(s_2,a_2)=[4],\quad Q(s_2,a_2)=4. \]
第二条 episode 是:
\[ s_1,a_2,R_1=1,\ s_2,a_1,R_2=6,\ terminal. \]
对 \((s_1,a_2)\):
\[ G=R_1+\gamma R_2=1+0.9\times 6=6.4. \]
所以:
\[ Returns(s_1,a_2)=[6.4],\quad Q(s_1,a_2)=6.4. \]
对 \((s_2,a_1)\):
\[ G=6. \]
所以:
\[ Returns(s_2,a_1)=[6],\quad Q(s_2,a_1)=6. \]
第三条 episode 是:
\[ s_1,a_1,R_1=3,\ s_2,a_2,R_2=2,\ terminal. \]
对 \((s_1,a_1)\):
\[ G=3+0.9\times 2=4.8. \]
把它加入原来的列表:
\[ Returns(s_1,a_1)=[5.6,4.8]. \]
于是:
\[ Q(s_1,a_1)=average([5.6,4.8])=\frac{5.6+4.8}{2}=5.2. \]
对 \((s_2,a_2)\):
\[ G=2. \]
更新:
\[ Returns(s_2,a_2)=[4,2], \]
\[ Q(s_2,a_2)=average([4,2])=3. \]
此时四个动作价值估计为:
\[ Q(s_1,a_1)=5.2,\quad Q(s_1,a_2)=6.4, \]
\[ Q(s_2,a_1)=6,\quad Q(s_2,a_2)=3. \]
策略改进时,在每个状态分别选择 \(Q\) 值最大的动作:
\[ \pi(s_1)=\arg\max_a Q(s_1,a)=a_2, \]
\[ \pi(s_2)=\arg\max_a Q(s_2,a)=a_1. \]
这个例子展示了 Monte Carlo ES 的两个核心动作:先用完整 episode 的折扣回报样本更新每个 \(Q(s,a)\),再在每个状态中选择当前动作价值最高的动作来改进策略。
5.5 Monte Carlo 的优缺点
Monte Carlo 方法的优点是简单、直观、不需要环境模型,而且估计目标是真实完整回报。缺点是必须等 episode 结束才能更新。如果任务很长,甚至没有自然终止状态,Monte Carlo 学习会很慢或不方便。
另一个问题是方差较大。因为完整回报受很多随机因素影响,同一个状态开始的回报可能波动很大,需要很多样本平均才稳定。
6 Temporal-Difference Learning
6.1 从一个小例子开始
假设智能体在一个很简单的走廊里移动,只有两个非终止状态 \(s_1,s_2\),然后到达终点:
\[ s_1 \rightarrow s_2 \rightarrow terminal. \]
智能体已经有一张当前的状态价值估计表:
| 状态 | 当前估计价值 |
|---|---|
| \(V(s_1)\) | \(2\) |
| \(V(s_2)\) | \(5\) |
| \(V(terminal)\) | \(0\) |
现在智能体实际走了一步:它从 \(s_1\) 到了 \(s_2\),并且这一步拿到奖励:
\[ R_{t+1}=1. \]
假设折扣因子:
\[ \gamma=0.9. \]
问题是:看到这一步经验以后,我们要不要更新 \(V(s_1)\)?
TD 的答案是:要更新,而且不用等到整个 episode 结束。因为虽然我们还不知道从 \(s_2\) 后面最终到底会得到多少完整回报,但我们已经有一个旧估计:
\[ V(s_2)=5. \]
所以可以先用“这一步奖励 + 下一状态的估计价值”来形成一个临时目标:
\[ R_{t+1}+\gamma V(s_2)=1+0.9\times 5=5.5. \]
这表示:从 \(s_1\) 走一步到 \(s_2\),马上拿到 \(1\) 分;而 \(s_2\) 之后的未来,暂时用旧估计 \(V(s_2)=5\) 来代表。于是 TD 认为,\(s_1\) 的价值应该更接近 \(5.5\),而不是原来的 \(2\)。
如果学习率 \(\alpha=0.1\),更新就是:
\[ V(s_1)\leftarrow 2+0.1(5.5-2)=2.35. \]
这个例子就是 TD 学习的核心:走一步,看到一个奖励和下一个状态,就立刻把当前状态的价值往更合理的方向推一点。
6.2 TD 和 Monte Carlo 的区别
还是上面的走廊例子。假设完整 episode 是:
\[ s_1,R_1=1,\ s_2,R_2=10,\ terminal. \]
如果用 Monte Carlo 方法更新 \(V(s_1)\),必须等 episode 结束,然后计算从 \(s_1\) 开始的完整回报:
\[ G=R_1+\gamma R_2=1+0.9\times 10=10. \]
Monte Carlo 会用 \(10\) 作为目标来更新 \(V(s_1)\)。
而 TD 不等终点。它在刚看到 \(s_1\rightarrow s_2\) 这一步时,就用:
\[ R_1+\gamma V(s_2) \]
作为目标。如果当时 \(V(s_2)=5\),TD 目标就是:
\[ 1+0.9\times 5=5.5. \]
所以两者的区别是:
| 方法 | 更新目标 | 是否等 episode 结束 |
|---|---|---|
| Monte Carlo | 真实完整回报 \(G\) | 需要 |
| TD | 一步奖励 \(+\) 下一状态的估计价值 | 不需要 |
Monte Carlo 的目标更“真实”,因为它真的看到了后面发生什么;TD 的目标更“及时”,因为它可以边走边学。TD 用了一个旧估计 \(V(s_2)\) 来更新另一个估计 \(V(s_1)\),这就叫 bootstrap。
6.3 TD(0) 更新公式
TD(0) 是最基础的一步时序差分方法。这里的 TD 是“时序差分”,表示用相邻时间步之间的估计差异来学习;括号里的 \(0\) 可以理解为“不额外等待更多真实奖励”,也就是只用当前一步交互得到的信息。
更具体地说,智能体在状态 \(S_t\) 执行动作 \(A_t\) 后,环境返回即时奖励 \(R_{t+1}\),并转移到下一状态 \(S_{t+1}\)。TD(0) 只用这一步观察到的 \(R_{t+1}\) 和 \(V(S_{t+1})\) 来更新 \(V(S_t)\)。
TD(0) 的目标是:
\[ R_{t+1}+\gamma V(S_{t+1}). \]
其中 \(R_{t+1}\) 是刚刚收到的即时奖励,\(V(S_{t+1})\) 是下一状态的当前估计价值。
TD(0) 的更新公式是:
\[ V(S_t)\leftarrow V(S_t)+\alpha[R_{t+1}+\gamma V(S_{t+1})-V(S_t)]. \]
这条公式可以读成:
\[ \text{新价值} = \text{旧价值} + \text{学习率}\times(\text{TD目标}-\text{旧价值}). \]
6.4 TD error 是什么
TD 更新中最重要的量是 TD error:
\[ \delta_t = R_{t+1}+\gamma V(S_{t+1})-V(S_t). \]
它就是“TD 目标”和“旧估计”之间的差距。用 TD error 可以把更新公式简写成:
\[ V(S_t)\leftarrow V(S_t)+\alpha\delta_t. \]
从直觉上看,\(\delta_t\) 有点像梯度下降里的误差信号:它的正负号告诉我们 \(V(S_t)\) 应该往上调还是往下调,它的大小表示这次修正应该有多强。
仍然用刚才的例子:
\[ V(s_1)=2,\quad R_{t+1}=1,\quad \gamma=0.9,\quad V(s_2)=5. \]
TD 目标是:
\[ 1+0.9\times 5=5.5. \]
TD error 是:
\[ \delta_t=5.5-2=3.5. \]
因为 \(\delta_t>0\),说明原来把 \(s_1\) 估低了,所以要提高 \(V(s_1)\)。如果 \(\delta_t<0\),就说明原来估高了,需要降低。
如果 \(\alpha=0.1\),更新为:
\[ V(s_1)\leftarrow 2+0.1\times 3.5=2.35. \]
注意,TD 不会一下子把 \(V(s_1)\) 改成 \(5.5\),而是只朝 \(5.5\) 移动一小步。这样做可以避免单次经验噪声太大导致估计剧烈震荡。
6.5 Tabular TD for \(v_\pi\)
这里的表格式 TD 策略评估,就是用 TD(0) 来估计某个固定策略 \(\pi\) 下的状态价值 \(v_\pi\)。
这里的 tabular 指“表格式”。意思是:如果状态数量不大,我们可以真的建一张表,每一行对应一个状态,每一行里存一个当前价值估计 \(V(s)\)。算法每走一步,就找到当前状态对应的那一行,把这一行的数值更新一下。
例如可以有这样一张价值表:
| 状态 | 当前价值估计 |
|---|---|
| \(s_1\) | \(2.0\) |
| \(s_2\) | \(5.0\) |
| \(terminal\) | \(0\) |
表格式 TD 的过程可以理解为:
- 给定一个要评估的策略 \(\pi\)。
- 初始化所有状态价值 \(V(s)\),终止状态价值设为 \(0\)。
- 从某个初始状态 \(S\) 开始一个 episode。
- 按策略 \(\pi\) 在状态 \(S\) 选择动作 \(A\)。
- 执行动作,观察奖励 \(R\) 和新状态 \(S'\)。
- 立刻更新当前状态:
\[ V(S)\leftarrow V(S)+\alpha[R+\gamma V(S')-V(S)]. \]
- 令 \(S\leftarrow S'\),继续往前走,直到到达终止状态。
这个算法最重要的特点是:每走一步就能更新一步。它不需要知道环境模型,也不需要等整条轨迹结束。
6.5.1 一个表格式 TD 更新例子
假设当前价值表是:
| 状态 | 更新前的 \(V(s)\) |
|---|---|
| \(s_1\) | \(2.0\) |
| \(s_2\) | \(5.0\) |
| \(terminal\) | \(0\) |
现在智能体在状态 \(s_1\),按照策略 \(\pi\) 选择了某个动作,环境返回:
\[ R=1,\quad S'=s_2. \]
设:
\[ \gamma=0.9,\quad \alpha=0.1. \]
TD 目标是:
\[ R+\gamma V(S')=1+0.9\times V(s_2)=1+0.9\times 5=5.5. \]
当前旧估计是:
\[ V(s_1)=2.0. \]
所以:
\[ V(s_1)\leftarrow 2.0+0.1(5.5-2.0)=2.35. \]
更新后,价值表变成:
| 状态 | 更新后的 \(V(s)\) |
|---|---|
| \(s_1\) | \(2.35\) |
| \(s_2\) | \(5.0\) |
| \(terminal\) | \(0\) |
注意这一步只改了 \(s_1\) 这一行,因为当前被更新的是刚刚访问的状态 \(S=s_1\)。\(s_2\) 的值这次没有直接改,它只是作为下一状态出现在 TD 目标里。
6.6 为什么 TD 学习重要
TD 学习结合了 Monte Carlo 和动态规划的优点:
| 来源 | TD 继承的优点 |
|---|---|
| Monte Carlo | 不需要环境模型,可以直接从实际经验中学习 |
| 动态规划 | 可以用已有价值估计更新当前价值,不必等完整回报 |
TD learning 是强化学习中非常核心的思想。很多后续算法,例如 SARSA、Q-Learning、Expected SARSA,都可以看作把 TD 的更新思想从状态价值 \(V(s)\) 推广到动作价值 \(Q(s,a)\)。
6.7 Monte Carlo、TD、动态规划对比
| 方法 | 是否需要模型 | 是否需要完整 episode | 是否 bootstrap | 典型特点 |
|---|---|---|---|---|
| 动态规划 | 需要 | 不需要 | 是 | 知道环境转移概率,可以直接算期望 |
| Monte Carlo | 不需要 | 需要 | 否 | 用真实完整回报,直观但更新慢 |
| TD | 不需要 | 不需要 | 是 | 走一步学一步,适合在线学习 |
初学者可以这样记:动态规划“知道地图和概率,所以可以算”;Monte Carlo“不知道地图,但走完整局后总结”;TD“不知道地图,也不等完整局,走一步学一步”。
7 SARSA 与 Q-Learning
7.1 从价值评估到控制
前面的 TD(0) 主要是在评估一个给定策略的状态价值 \(V(s)\)。但强化学习最终要解决控制问题:不仅要知道当前策略好不好,还要学出更好的策略。
为了直接选择动作,控制算法通常学习动作价值 \(Q(s,a)\)。一旦知道 \(Q(s,a)\),就可以用 \(\epsilon\)-greedy 等方式从 \(Q\) 导出策略。
SARSA 和 Q-Learning 都是 TD 控制算法,区别在于它们使用不同的更新目标。
7.2 SARSA:学习自己实际执行的策略
SARSA 是 on-policy TD control。On-policy 的意思是:用来生成行为的策略和被学习评估的策略是同一个策略。
SARSA 的更新公式是:
\[ Q(S,A)\leftarrow Q(S,A)+\alpha[R+\gamma Q(S',A')-Q(S,A)]. \]
这次更新使用了五个量:
\[ S,A,R,S',A'. \]
这也是 SARSA 名字的来源。
算法步骤:
- 初始化 \(Q(s,a)\)。
- 在当前状态 \(S\),按由 \(Q\) 导出的策略选择动作 \(A\),例如 \(\epsilon\)-greedy。
- 执行动作 \(A\),得到奖励 \(R\) 和下一状态 \(S'\)。
- 在 \(S'\) 再按同一个策略选择下一动作 \(A'\)。
- 用 \(R+\gamma Q(S',A')\) 更新 \(Q(S,A)\)。
- 令 \(S\leftarrow S'\),\(A\leftarrow A'\),继续。
关键点在于:SARSA 的目标中用的是实际选出来的 \(A'\)。如果策略包含探索,那么 SARSA 会把探索动作可能带来的后果也考虑进去。
7.3 Q-Learning:学习贪心最优目标
Q-Learning 是 off-policy TD control。Off-policy 的意思是:行为策略和学习目标策略可以不同。
Q-Learning 的更新公式是:
\[ Q(S,A)\leftarrow Q(S,A)+\alpha[R+\gamma\max_a Q(S',a)-Q(S,A)]. \]
它与 SARSA 最大的区别在于下一状态部分。SARSA 用实际选择的 \(Q(S',A')\),Q-Learning 用所有动作中最大的 \(\max_a Q(S',a)\)。
这表示 Q-Learning 即使当前用 \(\epsilon\)-greedy 探索,更新目标也是假设未来会选择当前估计最优动作。因此它学习的是贪心目标策略的动作价值。
7.4 SARSA 与 Q-Learning 的直观差异
| 维度 | SARSA | Q-Learning |
|---|---|---|
| 策略类型 | On-policy | Off-policy |
| 下一步目标 | 实际选择的 \(A'\) | 价值最大的动作 |
| 更新目标 | \(R+\gamma Q(S',A')\) | \(R+\gamma\max_a Q(S',a)\) |
| 是否考虑探索风险 | 考虑 | 较少考虑 |
| 行为风格 | 更保守 | 更接近贪心最优 |
一个经典理解方式是悬崖行走问题。智能体从起点走到终点,中间有悬崖。靠近悬崖的路径最短,但如果探索时随机走错一步就会掉下去。SARSA 因为考虑实际 \(\epsilon\)-greedy 探索的风险,可能学到远离悬崖的安全路径;Q-Learning 因为目标中总是假设下一步选最优动作,可能更倾向于贴近悬崖的短路径。
7.5 Expected SARSA
Expected SARSA 不使用实际采样的 \(A'\),也不像 Q-Learning 只取最大值,而是对下一状态所有动作按当前策略概率求期望:
\[ Q(S,A)\leftarrow Q(S,A)+\alpha \left[ R+\gamma\sum_a \pi(a\mid S')Q(S',a)-Q(S,A) \right]. \]
它介于 SARSA 和 Q-Learning 之间:比 SARSA 的单次采样方差小,因为它求期望;又比 Q-Learning 更忠实于当前策略,因为它使用 \(\pi(a\mid S')\)。
8 Model-based Methods
8.1 Model-free 与 Model-based
强化学习方法可以粗略分为 model-free 和 model-based。
Model-free 方法不显式学习环境模型,只直接学习价值函数或策略。前面的 Monte Carlo、TD、SARSA、Q-Learning 都可以看作 model-free 的代表。
Model-based 方法会学习或使用环境模型。环境模型通常回答两个问题:
- 在状态 \(s\) 执行动作 \(a\) 后,会到达什么状态 \(s'\)?
- 会得到什么奖励 \(r\)?
如果模型能预测下一状态和奖励,智能体就可以在模型中“想象”未来,再利用模拟经验学习。
8.2 Model-based Methods 的流程
这里的 Model-based Methods 图包含几个部分:
| 部分 | 含义 |
|---|---|
| real experience | 智能体和真实环境交互得到的经验 |
| model learning | 用真实经验学习环境模型 |
| Model | 学到的环境模型 |
| simulated experience | 通过模型生成的模拟经验 |
| policy/value functions | 策略或价值函数 |
| planning update | 用模拟经验更新策略或价值 |
基本循环是:
- 智能体在真实环境中行动,获得真实经验。
- 用真实经验更新价值函数或策略。
- 同时用真实经验学习环境模型。
- 用模型生成模拟经验。
- 用模拟经验进一步更新价值函数或策略。
这类方法的优势是样本效率高,因为真实环境交互往往昂贵。比如机器人真实摔倒一次成本很高,如果能在模型中模拟很多次,就可以减少真实试错。
8.3 Model-based 的风险
Model-based 方法的核心风险是模型误差。如果模型预测不准确,智能体可能在错误模型里学到错误策略。
例如自动驾驶模型如果低估雨天刹车距离,规划算法可能在模拟中认为某个动作安全,但真实世界中却很危险。因此 model-based 方法需要关注模型质量、误差累积和不确定性估计。
9 Policy Gradient Methods
9.1 为什么要直接学习策略
前面的很多方法先学习价值函数,再通过价值函数选择动作。但在某些任务中,直接学习策略更自然。
例如机器人控制中,动作可能是连续值,如关节角速度。此时不方便枚举所有动作并计算 \(\max_a Q(s,a)\)。策略梯度方法直接用参数 \(\theta\) 表示策略:
\[ \pi(a\mid s,\theta). \]
学习目标是调整 \(\theta\),让策略产生更高回报。
9.2 Softmax 策略
这里先为每个状态-动作对定义数值偏好:
\[ h(s,a,\theta). \]
偏好不是概率,可以是任意实数。为了把偏好变成合法概率,使用 softmax:
\[ \pi(a\mid s,\theta) = \frac{\exp(h(s,a,\theta))} {\sum_b \exp(h(s,b,\theta))}. \]
这个公式的作用是:
- 指数函数保证每个动作权重为正。
- 分母对所有动作归一化,保证概率和为 \(1\)。
- 偏好更大的动作会得到更大的概率。
例如两个动作偏好分别为 \(h_1=2\)、\(h_2=1\),第一个动作概率会更高,但第二个动作仍然有非零概率。这有助于保持探索。
9.3 REINFORCE with Baseline
这一节的算法要解决的问题是:如果策略本身是带参数的概率分布,我们应该怎样直接调整这些参数,让好动作以后更容易被选中,坏动作以后更不容易被选中?
前面的 Q-Learning、SARSA 通常先学习 \(Q(s,a)\),再根据 \(Q\) 选择动作。策略梯度方法不一定先学完整的 \(Q\) 表,而是直接学习策略:
\[ \pi(a\mid s,\theta). \]
这里 \(\theta\) 是策略参数。算法的目标是让 \(\theta\) 变得更好,使策略在状态 \(s\) 下更倾向于选择能带来高回报的动作。
REINFORCE 的基本想法很直观:
- 先按照当前策略跑一条完整 episode。
- 看每一步选择的动作最后带来了多少回报 \(G_t\)。
- 如果某个动作之后的回报比预期好,就提高这个动作以后被选中的概率。
- 如果某个动作之后的回报比预期差,就降低这个动作以后被选中的概率。
带 baseline 的 REINFORCE 多做了一件事:它不只看“回报 \(G_t\) 大不大”,而是看“回报 \(G_t\) 是否比这个状态本来预期的价值更好”。这个“本来预期”就是 baseline。
这里的算法使用两类参数:
| 参数 | 作用 |
|---|---|
| \(\theta\) | 策略参数,决定动作概率 |
| \(\mathbf{w}\) | 价值函数参数,用来估计 baseline |
在深度强化学习里,可以把 \(\theta\) 理解成策略网络的参数:输入状态 \(s\),输出各个动作的概率 \(\pi(a\mid s,\theta)\)。可以把 \(\mathbf{w}\) 理解成价值网络的参数:输入状态 \(s\),输出这个状态的价值估计 \(\hat v(s,\mathbf{w})\)。不过从理论上说,它们不一定必须是神经网络参数,也可以是线性模型或其他可微函数的参数。
每轮先按当前策略生成完整 episode:
\[ S_0,A_0,R_1,\ldots,S_{T-1},A_{T-1},R_T. \]
对于每个时间步 \(t\),计算从该步开始的回报 \(G_t\)。然后计算优势或误差信号:
\[ \delta = G_t-\hat v(S_t,\mathbf{w}). \]
这里 \(\hat v(S_t,\mathbf{w})\) 是 baseline,表示在状态 \(S_t\) 本来预计能得到多少回报。\(\delta\) 表示实际回报比预期高多少。
这个 \(\delta\) 可以理解为“这次动作表现是否超出预期”:
| 情况 | 含义 | 策略应该怎么改 |
|---|---|---|
| \(\delta>0\) | 实际回报高于预期 | 增加动作 \(A_t\) 的概率 |
| \(\delta<0\) | 实际回报低于预期 | 降低动作 \(A_t\) 的概率 |
| \(\delta=0\) | 正好符合预期 | 基本不改变 |
如果 \(\delta>0\),说明动作 \(A_t\) 带来的结果比预期好,应增加它在状态 \(S_t\) 下的概率:
\[ \theta \leftarrow \theta+\alpha^{\theta}\gamma^t\delta\nabla_{\theta}\ln\pi(A_t\mid S_t,\theta). \]
如果 \(\delta<0\),则降低该动作概率。
同时更新价值函数参数:
\[ \mathbf{w}\leftarrow \mathbf{w}+\alpha^{\mathbf{w}}\gamma^t\delta\nabla_{\mathbf{w}}\hat v(S_t,\mathbf{w}). \]
Baseline 不改变策略梯度的期望方向,但能降低方差。直观地说,我们不只看“回报是不是大”,而是看“回报是否比这个状态的正常水平更大”。
9.3.1 例子
假设在某个状态 \(s\) 下,智能体有两个动作:\(a_1\) 和 \(a_2\)。当前策略是:
\[ \pi(a_1\mid s,\theta)=0.6,\quad \pi(a_2\mid s,\theta)=0.4. \]
也就是说,当前策略更倾向于选 \(a_1\)。
现在智能体按照当前策略跑了一次 episode。在状态 \(s\) 时,它选择了动作 \(a_2\),最后从这一步开始得到的回报是:
\[ G_t=8. \]
同时,价值函数给出的 baseline 是:
\[ \hat v(s,\mathbf{w})=5. \]
所以:
\[ \delta=G_t-\hat v(s,\mathbf{w})=8-5=3. \]
因为 \(\delta>0\),说明这次选择 \(a_2\) 的结果比原来预期更好。于是策略更新应该让 \(a_2\) 以后在状态 \(s\) 下更容易被选中。更新后的策略可能变成:
\[ \pi(a_1\mid s,\theta)=0.55,\quad \pi(a_2\mid s,\theta)=0.45. \]
具体概率改多少由学习率和梯度决定,但方向很清楚:表现超过预期的动作,概率上调。
如果另一次 episode 中,智能体在状态 \(s\) 选择 \(a_1\),但最后回报只有:
\[ G_t=2, \]
而 baseline 仍然是:
\[ \hat v(s,\mathbf{w})=5, \]
则:
\[ \delta=2-5=-3. \]
这说明动作 \(a_1\) 的结果比预期差,策略更新就会降低 \(a_1\) 以后被选中的概率。
这个例子说明了 REINFORCE with Baseline 的核心:不是简单奖励高就鼓励、奖励低就惩罚,而是看它相对于当前状态的正常水平是更好还是更差。
10 n-step Bootstrapping 与 Eligibility Traces
10.1 从 1-step TD 到 Monte Carlo
1-step TD 用一步奖励加下一状态估计作为目标:
\[ R_{t+1}+\gamma V(S_{t+1}). \]
Monte Carlo 用从当前开始直到 episode 结束的完整真实回报。n-step Bootstrapping 位于两者之间:先看未来 \(n\) 步真实奖励,再用第 \(n\) 步之后的价值估计补上剩余未来。
这里的 n-step return 为:
\[ G_{t:t+n} = R_{t+1}+\gamma R_{t+2}+\cdots+\gamma^{n-1}R_{t+n} +\gamma^n \hat v(S_{t+n},\mathbf{w}_{t+n-1}). \]
其中前 \(n\) 项是真实观察到的奖励,最后一项是 bootstrap。
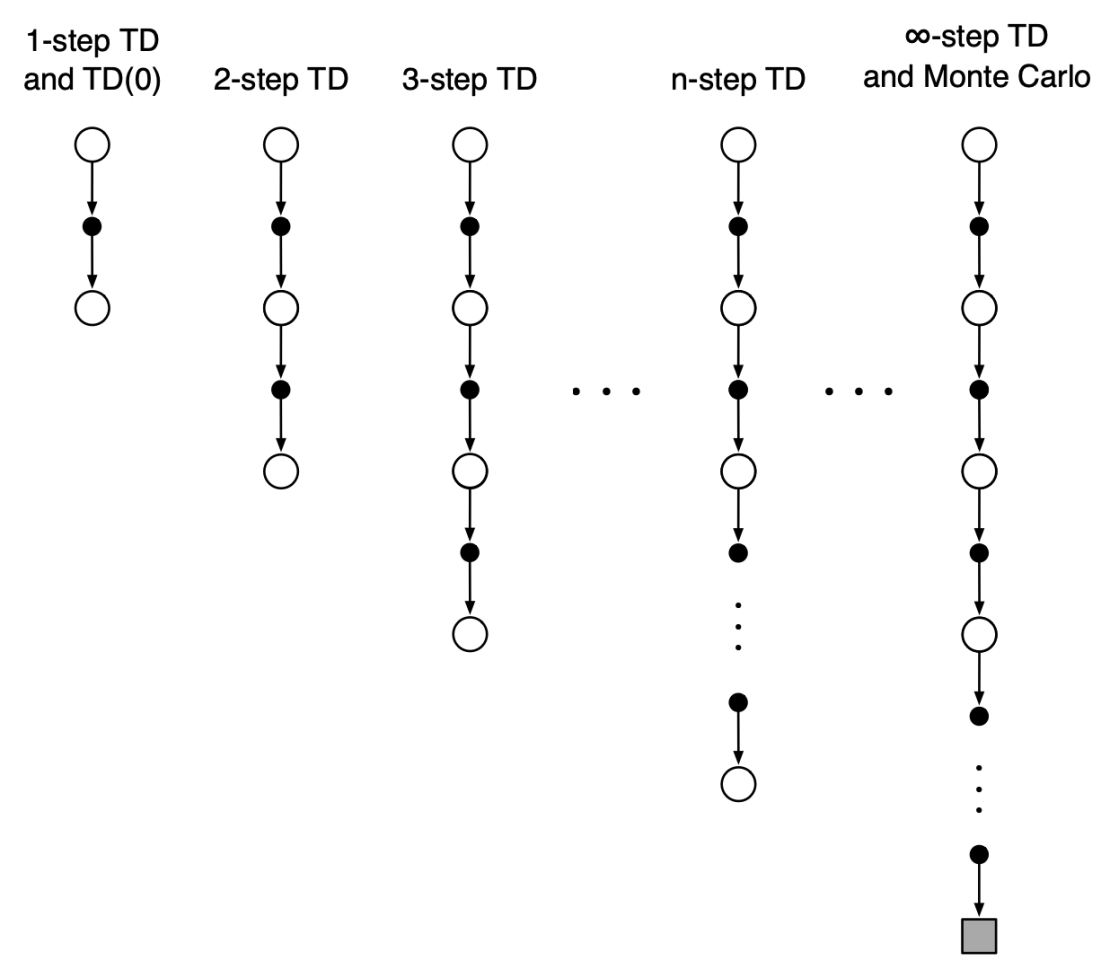
白色圆圈:状态
黑色圆圈:动作
10.2 n 的影响
当 \(n=1\) 时:
\[ G_{t:t+1}=R_{t+1}+\gamma \hat v(S_{t+1}). \]
这就是 TD(0) 目标。
当 \(n\) 很大并一直到 episode 结束时,最后的 bootstrap 项消失,目标接近 Monte Carlo 回报。
| 方法 | 看真实奖励的步数 | 是否 bootstrap | 倾向 |
|---|---|---|---|
| 1-step TD | 1 步 | 是 | 更新快,方差小,但偏差可能较大 |
| n-step TD | n 步 | 是 | 在 TD 和 MC 之间折中 |
| Monte Carlo | 到 episode 结束 | 否 | 偏差小,但方差大、更新慢 |
10.3 \(\lambda\)-return
n-step return 定义为:
\[ G_{t:t+n} \doteq R_{t+1}+\gamma R_{t+2}+\cdots+\gamma^{n-1}R_{t+n} +\gamma^n\hat v(S_{t+n},\mathbf{w}_{t+n-1}), \quad 0\le t\le T-n. \]
这个公式的意思是:先使用未来 \(n\) 步真实奖励,再用第 \(n\) 步后的状态价值估计 \(\hat v(S_{t+n},\mathbf{w}_{t+n-1})\) 来补上更远的未来。这就是 n-step bootstrapping。
接着,\(\lambda\)-return 的求和形式为:
\[ G_t^\lambda \doteq (1-\lambda)\sum_{n=1}^{\infty}\lambda^{n-1}G_{t:t+n}. \]
这里的权重依次是:
\[ (1-\lambda),\quad (1-\lambda)\lambda,\quad (1-\lambda)\lambda^2,\ldots \]
因此,\(\lambda\)-return 可以理解为把 1-step、2-step、3-step 等不同长度的 return 按权重混合起来。\(\lambda\) 越小,短步数 return 权重越大;\(\lambda\) 越接近 \(1\),更长步数的 return 权重越大。
特殊情况:
| \(\lambda\) | 含义 |
|---|---|
| \(\lambda=0\) | 只使用 1-step TD |
| \(\lambda\approx 1\) | 更接近 Monte Carlo |
| \(0<\lambda<1\) | 混合不同长度的回报 |
10.4 Forward View
前向视角(forward view)从当前状态往未来看。它问的是:当前状态应该用未来哪些长度的回报来更新?答案是用 \(\lambda\)-return,即不同 n-step return 的加权平均。
前向视角适合解释算法原理,因为它直观地展示了 TD(\(\lambda\)) 如何在 TD 和 Monte Carlo 之间插值。但它的问题是需要知道未来很多步,甚至要等 episode 结束,因此不方便在线实时更新。
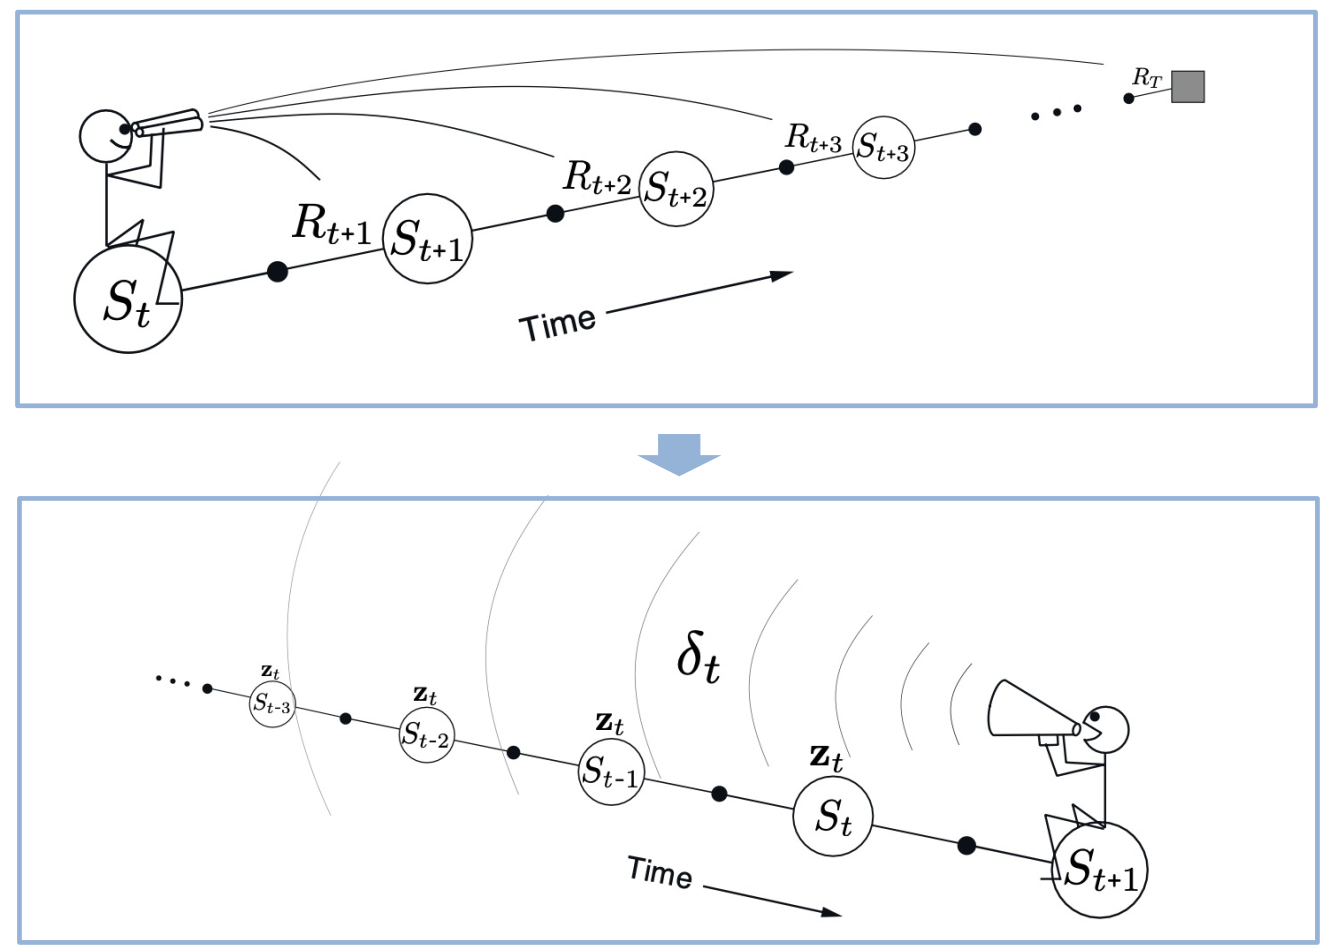
10.5 Backward View 与资格迹
后向视角(backward view)从当前 TD error 往过去分配信用。它引入资格迹(eligibility trace)\(z\),记录过去访问过的状态或特征还有多少“资格”被当前误差信号更新。
Semi-gradient TD(\(\lambda\)) 用于估计:
\[ \hat v \approx v_\pi. \]
也就是说,我们想用一个带参数的函数 \(\hat v(S,\mathbf{w})\) 来近似策略 \(\pi\) 下的真实状态价值 \(v_\pi(S)\)。
算法的输入是:
- 要被评估的策略 \(\pi\)。
- 一个可微的价值函数近似器 \(\hat v:S^+\times\mathbb{R}^d\rightarrow\mathbb{R}\),并且满足 \(\hat v(terminal,\cdot)=0\)。
初始化价值函数参数:
\[ \mathbf{w}\leftarrow \text{任意值,例如 }\mathbf{w}=\mathbf{0}. \]
然后对每个 episode 重复以下过程:
- 初始化状态 \(S\)。
- 初始化资格迹:
\[ \mathbf{z}\leftarrow \mathbf{0}. \]
这里 \(\mathbf{z}\) 是一个 \(d\) 维向量,维度和参数 \(\mathbf{w}\) 相同。
- 对 episode 中的每一步重复:
按照策略选择动作:
\[ A\sim \pi(\cdot\mid S). \]
执行动作 \(A\),观察奖励和下一状态:
\[ R,\ S'. \]
更新资格迹:
\[ \mathbf{z}\leftarrow \gamma\lambda\mathbf{z}+\nabla \hat v(S,\mathbf{w}). \]
这表示旧资格迹会按 \(\gamma\lambda\) 衰减,当前状态的特征梯度会加入资格迹。
计算 TD error:
\[ \delta \leftarrow R+\gamma \hat v(S',\mathbf{w})-\hat v(S,\mathbf{w}). \]
用 TD error 和资格迹更新参数:
\[ \mathbf{w}\leftarrow \mathbf{w}+\alpha\delta\mathbf{z}. \]
最后令:
\[ S\leftarrow S', \]
直到 \(S'\) 是终止状态。
直观理解:如果某个状态刚刚出现过,它的资格迹很大,当前 TD error 会强烈更新它;如果它很久以前出现过,资格迹已经衰减,更新影响就小。
10.6 Eligibility Traces 的意义
Eligibility Traces 的关键作用可以总结为:
- 它统一了 TD 和 Monte Carlo。
- \(\lambda=0\) 是 one-step TD,\(\lambda=1\) 接近 Monte Carlo。
- 中间值通常能取得更好的偏差-方差折中。
- 它允许在线实现类似 Monte Carlo 的多步信用分配。
这部分初学者最重要的是理解“信用分配”。如果最终得到奖励,不只最后一步有功,之前很多步也可能有贡献。Eligibility traces 就是一种把当前反馈分配给过去状态的方法。
11 深度强化学习与多智能体自课程
11.1 为什么需要深度强化学习
前面很多公式默认状态和动作可以用表格枚举。例如迷宫格子数量有限,可以为每个状态存一个 \(V(s)\),为每个状态-动作对存一个 \(Q(s,a)\)。
但现实任务中状态可能非常高维。例如围棋棋盘有极多可能局面,自动驾驶输入可能是图像、速度、地图和传感器数据,机器人控制涉及连续状态和连续动作。表格方法无法直接处理这些情况。
深度强化学习(Deep Reinforcement Learning)用神经网络近似价值函数或策略:
\[ V(s)\approx V(s;\mathbf{w}),\quad Q(s,a)\approx Q(s,a;\mathbf{w}),\quad \pi(a\mid s)\approx \pi(a\mid s;\theta). \]
神经网络的作用是从高维输入中学习有用表示,并把经验推广到相似状态。
11.2 AlphaGo 例子
AlphaGo 可以说明深度网络和强化学习的结合。围棋困难在于:
- 状态空间巨大,棋盘局面数量远超暴力搜索能力。
- 动作选择复杂,每一步有许多可能落子点。
- 局面价值难以手工评估,因为一次落子的影响可能很久之后才显现。
AlphaGo 使用两类网络:
| 网络 | 作用 |
|---|---|
| 策略网络(policy network) | 给出下一步可能动作,缩小搜索范围 |
| 价值网络(value network) | 评估当前棋盘局面的胜率或价值 |
这些网络先从人类专家棋谱中学习,再通过自我对弈进行强化学习。这个例子体现了深度学习和强化学习的互补:深度学习负责表示和泛化,强化学习负责通过长期回报改进行为。
11.3 Multi-Agent Autocurricula
“Emergent tool use from multi-agent autocurricula” 体现了多智能体自课程的思想。多智能体自课程(multi-agent autocurricula)指多个智能体在互动中自动产生越来越复杂的训练任务。
在单智能体任务中,环境通常相对固定;在多智能体任务中,其他智能体也是会学习的,因此环境会随对手或队友策略变化而变化。这会产生一种自动课程:一方学会某种技巧后,另一方必须学会应对,从而推动任务难度升级。
例如一组智能体玩追逐和躲避游戏。追逐者变强后,躲避者需要学会利用障碍;躲避者学会防御后,追逐者又可能学会使用工具。复杂行为不是人工逐条写出来的,而是在竞争或协作中涌现。
12 强化学习的挑战与总结
12.1 强化学习的挑战
强化学习面临多个挑战。下面按初学者更容易理解的方式展开。
| 挑战 | 解释 | 例子 |
|---|---|---|
| 状态表示与特征学习 | 状态可能高维、连续,不能简单列成表 | 自动驾驶看到的是图像和传感器流 |
| 奖励设计 | 奖励如果设计不好,会诱导错误行为 | 只奖励速度可能导致机器人不顾安全 |
| 策略评估延迟 | 动作后果可能很久以后才出现 | 下棋一步棋可能几十步后才体现价值 |
| 探索-利用权衡 | 要尝试新动作,也要使用已知好动作 | 推荐系统既要推荐热门内容,也要试探用户新兴趣 |
| 样本效率 | 真实试错代价高,不能无限采样 | 机器人不能摔坏几万次来学习走路 |
| 世界模型学习 | 模型可以帮助规划,但模型误差会误导策略 | 模拟器不准会导致真实部署失败 |
| 子问题选择 | 智能体需要知道该练什么 | 从简单任务逐渐学到复杂任务 |
| 多智能体学习 | 多个学习者相互影响,环境变得非平稳 | 游戏、市场、交通系统中都有其他决策者 |
12.2 金融最优执行例子
这里的 “RL for Optimized Execution” 把交易执行看作随机最优控制问题。假设要在一段时间内买入或卖出一定数量股票,智能体需要决定每一时刻如何下单。
可以对应为:
| 强化学习元素 | 金融执行中的含义 |
|---|---|
| 状态 | 剩余时间、剩余股票数量、当前订单簿、市场波动 |
| 动作 | 下单价格、下单数量、订单在订单簿中的位置 |
| 奖励 | 成交价格、交易成本、滑点、风险调整收益 |
| 随机性 | 市场价格和其他交易者行为不可完全预测 |
这个例子说明强化学习不仅用于游戏,还可用于真实决策系统。但真实系统更强调风险、稳定性和可解释性。
12.3 核心关系
知识点很多,但可以用一条主线串起来:
- 强化学习目标是最大化长期回报 \(G_t\)。
- 为了判断长期回报,需要定义价值函数 \(v_\pi(s)\) 和 \(q_\pi(s,a)\)。
- Bellman 方程把长期价值拆成即时奖励和下一状态价值。
- 策略评估估计价值,策略改进用价值优化策略。
- Monte Carlo 用完整回报学习价值。
- TD 用一步奖励加下一状态估计学习价值。
- SARSA 和 Q-Learning 把 TD 思想用于控制。
- Policy Gradient 直接优化策略参数。
- Eligibility Traces 用 \(\lambda\) 把 TD 和 Monte Carlo 联系起来。
12.4 必背公式与理解
回报:
\[ G_t = \sum_{k=0}^{\infty}\gamma^kR_{t+k+1}. \]
含义:从当前开始,未来奖励的折扣和。
状态价值:
\[ v_\pi(s)=\mathbb{E}_\pi[G_t\mid S_t=s]. \]
含义:在状态 \(s\) 开始,按策略 \(\pi\) 行动的期望回报。
Bellman 方程:
\[ v_\pi(s) = \sum_a \pi(a\mid s)\sum_{s',r}p(s',r\mid s,a)[r+\gamma v_\pi(s')]. \]
含义:当前状态价值等于所有可能动作、转移和奖励下的“即时奖励 + 折扣未来价值”的期望。
Bandit 增量更新:
\[ Q_{n+1}=Q_n+\frac{1}{n}[R_n-Q_n]. \]
含义:用新奖励和旧估计的误差修正平均值。
TD(0):
\[ V(S_t)\leftarrow V(S_t)+\alpha[R_{t+1}+\gamma V(S_{t+1})-V(S_t)]. \]
含义:走一步就更新,用下一状态价值估计未来。
SARSA:
\[ Q(S,A)\leftarrow Q(S,A)+\alpha[R+\gamma Q(S',A')-Q(S,A)]. \]
含义:用实际选择的下一动作更新,属于 on-policy。
Q-Learning:
\[ Q(S,A)\leftarrow Q(S,A)+\alpha[R+\gamma\max_a Q(S',a)-Q(S,A)]. \]
含义:用下一状态最优动作价值更新,属于 off-policy。
\(\lambda\)-return:
\[ G_t^\lambda = (1-\lambda)\sum_{n=1}^{\infty}\lambda^{n-1}G_{t:t+n}. \]
含义:把不同步数的 n-step return 加权平均,在 TD 和 Monte Carlo 之间折中。
12.5 概念辨析
| 容易混淆点 | 正确理解 |
|---|---|
| reward 和 return | reward 是一步奖励,return 是未来奖励的折扣总和 |
| state value 和 action value | \(v(s)\) 评价状态,\(q(s,a)\) 评价状态下某个动作 |
| policy evaluation 和 policy improvement | 前者估计当前策略价值,后者用价值改进策略 |
| Monte Carlo 和 TD | MC 等完整 episode,TD 走一步就更新 |
| SARSA 和 Q-Learning | SARSA 用实际下一动作,Q-Learning 用最大下一动作 |
| on-policy 和 off-policy | on-policy 学习正在执行的策略,off-policy 可以用一种策略探索、学习另一种目标策略 |
| model-free 和 model-based | model-free 不显式学环境模型,model-based 学或使用环境模型 |
12.6 总结
强化学习研究的是智能体如何在与环境的连续交互中,通过奖励信号学习最大化长期回报的策略。 从 Bandit 的动作价值估计开始,可以逐步引出 Bellman 方程、策略迭代、Monte Carlo、TD、SARSA、Q-Learning、模型方法、策略梯度和资格迹。所有这些方法都围绕同一件事展开:如何更准确地估计未来价值,并用这些估计做出更好的动作选择。