目录
- 存储层次结构
- Moore 定律与数据库 I/O 瓶颈
- 磁盘结构与块访问机制
- 磁盘访问时间模型
- DBMS 的 I/O 计算模型
- 磁盘上的排序:两阶段多路归并排序
- 更大关系的多阶段归并排序
- 二级存储访问优化方法
- 总结与概念对比
1 存储层次结构
1.1 为什么要学习数据存储
数据库系统处理的数据通常远大于主存,且必须长期保存。因此,DBMS 不可能只依赖 CPU 和内存模型来分析性能,而必须理解数据在不同存储层次之间移动的代价。分析数据存储时,核心问题是:数据在计算机系统中存放在哪里?回答这个问题需要同时考虑三个维度:
- 容量(capacity):能存多少数据。
- 速度(speed):读写数据需要多久。
- 成本(cost):每单位数据的价格是多少。
这三个指标通常互相制约:越快的存储越贵、容量越小;越便宜且容量大的存储通常越慢。数据库系统的很多设计,本质上就是在这些存储层次之间安排数据移动,使常用数据尽可能靠近 CPU,而大量持久数据仍保存在便宜、可靠的大容量设备中。
1.2 Cache:处理器附近的高速缓存
缓存(Cache) 位于微处理器同一芯片或非常接近处理器的位置。它容量较小,通常以 MB 为单位,但访问速度极快。
典型时间尺度大致如下:
- cache I/O 约为纳秒级,即 \(10^{-9}\) 秒,速度接近 CPU 运算速度。
- cache 与主存之间交换数据大约需要 \(100\) 纳秒。
从数据库角度看,cache 通常不是 DBMS 直接管理的主要对象,而是由硬件和操作系统透明使用。但它提醒我们:不同层次之间的数据移动时间差异非常大。CPU 计算很快,如果数据不在靠近 CPU 的层次中,等待数据会成为主要代价。
1.3 Main Memory:主存
主存(Main Memory / RAM) 的容量通常从几百 MB 到数十 GB 甚至更多。它支持快速随机访问,访问时间大约为 \(10\) 到 \(100\) 纳秒。
主存的特点是:
| 特性 | 含义 |
|---|---|
| 快速随机访问 | 访问任意地址的时间大致相近 |
| 容量有限 | 相比磁盘,主存容量仍然小得多 |
| 易失性 | 断电后数据丢失 |
| 价格较高 | 每字节成本高于磁盘和磁带 |
因此,传统 DBMS 通常把主存作为 缓冲区(buffer):把磁盘中的块读入内存,在内存中处理,再按需要写回磁盘。
1.4 Virtual Memory:虚拟内存
虚拟内存(Virtual Memory) 为程序提供一个看似连续、较大的地址空间。在 32 位机器上,总地址空间约为:
\[ 2^{32}=4\text{GB} \]
当程序需要的空间超过实际主存时,操作系统会把暂时不用的数据页放到磁盘上,并通过 分页机制(paging mechanism) 在主存和磁盘之间换入、换出。
有些 主存数据库系统(Main-memory Database Systems) 依赖虚拟内存来管理数据,看起来程序可以访问很大的内存空间,但实际上一旦发生频繁分页,性能会急剧下降。原因是磁盘 I/O 比内存访问慢很多,若系统不断把页从磁盘换入内存,就会出现严重的 I/O 瓶颈。
1.5 Secondary Storage:二级存储
二级存储(Secondary Storage) 主要指磁盘、SSD、光盘等非易失存储设备。这里重点讨论传统磁盘。与主存相比,磁盘具有以下特点:
| 维度 | 与主存相比的特点 |
|---|---|
| 速度 | 慢很多,量级上可比主存慢约 \(10^5\) |
| 容量 | 大很多,量级上可比主存大约 \(10^2\) |
| 成本 | 每字节更便宜 |
| 持久性 | 非易失,适合保存数据库文件 |
磁盘支持两种访问方式:
- 顺序访问(Sequential Access):连续读取相邻块,速度较快。
- 随机访问(Random Access):读取位置分散的块,速度较慢。
数据库系统中的基本 I/O 操作可以理解为:
- Disk read:把一个块从磁盘移动到主存。
- Disk write:把一个块从主存写回磁盘。
这里的 块(block) 是磁盘与主存之间数据传输的逻辑单位。后面所有 I/O 代价模型都围绕“访问了多少个块”展开。
1.6 Tertiary Storage:三级存储
三级存储(Tertiary Storage) 例如磁带、光盘库等,主要用于归档、备份和冷数据保存。它的容量可以达到 TB 甚至更高,单位成本更低,但访问时间远高于磁盘。
三级存储通常只支持或更适合 顺序访问。这意味着如果要读取中间某个数据,可能必须先经过前面的许多数据,因此不适合频繁随机查询,但适合长期归档、备份恢复、历史数据保存等场景。
1.7 易失性与非易失性
存储介质还可以按断电后数据是否保留来分类:
| 类型 | 含义 | 例子 |
|---|---|---|
| 易失性(Volatile) | 断电后数据丢失 | cache、main memory |
| 非易失性(Non-volatile) | 断电后数据仍保留 | magnetic disks、tapes、CD-ROM |
数据库必须依赖非易失性存储来保证持久化,但又必须使用易失性存储来获得高性能。这正是数据库缓冲区管理、日志、检查点和恢复机制存在的背景。
2 Moore 定律与数据库 I/O 瓶颈
2.1 Moore 定律的基本含义
Moore 定律常被概括为:大约每 \(18\) 个月翻倍,或者大约每 \(10\) 年增长 \(100\) 倍。增长对象包括:
- 处理器速度。
- 存储每 bit 成本的下降速度。
形式上可以近似理解为:
\[ 2^{\frac{10\times 12}{18}} \approx 100 \]
也就是说,十年尺度上硬件能力会发生数量级变化。对数据库系统来说,重要的不是“所有东西都变快”,而是 不同部件变快的速度不一样。
2.2 存储访问相对变慢
这里提出的第一个后果是:Storage access becomes slower。这句话不是说磁盘的绝对访问时间一定变慢,而是说相对于 CPU 运算速度,数据访问延迟越来越显著。
CPU 速度提升很快,但把数据从磁盘、主存等较低层次移动到较高层次的时间改善较慢。于是:
- CPU 每秒能做更多计算。
- 但等待数据从低层存储移动上来的时间没有同比例缩短。
- 结果是系统越来越容易被 I/O 卡住,而不是被 CPU 算力卡住。
因此,数据库性能优化经常不是优化单条指令,而是减少 I/O 次数、增加顺序访问、减少随机访问、提高缓存命中率。
2.3 Data Flood:数据洪流
这里提出的第二个后果是 Data Flood。随着单位存储价格下降,社会和应用产生、保存的数据量快速增长。例如数据仓库、互联网日志、Web 归档、天文观测等场景都会持续产生大量数据。
这里的核心矛盾是:存储容量增长很快,但数据需求增长得也很快,甚至更快。数据库系统面对的不是“数据终于可以全部放进内存”的世界,而是“能保存的数据越来越多,需要处理的数据也越来越大”的世界。
所以 DBMS 必须把大规模数据处理建立在外存模型上,不能只假设数据都在内存里。
3 磁盘结构与块访问机制
3.1 磁盘的机械组成
传统机械磁盘由多个盘片、盘面、磁道、扇区、磁头和磁盘控制器组成。磁盘访问不是单纯的电子寻址,还包含磁头移动和盘片旋转等机械运动。
| 概念 | 含义 |
|---|---|
| 盘片(platter) | 存储数据的圆形磁性介质 |
| 盘面(surface) | 盘片的一个可读写表面 |
| 磁道(track) | 盘面上的同心圆轨道 |
| 柱面(cylinder) | 多个盘面上半径相同的一组磁道 |
| 扇区(sector) | 磁盘上的物理存储单位 |
| 块(block) | 磁盘与主存之间传输数据的逻辑单位,一个块可包含一个或多个扇区 |
| 磁头(head) | 负责读写某个盘面的部件 |
| 磁盘控制器(disk controller) | 控制磁头移动、选择盘面与扇区、传输数据 |
数据库系统一般不直接以扇区为单位思考,而更常以 block/page 为单位管理数据。block 是磁盘和主存之间传输的逻辑单位,后续 I/O 代价分析也以 block access 为基本单位。
3.2 磁盘控制器
磁盘控制器(Disk Controller) 负责协调底层磁盘操作,包括:
- 控制磁头组件移动。
- 选择具体盘面和扇区。
- 在磁盘和主存之间传输数据。
- 一个控制器可以控制多个磁盘。
这说明磁盘访问时间不仅取决于磁盘本身,也可能受控制器、总线、内存带宽等资源影响。在理论代价模型中,这些因素常被简化;但在真实系统中,它们会影响并行磁盘、预取和大规模缓冲的效果。
3.3 磁盘存储参数
影响磁盘容量和性能的典型参数包括:
- 磁盘转速,例如 \(5400\) RPM。
- 每个磁盘单元中的盘片数量,例如 \(5\) 个盘片、\(10\) 个盘面。
- 每个盘面的磁道数,例如 \(20000\) 条磁道。
- 每条磁道的字节数,例如 \(1\) MB。
这些参数共同决定磁盘容量和访问性能。粗略地说,容量可以从“盘面数、每盘面磁道数、每磁道字节数”等指标相乘得到;而性能则与磁头移动、旋转速度、传输速率等因素相关。
3.4 访问一个磁盘块的三个步骤
访问一个磁盘块通常分成三步:
- 移动磁头到正确柱面:产生 seek time。
- 等待磁盘旋转到目标扇区:产生 rotational delay。
- 传输数据:产生 transfer time。
这三个步骤对应磁盘访问时间模型:
\[ \text{Time} = \text{Seek Time} + \text{Rotational Delay} + \text{Transfer Time} + \text{Other} \]
理解这个模型非常重要,因为它解释了为什么随机 I/O 昂贵。随机访问每次都可能需要重新寻道和等待旋转,而顺序访问可以摊薄这些机械代价。
4 磁盘访问时间模型
4.1 Seek Time:寻道时间
寻道时间(Seek Time) 是磁头移动到目标柱面的时间。它通常与磁头移动距离相关,距离越远,时间越长,单位通常是毫秒。
平均随机寻道时间可以表示为:
\[ S= \frac{ \sum_{i=1}^{N} \sum_{\substack{j=1\\j\ne i}}^{N} \text{SEEKTIME}(i\to j) }{ N(N-1) } \]
其中 \(N\) 是柱面数量,\(\text{SEEKTIME}(i\to j)\) 表示磁头从柱面 \(i\) 移动到柱面 \(j\) 的时间。典型平均随机寻道时间约为 \(10\) ms 到 \(40\) ms。
练习中要注意:寻道时间不是访问数据本身的传输时间,而是机械定位成本。随机 I/O 之所以慢,主要原因之一就是每次都可能付出寻道时间。
4.2 Rotational Delay:旋转延迟
旋转延迟(Rotational Delay) 是磁头已经在正确磁道上后,等待目标块转到磁头下方的时间。
如果目标块在磁道上的位置随机,平均旋转延迟约为半圈:
\[ R=\frac{1}{2}\text{ revolution} \]
例如,当磁盘转速为 \(3600\) RPM 时,平均旋转延迟约为 \(8.33\) ms。计算方法是:
\[ 3600\text{ RPM}=60\text{ revolutions/second} \]
一圈时间为:
\[ \frac{1}{60}\text{ second}=16.67\text{ ms} \]
半圈即:
\[ 8.33\text{ ms} \]
4.3 Transfer Time:传输时间
传输时间(Transfer Time) 是数据真正从磁盘传到主存,或从主存写回磁盘所花的时间。若磁盘传输速率为 \(t\),块大小为 \(\text{Block Size}\),则:
\[ \text{Transfer Time}= \frac{\text{Block Size}}{t} \]
在这个模型里,典型传输速率取 \(1\) 到 \(3\) MB/s。虽然现代硬件数值会变化,但模型思想不变:传输时间与块大小成正比,与传输速率成反比。
4.4 Other Delays:其他延迟
其他延迟包括:
- CPU 发起 I/O 请求的时间。
- 控制器竞争。
- 总线竞争。
- 内存访问竞争。
这里为了简化模型,把典型值设为 \(0\)。这并不表示真实系统不存在这些延迟,而是说明在基础 DBMS 代价模型中,重点通常放在 seek、rotation 和 transfer 上。
4.5 随机 I/O 与顺序 I/O
一个非常重要的经验法则是:
Random I/O is expensive, sequential I/O is much less expensive.
原因是:
- 随机读一个块时,通常需要寻道、旋转等待和传输。
- 顺序读下一个块时,如果数据布局合理,可以几乎只付出传输时间。
例如:
| 访问方式 | 1 KB block 的典型时间 |
|---|---|
| Random I/O | 约 \(20\) ms |
| Sequential I/O | 约 \(1\) ms |
这个差异直接影响数据库算法设计。例如外部排序、扫描、连接算法都倾向于把访问组织成大块顺序 I/O,而不是大量分散随机 I/O。
4.6 写操作与修改块
写块的成本通常与读块相似。但如果写完后需要验证写入是否正确,则需要额外成本:
\[ \text{extra time}= \text{full rotation} +\frac{\text{Block Size}}{t} \]
原因是磁头写完一个块后,不能立刻“回到”刚写过的位置进行验证,通常要等磁盘再转一圈。
修改一个块通常包括:
- 读入块。
- 在内存中修改。
- 写回块。
- 如需要,再进行验证。
所以数据库中的更新操作往往比表面上复杂。即使只改一条记录,也可能涉及整个页/块的读入和写回。
5 DBMS 的 I/O 计算模型
5.1 RAM 模型的局限
传统 RAM 模型(Random Access Machine Model) 假设数据都在主存中,并且访问任意数据项所花时间相同。在许多算法课中,这个模型很自然,因为它适合分析 CPU 计算复杂度。
但 DBMS 面临的情况不同:
- 数据通常不能完全放入主存。
- 数据需要存储在二级甚至三级存储中。
- 磁盘 I/O 时间远大于内存中处理数据的时间。
因此,直接使用 RAM 模型会低估数据库算法的真实代价。例如,一个内存中 \(O(n\log n)\) 的排序算法,如果频繁随机访问磁盘,实际性能可能非常差。
5.2 I/O Model of Computation
DBMS 代价分析常用 I/O 计算模型(I/O Model of Computation)。它的基本假设是:
执行磁盘 I/O 的时间远大于在主存中操作数据的时间。
因此,优化目标是:
\[ \text{minimize the number of block accesses} \]
也就是尽可能减少磁盘块访问次数。这个模型的核心不是数 CPU 指令,而是数读写了多少个磁盘块。
例如,一个算法如果 CPU 操作稍多,但能把随机 I/O 变成顺序 I/O,通常在数据库中更有价值。后面的两阶段多路归并排序就是典型例子:它利用内存缓冲区,把大文件排序转化成可预测的顺序读写。
6 磁盘上的排序:两阶段多路归并排序
6.1 内存归并排序回顾
先看内存中的 归并排序(Merge Sort)。其递归关系为:
\[ T(n)=2T(n/2)+an \]
由主定理可得:
\[ T(n)=O(n\log n) \]
归并排序的基本过程是:
- 基础情况:只有一个元素的列表已经有序。
- 把列表平均分成两个子列表。
- 分别排序两个子列表。
- 把两个有序子列表线性合并。
两个有序列表的合并时间与两个列表总长度成线性关系。这个思想可以扩展到外存排序,但必须把“元素访问”改成“块 I/O”来分析。
6.2 为什么磁盘排序不能直接套用内存排序
如果数据全部在内存中,排序算法主要关注比较次数和 CPU 时间。但数据库中的关系可能比内存大得多,无法一次性装入内存。
若直接在磁盘上按普通归并排序方式频繁访问元素,会产生大量随机 I/O。由于随机 I/O 的寻道和旋转成本很高,实际性能会很差。
因此,外存排序的目标是:
- 尽量顺序读写磁盘块。
- 每次尽可能利用满主存。
- 把临时结果组织成较大的有序子列表。
- 减少完整扫描数据的轮数。
6.3 TPMMS 的两个阶段
两阶段多路归并排序(Two-phase, Multiway Merge-sort, TPMMS)分为两个阶段:
| 阶段 | 作用 | 结果 |
|---|---|---|
| Phase 1 | 把能放入主存的数据块读入内存并排序 | 生成若干个有序子列表 |
| Phase 2 | 多路归并所有有序子列表 | 得到一个完整有序文件 |
6.3.1 Phase 1:生成有序子列表
第一阶段每次读入一块“主存大小”的数据。假设主存能容纳 \(M\) 字节,就读入最多 \(M\) 字节的数据,在内存中用普通排序算法排序,然后把排序结果写回磁盘,形成一个有序子列表。
这一阶段的特点是:
- 读原始关系一次。
- 写出有序子列表一次。
- I/O 模式主要是顺序读写。
如果关系有 \(R\) 个磁盘块,则 Phase 1 的 I/O 代价为:
\[ 2R \]
其中 \(R\) 是读,\(R\) 是写。
6.3.2 Phase 2:多路归并
第二阶段把第一阶段生成的多个有序子列表归并成一个完整有序结果。Phase 2 的核心步骤是:
- 在所有子列表当前剩余元素的第一个元素中找最小 key。
- 把最小元素移动到输出缓冲区的第一个可用位置。
- 如果输出块满了,就把输出块写到磁盘,并重新初始化输出缓冲区。
- 如果某个输入缓冲区耗尽,就从对应子列表读取下一块。
这一阶段需要为每个输入子列表准备输入缓冲区,还需要一个输出缓冲区。由于每个子列表本身已经有序,所以每次只比较各子列表头部元素即可完成多路归并。
Phase 2 同样需要读所有有序子列表一次,并写最终结果一次,所以 I/O 代价也是:
\[ 2R \]
6.4 TPMMS 的 I/O 代价
如果关系共有 \(R\) 个块,则 TPMMS 总 I/O 代价为:
\[ 4R \]
解释如下:
| 阶段 | 读 I/O | 写 I/O | 合计 |
|---|---|---|---|
| Phase 1 | \(R\) | \(R\) | \(2R\) |
| Phase 2 | \(R\) | \(R\) | \(2R\) |
| 总计 | \(2R\) | \(2R\) | \(4R\) |
这个结论的前提是:第二阶段能够一次性归并所有第一阶段产生的有序子列表。如果子列表太多,内存缓冲区不够,就需要更多阶段。
6.5 TPMMS 可排序数据规模上界
TPMMS 能处理的数据规模有一个上界。设:
- 块大小为 \(B\) 字节。
- 主存大小为 \(M\) 字节。
- 每条记录大小为 \(R\) 字节。
主存中的缓冲区数量为:
\[ \frac{M}{B} \]
其中 Phase 2 需要 \(1\) 个输出缓冲区,因此最多可同时归并的输入子列表数量为:
\[ \frac{M}{B}-1 \]
Phase 1 中每个有序子列表最多包含:
\[ \frac{M}{R} \]
条记录,因为每次最多把 \(M\) 字节数据读入内存排序。
因此,TPMMS 能排序的总记录数上界为:
\[ \frac{M}{R}\left(\frac{M}{B}-1\right) \]
当 \(M/B\) 较大时,可近似为:
\[ \frac{M^2}{RB} \]
例如:
\[ M=10^8,\quad B=2^{14},\quad R=169 \]
则:
\[ \frac{M^2}{RB}\approx 4.2\text{ billion records} \]
约等于 \(2/3\) TB 数据。
这个公式背后的直观含义是:主存越大,TPMMS 能处理的数据规模增长非常快,因为主存既决定每个初始 run 的大小,也决定第二阶段能同时归并多少个 run。
7 更大关系的多阶段归并排序
7.1 为什么需要第三阶段
如果关系太大,Phase 1 产生的有序子列表数量超过了:
\[ \frac{M}{B}-1 \]
那么 Phase 2 无法一次性归并所有子列表。此时需要把若干子列表先归并成更大的有序列表,再进行最终归并。
这种情况称为 Multiway Merging of Larger Relations。基本思想是:
- 先用 TPMMS 对一组一组的数据排序,每组规模不超过 \(\frac{M^2}{RB}\) 条记录。
- 得到多个较大的有序列表。
- 在第三阶段中,再归并最多 \(\frac{M}{B}-1\) 个这样的列表。
7.2 三阶段能力上界
对于更大关系,能力上界为:
\[ \frac{M^3}{RB^2} \]
直观理解是:每多一轮多路归并,就能利用 \(\frac{M}{B}\) 级别的 fan-in 扩大可处理规模。
在同一组参数下,三阶段归并可以支持约 \(27\) trillion 条记录,约 \(4.3\) PB 数据。重点不是记住具体数值,而是理解:
外存排序的可处理规模由主存大小、块大小、记录大小和归并路数共同决定。
8 二级存储访问优化方法
8.1 优化目标
加速二级存储访问通常有五类方法:
- 按柱面组织数据。
- 使用多个磁盘。
- 磁盘镜像。
- 磁盘调度算法。
- 预取和大规模缓冲。
这些方法的共同目标是减少随机 I/O 的机械代价、提高并行度,或把等待 I/O 的时间与 CPU 处理时间重叠。
8.2 按柱面组织数据
按柱面组织数据(Organizing data by cylinders) 是指把经常一起访问的块放在同一柱面或相邻柱面上。
这样做的好处是:连续读取多个块时,可能只需要一次寻道和一次旋转等待,后续块主要付出传输时间。
例如,如果一个查询经常扫描同一个表的连续页,把这些页尽量放在相邻位置可以显著降低扫描时间。
对于 TPMMS:
- 这种策略可以显著减少 Phase 1 的时间,因为 Phase 1 需要顺序读入主存大小的数据块并写出有序子列表。
- 但对 Phase 2 没有明显好处,因为 Phase 2 需要从多个子列表交替读取,访问模式不再是单一连续扫描。
8.3 使用多个磁盘与条带化
使用多个磁盘(Using multiple disks) 可以把数据访问分摊到多个设备上。理想情况下,所有与读写磁盘相关的时间可以除以磁盘数量。
但这个理想效果有前提:
- 磁盘控制器能同时处理多个磁盘的数据传输。
- 总线带宽足够。
- 主存能以足够高的速率接收或发送数据。
典型方法是 条带化(Striping):把连续数据分布到多个磁盘上,使多个磁盘可以并行读写。例如读取一个大文件时,不是由一个磁盘独自传输所有块,而是多个磁盘同时传输不同部分。
条带化提升吞吐量,但也可能影响可靠性:如果没有冗余,一个磁盘故障可能导致整体数据不可用。因此实际系统常把条带化与镜像或校验结合起来。
8.4 磁盘镜像
磁盘镜像(Mirroring Disks) 指两个或多个磁盘保存完全相同的数据副本。这样做有两个动机:
- 高可用性(high availability):某个磁盘损坏时,可以从副本读取。
- 加速数据访问:多个副本可以服务并行读请求。
如果有 \(n\) 个副本,那么可以并行读取任意 \(n\) 个块。即使副本数量较少,也可以选择当前磁头位置更接近目标块的磁盘来读取,从而减少寻道时间。
镜像通常 不会加速写入,但也不会显著拖慢写入。原因是写操作需要把同样的数据写到所有副本上,无法像读操作那样只选择一个副本。但在并行写和控制器支持较好的情况下,写入时间不一定比单盘慢很多。
8.5 磁盘调度:电梯算法
当系统中有多个独立 I/O 请求时,请求服务顺序会影响总寻道时间。电梯算法(Elevator Algorithm) 的思想类似电梯运行:
- 磁头沿一个方向从内圈到外圈扫描请求。
- 到达当前方向上没有更多请求的位置后,再反向扫描。
- 这样可以避免磁头在磁盘上来回大幅跳动。
它相比 先来先服务(First-Come-First-Serve, FCFS) 更能降低平均寻道距离。
考虑一个简化模型:
\[ \text{average rotation time}+\text{block access time}=4.43\text{ ms} \]
\[ \text{seek time}=1+\frac{\text{number of tracks}}{1000}\text{ ms} \]
这个模型用于比较不同调度策略下的访问总时间。练习中如果遇到类似题目,应先计算请求顺序导致的磁道移动距离,再加上每次访问固定的旋转和块访问时间。
8.6 预取与大规模缓冲
预取(Prefetching) 是指当系统能够预测接下来的块访问顺序时,在程序真正需要之前提前把块读入内存。
例如顺序扫描一个文件时,系统可以在处理当前块的同时预读后续块。这样 CPU 处理和磁盘 I/O 可以部分重叠,减少等待时间。
大规模缓冲(Large-scale Buffering) 包括:
- track-size buffering:一次缓存整条磁道大小的数据。
- cylinder-size buffering:一次缓存整个柱面相关的数据。
这样可以把每个块都付出的寻道代价,变成每条磁道或每个柱面才付出一次寻道代价。
缺点是:需要额外内存。如果预取的数据最终没有被使用,还会浪费 I/O 和缓冲区空间。
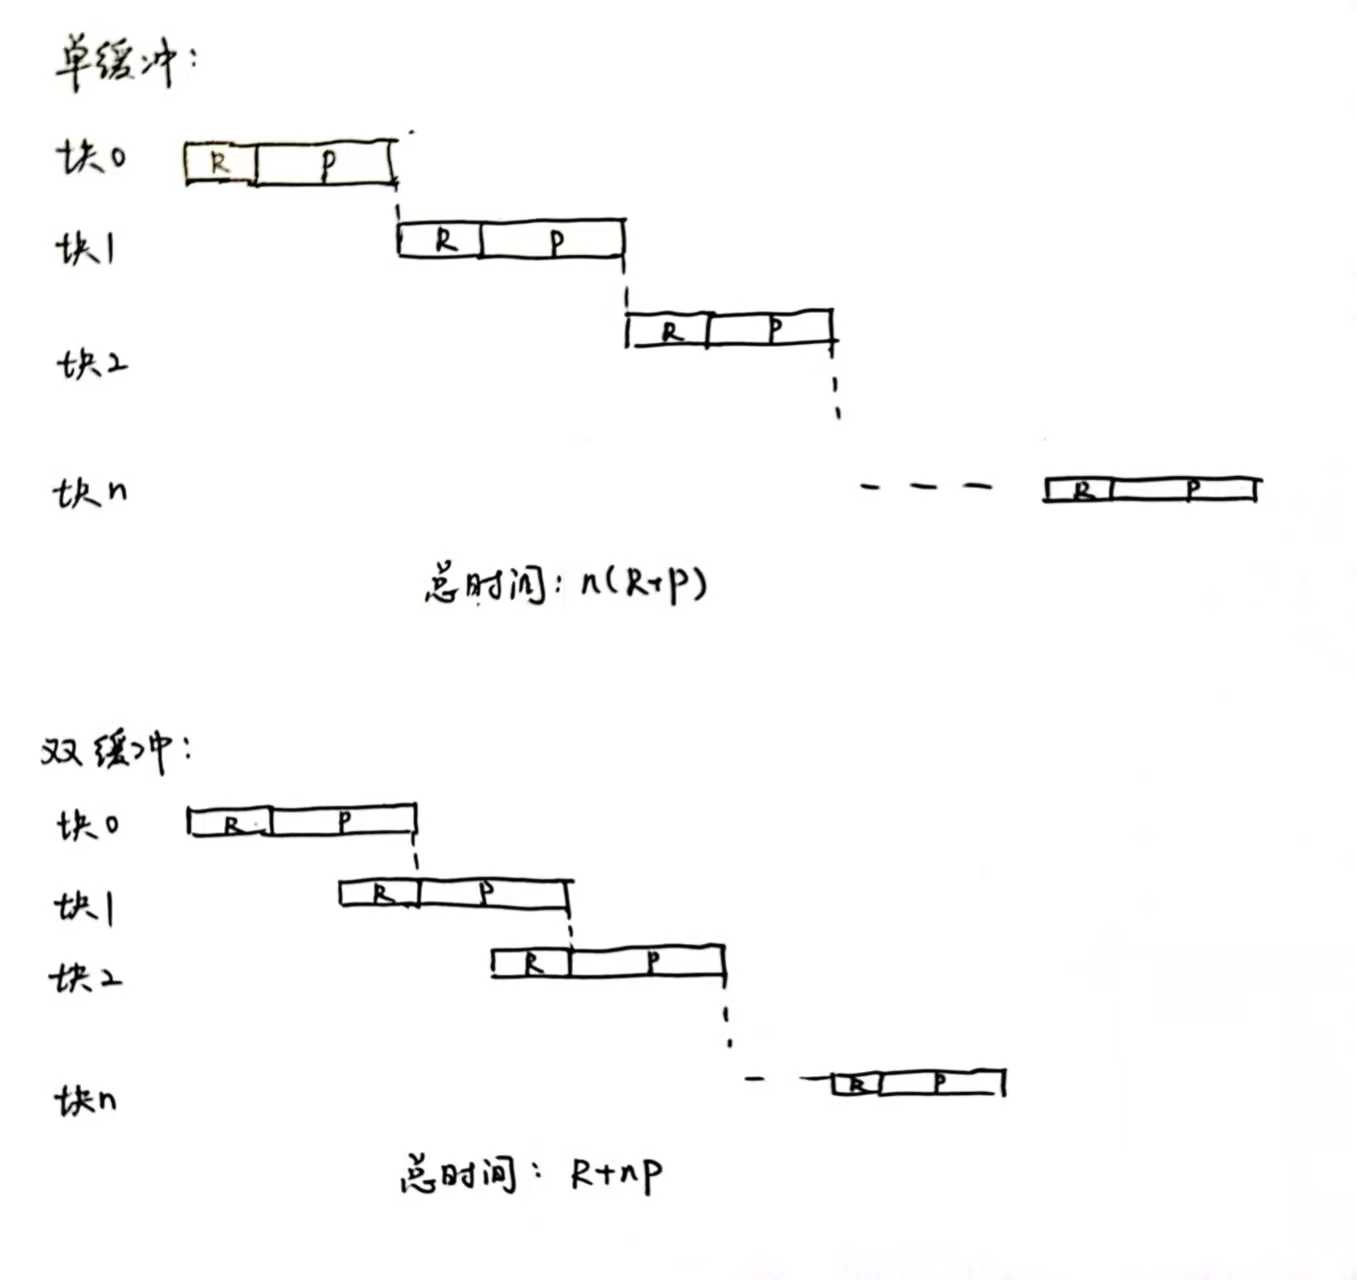
8.7 单缓冲与双缓冲
可以用顺序处理文件的过程理解 单缓冲(Single Buffering) 和 双缓冲(Double Buffering) 的区别。
假设:
- \(P\) = 每个块的处理时间。
- \(R\) = 读取一个块的 I/O 时间。
- \(n\) = 块数量。
8.7.1 单缓冲
单缓冲的流程是:
- 读入 \(B_1\) 到缓冲区。
- 处理缓冲区中的数据。
- 读入 \(B_2\) 到同一个缓冲区。
- 继续处理。
读和处理不能重叠,因此总时间为:
\[ n(P+R) \]
8.7.2 双缓冲
双缓冲使用两个缓冲区。当程序处理当前缓冲区中的块时,磁盘可以把下一个块读入另一个缓冲区。
当 \(P\ge R\) 时,双缓冲时间为:
\[ R+nP \]
解释如下:
- 开始时必须先花 \(R\) 时间读入第一个块。
- 之后每处理一个块花 \(P\) 时间。
- 因为 \(P\ge R\),读取下一个块可以被当前块处理时间覆盖。
与单缓冲相比:
\[ \text{Single Buffer} = n(P+R) \]
\[ \text{Double Buffer} = R+nP \]
双缓冲显著减少了等待 I/O 的时间。它并没有让磁盘本身更快,而是通过重叠 I/O 和计算提高整体吞吐。
9 总结
9.1 核心结论
数据库性能常由 I/O 决定,而不是 CPU 决定。
因为磁盘 I/O 时间远大于主存处理时间,所以 DBMS 算法设计通常以减少块访问次数为核心。随机 I/O 远慢于顺序 I/O。
随机 I/O 需要寻道和旋转等待,顺序 I/O 在布局合理时主要付出传输时间。磁盘访问时间模型是:
\[ \text{Time}= \text{Seek Time} +\text{Rotational Delay} +\text{Transfer Time} +\text{Other} \]
平均旋转延迟通常是半圈。
如果转速是 \(3600\) RPM,则一圈 \(16.67\) ms,平均旋转延迟 \(8.33\) ms。I/O 计算模型的优化目标是减少 block access 数量。
TPMMS 的 I/O 代价是 \(4R\)。
前提是第二阶段能一次性归并所有第一阶段产生的有序子列表。TPMMS 可排序记录数上界近似为:
\[ \frac{M^2}{RB} \]
更大关系的三阶段归并能力近似为:
\[ \frac{M^3}{RB^2} \]
双缓冲通过重叠 I/O 与处理降低总时间。
当 \(P\ge R\) 时:\[ \text{Double Buffering Time}=R+nP \]
9.2 常见概念对比
| 概念 | 容易混淆点 | 正确理解 |
|---|---|---|
| sector 与 block | 以为二者相同 | sector 是物理单位,block 是磁盘与主存传输的逻辑单位,一个 block 可包含多个 sector |
| seek time 与 rotational delay | 都是“找数据”的时间 | seek time 是磁头移动到柱面,rotational delay 是等待目标扇区转到磁头下 |
| random I/O 与 sequential I/O | 都读一个块,代价应相同 | random I/O 常要重新寻道和旋转,sequential I/O 可以摊薄这些成本 |
| RAM model 与 I/O model | 都是算法分析模型 | RAM model 重 CPU 操作,I/O model 重磁盘块访问次数 |
| striping 与 mirroring | 都使用多个磁盘 | striping 主要提高并行吞吐,mirroring 主要提高可用性并可加速读 |
| single buffering 与 double buffering | 都只是多一个缓冲区 | 双缓冲的关键是让 I/O 和处理重叠 |
9.3 典型计算题思路
9.3.1 磁盘访问时间计算
如果已知寻道时间、转速、块大小和传输速率,通常按下式计算:
\[ \text{Access Time}= \text{Seek Time} +\frac{1}{2}\text{Rotation Time} +\frac{\text{Block Size}}{\text{Transfer Rate}} \]
如果需要考虑写后验证,还要额外加:
\[ \text{Full Rotation} +\frac{\text{Block Size}}{\text{Transfer Rate}} \]
9.3.2 TPMMS 代价计算
如果关系有 \(R\) 个块,且内存足够在第二阶段归并所有 run:
\[ \text{Cost}=4R \]
如果问为什么不是 \(2R\),要回答:因为排序需要读原始数据、写临时有序子列表、再读临时子列表、写最终结果。
9.3.3 TPMMS 上界计算
设主存 \(M\)、块大小 \(B\)、记录大小 \(R\)。先计算:
\[ \text{buffer number}=\frac{M}{B} \]
最多输入 run 数为:
\[ \frac{M}{B}-1 \]
每个 run 的记录数为:
\[ \frac{M}{R} \]
所以可排序记录数为:
\[ \frac{M}{R}\left(\frac{M}{B}-1\right) \]
近似为:
\[ \frac{M^2}{RB} \]
9.3.4 缓冲时间计算
单缓冲:
\[ n(P+R) \]
双缓冲在 \(P\ge R\) 时:
\[ R+nP \]
如果 \(R>P\),则读取无法完全被处理覆盖,实际瓶颈会转向 I/O,此时不能机械套用 \(R+nP\),要根据题目给定条件分析流水线时间。
9.4 本章学习建议
学习本章时,不要只背硬件名词,而要抓住一条主线:
数据库数据太大,不能全放内存;磁盘随机访问很慢;因此 DBMS 用块作为 I/O 单位,并设计外存算法和缓冲技术来减少随机 I/O、增加顺序 I/O、重叠计算与 I/O。
如果能围绕这条主线解释存储层次、磁盘访问时间、I/O 模型、TPMMS 和双缓冲,本章的主要内容就已经串起来了。