目录
- 外部排序操作
- 关系操作的执行
- 查询优化简介
- 一个典型的关系查询优化器
- Proactive Query Re-optimization 补充
- 总结与公式汇总
1 外部排序操作
1.1 为什么数据库需要外部排序
排序(sorting)
是数据库系统中非常基础的操作。它不仅用于 ORDER BY
返回有序结果,还常出现在批量装载(bulk
loading)、重复元组删除、投影、集合操作以及连接算法中。数据库中的关系通常远大于内存,且
DBMS
还要支持多用户并发,因此不能假设数据可以一次性全部装入内存排序,这就需要
外部排序(external sorting)。
外部排序的性能通常以 磁盘 I/O 页数 衡量。原因是相对于内存计算,磁盘读写在传统数据库代价模型中占主导地位。因此,外部排序的公式基本都围绕“每一页被读几次、写几次”展开。
1.2 简单两路 Merge 排序
简单两路外部归并排序只使用 3 个缓冲页:两个输入缓冲页和一个输出缓冲页。基本思想是:
- Pass 0:每次读入一页,在内存中排序后写回磁盘,形成一个长度为 1 页的有序 run。
- 后续 Pass:每次选两个 run 进行归并,输出更长的 run。
- 不断重复,直到只剩下一个有序 run。
run 是指一个已经排好序的临时子文件/有序段,pass 是指 外部排序中的一轮处理过程。
例子:
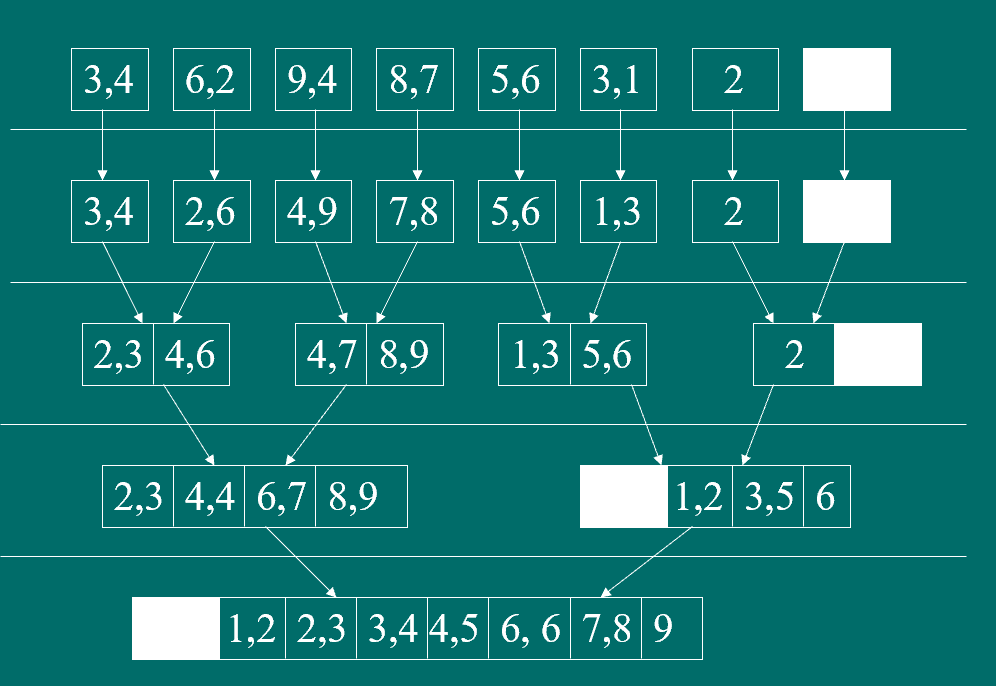
如果输入文件有 \(N\) 页,且 \(N=2^k\),那么:
- Pass 0 产生 \(N\) 个 run,每个 run 1 页。
- Pass 1 产生 \(N/2\) 个 run,每个 run 2 页。
- Pass 2 产生 \(N/4\) 个 run,每个 run 4 页。
- 总 pass 数为 \(\lceil \log_2 N \rceil + 1\)。
每个 pass 都要读一遍文件、写一遍文件,因此总代价为:
\[ 2N(\lceil \log_2 N \rceil + 1) \]
这里的 \(2N\) 表示一次完整 pass 中对 \(N\) 页各读一次、写一次。
1.3 多路外部 Merge 排序
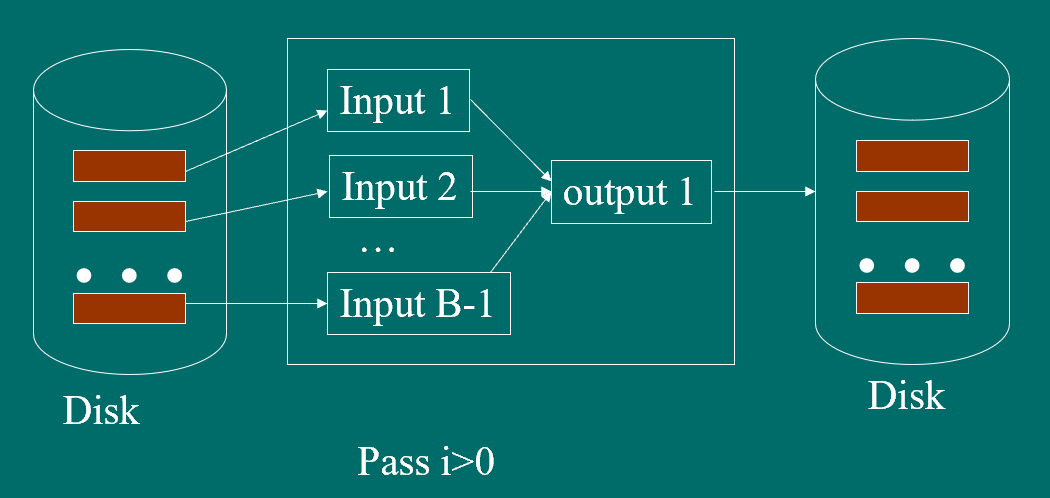
如果内存中有 \(B\) 个缓冲页(\(B-1\) 个输入缓冲区,\(1\) 个输出缓冲区),就可以比两路归并更有效地利用内存:
- Pass 0:分多次读入 \(B\) 页,在内存中排序,写出一个长度最多为 \(B\) 页的 run。
- 后续 Pass:使用 \(B-1\) 个缓冲页作为输入缓冲区,1 个缓冲页作为输出缓冲区,做 \(B-1\) 路归并。
第一次之后的 run 数为:
\[ N_1 = \lceil N/B \rceil \]
总扫描遍数为:
\[ \lceil \log_{B-1} N_1 \rceil + 1 \]
因此 I/O 代价为:
\[ 2N(\lceil \log_{B-1} \lceil N/B \rceil \rceil + 1) \]
举一个具体例子。为方便理解,先把“1 页”想成“1 个数字”。假设文件共有 \(N=12\) 页,内存有 \(B=4\) 页,原始数据顺序为:
1 | 9, 3, 7, 1, 8, 2, 6, 4, 12, 5, 11, 10 |
Pass 0 时,每次读入 4 页,在内存中排序后写出一个 run:
1 | Pass 0: |
所以 Pass 0 之后共有:
\[ N_1=\lceil 12/4\rceil=3 \]
个初始 run。后续归并阶段中,4 个缓冲页要分成 3 个输入缓冲页和 1 个输出缓冲页,因此一次最多可以做 \(B-1=3\) 路归并:
1 | Pass 1: |
这个例子只需要两个 pass:Pass 0 生成 3 个初始 run,Pass 1 把这 3 个 run 一次性归并完成。每个 pass 都读写整个文件一遍,所以总 I/O 约为:
\[ 2N \times 2 = 2 \times 12 \times 2 = 48 \]
也就是 48 次页 I/O。相比两路归并,多路归并的优势就在于:内存越多,一次能合并的 run 越多,所需 pass 数越少。
核心结论:缓冲页数越大,每轮可以归并的 run 越多,pass 数越少,I/O 代价下降明显。
1.4 减少初始 run 个数:Replacement Selection 思想
Pass 0 可以通过一些技巧让初始 run 平均长度达到约 \(2B\)。其思想类似 replacement selection:
- 使用输入缓冲区、输出缓冲区和当前排序缓冲区。
- 先把 \(B-2\) 页数据放入当前排序缓冲区并排序。
- 不断选择“比当前输出值更大”的最小记录输出,同时从输入缓冲区补充新记录。
- 当当前缓冲区中再也找不到可继续当前 run 的记录时,一个 run 结束。
举一个具体数字例子。为方便理解,假设当前排序缓冲区最多放 3 个数字,输入序列为:
1 | 5, 8, 10, 2, 6, 12, 1, 7 |
先读入前 3 个数字并排序:
1 | 当前排序缓冲区:[5, 8, 10] |
接下来不断输出“能接在当前 run 后面”的最小数字。刚开始还没有输出过数字,所以先输出 5,然后从输入中补入下一个数字 2:
1 | 输出 5 |
因为当前 run 最后一个数字是 5,而 2 小于 5,所以 2 不能继续放进当前 run,否则 run 就不是有序的。于是 2 被“冻结”,留给下一个 run。当前 run 只能继续从未冻结的 8 和 10 中选择最小值:
1 | 冻结:2 |
此时 6 小于当前 run 的最后一个数字 8,也不能接在当前 run 后面,因此 6 也被冻结。继续输出未冻结的 10:
1 | 冻结:2, 6 |
12 大于 10,可以继续当前 run,于是输出 12:
1 | 输出 12 |
这时当前缓冲区里已经没有未冻结、且能接在 12 后面的数字,所以第一个 run 结束:
1 | run1 = [5, 8, 10, 12] |
被冻结的数字会进入下一个 run。继续读取后面的 1 和 7 后,第二个 run 可以从这些数字开始重新排序生成:
1 | 待处理/冻结数据:2, 6, 1, 7 |
这个例子的重点是:虽然排序缓冲区一次只能放 3 个数字,但第一个 run 的长度达到了 4。实际数据库中,如果输入数据近似随机,新读入的数据大约有一半能继续接在当前 run 后面,因此初始 run 的平均长度可接近 \(2B\)。
这样做的意义是:初始 run 变长,后续归并 pass 数减少,从而降低 I/O。
1.5 块 I/O 与双缓冲区
1.5.1 块 I/O
如果一次读写一个连续块(block),每个块包含 \(b\) 个页,可以减少磁头移动或随机访问开销。此时可同时归并的 run 数不再是 \(B-1\),而是:
\[ F = \left\lfloor \frac{B-b}{b} \right\rfloor \]
其中 \(B\) 是总缓冲页数,\(b\) 是每个块的页数。若初始 run 平均长度用优化方法达到约 \(2B\),则:
\[ N_2 = \lceil N/(2B) \rceil \]
扫描遍数可估为:
\[ \lceil \log_F N_2 \rceil + 1 \]
1.5.2 双缓冲区
排序时间包含 I/O 时间和 CPU 计算时间。普通方法中,CPU 计算和 I/O 往往串行发生。双缓冲区(double buffering) 为每个 run 准备两个缓冲区:一个缓冲区做 I/O 时,另一个缓冲区被 CPU 处理,从而实现 I/O 与计算重叠,提高吞吐率。
1.6 利用 B+ 树进行排序
B+ 树索引可以天然提供按键值有序的访问路径,但聚集索引与非聚集索引差别很大:
| 索引类型 | 排序访问特点 | 代价直觉 |
|---|---|---|
| 聚集 B+ 树索引 | 数据页本身按照索引键顺序组织 | 顺序扫描数据页,排序和访问性能都高 |
| 非聚集 B+ 树索引 | data entry 有序,但数据页物理位置无序 | 可能需要大量随机 I/O |
非聚集索引排序的代价可估为:
\[ (f+p)N \]
其中 \(N\) 是数据页数,\(p\) 是每页平均记录数,\(f\) 是 data entry 长度与记录长度的比值。该公式反映了:既要扫描索引项,又可能为每条记录访问数据页。
2 关系操作的执行
2.1 查询执行中的三类基本技术
关系操作包括选择、投影、连接、集合、聚集等操作。不同操作会有多种执行方法,优化器根据表大小、索引、排序状态、缓冲区大小和中间结果特性选择具体算法。
常见基本技术有三类:
| 技术 | 含义 | 典型用途 |
|---|---|---|
| Iteration | 顺序扫描关系或索引项,逐条检查 | 无索引选择、聚集 |
| Indexing | 利用索引定位满足条件的元组 | 选择、索引嵌套循环连接 |
| Partitioning | 通过排序或哈希把关系划分成更小部分 | 投影去重、Hash Join、Sort-Merge Join |
2.2 访问路径与选择率
访问路径(access path) 指从关系中访问记录的方法,包括:
- 文件扫描(file scan)。
- 利用索引和匹配条件访问,例如
attr op value。
这里“选择率(selectivity)”用总共访问的页数衡量。更准确地说,优化目标是选择访问页数更少、过滤效果更好的访问路径。索引只有建立在相关属性上,且谓词形式适合该索引时,才能成为有效访问路径。
后续例子使用:
Reserves(sid, bid, day, rname):1000 页,每页 100 条记录。Sailors(sid, sname, rating, age):500 页,每页 80 条记录。- 只考虑 I/O 页数,忽略结果输出大小。
2.3 Selection 操作
以查询:
1 | SELECT * |
为例。它对应关系代数:
\[ \sigma_{rname='Joe'}(R) \]
2.3.1 无索引、数据无序
只能扫描整个表。对 Reserves 来说代价为 1000 次
I/O。优点是简单稳定,缺点是无论结果多少都要读完整表。
2.3.2 无索引、数据有序
如果数据已经按选择属性排序,可用二分查找找到起点。例如 1000 页约需:
\[ O(\log_2 1000) \approx 10 \]
次 I/O 找到位置。对于范围条件如
attr > 5,找到起点后再顺序扫描后续页。
2.3.3 使用 B+ 树索引
B+ 树索引适合等值查询和范围查询。执行过程是:
- 从根到叶找到满足条件的起始 data entry。
- 沿叶节点顺序扫描满足条件的 data entry。
- 根据 data entry 中的 rid 访问数据元组。
主要代价不在“找到叶节点”,因为通常只需 2-3 次 I/O;真正的差异来自索引是否聚集:
| 情况 | 读取结果元组的代价 |
|---|---|
| 聚集索引 | 满足条件的数据页通常连续,范围查询代价接近结果页数 |
| 非聚集索引 | 数据页分散,最坏接近每条结果一次 I/O |
例如 rname < 'c%' 返回 10% 的
Reserves:
- 聚集索引:约访问 100 个数据页。
- 非聚集索引:最坏可能访问 10000 次记录级随机 I/O。
- 如果先对 page id 排序,可避免重复读同一页,最坏约 1000 页。
2.3.4 使用 Hash 索引
Hash 索引适合 等值选择,不适合范围查询。执行过程是:
- 根据 Hash 函数找到桶。
- 在桶中检查 data entry。
- 根据 rid 访问数据页。
如果索引非聚集,且结果较多,访问结果元组时仍可能产生大量随机 I/O。对 page id 排序可以减少重复读取。
2.4 General Selection 操作
一般选择条件是由逻辑连接词 \(\land\) 和 \(\lor\) 组成的表达式,通常可以用 CNF(Conjunctive Normal Form,合取范式) 描述:
- 一个 CNF 是多个 conjunct 用 \(\land\) 连接。
- 一个 conjunct 可以是多个 term 用 \(\lor\) 连接。
- term 形式通常是
attr op value或attr1 op attr2。
例如:
\[ (day<8/9/94 \land rname='Joe') \lor bid=5 \lor sid=3 \]
可变换为:
\[ (day<8/9/94 \lor bid=5 \lor sid=3) \land (rname='Joe' \lor bid=5 \lor sid=3) \]
2.4.1 复合索引匹配规则
设条件为:
\[ rname='Joe' \land bid=5 \land sid=3 \]
复合索引能否使用,取决于索引类型和属性顺序:
| 索引 | 能否支持条件 | 说明 |
|---|---|---|
Hash(<rname,bid,sid>) |
支持完整三属性等值查询 | 但不能直接支持只给
<rname,bid> 的前缀查询 |
B+
树(<rname,bid,sid>) |
支持完整查询,也支持
<rname,bid> 前缀 |
不适合只给
bid=5 AND sid=3 |
Hash/B+
树(<bid,sid>) |
支持 bid=5 AND sid=3 |
之后还需检查 rname |
关键辨析:B+ 树复合索引通常支持最左前缀;Hash 复合索引通常要求完整键值匹配。
2.4.2 不含 disjunction 的选择
如果选择条件没有 \(\lor\),可以:
- 文件扫描并检查所有 conjunct。
- 选择过滤性最强的 primary conjunct,通过索引先取候选元组,再用剩余条件筛选。
- 如果多个索引都能提供候选 rid 集合,可以分别取出 rid,再做交集。
实际系统中 rid 集合交操作可能使用位图、Hash Join、Bloom filter 或索引连接等方法。
2.4.3 包含 disjunction 的选择
如果条件中有 \(\lor\),处理更复杂。关键原则是:
- 若某个 disjunct 无法使用索引且需要全表扫描,则整个 \(\lor\) 条件往往难以避免全表扫描。
- 若每个 disjunct 都有索引支持,可以分别通过索引找候选集合,再做并集。
- 若外层还有强选择条件,例如:
\[ (day<8/9/94 \lor rname='Joe') \land sid=3 \]
可以先利用 sid=3 的索引缩小候选集,再检查前半部分。
2.5 Projection 操作
投影操作如:
1 | SELECT DISTINCT R.sid, R.bid |
对应:
\[ \pi_{sid,bid}(Reserves) \]
投影有两个任务:
- 去掉不需要的属性。
- 如果有
DISTINCT,删除重复元组。
2.5.1 基于排序的投影
基本步骤:
- 扫描关系 \(R\),生成只包含目标属性的中间结果。
- 对中间结果排序。
- 扫描排序结果,比较相邻元组并去重。
设原表大小为 \(M\) 页,投影后的中间结果为 \(T\) 页,则基础代价包括:
- 扫描并写出中间结果:\(M+T\)。
- 排序中间结果:取决于外排序代价。
- 扫描排序结果去重:\(T\)。
例如,Reserves 为 1000 页,投影后 sid+bid
长度为原记录的 \(10/40=\frac{1}{4}\),所以 \(T=250\) 页。直接方法代价为:
\[ 1000+250+2\times2\times250+250=2500 \]
若有 20 页缓冲区,可将投影写出与排序 Pass 0 合并,并在 merge 时去重,总代价可降为约 1500。
举一个小例子。假设原关系 Reserves 中有如下 6
条记录:
| sid | bid | day |
|---|---|---|
| 22 | 101 | 10/10 |
| 31 | 101 | 10/11 |
| 22 | 101 | 10/12 |
| 58 | 103 | 11/12 |
| 31 | 102 | 10/13 |
| 31 | 101 | 10/14 |
执行:
1 | SELECT DISTINCT sid, bid |
第一步先扫描原表,只保留投影属性 sid 和
bid,得到中间结果:
1 | (22,101), (31,101), (22,101), (58,103), (31,102), (31,101) |
第二步对中间结果按 (sid,bid) 排序:
1 | (22,101), (22,101), (31,101), (31,101), (31,102), (58,103) |
第三步顺序扫描排序结果,只要当前元组和前一个元组相同,就丢弃当前元组。最终得到:
1 | (22,101), (31,101), (31,102), (58,103) |
排序方法去重的关键是:重复元组在排序后会相邻出现,因此只需要比较相邻元组即可删除重复项。
2.5.2 基于 Hashing 的投影
Hash 投影分两阶段:
- 分区阶段:扫描输入,把投影后的元组用 Hash 函数分到 \(B-1\) 个分区。
- 去重阶段:逐个读取分区,在内存中用另一个 Hash 函数去重。
如果第二阶段每个分区都能放入内存:
\[ \text{总代价}=M+2T \]
对示例:
\[ 1000+2\times250=1500 \]
仍然使用上面的投影中间结果:
1 | (22,101), (31,101), (22,101), (58,103), (31,102), (31,101) |
假设内存中可以使用 3 个输出分区,即分区阶段把元组分到
partition0、partition1、partition2。为了便于说明,设
Hash 函数按 sid mod 3 分区:
1 | (22,101) -> 22 mod 3 = 1 -> partition1 |
这个 Hash
函数在这个小例子里分布很差,所有元组都落到同一个分区。为了展示正常分区效果,也可以设
Hash 函数按 (sid+bid) mod 3 分区:
1 | (22,101) -> 123 mod 3 = 0 -> partition0 |
分区阶段结束后:
1 | partition0: (22,101), (31,101), (22,101), (31,101) |
第二阶段逐个读取分区,在内存 Hash 表中删除重复元组:
1 | 处理 partition0: |
最终结果仍然是:
1 | (22,101), (31,101), (31,102), (58,103) |
Hash 方法去重的关键是:相同的投影元组一定会被 Hash 到同一个分区,所以只要在每个分区内部去重,就不会漏掉跨分区重复项。
2.5.3 排序投影与 Hash 投影比较
| 方法 | 优点 | 局限 |
|---|---|---|
| 排序投影 | 结果有序;对小内存和数据倾斜更稳健 | 排序 I/O 可能较高 |
| Hash 投影 | 内存足够且分布均匀时效率高 | 数据倾斜或分区过大时可能退化 |
| 索引投影 | 若所需属性都在索引中,可不访问数据表 | 依赖覆盖索引 |
2.6 Join 操作
连接例子:
1 | SELECT * |
连接可视为笛卡尔积后再选择,但实际执行不会真的先生成完整笛卡尔积,因为那会极其昂贵。
设:
- \(R\) 有 \(M\) 页,每页 \(P_R\) 个元组。
- \(S\) 有 \(N\) 页,每页 \(P_S\) 个元组。
下面各 Join 例子都使用同一组小数据。假设要执行:
1 | SELECT R.sid, S.sname, R.bid |
Sailors 表:
| sid | sname |
|---|---|
| 22 | Dustin |
| 31 | Lubber |
| 58 | Rusty |
Reserves 表:
| sid | bid |
|---|---|
| 22 | 101 |
| 31 | 102 |
| 22 | 103 |
| 44 | 104 |
| 58 | 105 |
正确 Join 结果应为:
1 | (22, Dustin, 101) |
Reserves 中的 (44,104) 找不到
sid=44 的 Sailors
元组,因此不会出现在结果中。
2.6.1 简单嵌套循环 Join
伪代码思想:
1 | for each tuple r in R: |
若 \(R\) 为 outer,\(S\) 为 inner,逐元组扫描代价为:
\[ M + P_R \times M \times N \]
对 \(M=1000, P_R=100, N=500\):
\[ 1000 + 100 \times 1000 \times 500 = 1000 + 5\times10^7 \]
优化方式:
- 一次读入 outer 的一页,而不是一个元组,代价可近似为 \(M+MN\)。
- 选择较小关系作为 outer,减少 outer 循环次数。
用上面的小数据举例,令 Reserves 为
outer,Sailors 为 inner。简单嵌套循环会对每条
Reserves 元组完整扫描一遍 Sailors:
1 | 外层 R=(22,101): |
这个例子里有 5 条 Reserves、3 条
Sailors,所以会做 \(5\times3=15\)
次元组比较。它的特点是非常直接,但 inner 表会被反复扫描。
2.6.2 块嵌套循环 Join
块嵌套循环连接(block nested loop join)每次将 \(B-2\) 页 outer 关系读入内存,1 页用于 inner 输入,1 页用于输出。代价为:
\[ M+\left\lceil \frac{M}{B-2} \right\rceil N \]
对 \(M=1000, N=500, B=100\):
\[ 1000+\left\lceil \frac{1000}{98}\right\rceil \times 500 \approx 1000+10\times500=6000 \]
如果将较小的 Sailors 作为 outer:
\[ 500+\left\lceil \frac{500}{98}\right\rceil \times 1000 \approx 5500 \]
内存中的 outer block 可以建 Hash 表,以加快与 inner 页元组的匹配,但这主要降低 CPU 代价,I/O 公式仍由扫描次数决定。
用小数据举例,假设内存一次可以放入 2 条 outer 元组作为一个 block。把
Reserves 分成 3 个 block:
1 | Block 1: (22,101), (31,102) |
执行时每次读入一个 Reserves block,然后扫描整个
Sailors:
1 | 读入 Block 1: |
和简单嵌套循环相比,块嵌套循环不是“每条 outer 元组扫描一次 inner”,而是“每个 outer block 扫描一次 inner”。如果 block 越大,inner 被重复扫描的次数越少。CPU 比较次数未必降低特别多,它真正省的是 inner 表反复从磁盘读入的 I/O 代价。
2.6.3 索引嵌套循环 Join
索引嵌套循环连接(index nested loop join)要求 inner 关系在连接属性上有索引。执行方式是:
1 | for each tuple r in R: |
其代价可理解为:
\[ \text{扫描 outer 的代价} + \text{outer 元组数} \times \text{每次索引查找及取数代价} \]
如果 inner 索引是 B+ 树,定位叶节点通常 2-4 次 I/O;如果是 Hash 索引,通常 1-2 次 I/O。若索引非聚集,取数据元组的随机 I/O 可能很高。
如果 Sailors.sid 上有 Hash 索引,且 sid
是键,每个 Reserves 元组最多匹配一个 Sailors
元组,则代价约为:
\[ 1000 + 100000 \times 1.2 \]
其中 \(100000\) 是
Reserves 的元组数。
用小数据举例,仍令 Reserves 为 outer,并假设
Sailors.sid 上有 Hash 索引:
1 | Sailors.sid 的索引: |
执行过程变成:
1 | 读 R=(22,101): |
这里不再反复扫描完整 Sailors,而是对每条 outer
元组做一次索引查找。若 outer 很小、inner
索引选择性高,这种方法通常很快;但如果索引非聚集且匹配结果很多,随机访问数据页的代价可能很高。
2.6.4 Sort-Merge Join
Sort-Merge Join 适合等值连接,特别是输入已排序或需要输出有序结果时。步骤:
- 如果 \(R\) 未按连接属性排序,则排序 \(R\)。
- 如果 \(S\) 未按连接属性排序,则排序 \(S\)。
- 用两个指针顺序扫描两个有序关系,找到连接属性相同的分组并输出匹配结果。
代价包括:
\[ \text{sort}(R)+\text{sort}(S)+M+N \]
当 \(M=1000, N=500, B=100\) 时,排序代价为:
\[ 2\times2\times1000 + 2\times2\times500 = 6000 \]
merge 阶段:
\[ 1000+500=1500 \]
总代价为 7500。
如果排序的最后一次 merge 可以和 Join 的 merge 合并,还能进一步减少 I/O。
用小数据举例,先分别按 sid 排序:
1 | Reserves 按 sid 排序: |
然后用两个指针从前往后扫描:
1 | R 指向 sid=22,S 指向 sid=22: |
Sort-Merge Join
的关键是:两个输入已经按连接属性排序后,不需要反复回头扫描;指针整体向前移动即可。若某个
sid 在两边都有多个元组,则需要对这两个相同 sid
的分组做局部匹配。
2.6.5 Hash Join
Hash Join 分为两个阶段:
- Partitioning 阶段:对两个关系的连接属性使用同一个 Hash 函数分区。能连接的元组必定落在同编号分区。
- Probing 阶段:逐个处理对应分区。通常把较小分区装入内存建 Hash 表,再扫描另一个分区并探测匹配。
若分区能放入内存,代价为:
\[ 2(M+N)+(M+N)=3(M+N) \]
对 \(M=1000, N=500\):
\[ 3(1000+500)=4500 \]
如果某个分区太大,需再次分区。若缓冲区足够大,可以使用 Hybrid Hash Join:分区时保留一个分区在内存中,读另一个关系时直接完成该分区的 probing,从而减少一部分写出和读回。
用小数据举例,设 Hash 函数为:
\[ h(sid)=sid \bmod 3 \]
先进行 Partitioning 阶段。对 Reserves 分区:
1 | (22,101) -> 22 mod 3 = 1 -> R1 |
对 Sailors 分区:
1 | (22,Dustin) -> 22 mod 3 = 1 -> S1 |
得到:
1 | R1: (22,101), (31,102), (22,103), (58,105) |
Probing 阶段只需要比较同编号分区。比如处理 R1 和
S1 时,先把较小的 S1 放入内存 Hash 表:
1 | 内存 Hash 表: |
然后扫描 R1:
1 | R=(22,101) -> 查 22 -> 输出 (22,Dustin,101) |
R2 中的 (44,104) 只会和 S2
比较;由于 S2 为空,所以没有输出。Hash Join
的关键是:能连接的元组一定会落到同一个分区,因此不同分区之间不需要互相比较。
2.6.6 Join 算法比较
| Join 算法 | 适用条件 | 优点 | 风险或局限 |
|---|---|---|---|
| 简单嵌套循环 | 无索引、实现简单 | 通用 | 代价极高 |
| 块嵌套循环 | 有一定缓冲区 | 比简单嵌套循环大幅减少 inner 扫描次数 | 内存不足时仍要多次扫 inner |
| 索引嵌套循环 | inner 连接属性有索引 | outer 很小或索引选择性高时很好 | 非聚集索引可能随机 I/O 很高 |
| Sort-Merge Join | 等值连接、输入已排序、结果需有序 | 对数据倾斜较稳健,输出有序 | 排序代价高 |
| Hash Join | 等值连接、分布较均匀、内存足够 | 通常 I/O 代价低 | 不适合非等值连接;数据倾斜会影响分区 |
对于条件如 \(R.rname < S.sname\) 的非等值连接,Hash Join 和普通 Sort-Merge Join 不适用,索引嵌套循环可能更合适。
用一个选择算法的例子来总结。假设查询仍是:
1 | SELECT R.sid, S.sname, R.bid |
如果 Sailors.sid 上有 Hash 索引,且
Reserves 经过选择后只剩很少几条记录,那么
索引嵌套循环 Join 很合适,因为每条
Reserves 记录只需查一次索引。
如果两个表都很大、没有可用索引、连接条件是等值连接,并且内存足够让分区较好地放入缓冲区,那么 Hash Join 往往更合适,因为它通常只需要固定几遍扫描。
如果两个输入本来已经按 sid 排序,或者后续还需要按
sid 有序输出,那么 Sort-Merge Join
很有吸引力,因为它可以利用已有顺序,并产生有序结果。
如果没有索引、内存也比较小,但还能一次放入若干页 outer 关系,那么 块嵌套循环 Join 通常比简单嵌套循环更好,因为它减少了 inner 表的重复扫描次数。
2.7 集合操作与聚集操作
集合操作包括:
\[ R \cup S,\quad R \cap S,\quad R \times S,\quad R-S \]
其中交集和笛卡尔积可视为特殊 Join;并集和差集的关键是识别两个关系中相同元组,常用排序或 Hash 方法实现。
SQL-92 中常见聚集包括
AVG、MIN、MAX、SUM、COUNT。普通聚集通常扫描全表并维护少量状态:
| 聚集 | 需要维护的信息 |
|---|---|
SUM |
当前总和 |
AVG |
当前总和与计数 |
COUNT |
计数 |
MIN |
当前最小值 |
MAX |
当前最大值 |
GROUP BY 需要先按分组属性聚类,可用:
- 排序方法:按 group-by 属性排序后逐组聚集。
- Hash 方法:按 group-by 属性哈希分区并维护组状态。
- 索引方法:如果 group-by 属性上有索引,或所需属性都在索引中,可直接利用索引顺序或覆盖索引。
2.8 缓冲区对查询执行的影响
缓冲区大小对算法选择影响非常大。典型影响包括:
- 外排序中,\(B\) 越大,pass 数越少。
- 块嵌套循环中,\(B\) 越大,outer block 越大,inner 扫描次数越少。
- Hash Join 中,\(B\) 决定分区是否能放入内存。
- 非聚集索引访问数据页时,如果缓冲区太小且访问顺序混乱,会造成重复读页。
缓冲区替换策略也会影响执行。例如简单 nested loop join 中,如果 inner 关系不能全放入缓冲区,LRU 可能导致大量无效换入换出;某些访问模式下 MRU 反而更合适。对于 index nested loop join,如果 inner 索引非聚集,可以先按 outer 产生的 page id 排序,减少 inner 数据页重复读取。
3 查询优化简介
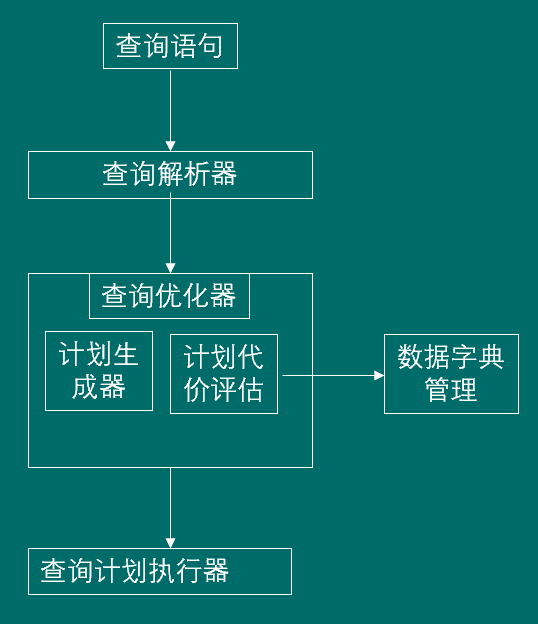
3.1 查询优化器的任务
同一个 SQL 查询可以有多种等价执行方式。查询优化器的任务是:
- 根据 SQL 生成关系代数表达式。
- 枚举可能的访问计划。
- 估算每个计划的执行代价。
- 选择代价最低或足够好的计划。
一个访问计划不仅描述关系代数树,还要在每个节点上标明:
- 关系访问方法,如 file scan、B+ 树索引、Hash 索引。
- 操作执行算法,如 block nested loop join、sort-merge join、hash join。
- 是否流水线执行(pipelined / on-the-fly)或物化中间结果。
3.2 流水线执行与物化
如果一个操作的结果直接传给下一个操作,不生成临时表,称为 流水线执行(pipelined evaluation / on-the-fly)。例如连续选择、选择后投影、某些连续连接都可以流水线。
如果一个操作先把结果写成中间表,再由父操作读取,称为 物化(materialization)。物化会增加写出和读回中间结果的 I/O,但有时是必要的,例如排序、Hash 分区或某些阻塞算子。
执行器通常提供迭代器接口:
| 接口 | 作用 |
|---|---|
Open |
初始化算子并分配缓冲区 |
Get_next |
产生下一个结果元组 |
Close |
释放资源 |
这个接口天然支持流水线:父算子调用子算子的
Get_next,逐步拉取结果。
3.2.1 流水线执行的例子
举一个流水线执行的例子:
1 | SELECT S.sname |
对应的逻辑操作是:
\[ \pi_{sname}(\sigma_{rating>5}(Sailors)) \]
如果采用流水线方式,执行过程可以是:
1 | File Scan 读出一条 Sailors 元组 |
例如 Sailors 表为:
| sid | sname | rating |
|---|---|---|
| 22 | Dustin | 7 |
| 31 | Lubber | 4 |
| 58 | Rusty | 10 |
流水线执行时:
1 | 读 (22,Dustin,7) -> rating>5 成立 -> 立刻输出 Dustin |
这里不会先把所有满足 rating>5
的元组写成临时表,再做投影;每条元组被读出后就沿着算子链向上流动。
3.2.2 物化的例子
再举一个物化的例子:
1 | SELECT S.rating, COUNT(*) |
如果采用基于排序的 GROUP BY,执行过程通常需要先把输入按
rating 排好序。排序是一个 阻塞操作(blocking
operator):它必须先看到足够多甚至全部输入,才能产生正确的有序输出。
假设 Sailors 表为:
| sid | sname | rating |
|---|---|---|
| 22 | Dustin | 7 |
| 31 | Lubber | 4 |
| 58 | Rusty | 7 |
| 44 | Guppy | 4 |
基于排序的物化过程可以是:
1 | 第一步:扫描 Sailors,取出 group-by 需要的 rating |
这里排序结果需要先形成一个中间状态,父算子不能在读到第一条元组时就立刻知道每个
rating 的最终
COUNT(*)。因此这种执行方式就是物化,或者至少包含一个必须暂存大量中间结果的阻塞阶段。
3.3 System R 优化器
System R 是第一个关系数据库管理系统,其优化器对后来的 DBMS 影响很大。它的主要特点包括:
- 使用系统统计信息估计访问计划代价。
- 主要考虑二元 Join,并用启发式方法减少候选计划数量。
- 不优化嵌套查询。
- 投影通常不做重复元组删除。
- 代价模型同时考虑 CPU 和 I/O,但这里的例子主要关注 I/O。
System R 风格优化器的核心思想是:用统计信息估计中间结果大小,再用代价模型比较不同计划。
3.4 系统数据字典
DBMS 的系统数据字典(system catalog / catalog)存储数据库对象及统计信息。优化器依赖这些信息估算代价。
对关系,数据字典记录:
- 关系名、属性名、属性类型。
- 索引名、约束描述。
- 元组数量、页数量。
对索引,数据字典记录:
- 索引名。
- 索引结构类型。
- 索引属性。
- 是否聚集。
- 不同键值数量、索引大小、高度、取值范围等。
统计信息越准确,优化器越容易选择正确计划。
举例来说,假设数据库里有两张表:
1 | Sailors(sid, sname, rating, age) |
3.4.1 描述关系的 catalog 表
系统数据字典中可能会有一张描述“关系”的 catalog 表,内容类似:
| relname | tuple_count | page_count | record_size |
|---|---|---|---|
| Sailors | 40000 | 500 | 50 bytes |
| Reserves | 100000 | 1000 | 40 bytes |
优化器看到这些信息后,就知道 Reserves 比
Sailors 更大。如果要做 block nested loop
join,它会倾向于考虑把较小的 Sailors 放在 outer
位置,因为这样 outer block 数量可能更少。
3.4.2 描述属性的 catalog 表
还可能有一张描述“属性”的 catalog 表:
| relname | attrname | type | length | low_value | high_value | num_distinct |
|---|---|---|---|---|---|---|
| Sailors | sid | integer | 4 | 1 | 60000 | 40000 |
| Sailors | rating | integer | 4 | 1 | 10 | 10 |
| Reserves | bid | integer | 4 | 1 | 500 | 500 |
| Reserves | sid | integer | 4 | 1 | 60000 | 30000 |
如果查询条件是:
1 | WHERE S.rating = 5 |
优化器可以用 num_distinct=10 粗略估计:
\[ RF(rating=5)=\frac{1}{10} \]
也就是说,Sailors 的 40000 条记录中,大约有 4000
条满足条件。如果查询条件是:
1 | WHERE R.bid = 100 |
优化器可以用 num_distinct=500 估计:
\[ RF(bid=100)=\frac{1}{500} \]
所以 Reserves 的 100000 条记录中,大约有 200
条满足条件。这个估计会影响优化器是否选择索引访问。
3.4.3 索引 catalog
索引 catalog 可能类似:
| index_name | relname | attrs | index_type | clustered | height | num_keys |
|---|---|---|---|---|---|---|
| idx_sailors_sid | Sailors | sid | Hash | yes | - | 40000 |
| idx_sailors_rating | Sailors | rating | B+Tree | no | 3 | 10 |
| idx_reserves_bid | Reserves | bid | B+Tree | yes | 3 | 500 |
| idx_reserves_sid | Reserves | sid | Hash | no | - | 30000 |
例如查询:
1 | SELECT * |
优化器看到 idx_reserves_bid 是建在 bid
上的聚集 B+ 树索引,并且 bid=100 预计只返回约 200
条记录,就可能选择该索引,而不是扫描 1000 页的整个 Reserves
表。
再看 Join 查询:
1 | SELECT * |
优化器可能根据 catalog 做出如下判断:
- 先用
idx_reserves_bid找到bid=100的少量Reserves元组。 - 对每条结果,用
idx_sailors_sid到Sailors中查对应水手。 - 因为
Sailors.sid是高选择性键值索引,所以 index nested loop join 可能很便宜。
如果 catalog 统计信息过期,例如 bid=100 实际上有 50000
条记录,但 catalog 仍估计只有 200 条,那么优化器就可能误选 index nested
loop join,导致大量随机 I/O。这也是为什么实际 DBMS
需要定期更新统计信息。
3.5 不同访问计划的代价差异
示例:
1 | SELECT S.sname |
原始关系代数可写成:
\[ \pi_{sname}(\sigma_{bid=100 \land rating>5}(Reserves \Join _{sid=sid} Sailors)) \]
如果直接对 Reserves 和 Sailors
做简单嵌套循环连接,代价可能为:
\[ 1000+1000\times500=501000 \]
但若先下推选择,假设:
Reserves选择结果为 10 页。Sailors选择结果为 250 页。- 缓冲区为 5 页。
采用排序并 Sort-Merge Join:
\[ (1000+10+500+250)+(40+2000+260)=4060 \]
采用 block nested loop join:
\[ 10 + 4 \times 250 = 1010 \]
总计:
\[ 1000+10+500+250+1010=2770 \]
如果能利用索引和流水线执行,例如 Reserves.bid 上有聚集
Hash 索引,Sailors.sid 上有 Hash
索引,总代价可能降到约:
\[ 10 + 1.2 \times 1000 = 1210 \]
这个例子说明:选择下推、合适的 Join 算法、索引利用和避免不必要物化,是查询优化的关键。
4 一个典型的关系查询优化器
4.1 SQL 查询块与关系代数转换
查询优化器通常先把 SQL 分解为多个 查询块(query
block)。一个查询块是不含嵌套的查询语句,具有唯一的
SELECT、FROM、WHERE、GROUP BY、HAVING
子句。
例如:
1 | SELECT S.sid, MIN(R.day) |
可拆成:
- 嵌套块:
SELECT MAX(S2.rating) FROM Sailors S2 - 外部块:主查询,其中
S.rating与嵌套块结果比较。
外部块可转换为带扩展操作的关系代数:
\[ \pi_{S.sid,MIN(R.day)}( HAVING_{COUNT(*)>2}( GROUP BY_{S.sid}( \sigma_{S.sid=R.sid \land R.bid=B.bid \land B.color='red' \land S.rating=value} (Sailors \times Reserves \times Boats)))) \]
4.2 访问计划代价估算
估算一个访问计划时要考虑:
- 每个操作本身的执行代价。
- 子结果是流水线输入还是临时表输入。
- 每个操作输出多少页、多少元组。
- 输出是否已有序,能否帮助父节点执行
GROUP BY、ORDER BY或 Sort-Merge Join。
结果大小由两个因素决定:
- 返回属性的长度。
WHERE条件带来的 Reduction Factor(缩减因子)。
缩减因子 可以理解成:一个查询条件会把原表“缩小到原来的多少比例”。如果一个表有 10000 条记录,某个条件的缩减因子是 \(0.1\),那优化器就估计结果大约有 \(1000\) 条记录。
比如有一个查询条件是 WHERE rating = 5。如果 rating
一共有 10
种可能取值,并且假设分布均匀,那么大约只有十分之一的记录满足条件,因此
\(RF(rating=5)=\frac{1}{10}\)。
4.2.1 Reduction Factor
System R 风格估计可以写成:
| 条件 | Reduction Factor | 解释 |
|---|---|---|
Column = value 且有索引 |
\(1/NKeys(I)\) | 用索引统计信息中的不同键值数估计命中比例。例如
rating 有 10 个不同取值,则 rating=5 约留下
\(1/10\) 的记录。 |
Column = value 且无索引 |
估计为 \(1/10\) | 没有索引或更细统计信息时,System R 使用经验值粗略估计。 |
Column1 = Column2
且两列有索引 |
\(1/\max(NKeys(I_1), NKeys(I_2))\) | 常用于等值 Join,如
R.sid=S.sid。若 R.sid 有 30000
个不同值、S.sid 有 40000 个不同值,则 RF 约为 \(1/40000\)。 |
Column1 = Column2
且无索引 |
估计为 \(1/10\) | 缺少索引统计信息时的经验估计,实际系统通常会尽量依赖 catalog 统计、直方图或采样提高精度。 |
Column > value |
\((High(I)-value)/(High(I)-Low(I))\) | 用属性取值范围估计范围谓词比例。例如
age 范围为 0 到 100,age>60 的 RF 约为
\((100-60)/(100-0)=0.4\)。 |
Column IN (value list) |
Column=value
的缩减因子乘以列表长度 |
可近似看作多个等值条件的并集。例如
rating IN (3,5,7),若 rating 有 10
个不同取值,则 RF 约为 \(3\times1/10=3/10\)。 |
4.2.2 直方图估计
为提高估计精度,DBMS 常使用 直方图(histogram)。直方图把属性取值范围分成若干桶,记录每个桶中的元组数量,并假设桶内均匀分布。
| 直方图类型 | 含义 | 特点 |
|---|---|---|
| 等宽直方图 | 每个桶覆盖相同取值范围 | 简单,但对倾斜分布不敏感 |
| 等深直方图 | 每个桶包含相近数量的元组 | 对倾斜分布描述更准确 |
举一个具体例子。假设 Sailors.rating 的取值范围是 1 到
10,但数据分布并不均匀:
| rating | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|
| 元组数 | 2 | 3 | 5 | 10 | 30 | 25 | 15 | 6 | 3 | 1 |
总元组数为 100。现在要估计:
1 | WHERE rating > 6 |
真实结果是 rating=7,8,9,10 的元组数之和:
\[ 15+6+3+1=25 \]
所以真实选择率为:
\[ 25/100=0.25 \]
如果使用 等宽直方图,可以把 1 到 10 分成 5 个桶,每个桶覆盖 2 个取值:
| 桶 | 覆盖范围 | 桶内元组数 |
|---|---|---|
| bucket1 | 1-2 | \(2+3=5\) |
| bucket2 | 3-4 | \(5+10=15\) |
| bucket3 | 5-6 | \(30+25=55\) |
| bucket4 | 7-8 | \(15+6=21\) |
| bucket5 | 9-10 | \(3+1=4\) |
估计 rating > 6 时,查询范围刚好覆盖 bucket4 和
bucket5,因此估计结果为:
\[ 21+4=25 \]
这次估计正好等于真实值。但如果查询是:
1 | WHERE rating > 5 |
它会切到 bucket3 的内部。等宽直方图通常假设桶内均匀分布,因此 bucket3
覆盖 5 和 6,总数为 55,估计其中一半属于 rating=6:
\[ 55/2=27.5 \]
再加上 bucket4 和 bucket5:
\[ 27.5+21+4=52.5 \]
而真实结果是:
\[ 25+15+6+3+1=50 \]
误差来自桶内“均匀分布”的假设。若某个桶内部数据倾斜更严重,误差会更大。
如果使用 等深直方图,目标是让每个桶包含相近数量的元组,而不是覆盖相同取值范围。对于上面的数据,可以粗略分成:
| 桶 | 覆盖取值 | 桶内元组数 |
|---|---|---|
| bucket1 | 1,2,3,4 | \(2+3+5+10=20\) |
| bucket2 | 5 | 30 |
| bucket3 | 6 | 25 |
| bucket4 | 7,8,9,10 | \(15+6+3+1=25\) |
等深直方图会把高频值 rating=5 和 rating=6
单独放入桶中,因此能更清楚地描述数据倾斜。估计
rating > 6 时,直接取 bucket4:
\[ 25 \]
估计 rating > 5 时,直接取 bucket3 和 bucket4:
\[ 25+25=50 \]
这个例子说明:直方图不是只记录最小值和最大值,而是记录每个取值区间里大约有多少数据。等宽直方图实现简单,但如果热点值集中在某个桶内,估计可能不准;等深直方图更能反映倾斜分布,因此很多实际 DBMS 会使用等深或类似变体。
实际系统中,Oracle、DB2、Informix、Sybase、SQL Server 都使用不同形式的直方图,并对高频值、重复值或特殊分布做额外处理。
4.3 关系代数等价变换
查询优化依赖关系代数表达式的等价变换。两个表达式等价,当且仅当它们对任意数据库实例产生相同结果。
4.3.1 选择与投影
层叠选择:
\[ \sigma_{c_1 \land c_2 \land \cdots \land c_n}(R) \equiv \sigma_{c_1}(\sigma_{c_2}(\cdots(\sigma_{c_n}(R))\cdots)) \]
选择交换:
\[ \sigma_{c_2}(\sigma_{c_1}(R)) \equiv \sigma_{c_1}(\sigma_{c_2}(R)) \]
投影层叠:
\[ \pi_{a_1}(R) \equiv \pi_{a_1}(\pi_{a_2}(\cdots(\pi_{a_n}(R))\cdots)) \]
其中 \(a_1 \subseteq a_2 \subseteq \cdots \subseteq a_n\)。
4.3.2 叉乘与连接
交换律:
\[ R \times S \equiv S \times R \]
\[ R \Join S \equiv S \Join R \]
结合律:
\[ R \times (S \times T) \equiv (R \times S) \times T \]
\[ R \Join (S \Join T) \equiv (R \Join S) \Join T \]
这些规则允许优化器改变 Join 顺序。
4.3.3 选择、投影与连接的下推
选择与连接:
\[ R \Join_c S \equiv \sigma_c(R \times S) \]
如果条件 \(c\) 只涉及 \(R\) 的属性,则:
\[ \sigma_c(R \times S) \equiv (\sigma_c R) \times S \]
\[ \sigma_c(R \Join S) \equiv (\sigma_c R) \Join S \]
这就是 选择下推(selection pushdown) 的理论基础。它能提前缩小中间结果,是降低 Join 代价的主要手段。
投影也可下推,但必须保留后续操作需要的属性,包括连接属性、分组属性、输出属性等。
4.4 单关系查询访问计划
单关系查询的优化重点是:
- 是否使用索引。
- 使用哪个索引。
- 是否合并多个索引的 rid 集合。
- 是否利用索引顺序支持
GROUP BY或ORDER BY。 - 是否能只通过覆盖索引完成查询。
例子:
1 | SELECT S.rating, COUNT(*) |
如果不使用索引:
- 扫描
Sailors:500 页。 - 选择和投影后写出中间结果,估计为 20 页。
- 对中间结果排序,代价约 \(3\times20=60\)。
- 总代价约 \(500+20+60=580\)。
如果使用索引,可能的访问路径包括:
| 访问路径 | 思路 |
|---|---|
| 单索引 | 选择过滤性最高的索引,再检查其他条件 |
| 多索引 | 分别用多个索引取 rid,求交集后访问数据页 |
| 排序索引 | 若索引顺序匹配
GROUP BY,可减少排序 |
| 覆盖索引 | 查询所需属性都在索引中,可避免访问数据表 |
这四类访问路径的区别可以展开如下。
4.4.1 单索引访问路径
单索引访问路径 是指优化器只选择一个最有用的索引来缩小候选集合,然后再对候选元组检查剩余条件。
仍以上面的查询为例:
1 | WHERE S.rating > 5 |
假设有两个索引:
1 | idx_rating: 建在 rating 上的 B+ 树索引 |
如果 catalog 估计:
1 | rating > 5 会留下约 50% 的 Sailors |
那么 age=20 的过滤性更强,优化器可能选择:
1 | 用 idx_age 找出 age=20 的候选 rid |
这里虽然查询里有两个条件,但真正用来访问数据的只有一个索引。另一个条件作为 residual predicate,在取出候选元组后再判断。
4.4.2 多索引访问路径
多索引访问路径 是指优化器同时利用多个索引分别找候选 rid,然后对 rid 集合求交集,再访问数据页。
仍假设:
1 | idx_rating: rating 上的 B+ 树索引 |
查询条件为:
1 | WHERE S.rating > 5 |
执行思路可以是:
1 | idx_rating 找到 rating>5 的 rid 集合: |
这样做的好处是:如果两个条件单独看都不算特别强,但合起来很强,多索引交集可以大幅减少真正访问的数据页。实际系统中,rid 集合可以用排序列表、位图、Hash 表、Bloom filter 等结构处理。
但多索引也有额外代价:需要扫描多个索引,还要合并 rid 集合。如果某个单索引已经足够过滤,额外使用另一个索引未必划算。
4.4.3 排序索引访问路径
排序索引访问路径
强调的不只是“过滤”,而是利用索引本身的顺序。B+
树索引中的键值天然有序,如果查询后续需要
GROUP BY、ORDER BY 或 Sort-Merge
Join,这个顺序可能很有价值。
例如查询:
1 | SELECT S.rating, COUNT(*) |
如果 rating 上有 B+ 树索引,优化器可以沿着索引从
rating>5 的第一个位置开始顺序扫描:
1 | rating=6 的元组连续出现 |
这样输入天然按 rating 分组,后面的
GROUP BY rating 可以边扫描边聚集:
1 | 看到一批 rating=6 -> 统计 count |
因此排序索引的价值在于:它可能减少甚至避免额外排序。即使某个索引不是过滤性最强的索引,只要它能提供后续需要的 interesting order,优化器也可能保留这个计划作为候选。
4.4.4 覆盖索引访问路径
覆盖索引(covering index)访问路径 是指查询需要的所有属性都已经包含在某个索引中,因此可以只读索引,不访问原始数据表。
例如查询:
1 | SELECT S.rating, S.sname |
如果有一个复合 B+ 树索引:
1 | idx_rating_sname_age = <rating, sname, age> |
那么查询中涉及的属性只有:
1 | rating, sname, age |
这些属性都在索引项里。优化器可以:
1 | 沿 idx_rating_sname_age 找到 rating>5 的索引项 |
整个过程不需要根据 rid 回表访问 Sailors
的数据页。覆盖索引尤其适合非聚集索引场景,因为非聚集索引回表可能产生大量随机
I/O;如果能只读索引,就能避免这部分代价。
不过覆盖索引也不是越多越好。索引越宽,维护成本越高,插入、删除、更新时需要同步维护更多索引页。因此实际系统会在查询性能和更新成本之间权衡。
4.5 多关系查询访问计划
多关系查询的主要难点是 Join 顺序选择。关系越多,可能的 Join 树越多,搜索空间爆炸。
Join 树常见两类:
- Left-deep tree:每次把已有中间结果与一个基表连接。
- Bushy tree:允许两个中间结果互相连接。
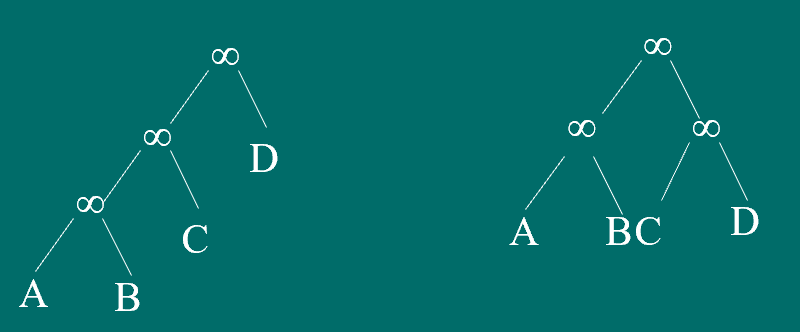
左图是 Left-deep-tree,右图是 Bushy tree。图中的 \(∞\) 应该是连接的意思。
System R 和许多商业系统偏向 left-deep tree,原因是:
- 候选计划数量较少。
- 更容易使用流水线执行。
- 中间结果物化代价较低。
Left-deep 枚举过程:
- 第一遍:枚举每个单关系的最佳访问计划,考虑选择、投影、索引和输出顺序。
- 第二遍:枚举两个关系的 Join 计划,把第一遍结果作为 outer,另一个关系作为 inner,考虑不同 Join 算法。
- 第三遍及以后:继续扩展到三个关系、四个关系,直到覆盖整个查询。
- 如果有
GROUP BY和HAVING,通常最后再考虑。
优化器不会保留所有计划,而是保留“有希望”的计划,例如代价最低的计划,以及具有有用输出顺序(interesting order)的计划。
4.5.1 两表 join 的例子
第一个例子是两表 Join:
1 | SELECT S.sname |
对应的逻辑树可以理解为:
1 | π sname |
假设索引情况如下:
1 | Sailors: |
Left-deep 枚举会分两遍做。
第一遍先看单个关系的访问计划:
1 | 对 Reserves: |
这一步只是在为每张基表挑访问路径,并记录每个访问路径的代价、输出大小、输出是否有序等性质。
第二遍枚举两个关系的 Join 计划。优化器会考虑两个方向:
1 | 方案 A: |
对于方案 A,Reserves 经过 bid=100
过滤后可能比较小。对每条外层 Reserves
元组,都需要找满足:
1 | S.sid = R.sid |
的 Sailors 元组。由于 Sailors.sid 上有 Hash
索引,优化器可能选择 index nested loop join:
1 | 用 Reserves.bid 的 B+ 树索引找到 bid=100 的 R 元组 |
这里有一个细节:虽然第一遍中 Sailors.rating>5 可以用
rating 上的 B+ 树索引,但当 Sailors 作为 inner
且连接条件变成 sid=value 时,Sailors.sid 上的
Hash 索引反而更有用。也就是说,内关系此时要处理的是
sid=value 这样的等值查找,如果 sid 上有 Hash
索引,就可以用它替代 rating 上的 B+ 树索引。
对于方案 B,优化器也会考虑把 Sailors 作为 outer:
1 | 先用 Sailors.rating 的 B+ 树索引找 rating>5 的 S 元组 |
如果 Reserves.sid 上没有合适索引,而
Reserves.bid 上的索引更适合先做
bid=100,那么方案 B
未必便宜。优化器会比较这些候选方案的估计代价,最后保留代价最低的
left-deep 计划。
这个例子体现了 left-deep 枚举的核心:先为单表选择访问路径,再把一个已有结果作为 outer,不断接上一个基表作为 inner。inner 的访问方法要根据 Join 条件重新考虑,不一定沿用第一遍单表查询时的访问路径。
4.5.2 三表 join 的例子
第二个例子是三表 Join:
1 | SELECT S.sid, COUNT(*) AS numrs |
逻辑上可以看成:
1 | GROUP BY S.sid |
假设索引情况为:
1 | Boats: |
Left-deep 枚举过程可以理解为:
第一遍枚举单表计划。
Boats有选择条件B.color='red',所以可以用color上的索引先缩小结果。Sailors和Reserves本身没有单表选择条件,文件扫描可能就是合理选择。第二遍枚举两表 Join。
优化器会考虑:
1
2
3
4σ color='red'(Boats) Join Reserves
Reserves Join Sailors
Sailors Join Reserves
...对每个组合,还要考虑谁做 outer、谁做 inner,以及使用 nested loop、index nested loop、sort-merge、hash join 等哪种 Join 算法。
第三遍把两表 Join 结果继续作为 outer,再接上剩下的一个基表。
例如可能形成这样的 left-deep 计划:
1
((σ color='red'(Boats) Join Reserves) Join Sailors)
也可能形成:
1
((Sailors Join Reserves) Join σ color='red'(Boats))
优化器会根据中间结果大小、索引可用性、输出顺序和 Join 算法代价选择更便宜的方案。
最后再处理
GROUP BY S.sid。如果前面的计划输出已经按
S.sid有序,GROUP BY可能受益;否则可能需要排序或 Hash 聚集。
这个三表例子说明:left-deep tree 不是随便固定一个 Join 顺序,而是在每一轮动态保留较优的局部计划,然后逐步扩展到包含所有关系的完整计划。
4.6 嵌套子查询优化
嵌套子查询分为非相关和相关两类。
4.6.1 非相关嵌套子查询
例:
1 | SELECT S.sname |
子查询不依赖外层元组,只需执行一次。优化器可先执行子查询,把结果作为常量带入外层查询。
另一个例子:
1 | SELECT S.sname |
也可先执行子查询,或把子查询结果作为临时表,与外层查询连接。
4.6.2 相关嵌套子查询
例:
1 | SELECT S.sname |
子查询引用了外层的 S.sid,因此称为
相关子查询(correlated
subquery)。朴素执行会对外层每个元组执行一次子查询,代价很高。
常见优化是把它转换成非嵌套 Join:
1 | SELECT S.sname |
这样就可以使用所有常规 Join 算法,而不是局限于 index nested loop。
4.7 其他查询优化方法
当关系数量较多时,传统枚举空间太大,可以考虑一些扩展方法:
- 基于规则的方法:使用启发式规则快速改写查询。
- 随机访问计划生成方法:在巨大搜索空间中随机或启发式搜索好计划。
- 带参数的查询优化:考虑参数值变化导致的不同最佳计划。
- 多查询优化:同时优化多个查询,复用公共子表达式或共享扫描。
5 Proactive Query Re-optimization 补充
SIGMOD 2005 的 Proactive Query Re-optimization 关注一个实际问题:传统优化器在统计信息不准确时,如何避免选错执行计划。
5.1 传统优化的问题
传统优化流程是:
- Parsing。
- Optimization。
- Code generation。
- Execution。
优化器通常先枚举计划,用统计信息估计每个计划代价,然后选择估计代价最低的计划。这种 plan-first-execute-next 方法强依赖统计估计准确性。
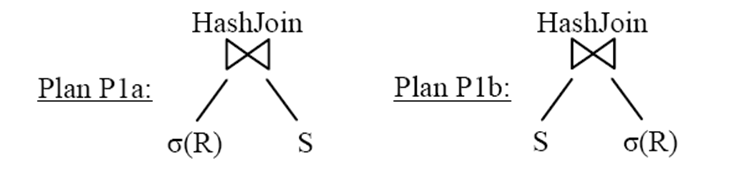
问题在于:由于数据倾斜、属性相关性或过期统计信息,优化器可能严重低估或高估中间结果大小。例如:
- \(|R|=500MB\)
- \(|S|=160MB\)
- 实际 \(|\sigma(R)|=300MB\)
- 优化器误估为 \(150MB\)
- Buffer cache 为 \(200MB\)
如果优化器以为 \(\sigma(R)\) 能放入内存,就可能选择依赖该假设的计划 P1a;但实际大小超过预期后,另一个计划 P1b 才更优。
5.2 Reactive Re-optimization
Reactive re-optimization 的思路是:
- 先用传统优化器选择计划。
- 执行过程中用 check operator 监测是否偏离估计。
- 如果发现计划明显次优,触发重新优化。
它的问题包括:
- 初始优化器可能选择高度依赖不确定统计信息的计划,导致很容易触发重优化。
- 如果原计划是流水线执行,重优化时已经完成的部分工作可能丢失。
- 执行中快速且准确收集统计信息并不容易。
- 重优化后仍可能因为新统计不准再次选错,导致 thrashing(激烈扭动,翻来覆去)。
5.3 Proactive Re-optimization 的核心思想
Proactive Re-optimization 不把统计信息看作单点估计,而用 bounding box(边界盒 / 区间不确定性) 表示估计不确定范围。
它的目标不是只找单点估计下最优的计划,而是找:
- 在整个不确定范围内都最优的计划。
- 或者在整个范围内都接近最优的 robust plan。
- 或者可以在执行中根据更准统计信息切换的 switchable plan。
这样可以减少重优化次数,避免大量流水线工作被丢弃。
5.4 Bounding Box 与不确定性
传统优化器使用单点估计,例如认为某个选择结果大小就是 \(150MB\)。Proactive 方法使用区间,例如 \([100MB, 350MB]\)。随着执行过程中采样和统计更准确,区间会逐渐变窄。
RIO 系统(即作者做的一个系统,用于验证他的想法)中,不确定性主要用于大小和选择率估计。每个估计值 \(E\) 会被分配一个不确定桶 \(U\),\(U\) 取值从 0 到 6:
- 0 表示无不确定性。
- 6 表示非常高的不确定性。
系统根据 \((E,U)\) 计算 bounding box。论文中使用的简单规则是:
\[ B=[low,high] \]
\[ low=E(1-0.1U),\quad high=E(1+0.2U) \]
例如 \(E=160MB, U=1\),则 \(B=[144MB,192MB]\);如果 \(E=150MB, U=5\),则 \(B=[75MB,300MB]\)。也就是说,\(U\) 越大,估计越不可靠,区间就越宽。
5.5 Robust Plan 与 Switchable Plan
对于一个 bounding box \(B\),可能出现四种情况:
| 情况 | 含义 |
|---|---|
| Single optimal plan | 同一个计划在 \(B\) 内所有点都最优 |
| Single robust plan | 同一个计划虽不处处最优,但在 \(B\) 内都接近最优 |
| Switchable plan | 有一组计划,可推迟到统计更准后再选 |
| None | 没有单一稳健计划,也无法构造可切换计划 |
Switchable plan 是一组计划 \(S\),满足:
- 对 \(B\) 内每个点,\(S\) 中至少有一个计划接近该点最优计划。
- 可以推迟到获得更准确统计信息后再决定执行哪个计划。
- 如果真实统计落在 \(B\) 内,切换时不会损失大量已完成工作。
5.6 RIO 的实现细节
RIO 的流程包括:
- 为输入大小和选择率估计计算 bounding box。
- 对每个 Join 子集(JS)和 interesting order(IO)组合尝试生成 switchable plan。
- 如果失败,则退回传统单点估计下的最优计划。
生成 seed plans 时,RIO 对每个候选计划考虑三种代价:
- \(C_{LOW}\):bounding box 左下角的代价。
- \(C_{EST}\):传统单点估计代价。
- \(C_{HIGH}\):bounding box 右上角的代价。
由此得到:
BestPlanLowBestPlanEstBestPlanHigh
之后判断:
- 如果三个 seed 是同一计划,则直接使用它。
- 如果不同但其中一个是 robust plan,则用该 robust plan。
- 如果可以由 seeds 构造 switchable plan,则构造之。
- 如果都不行,则使用
BestPlanEst。
为了支持主动重优化,执行引擎还需要:
- switch operator:处理可切换计划。
- buffer operator:在决定计划前暂存元组。
- randomization-aware operators:执行随机采样以获得更准确统计。
- inter-operator communication:算子之间交换估计值和样本。
6 总结
6.1 核心概念
外部排序:当数据无法全部放入内存时,通过初始 run 生成和多路 merge 完成排序。
run:外部排序中已经排好序的子文件。
聚集索引与非聚集索引:聚集索引的数据页物理顺序接近索引顺序;非聚集索引 data entry 有序但数据页分散,范围查询和排序可能产生大量随机 I/O。
访问路径:DBMS 从关系读取记录的方法,包括文件扫描和索引访问。
选择下推:尽早执行选择操作,减少后续 Join 输入大小。
流水线执行:不物化中间结果,父算子通过迭代器接口逐步消费子算子输出。
Reduction Factor:谓词对结果规模的缩减比例,是代价估计的基础。
Interesting
Order:某个访问计划输出的有用排序顺序,可能帮助后续
ORDER BY、GROUP BY 或 Sort-Merge Join。
6.2 常用 I/O 公式
| 操作 | 公式 |
|---|---|
| 两路外部排序 | \(2N(\lceil \log_2 N \rceil + 1)\) |
| 多路外部排序 | \(2N(\lceil \log_{B-1}\lceil N/B\rceil\rceil + 1)\) |
| 简单嵌套循环 Join | \(M+P_RMN\) |
| 页级嵌套循环 Join | \(M+MN\) |
| 块嵌套循环 Join | \(M+\lceil M/(B-2)\rceil N\) |
| Sort-Merge Join | \(\text{sort}(R)+\text{sort}(S)+M+N\) |
| Hash Join | \(3(M+N)\) |
| Hash 投影去重 | \(M+2T\) |
其中:
- \(N\):文件页数,或 Join 中 inner 关系页数,视上下文而定。
- \(M\):Join 中 outer 关系页数。
- \(B\):缓冲区页数。
- \(P_R\):outer 关系每页元组数。
- \(T\):投影后的中间结果页数。
6.3 算法选择参考
| 场景 | 优先考虑 |
|---|---|
| 等值选择,有 Hash 索引 | Hash 索引 |
| 范围选择,有 B+ 树索引 | B+ 树索引,聚集更佳 |
| 投影去重且需要有序结果 | 排序投影 |
| 投影去重且内存足、分布均匀 | Hash 投影 |
| 等值 Join 且内存足、分布均匀 | Hash Join |
| 输入已按连接属性排序 | Sort-Merge Join |
| inner 连接属性有高选择性索引 | Index Nested Loop Join |
| outer 很小 | Index Nested Loop Join 往往有利 |
| 非等值 Join | Index Nested Loop 或其他专门方法 |
6.4 常见误区
- Hash 索引不适合范围查询;B+ 树适合范围查询。
- 非聚集索引不等于低代价,结果多时可能比全表扫描更差。
- Sort-Merge Join 的优势不只是 Join,也包括输出有序。
- Hash Join 通常只适合等值 Join。
- 选择下推通常有利,但有时提前物化或破坏索引利用也可能不划算。
- 查询优化器选择的是估计代价最低的计划,不一定是真实执行最快的计划。
- 统计信息的均匀分布和独立性假设可能导致严重估计错误。
- 多关系查询中,Join 顺序往往比单个算子选择更影响总代价。