目录
- 1 索引结构的基本思想
- 2 索引的 data entry 与基本分类
- 3 树结构索引:ISAM
- 4 动态树索引:B+ 树
- 5 基于 Hash 的索引结构
- 6 多键索引与特殊数据类型索引
- 7 总结与核心内容
1 索引结构的基本思想
索引结构(Index Structure)的核心目标是减少查询时需要访问的数据页数量。借助索引,DBMS 不必从头到尾扫描整个数据文件,而是可以先在较小的辅助结构中定位候选记录,再访问实际数据页。
从逻辑上看,索引可以理解为一个由 data entry 组成的集合。每个 data entry 通常围绕某个查询属性值组织,并记录如何找到对应记录的位置。索引并不改变关系表的逻辑语义,但会显著影响查询、插入、删除和更新的代价。
1.1 为什么需要索引
如果没有索引,数据库要查找某个属性值,通常只能进行顺序扫描。例如要找所有
age=44
的记录,系统可能需要读取整张表的许多页。索引通过对属性值进行重新组织,让查询过程先在索引中查找,再根据索引给出的记录位置访问数据文件。
索引项常见形式可以抽象为:
\[ Map: \text{属性值} \rightarrow \text{rid} \]
其中 rid 是记录标识符(Record
ID),用于定位记录所在的数据页和页内位置。
1.2 索引设计要考虑的问题
索引不是简单地“建一个查找表”就结束了。实际 DBMS 必须同时考虑两个方面:
- 如何组织 data entry: 即每个索引项保存什么内容,是保存整条记录、单个 rid,还是 rid 列表。
- 如何适应存储介质: 数据库主要运行在磁盘、SSD 等外存上,访问代价以页为单位,因此索引结点通常也设计成一个物理页大小,以减少 I/O 次数。
因此,索引结构的设计重点不是单纯追求 CPU 上的比较次数,而是尽量减少磁盘页访问次数。
2 索引的 data entry 与基本分类
索引的许多性质都取决于 data entry 的形式,以及索引顺序与数据文件物理顺序之间的关系。本节是理解后续 ISAM、B+ 树和 Hash 索引的基础。
2.1 三种 data entry 形式
经典 data entry 通常有三种组织方式:
| 形式 | 含义 | 特点 |
|---|---|---|
| \(k^*\) | 搜索键值为 \(k\) 的完整记录 | 索引本身就保存数据,因此可视为一种特殊文件组织形式 |
| \(\langle k, rid\rangle\) | 一个键值 \(k\) 对应一条记录的位置 | 适合一个键值可能出现多条记录的情况,每条记录有一个索引项 |
| \(\langle k, rid\text{-}list\rangle\) | 一个键值 \(k\) 对应一组记录位置 | 重复值较多时更紧凑,但维护 rid 列表会更复杂 |
第一种 \(k^*\) 中已经包含完整记录,因此不需要另存一份数据文件。第二、三种更常见,尤其适用于一个表上存在多个索引的情况:数据文件只保存一份,而不同索引分别保存到记录位置的引用。
下面用同一组记录来理解三种 data
entry。假设数据文件中有如下员工记录,其中 rid
表示记录在数据文件中的物理位置:
| rid | name | age | sal |
|---|---|---|---|
| r1 | Smith | 44 | 3000 |
| r2 | Jones | 40 | 6003 |
| r3 | Tracy | 44 | 5004 |
| r4 | Ashby | 25 | 3000 |
如果在 age 上建立索引,三种 data entry
的例子分别是:
- \(k^*\): data
entry 保存完整记录。例如
44*可以直接表示搜索键age=44对应的完整记录,如(Smith,44,3000)和(Tracy,44,5004)。采用这种方式时,索引叶子层本身就是数据记录的存放处,因此通常只能作为一种文件组织方式,而不适合在同一张表上为很多属性都这样建索引。 - \(\langle
k,rid\rangle\): 每条满足键值的记录都有一个索引项。例如
age=44有两条记录,则索引中可以出现 \(\langle 44,r1\rangle\) 和 \(\langle 44,r3\rangle\)。查询age=44时,系统先找到这两个索引项,再根据r1、r3到数据文件中取出完整记录。 - \(\langle
k,rid\text{-}list\rangle\):
相同键值只保留一个索引项,但它携带一组 rid。例如
age=44可以写成 \(\langle 44,[r1,r3]\rangle\),age=25可以写成 \(\langle 25,[r4]\rangle\)。这种形式在重复值较多时节省键值存储空间,但插入、删除记录时需要维护 rid-list。
可以对不止一个属性建索引。例如,若表中有 age 和
sal 两个属性,可以分别在 age 和
sal 上建立索引。age
索引用于快速查找某年龄的人,sal
索引用于快速查找某薪资的人。两者都通过 rid
指向同一份数据记录。
2.2 Clustered 与 Unclustered Index
簇聚索引(Clustered Index) 指索引中 data entry
的顺序与数据文件中记录的物理顺序一致或接近一致。若文件中的记录按照
age 排序,而 age 索引中的 data entry 也按
age 排序,则这个索引可以是簇聚索引。
非簇聚索引(Unclustered Index) 指索引顺序与数据文件记录的物理顺序不一致。通过非簇聚索引找到多个记录时,这些记录可能分散在许多不同数据页中,导致大量随机 I/O。
两者的主要区别如下:
| 项目 | Clustered Index | Unclustered Index |
|---|---|---|
| 数据顺序 | 与索引键顺序一致或接近一致 | 与索引键顺序无关 |
| 一个表可有数量 | 通常只能有一个 | 可以有多个 |
| 范围查询 | 很有优势,可顺序读连续数据页 | 可能频繁随机访问数据页 |
| 维护代价 | 插入、删除、更新可能影响数据物理顺序 | 维护相对灵活 |
下面用一个具体例子说明两者差别。假设数据文件中有 6
条员工记录,每个数据页只能放 2 条记录,并且要在 age
上建立索引。
如果数据文件本身按照 age 排序存放:
| 数据页 | 页内记录 |
|---|---|
| Page 1 | (Ashby,25,3000),
(Bristow,30,2007) |
| Page 2 | (Basu,33,4003),
(Jones,40,6003) |
| Page 3 | (Smith,44,3000),
(Tracy,44,5004) |
此时 age 索引中的 data entry
顺序与数据页顺序一致,例如索引项按 25,30,33,40,44,44
排列,而数据文件也按这个顺序存放。这就是 age 上的
聚集索引。如果执行范围查询:
1 | WHERE age BETWEEN 30 AND 44 |
系统通过索引定位到 age=30 后,可以顺着数据文件连续读取
Page 1、Page 2、Page 3
中相邻的记录。由于满足条件的记录在物理上大体连续,磁盘 I/O 比较顺。
如果数据文件没有按照 age
排序,而是按照插入顺序或其他属性存放:
| 数据页 | 页内记录 |
|---|---|
| Page 1 | (Smith,44,3000),
(Jones,40,6003) |
| Page 2 | (Ashby,25,3000),
(Tracy,44,5004) |
| Page 3 | (Bristow,30,2007),
(Basu,33,4003) |
此时即使 age 索引本身仍然按
25,30,33,40,44,44
排序,每个索引项指向的数据记录却分散在不同页中。例如 age=30
在 Page 3,age=33 也在 Page 3,age=40 在 Page
1,age=44 分别在 Page 1 和 Page 2。这就是 age
上的 非聚集索引。同样执行
age BETWEEN 30 AND 44 时,系统可能需要在 Page 3、Page
1、Page 2 之间跳转访问,随机 I/O 更多。
因此,聚集索引与非聚集索引的关键区别不在于索引文件是否有序;索引文件通常都会按键值组织。真正的区别在于数据文件中的记录物理顺序是否也跟着索引键值排列。
核心内容:一个表通常只能有一个簇聚索引,因为数据文件的物理顺序只能主要按照一种键值组织。 但可以有多个非簇聚索引,因为它们只是额外的辅助结构。
实际系统中,即使建立簇聚索引,也不一定始终保持严格排序。因为频繁插入和删除会使严格维护代价很高,系统可能采用溢出链表,并定期重新整理数据。
2.3 Dense 与 Sparse Index
稠密索引(Dense Index)
是指表中该属性出现的每个搜索键值,在索引文件中至少有一个 data entry
与之对应。若 age 出现了
22,25,30,33,40,44,50,稠密索引中这些键值都需要出现。
稀疏索引(Sparse Index) 通常不是为每个键值都建立索引项,而是每个数据页建立一个 data entry,例如记录该页第一条记录的键值和页指针。查询时先通过稀疏索引定位到可能的数据页,再在页内或相邻页继续查找。
| 项目 | Dense Index | Sparse Index |
|---|---|---|
| 索引项覆盖 | 每个搜索键值至少一个索引项 | 通常每个数据页一个索引项 |
| 空间开销 | 较大 | 较小 |
| 查询定位 | 更直接 | 需要进入数据页后继续查找 |
| 与簇聚关系 | 可簇聚也可非簇聚 | 只能用于簇聚索引 |
下面继续用按 age 排序的数据文件举例。假设每页放 2
条记录:
| 数据页 | 页内记录 |
|---|---|
| Page 1 | (Daniels,22,6003),
(Ashby,25,3000) |
| Page 2 | (Bristow,30,2007),
(Basu,33,4003) |
| Page 3 | (Jones,40,6003),
(Smith,44,3000) |
| Page 4 | (Tracy,44,5004),
(Cass,50,5004) |
如果建立 age 上的
稠密索引,每个出现过的 age 值都至少有一个
data entry。若采用 \(\langle
k,rid\text{-}list\rangle\) 形式,索引可以写成:
| age | rid-list |
|---|---|
| 22 | [r1] |
| 25 | [r2] |
| 30 | [r3] |
| 33 | [r4] |
| 40 | [r5] |
| 44 | [r6,r7] |
| 50 | [r8] |
查询 age=44 时,稠密索引可以直接找到键值 44
对应的 rid-list,再取出 Smith 和 Tracy
两条记录。它的优点是定位直接,缺点是索引项更多,占用空间更大。
如果建立 age 上的
稀疏索引,索引不记录每个
age,而是每个数据页记录一个代表项,通常记录该页第一条记录的键值和页指针:
| 索引键 | 指向的数据页 |
|---|---|
| 22 | Page 1 |
| 30 | Page 2 |
| 40 | Page 3 |
| 44 | Page 4 |
查询 age=33 时,稀疏索引中没有 33
这个键。系统会找到小于等于 33 的最大索引键
30,进入 Page 2,再在 Page 2 中查找
(Basu,33,4003)。查询 age=50
时,会定位到小于等于 50 的最大索引键 44,进入
Page 4,再在页内找到 (Cass,50,5004)。
这个例子也解释了为什么稀疏索引必须依赖聚集索引:只有当数据文件按
age 排序时,看到索引项
30 -> Page 2,系统才知道 30
到下一个页起始键 40 之间的值都应该在 Page 2
附近。如果数据文件乱序,age=33
可能在任意页中,稀疏索引就无法只靠每页第一个键可靠定位。
稀疏索引只能建立在簇聚索引之上,因为只有数据文件按索引键排序时,系统才能根据“某页第一个键值”推断目标值可能在哪个页附近。如果数据文件无序,稀疏索引无法可靠定位。
2.4 Primary、Secondary、Unique 与 Duplicates Index
Primary Index 有两种常见解释:
- 如果索引建立在包含主键(Primary Key) 的属性上,则称为主键索引(Primary Index)。
- 也有教材把第一种 data entry \(k^*\) 对应的索引称为主键索引,而将 \(\langle k,rid\rangle\) 与 \(\langle k,rid\text{-}list\rangle\) 称为二级索引。
更常用的理解是:主索引建立在主键或主要组织键上,二级索引用于支持其他查询属性。
此外,还要区分:
- 唯一索引(Unique Index): 不允许两个 data entry 具有相同搜索键值。
- 重复索引(Duplicates Index): 多个记录可以有相同搜索键值,例如多名学生年龄相同、多个员工工资相同。
下面用学生表举例。假设 sid
是学生编号,也是主键;name 不是主键;age
允许重复:
| rid | sid | name | age | gpa |
|---|---|---|---|---|
| r1 | S001 | Li Hua | 20 | 3.6 |
| r2 | S002 | Wang Ming | 21 | 3.2 |
| r3 | S003 | Zhang Wei | 20 | 3.8 |
| r4 | S004 | Li Hua | 22 | 3.1 |
如果在主键 sid 上建立索引:
| sid | rid |
|---|---|
| S001 | r1 |
| S002 | r2 |
| S003 | r3 |
| S004 | r4 |
这个索引可以称为
主键索引,因为它建立在包含主键的属性上。由于
sid 是主键,每个 sid
只能对应一条记录,所以它同时也是 唯一索引。查询
sid='S003' 时,系统能通过索引直接定位到
r3。
如果在 age 上建立索引:
| age | rid-list |
|---|---|
| 20 | [r1,r3] |
| 21 | [r2] |
| 22 | [r4] |
这个索引通常称为
二级索引,因为它不是建立在主键上,而是为了支持按年龄查询。它也是
重复索引,因为 age=20
对应了两条学生记录。查询 age=20 时,系统会得到
r1 和 r3 两个候选记录。
如果在 name 上建立索引,也可能是二级索引,而且是否
unique 取决于业务约束。上表中 Li Hua 出现了两次,因此普通
name
索引是重复索引;如果学校规定姓名不能重复并强制唯一约束,那么
name 索引才可能是 Unique
Index。实际数据库中,Primary/Secondary
关注索引建在哪类属性上,Unique/Duplicates
关注搜索键值是否允许重复,这两组概念不是同一个分类维度。
2.5 Composite Search Key 索引
组合搜索键(Composite Search Key) 索引建立在多个属性上,例如 \(\langle age, sal\rangle\) 或 \(\langle sal, age\rangle\)。组合索引的顺序非常重要。
例如索引 \(\langle age, sal\rangle\)
首先按 age 排序,age 相同的记录再按
sal 排序。因此它特别适合以下查询:
1 | WHERE age = 12 AND sal = 20 |
但它不一定适合只按 sal 查询,因为 sal
不是最左侧属性。相反,\(\langle sal,
age\rangle\) 对按 sal 查找更有利。
下面用一个小例子说明“属性顺序”的影响。假设员工表中有如下记录:
| rid | name | age | sal |
|---|---|---|---|
| r1 | Bob | 12 | 10 |
| r2 | Cal | 11 | 80 |
| r3 | Joe | 12 | 20 |
| r4 | Sue | 13 | 75 |
如果建立组合索引 \(\langle
age,sal\rangle\),索引项会先按 age
排序,age 相同再按 sal 排序:
| 排序位置 | 组合键 \(\langle age,sal\rangle\) | rid |
|---|---|---|
| 1 | \(\langle 11,80\rangle\) | r2 |
| 2 | \(\langle 12,10\rangle\) | r1 |
| 3 | \(\langle 12,20\rangle\) | r3 |
| 4 | \(\langle 13,75\rangle\) | r4 |
这个索引适合查询 age=12,因为所有 age=12
的索引项连续排列在一起;也适合查询
age=12 AND sal=20,因为系统可以先定位 age=12
的范围,再进一步比较 sal=20。但如果只查询
sal=20,这个索引帮助有限,因为 sal
值不是第一排序字段,不同 sal 的记录不会按 sal
连续聚集。
如果建立组合索引 \(\langle
sal,age\rangle\),排序顺序就变成先按 sal,再按
age:
| 排序位置 | 组合键 \(\langle sal,age\rangle\) | rid |
|---|---|---|
| 1 | \(\langle 10,12\rangle\) | r1 |
| 2 | \(\langle 20,12\rangle\) | r3 |
| 3 | \(\langle 75,13\rangle\) | r4 |
| 4 | \(\langle 80,11\rangle\) | r2 |
这个索引适合查询 sal=20 或
sal BETWEEN 10 AND 75,因为相近工资的索引项在物理上相邻。但如果只查询
age=12,它不能像 \(\langle
age,sal\rangle\) 那样直接把 age=12
的记录聚在一起。
可以把组合索引理解为一本按多级规则排序的字典:\(\langle age,sal\rangle\) 是先按年龄分组,再在同年龄中按工资排序;\(\langle sal,age\rangle\) 是先按工资分组,再在同工资中按年龄排序。最左侧属性决定了索引最自然支持的查询入口。
学习时要牢记:组合索引不是多个单列索引的简单并列,键的排列顺序直接决定它能高效支持哪些查询。
2.6 SQL 中索引的定义
SQL-92 标准中没有统一规定索引语句,因为索引属于物理实现层面的结构,不属于关系模型的核心逻辑。但几乎所有商用 DBMS 都提供索引相关语句。例如:
1 | CREATE INDEX IndAgeRating on Student |
这表示在 Student 表上按照 (age, gpa)
建立一个 B-tree/B+ tree 风格的索引。不同系统的语法可能不同,例如
MySQL、PostgreSQL、Oracle 和 SQL Server 都有自己的索引选项。
3 树结构索引:ISAM
树结构索引的目标是在磁盘页层面提供高效搜索。ISAM(Indexed Sequential Access Method,索引序列访问方法)是一种静态索引结构,适用于数据变化不大的场景。
3.1 从排序文件到二级索引
假设数据文件已经按 gpa 排序,现在要执行范围查询:“找
gpa > 3.0
的学生”。一种方法是在整个排序文件上做二分查找,找到第一个满足条件的位置,然后从该位置开始顺序读取。
但直接在大文件上二分查找仍然可能产生多次磁盘 I/O。ISAM 的基本思想是额外创建一个较小的二级索引文件:对每个数据页,只记录该页第一条记录的键值和指向该页的指针。
索引项格式可以写成:
\[ (\text{页中第一个键}, \text{指向该页的指针}) \]
这个二级文件的好处是空间小、查找快:它只取每页一个记录,而且只保留一个属性值和页指针。
3.2 ISAM 的结构
ISAM 将“为数据页建立索引”的思想递归应用:如果底层索引文件仍然较大,就再为它建立上一层索引,直到形成多级结构。
ISAM 的典型结构包括:
- 非叶子结点: 保存键值和指向下层结点的指针。
- 叶子结点或主数据页(Primary Page): 保存实际数据或 data entry。
- 溢出页(Overflow Page): 当叶子页满后,新插入记录进入溢出链表。
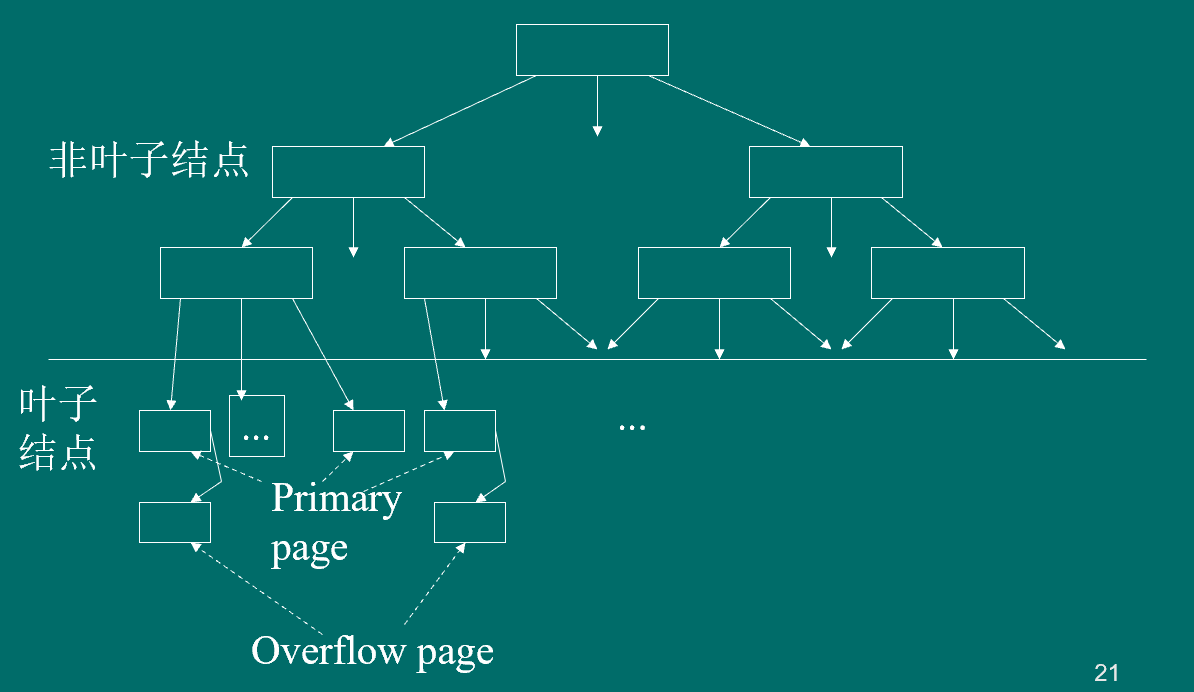
下面用一个小例子说明 ISAM 的层次结构。假设数据文件已经按搜索键
age 排序,每个数据页最多存放 3 条记录:
| 数据页 | 记录键值 |
|---|---|
| Page 1 | 10*, 15*,
20* |
| Page 2 | 27*, 33*,
37* |
| Page 3 | 40*, 46*,
51* |
| Page 4 | 55*, 63*,
97* |
在 ISAM 中,叶子层可以保存每个数据页的代表键和页指针。若每个叶子索引页最多保存 2 个索引项,则叶子层可以组织成:
| 叶子索引页 | 索引项 |
|---|---|
| Leaf 1 | (10, Page 1),
(27, Page 2) |
| Leaf 2 | (40, Page 3),
(55, Page 4) |
上层根结点只需要保存能够区分两个叶子页的键和指针。例如可以把根结点理解为:
| 根结点内容 | 含义 |
|---|---|
P0 -> Leaf 1 |
小于 40 的键进入 Leaf 1 |
40 |
分隔键 |
P1 -> Leaf 2 |
大于等于 40 的键进入 Leaf
2 |
查询 age=46 时,系统先在根结点看到
46 >= 40,于是进入 Leaf 2;再通过
(40, Page 3) 定位到 Page 3;最后在 Page 3 中找到
46*。查询 age=33 时,则进入
Leaf 1,再定位到 Page 2。
如果后来插入 42*,它应该进入 Page 3,因为 Page 3
的键值范围大约是 40 到 51。但 Page 3
已经满了,ISAM 不会像 B+ 树那样分裂并调整上层结点,而是在 Page 3
后面挂一个 overflow page:
| 主数据页 | 原有记录 | 溢出页 |
|---|---|---|
| Page 3 | 40*, 46*,
51* |
Overflow Page: 42* |
此时根结点和叶子索引页都不变。查询 age=42
时,系统仍然通过根结点和 Leaf 2 定位到 Page 3,然后发现主数据页中没有
42*,还要继续沿 overflow page 查找。这个例子体现了 ISAM
的静态特点:非叶子层稳定,更新主要通过叶子层的溢出链处理;溢出链短时效率很好,溢出链长时查询会退化。
ISAM 的关键特征是:树的主体结构是静态的,创建后非叶子层基本不变化,只有叶子层的溢出页会随插入和删除变化。
3.3 ISAM 的基本操作
3.3.1 搜索
ISAM 搜索从根结点开始,根据搜索键逐层选择下一个结点,直到到达叶子页。若存在溢出页,还需要顺着溢出链查找。
对于单值查询,找到目标键所在页后读取对应记录。对于范围查询,先找到范围起点,再沿着叶子页顺序读取后续记录。
3.3.2 插入
插入时先查找新记录应该属于哪个叶子页。如果该页还有空间,就直接插入;如果页满了,就增加溢出页,把新记录放入溢出链。
这种策略避免了修改上层索引结构,因此插入实现简单,并发控制也相对容易。但如果大量记录连续插入到同一个叶子页,溢出链会越来越长。
3.3.3 删除
删除时同样先查找目标记录所在叶子页或溢出页,然后删除记录。如果某个溢出页变空,可以释放该溢出页。
删除不会主动让 ISAM 的非叶子结构重新平衡,所以长期大量更新后,索引性能可能退化。
3.4 ISAM 的复杂性与性能直觉
ISAM 的搜索复杂性可以写成:
\[ O(\log_F N) \]
其中 \(F\) 是每个结点中 data entry 的数量,也可理解为扇出(fan-out),\(N\) 是关系中的记录数。相比内存算法常说的 \(O(\log_2 N)\),数据库索引更关心扇出 \(F\),因为一个磁盘页可以容纳很多索引项,一次 I/O 就能排除大量数据。
示例:若有 \(1,000,000\) 条记录,每页 \(10\) 条记录,每个索引结点可容纳 \(100\) 个 data entry:
| 方法 | 大致访问代价 |
|---|---|
| 顺序搜索 | 约 \(100,000\) 个数据页 |
| 直接二分法 | 约 \(17\) 次定位 |
| 一层索引加二分 | 约 \(10\) 次 |
| ISAM 多级索引 | 约 \(3\) 次 |
这个例子说明,高扇出的多级索引可以把大量数据的查询压缩到很少的页访问。
3.5 ISAM 的优缺点
ISAM 的优点是结构稳定、查询快、并发控制较简单。由于非叶子结点不随插入删除频繁变化,修改主要限制在叶子层和溢出页,系统维护成本较低。
它的缺点也来自静态结构:当插入和删除很多时,溢出链可能很长,查询时要在溢出链中顺序查找,性能会下降。常见缓解方法是在创建索引时预留空闲空间,或者定期重组索引。
4 动态树索引:B+ 树
B+ 树(B+ Tree) 是数据库中最经典、最常用的动态索引结构。它解决了 ISAM 静态结构带来的溢出链过长问题,能够在插入和删除过程中保持树的平衡。
4.1 B+ 树的基本性质
\(m\) 阶 B+ 树通常满足以下性质:
- 每个结点至多有 \(m\) 棵子树,至少有 \(\lceil m/2\rceil\) 棵子树。
- 根结点要么是叶结点,要么至少有两棵子树。
- 插入和删除后,树仍保持平衡。
- 所有叶结点处在同一层。
- data entry 层通常用双向链表连接,便于顺序访问和范围查询。
B+ 树的搜索代价主要取决于树高。由于每个结点是一个页,且扇出通常很大,实际数据库中的 B+ 树高度往往很低。
4.2 B+ 树结点结构
B+ 树结点与 ISAM 结点形式相似。一个内部结点通常由 \(n\) 个键值和 \(n+1\) 个指针构成:
\[ P_0, K_1, P_1, K_2, \ldots, K_n, P_n \]
指针 \(P_i\) 指向某个子树,键值用于决定搜索应该进入哪个子树。也就是说,每个子指针都对应一个键值区间;若某个键 \(k\) 落在 \(K_i \le k \le K_{i+1}\) 这样的区间内,搜索就沿着对应的 \(P_i\) 子树继续向下。
B+ 树一般使用第二种或第三种 data entry,即 \(\langle k,rid\rangle\) 或 \(\langle k,rid\text{-}list\rangle\)。如果 data entry 包含完整记录,则叶子层本身就相当于数据文件;否则叶子层是独立的索引文件,通过 rid 指向数据文件。
4.3 B+ 树搜索
搜索从根结点开始。如果当前结点是叶子结点,直接返回;否则根据搜索键 \(K\) 和当前结点中的键值比较,选择合适指针继续向下。
B+ 树插入伪代码的核心逻辑可以概括为:
1 | 如果当前结点是叶子,返回该结点; |
由于所有叶子在同一层,任何搜索到达叶子的路径长度相同,这就是 B+ 树“平衡”的含义。
4.4 插入:分裂与重分配
B+ 树插入分为几个步骤:
- 从根结点向下搜索,找到新 data entry 应该插入的叶子结点。
- 将 data entry 插入叶子结点的有序位置。
- 如果结点未满,操作结束。
- 如果结点满了,进行分裂(split)。
- 分裂可能把一个分隔键插入父结点,若父结点也满,则继续向上分裂。
- 如果根结点分裂,树高增加一层。
还有一种常见优化是重新分配(redistribution):如果相邻兄弟结点未满,可以把部分 data entry 移到兄弟结点,而不是立刻分裂。这能减少分裂次数,降低更新开销。
下面用一个小型 B+ 树覆盖插入的主要情况。为了让例子清晰,先约定:
- 叶子结点最多存放 3 个 data entry;非根叶子结点至少保留 2 个 data entry。
- 内部结点最多存放 3 个分隔键;非根内部结点至少保留 1 个分隔键,即至少有 2 个孩子。
- 叶子结点之间用
->表示链表连接。 - 内部结点中的分隔键采用 B+ 树常见规则:某个右侧孩子的第一个键会出现在父结点中作为分隔键。
插入情况 1:叶子未满,直接插入
初始树如下:
1 | Root: [10 | 20] |
插入 12* 时,先从根结点定位到中间叶子
[10*, 15*]。该叶子还有空位,所以直接插入:
1 | Root: [10 | 20] |
这种情况最简单:只改叶子结点,不影响父结点,也不改变树高。
插入情况 2:叶子满,分裂叶子,但父结点未满
继续插入 18*。目标叶子是
[10*, 12*, 15*],已经满了。临时插入后得到:
1 | [10*, 12*, 15*, 18*] |
叶子分裂成两个叶子:
1 | [10*, 12*] [15*, 18*] |
新右叶子的第一个键 15
被复制到父结点中,作为新的分隔键:
1 | Root: [10 | 15 | 20] |
这里父结点原来有空间,因此只发生叶子分裂,没有继续向上分裂。
插入情况 3:叶子分裂后父结点也满,继续向上分裂并产生新根
现在根结点 [10 | 15 | 20] 已经满了。假设右侧叶子为
[20*, 25*, 30*]:
1 | Root: [10 | 15 | 20] |
插入 22* 时,目标叶子 [20*, 25*, 30*]
满,临时插入后为:
1 | [20*, 22*, 25*, 30*] |
叶子分裂:
1 | [20*, 22*] [25*, 30*] |
新右叶子的第一个键 25
要插入父结点。但父结点已满,插入后临时变成:
1 | [10 | 15 | 20 | 25] |
内部结点也需要分裂。中间分隔键 20
上推成为新根,左内部结点保留 [10 | 15],右内部结点保留
[25]:
1 | Root: [20] |
这种情况体现了 B+ 树插入的级联特征:叶子分裂可能导致父结点分裂,父结点分裂可能继续向上传播;如果根结点分裂,树高增加一层。
插入情况 4:兄弟结点有空间,先重新分配而不是分裂
有些实现会在分裂前尝试和兄弟结点重新分配。假设:
1 | Root: [10 | 20] |
插入 18* 时,中间叶子满了,但右兄弟 [20*]
还有空间。可以把临时结果 [10*,12*,15*,18*] 中较大的
18* 移到右兄弟,让两个叶子保持有序:
1 | Root: [10 | 18] |
注意父结点的第二个分隔键要从 20 更新为
18,因为右兄弟现在的第一个键变成了
18。这种情况没有增加新叶子,也没有增加父结点的键数。
4.5 删除:合并与重分配
B+ 树删除与插入对称:
- 从根结点向下搜索,找到要删除的 data entry。
- 在叶子结点中删除该 entry。
- 如果结点仍满足最小占用要求,操作结束。
- 如果结点过空,则考虑与兄弟结点重新分配。
- 若兄弟结点也无法借出 entry,则进行合并(merge)。
- 合并可能导致父结点键值减少,必要时继续向上调整。
调整不仅可能发生在叶子结点,也可能发生在非叶子结点。删除过程的目标是保持 B+ 树的平衡和结点占用率要求。
下面的删除例子沿用 4.4 中的小型 B+ 树约定:叶子最多 3 个 entry、非根叶子至少 2 个 entry,内部结点最多 3 个分隔键、非根内部结点至少 1 个分隔键。
删除情况 1:删除后叶子仍满足最小占用
从下面的树删除 12*:
1 | Root: [10 | 20] |
删除后中间叶子变成 [10*, 15*],仍有 2 个 data
entry,满足最小占用:
1 | Root: [10 | 20] |
这种情况只修改叶子结点。
删除情况 2:删除了叶子第一个键,需要更新父结点分隔键
考虑:
1 | Root: [20] |
删除 20* 后,右叶子变成
[25*, 30*],没有过空。在本例采用的约定中,父结点分隔键保存“右孩子的第一个键”,因此右叶子的第一个键从
20 变成 25 后,父结点分隔键也更新为
25:
1 | Root: [25] |
这说明删除不一定导致合并或借位,但仍可能影响父结点中的分隔键。需要注意,不同教材或系统对内部结点分隔键的约定略有差异:如果把
20 只看作“右子树的下界 fence key”,那么删除叶子里的
20* 后保留根结点 [20]
也仍然能正确导航,因为小于 20 的键去左边,大于等于
20
的键去右边;但在“父结点保存右孩子最小键”的讲法下,应把它改成
25。
删除情况 3:叶子过空,向左兄弟借一个 entry
考虑:
1 | Root: [10 | 20] |
删除 12* 后,中间叶子只剩
[10*],低于最小占用。左兄弟 [1*,5*,7*] 有 3 个
entry,可以借出一个最大的 7*。重新分配后:
1 | Root: [7 | 20] |
父结点中指向中间叶子的分隔键从 10 更新为
7,因为中间叶子的第一个键变了。
删除情况 4:叶子过空,向右兄弟借一个 entry
右借是对称情况。考虑:
1 | Root: [10 | 20] |
删除 12* 后,中间叶子只剩 [10*],右兄弟有 3
个 entry,可以借出最小的 20*:
1 | Root: [10 | 25] |
父结点中右兄弟对应的分隔键从 20 更新为
25,因为右兄弟新的第一个键变成了 25。
删除情况 5:兄弟不能借,叶子合并,但父结点仍合法
考虑:
1 | Root: [10 | 20] |
删除 12* 后,中间叶子只剩
[10*],左右兄弟都只有 2 个
entry,不能借。于是把中间叶子与左兄弟合并:
1 | Root: [20] |
父结点中原来用于指向中间叶子的分隔键 10
被删除。根结点还剩一个键 [20],仍然合法。
删除情况 6:叶子合并导致父结点过空,继续向上合并,最终根收缩
最后看级联删除。初始树高度为 3:
1 | Root: [50] |
删除 25* 后,叶子 [20*,25*] 变成
[20*],过空。它的左兄弟 [10*,15*] 也只有 2 个
entry,不能借,所以两个叶子合并:
1 | [10*,15*] + [20*] => [10*,15*,20*] |
合并后,左侧内部结点 [20]
失去了一个孩子和分隔键,变成只有一个孩子、没有分隔键,作为非根内部结点已经过空:
1 | Root: [50] |
右侧内部兄弟 [70]
也只有最小数量的孩子,不能借,所以左内部结点、根分隔键
50、右内部结点合并。合并后根结点没有分隔键了,树高可以下降一层,新的根就是合并得到的内部结点:
1 | New Root: [50 | 70] |
这就是删除中最复杂的情况:叶子合并可能让父结点过空;父结点过空又可能继续向上合并;如果根结点最后只剩一个孩子,就用这个孩子替代根,树高减少一层。
4.6 重复数据的处理
当索引列上存在重复值时,B+ 树需要额外处理。常见思路有两种:
- 使用 \(\langle k,rid\rangle\):每条重复记录有一个 data entry。查询时需要修改算法,例如找到同值记录范围,再逐个取出。
- 使用 \(\langle k,rid\text{-}list\rangle\):一个键值对应一个 rid 列表,处理重复值更直接,但当重复记录很多时,rid 列表本身的查询和修改也会变复杂。
实际系统可能采用不同策略。Sybase 使用第三种 data entry;DB2、Oracle 8、SQL Server 等系统则通过在键中增加 RID 的方式处理重复数据,使内部排序键保持可区分。
4.7 B+ 树在实际系统中的优化
4.7.1 索引值压缩
数据库查询代价与 B+ 树高度相关,而高度近似为:
\[ O(\log_{\text{fan-out}}(\#\text{data entries})) \]
扇出越大,树越矮;一个结点中能放更多索引项,扇出就越大。因此实际系统会考虑降低键值长度。
对字符串键,可以使用前缀压缩(prefix compression)。基本思想是在非叶子结点中不保存完整字符串,而只保存足以区分左右子树的最短前缀。例如,“David Smith”只能压缩成 “Davi”,因为压缩后的值必须大于左子树所有键,并小于右子树所有键。
4.7.2 实际系统中的删除
实际 DBMS 删除索引项时不一定马上物理删除。有些系统会先打标记,之后再批量清理或重组。
| 系统 | 删除策略 |
|---|---|
| Sybase | 可以马上删除,也可以先标记再删除 |
| Oracle 8 | 先做删除标记,将来再调整 |
| Informix | 被删除数据加标签 |
| DB2、SQL Server | 被删除数据马上删除 |
这体现了数据库实现中的权衡:立即删除能及时回收空间,但可能增加当前操作成本;延迟删除能让当前操作更快,但需要后续维护。
4.7.3 B+ 树批量建立
如果已经收集好大量 data entry,再逐条插入 B+ 树会很慢,因为每条记录都可能触发查找、分裂和调整。更高效的方法是批量建立(bulk loading):
- 收集所有 data entry。
- 按搜索键排序。
- 将排序后的 data entry 组织成叶子页。
- 每页取出一个代表键,逐步建立上层索引结点。
- 从左到右构造整棵树,直到根结点形成。
批量建立利用了数据已经排序的事实,通常比逐条插入快很多,适合离线建索引或大规模数据导入后的建索引。
5 基于 Hash 的索引结构
树索引适合等值查询和范围查询,而 Hash 索引(Hash Index) 更适合等值查询。Hash 索引通过 Hash 函数把搜索键映射到某个 bucket,然后在该 bucket 中查找记录。
5.1 Hash 索引的基本思想
Hash 索引将键值 \(key\) 输入 Hash 函数 \(h\),得到一个 bucket 编号:
\[ h(key) \bmod N \]
其中 \(N\) 是 bucket 数量。每个 bucket 通常包含一个 primary bucket page 和若干 overflow page。查询时先计算 Hash 值,定位 primary page,再在 primary page 和 overflow pages 中查找目标记录。
Hash 索引对等值查询很快,例如:
1 | WHERE age = 25 |
但它不适合范围查询,例如:
1 | WHERE age BETWEEN 20 AND 30 |
原因是 Hash 函数会打散键值顺序,Hash 相邻的 bucket 不代表原始键值相邻。
5.2 静态 Hashing
静态 Hashing(Static Hashing) 中 primary bucket page 的数量固定。每个 bucket 可以带一串 overflow page,以处理 bucket 满的情况。
静态 Hashing 的查询、插入和删除都基于 Hash 定位:
- 查询:计算 Hash 值,进入对应 bucket,扫描 primary page 和 overflow pages。
- 插入:先定位 bucket,如果 primary page 满,则插入 overflow page。
- 删除:先定位 bucket,再删除目标记录。
Hash 函数选择非常关键。一个好的 Hash 函数应尽量把数据均匀分布到 bucket 中。一个简单形式是:
\[ H(value)=a \cdot value + b \]
实际系统中还需要结合取模、位运算或更复杂的 Hash 方法。
静态 Hashing 的主要问题是 bucket 数固定:
- 数据增加时,overflow page 串变长,查询性能下降。
- 数据减少时,primary bucket page 可能浪费空间。
解决方法包括定期重组,或者采用动态 Hashing。
5.3 可扩充 Hashing
可扩充 Hashing(Extendible Hashing) 使用一个 directory 记录 bucket 地址。它会根据数据增长动态扩展 directory,并在 bucket 满时分裂 bucket,而不是简单增加长溢出链。
可扩充 Hashing 的关键概念有:
- Directory: 内存或磁盘中的目录,目录项指向 bucket。
- Global Depth: 全局深度,表示当前 directory 使用 Hash 值的后多少位来寻址。
- Local Depth: 局部深度,表示某个 bucket 实际用多少位区分自己。
- Bucket Split: 当 bucket 满时,将其分裂为两个 bucket,并根据更多 Hash 位重新分配数据。
查询时,系统取 Hash 值的最后若干位,按 global depth 在 directory 中找到 bucket,再在 bucket 内查找。
如果 bucket 的 local depth 小于 global depth,分裂时可能只需要更新部分 directory 指针;如果 local depth 等于 global depth,则需要 directory 翻倍,使 global depth 加一。
下面用一个小例子说明可扩充 Hashing 的工作过程。假设 bucket 最多只能放 2 个 data entry,Hash 值直接用键值的二进制低位表示,初始 global depth 为 1,因此 directory 只看 Hash 值最后 1 位:
| Directory 项 | 指向 bucket | bucket 内容 | local depth |
|---|---|---|---|
0 |
B0 | 空 | 1 |
1 |
B1 | 空 | 1 |
现在依次插入 4*、12*、5*。因为
\(4=(100)_2\),\(12=(1100)_2\),它们最后 1 位都是
0,所以进入 B0;\(5=(101)_2\) 最后 1 位是
1,所以进入 B1:
| Directory 项 | 指向 bucket | bucket 内容 |
|---|---|---|
0 |
B0 | 4*, 12* |
1 |
B1 | 5* |
接着插入 13*。\(13=(1101)_2\),最后 1 位是
1,进入 B1。B1 原来只有
5*,还能容纳,所以插入后为:
| Directory 项 | 指向 bucket | bucket 内容 |
|---|---|---|
0 |
B0 | 4*, 12* |
1 |
B1 | 5*, 13* |
再插入 20*。\(20=(10100)_2\),最后 1 位是
0,应进入 B0,但 B0 已满。此时 B0 的 local depth 为 1,等于
global depth 1,因此必须先让 directory 翻倍:global depth 从 1 变成
2,directory 从 0/1 扩展成 00/01/10/11。然后
B0 分裂为两个 bucket,按最后 2 位重新分配原数据和新数据:
| 键值 | 二进制 | 最后 2 位 | 新 bucket |
|---|---|---|---|
| 4 | 00100 |
00 |
B00 |
| 12 | 01100 |
00 |
B00 |
| 20 | 10100 |
00 |
B00 |
这里会出现一个很重要的现象:即使 directory
扩展了,4*、12*、20* 的最后 2
位仍然都是 00,它们还是落在同一个 bucket 中。如果 bucket
容量仍然只有 2,则 B00 还会继续溢出,需要再次分裂,并可能继续增加 local
depth。这个例子说明,可扩充 Hashing 能动态扩展,但如果 Hash
低位分布不均匀,directory 和 bucket 分裂可能增长得很快。
为了看到正常分裂的效果,再假设插入的是 2* 而不是
20*。\(2=(10)_2\) 的最后 2
位是 10,那么 B0 分裂后可重新分配为:
| Directory 项 | 指向 bucket | bucket 内容 | local depth |
|---|---|---|---|
00 |
B00 | 4*, 12* |
2 |
10 |
B10 | 2* |
2 |
01 |
B1 | 5*, 13* |
1 |
11 |
B1 | 5*, 13* |
1 |
注意 01 和 11 仍然可以指向同一个 B1,因为
B1 的 local depth 还是 1,它只用最后 1 位区分数据;而 B00、B10 的 local
depth 已经是 2,它们需要最后 2 位才能区分。查询时,global depth
决定先看几位进入 directory,local depth 说明某个 bucket
自己实际被分裂到了多细。
可扩充 Hashing 的优点是 overflow 链较短,查询性能较好。缺点是当 Hash 函数不均匀时,directory 可能快速增长,占用较多空间。
5.4 线性 Hashing
线性 Hashing(Linear Hashing) 也是动态 Hashing,但它没有 directory。它通过按顺序分裂 bucket 来逐步扩展索引,避免可扩充 Hashing 在数据倾斜时 directory 频繁扩大的问题。
线性 Hashing 使用一族 Hash 函数:
\[ h_i(value)=h(value)\bmod(2^iN) \]
其中 \(N\) 是初始 bucket 数,\(i\) 表示当前 level。\(h_i\) 的地址范围是 \(h_{i+1}\) 的一半。系统还维护一个
Next 指针,指向下一个要分裂的 bucket。
查询时通常先用当前 level 的 Hash 函数 \(h_i\) 定位 bucket。如果结果对应的 bucket
已经被 Next 指针越过,说明该 bucket 已分裂,需要使用 \(h_{i+1}\) 重新定位。
插入触发分裂时,并不一定分裂当前溢出的 bucket,而是分裂
Next 指向的 bucket。新分裂出的 bucket 放在 bucket
序列末尾,Next 向后移动。当 Next
扫过一轮后,level 增加,Next 回到起点。
下面用一个例子说明线性 Hashing 的过程。假设初始有 \(N=4\) 个 bucket,bucket 编号为
0,1,2,3,每个 bucket 最多放 3 个 data entry。初始
Level=0,Next=0,使用:
\[ h_0(k)=h(k)\bmod 4 \]
为了便于计算,假设 \(h(k)=k\)。初始状态如下:
| bucket | 内容 |
|---|---|
| 0<-Next | 32*, 44*,
36* |
| 1 | 9*, 25*,
5* |
| 2 | 14*, 18*,
10* |
| 3 | 31*, 35*,
7* |
现在插入 43*。因为 \(h_0(43)=43\bmod 4=3\),所以它应该进入
bucket 3。但 bucket 3 已满,于是 43* 先进入 bucket 3 的
overflow page。线性 Hashing 接着触发一次分裂,但分裂的不是
bucket 3,而是 Next=0 指向的 bucket 0。
分裂 bucket 0 时,新 bucket 会追加到 bucket 序列末尾,编号为
4。bucket 0 中原来的记录要用下一层 Hash 函数重新分配:
\[ h_1(k)=h(k)\bmod 8 \]
| 记录 | \(h_1(k)\) | 分裂后位置 |
|---|---|---|
32* |
\(32\bmod 8=0\) | bucket 0 |
44* |
\(44\bmod 8=4\) | bucket 4 |
36* |
\(36\bmod 8=4\) | bucket 4 |
分裂完成后,Next 从 0 移到 1:
| bucket | 内容 |
|---|---|
| 0 | 32* |
| 1<-Next | 9*, 25*,
5* |
| 2 | 14*, 18*,
10* |
| 3 | 31*, 35*,
7*,overflow: 43* |
| 4 | 44*, 36* |
这里要注意:虽然 43* 的插入让 bucket 3
溢出了,但本轮实际分裂的是 bucket 0。线性 Hashing 通过 Next
按顺序分裂 bucket,使扩展过程比较平滑。
接着插入 37*。先算 \(h_0(37)=37\bmod 4=1\),目标是 bucket
1。bucket 1 已满,于是 37* 进入 bucket 1 的 overflow
page,并触发分裂。此时 Next=1,所以这次分裂 bucket
1,并新增 bucket 5。用 \(h_1(k)=k\bmod
8\) 重新分配 bucket 1 中的数据:
| 记录 | \(h_1(k)\) | 分裂后位置 |
|---|---|---|
9* |
\(9\bmod 8=1\) | bucket 1 |
25* |
\(25\bmod 8=1\) | bucket 1 |
5* |
\(5\bmod 8=5\) | bucket 5 |
37* |
\(37\bmod 8=5\) | bucket 5 |
分裂后 Next 移到 2:
| bucket | 内容 |
|---|---|
| 0 | 32* |
| 1 | 9*, 25* |
| 2<-Next | 14*, 18*,
10* |
| 3 | 31*, 35*,
7*,overflow: 43* |
| 4 | 44*, 36* |
| 5 | 5*, 37* |
查询时也要考虑 Next。例如现在
Level=0、Next=2。查询 44*
时,先算 \(h_0(44)=0\),但 bucket 0
已经被分裂过,因为 0 < Next,所以要改用 \(h_1(44)=4\),最终到 bucket 4 查找。查询
18* 时,\(h_0(18)=2\),而
2 没有小于 Next=2,说明 bucket 2
还没分裂,所以仍在 bucket 2 查找。
当 Next 依次从 0、1、2、3 扫完整个旧 bucket
序列后,一轮分裂结束,Level 增加为 1,Next
回到 0。之后基础 Hash 函数变为 \(h_1(k)=k\bmod
8\),下一轮分裂会继续产生更多 bucket。
5.5 可扩充 Hashing 与线性 Hashing 的比较
两者都依赖 Hash 函数的质量。当 Hash 函数均匀时,两者性能差距不大;线性 Hashing 少了一次读取 directory 的开销。
当 Hash 函数不均匀时,两者表现不同:
| 项目 | 可扩充 Hashing | 线性 Hashing |
|---|---|---|
| 是否有 directory | 有 | 无 |
| 扩展方式 | bucket 满时可能分裂并扩展 directory | 按 Next 指针顺序分裂 bucket |
| 查询性能 | overflow 链较短,通常较好 | 可能因 overflow 链较长而较差 |
| 空间开销 | directory 和 bucket 数可能增长较快 | primary bucket 增长较慢,空间较省 |
| 数据倾斜时 | directory 可能急剧增大 | 空间较稳,但查询可能退化 |
核心权衡:可扩充 Hashing 用更多空间换较短 overflow 链和更好查询性能;线性 Hashing 用更平滑的扩展方式节省空间,但可能保留较长 overflow 链。
6 多键索引与特殊数据类型索引
多属性查询和非传统数据类型索引共同体现一个原则:索引结构必须结合查询模式、数据分布和数据语义来设计。
6.1 多键索引问题
对于查询:
1 | SELECT eno |
如果只有单属性索引,DBMS 可能有三种方式:
- 使用
ename索引找出所有ename='liu'的记录,再检查salary=600。 - 使用
salary索引找出所有salary=600的记录,再检查ename='liu'。 - 分别使用两个索引,取两个结果集合的交集。
问题是中间结果可能过多。若叫 liu 的人很多,或工资为
600 的人很多,单属性索引仍然会产生大量候选记录。
因此,多键索引的目标是同时利用多个属性进行裁剪,尽量减少中间结果。
6.2 网格文件
网格文件(Grid File) 是一种多维索引思想。它把多个属性的取值空间划分为网格,每个网格单元对应一个 bucket。查询多个属性条件时,可以定位到对应区域,而不是只靠单个属性过滤。
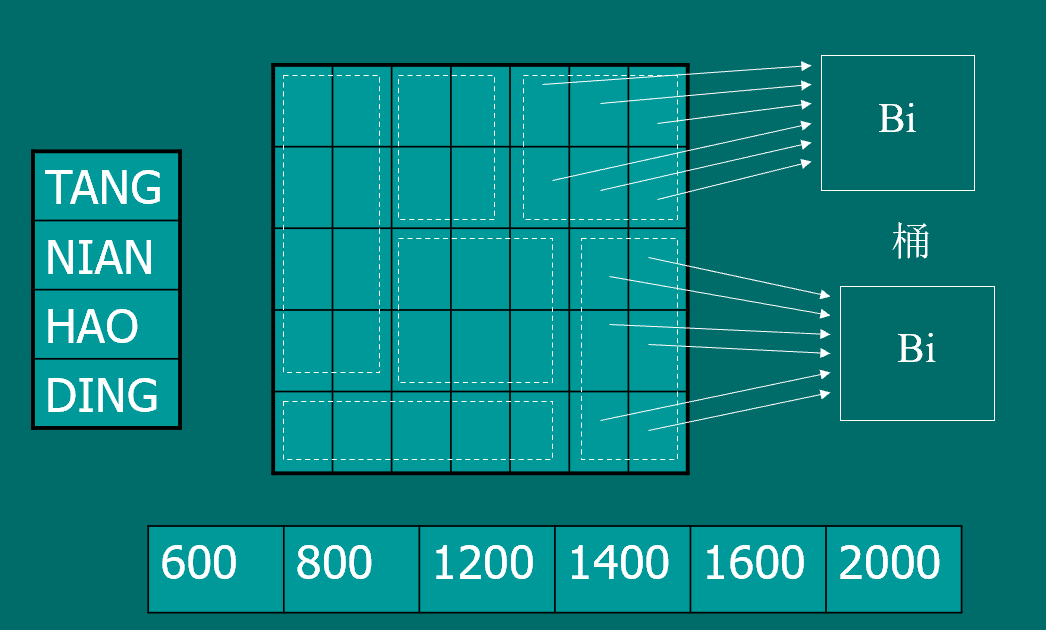
例如对于姓名和工资两个维度,可以按姓名范围、工资范围划分网格。查询
ename='liu' AND salary=600
时,系统可以直接定位到姓名维度和工资维度共同确定的桶。
6.3 分区散列技术
分区散列技术(Partitioned Hashing) 也用于多个属性上的索引。它把复合查询键的各个属性分别映射为 Hash 位串,再组合成整体 Hash 表示。
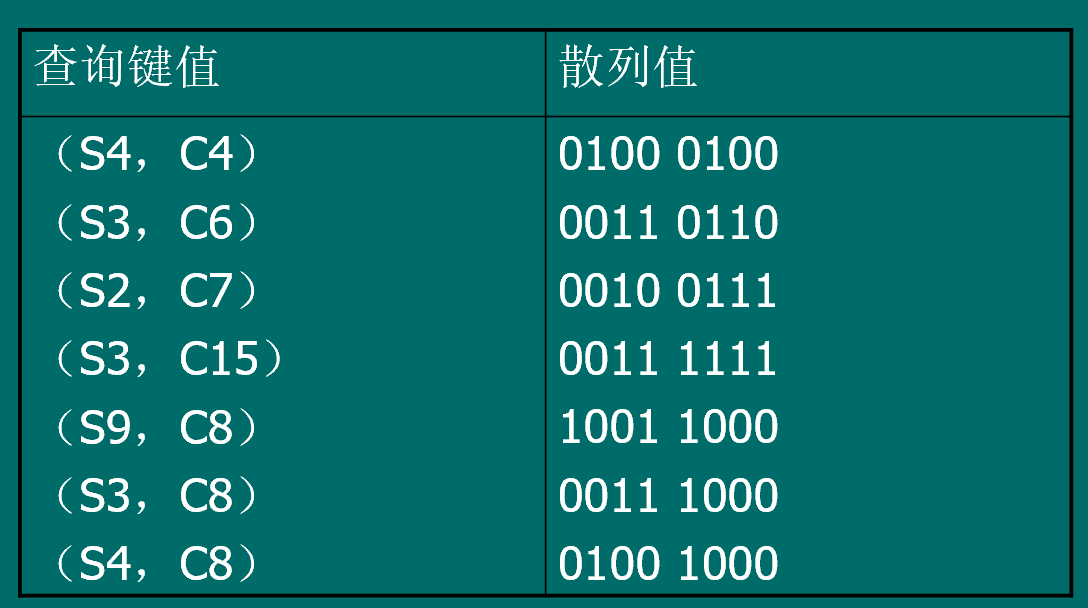
查询键值如 \((S4,C4)\)、\((S3,C6)\)、\((S2,C7)\) 可以被映射为类似
0100 0100、0011 0110
的散列值。这种方式可以在多属性条件下利用不同属性对应的位段,支持更细粒度的定位。
6.4 R 树
R 树(R-tree) 是动态空间数据索引结构,常用于二维或多维空间对象,例如矩形、区域、地理位置和空间数据库。
R 树的核心思想是用最小覆盖矩形(Minimum Bounding Rectangle, MBR) 组织数据。每个内部结点保存若干矩形,每个矩形覆盖其子树中的所有对象。查询时,如果查询区域与某个 MBR 相交,就需要进入对应子树。
R 树与 B+ 树不同:B+ 树查询通常只沿一条路径下降,而 R 树的一次空间查询可能覆盖多条路径,因为多个 MBR 可能重叠。矩形划分质量直接影响性能。
下面用二维地图数据举例。假设数据库中存储几个空间对象,每个对象用一个矩形区域表示:
| 对象 | 空间范围,格式为 \((x_{\min},y_{\min})-(x_{\max},y_{\max})\) |
|---|---|
| A 商场 | \((1,1)-(4,4)\) |
| B 学校 | \((5,1)-(8,3)\) |
| C 公园 | \((2,6)-(5,9)\) |
| D 医院 | \((6,6)-(9,9)\) |
R 树可以把相近的对象分成两组,并为每组建立一个 MBR:
| R 树结点 | 覆盖对象 | MBR |
|---|---|---|
| Node 1 | A 商场、B 学校 | \((1,1)-(8,4)\) |
| Node 2 | C 公园、D 医院 | \((2,6)-(9,9)\) |
如果用户查询“找出与区域 \((3,2)-(6,7)\) 相交的对象”,系统先检查查询区域与上层 MBR 是否相交。该查询区域既与 Node 1 的 MBR 相交,也与 Node 2 的 MBR 相交,因此 R 树必须同时进入两个子结点继续检查。进入 Node 1 后,发现查询区域与 A 商场、B 学校都可能相交;进入 Node 2 后,又发现它与 C 公园相交,但不一定与 D 医院相交。
这个例子说明了 R 树的两个特点:第一,内部结点保存的是“覆盖一组对象的矩形”,不是单个排序键;第二,多个 MBR 可能同时与查询区域相交,所以一次查询可能走多条路径。R 树的性能很依赖矩形划分质量,MBR 重叠越少,查询时需要访问的路径越少。
6.5 KD 树
KD 树(K-D Tree, k-dimensional tree) 是一种用于 \(k\) 维数据空间的二叉查找树。它通过不断选择某个维度上的超平面,把数据集合划分为两个子集合。
构造过程可以理解为:
- 选择一个划分维度。
- 在该维度上选择划分值。
- 将点集分成两个不相交子集。
- 对子集递归划分,直到集合足够小或只剩一个点。
KD 树适合点数据的空间查找。它通常组织成平衡树,并通过空间划分减少搜索范围。
下面用二维点数据举例。假设有 6 个位置点:
| 点 | 坐标 \((x,y)\) |
|---|---|
| P1 | \((2,3)\) |
| P2 | \((5,4)\) |
| P3 | \((9,6)\) |
| P4 | \((4,7)\) |
| P5 | \((8,1)\) |
| P6 | \((7,2)\) |
构造 KD 树时,可以在不同层轮流选择划分维度。第一层按 \(x\) 维划分,选择中位点附近的 \(x=7\) 作为根划分:\(x<7\) 的点进入左子树,\(x\ge 7\) 的点进入右子树。
| 第一层划分 | 点集合 |
|---|---|
| 左子树:\(x<7\) | P1 \((2,3)\)、P2 \((5,4)\)、P4 \((4,7)\) |
| 右子树:\(x\ge 7\) | P3 \((9,6)\)、P5 \((8,1)\)、P6 \((7,2)\) |
第二层可以改按 \(y\) 维划分。例如左子树中按 \(y\) 划分,P2 \((5,4)\) 可作为中间点,\(y<4\) 的 P1 在其一侧,\(y\ge 4\) 的 P4 在另一侧;右子树中也按 \(y\) 划分,P6 \((7,2)\) 可把 P5 \((8,1)\) 和 P3 \((9,6)\) 分开。
如果查询“找 \(x\) 在 1 到 6 且 \(y\) 在 2 到 5 之间的点”,即查询矩形:
\[ 1 \le x \le 6,\quad 2 \le y \le 5 \]
KD 树会先根据根结点的 \(x\) 划分判断:查询范围的 \(x\) 最大值是 6,小于 7,因此右子树整体可以被剪掉,只需要进入左子树。进入左子树后,再根据 \(y\) 划分继续过滤,最终 P1 \((2,3)\) 和 P2 \((5,4)\) 满足条件,P4 \((4,7)\) 因为 \(y=7\) 不满足而被排除。
这个例子体现了 KD 树的核心:它不是用 MBR 包住对象,而是用超平面不断切分空间;查询时根据查询区域与切分平面的关系,尽量剪掉不可能包含结果的子空间。
6.6 图数据索引
6.6.1 图数据库
图数据库(Graph Database) 是一种以“点”和“边”为核心组织数据的数据库。点表示实体,例如用户、论文、城市、商品;边表示实体之间的关系,例如“关注”“引用”“连接”“购买”。如果关系本身比单个实体属性更重要,图数据库通常比普通关系表更自然。
例如一个社交网络可以表示为图:
| 点或边 | 含义 |
|---|---|
点
Alice、Bob、Cindy、David |
用户 |
边 Alice -> Bob |
Alice 关注 Bob |
边 Bob -> Cindy |
Bob 关注 Cindy |
边 Alice -> David |
Alice 关注 David |
边 David -> Cindy |
David 关注 Cindy |
在关系数据库中,这些关系可能要放在用户表、关注关系表里,再通过多次
join 查询;而在图数据库中,查询可以直接沿着边走。例如“找 Alice
的二跳好友”就是从 Alice 出发,先走到 Bob 和
David,再继续走到 Cindy。
6.6.2 图数据索引
图数据索引(Graph Data Index)
是为了加速图查询而建立的辅助结构。普通 B+ 树或 Hash
索引擅长处理单个属性值,例如
age=20、sid='S001';但图查询常常关心的是一段关系模式,例如“谁关注了某人”“是否存在某种路径”“是否包含某个子图”。因此图数据索引通常索引的是路径、邻接关系、频繁子结构或图的规范化表示。
典型查询模式包括子图匹配(Subgraph Matching):判断大图中是否存在与查询图结构相同或相似的子图。
图索引的构建思路包括:
- 基于频繁模式建立索引。
- 基于路径建立索引。
- 利用图数据的唯一化表示,避免同构图被重复表示。
下面用两个例子说明图数据索引到底在加速什么。
第一个例子是路径索引。假设论文引用网络中,点表示论文,边
A -> B 表示论文 A 引用了论文 B:
| 引用边 | 含义 |
|---|---|
| P1 -> P2 | P1 引用 P2 |
| P2 -> P3 | P2 引用 P3 |
| P1 -> P4 | P1 引用 P4 |
| P4 -> P3 | P4 引用 P3 |
如果经常查询“从 P1 出发,经过两次引用能到达哪些论文”,没有索引时系统需要从 P1 的邻接边开始逐层遍历。路径索引可以预先保存长度为 2 的可达关系:
| 起点 | 长度为 2 的路径终点 | 路径 |
|---|---|---|
| P1 | P3 | P1 -> P2 -> P3 |
| P1 | P3 | P1 -> P4 -> P3 |
这样查询 P1 的二跳引用结果时,可以直接查路径索引,而不必每次重新遍历所有边。这个思路类似普通索引把“键值到记录位置”的关系提前保存下来,只是这里保存的是“路径模式到匹配位置”。
第二个例子是频繁子图索引。假设化学分子数据库中,每个分子是一张图:原子是点,化学键是边。用户查询“哪些分子中包含苯环结构”。苯环可以看作一个常见的六元环子图。如果没有索引,系统可能要对每个分子做复杂的子图匹配;如果预先把常见结构如“六元环”“羟基”“羧基”建成索引,就可以先快速筛出可能包含苯环的分子,再做精确验证。
这里的关键是:图索引通常只能先做候选过滤,不一定直接给出最终答案。因为图结构可能存在同构、边标签、点标签、方向等复杂条件,索引筛出的候选图还需要进一步匹配确认。
图索引的难点在于图结构复杂,节点和边没有天然线性顺序,子图匹配本身计算代价较高。因此索引重点是尽快排除不可能匹配的候选图。
6.7 时间序列索引与 iSAX
时间序列数据广泛出现在物联网、传感器、金融数据和监控系统中。时间序列索引的主要目标是支持相似性查询,即找出与某条时间序列形状相似的数据。
时间序列可以有多种表示方法,不同表示关注不同特征,例如整体趋势、局部波动、分段均值或符号模式。
iSAX(indexable Symbolic Aggregate approXimation) 的思想是:
- 支持 PAA(Piecewise Aggregate Approximation,分段聚合近似),即把时间序列划分为若干段,并用每段平均值近似表示。
- 支持符号序列表示,把数值序列转换为符号串。
- 不同段可以有不同基数,例如 \((111, 11, 101, 0)=(7_8,3_4,5_8,0_2)\) 表示各段基数分别为 \(8,4,8,2\)。
- 借鉴 KD 树思想,利用区分能力最强的属性进行划分。
下面用传感器温度数据举例。假设某个传感器在 8 个连续时刻记录到如下温度序列:
\[ T=[20,22,21,23,30,32,31,33] \]
如果直接比较完整时间序列,系统需要逐点比较 8 个数。PAA 的第一步是把序列分段,例如每 2 个点一段,共分成 4 段,然后用每段平均值代表这一段:
| 分段 | 原始数值 | PAA 平均值 |
|---|---|---|
| 第 1 段 | \(20,22\) | \(21\) |
| 第 2 段 | \(21,23\) | \(22\) |
| 第 3 段 | \(30,32\) | \(31\) |
| 第 4 段 | \(31,33\) | \(32\) |
于是原始序列可近似表示为:
\[ PAA(T)=[21,22,31,32] \]
第二步是把这些数值进一步转换成符号。为了简单说明,假设系统把平均值区间划分成 4 个符号:
| 数值区间 | 符号 | 二进制编码 |
|---|---|---|
| \([0,20)\) | a | 00 |
| \([20,25)\) | b | 01 |
| \([25,30)\) | c | 10 |
| \([30,\infty)\) | d | 11 |
那么 \([21,22,31,32]\) 会被转换成:
\[ [b,b,d,d] \]
也可以写成二进制符号序列:
\[ (01,01,11,11) \]
这个符号序列就是时间序列的压缩表示。它丢掉了一些细节,例如
20,22 和 21,21
都可能落到同一个符号,但保留了整体形状:前半段温度较低,后半段温度较高。
如果数据库中有很多传感器序列,iSAX 可以把相似符号前缀组织在同一个索引结点中。例如:
| 序列 | 原始趋势 | iSAX 符号 |
|---|---|---|
| T1 | 低、低、高、高 | (01,01,11,11) |
| T2 | 低、低、高、高 | (01,01,10,11) |
| T3 | 高、高、低、低 | (11,11,01,01) |
当用户查询“找和 T1 形状相似的时间序列”时,系统不需要一开始就把 T1
和所有原始序列逐点比较,而是先通过 iSAX 符号找到
(01,01,*,*) 或更接近 (01,01,11,11)
的候选序列,例如
T2,再对候选序列做精确距离计算。这样索引的作用就是先用粗粒度符号表示快速排除明显不相似的序列。
不同基数可以理解为不同分段的区分精度:某些分段需要更细的区分能力,就用更多
bit 表示。例如 (111, 11, 101, 0) 中第一段有 3 bit,能区分
\(2^3=8\) 个符号;第二段有 2
bit,能区分 \(2^2=4\)
个符号;最后一段只有 1 bit,只能粗略区分 2 个符号。iSAX
会优先在区分能力最强、最有助于分开数据的维度上继续划分,这一点和 KD
树按维度切分空间的思想相似。
iSAX 的直觉是:先把长时间序列压缩成较短的符号表示,再用这些符号进行索引,从而支持大规模时间序列相似性查询。
6.8 GiST
GiST(Generalized Search Tree,广义搜索树) 是 Berkeley 提出的通用索引框架。它不是某一种固定索引,而是提供一种构造搜索树索引的抽象方法。
GiST 的意义在于:不同数据类型和查询谓词可能需要不同的索引逻辑,例如空间数据、文本、区间、集合等。通过广义搜索树框架,可以把“如何判断进入哪个子树、如何分裂、如何判断匹配”等操作抽象出来,为多种索引结构提供统一实现基础。
7 总结
索引结构的主线是:数据库通过组织 data entry 来快速定位记录;不同索引结构适合不同查询模式和更新场景。树索引强调有序性和范围查询,Hash 索引强调等值查询,多维和特殊数据索引则进一步结合数据语义设计裁剪方式。
7.1 核心概念
- data entry 的三种形式: \(k^*\)、\(\langle k,rid\rangle\)、\(\langle k,rid\text{-}list\rangle\)。
- 簇聚索引与非簇聚索引: 是否与数据文件物理顺序一致,尤其影响范围查询代价。
- 稠密索引与稀疏索引: 是否为每个搜索键值建立索引项;稀疏索引必须依赖簇聚顺序。
- 主索引、辅助索引、唯一索引、重复索引: 分别从索引建立属性和键值是否重复角度分类。
- 组合搜索键索引: 多属性索引中属性顺序会影响可用查询。
7.2 ISAM 与 B+ 树对比
| 项目 | ISAM | B+ 树 |
|---|---|---|
| 类型 | 静态索引结构 | 动态索引结构 |
| 更新方式 | 非叶子层基本不变,叶子层可接溢出页 | 插入删除后通过分裂、合并、重分配保持平衡 |
| 查询性能 | 初始较好,溢出链过长会退化 | 长期较稳定 |
| 并发控制 | 相对简单 | 较复杂 |
| 适用场景 | 数据变化不大 | 大多数动态数据库场景 |
重点理解:ISAM 快而稳定,但怕大量更新;B+ 树维护成本更高,但能长期保持平衡,是实际系统中最常见的索引结构。
7.3 B+ 树
B+ 树需要重点关注以下问题:
- 为什么所有叶子结点必须在同一层。
- 内部结点中的键值和指针如何引导搜索。
- 插入时何时分裂,分裂如何向上传播。
- 删除时何时重分配或合并,调整如何影响父结点。
- 为什么叶子层链表有利于范围查询。
- 为什么增大 fan-out 可以降低树高和 I/O 代价。
- 前缀压缩如何通过缩短键值提高 fan-out。
7.4 Hash 索引
Hash 索引要重点区分三类:
| 类型 | 关键思想 | 主要问题 |
|---|---|---|
| 静态 Hashing | 固定 bucket 数,溢出页处理增长 | 数据增长导致 overflow 链变长,数据减少浪费空间 |
| 可扩充 Hashing | 使用 directory、global depth、local depth 动态分裂 | directory 可能增长很快 |
| 线性 Hashing | 无 directory,按 Next 指针逐步分裂 | 可能保留较长 overflow 链 |
同时要记住:Hash 索引适合等值查询,不适合范围查询。
7.5 索引结构构建的总体思路
索引结构设计可以归纳为几个原则:
- 结合用户查询模式,优先优化常见查询。
- 结合数据分布,避免索引在倾斜数据上退化。
- 结合存储结构,减少页访问次数。
- 分析数据语义层次,为空间、图、时间序列等复杂数据选择合适表示。
- 尽快裁剪搜索空间,减少候选数据规模。
从练习和实践角度看,索引设计不是“某种结构永远最好”,而是在查询类型、更新频率、空间开销、数据分布和存储介质之间做权衡。