1 大规模分布式训练的背景
本讲讨论的是大规模分布式训练(Large-Scale Distributed Training):当模型参数、激活值、训练数据和计算量都大到单张 GPU 无法承受时,如何把一次神经网络训练拆到很多 GPU 上完成。
课件用 Llama3-405B 作为贯穿例子。GPT-4 技术报告公开了模型能力,但没有公开太多架构、训练硬件、训练数据和训练方法细节;而 Meta 的 Llama 3 论文公开了较多模型规模和训练系统信息,因此适合作为课程中的工程案例。
这里的核心问题是:给定一个巨大模型和一个 GPU 集群,如何让模型放得下、跑得快、通信不拖垮训练。
2 GPU 硬件与训练集群
2.1 GPU 为什么适合深度学习
GPU(Graphics Processing Unit)最初是为图形渲染设计的,但现在已经成为通用并行处理器。深度学习中的卷积、线性层、注意力等计算大量依赖矩阵乘法和向量化操作,这类工作天然适合 GPU 上的大规模并行执行。
以 NVIDIA H100 为例,一张 GPU 内部包含大量计算核心、片上缓存、高带宽显存和专门加速矩阵乘法的 Tensor Core。课件给出的关键数字包括:
| 组件或指标 | 含义 |
|---|---|
| HBM 显存 | H100 有约 80GB 高带宽显存 |
| 显存到计算核心带宽 | 约 \(3352 \text{ GB/s}\) |
| L2 Cache | 约 50MB |
| Streaming Multiprocessor(SM) | H100 有 132 个启用 SM,可看作很多独立并行核心 |
| FP32 Core | 每个 SM 有 128 个 FP32 Core,适合普通浮点向量运算 |
| Tensor Core | 每个 SM 有 4 个 Tensor Core,专门加速矩阵乘法 |
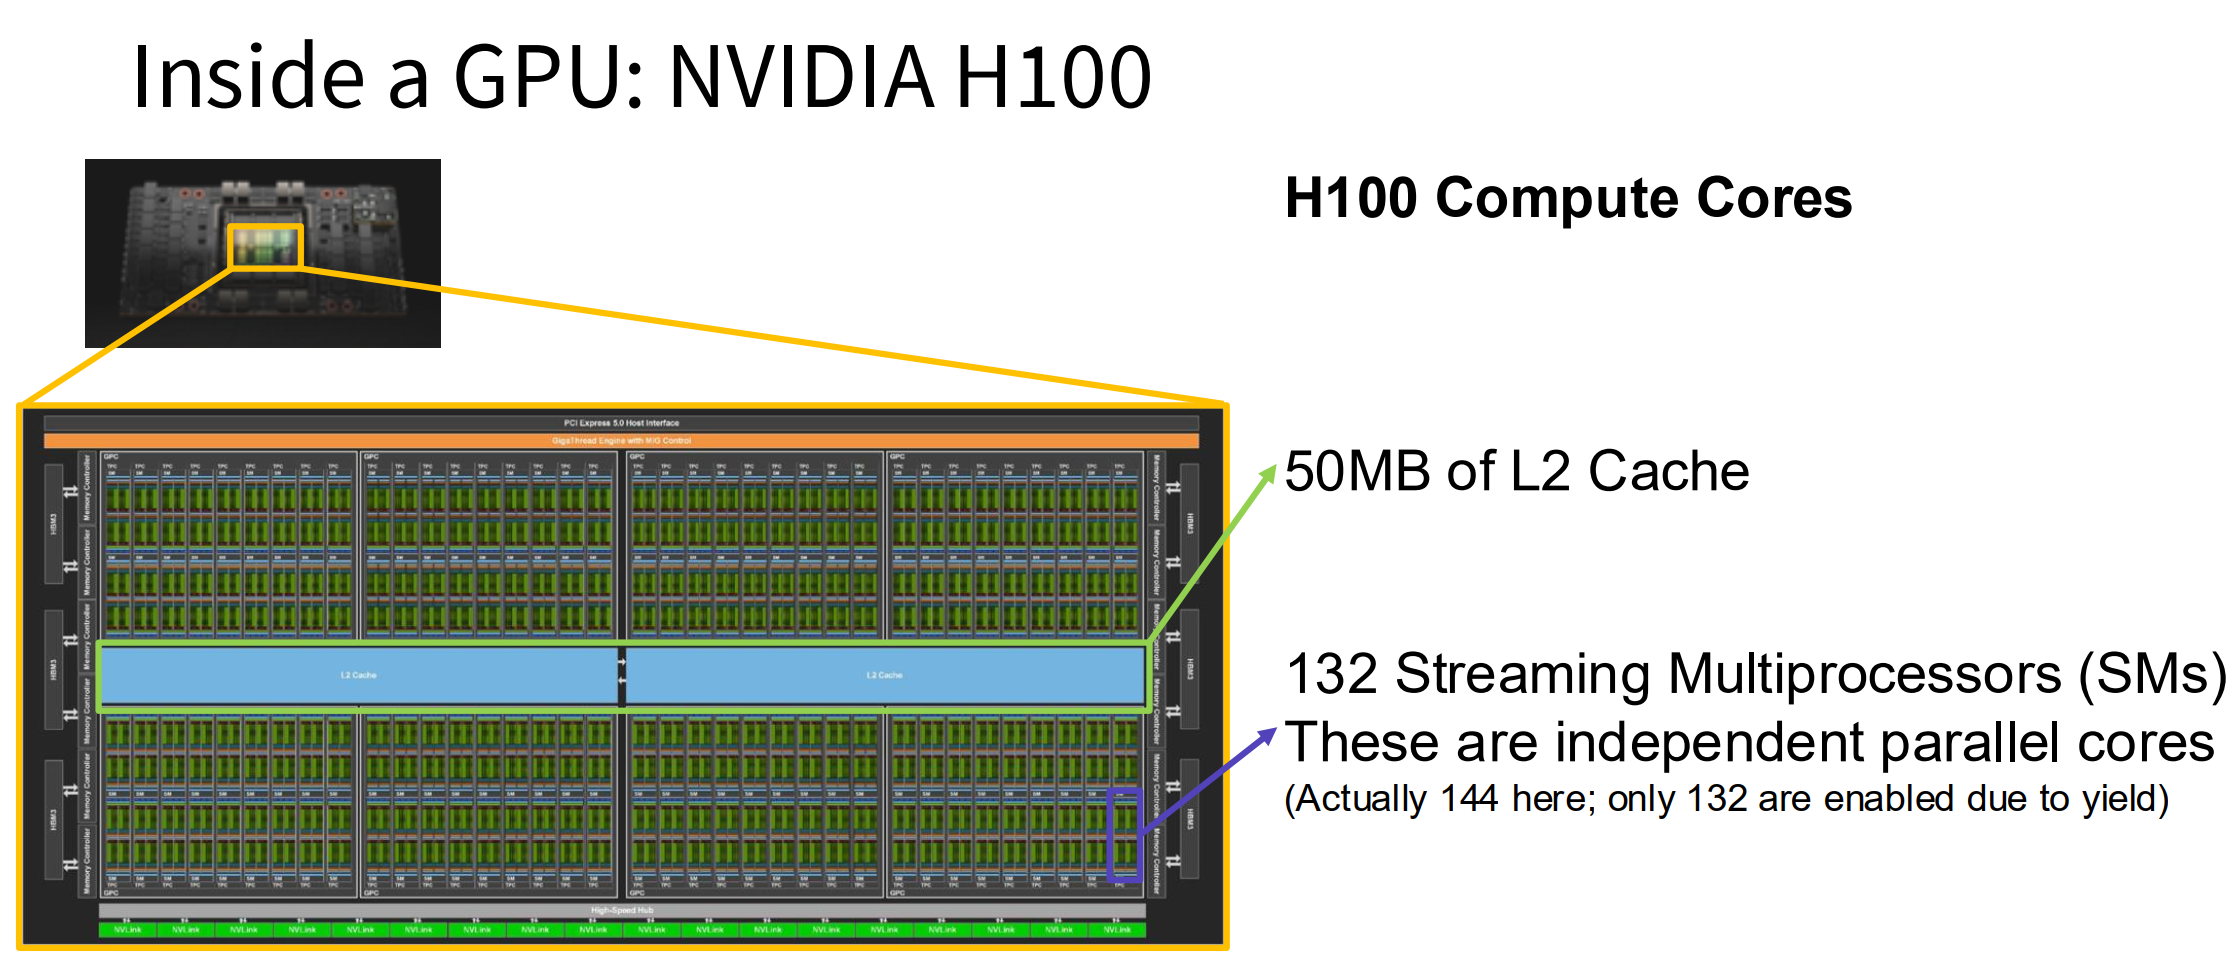
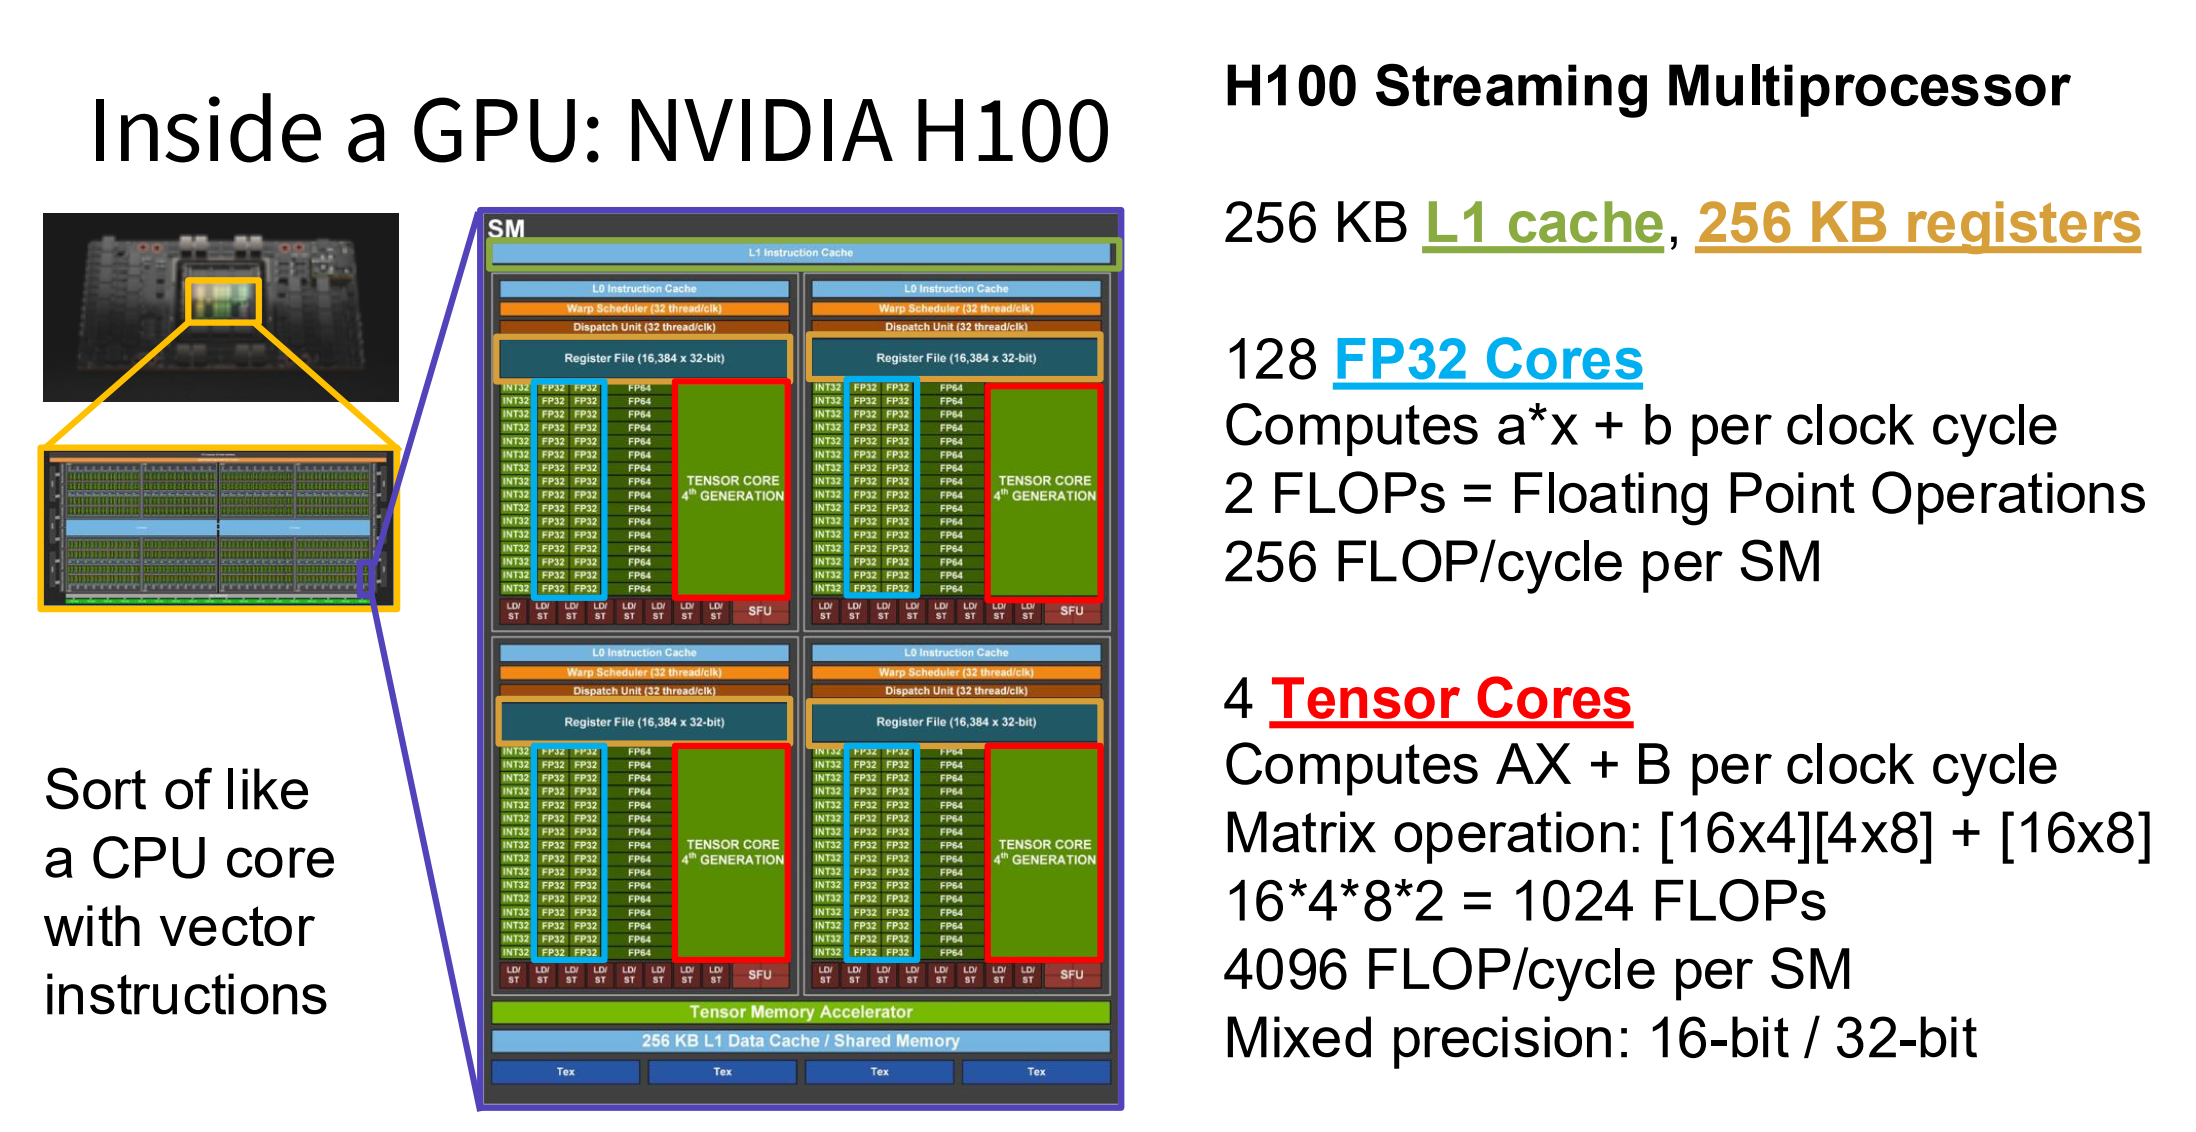
普通 FP32 Core 可以执行类似 \(a \times x + b\) 的标量/向量浮点运算;Tensor Core 则直接执行小块矩阵乘加,例如 \(AX+B\)。因此,在现代深度学习训练中,大矩阵乘法能否充分喂饱 Tensor Core 是训练速度的关键。
2.2 FLOPs、Tensor Core 与混合精度
FLOP(Floating Point Operation)表示一次浮点操作。课件中提到,一个 FP32 Core 每个周期做乘加时可视为 2 FLOPs;而 Tensor Core 一次可以完成小矩阵乘加,例如:
\[ [16 \times 4][4 \times 8] + [16 \times 8] \]
这个矩阵乘加包含:
\[ 16 \times 4 \times 8 \times 2 = 1024 \]
次浮点操作。由于每个 SM 有多个 Tensor Core,H100 在 16-bit 矩阵乘法上的理论吞吐可以远高于普通 FP32 运算。
这也解释了为什么大模型训练通常使用混合精度(Mixed Precision):权重、激活或矩阵乘法使用 FP16/BF16 等 16-bit 数值来提高吞吐和降低显存占用,而某些累加、归一化或优化器状态可能保留更高精度以保证稳定性。
2.3 GPU 性能增长与集群规模
课件展示了 GPU 从 K40、P100、V100、A100 到 H100、B200 的计算能力增长。相比 2013 年左右的 K40,现代 Tensor Core GPU 的理论吞吐提升可达约 \(1000\times\)。但是单张 GPU 仍然不够训练今天最大的模型,因此还需要把很多 GPU 组织成集群。
以 Llama3 集群为例,课件给出了一种层级结构:
| 层级 | 规模 | 通信特点 |
|---|---|---|
| 单张 H100 GPU | 80GB 显存,内部带宽约 \(3352 \text{ GB/s}\) | GPU 内部最快 |
| 单台服务器 | 8 张 GPU | GPU 间带宽约 \(900 \text{ GB/s}\) |
| 一个 Rack | 2 台服务器,16 张 GPU | 机架内通信较快 |
| 一个 Pod | 192 个 Rack,3072 张 GPU | GPU 间约 \(50 \text{ GB/s}\) |
| 一个 Cluster | 8 个 Pod,24576 张 GPU | 跨 Pod 通信更慢 |
这个层级非常重要:分布式训练不仅要看 GPU 数量,还要看 GPU 之间的通信拓扑。 同一台服务器内的 GPU 通信很快,跨机架、跨 Pod 的通信慢得多。因此后面设计并行策略时,通常会把通信最频繁的维度放在同机或同 Pod 内,把通信较少的维度放到更远的网络层级上。
2.4 其他训练芯片
除了 NVIDIA GPU,课件还提到:
| 芯片 | 特点 |
|---|---|
| Google TPU v5p | Google 设计的训练加速芯片,单芯片约 459 TFLOP/s BF16、95GB 内存,可组成 8960 芯片的 pod |
| AMD MI325X | 约 1300 TFLOP/s BF16、256GB 内存 |
| AWS Trainium2 | 约 667 TFLOP/s BF16、96GB 内存,可在 UltraServer 中打包 64 个芯片 |
这些硬件的共同目标都是提高矩阵计算吞吐、显存容量和集群扩展能力。
3 多 GPU 训练的基本切分维度
一个有 \(L\) 层的模型通常在形状为:
\[ (\text{Batch}, \text{Sequence}, \text{Dim}) \]
的张量上工作。要把模型训练拆到多张 GPU 上,可以沿不同维度切分:
| 并行方式 | 切分维度 | 核心思想 |
|---|---|---|
| 数据并行(Data Parallelism, DP) | Batch 维度 | 每张 GPU 处理不同样本,最后同步梯度 |
| 上下文并行(Context Parallelism, CP) | Sequence 维度 | 多张 GPU 共同处理一个超长序列 |
| 流水线并行(Pipeline Parallelism, PP) | Layer 维度 | 不同 GPU 负责不同层 |
| 张量并行(Tensor Parallelism, TP) | Dim 维度 | 把线性层权重和矩阵乘法按块切开 |
这四种方法不是互斥的。最大模型训练时往往会把它们组合起来,形成多维并行。
4 数据并行、FSDP 与 HSDP
4.1 普通数据并行
数据并行是最容易理解的多 GPU 训练方式。假设原本一个 minibatch 有 \(N\) 个样本,现在有 \(M\) 张 GPU,则可以使用 \(MN\) 个样本的大 batch,把每 \(N\) 个样本分给一张 GPU。
损失函数可以写成:
\[ L = \frac{1}{MN}\sum_{i=1}^{M}\sum_{j=1}^{N}\ell(x_{i,j}, W) \]
由于梯度对样本求和是线性的,总梯度可以写成每张 GPU 局部梯度的平均:
\[ \frac{\partial L}{\partial W} = \frac{1}{M}\sum_{i=1}^{M} \frac{1}{N}\sum_{j=1}^{N} \frac{\partial}{\partial W}\ell(x_{i,j}, W) \]
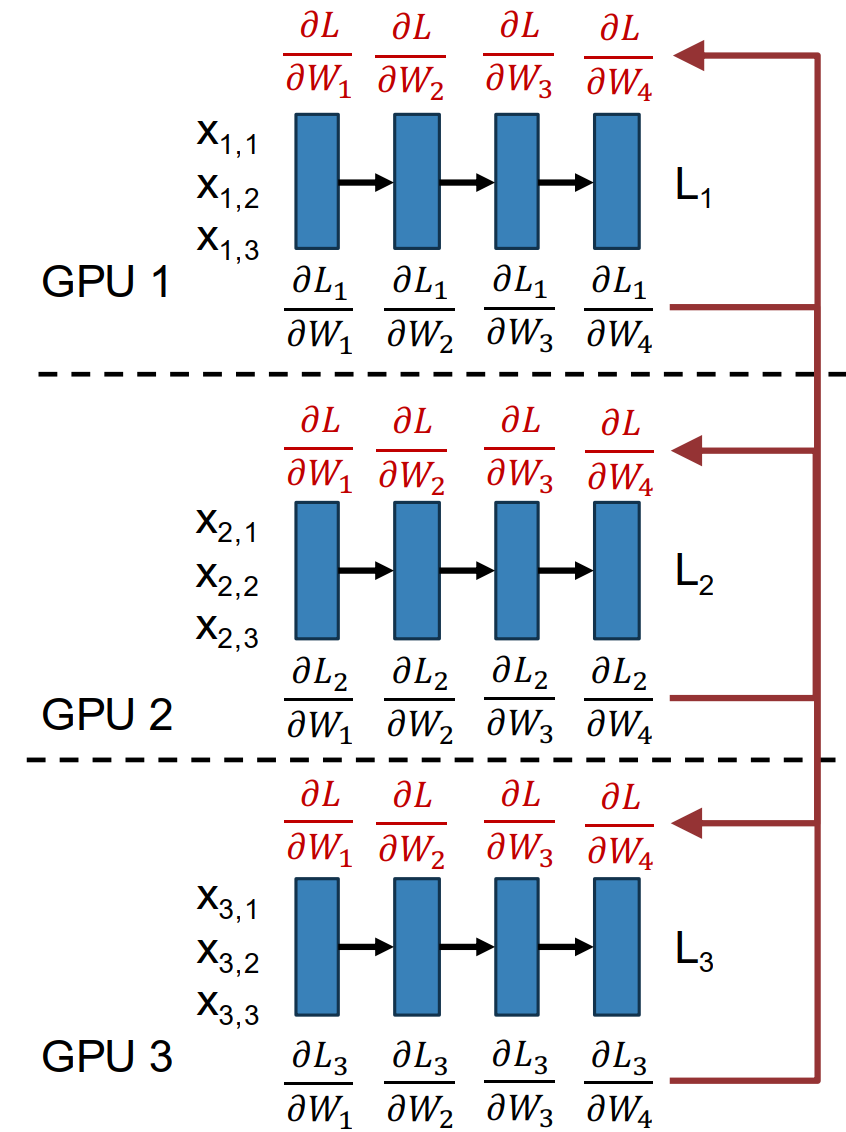
一次普通 DP 训练迭代通常是:
- 每张 GPU 保存一份完整模型和优化器状态。
- 每张 GPU 读取自己的局部 batch。
- 每张 GPU 独立前向传播,得到局部 loss。
- 每张 GPU 独立反向传播,得到局部梯度。
- 所有 GPU 对梯度求平均,常用 all-reduce 完成。(可与第4步并行)
- 每张 GPU 用相同平均梯度更新自己的模型副本。
DP 的优点是简单、吞吐提升明显,而且反向传播和梯度通信可以部分重叠。但它有一个致命限制:每张 GPU 都要放下一整份模型、梯度和优化器状态。
4.2 普通 DP 的显存瓶颈
使用 Adam 优化器时,每个参数通常至少需要保存 4 类数值:
| 数值 | 作用 |
|---|---|
| 参数 \(W\) | 当前模型权重 |
| 梯度 \(\nabla W\) | 本轮反向传播得到的梯度 |
| Adam 一阶矩 \(\beta_1\) 状态 | 估计梯度均值 |
| Adam 二阶矩 \(\beta_2\) 状态 | 估计梯度平方均值 |
如果每个数用 2 字节,那么 1B 参数约需要:
\[ 1\text{B} \times 4 \times 2 \text{ bytes} = 8 \text{GB} \]
因此 10B 参数就会占满一张 80GB GPU 的大部分显存,更不用说激活值、临时 buffer 和通信缓存。普通 DP 只能扩 batch,不能解决“模型本身放不下”的问题。
4.3 Fully Sharded Data Parallelism(FSDP)
FSDP(Fully Sharded Data Parallelism)思想来自 ZeRO 系列优化:把模型权重、梯度和优化器状态切分到多张 GPU 上,而不是每张 GPU 都保存完整副本。
FSDP 的基本机制如下:
- 每个权重块 \(W_i\) 只由某一张 GPU 或某一组 GPU 拥有,同时该 GPU 保存对应的梯度和优化器状态。
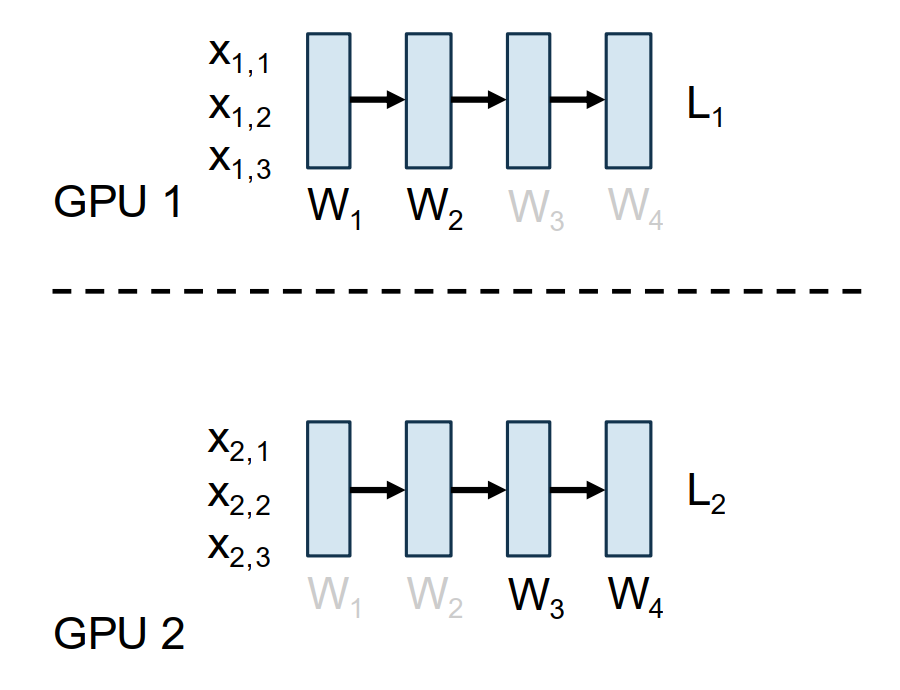
- 在某层前向传播前,拥有 \(W_i\) 的 GPU 把该层权重广播给其他 GPU。
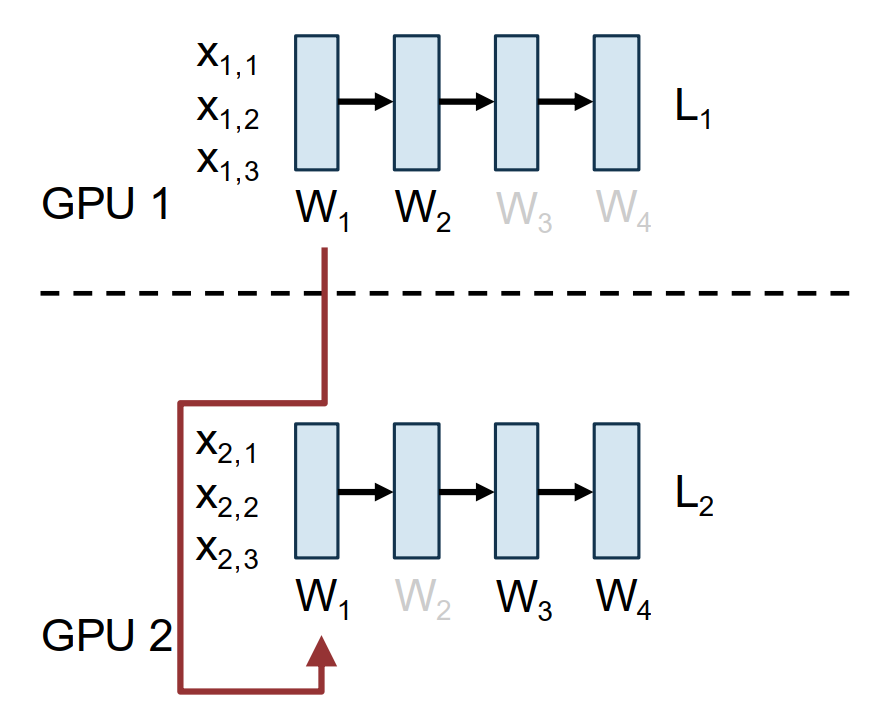
所有 GPU 使用 \(W_i\) 计算该层前向传播,算完后删除临时权重副本。
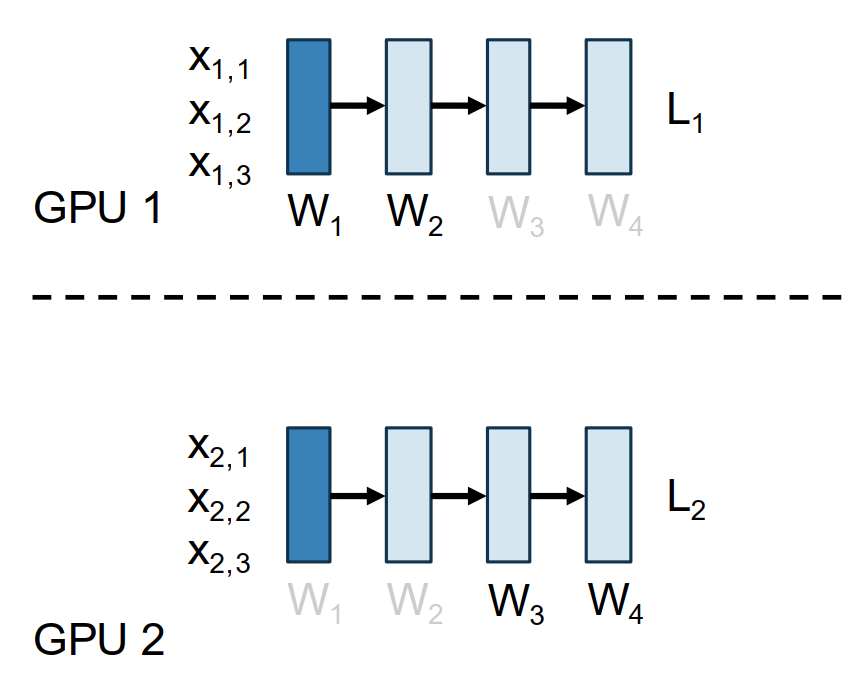
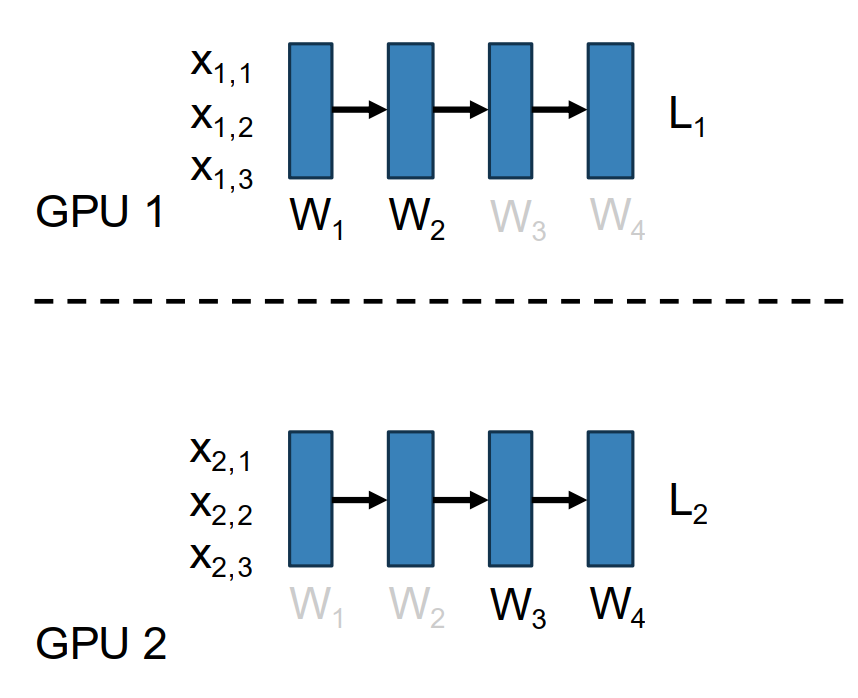
在反向传播到该层前,再次广播所需权重。
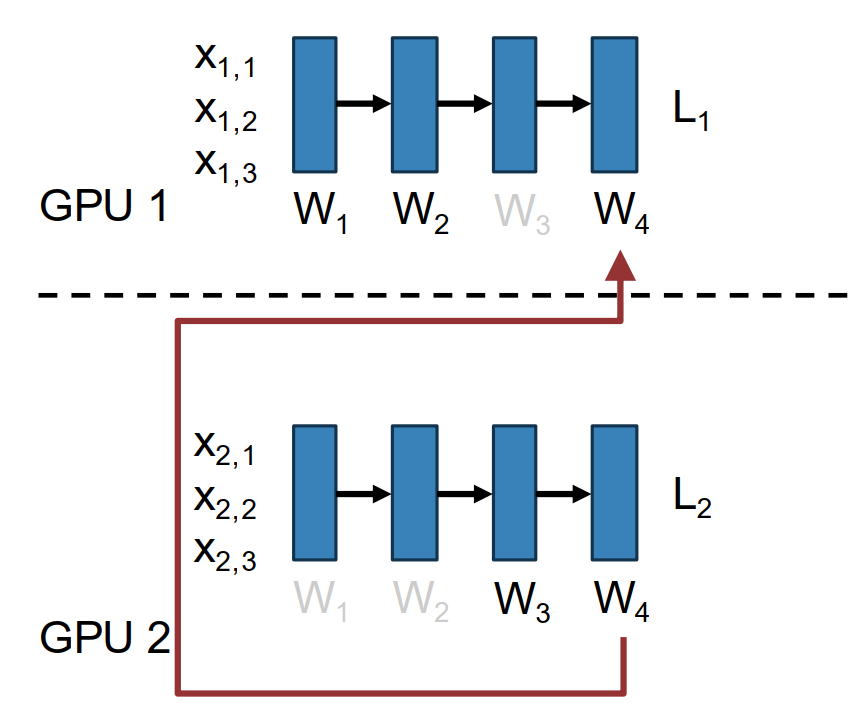
每张 GPU 计算自己局部 batch 对该层权重的局部梯度。
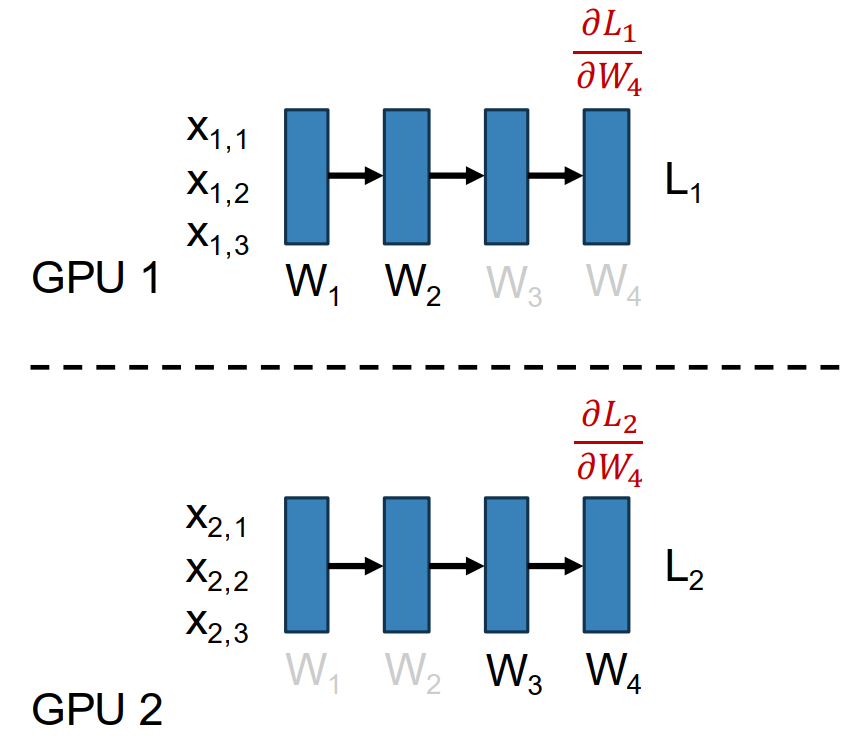
局部梯度被发送回拥有该权重的 GPU,由拥有者汇总并更新参数。
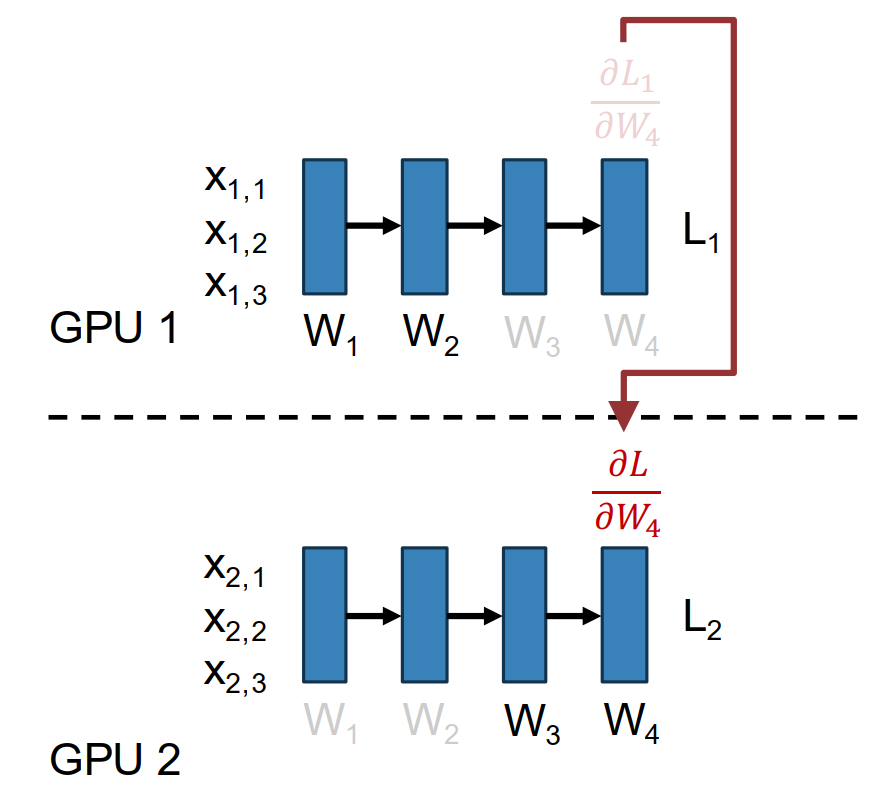
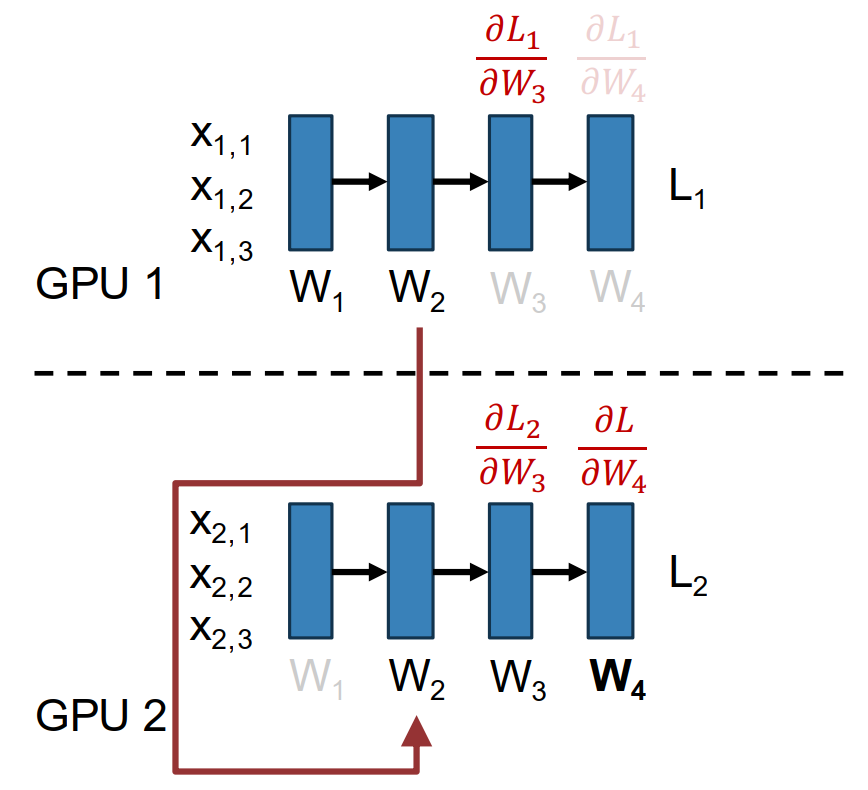
FSDP 的关键是显存从“每张 GPU 保存全模型”变成“每张 GPU 保存模型的一部分”。例如 100B 参数若每个参数需要 4 个 2 字节数值,总共约 800GB;如果分到 80 张 GPU 上,每张 GPU 只需要约 10GB 来保存这些状态。
代价是通信增加。FSDP 在前向和反向中都要不断取回当前层权重,并在反向后汇总梯度。实际系统会做预取和重叠,例如在计算 \(W_i\) 对应层的同时预取 \(W_{i+1}\),在反向计算 \(W_i\) 时同时发送上一层梯度并更新参数。这样可以把一部分通信隐藏在计算之后。
4.4 Hybrid Sharded Data Parallel(HSDP)
当 GPU 数量继续变大时,完全在所有 GPU 上做 FSDP 可能导致通信范围过大。HSDP(Hybrid Sharded Data Parallel) 把 \(N=M\times K\) 张 GPU 分成 \(M\) 个组,每组 \(K\) 张 GPU:
- 组内做 FSDP:模型状态在 \(K\) 张 GPU 之间切分。
- 组间做 DP:不同组处理不同数据,最后同步组间梯度。
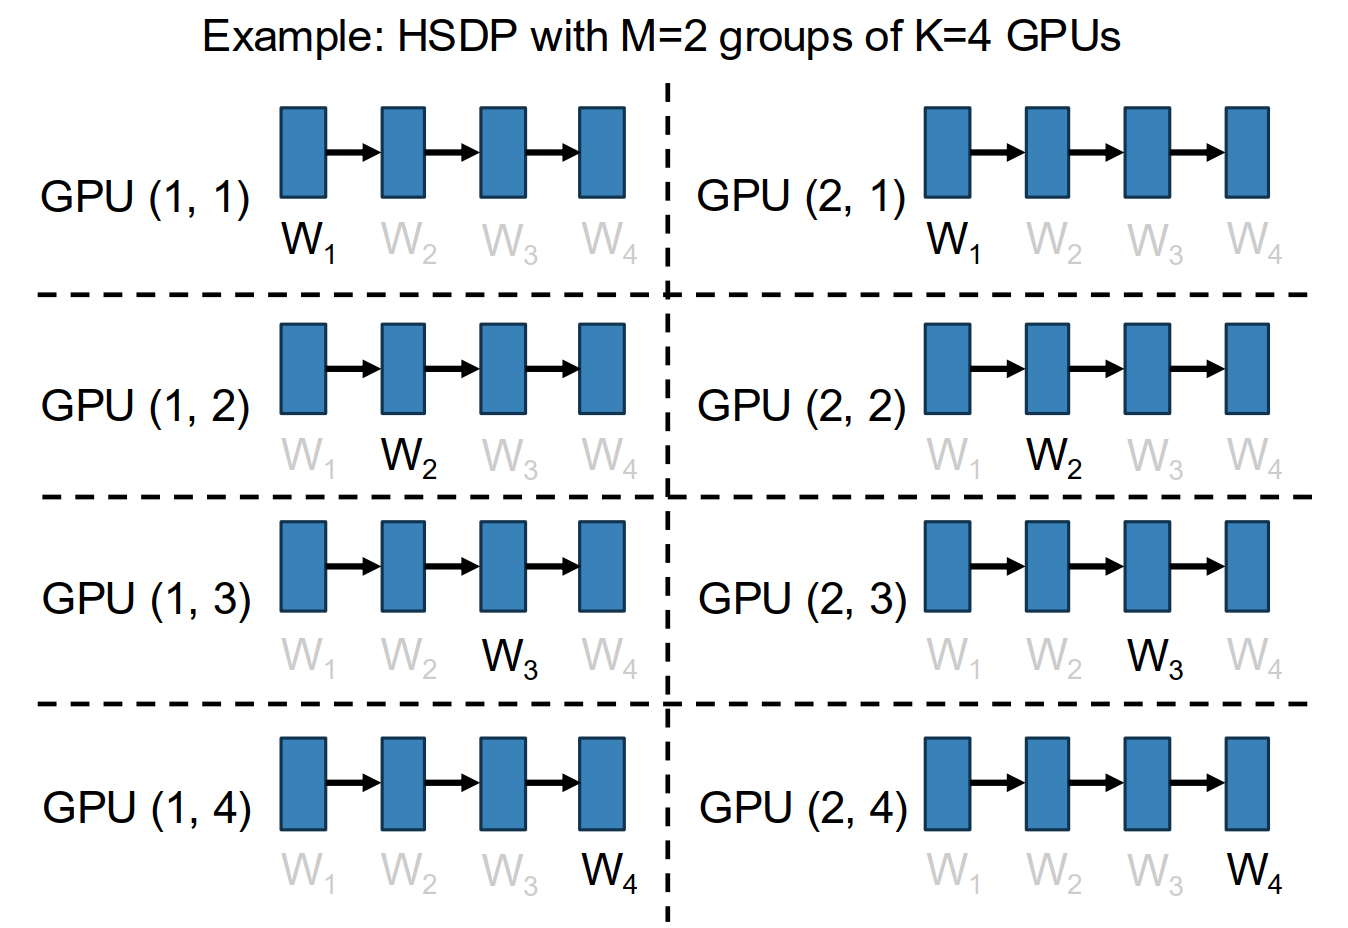
这是一种二维并行:一个维度负责模型切分,另一个维度负责数据切分。课件强调通信层级:
| 通信位置 | 通信内容 | 设计建议 |
|---|---|---|
| FSDP 组内 | 前向取 \(W\),反向取 \(W\) 和传 \(\nabla W\),约 3 倍通信 | 放在同节点或同 Pod 等高速网络内 |
| DP 组间 | 主要同步 \(\nabla W\),约 1 倍通信 | 可以跨更慢的网络层级 |
因此 HSDP 的意义不只是省显存,也是在匹配硬件拓扑:高频通信放近,低频通信放远。
5 Activation Checkpointing:用计算换显存
5.1 为什么激活值也会撑爆显存
即使 FSDP 解决了参数和优化器状态的显存问题,训练时还必须保存激活值。反向传播需要用前向传播中的中间激活来计算梯度。
课件给出 Llama3-405B 的例子:Transformer 有 126 层,隐藏维度 \(D=16384\),序列长度为 4096。仅 FFN hidden activations 就可能需要:
\[ 2 \times 126 \times (4 \times 16384) \times 4096 \text{ bytes} \approx 63 \text{GB} \]
这还没有包括注意力、残差、归一化等其他激活。因此,仅靠切分参数还不够,还要处理激活显存。
5.2 常规反向传播的复杂度
设第 \(i\) 层前向函数为:
\[ A_{i+1}=F_i^{\rightarrow}(A_i) \]
反向函数为:
\[ G_i=F_i^{\leftarrow}(A_i, G_{i+1}) \]
其中 \(A_i\) 是第 \(i\) 层激活,\(G_i\) 是对该激活的梯度。普通训练会在前向时保存每一层激活,反向时直接使用它们。
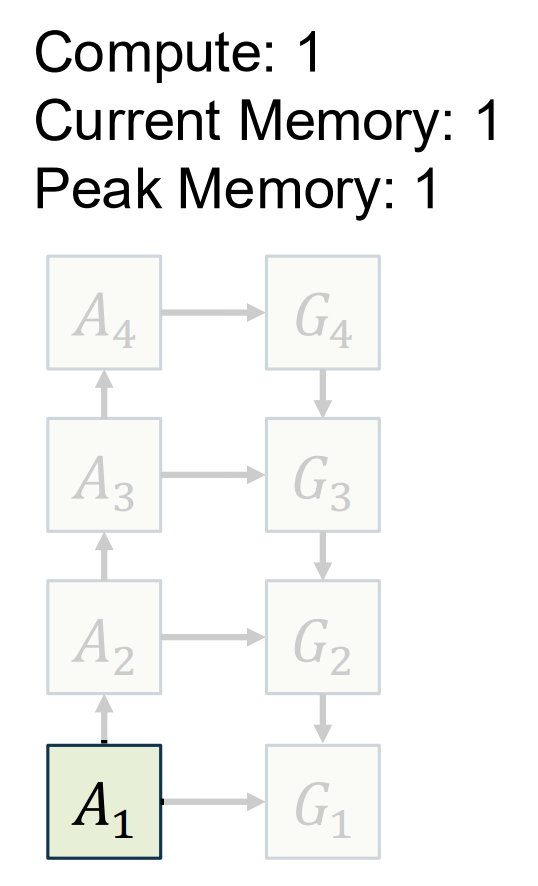
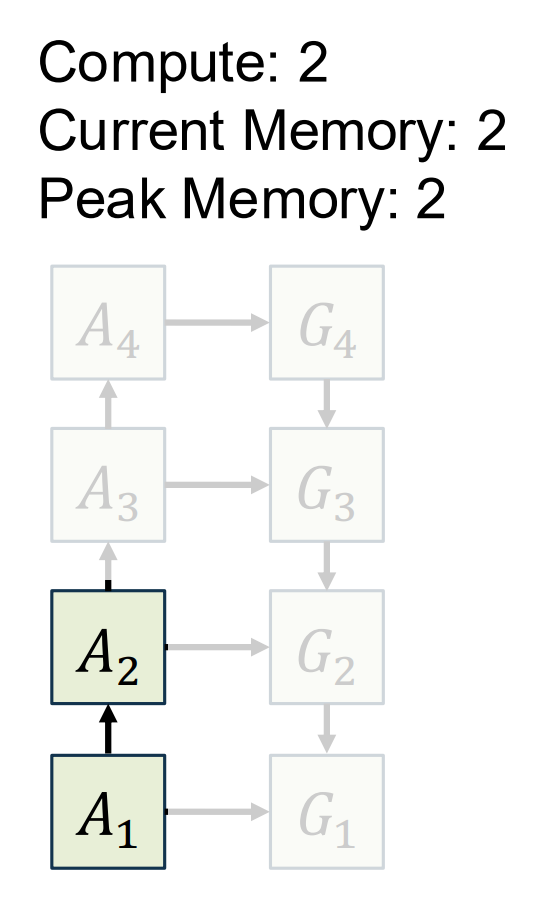
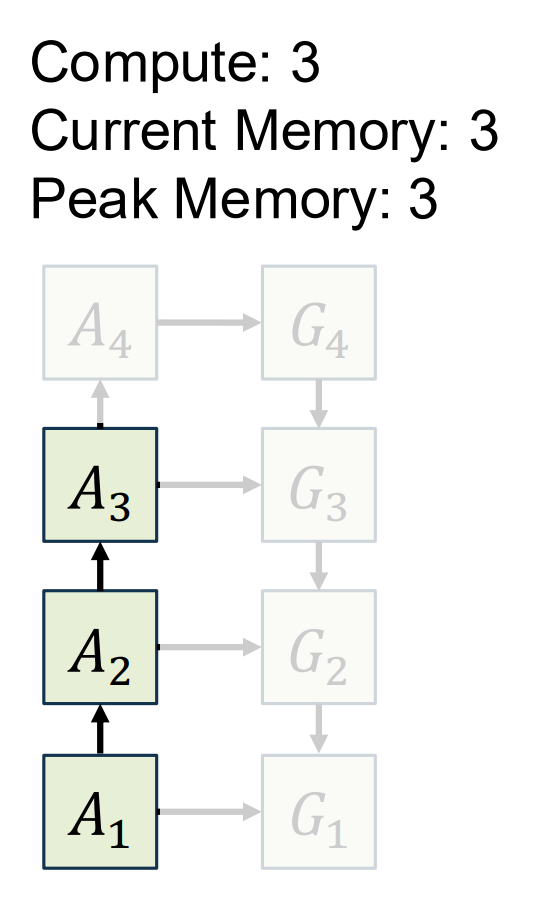
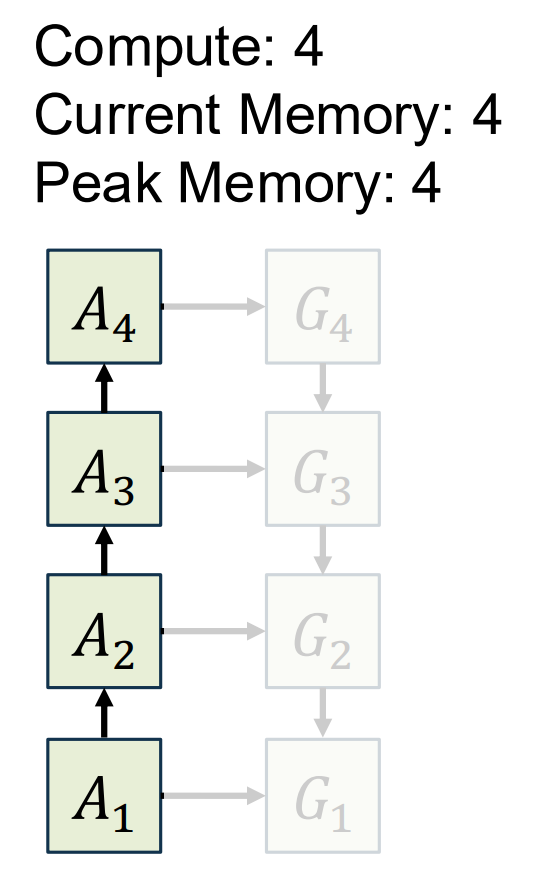
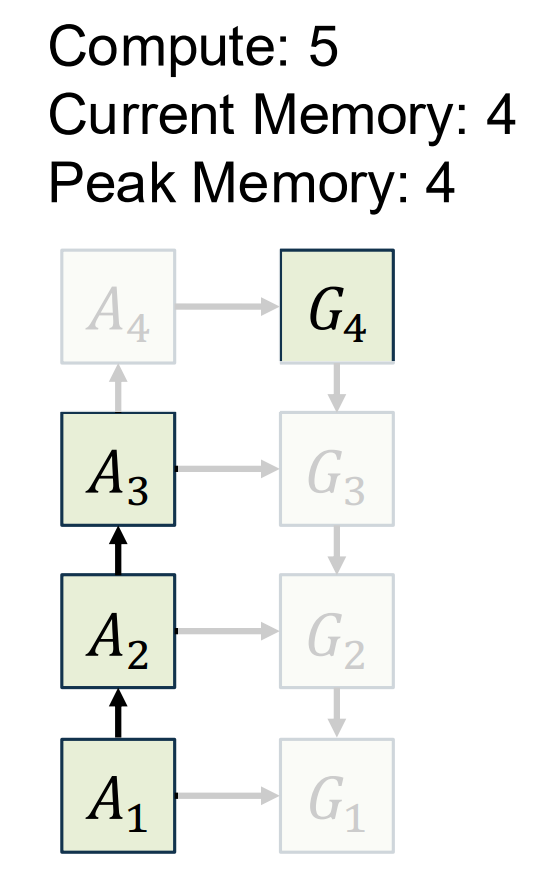
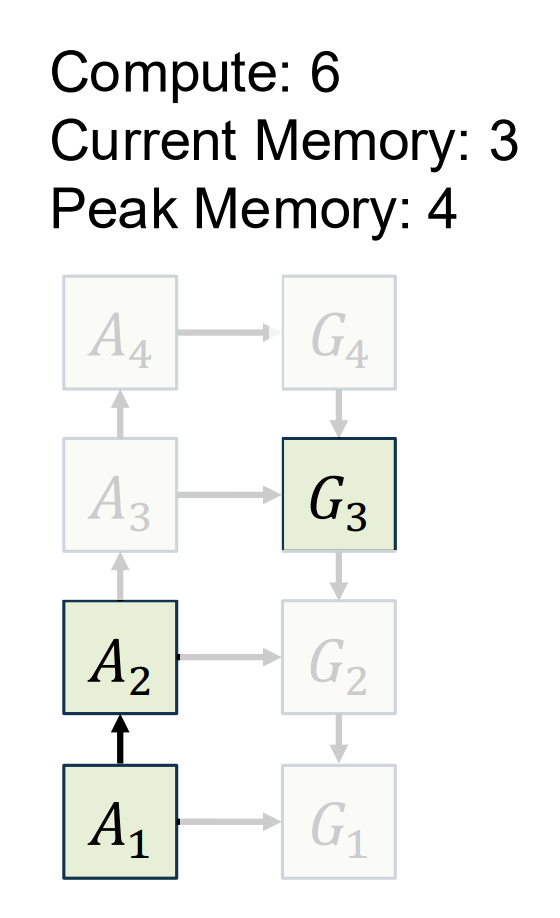
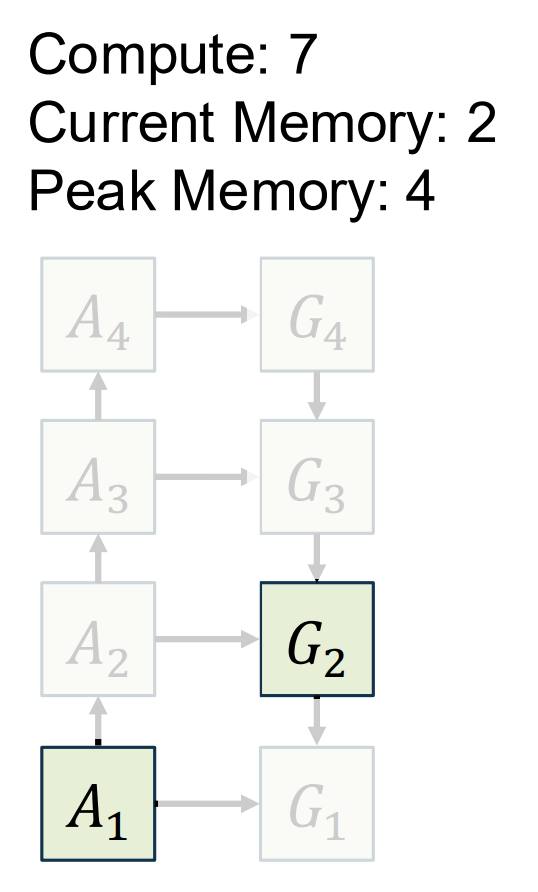
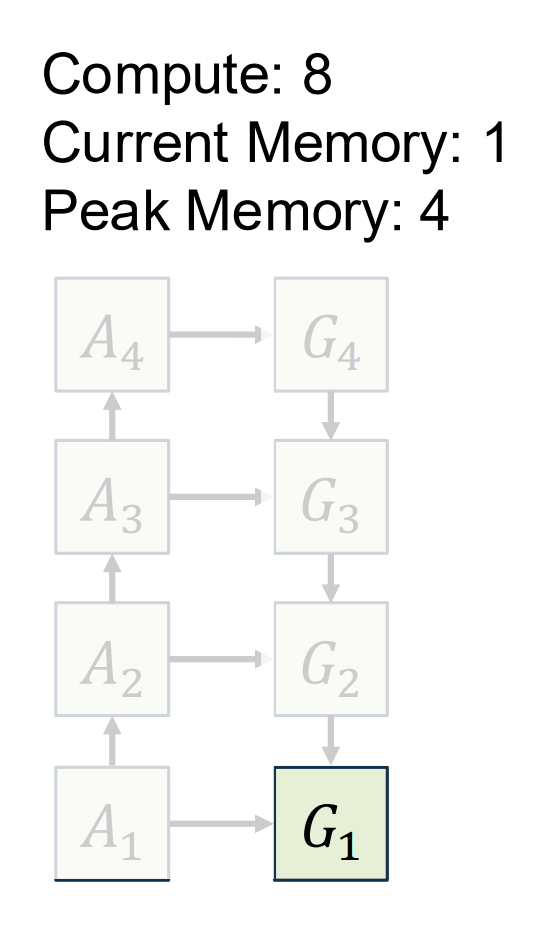
如果每一层前向和反向都看作 \(O(1)\) 计算和内存,则 \(N\) 层网络的普通前向加反向复杂度是:
| 方法 | 计算复杂度 | 激活内存复杂度 |
|---|---|---|
| 保存所有激活 | \(O(N)\) | \(O(N)\) |
它计算最省,但内存随层数线性增长。
5.3 完全重计算
Activation Checkpointing 的核心思想是:前向时不保存所有激活,反向需要某个激活时再从最近的已知激活重新算出来。
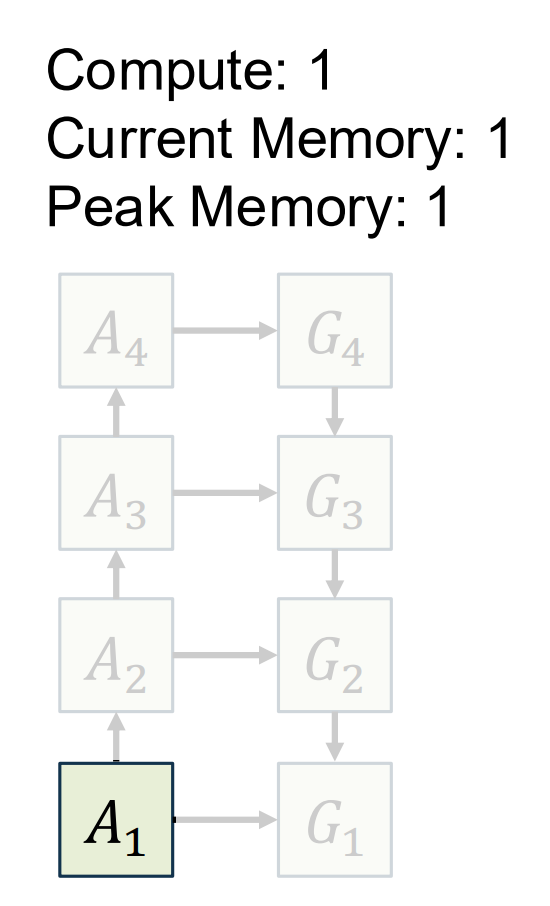
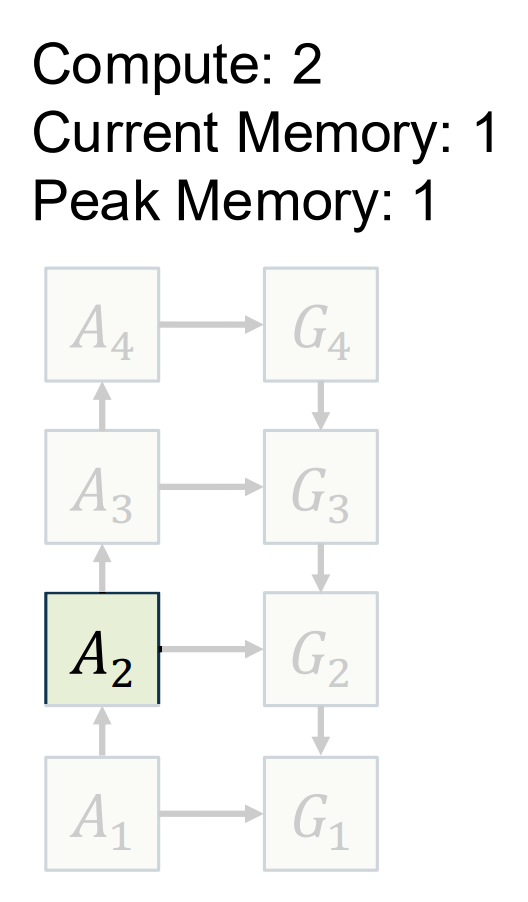
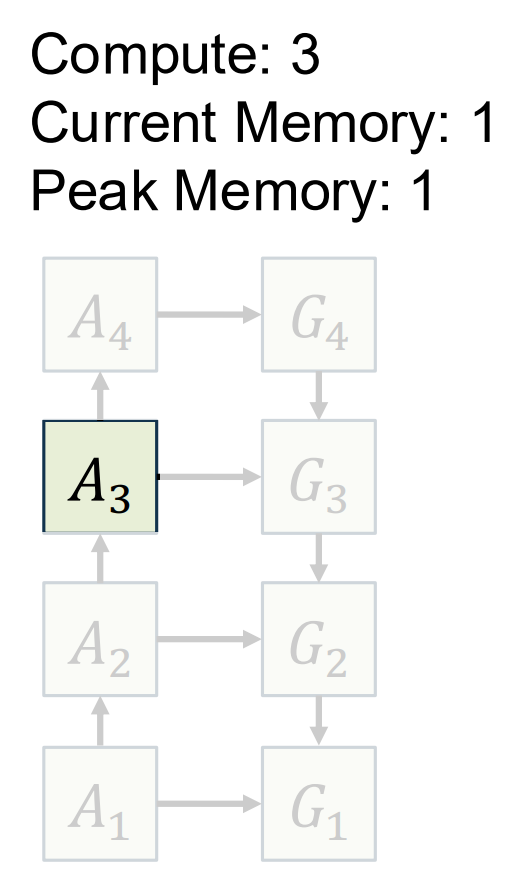
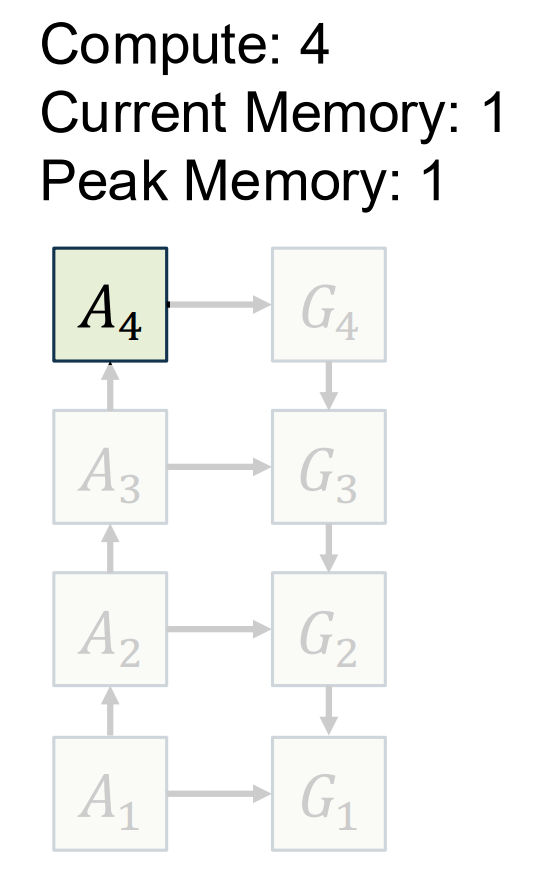
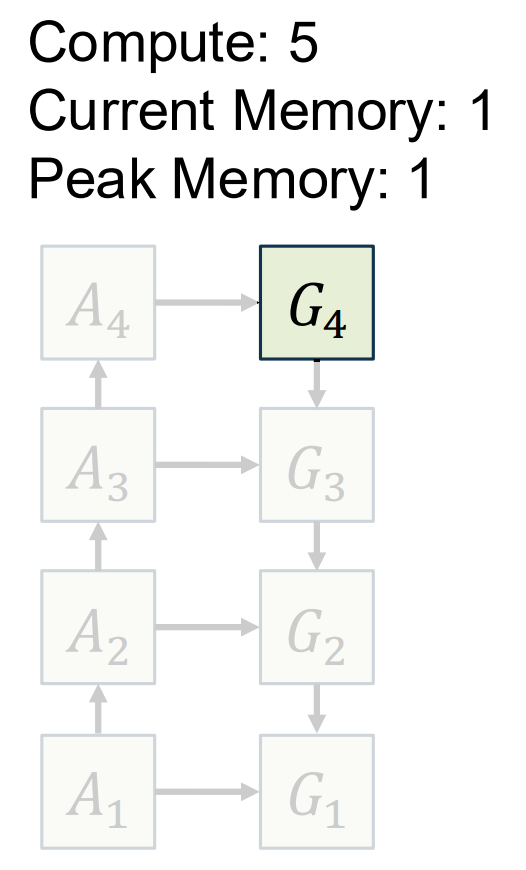
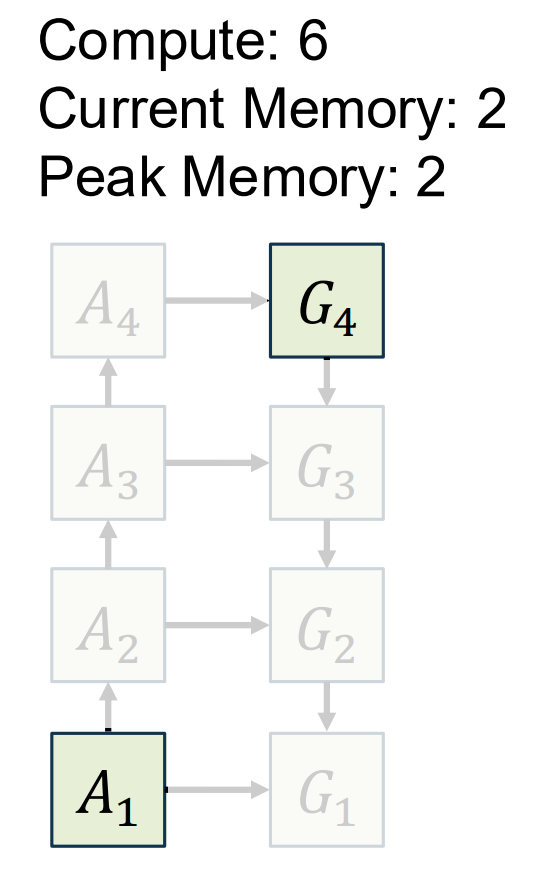
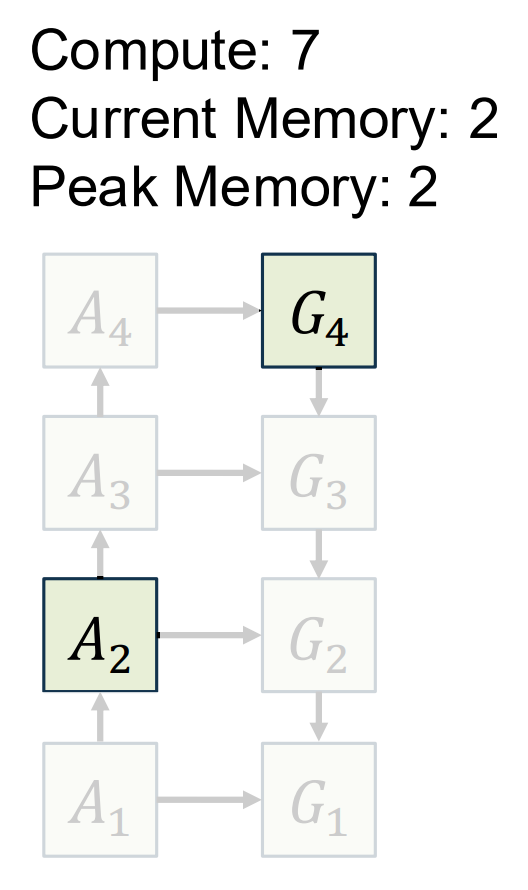
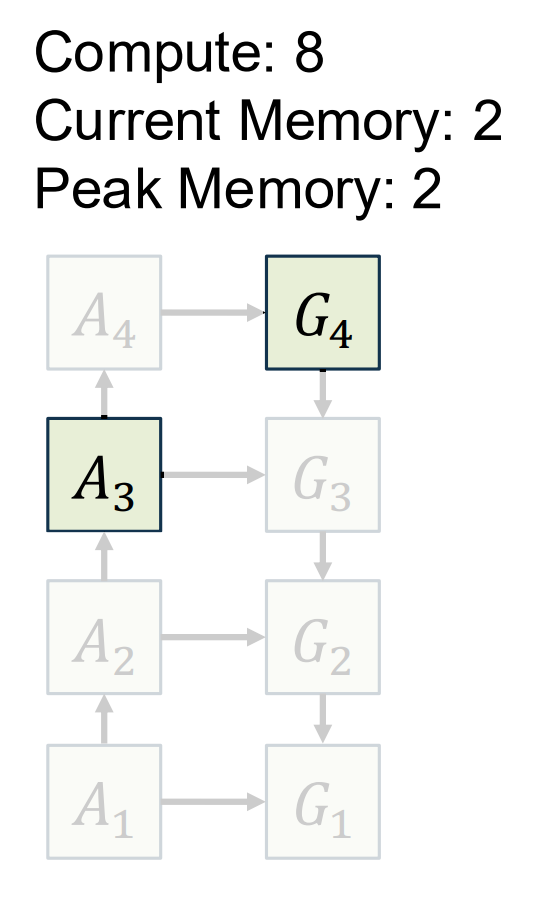
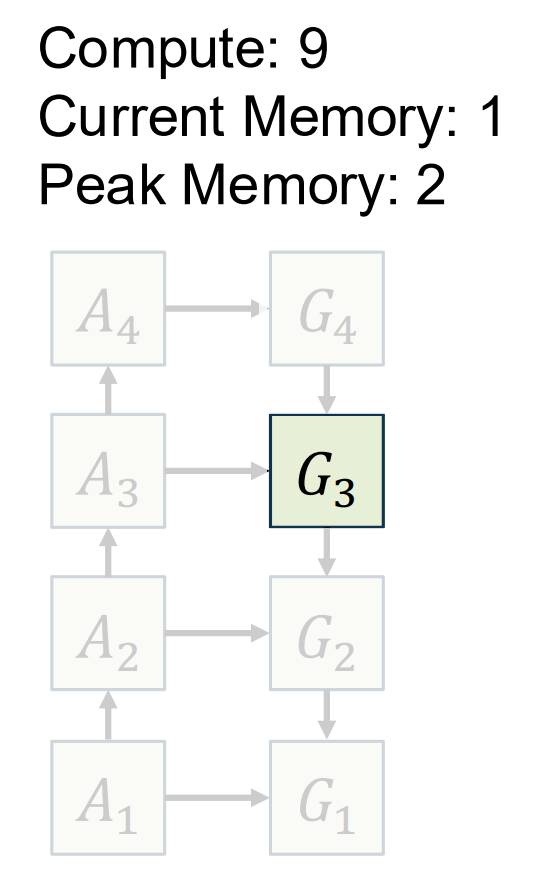
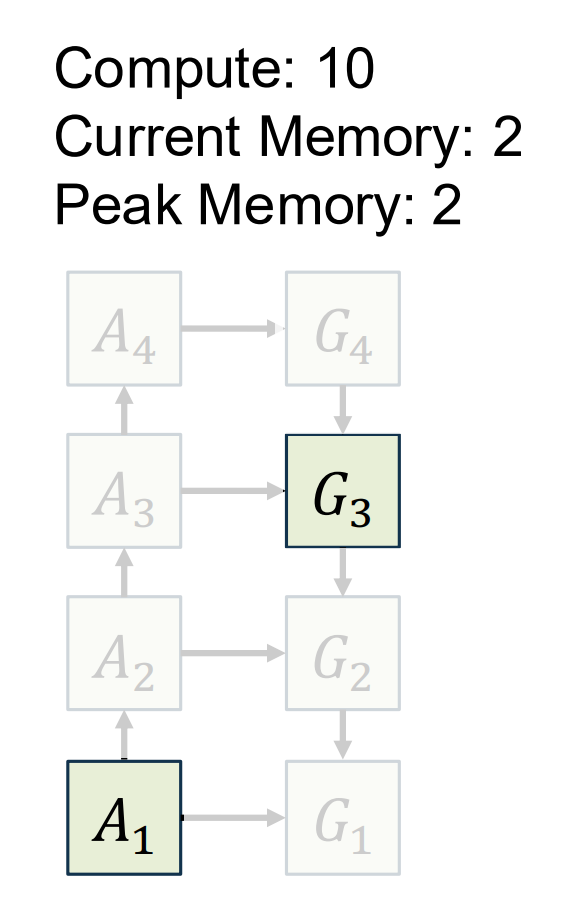
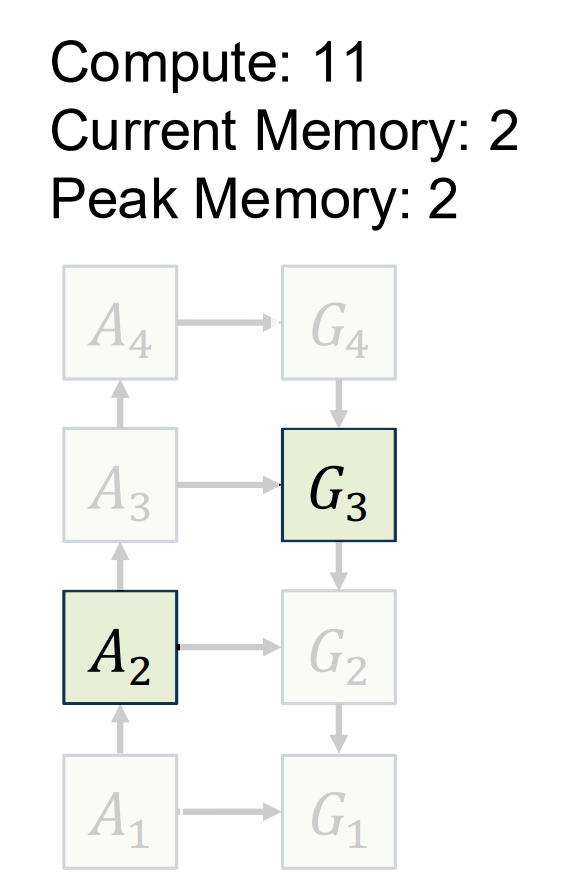
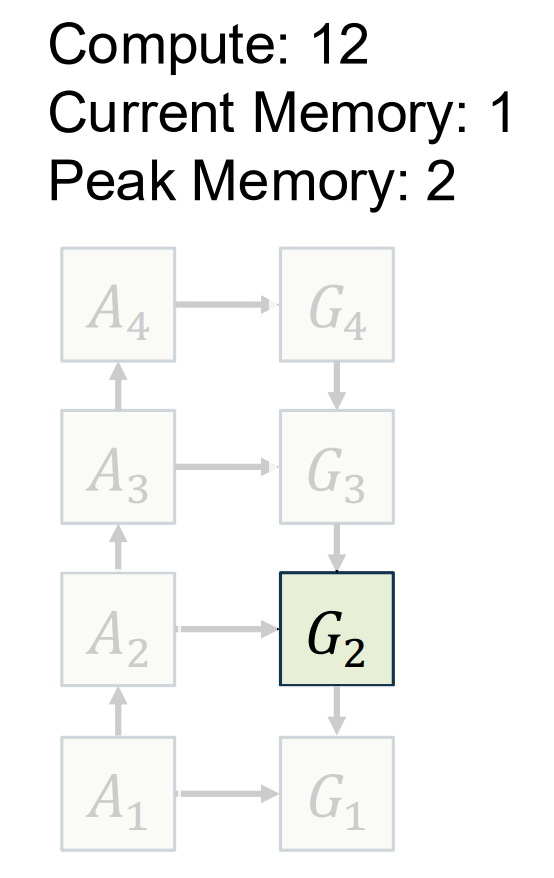
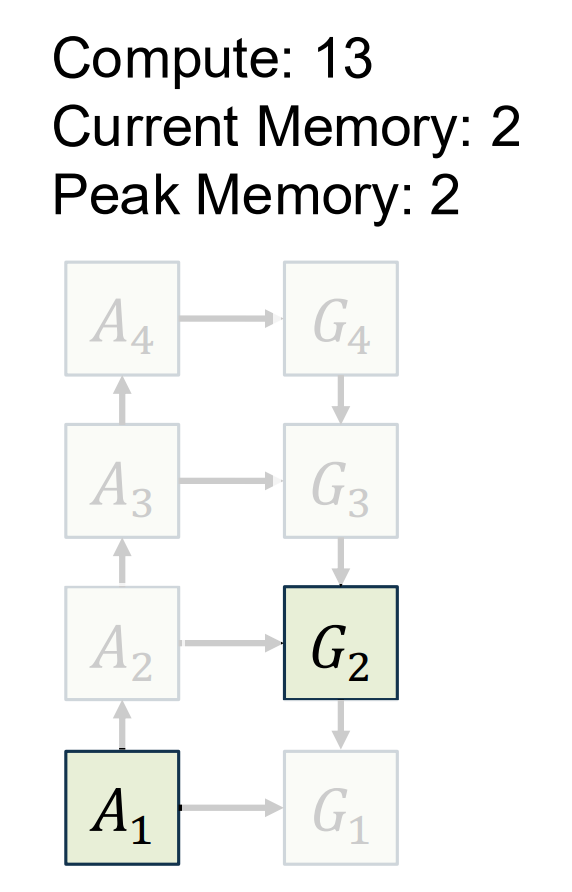
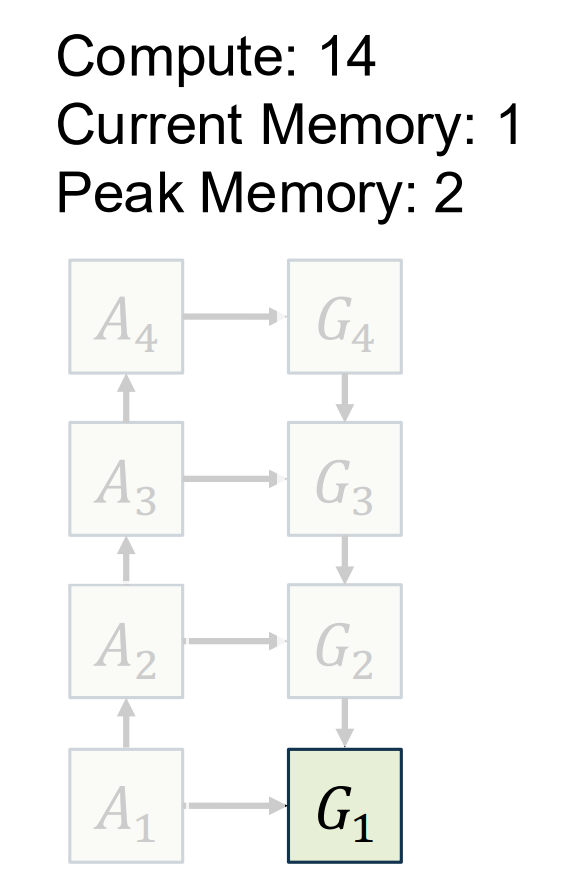
最极端的做法是只保存输入,其他激活都不保存。这样内存可以降到 \(O(1)\),但反向时每到一层都可能需要从头重新前向计算一遍,导致计算复杂度变成 \(O(N^2)\):
| 方法 | 计算复杂度 | 激活内存复杂度 |
|---|---|---|
| 完全重计算 | \(O(N^2)\) | \(O(1)\) |
这在大模型里通常太慢,因为 \(N^2\) 级别的重算会浪费大量 GPU 时间。
5.4 每隔 C 层保存 checkpoint
更实用的方法是在前向传播中每隔 \(C\) 层保存一个 checkpoint。反向传播时,如果需要某个中间层激活,就从最近的 checkpoint 重新算到目标层。
课件给出的近似复杂度是:
| 方法 | 计算复杂度 | 激活内存复杂度 |
|---|---|---|
| 保存所有激活 | \(O(N)\) | \(O(N)\) |
| 完全重计算 | \(O(N^2)\) | \(O(1)\) |
| 保存 \(C\) 个 checkpoint | \(O(N^2/C)\) | \(O(C)\) |
| 保存 \(\sqrt{N}\) 个 checkpoint | \(O(N\sqrt{N})\) | \(O(\sqrt{N})\) |
直观上,checkpointing 是一个典型的工程 trade-off:牺牲一些额外计算,换取显存下降,从而允许更大模型、更长序列或更大 batch。
5.5 一个实用扩展配方
课件给出了一套逐步扩展训练规模的经验配方:
- 先使用数据并行扩展到约 128 张 GPU,适合约 1B 参数模型。
- 每张 GPU 的 batch size 尽量设到能吃满显存。
- 如果模型超过 1B 参数,考虑 FSDP。
- 加入 activation checkpointing,以容纳更大 batch 或更长序列。
- 如果超过 256 张 GPU,考虑 HSDP。
- 如果超过 1000 张 GPU、模型超过 50B 参数,或序列长度超过 16K,再考虑 CP、PP、TP 等更复杂策略。
这个配方的精神是:先用简单并行获得收益,再在明确遇到显存、序列长度或通信瓶颈时增加复杂并行维度。
6 HFU 与 MFU:如何评价训练效率
6.1 HFU:硬件 FLOPs 利用率
HFU(Hardware FLOPs Utilization) 衡量实际执行吞吐占硬件理论峰值的比例。以 H100 为例,它在 16-bit Tensor Core 矩阵乘法上的理论峰值约为:
\[ 989.4 \text{ TFLOP/s} \]
如果只跑大矩阵乘法这样的最佳场景,H100 可以达到较高 HFU,课件中大矩阵乘法约能达到 80% HFU。
但 HFU 有一个问题:它会把所有实际发生的计算都算进利用率,包括 activation checkpointing 的重计算、数据预处理、优化器更新等“辅助计算”。因此 HFU 高不一定说明模型训练本身高效。
6.2 MFU:模型 FLOPs 利用率
MFU(Model FLOPs Utilization) 更关心 GPU 理论峰值中有多少被用于“有用的模型计算”。计算步骤是:
- 估计一次 forward + backward 中模型矩阵乘法的理论 FLOPs,记为 \(\text{FLOP}_{\text{theoretical}}\)。通常可近似认为 backward FLOPs 约为 forward 的 2 倍。
- 查硬件理论峰值吞吐 \(\text{FLOP/s}_{\text{theoretical}}\),例如 H100 约 \(989 \text{ TFLOP/s}\)。
- 计算理论最短时间:
\[ t_{\text{theoretical}} = \frac{\text{FLOP}_{\text{theoretical}}} {\text{FLOP/s}_{\text{theoretical}}} \]
- 实测一次完整迭代时间 \(t_{\text{actual}}\),包括数据加载、前向、反向和优化器更新。
- 计算:
\[ \text{MFU} = \frac{t_{\text{theoretical}}}{t_{\text{actual}}} \]
MFU 体现的是:理论上做这些模型矩阵乘法需要这么久,实际一次训练迭代花了更久,那么二者比例就是模型计算利用率。
6.3 如何解读 MFU
课件给出经验标准:
| MFU | 解读 |
|---|---|
| \(>30\%\) | 已经不错 |
| \(>40\%\) | 非常优秀 |
MFU 会受到矩阵大小、通信开销、显存带宽、pipeline bubble、checkpoint 重算、数据加载等因素影响。课件还指出,新一代设备不一定 MFU 更高,因为峰值 FLOPs 增长可能快于显存带宽增长。例如从 A100 到 H100,FLOPs 约提升 \(3.1\times\),但显存带宽约提升 \(2.1\times\)。如果模型受到内存带宽或通信限制,理论峰值越高,反而越难“吃满”。
因此分布式训练调参的目标可以总结为:选择并行策略和 batch/序列/切分配置,使 MFU 尽可能高,同时满足显存约束。
7 Context Parallelism:沿序列维度切分
7.1 CP 的基本思想
Context Parallelism(CP) 通常用于 Transformer,尤其是长序列训练或长上下文微调。它沿 sequence 维度切分,让多张 GPU 共同处理同一个长序列。
如果序列长度 \(S\) 太长,单张 GPU 放不下注意力计算或激活,就可以把 token 分段放到不同 GPU 上。这样每张 GPU 只处理一部分序列,减轻单卡显存压力。
7.2 哪些模块容易序列并行
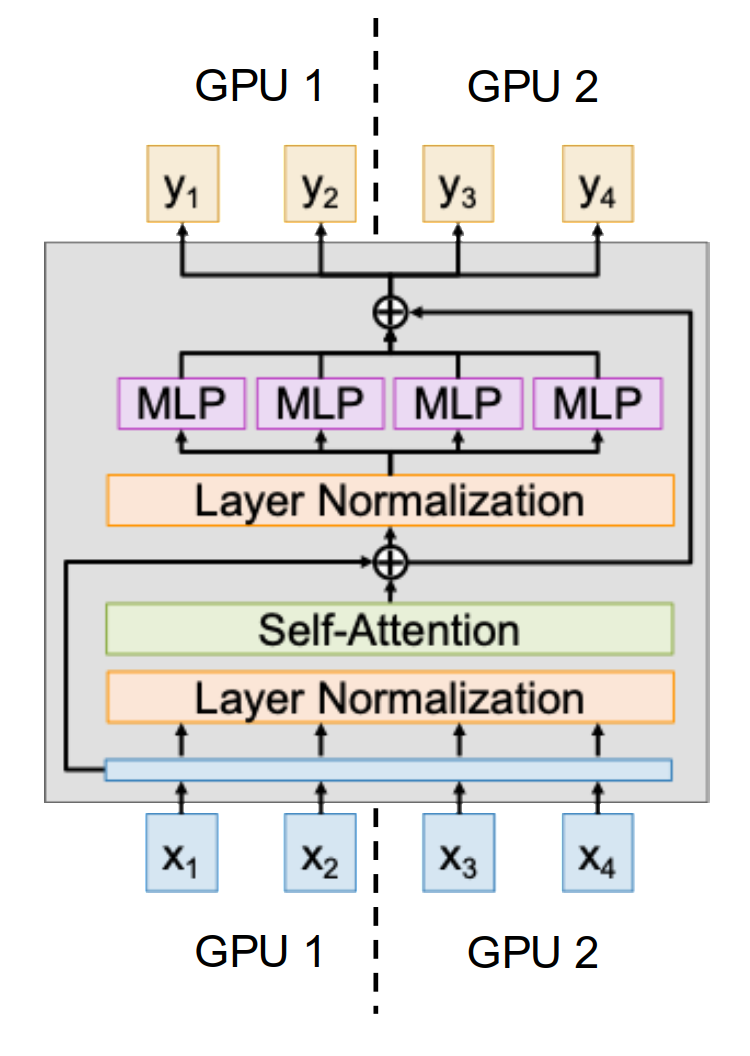
Transformer 中不同模块的 CP 难度不同:
| 模块 | 是否容易 CP | 原因 |
|---|---|---|
| LayerNorm / residual | 容易 | 没有权重或只做局部逐元素操作,各 token 可独立处理 |
| MLP | 相对容易 | 每个 token 的 MLP 可独立计算,但权重需要复制,梯度像 DP 一样同步 |
| QKV projection | 相对容易 | 本质也是对每个 token 做线性投影 |
| Attention operator | 最难 | 每个 query 可能需要看所有 key/value,天然跨序列位置通信 |
难点集中在注意力。自注意力需要构造 query-key 相似度,如果序列被分到多张 GPU 上,每张 GPU 上的 query 仍可能需要其他 GPU 上的 key/value。
7.3 Ring Attention 与 Ulysses
课件提到两种处理长序列注意力的方案:
| 方法 | 思路 | 优点 | 限制 |
|---|---|---|---|
| Ring Attention | 把序列分成 block 分布到 GPU 上,内层循环遍历 key/value,外层循环遍历 query,通过环形通信逐步完成注意力 | 可扩展到非常长的上下文 | 实现复杂,通信调度要求高 |
| Ulysses | 不直接分布完整注意力矩阵,而是按 multi-head attention 的 head 维度并行 | 相对简单 | 最大并行度受 attention head 数量限制 |
Llama3-405B 的例子中,Stage 1 使用 \(S=8192\),不使用 context parallelism;Stage 2 使用 \(S=131072\),采用 16-way context parallelism,相当于每张 GPU 处理约 8192 个 token。
8 Pipeline Parallelism:沿层数切分
8.1 PP 的基本思想
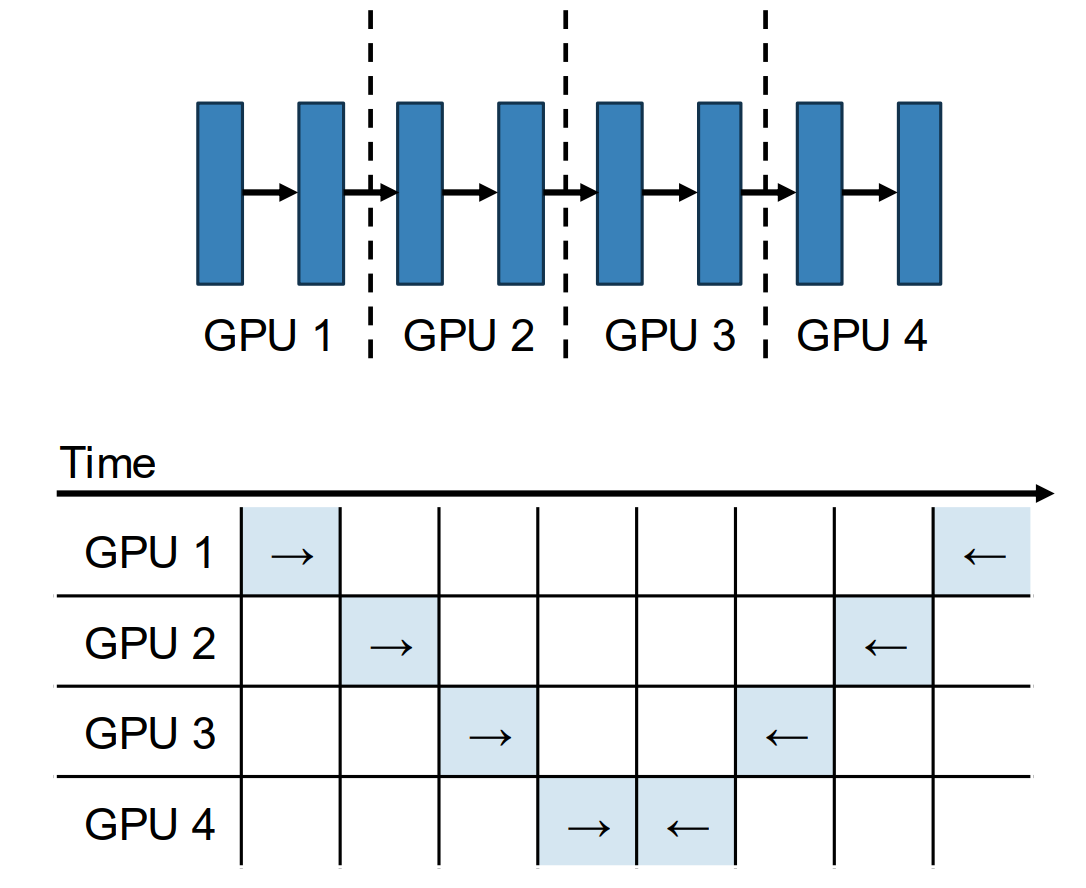
Pipeline Parallelism(PP) 沿模型层数切分。假设有 4 张 GPU,可以让 GPU 1 负责前几层,GPU 2 负责中间一段层,GPU 3 和 GPU 4 负责后续层。前向传播时,GPU 1 计算完自己的层后,把激活传给 GPU 2;反向传播时,梯度反向传回来。
PP 的好处是可以把模型参数按层分散到多张 GPU 上,解决单卡放不下所有层的问题。
8.2 Pipeline bubble
PP 的主要问题是顺序依赖。如果只有一个 batch,GPU 1 先工作,GPU 2 等待;GPU 2 工作时,GPU 1 可能空闲。反向传播也类似。大量 GPU 时间会浪费在等待上,这段空闲被称为 pipeline bubble。
课件指出,如果直接做 \(N\)-way PP 而没有 microbatch,最大 MFU 可能只有:
\[ \frac{1}{N} \]
例如 4-way PP 时,上限只有 25%,非常低。
8.3 Microbatch 提高流水线利用率
解决方法是把一个大 batch 切成多个 microbatch,让多个 microbatch 同时处在 pipeline 的不同阶段。这样 GPU 1 在处理第 2 个 microbatch 时,GPU 2 可以处理第 1 个 microbatch,流水线逐渐被填满。下图中不同的颜色代表不同的microbatch:
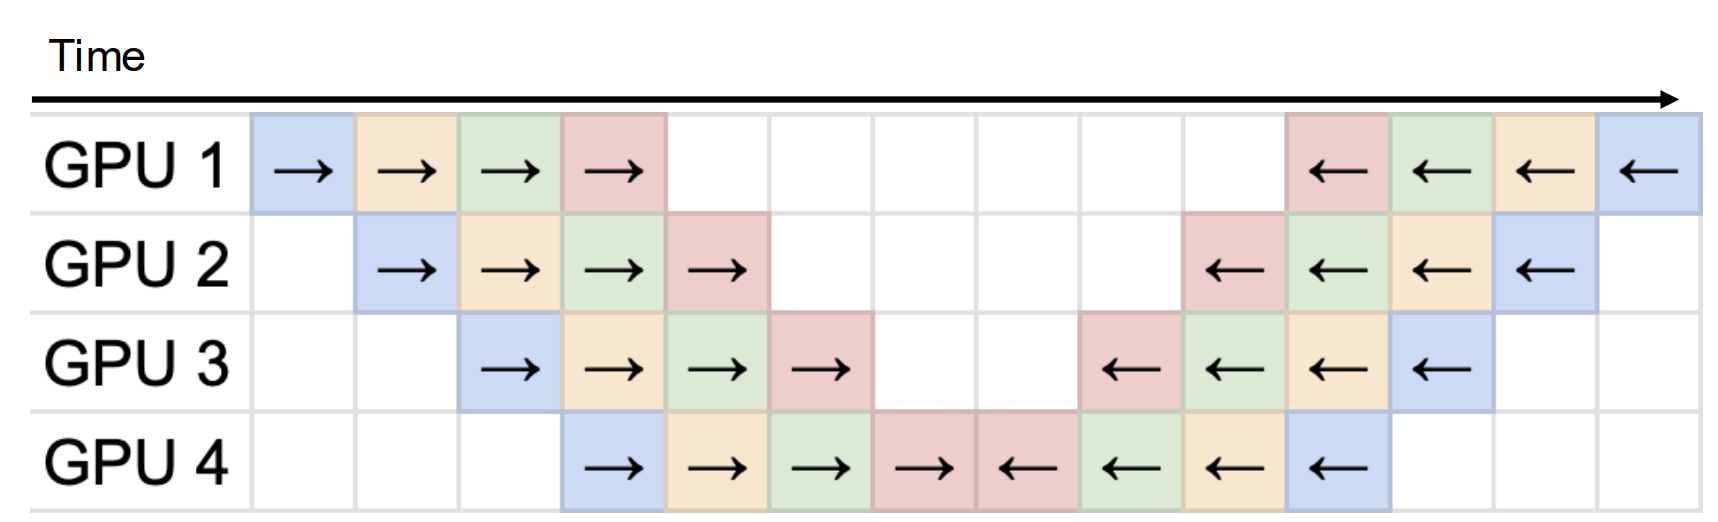
课件中的例子是 4-way PP 配 4 个 microbatch,最大 MFU 从:
\[ \frac{1}{4}=25\% \]
提高到:
\[ \frac{16}{28}\approx 57.1\% \]
因此 PP 的核心调参问题是:如何选择 pipeline stage 数量和 microbatch 数量,让 bubble 尽量小,同时不让显存和通信失控。
9 Tensor Parallelism:沿特征维度切分
9.1 TP 的基本思想
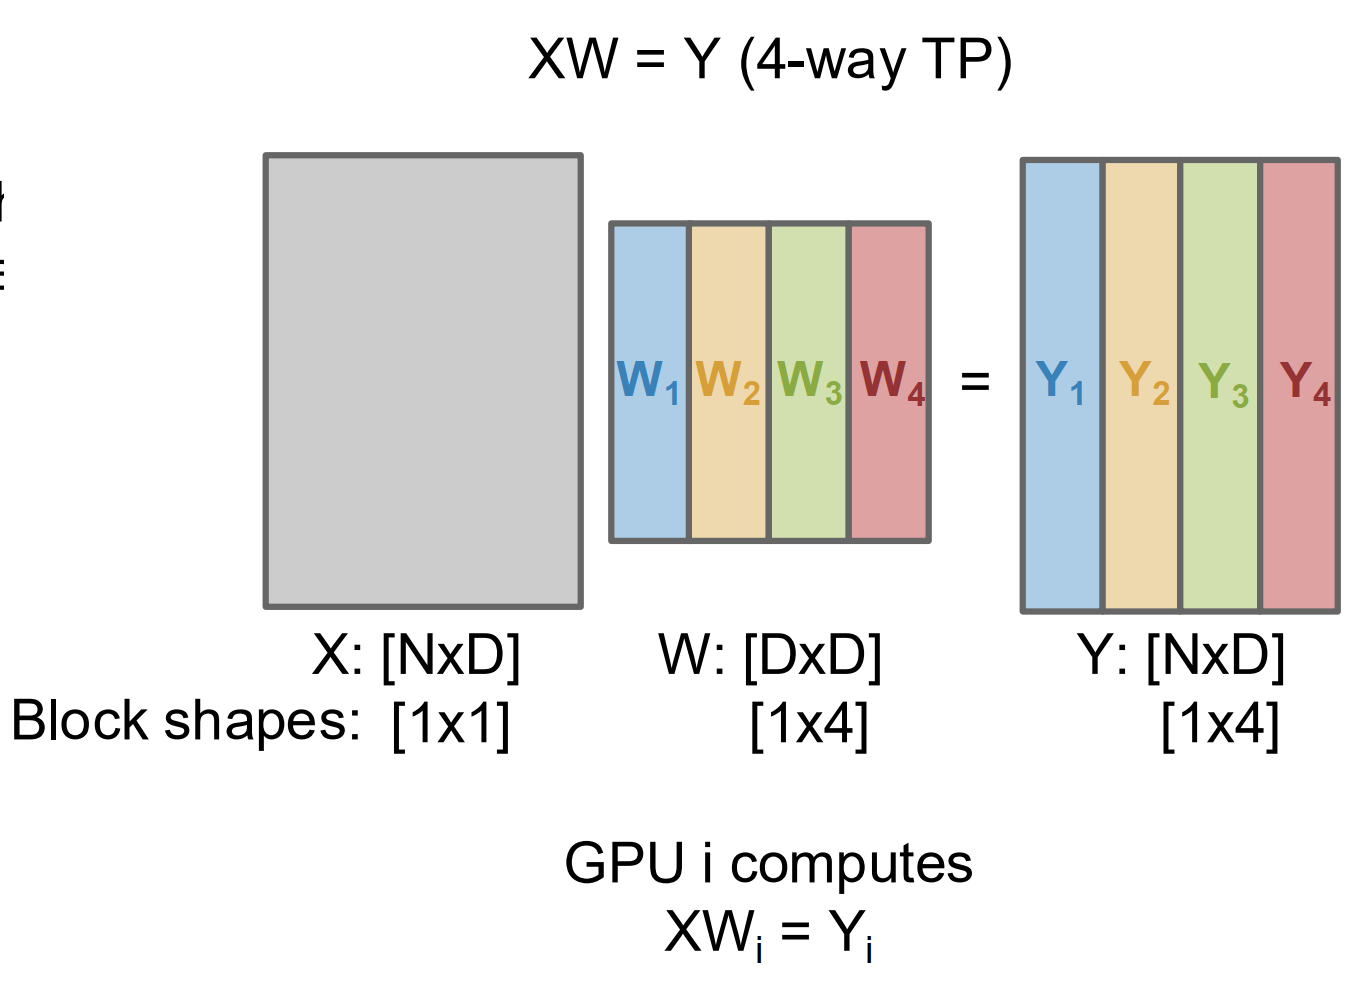
Tensor Parallelism(TP) 把单个线性层的矩阵乘法拆到多张 GPU 上。考虑一层线性变换:
\[ XW=Y \]
其中:
\[ X \in \mathbb{R}^{N\times D},\quad W \in \mathbb{R}^{D\times D},\quad Y \in \mathbb{R}^{N\times D} \]
如果做 4-way TP,可以把 \(W\) 按列切成:
\[ W = [W_1, W_2, W_3, W_4] \]
每张 GPU 计算:
\[ Y_i = XW_i \]
最后得到:
\[ Y = [Y_1, Y_2, Y_3, Y_4] \]
这能把单层大矩阵乘法分散到多张 GPU 上。
9.2 TP 的通信问题
如果只看一层,列切分后每张 GPU 只得到 \(Y\) 的一部分。下一层如果需要完整 \(Y\),就必须 gather 所有分片。这个 gather 往往不能很好地与计算重叠,因此会成为性能瓶颈。
课件给出的技巧是:连续两层使用互补切分方式,减少中间通信。
第一层按列切分:
\[ XW = [XW_1, XW_2, XW_3, XW_4] = [Y_1, Y_2, Y_3, Y_4] \]
第二层把权重 \(U\) 按行切分:
\[ U = \begin{bmatrix} U_1 \\ U_2 \\ U_3 \\ U_4 \end{bmatrix} \]
则:
\[ YU = Y_1U_1 + Y_2U_2 + Y_3U_3 + Y_4U_4 = Z \]
每张 GPU 可以先计算自己的局部项:
\[ Z_i = Y_iU_i \]
最后再把这些局部结果相加并广播。这样中间的 \(Y\) 不需要先完整 gather,通信位置被推迟到第二层之后。
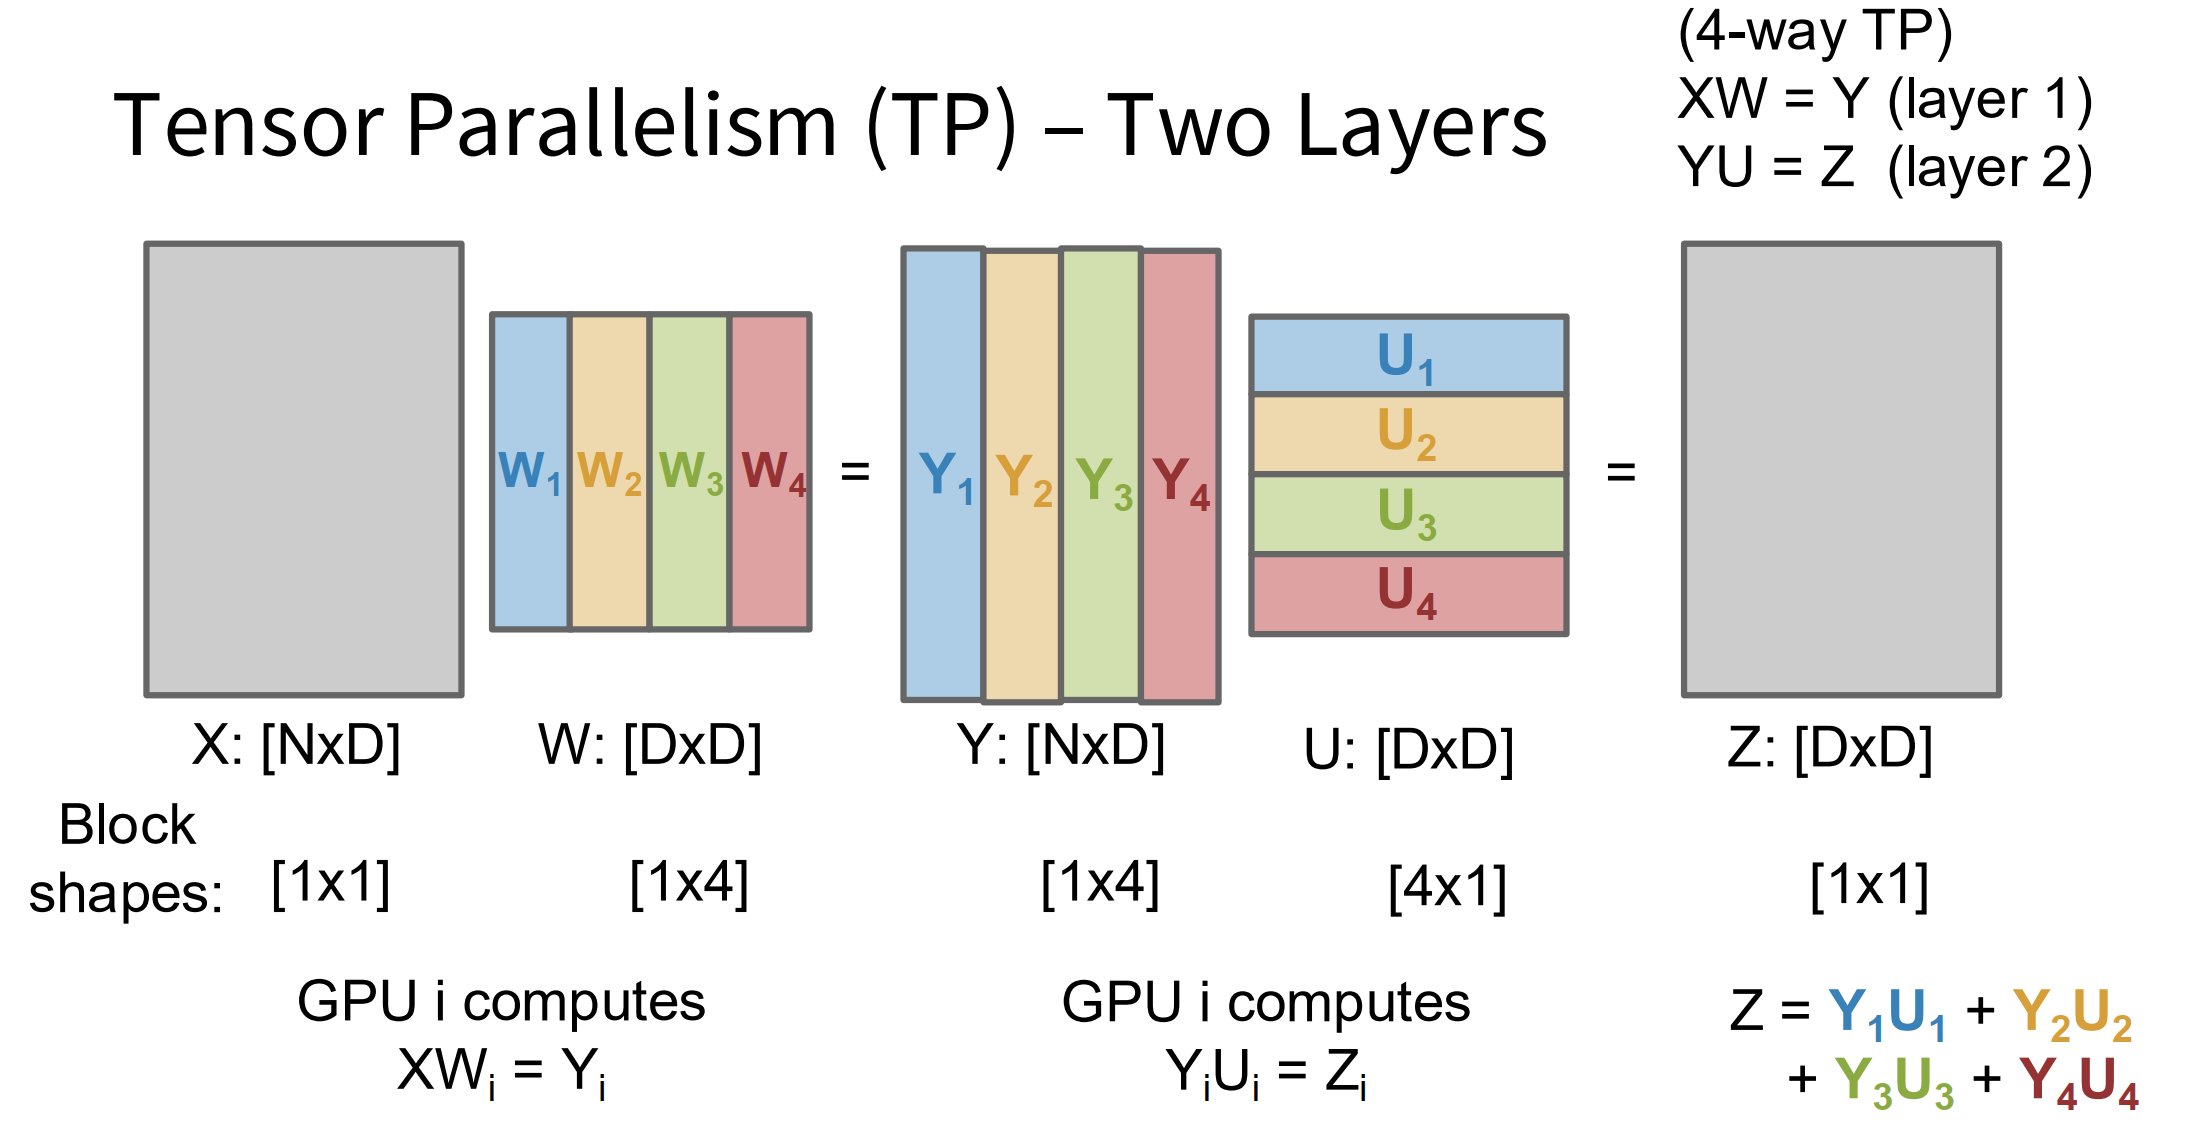
图中的等号有点歧义,实际上是 \(Y_i=XW_i\),\(Z_i=Y_i U_i\)
9.3 TP 的适用场景
TP 特别适合单层矩阵很大的模型,例如超大 Transformer 的 MLP 和 attention projection。它的优点是能切开单层计算和单层参数;缺点是通信非常频繁,通常需要高速 GPU 互联,适合放在同一节点内或高速互联的小组内使用。
10 多维并行与复习重点
10.1 ND Parallelism
对于最大规模模型,答案通常不是只用一种并行,而是 DP、FSDP/HSDP、CP、PP、TP 同时使用。课件称为 ND Parallelism:把 GPU 排成多维网格,每张 GPU 的坐标决定它在数据维度、序列维度、层维度和张量维度上的角色。
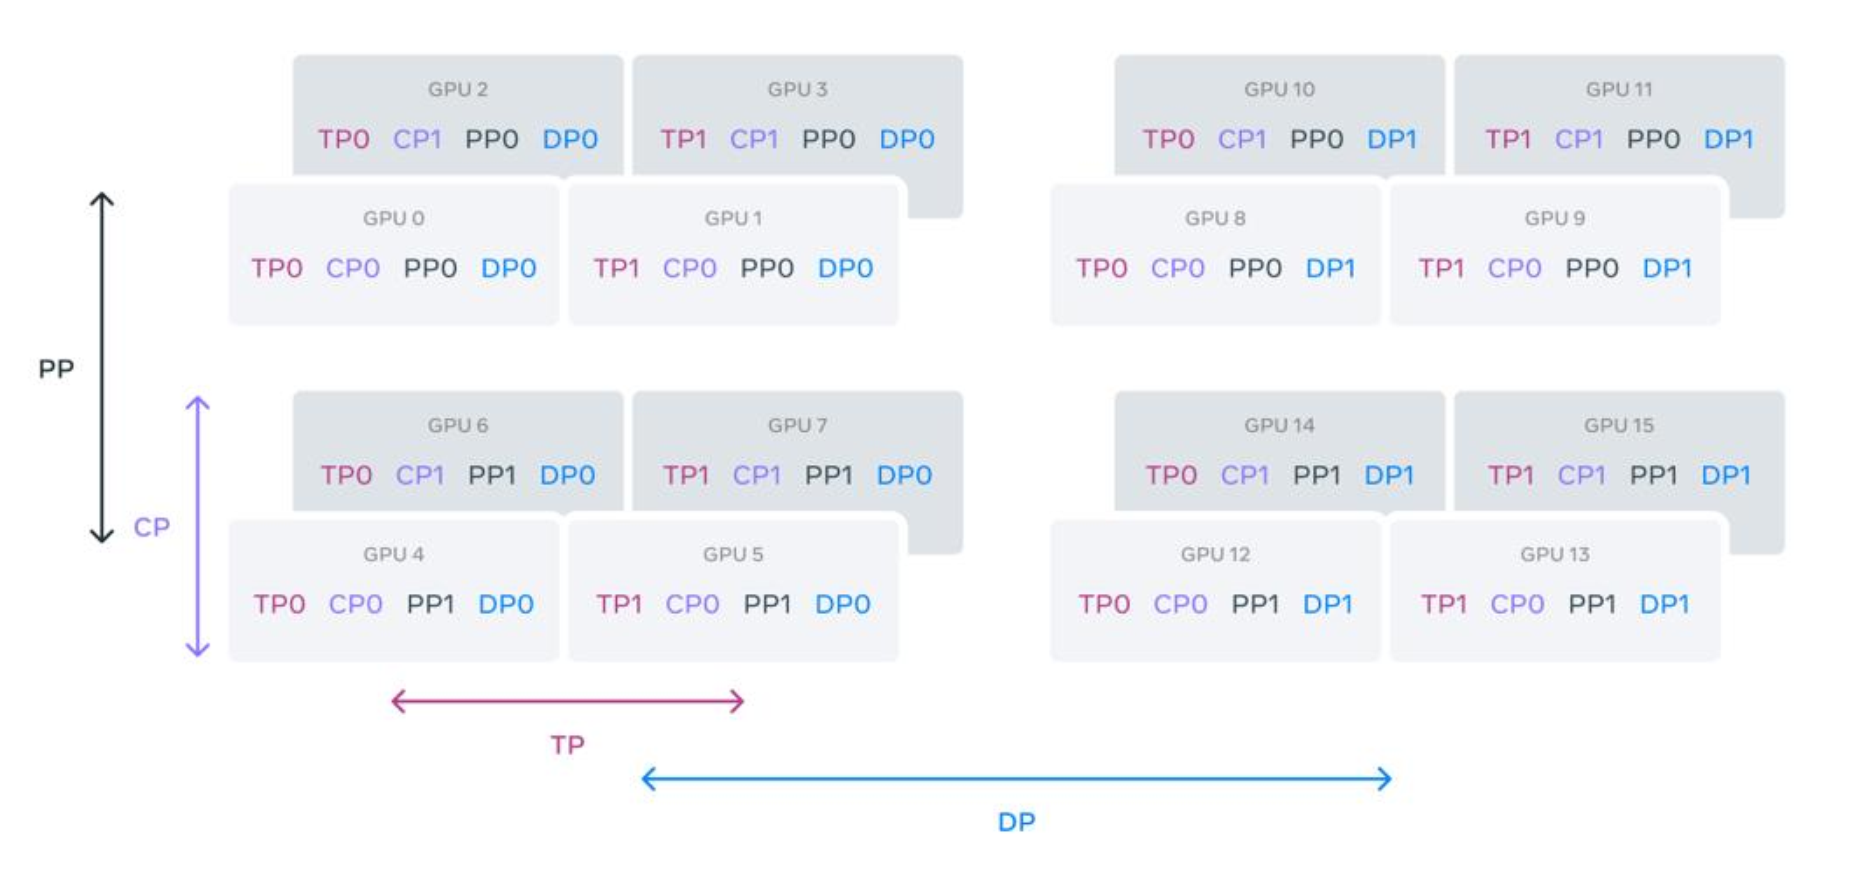
例如一个训练系统可以这样组织:
| 维度 | 并行策略 | 主要解决问题 |
|---|---|---|
| Batch | DP / HSDP | 提高数据吞吐,扩大 global batch |
| 参数状态 | FSDP / HSDP | 让超大参数和优化器状态放得下 |
| Sequence | CP | 支持超长上下文 |
| Layers | PP | 把不同层分到不同 GPU |
| Dim / Linear layer | TP | 切开单层巨大矩阵乘法 |
调参目标仍然是:在满足显存、通信拓扑和模型正确性的前提下,最大化 MFU。
10.2 四种并行方式对比
| 方法 | 切分对象 | 主要收益 | 主要代价 | 常见使用场景 |
|---|---|---|---|---|
| DP | batch | 简单提升吞吐 | 每卡保存完整模型,需同步梯度 | 中小模型、多卡训练起点 |
| FSDP | 参数、梯度、优化器状态 | 大幅降低每卡参数显存 | 前向/反向频繁取权重和传梯度 | 模型放不进单卡时 |
| HSDP | 组内 FSDP,组间 DP | 兼顾省显存和通信拓扑 | 并行配置更复杂 | 数百张以上 GPU |
| CP | sequence | 支持长上下文 | attention 通信复杂 | 长序列训练/微调 |
| PP | layers | 模型按层放到多卡 | pipeline bubble,需 microbatch | 层数很多、参数按层可切 |
| TP | dim / linear weights | 切开单层大矩阵 | 频繁通信,需要高速互联 | 超大 Transformer 层 |
10.3 容易考的关键结论
- 数据并行的数学依据是梯度对样本平均的线性性。 每张 GPU 算局部梯度,平均后等价于在更大的 batch 上训练。
- 普通 DP 不能解决大模型显存问题。 因为每张 GPU 都保存完整参数、梯度和优化器状态。
- FSDP/ZeRO 的核心是 shard 模型状态。 它用更多通信换更低显存。
- HSDP 是拓扑友好的折中。 组内高频通信放在高速互联内,组间低频通信可以跨更慢网络。
- Activation checkpointing 用重计算换显存。 保存所有激活是 \(O(N)\) compute、\(O(N)\) memory;完全重算是 \(O(N^2)\) compute、\(O(1)\) memory;保存 \(\sqrt{N}\) 个 checkpoint 可达到 \(O(N\sqrt{N})\) compute、\(O(\sqrt{N})\) memory。
- HFU 不等于 MFU。 HFU 看硬件实际执行 FLOPs 占峰值比例;MFU 看有用模型计算占理论峰值比例,更适合评价训练配置。
- MFU > 30% 通常不错,> 40% 很优秀。
- PP 的核心问题是 bubble。 microbatch 可以填充流水线,提高利用率。
- TP 的核心问题是通信。 连续两层采用列切分/行切分组合,可以减少中间 gather。
- 最大模型通常要多维并行。 Batch、Sequence、Layers、Dim 都可能被同时切分。
10.4 一句话总览
大规模分布式训练的本质是把一个形状为 \((\text{Batch}, \text{Sequence}, \text{Dim})\)、包含很多层的模型训练过程,沿数据、序列、层和特征维度拆到 GPU 集群上;每一种拆法都在显存、通信和计算利用率之间交换成本,最终目标是让模型放得下,并让 MFU 尽可能高。