1 视频理解的基本问题
1.1 从图像理解到视频理解
前几讲主要讨论的是静态图像任务,例如图像分类、目标检测、语义分割和实例分割。图像分类只需要判断一张图属于哪个类别,检测和分割进一步要求模型理解图像中的空间位置、物体边界和像素级语义。
视频理解在此基础上多了一个关键维度:时间(Time)。一段视频可以看成一串连续图像,因此常见输入张量可以写成:
\[ T \times 3 \times H \times W \]
或等价地写成:
\[ 3 \times T \times H \times W \]
其中 \(T\) 是帧数,\(3\) 是 RGB 通道数,\(H,W\) 是空间分辨率。视频不是简单的“多张图片堆在一起”,因为许多语义依赖时间变化。例如单张图像可能只能看出“一个人在泳池边”,但视频中的连续动作可以让我们判断“游泳”“跳水”或“跑步”。
1.2 视频分类的任务形式
视频分类(Video Classification)的输入是一段视频,输出是动作或事件类别,例如:
| 图像分类更关注 | 视频分类更关注 |
|---|---|
| 物体类别:dog, cat, truck, plane | 动作类别:swimming, running, jumping, eating |
| 单帧外观、纹理、形状 | 外观加运动、时间顺序、动作持续过程 |
因此,视频分类既需要识别“画面里有什么”,也需要识别“这些东西如何随时间变化”。在很多动作识别问题中,单帧外观本身已经很有帮助,但真正困难的部分通常来自运动和长时序结构。
1.3 视频数据很大
视频的主要工程难点是体量巨大。以未压缩 RGB 视频估算,每个像素 3 字节,若视频约为 30 fps:
| 分辨率 | 每分钟未压缩大小 |
|---|---|
| SD \(640 \times 480\) | 约 1.5 GB |
| HD \(1920 \times 1080\) | 约 10 GB |
这意味着不能简单地把完整高分辨率长视频直接送入模型训练。常见做法是:训练时采样短 clip,降低帧率和空间分辨率。例如取 \(T=16, H=W=112\) 的短片段,在 5 fps 下约覆盖 3.2 秒,数据量约 588 KB。这样既保留一定时间信息,又能让训练成本可控。
2 短视频片段上的视频分类
2.1 Clip 训练与测试
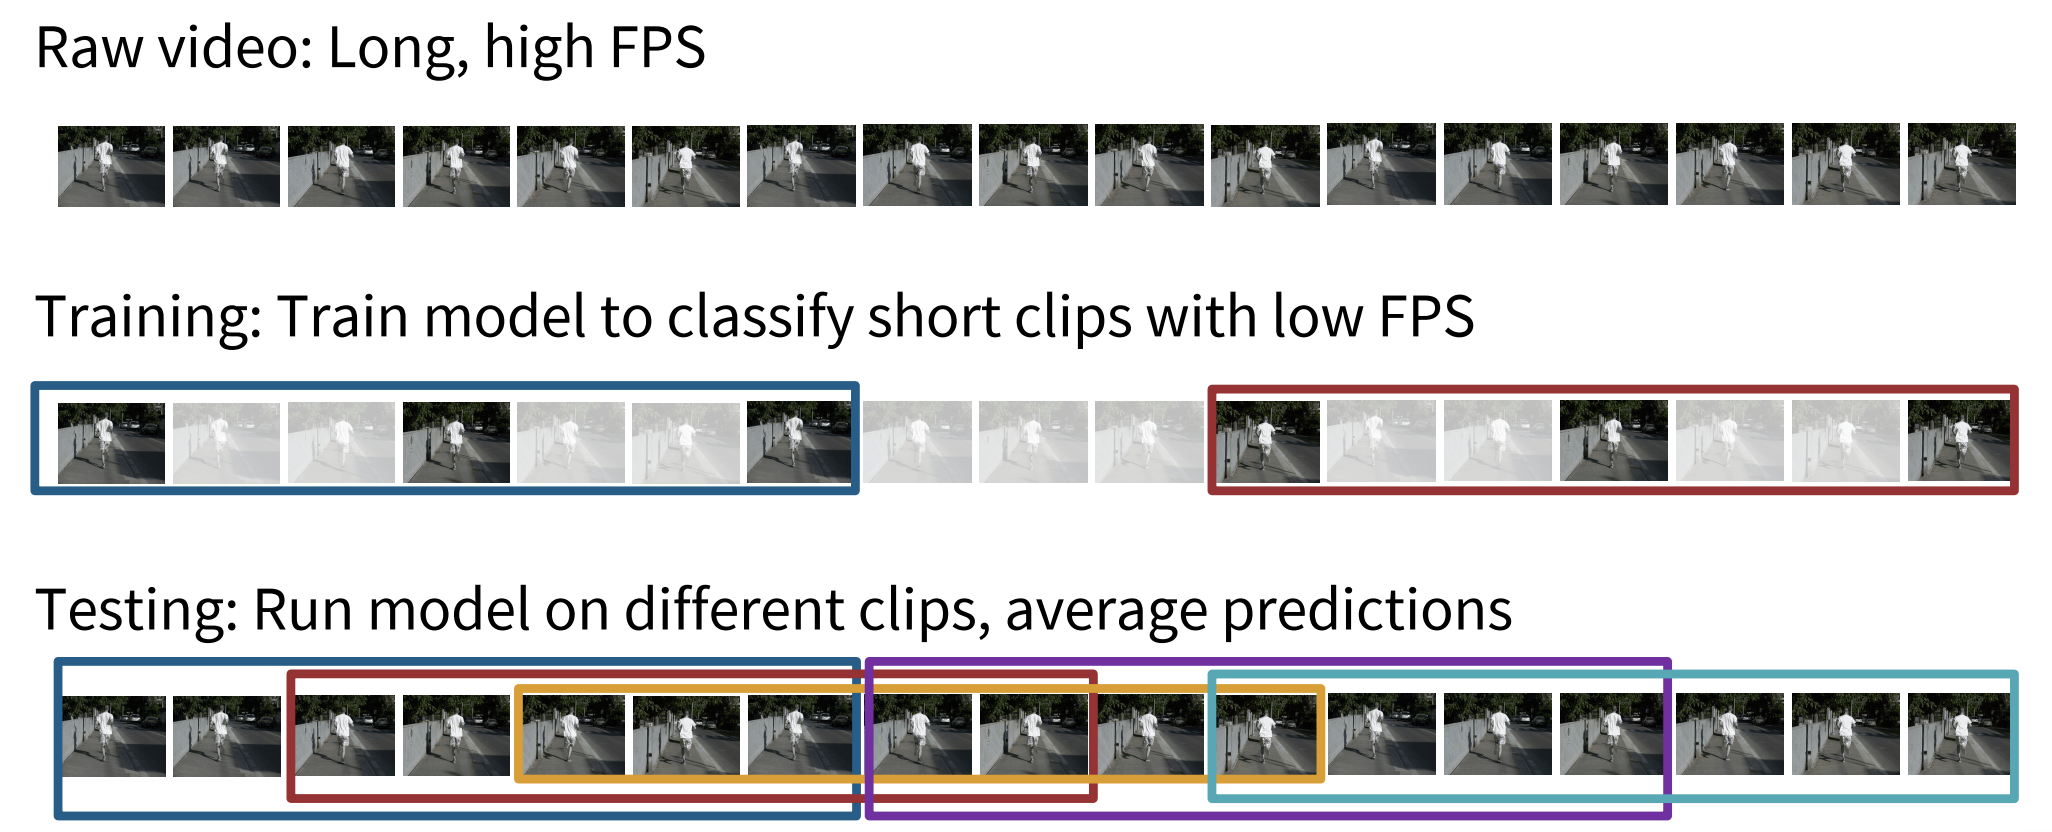
实际训练通常不是直接处理完整长视频,而是从原始视频中采样短片段:
- 原始视频通常很长、帧率高、分辨率高。
- 训练时采样短 clip,并以较低帧率和较低分辨率输入模型。
- 测试时可以从同一个视频采样多个 clip,对每个 clip 做预测,再平均预测概率。
这种策略的核心思想是:训练时让模型学习局部时间窗口中的视觉模式;测试时用多个局部窗口近似整段视频的语义。
2.2 Single-Frame CNN:必须先尝试的强基线
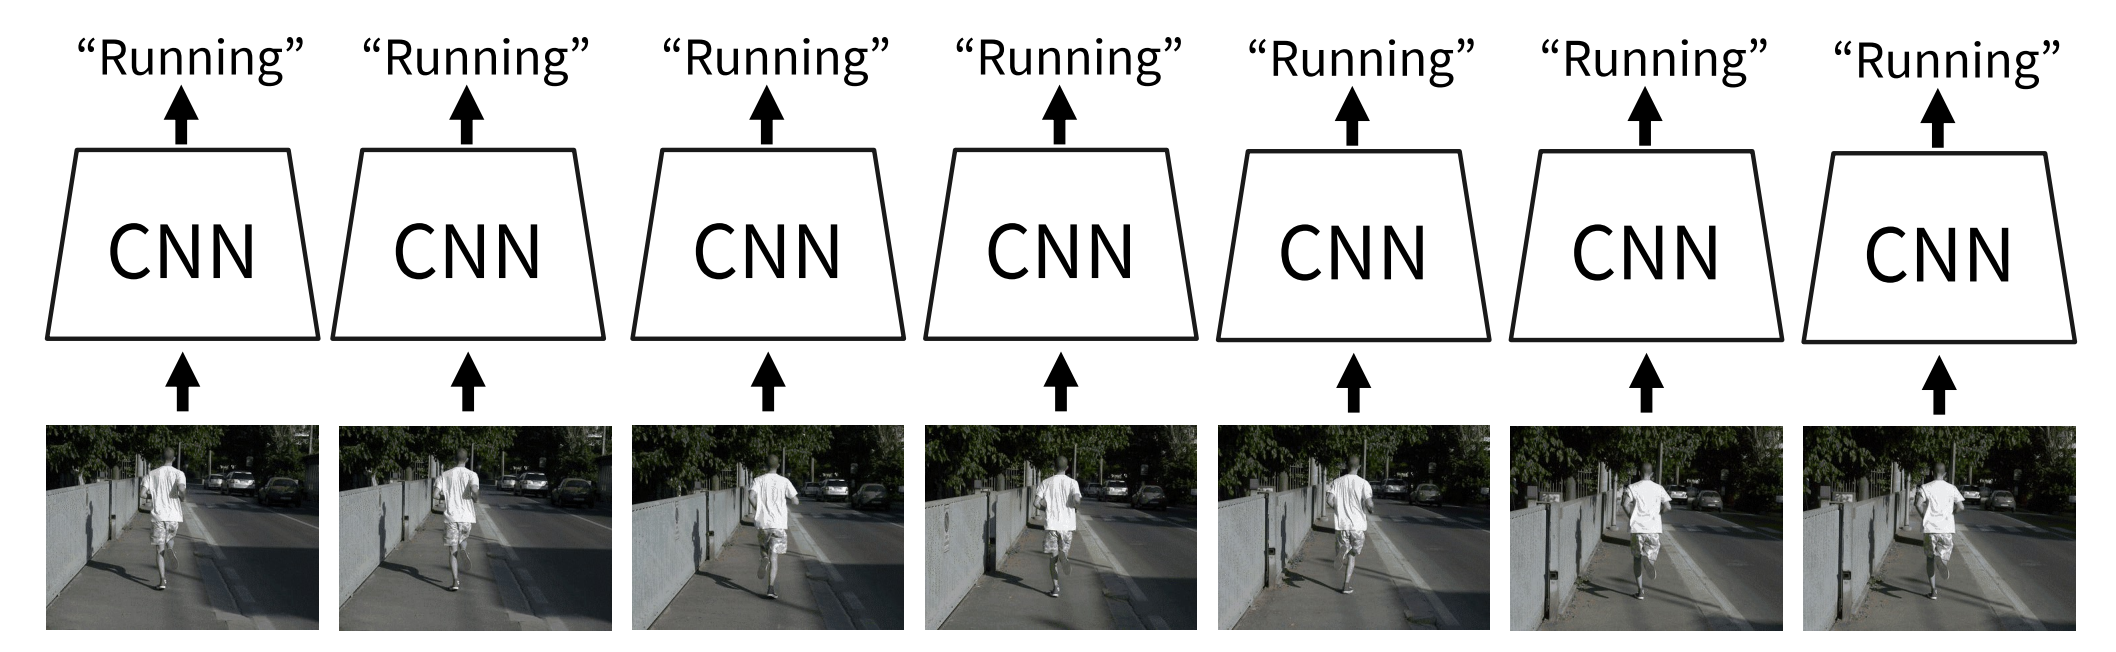
对于视频分类任务,最简单的想法是直接使用普通 2D CNN,对视频中的每一帧独立分类,测试时平均各帧预测概率。这被称为 Single-Frame CNN。
虽然它完全忽略显式时间建模,但在很多数据集上表现很强,原因是动作类别常常与场景和物体强相关。例如“游泳”常出现在泳池,“篮球”常出现在球场,“做饭”常出现在厨房。模型可能只靠单帧中的物体和背景就得到不错的分类结果。
2.3 Late Fusion:先提取每帧高级特征,再融合
Late Fusion 的思路是:先用同一个 2D CNN 独立处理每一帧,得到每帧的高级外观特征,再在高层融合时间信息。
一种实现是把所有帧特征拼接后送入 MLP:
\[ \text{Frame features}: T \times D \times H' \times W' \]
展平后得到 clip 级特征,再输出类别分数。另一种更常见的方式是对空间和时间做 average pooling,得到一个 \(D\) 维 clip 特征,然后接线性分类器。
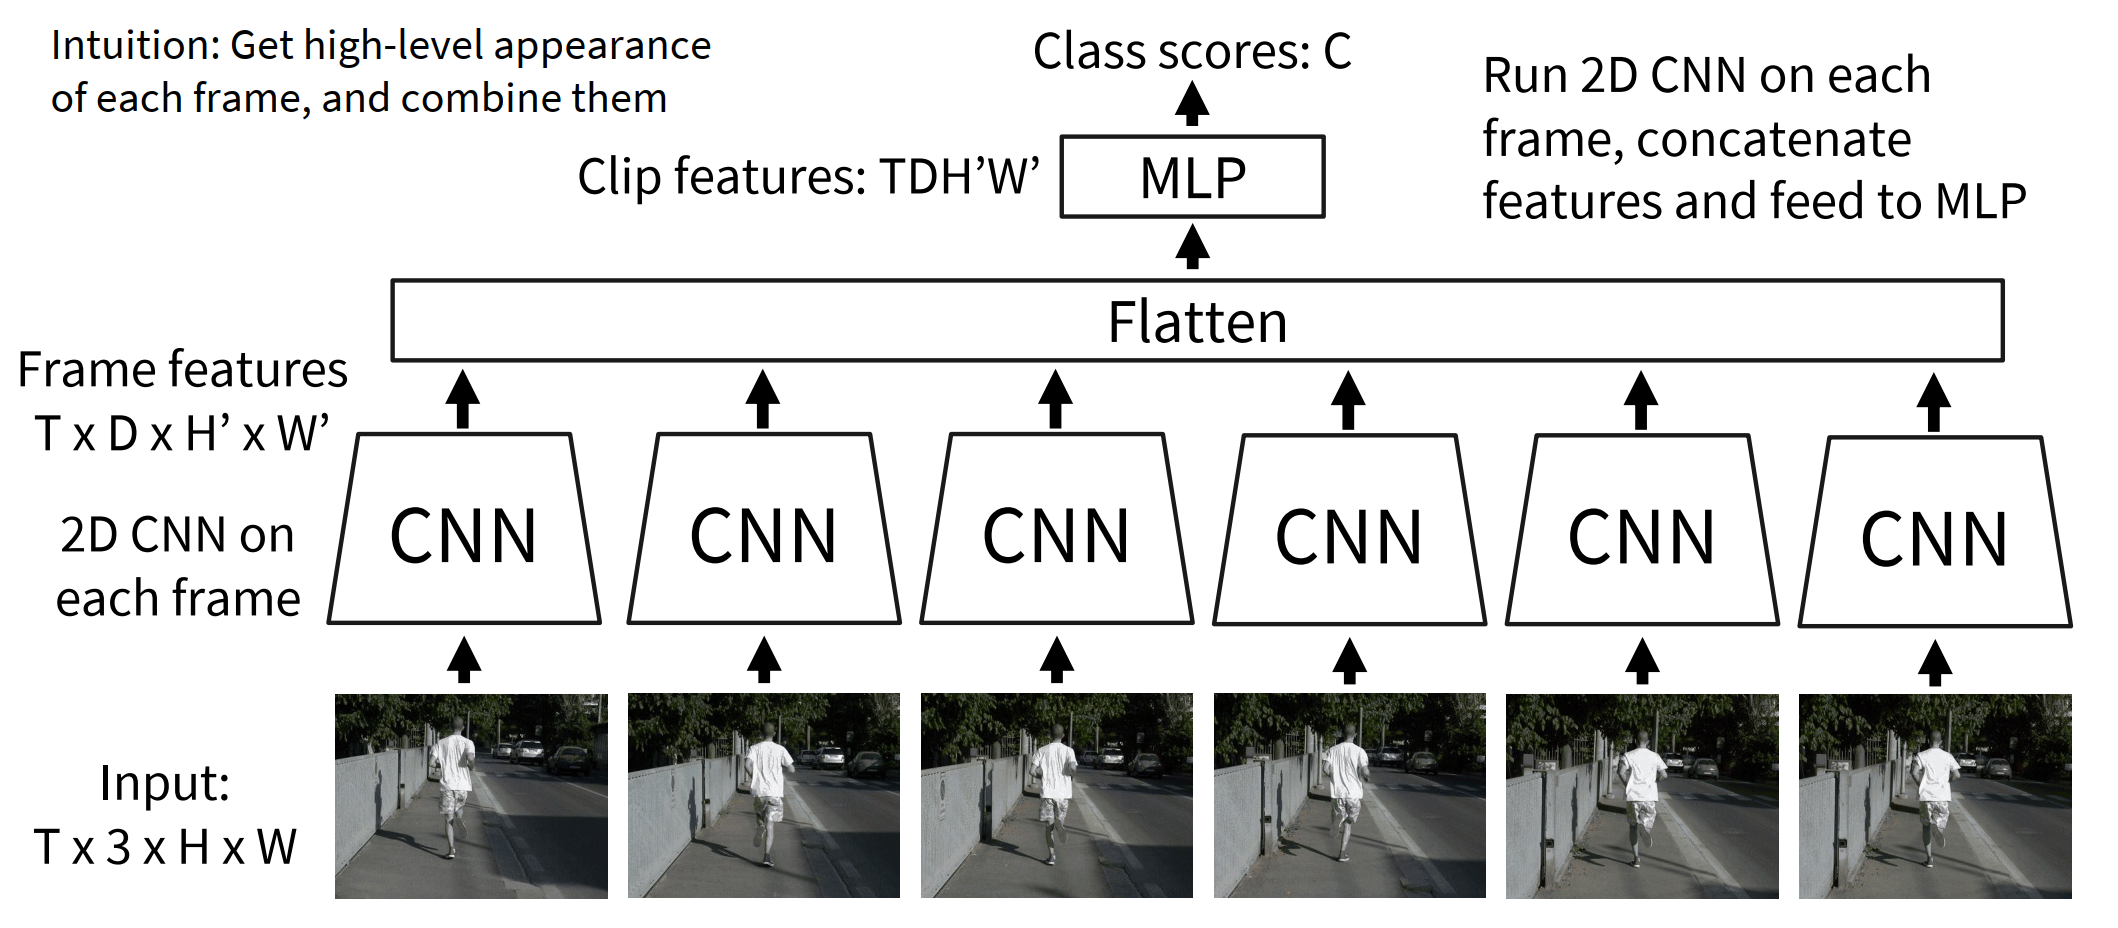
Late Fusion 的优点是实现简单,可以复用成熟的 2D CNN。缺点是:低层运动信息很难被比较。因为每帧在前面已经被独立处理,只有高层语义特征才被融合,模型不容易捕捉像素级或局部纹理随时间的细微变化。
2.4 Early Fusion:在最开始就融合时间
Early Fusion 把 \(T\) 帧沿通道维拼接,将输入从 \(T \times 3 \times H \times W\) 改写为:
\[ 3T \times H \times W \]
然后用普通 2D CNN 处理。第一层 2D 卷积会一次性看到所有帧,因此可以在网络开头比较不同时间的图像。
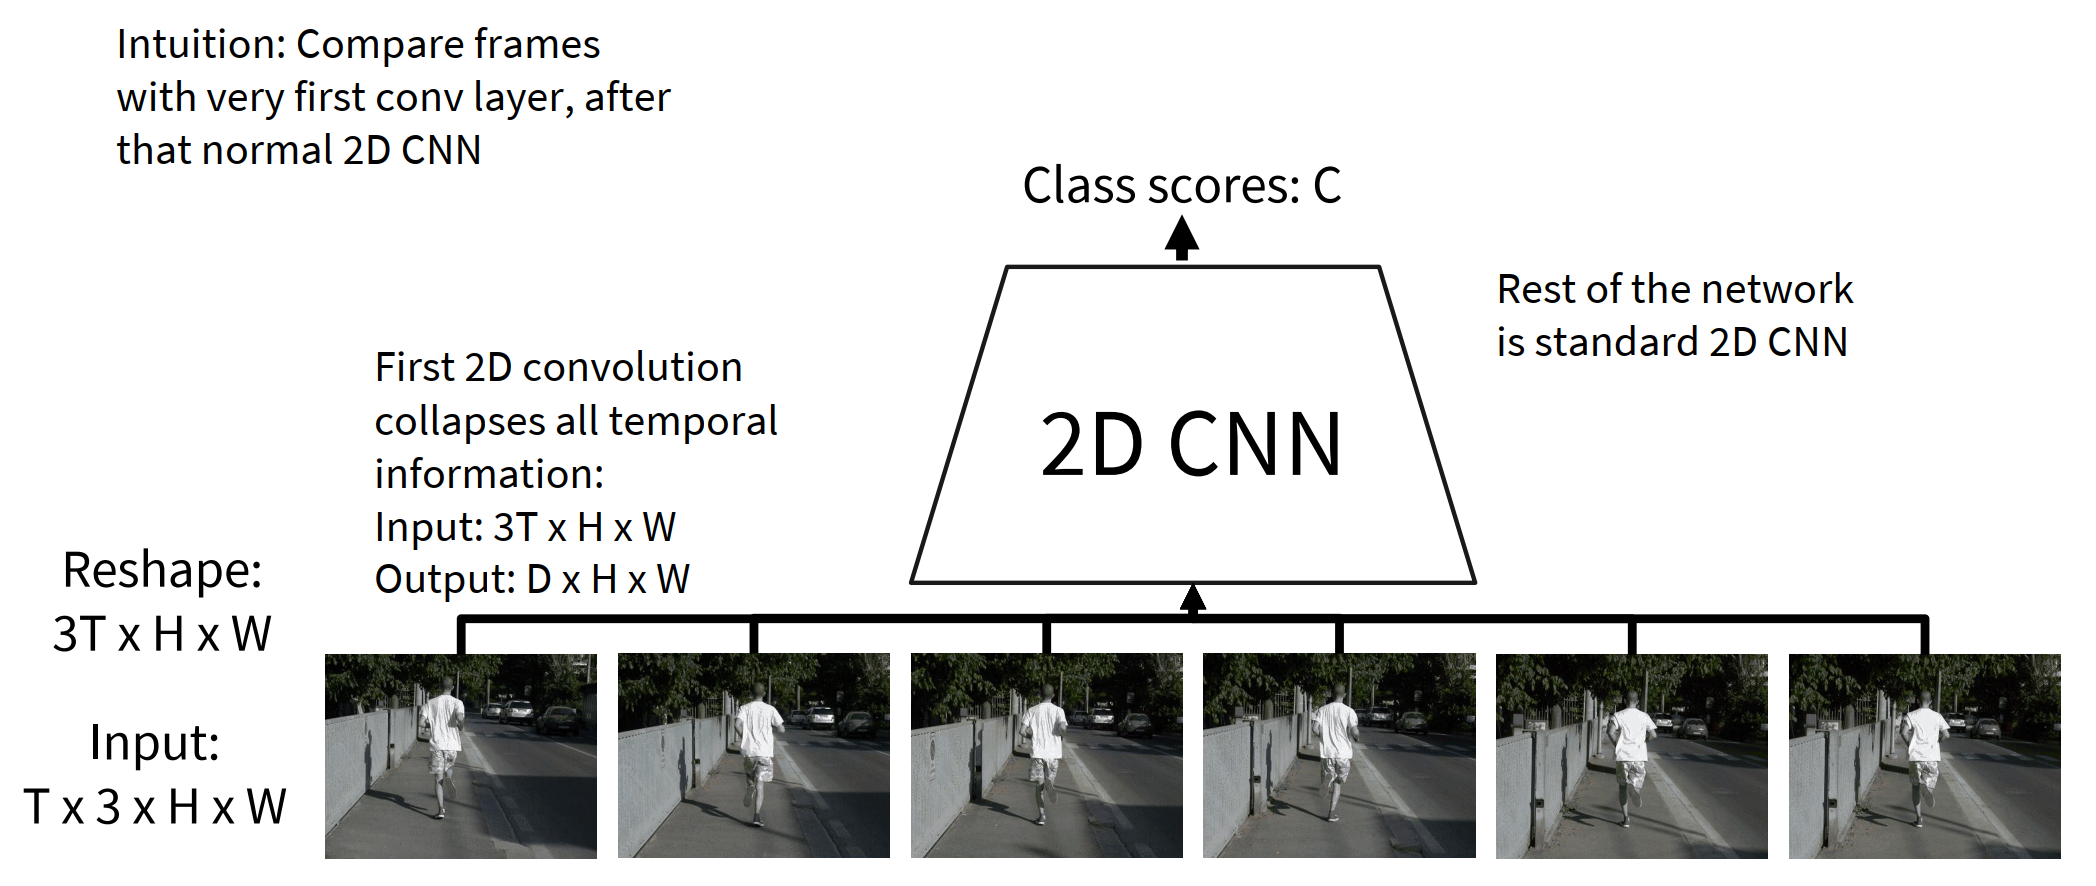
Early Fusion 的问题是:时间信息只在第一层被一次性压缩,后续网络又退化为普通 2D CNN。 如果动作需要多层次、逐步抽象的时间建模,仅靠第一层融合往往不够。
3 从 2D CNN 到 3D CNN:如何建模时间
3.1 3D CNN 的基本思想
3D CNN 将 2D 卷积和池化扩展到时间维。每一层特征是四维张量:
\[ D \times T \times H \times W \]
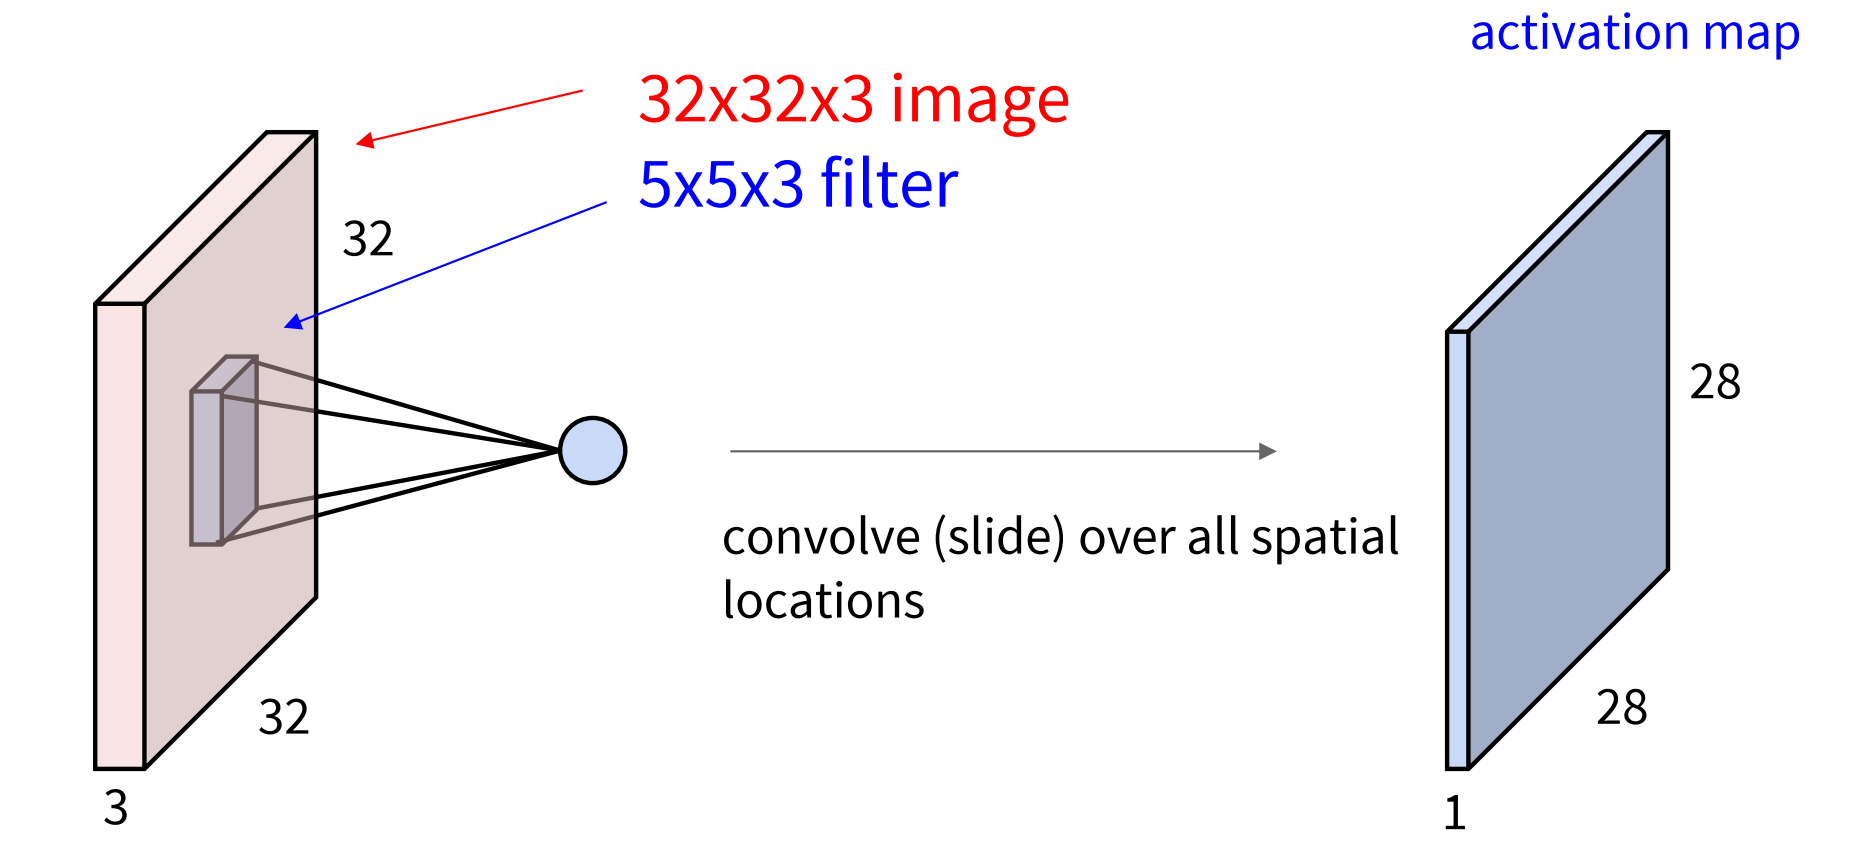
卷积核不再只在空间上滑动,而是在时间和空间上共同滑动。例如 \(3 \times 3 \times 3\) 卷积同时覆盖 3 帧、3 个高度位置和 3 个宽度位置。
与 Early Fusion 不同,3D CNN 会在网络多个层级中逐渐融合时间信息,因此也被称为 Slow Fusion:空间感受野逐层扩大,时间感受野也逐层扩大。
3.2 Early Fusion、Late Fusion 与 3D CNN 的感受野差异
PPT 用一个小网络对比三种方法。输入大小为:
\[ 3 \times 20 \times 64 \times 64 \]
| 方法 | 时间融合方式 | 直观结论 |
|---|---|---|
| Late Fusion | 前面各帧独立处理,最后全局平均池化才融合时间 | 空间逐步构建,时间在末尾一次性融合 |
| Early Fusion | 一开始把所有帧压到通道维,第一层融合时间 | 空间逐步构建,时间在开头一次性融合 |
| 3D CNN | 每层用 3D 卷积/池化逐步融合时间 | 空间和时间都逐步构建 |
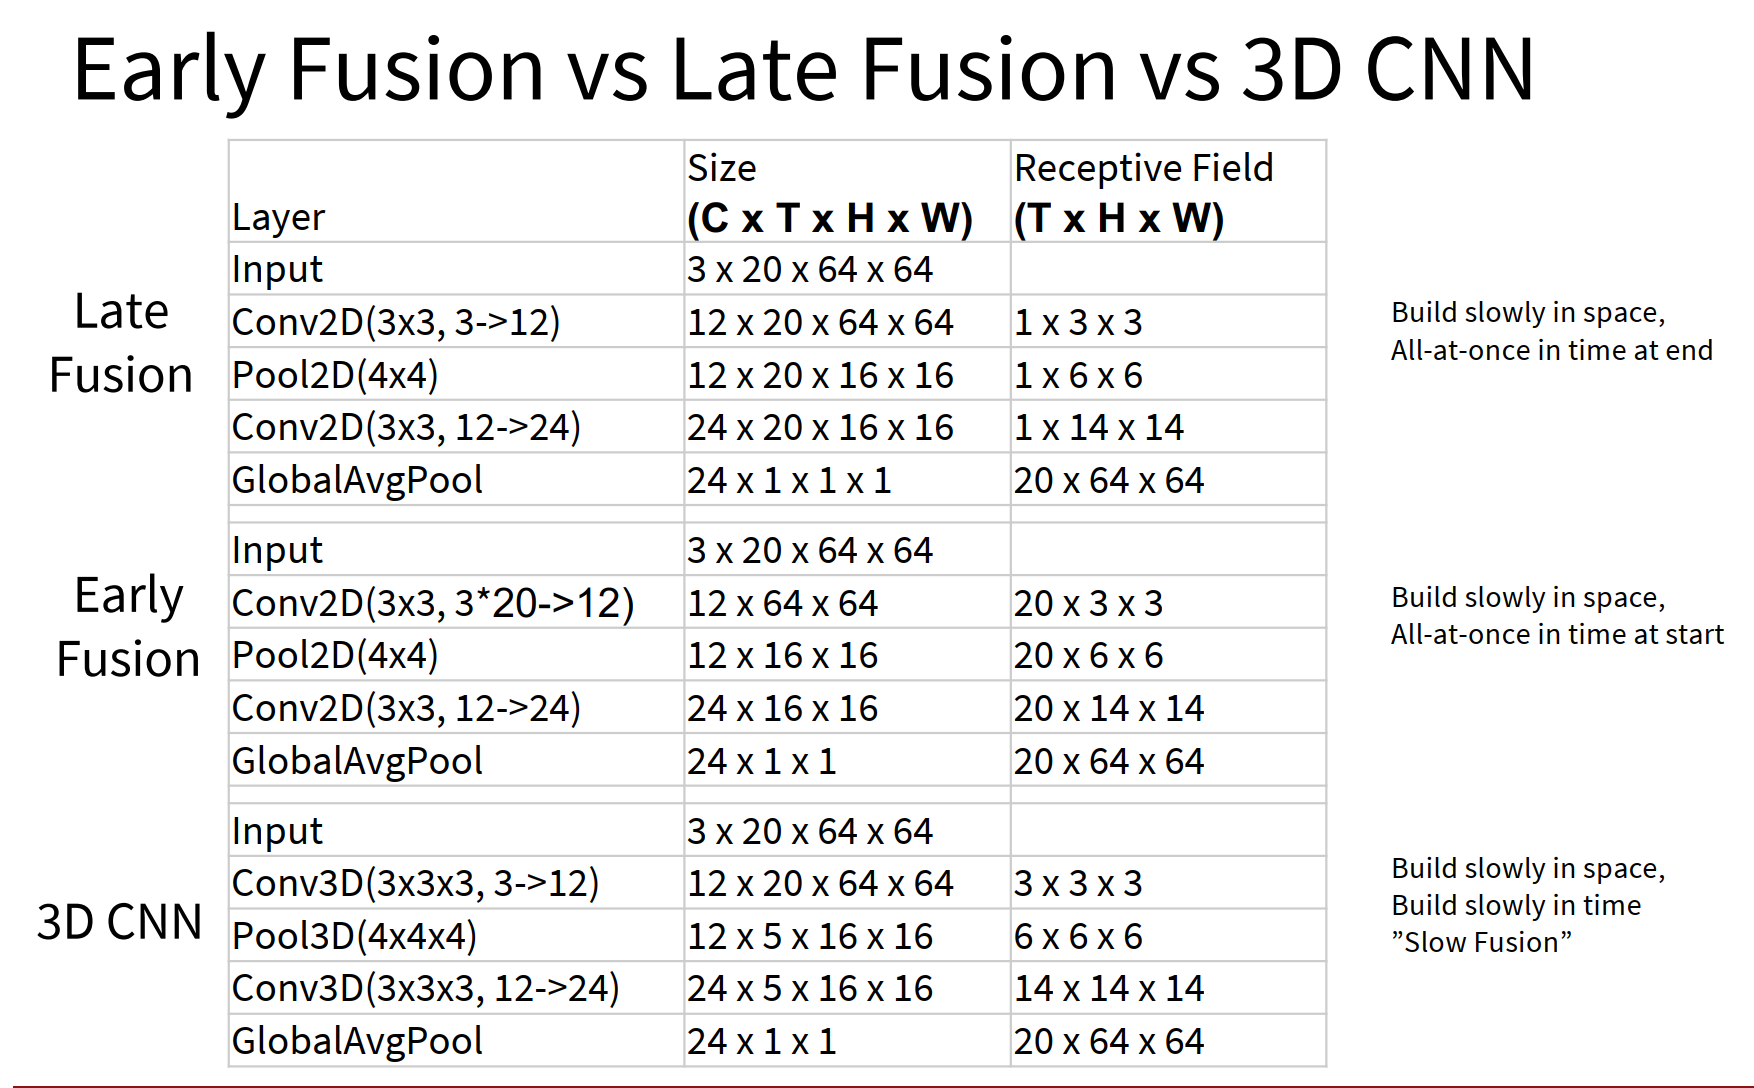
关键区别在于时间感受野。Late Fusion 的中间卷积层时间感受野通常仍是 \(1\),直到最后全局池化才覆盖所有帧。Early Fusion 的第一层已经覆盖全部 \(T\) 帧,但之后不再保留显式时间轴。3D CNN 则保留时间轴,并让每一层的时间感受野逐渐变大。
3.3 2D Early Fusion 与 3D Conv 的本质差异
Early Fusion 中的第一层 2D 卷积权重可以看成:
\[ C_{\text{out}} \times C_{\text{in}} \times T \times 3 \times 3 \]
它一次性覆盖整个 clip 的时间长度,但只在 \(x,y\) 空间位置滑动,不在时间上滑动。因此它没有时间平移不变性:如果同一个运动模式发生在 clip 的不同时间位置,模型可能需要学不同的滤波器。
3D 卷积的卷积核形状通常是:
\[ C_{\text{out}} \times C_{\text{in}} \times 3 \times 3 \times 3 \]
它会在时间、宽度、高度三个维度上滑动,因此具有时间平移不变性(temporal shift-invariance)。也就是说,同一个局部运动模式无论出现在 clip 的前、中、后,3D 卷积都可以用同一组权重检测。
一个直观例子:如果模型要识别“蓝色区域变成橙色区域”的局部运动,3D 卷积可以在任意时间位置检测这种变化;Early Fusion 则更像把不同时间位置当作不同通道,缺少自然的时间滑动结构。
3.4 Sports-1M 与早期实验结论
Sports-1M 是一个包含约 100 万 YouTube 视频、487 类运动标签的数据集。早期结果显示:
| 方法 | Sports-1M Top-5 Accuracy |
|---|---|
| Single Frame | 76.8 |
| Early Fusion | 77.7 |
| Late Fusion | 78.7 |
| 3D CNN | 80.2 |
| C3D | 84.4 |
这个结果说明两个重要事实:
- 单帧模型已经很强,因此任何视频模型都应与它比较。
- 更合理的时空建模可以带来提升,尤其是后来更成熟的 3D CNN 架构。
3.5 C3D:3D CNN 中的 VGG
C3D 可以理解为视频领域中类似 VGG 的 3D CNN:大量使用 \(3 \times 3 \times 3\) 卷积和 \(2 \times 2 \times 2\) 池化。输入通常为:
\[ 3 \times 16 \times 112 \times 112 \]
它的特点是结构规则、易于复用,并且曾经常被作为视频特征提取器,尤其是使用 Sports-1M 预训练模型。
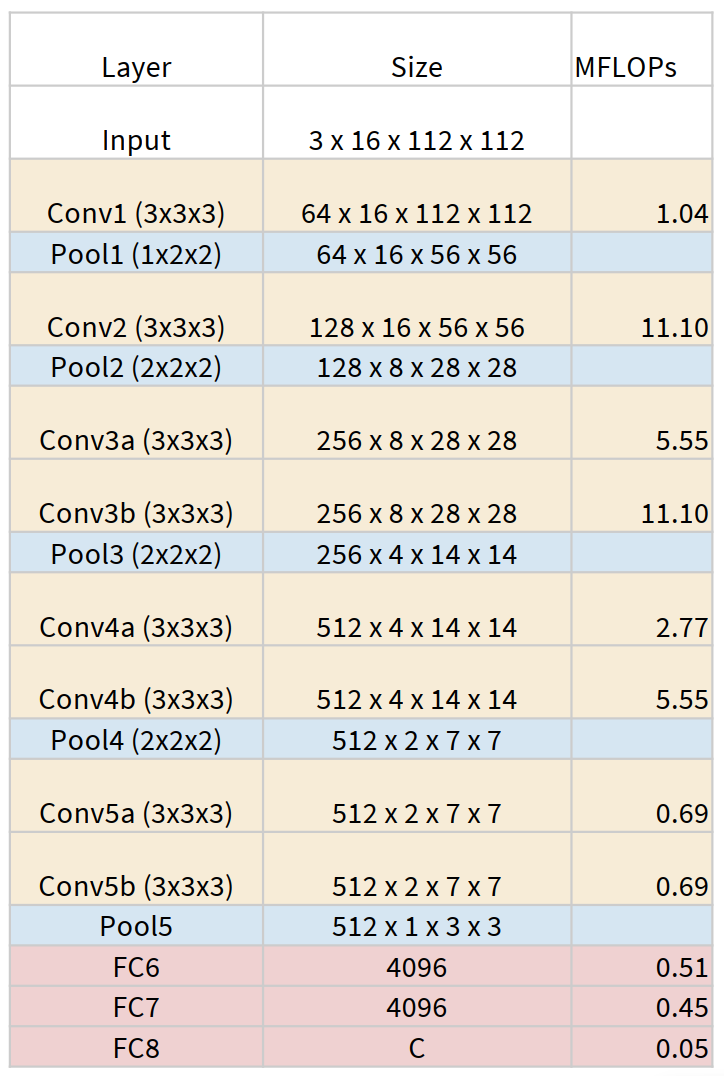
但 C3D 的问题也很明显:3D 卷积非常昂贵。PPT 中给出的计算量对比为:
| 模型 | 计算量 |
|---|---|
| AlexNet | 约 0.7 GFLOP |
| VGG-16 | 约 13.6 GFLOP |
| C3D | 约 39.5 GFLOP,约为 VGG 的 2.9 倍 |
因此,视频模型设计始终伴随一个核心矛盾:要利用时间信息,就需要处理更多维度;但时间维会显著增加计算和内存成本。
4 运动信息、光流与双流网络
4.1 人可以只靠运动识别动作
PPT 引用了生物运动感知的经典现象:人类可以只通过一些运动点的轨迹识别走路、跑步等动作。这说明动作识别不一定需要完整外观,运动本身就携带强语义信息。
这也是为什么视频理解不能只依赖单帧外观。某些动作的关键差异不在物体是什么,而在物体如何移动。例如“举重”和“拿着杠铃站立”在单帧上可能相似,但在运动模式上不同。
4.2 Optical Flow 的定义
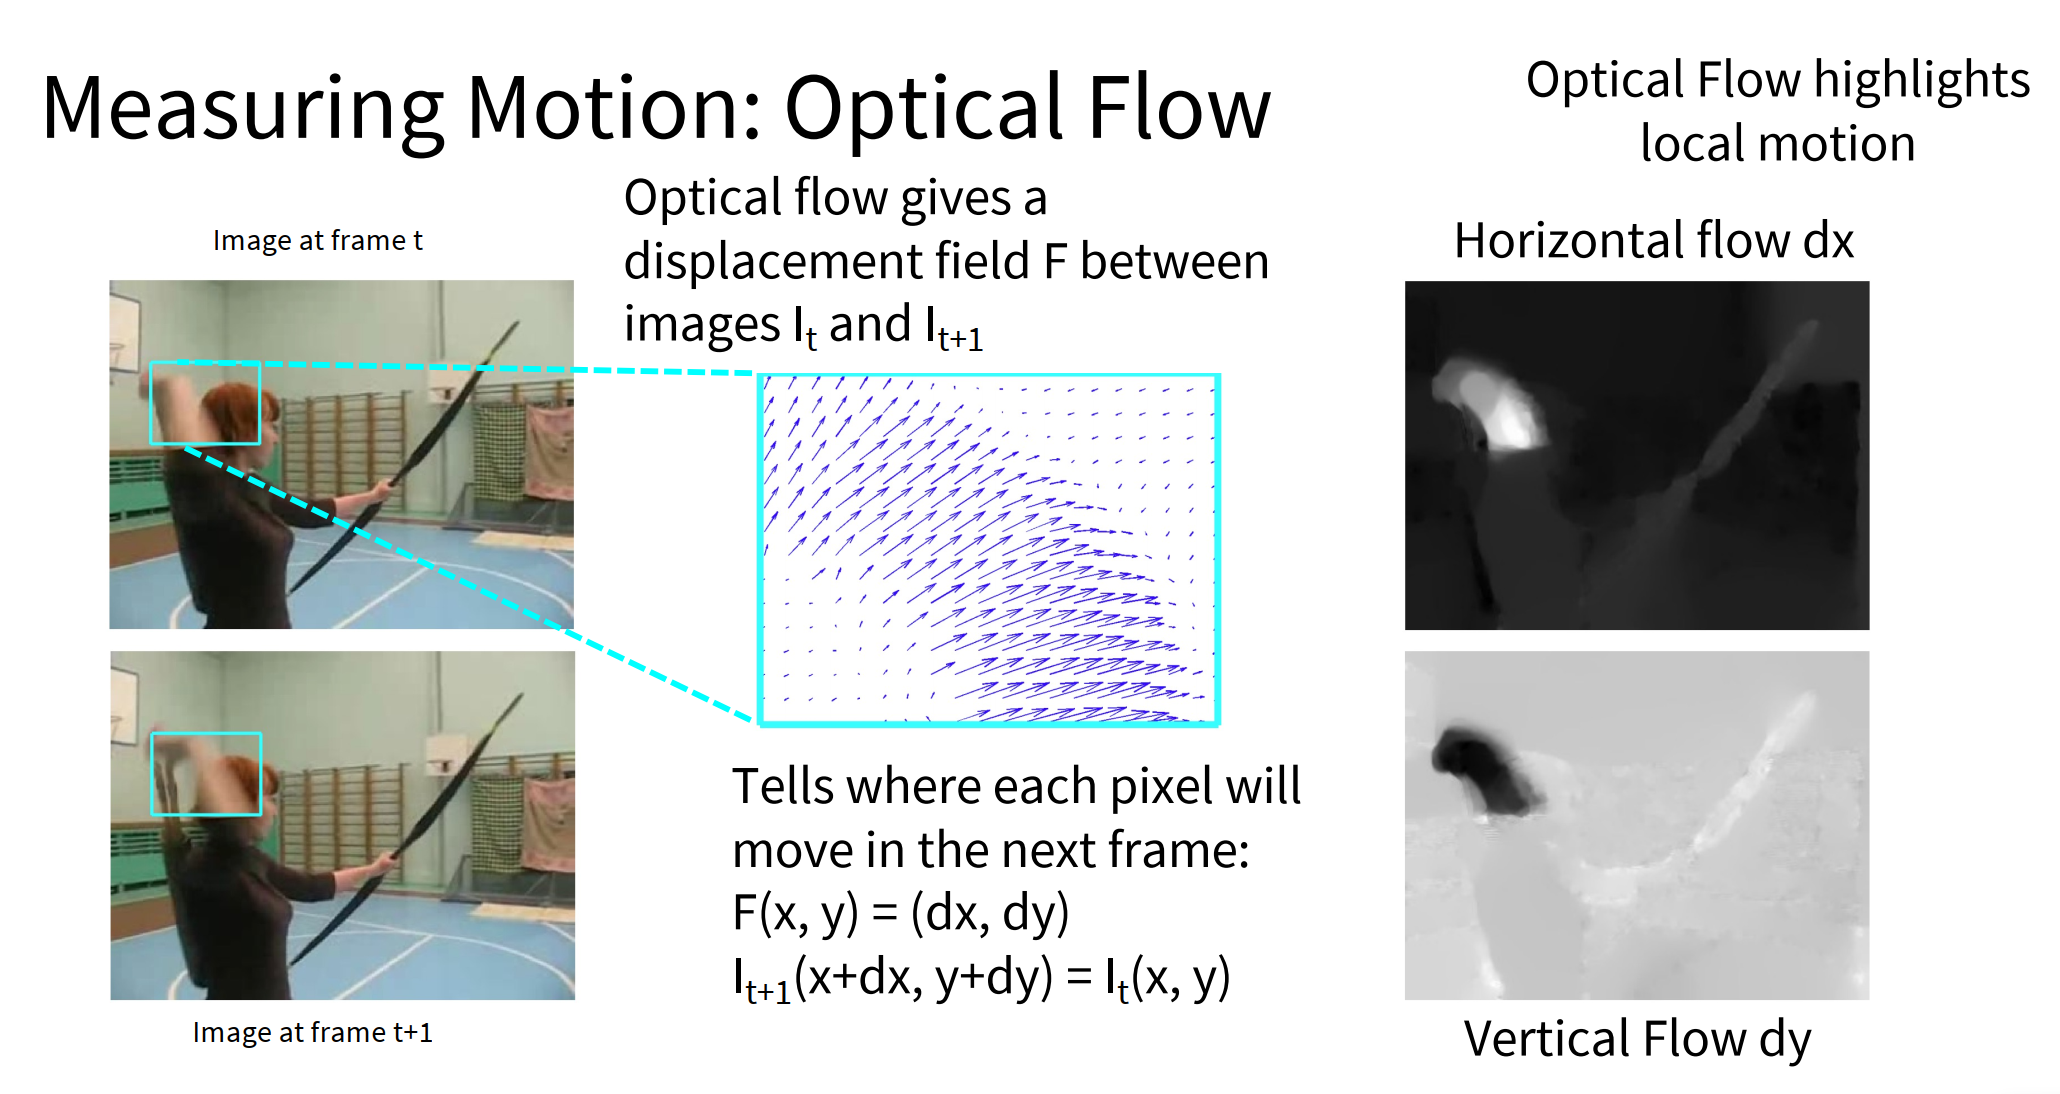
光流(Optical Flow)描述相邻两帧之间每个像素的位移场。对于第 \(t\) 帧图像 \(I_t\) 和第 \(t+1\) 帧图像 \(I_{t+1}\),光流 \(F\) 在像素位置 \((x,y)\) 上给出:
\[ F(x,y) = (dx, dy) \]
其理想关系可以写成:
\[ I_{t+1}(x+dx, y+dy) = I_t(x,y) \]
这里 \(dx\) 是水平位移,\(dy\) 是垂直位移。光流图把局部运动显式表示出来,因此能突出人体、物体或局部区域的运动方向和速度。
需要注意:这个公式依赖亮度一致性假设,即同一个物体点在相邻帧中的外观强度近似不变。现实中遮挡、光照变化和运动模糊会让光流估计变难。
4.3 Two-Stream Networks:分离外观与运动
双流网络(Two-Stream Networks)将视频输入分成两个分支:
| 分支 | 输入 | 作用 |
|---|---|---|
| Spatial stream | 单帧 RGB 图像,形状 \(3 \times H \times W\) | 建模外观、场景、物体 |
| Temporal stream | 连续光流堆叠,形状 \(2(T-1) \times H \times W\) | 建模运动方向和速度 |
Temporal stream 常使用 Early Fusion,因为多个光流帧直接沿通道堆叠,让第一层 2D 卷积处理整段运动信息。
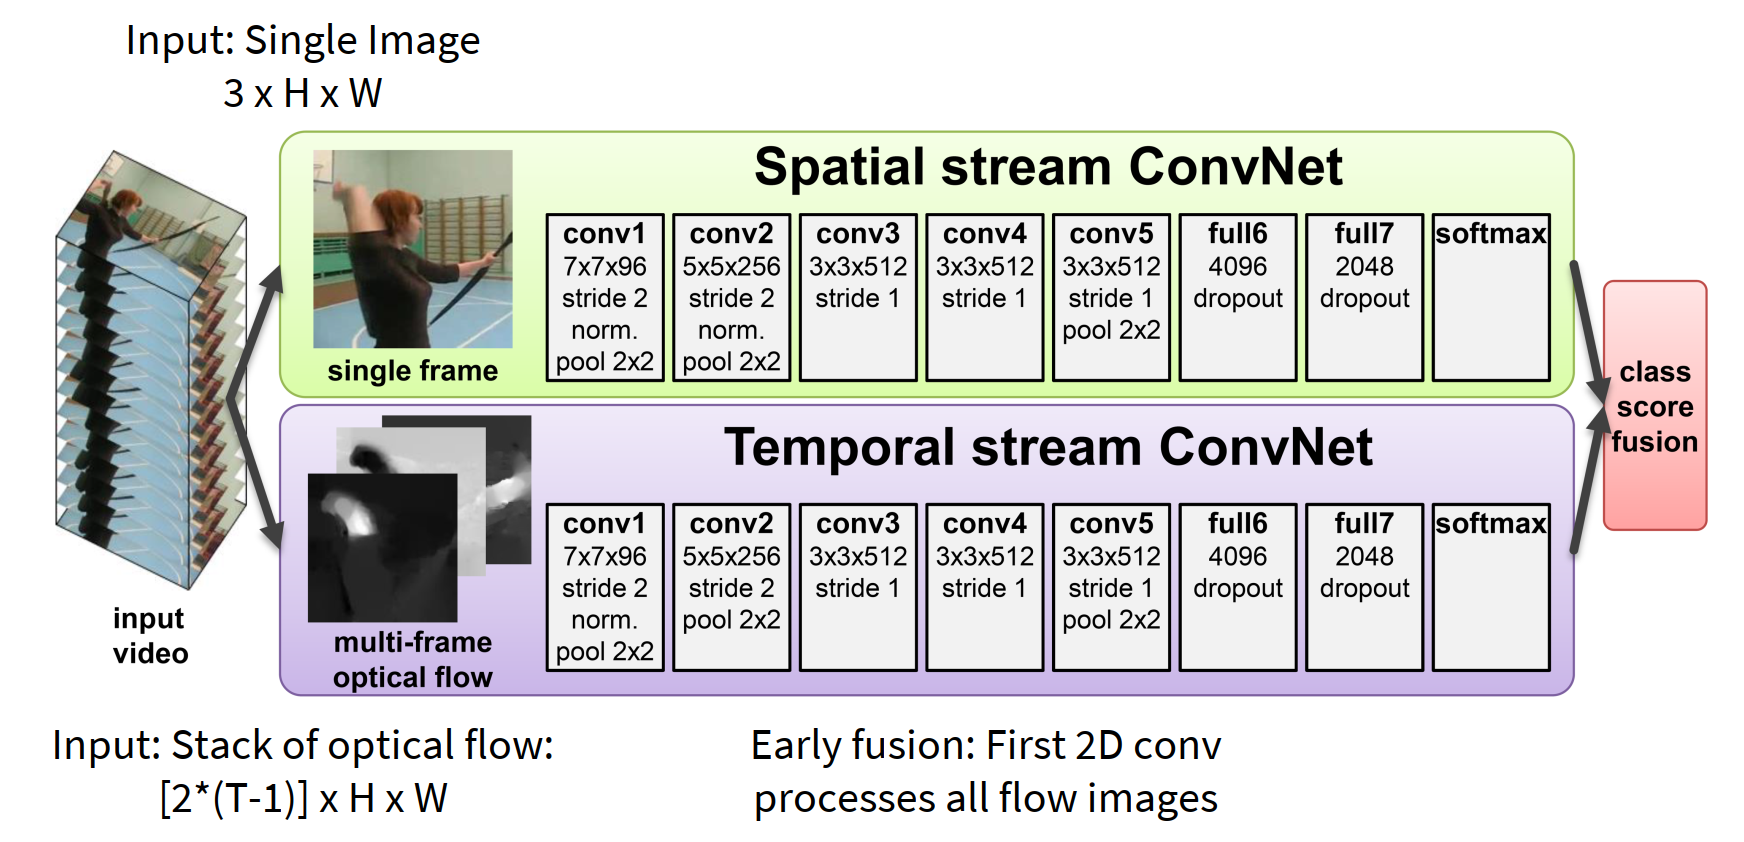
在 UCF-101 上,PPT 给出的大致结果为:
| 方法 | Accuracy |
|---|---|
| 3D CNN | 65.4 |
| Spatial only | 73.0 |
| Temporal only | 83.7 |
| Two-stream,平均融合 | 86.9 |
| Two-stream,SVM 融合 | 88.0 |
这个结果说明:在当时的数据和模型条件下,显式光流对动作识别非常有帮助,甚至 temporal stream 单独就超过 spatial stream。外观和运动互补,融合后效果最好。
5 长时序结构建模
5.1 短 clip 的局限
前面的 3D CNN、双流网络等通常处理约 2 到 5 秒的短 clip,擅长捕捉局部动作模式。但许多视频理解问题需要长时间结构。例如:
- 做饭包含拿食材、切菜、加热、装盘等阶段。
- 体育动作可能由准备、起跳、击球、落地组成。
- 复杂事件的类别取决于多个子事件的顺序。
因此问题变成:如何在局部时空特征之上建模长程依赖?
5.2 CNN + RNN / LSTM
一种自然方法是先用 CNN 提取每个时间片段的特征,再用循环网络处理这些特征序列:
\[ \text{Video} \rightarrow \text{CNN features} \rightarrow \text{RNN/LSTM} \rightarrow \text{Prediction} \]
根据任务不同,可以使用:
| 输出方式 | 适用任务 |
|---|---|
| Many-to-one | 整段视频分类,只在最后输出一个类别 |
| Many-to-many | 每帧或每个时间步输出,例如动作定位、逐帧标签 |
在实际训练中,有时不会把梯度反传回 CNN,而是先预训练 CNN,再把它当作固定特征提取器。这样可以节省显存和计算。
5.3 CNN 局部时间结构 vs RNN 全局时间结构
CNN 中的每个特征值只依赖一个固定大小的时间窗口,因此它天然建模局部时间结构。RNN 的隐藏状态则依赖过去所有时间步,因此理论上能建模全局时间结构。
两者可以互补:
- CNN 提供局部时空模式,例如短时间动作片段。
- RNN/LSTM 在这些局部特征之上整合更长时间的顺序关系。
不过 RNN 的主要问题是长序列处理慢,因为时间步之间存在递归依赖,难以完全并行化。
5.4 Recurrent Convolutional Network
Recurrent Convolutional Network 把 RNN 的递归结构和 CNN 的空间特征结合起来。每一层、每个时间步的特征图仍是:
\[ C \times H \times W \]
但当前特征依赖两个输入:
- 同一层前一时间步的特征。
- 前一层当前时间步的特征。
普通 RNN 的更新可以写成:
\[ h_t = \tanh(W_h h_{t-1} + W_x x_t) \]
Recurrent CNN 的关键是把矩阵乘法替换为 2D 卷积,使隐藏状态仍然保留空间结构:
\[ H_t^L = \tanh(W_h * H_{t-1}^L + W_x * H_t^{L-1}) \]
其中 \(*\) 表示卷积。这样模型既有递归时间建模,又不会像全连接 RNN 那样丢失空间布局。
6 时空自注意力、I3D 与 Video Transformer
6.1 Self-Attention 回顾
自注意力(Self-Attention)的核心是让每个 token 根据相似度从所有 token 聚合信息。给定输入向量 \(x_i\),先计算:
\[ q_i = x_i W_q,\quad k_i = x_i W_k,\quad v_i = x_i W_v \]
对第 \(j\) 个 query 和第 \(i\) 个 key 的匹配分数为:
\[ e_{i,j} = \frac{q_j \cdot k_i}{\sqrt{D}} \]
归一化得到注意力权重:
\[ a_{i,j} = \text{softmax}(e_{i,j}) \]
输出为 value 的加权和:
\[ y_j = \sum_i a_{i,j} v_i \]
自注意力的优势是可以直接建立远距离依赖,不需要像 CNN 那样通过多层局部卷积逐步扩大感受野,也不需要像 RNN 那样按时间顺序串行传播。
6.2 Spatio-Temporal Self-Attention 与 Nonlocal Block
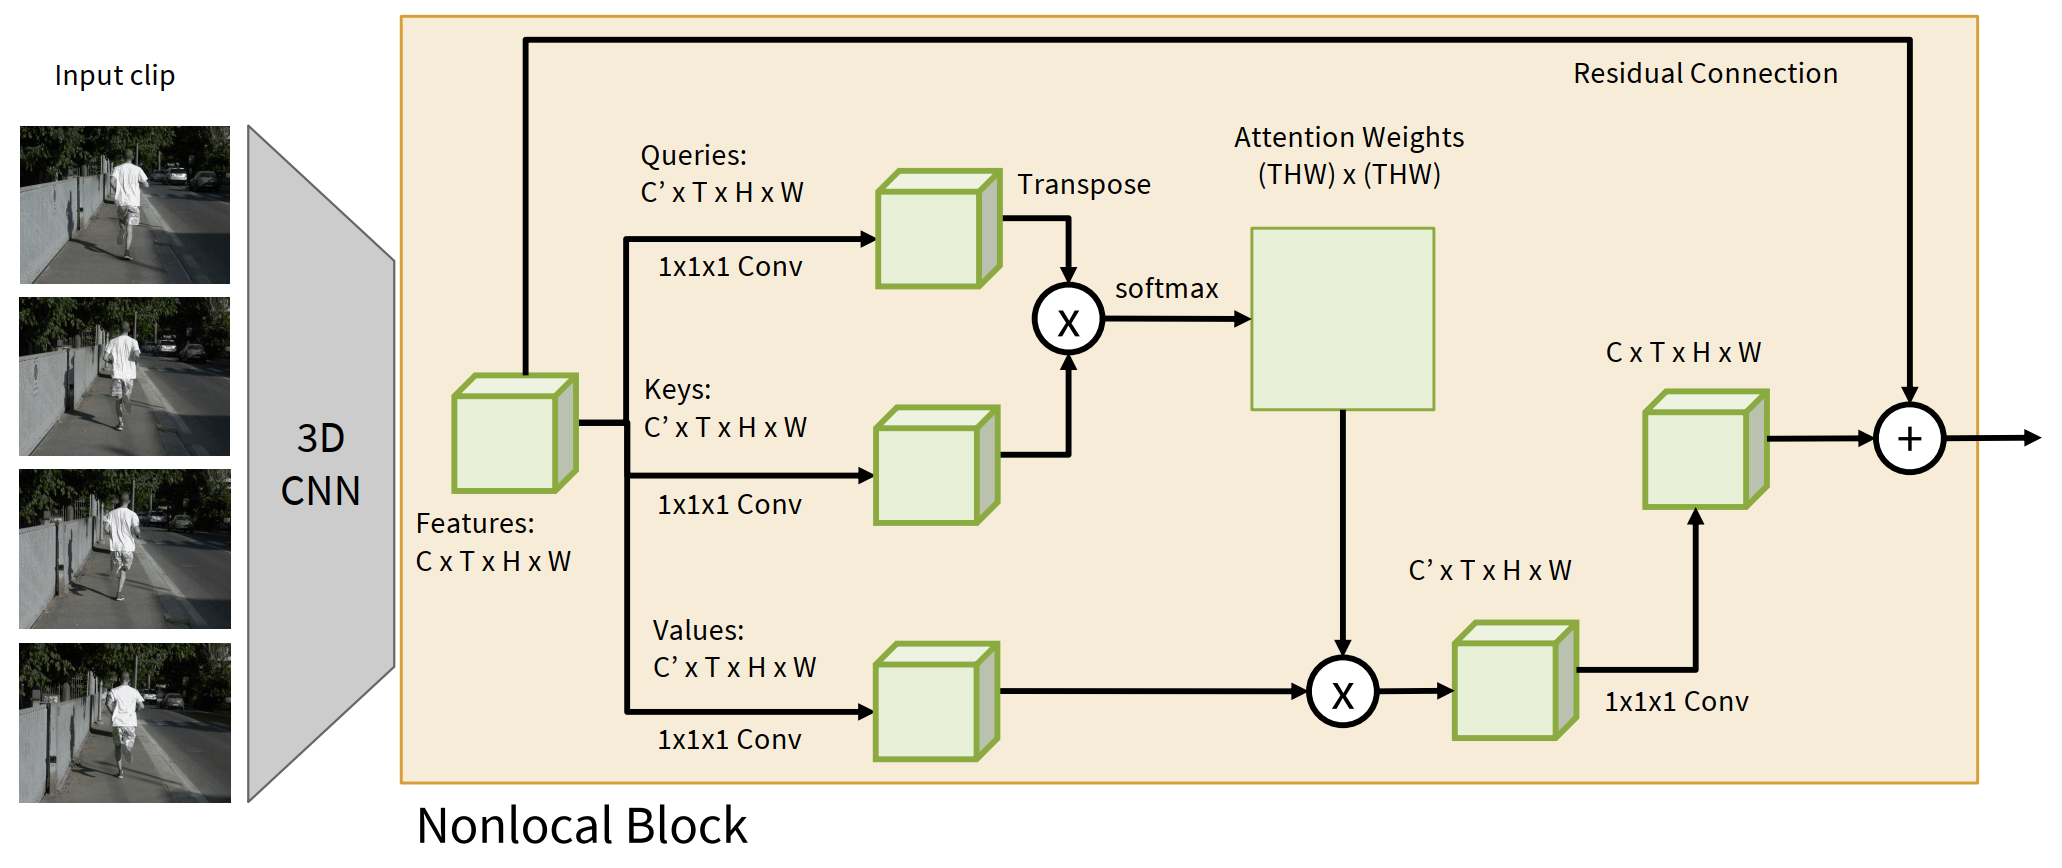
Nonlocal Block 将自注意力引入视频特征。假设 3D CNN 输出特征为:
\[ C \times T \times H \times W \]
首先用 \(1 \times 1 \times 1\) 卷积生成 query、key、value:
\[ Q,K,V \in C' \times T \times H \times W \]
然后把时空位置展平成 \(THW\) 个 token,计算大小为:
\[ (THW) \times (THW) \]
的注意力矩阵。这样任意两个时空位置之间都可以直接交互。例如,一个人在当前帧的手部位置可以关注到前几帧中的身体姿态或远处物体。
Nonlocal Block 通常还会通过 \(1 \times 1 \times 1\) 卷积映射回原通道数,并加上 residual connection。它可以插入已有 3D CNN 架构中,增强长距离时空依赖建模。
6.3 I3D:把 2D 图像网络膨胀到 3D
I3D(Inflated 3D ConvNet)的出发点是:图像领域已经有大量成熟 2D CNN 架构,能否把它们复用于视频?
方法是把 2D 卷积或池化层:
\[ K_h \times K_w \]
替换为 3D 版本:
\[ K_t \times K_h \times K_w \]
例如 Inception block 中的 \(3 \times 3\) 卷积可以膨胀成 \(3 \times 3 \times 3\) 卷积,\(1 \times 1\) 卷积变成 \(1 \times 1 \times 1\) 卷积。
I3D 还可以利用 ImageNet 预训练权重初始化 3D 卷积。设原 2D 卷积核为:
\[ C_{\text{out}} \times C_{\text{in}} \times K_h \times K_w \]
把它沿时间维复制 \(K_t\) 次,并除以 \(K_t\),得到:
\[ C_{\text{out}} \times C_{\text{in}} \times K_t \times K_h \times K_w \]
这样当输入视频在时间上是“常量视频”时,3D 卷积输出与原 2D 卷积保持一致。这是一个非常巧妙的初始化方式:既继承图像模型的表征能力,又允许模型继续学习时间特征。
6.4 Kinetics-400 上的模型趋势
PPT 展示了 Kinetics-400 上不同方法的 Top-1 Accuracy:
| 方法 | Top-1 Accuracy |
|---|---|
| Per-frame CNN | 62.2 |
| CNN + LSTM | 63.3 |
| Two-Stream CNN | 65.6 |
| I3D | 71.1 |
| Inflated I3D | 74.2 |
| SlowFast 16x8 + Nonlocal | 79.8 |
| MViTv2-L | 86.1 |
| VideoMAE V2-g | 90.0 |
可以看到,视频理解模型的发展趋势从手工加入光流、3D CNN、膨胀图像网络,逐渐走向更强的时空建模和大规模自监督预训练。
6.5 Vision Transformers for Video
Video Transformer 的关键挑战是 token 数量巨大。视频不仅有空间 patch,还有时间维,因此如果直接对所有时空 token 做全局注意力,计算成本会非常高。
PPT 提到几类重要思路:
| 思路 | 目的 |
|---|---|
| Factorized attention | 分解空间注意力和时间注意力,降低计算 |
| Pooling module / multiscale design | 减少 token 数量,在多尺度上建模 |
| Video masked autoencoders | 通过遮挡重建进行高效自监督预训练 |
现代方法如 MViT、VideoMAE 的性能显著超过早期 CNN/RNN/Two-Stream 方法,说明大规模预训练、Transformer 结构和高效 token 设计对视频理解非常关键。
7 从分类到定位、检测与可视化
7.1 可视化视频模型理解了什么
PPT 中展示了通过反向梯度可视化动作分类模型关注的内容。例如对 “weightlifting” 类别,可以分别观察:
- appearance:模型从静态外观中看到杠铃、身体姿态等信息。
- slow motion:模型关注较慢、稳定的动作变化。
- fast motion:模型关注快速运动,例如杠铃晃动或向上推举的瞬间。
这类可视化帮助我们理解:视频模型并不是只看“物体是什么”,也可能根据不同时间尺度的运动信息做判断。
7.2 Temporal Action Localization
前面的分类任务假设输入 clip 已经较短,且通常只需要输出一个动作类别。但现实视频常常是长而未裁剪的序列,其中不同时间段对应不同动作。
时间动作定位(Temporal Action Localization)的任务是:给定长视频,识别不同动作发生的时间区间。例如同一段视频中先 running,再 jumping。
PPT 提到可以使用类似 Faster R-CNN 的思想:先生成 temporal proposals,再对这些时间候选片段分类。这里的 proposal 不再是图像中的二维框,而是时间轴上的区间。
7.3 Spatio-Temporal Detection
时空检测(Spatio-Temporal Detection)更进一步:给定长视频,既要检测人物在每一帧中的空间位置,又要分类他们正在执行的动作。
这类任务的输出可以理解为“动作管道(action tube)”:空间上是随时间变化的 bounding boxes,时间上是动作发生的起止区间。AVA 数据集就是典型例子,它标注视频中人的空间位置和原子动作。
与视频分类相比,时空检测更接近真实应用,因为它要求模型回答:
- 谁在做动作?
- 动作发生在哪里?
- 动作发生在什么时候?
- 动作类别是什么?
8 多模态视频理解与高效视频理解
8.1 Temporal Stream 之外:音频与视觉融合
视频不仅包含视觉帧,还常常包含音频。PPT 后半部分从 temporal stream 扩展到多模态视频理解。一个经典例子是 McGurk effect:人类听到的音节会受到嘴型视觉信息影响,说明音频和视觉在感知中会相互融合。
在机器学习中,音频-视觉融合可以用于:
- 视觉引导的音频源分离。
- 音频-视觉活动识别。
- 多模态 masked autoencoder。
- 以音频作为预览信号来更高效地选择视频片段。
8.2 视觉引导的音频源分离
当多个说话者或多个乐器同时发声时,视觉信息可以帮助分离音频。例如看到左侧说话者的嘴在动,模型就可以把混合语音中的对应声源分离出来。类似地,在乐器视频中,模型可以根据不同乐器的视觉区域分离对应声音。
这说明视频理解并不只是“看帧”,而是可以把视觉、音频和时间对齐起来,学习跨模态对应关系。
8.3 Efficient Video Understanding
长视频理解非常昂贵,因此高效视频理解是一条重要方向。PPT 提到的方法包括:
| 方法方向 | 代表例子 | 核心动机 |
|---|---|---|
| 高效模型架构 | MoViNets, X3D | 减少视频模型计算量 |
| 显著 clip 采样 | SCSampler | 只处理信息量大的片段 |
| 自适应多模态学习 | AdaMML | 根据输入动态选择模态或计算路径 |
| 音频预览视觉 | Listen to Look | 用音频线索决定看哪些视频片段 |
高效视频理解的核心问题是:不是每一帧都同样重要。模型应当学会在长视频中选择关键时刻、关键模态和合适的计算量。
8.4 Egocentric Video 与 Video LLMs
PPT 最后还提到第一人称/自我中心视频(Egocentric Video)和 Video Understanding + LLMs。第一人称视频往往包含摄像头佩戴者的视角、麦克风阵列、人与人的互动等,适合研究日常活动、对话图结构和具身智能。
Video LLMs 则把视频理解与大语言模型结合起来,目标不只是分类动作,而是进行更细粒度的视频问答、描述、推理和对齐。例如 Video-LLaVA、Video-ChatGPT、VideoLLaMA 等工作都试图让模型以自然语言方式理解视频内容。
9 复习重点与易混点
9.1 核心概念总结
| 概念 | 一句话理解 |
|---|---|
| Video tensor | 视频是图像序列,常写为 \(T \times 3 \times H \times W\) 或 \(3 \times T \times H \times W\) |
| Clip training | 用短片段、低帧率、低分辨率训练,测试时多 clip 平均 |
| Single-Frame CNN | 强基线,只看单帧外观,不显式建模运动 |
| Late Fusion | 每帧先独立提特征,最后融合时间 |
| Early Fusion | 一开始把所有帧堆到通道维,第一层融合时间 |
| 3D CNN | 卷积核在时间和空间上滑动,逐层融合时空信息 |
| Optical Flow | 相邻帧像素位移场,显式表示局部运动 |
| Two-Stream | RGB 外观流 + 光流运动流 |
| CNN + RNN | CNN 提取局部特征,RNN/LSTM 建模长时序 |
| Nonlocal Block | 在 \(THW\) 个时空位置上做自注意力 |
| I3D | 把 2D 图像网络膨胀成 3D 视频网络,并可复用 ImageNet 权重 |
| Video Transformer | 用注意力建模视频,但必须处理 token 数量和计算成本 |
9.2 Early Fusion、Late Fusion、3D CNN 的易混点
Late Fusion 不是完全不融合时间,而是在高层或最后池化时融合。因此它能利用多帧信息,但很难比较低层运动。
Early Fusion 不是 3D CNN。它虽然一开始看到所有帧,但之后时间维被压入通道维,缺少时间滑动和时间平移不变性。
3D CNN 的关键不是“输入多帧”本身,而是卷积核在时间维上滑动,使局部运动模式可以在任意时间位置被同一组权重识别。
9.3 光流与 3D CNN 的区别
光流是显式预计算的运动表示,告诉模型像素如何移动;3D CNN 是从 RGB clip 中学习隐式时空特征。双流网络把两者结合:RGB 流提供外观,光流流提供运动。
现代视频模型常常不再依赖传统光流,原因是光流计算昂贵,而且大规模 3D CNN / Transformer 可以直接从数据中学习运动表征。但从概念上,光流仍然是理解视频动作识别的重要桥梁。
9.4 可能的考试题方向
- 解释为什么视频比图像更难处理,并写出视频张量形状。
- 比较 Single-Frame CNN、Early Fusion、Late Fusion 和 3D CNN 的优缺点。
- 说明为什么 3D 卷积具有时间平移不变性,而 Early Fusion 没有。
- 定义 optical flow,并解释它如何用于 Two-Stream Networks。
- 解释 CNN + RNN 如何结合局部时空特征和长时序依赖。
- 描述 Nonlocal Block 如何在 \(T \times H \times W\) 的时空位置上做自注意力。
- 说明 I3D 如何把 2D CNN 膨胀到 3D,并如何初始化 3D 卷积权重。
- 解释为什么现代 Video Transformer 需要 factorized attention、pooling 或 masked autoencoder 预训练。
- 区分视频分类、时间动作定位和时空检测。
- 举例说明音频-视觉融合为什么能改善视频理解。
9.5 本讲主线
本讲的主线可以概括为:
视频 = 图像 + 时间。 最简单的单帧模型已经很强,但它无法真正理解运动。Early Fusion、Late Fusion 和 3D CNN 是对时间建模的三种基本方式,其中 3D CNN 通过时空卷积逐层建立时间感受野。光流和双流网络显式利用运动信息,RNN/LSTM 用于更长时间结构,Nonlocal Block 和 Video Transformer 则通过注意力直接建模远距离时空依赖。随着任务扩展,视频理解从短 clip 分类走向动作定位、时空检测、多模态理解、高效长视频处理和 Video LLMs。