1 Transformer 与 Vision Transformer 回顾
1.1 三种序列处理方式
课件先回顾了三种处理序列或结构化输入的方式:循环神经网络(Recurrent Neural Network, RNN)、卷积(Convolution)和自注意力(Self-Attention)。
| 方法 | 适合的数据结构 | 优点 | 局限 |
|---|---|---|---|
| RNN | 一维有序序列 | 理论上对长度为 \(N\) 的序列只需要 \(O(N)\) 计算和内存,能逐步累积历史信息 | 隐状态必须按时间顺序计算,不易并行 |
| 卷积 | \(N\) 维规则网格,例如图像 | 各位置输出可以并行计算,局部结构建模强 | 长距离依赖需要堆很多层扩大感受野 |
| 自注意力 | 向量集合或 token 序列 | 每个输出能直接依赖所有输入,矩阵乘法形式高度并行 | 标准注意力计算量约为 \(O(N^2)\),长序列代价高 |
自注意力的核心思想是:每个输入 token 产生查询(Query)、键(Key)、值(Value),用查询和键计算相似度,再用 softmax 得到权重,对值向量做加权求和。它不像卷积那样预设局部邻域,因此非常适合捕捉全局关系。
1.2 Vision Transformer(ViT)的基本流程
Vision Transformer 把图像转换成类似 NLP token 的序列,然后直接套用 Transformer。以 \(224 \times 224 \times 3\) 图像和 \(16 \times 16\) patch 为例:
- 将输入图像切成固定大小的图像块(patch)。每个 patch 形状为 \(16 \times 16 \times 3\),展平后长度为 \(768\)。
- 用线性投影把每个 patch 映射成 \(D\) 维向量。
- 为每个位置加入可学习的位置编码(positional embedding),让模型知道 patch 在二维图像中的位置。
- 不使用因果 masking,每个图像 patch 都可以 attend 到所有其他 patch。
- Transformer 输出每个 patch 对应的 \(D\) 维向量。
- 分类时可以使用额外的分类 token(class token),或对所有 patch 输出做平均池化,再接线性层得到 \(C\) 类分类分数。
考试重点:ViT 并不是在像素网格上做卷积,而是把图像变成 patch token 序列。它的空间信息主要来自位置编码,全局交互来自自注意力。
1.3 Transformer 常见现代改动
虽然 2017 年以来 Transformer 主体变化不大,但一些工程上常见的改动已成为大模型和视觉 Transformer 的常规组件。
1.3.1 Pre-Norm Transformer
原始结构中 Layer Normalization 放在残差连接之外,这会带来一个有点奇怪的问题:模型难以严格学习恒等映射。Pre-Norm 把归一化移动到 Self-Attention 和 MLP 之前,也就是残差分支内部:
\[ x_{l+1} = x_l + \mathrm{Block}(\mathrm{Norm}(x_l)) \]
这样训练通常更稳定,尤其在层数很深时更明显。
1.3.2 RMSNorm
RMSNorm(Root-Mean-Square Normalization)用均方根归一化替代 LayerNorm。对输入 \(x \in \mathbb{R}^D\),输出为:
\[ y_i = \frac{x_i}{\mathrm{RMS}(x)} \gamma_i \]
其中
\[ \mathrm{RMS}(x) = \sqrt{\epsilon + \frac{1}{D}\sum_{i=1}^{D}x_i^2} \]
它不像 LayerNorm 那样显式减去均值,计算更简洁,训练也往往更稳定。
1.3.3 SwiGLU MLP
经典 Transformer MLP 通常写作:
\[ Y = \sigma(XW_1)W_2 \]
其中 \(X \in \mathbb{R}^{N \times D}\),\(W_1 \in \mathbb{R}^{D \times 4D}\),\(W_2 \in \mathbb{R}^{4D \times D}\)。SwiGLU 使用门控结构:
\[ Y = \left(\sigma(XW_1) \odot XW_2\right)W_3 \]
门控项让模型可以按维度控制信息通过程度。课件指出,当隐藏维度设为 \(H=\frac{8D}{3}\) 时,总参数量可以与经典 MLP 大致相当。
1.3.4 Mixture of Experts(MoE)
MoE 在每个 block 中学习 \(E\) 套不同的 MLP 权重,每套 MLP 称为一个专家(expert)。每个 token 只路由到 \(A<E\) 个活跃专家。这样参数量可以增加 \(E\) 倍,但每次前向计算只增加约 \(A\) 倍。
核心直觉:MoE 用“条件计算”换取更大的模型容量。不是每个输入都跑完整模型,而是让不同 token 使用不同专家。
2 视觉任务全景:分类、语义分割、目标检测、实例分割
课件用四类任务建立视觉问题的层级:
| 任务 | 输出形式 | 是否有空间范围 | 是否区分实例 |
|---|---|---|---|
| 图像分类(Classification) | 整张图一个类别,例如 cat | 否 | 否 |
| 语义分割(Semantic Segmentation) | 每个像素一个语义类别,例如 sky/cat/tree/grass | 是,像素级 | 否 |
| 目标检测(Object Detection) | 每个目标的类别与边界框,例如 dog: \((x,y,w,h)\) | 是,框级 | 是 |
| 实例分割(Instance Segmentation) | 每个目标的类别、边界框和 mask | 是,像素级 | 是 |
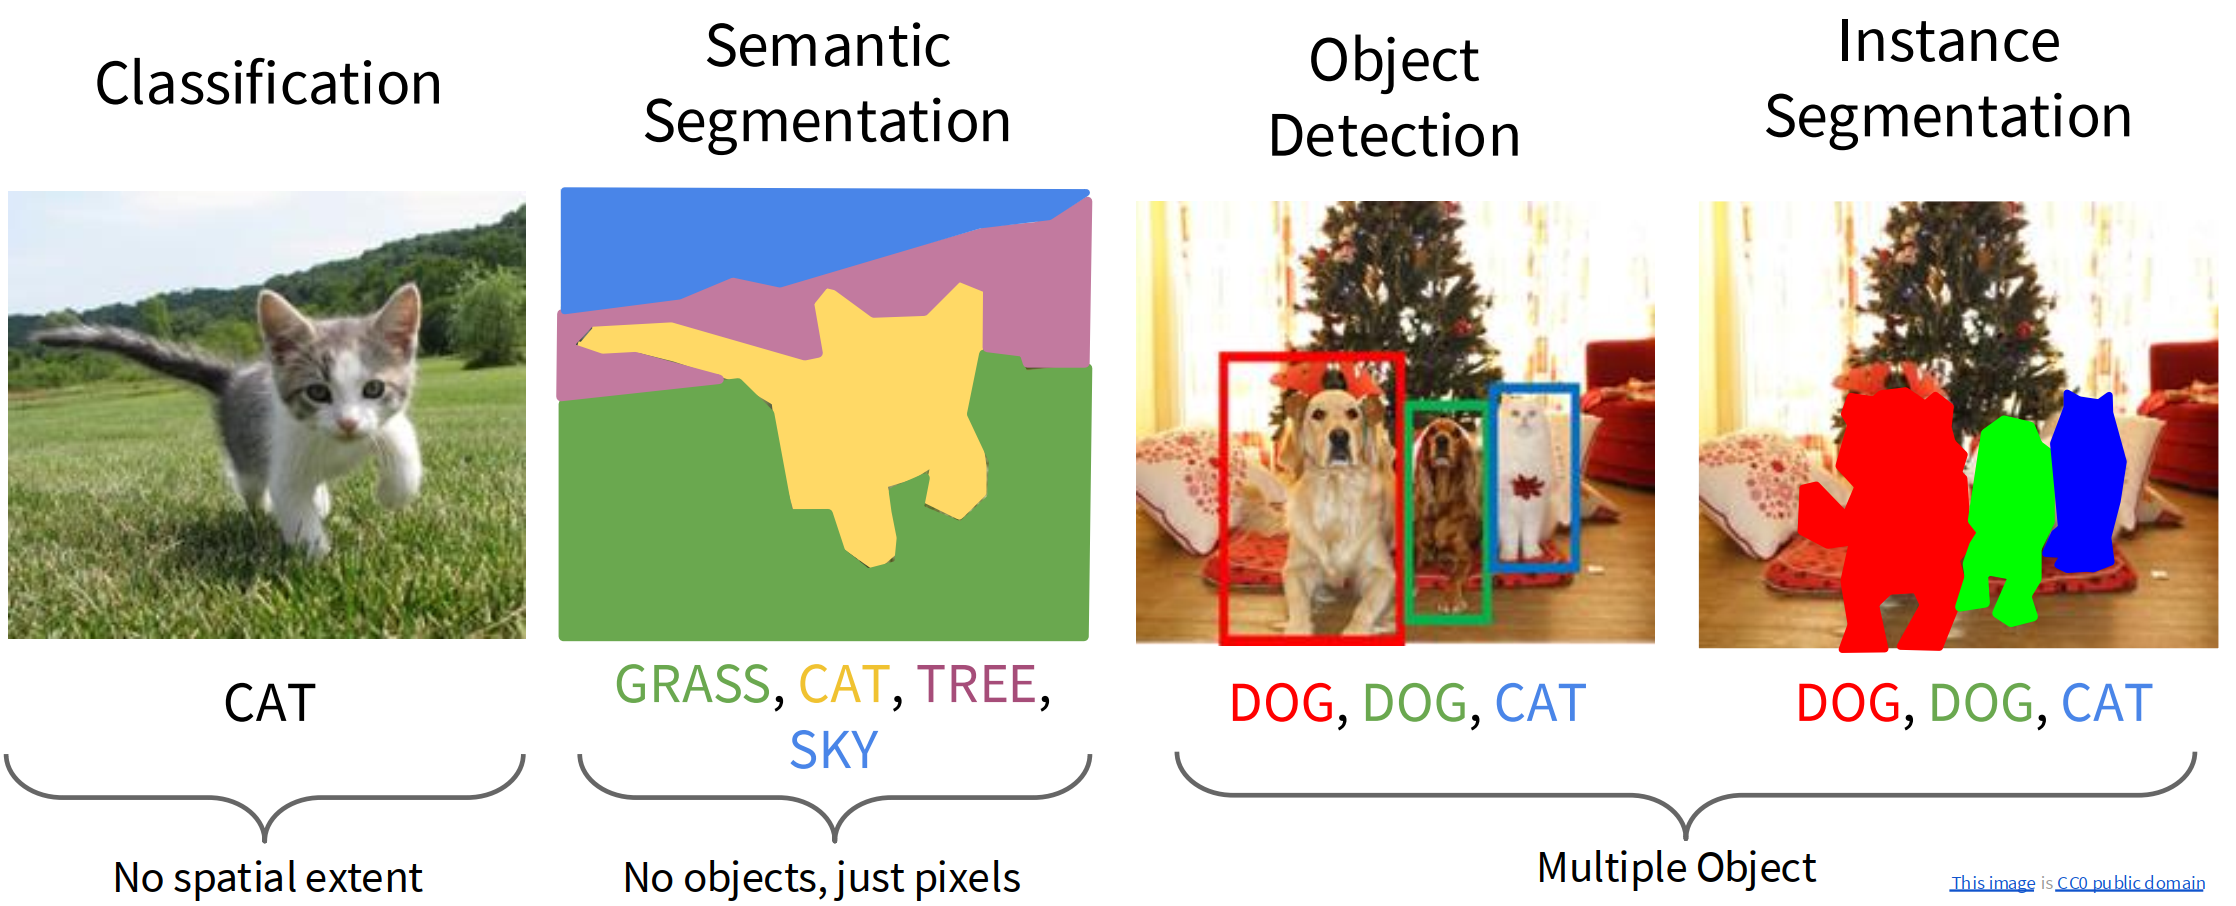
这四类任务的关系可以理解为:分类只问“图里有什么”;语义分割问“每个像素是什么”;目标检测问“每个物体在哪里、是什么”;实例分割进一步问“每个物体精确覆盖哪些像素”。
3 语义分割(Semantic Segmentation)
3.1 问题定义
语义分割的训练数据是成对的图像和像素标签。每张训练图像中,每个像素都被标注为一个语义类别。测试时,模型需要对新图像的每个像素输出类别。
语义分割不区分同类物体的不同实例。例如图中有两头牛,语义分割只会把相关像素标成 cow,而不会标成 cow 1 和 cow 2。
3.2 滑动窗口方法及其问题
早期直觉做法是滑动窗口:对每个待分类像素,截取其周围 patch,用 CNN 分类中心像素。这样能利用局部上下文,因为只看单个像素几乎无法判断类别。
问题是它非常低效。相邻像素的 patch 高度重叠,但模型会重复计算几乎相同的卷积特征。对于整张图逐像素分类,计算量不可接受。
3.3 全卷积网络(Fully Convolutional Network, FCN)
更自然的思路是一次性把整张图送入卷积网络,输出形状为 \(C \times H \times W\) 的类别分数图,再对每个像素取 argmax 得到 \(H \times W\) 的预测图。
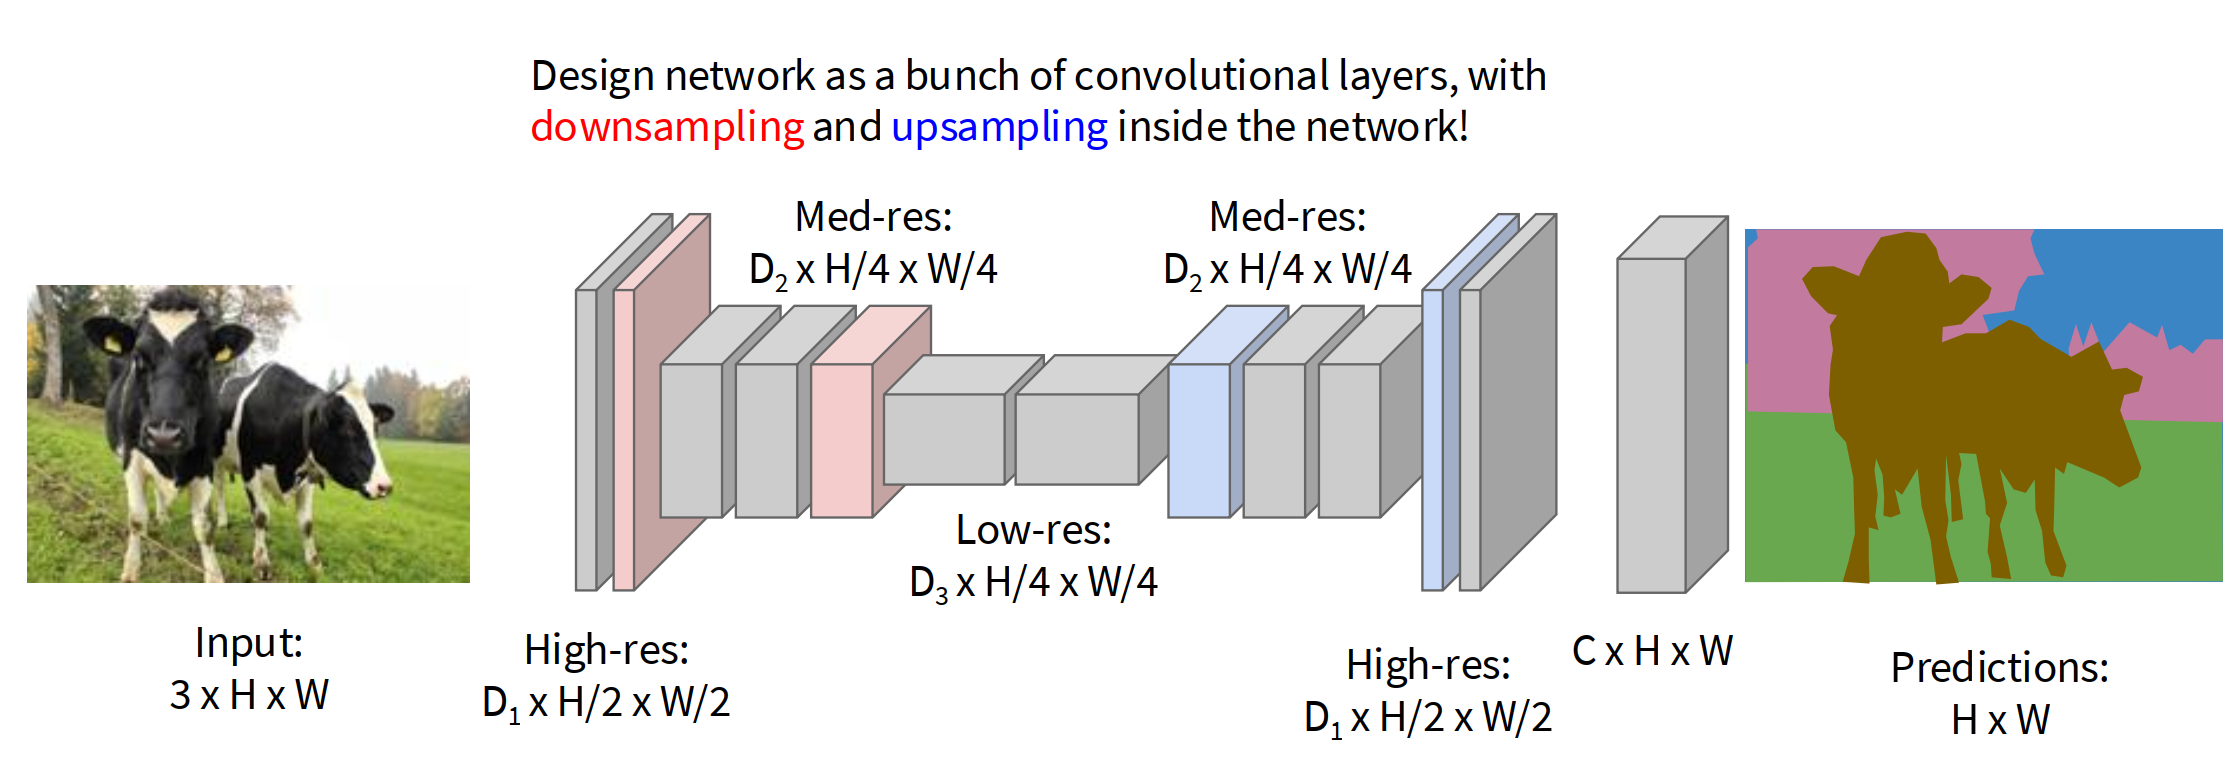
如果完全不下采样,所有卷积都在原始分辨率上运行,计算非常贵。因此实际分割网络通常采用编码器-解码器结构:
- 编码器阶段用池化或带步长卷积下采样,扩大感受野并提取高级语义特征。
- 解码器阶段用上采样恢复空间分辨率,最后输出与输入同尺寸的像素分类结果。
3.4 上采样方法
课件介绍了几种网络内上采样方式。它们都解决同一个问题:编码器得到的特征图空间分辨率较低,例如 \(H/4 \times W/4\),但语义分割最终需要回到 \(H \times W\) 的像素级预测。不同方法的差别在于:是否可学习、是否保留池化时的位置信息、恢复出的高分辨率特征是否平滑或稀疏。
3.4.1 最近邻上采样(Nearest Neighbor)
最近邻上采样是最直接的方法:把低分辨率特征中的每个值复制到高分辨率网格中的一块区域。比如一个 \(2 \times 2\) 输入
\[ \begin{bmatrix} 1 & 2 \\ 3 & 4 \end{bmatrix} \]
放大 2 倍后会变成
\[ \begin{bmatrix} 1 & 1 & 2 & 2 \\ 1 & 1 & 2 & 2 \\ 3 & 3 & 4 & 4 \\ 3 & 3 & 4 & 4 \end{bmatrix} \]
它的优点是简单、计算便宜、不会引入额外参数。缺点也很明显:复制操作本身不会学习“怎样恢复边界细节”,输出容易块状化。如果后面再接卷积层,网络可以在复制后的高分辨率特征上继续学习细化;如果只靠最近邻上采样,恢复能力就比较有限。
适合理解为:先粗暴地把特征图尺寸放大,再交给后续卷积去修边。
3.4.2 Bed of Nails
Bed of Nails 也是一种固定规则的上采样,但它不是复制数值,而是把原来的值放到放大网格的固定位置,其余位置填 0。仍以 \(2 \times 2\) 输入为例,放大 2 倍后可以得到:
\[ \begin{bmatrix} 1 & 0 & 2 & 0 \\ 0 & 0 & 0 & 0 \\ 3 & 0 & 4 & 0 \\ 0 & 0 & 0 & 0 \end{bmatrix} \]
这种结果非常稀疏,看起来不像最终想要的分割图,但它有一个重要作用:帮助理解转置卷积。可以把 Bed of Nails 看成“先把低分辨率输入插到高分辨率网格上并补零”,然后再用卷积核对这个稀疏网格做可学习的平滑和填充。
它本身通常不是最终单独使用的高质量上采样方法,因为补零会产生大量空洞位置;但作为转置卷积的直觉模型很有用。
适合理解为:把低分辨率特征“钉”到高分辨率画布上,空白处等待后续卷积填补。
3.4.3 Max Unpooling
Max Unpooling 与 Max Pooling 成对出现。Max Pooling 下采样时,每个池化窗口只保留最大值。例如一个 \(2 \times 2\) 窗口中最大值在右上角,那么池化输出只记住这个最大值。Max Unpooling 的关键是:池化时不仅保存最大值,还保存最大值来自窗口中的哪个位置,也就是 pooling indices。
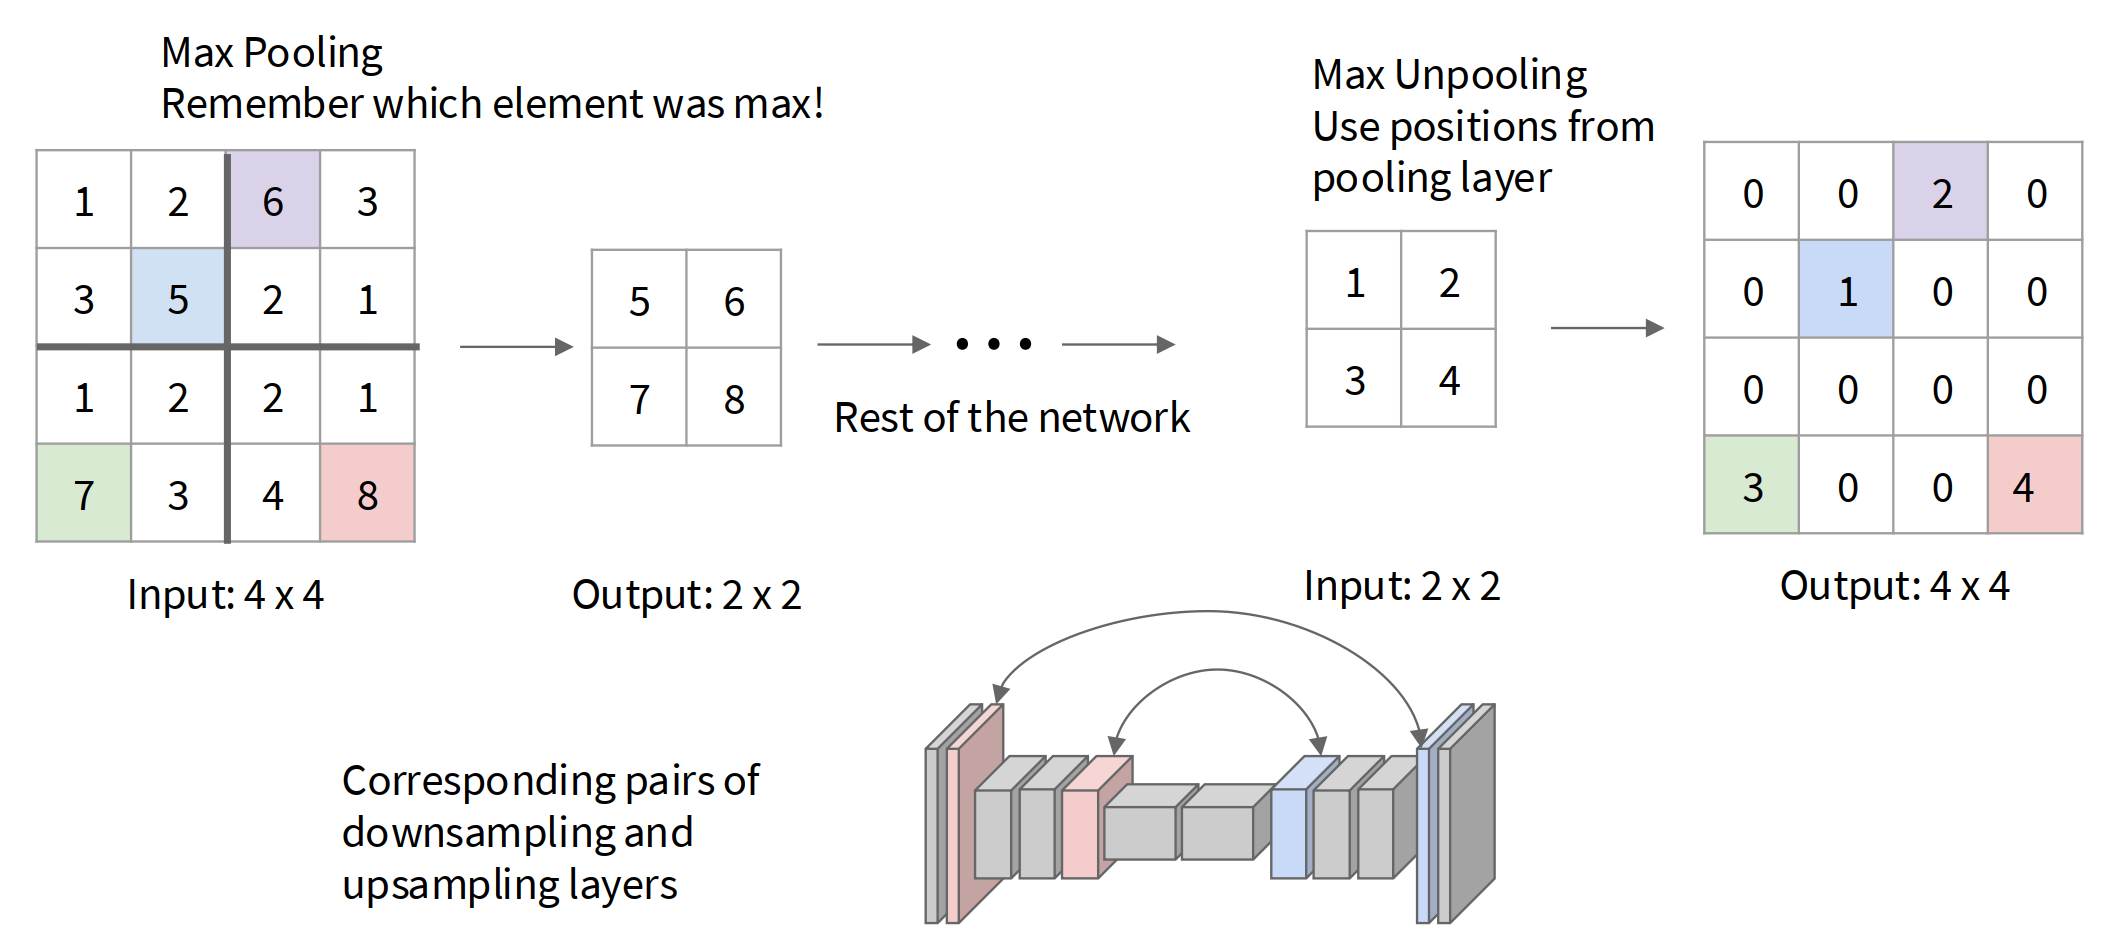
上采样时,Max Unpooling 会把低分辨率特征值放回当初最大值所在的位置,其余位置填 0。例如某个 \(2 \times 2\) 池化窗口最大值来自右上角,则反池化时该值也回到右上角。
这种方法的优点是利用了下采样阶段留下来的空间位置信息,比盲目复制更知道“强响应原本在哪里”。缺点是它依赖对应的 Max Pooling 层,必须额外保存 indices;同时未被选中的位置仍然填 0,所以通常还需要后续卷积来补全稀疏特征。
适合理解为:下采样时记住“赢家的位置”,上采样时让赢家回到原来的格子里。
3.4.4 转置卷积(Transposed Convolution)
转置卷积是可学习的上采样方法。普通卷积中,输出的每个位置来自输入局部窗口与卷积核的点积;如果 stride 为 2,卷积核在输入上每移动 2 个像素,输出移动 1 个位置,因此空间尺寸下降。转置卷积则把这个空间关系反过来:输入每移动 1 个位置,卷积核在输出空间移动 \(s\) 个像素,并把贡献累加到输出图上。
课件中的 1D 例子可以这样理解。输入为 \(a,b\),卷积核为 \(x,y,z\)。转置卷积会让每个输入值生成一份“按该值加权的卷积核副本”:
\[ a[x,y,z] = [ax, ay, az] \]
\[ b[x,y,z] = [bx, by, bz] \]
如果 stride 使两份副本在输出空间发生重叠,那么重叠位置相加,可能得到类似:
\[ [ax,\ ay,\ az+bx,\ by,\ bz] \]
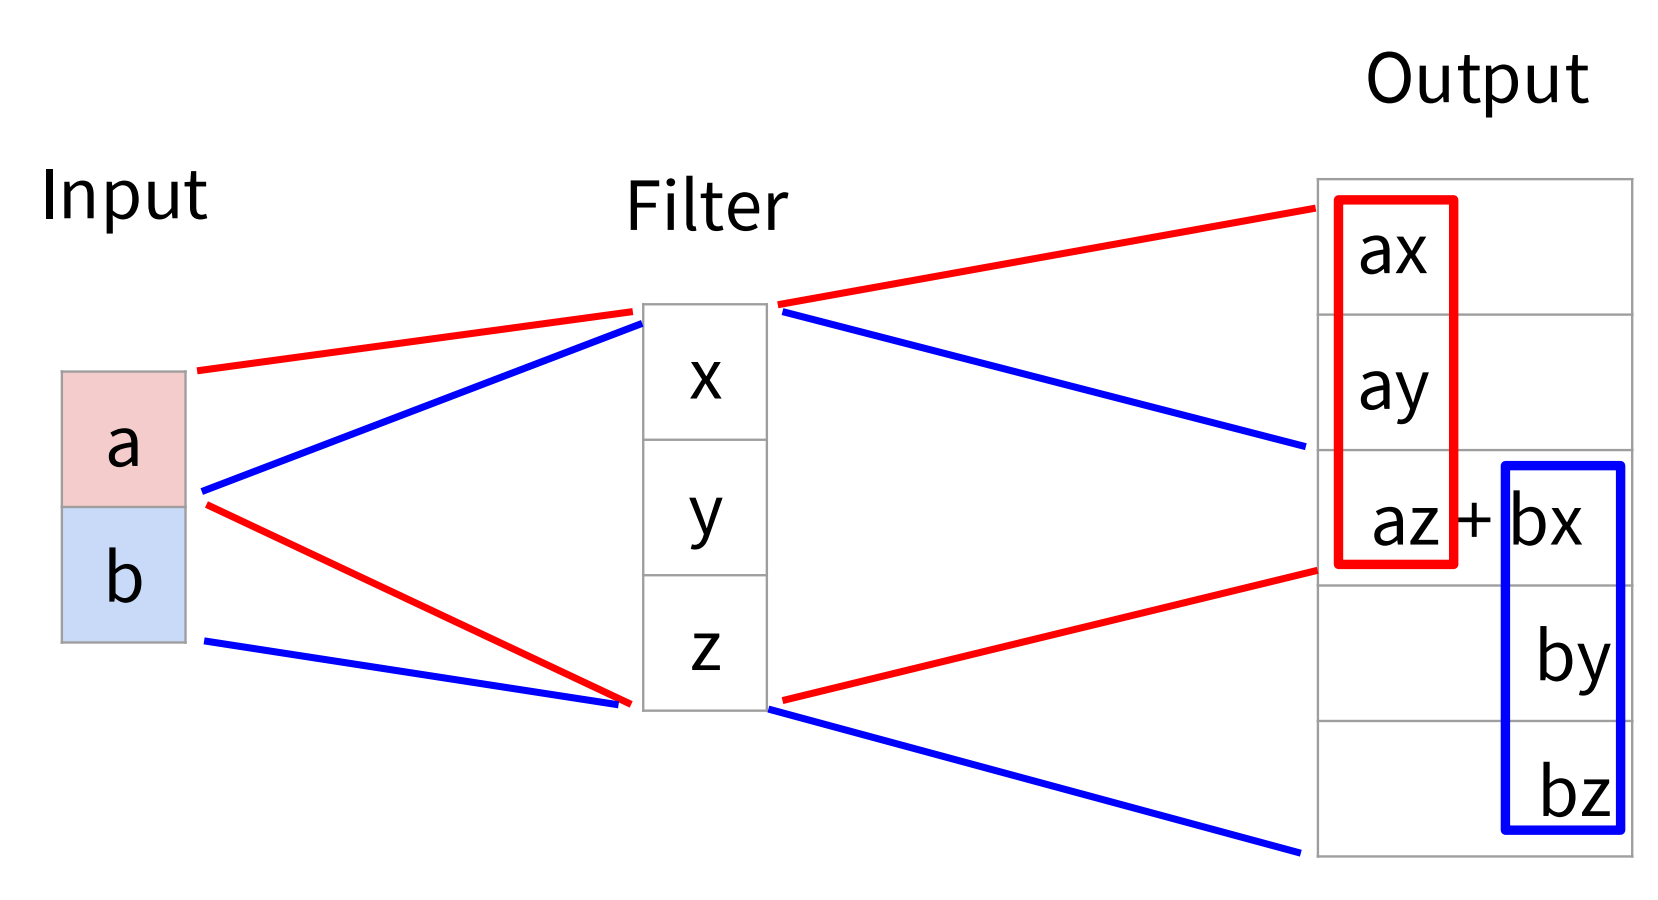
二维情况下也是同一个道理:低分辨率特征图中的每个位置都会在高分辨率输出图上“铺开”一个可学习卷积核,多个位置铺开的结果在重叠处求和。
举一个最小的二维例子。假设输入特征图是 \(2 \times 2\):
\[ X = \begin{bmatrix} a & b \\ c & d \end{bmatrix} \]
卷积核是 \(2 \times 2\):
\[ K = \begin{bmatrix} w_1 & w_2 \\ w_3 & w_4 \end{bmatrix} \]
如果使用 stride \(=2\) 的转置卷积,并且不考虑 padding,每个输入元素都会在输出图上放下一块按自身数值缩放的 \(2 \times 2\) 卷积核。由于 stride 等于卷积核大小,这个例子中各块刚好不重叠,输出为 \(4 \times 4\):
\[ Y = \begin{bmatrix} aw_1 & aw_2 & bw_1 & bw_2 \\ aw_3 & aw_4 & bw_3 & bw_4 \\ cw_1 & cw_2 & dw_1 & dw_2 \\ cw_3 & cw_4 & dw_3 & dw_4 \end{bmatrix} \]
这说明转置卷积不是简单复制像素,而是让每个低分辨率位置生成一个由可学习参数控制的小模式。若 kernel size 大于 stride,例如 kernel size \(=3\)、stride \(=2\),相邻输入位置铺开的 \(3 \times 3\) 小块会发生重叠,重叠处会把来自多个输入位置的贡献相加。因为卷积核参数可学习,所以模型能根据训练数据学习如何恢复更合理的边界、形状和局部结构。
普通带步长卷积可以看作可学习下采样:
\[ \text{input movement } s \rightarrow \text{output movement } 1 \]
转置卷积可以看作可学习上采样:
\[ \text{input movement } 1 \rightarrow \text{output movement } s \]
需要注意,转置卷积有时会产生棋盘格伪影(checkerboard artifacts),尤其当 kernel size、stride 和 padding 搭配不当时。实际网络中常见的替代做法是“插值上采样 + 普通卷积”,但本讲重点是理解转置卷积如何作为网络内部的可学习上采样层。
适合理解为:每个低分辨率位置都向高分辨率画布投放一个可学习的小模板,重叠处相加,最终学出放大后的特征图。
3.5 U-Net
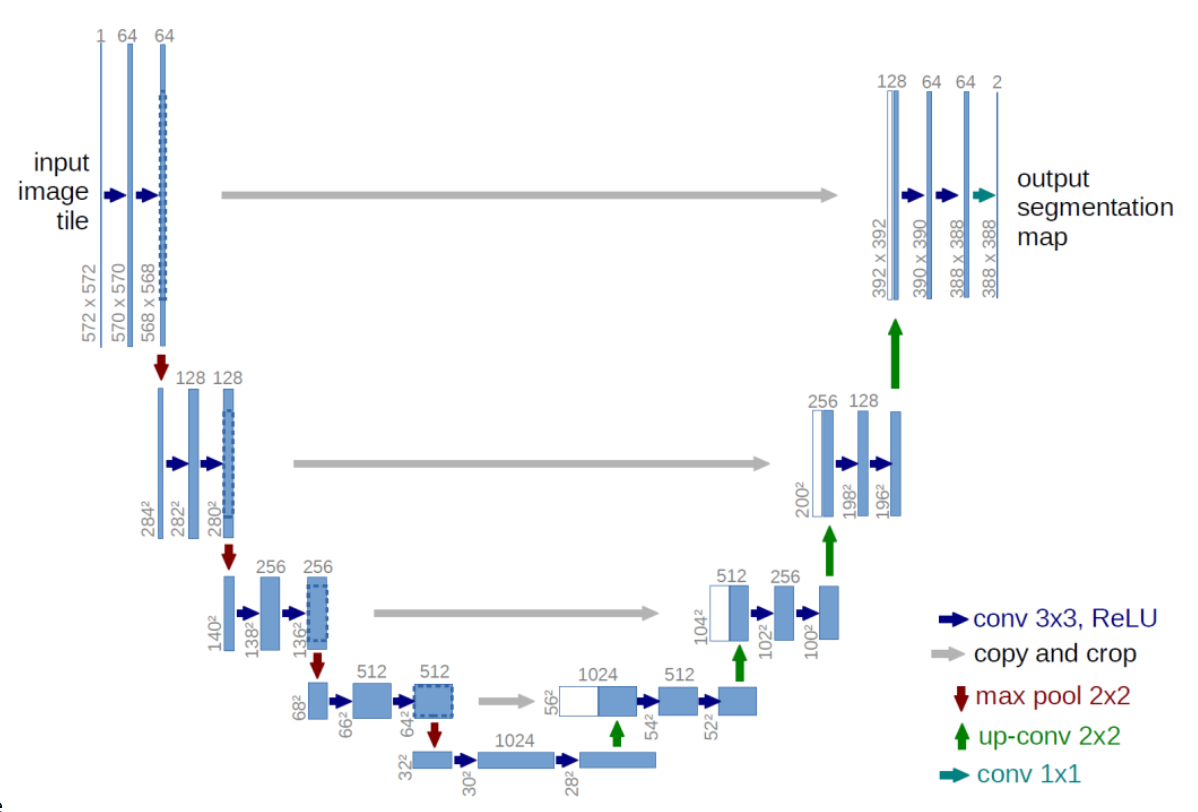
U-Net 是语义分割中的经典架构。它包含一个下采样路径和一个上采样路径:
- 下采样阶段逐步扩大感受野,提取高级语义,但会丢失精细空间信息。
- 上采样阶段恢复高分辨率预测。
- 关键设计是跳跃连接(skip connection):把下采样阶段的高分辨率特征与上采样阶段对应层拼接,使模型同时利用语义信息和细节位置信息。
直觉例子:判断“这是猫”需要高级语义特征,但确定猫耳朵边界需要低层空间细节。U-Net 的跳跃连接正是把这两类信息接起来。
4 目标检测(Object Detection)
4.1 单目标检测:分类 + 定位
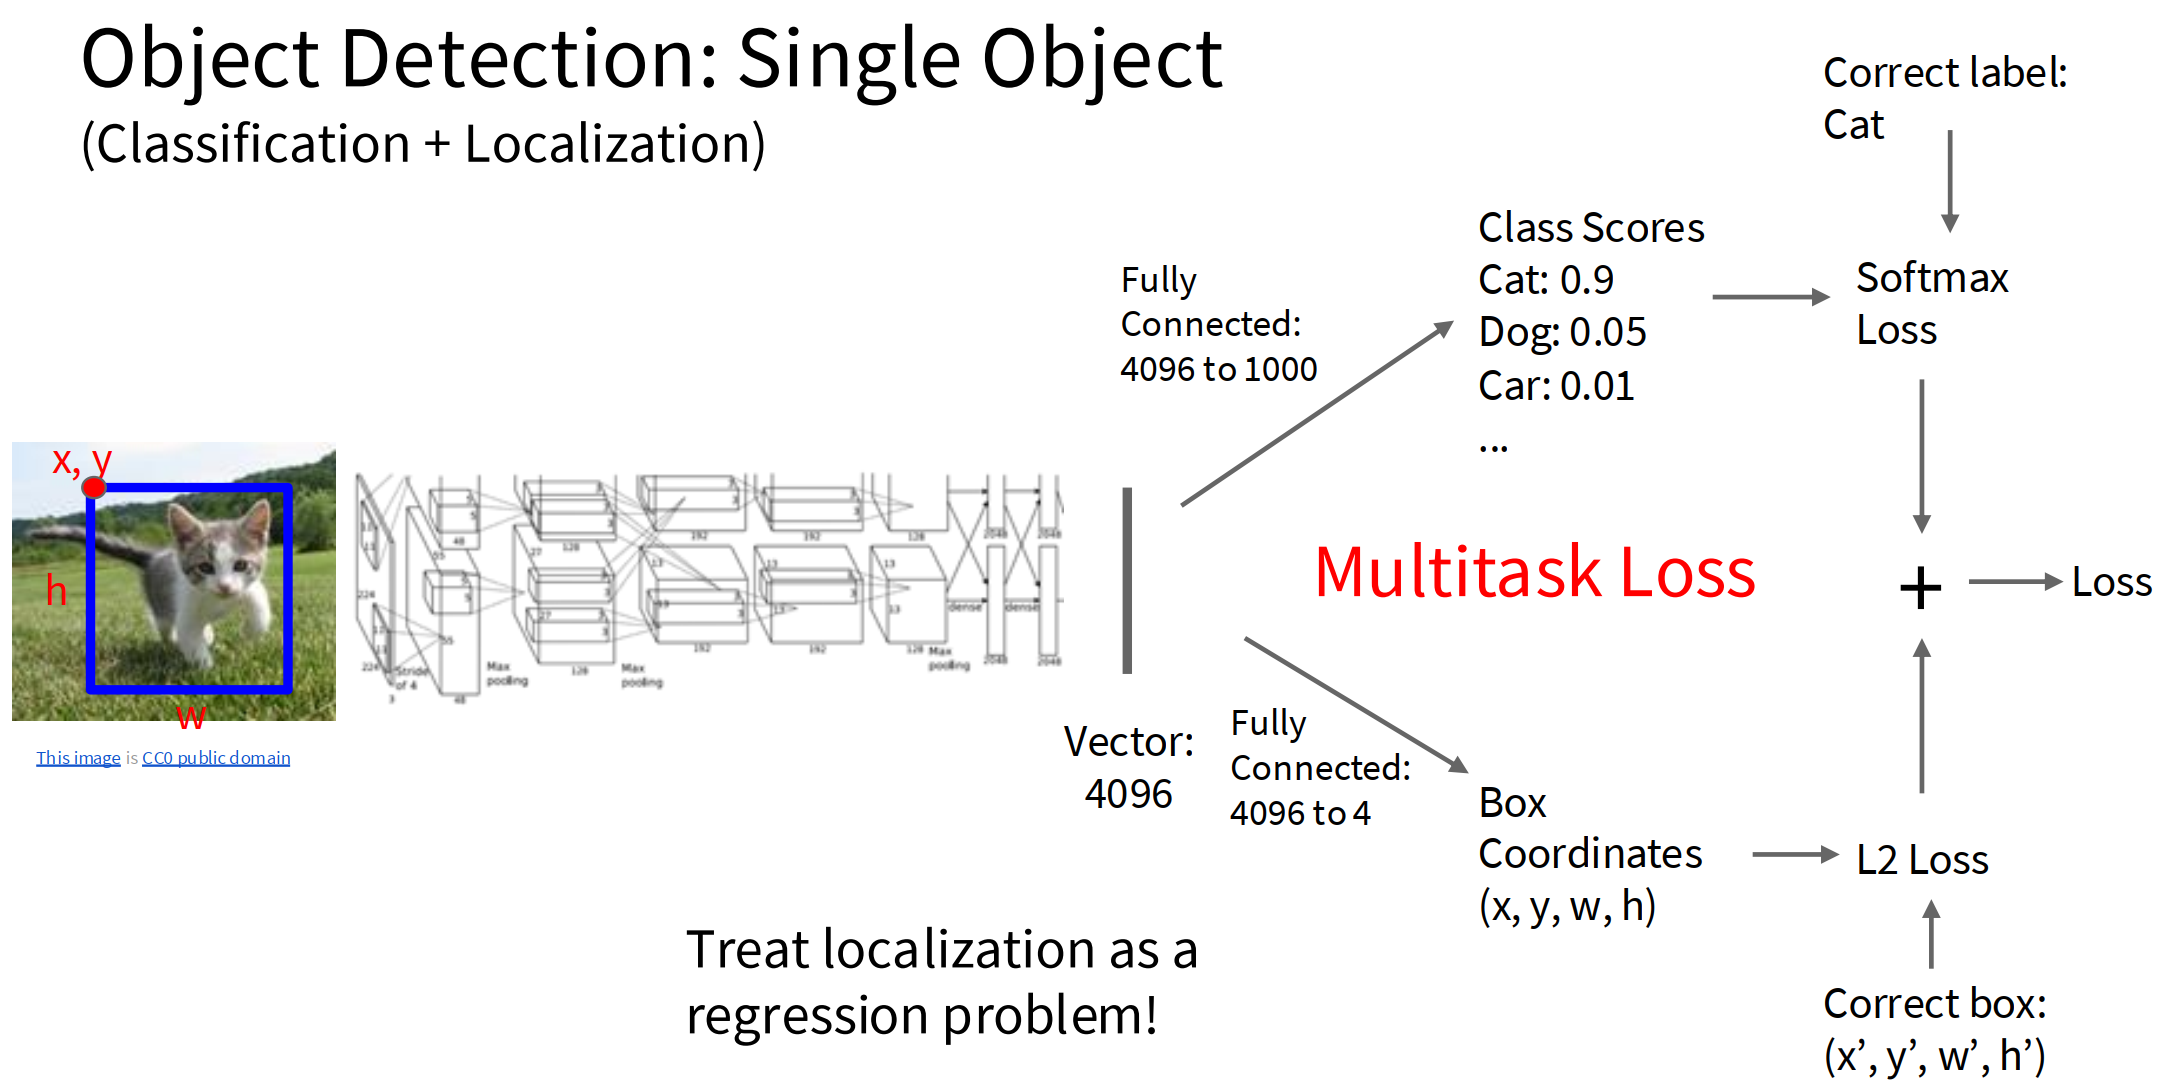
如果每张图只有一个物体,可以把任务写成多任务学习:
- 分类头输出类别分数,用 softmax loss 监督。
- 边界框回归头输出 \((x,y,w,h)\),用回归损失如 \(L_2\) loss 监督。
总损失可以写成:
\[ L = L_{\mathrm{cls}} + \lambda L_{\mathrm{box}} \]
其中 \(\lambda\) 控制分类和定位损失的相对权重。课件强调,锚框定位可以被看作一个回归问题。
4.2 多目标检测的核心困难
多目标检测中,每张图的输出数量不固定:一张图可能有 1 只猫,也可能有多只狗、猫和其他目标。因此不能简单让网络输出一个固定长度的类别向量和一个固定框。
朴素方法是对大量候选 crop 分别跑 CNN,判断每个 crop 是目标还是背景,并分类。但这需要覆盖大量位置、尺度和长宽比,计算极其昂贵。
4.3 Region Proposal 与 R-CNN
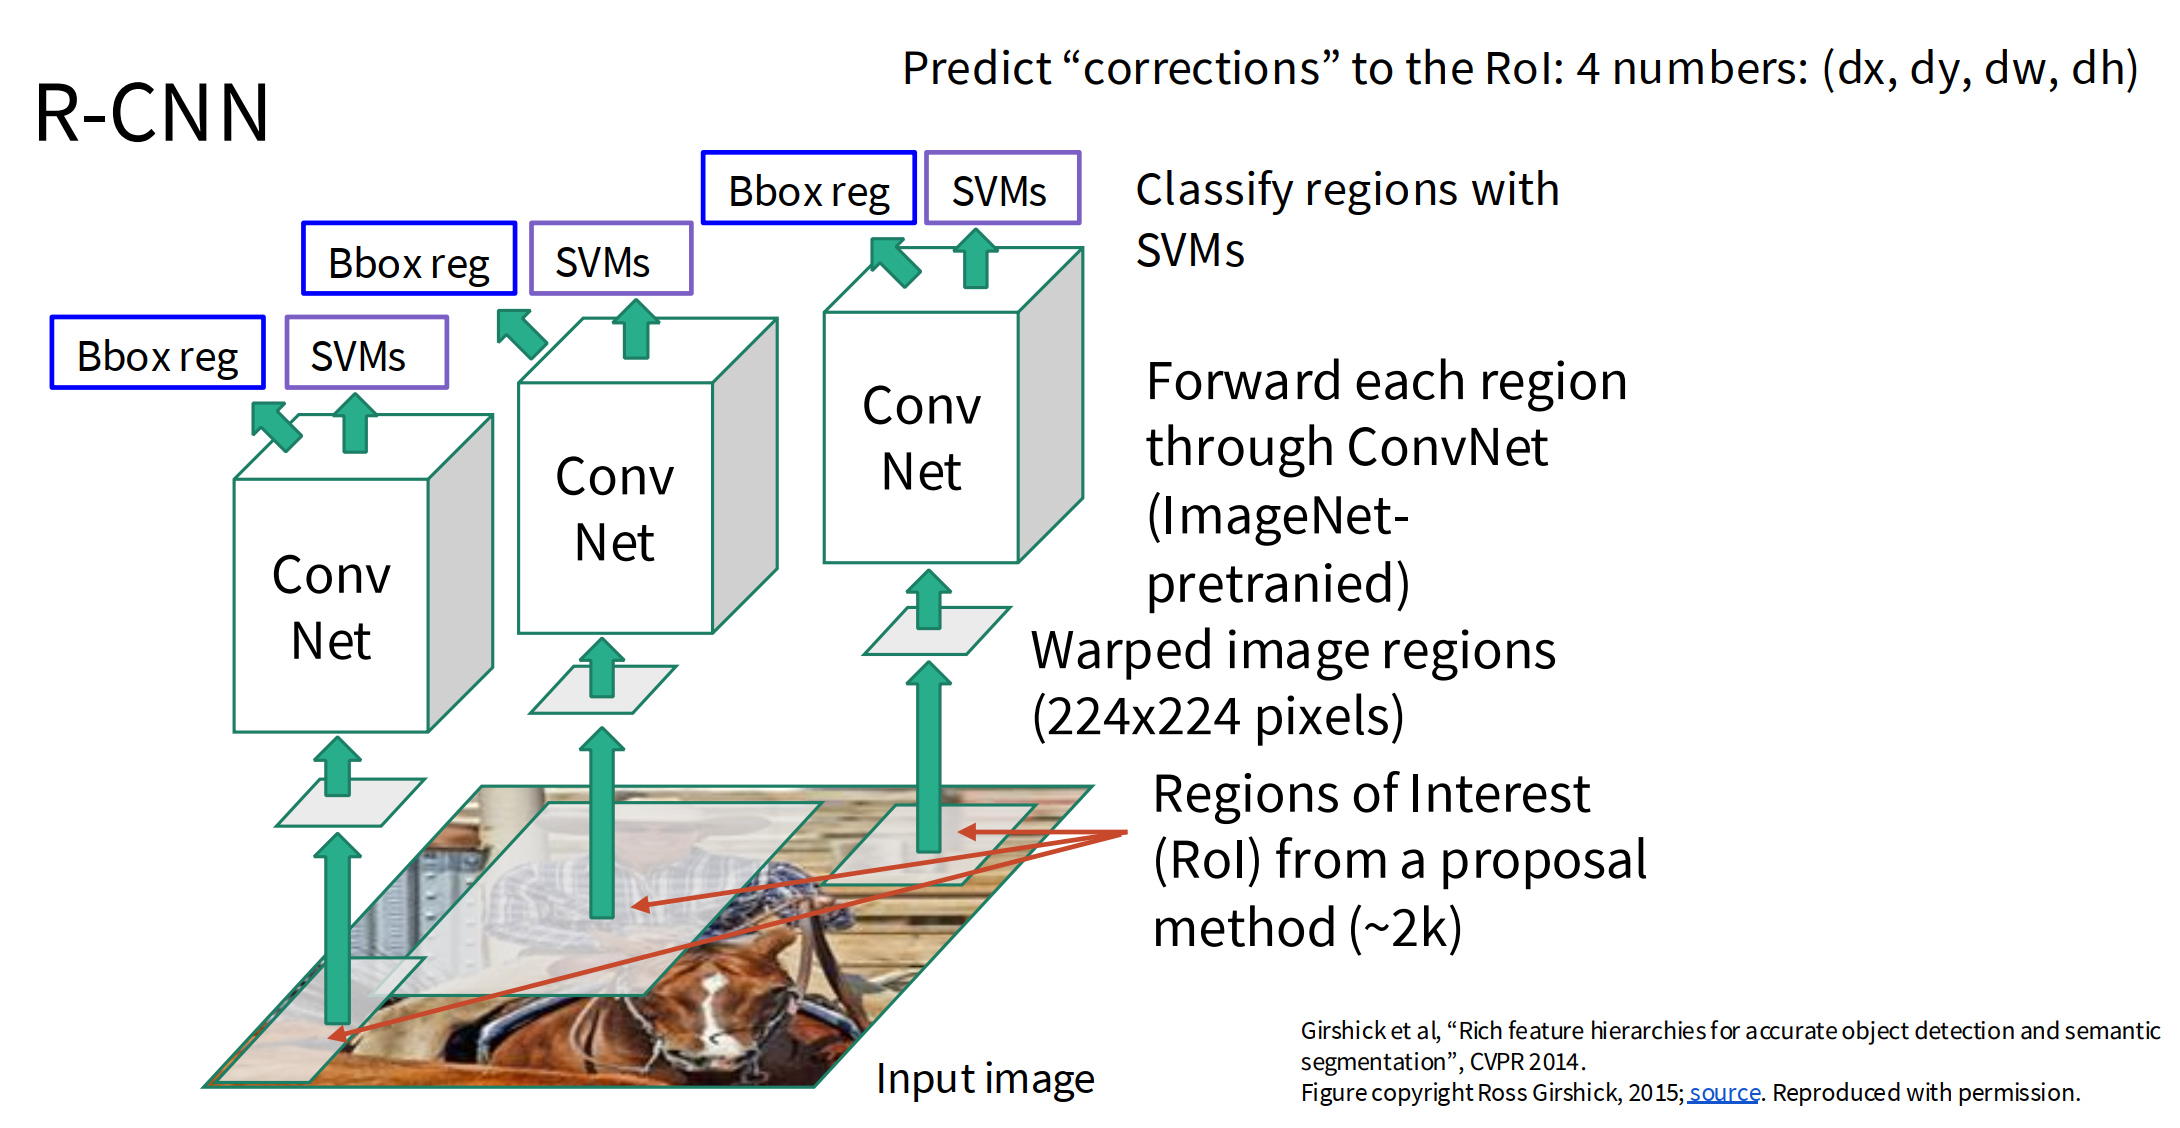
R-CNN 的流程是:
- 用 Selective Search 对输入图像生成约 2000 个 RoI(Region of Interest)。
- 将每个 RoI warp 到固定大小,例如 \(224 \times 224\)。
- 对每个区域独立跑预训练 ConvNet。
- 用 SVM 对区域特征分类。
- 用边界框回归预测相对 RoI 的修正量 \((d_x,d_y,d_w,d_h)\)。
4.3.1 Selective Search 如何生成候选区域
Selective Search 的目标是生成一批“可能包含物体”的候选框。它可以理解为一种基于图像底层线索的 objectness proposal 方法。它会生成约 2000 个候选区域,速度比穷举滑窗更快。
它的大致流程如下:
- 先用图像分割算法把图像切成很多小区域,通常称为超像素(superpixels)。这些小区域往往沿着颜色、纹理或边缘变化形成。
- 建立区域之间的邻接关系,只考虑空间上相邻的区域是否应该合并。
- 对相邻区域计算相似度,常用线索包括颜色直方图相似度、纹理相似度、区域大小以及合并后 bounding box 的紧凑程度。
- 每次选择最相似的一对相邻区域,将它们合并成一个更大的区域。
- 每次合并产生的新区域都可以转成一个 bounding box,作为候选 RoI。
- 用不同尺度、颜色空间和分割参数重复上述过程,以获得更丰富的候选框。
因此,Selective Search 是一种自底向上的层次合并过程:从很多小区域开始,逐步合并成更大的区域,并把合并过程中出现的区域都作为候选框。它的优势是比暴力滑动窗口少得多,通常每张图只给出约 2000 个 proposals;缺点是它仍然是外部算法,不能和 CNN 主体端到端训练,也会成为 R-CNN/Fast R-CNN 的速度瓶颈之一。
直觉例子:如果图中有一只狗,初始分割可能把狗的头、身体、腿、背景草地切成许多小块。Selective Search 会尝试把颜色和纹理相近、空间相邻的狗身体区域逐步合并,最后某些合并区域的外接框就可能覆盖整只狗,成为一个 proposal。
4.3.2 R-CNN 中 SVM 如何对区域特征分类
R-CNN 对每个 RoI 先用 CNN 提取一个固定长度的特征向量,记为 \(f\)。这个 \(f\) 可以看成该候选区域的视觉表征。
原始 R-CNN 使用的是按类别训练的线性 SVM(class-specific linear SVM)。如果数据集有 \(C\) 个目标类别,通常训练 \(C\) 个 one-vs-rest SVM。第 \(c\) 个类别对应一个超平面:
\[ s_c = w_c^T f + b_c \]
其中 \(w_c\) 和 \(b_c\) 是第 \(c\) 类 SVM 的参数,\(s_c\) 是该 RoI 属于类别 \(c\) 的分数。
对第 \(c\) 个 SVM 来说:
- 正样本是与类别 \(c\) 的 ground-truth box 有足够高 IoU 的 RoI。
- 负样本是背景 RoI,或者属于其他类别的 RoI。
- 训练目标是让类别 \(c\) 的正样本分数高,负样本分数低。
预测时,一个 RoI 会被送入所有类别的 SVM,得到:
\[ s_1, s_2, \dots, s_C \]
模型选择分数最高的类别作为该 RoI 的预测类别;如果所有类别分数都很低,则该区域可以被视为背景或在后处理时被过滤掉。
R-CNN 的主要问题是慢:每张图要对约 2000 个区域分别做一次 CNN 前向传播。
4.4 Fast R-CNN
Fast R-CNN 的关键改进是先对整张图跑一次 backbone ConvNet,得到共享卷积特征图,然后在特征图上裁剪每个 RoI 对应的区域,再对每个 RoI 做分类和边界框回归。
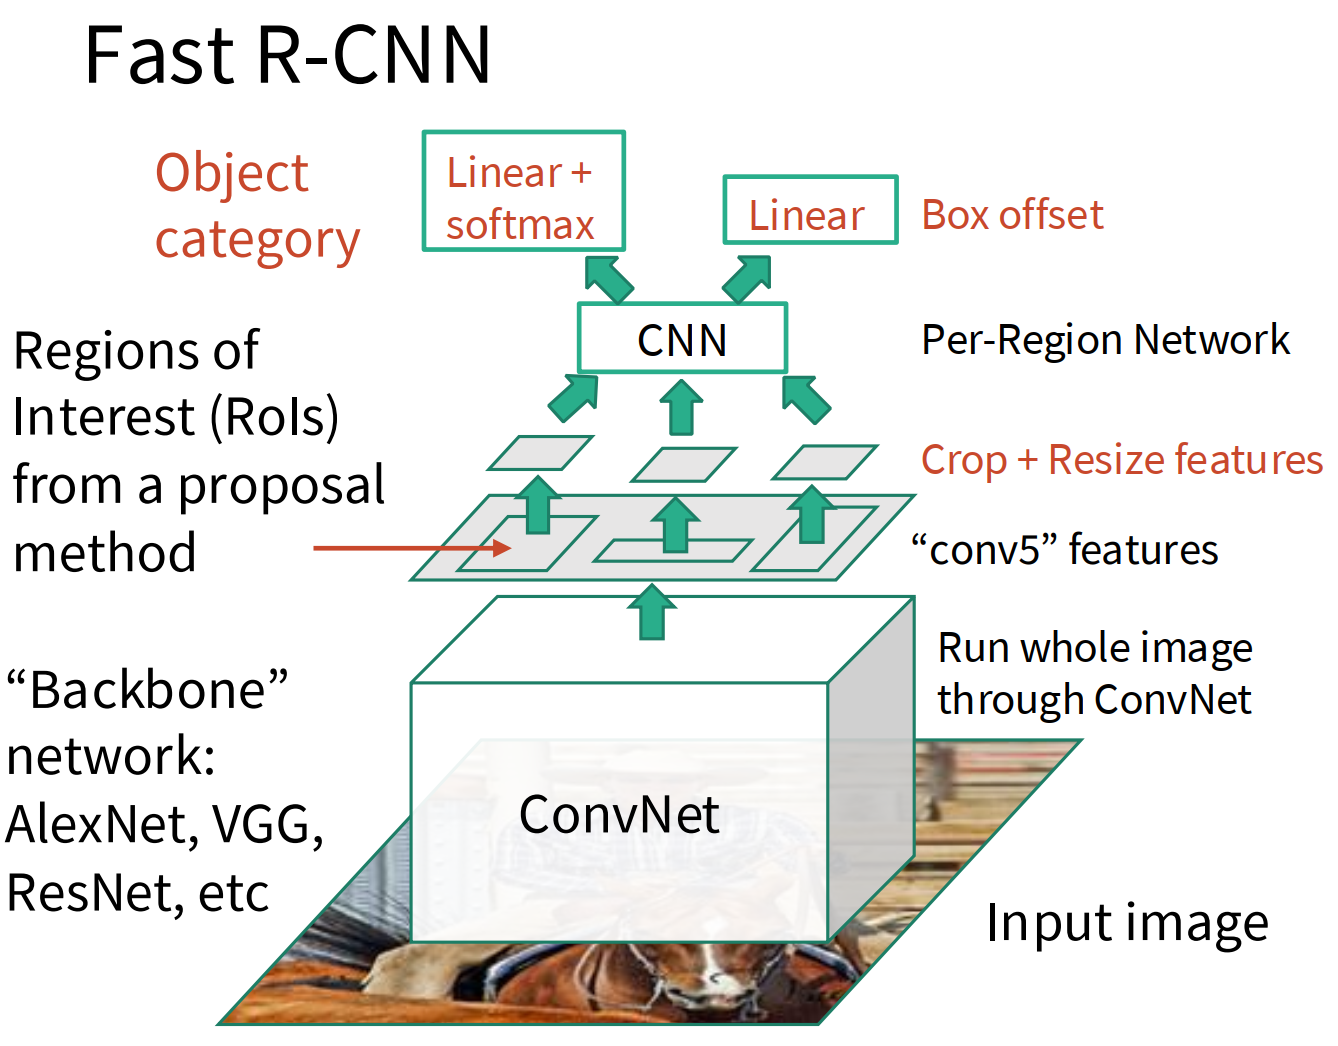
这样大量重叠区域共享底层卷积计算,速度显著提升。其流程可概括为:
- 整张图经过 backbone 得到 feature map。
- 外部 proposal 方法给出 RoI。
- 在 feature map 上 crop + resize 每个 RoI 的特征。
- per-region network 输出类别和 box offset。
4.5 RoI Pool 与 RoI Align
RoI Pool 和 RoI Align 的共同目的,是把大小不同的候选区域 RoI 转换成固定大小的区域特征,让后面的分类头和边界框回归头可以处理。
在目标检测中,每个 proposal 的大小和长宽比都不同:有的框可能覆盖一只小猫,有的框可能覆盖一辆大车。但全连接层或后续 per-region head 通常要求输入维度固定,例如每个 RoI 都要变成 \(512 \times 7 \times 7\) 的特征张量。因此 Fast R-CNN / Faster R-CNN 需要一个操作:从整张图的共享 feature map 中取出某个 RoI 对应的局部特征,并把它规整成统一尺寸。
RoI Pool 和 RoI Align 做的就是这件事。区别在于:RoI Pool 会把连续坐标取整后池化,简单但可能造成错位;RoI Align 保留小数坐标,用双线性插值采样,位置对齐更准确,尤其适合 Mask R-CNN 这种需要像素级 mask 的任务。
4.5.1 一个具体数字例子:RoI Pool
假设某张图经过 CNN 后得到一个单通道 \(4 \times 4\) feature map:
\[ F = \begin{bmatrix} 1 & 2 & 3 & 4 \\ 5 & 6 & 7 & 8 \\ 9 & 10 & 11 & 12 \\ 13 & 14 & 15 & 16 \end{bmatrix} \]
现在有一个候选框投影到 feature map 后,连续坐标大致为左上角 \((0.2, 0.2)\)、右下角 \((3.8, 3.8)\)。后面的分类网络要求固定大小输出为 \(2 \times 2\)。
RoI Pool 会先把连续坐标吸附到离散网格。为了便于手算,这里近似看成取整后覆盖整个 \(4 \times 4\) feature map。然后把它平均分成 \(2 \times 2\) 个 bin,每个 bin 是 \(2 \times 2\):
左上 bin:
\[ \begin{bmatrix} 1 & 2 \\ 5 & 6 \end{bmatrix} \Rightarrow \max = 6 \]
右上 bin:
\[ \begin{bmatrix} 3 & 4 \\ 7 & 8 \end{bmatrix} \Rightarrow \max = 8 \]
左下 bin:
\[ \begin{bmatrix} 9 & 10 \\ 13 & 14 \end{bmatrix} \Rightarrow \max = 14 \]
右下 bin:
\[ \begin{bmatrix} 11 & 12 \\ 15 & 16 \end{bmatrix} \Rightarrow \max = 16 \]
所以 RoI Pool 输出为:
\[ \begin{bmatrix} 6 & 8 \\ 14 & 16 \end{bmatrix} \]
这个例子里看起来很整齐,但关键问题是:原始 RoI 的边界其实在 \((0.2,0.2)\) 到 \((3.8,3.8)\),不是刚好贴着整数网格。RoI Pool 为了做离散池化,把小数坐标吸附到了整数格子,这会让候选框和 feature map 上的真实位置发生轻微错位。分类时这种错位可能还能忍受,但做 mask 时,边界错一点就会明显影响像素级预测。
4.5.2 一个具体数字例子:RoI Align
RoI Align 使用同样的输入 feature map 和同样的连续 RoI:
\[ (0.2,0.2) \rightarrow (3.8,3.8) \]
但它不把坐标取整。输出仍然要变成 \(2 \times 2\),所以这个 RoI 的宽和高都是:
\[ 3.8 - 0.2 = 3.6 \]
每个 bin 的宽和高是:
\[ \frac{3.6}{2} = 1.8 \]
为了简化说明,假设每个 bin 只取中心点作为采样点。那么四个 bin 的中心点分别是:
\[ (1.1,1.1),\ (2.9,1.1),\ (1.1,2.9),\ (2.9,2.9) \]
这些点一般不会刚好落在 feature map 的整数格子上,所以 RoI Align 用双线性插值计算该点的特征值。
以 \((1.1,1.1)\) 为例,它位于四个整数格点之间:
| 邻近格点 | 特征值 |
|---|---|
| \((1,1)\) | \(6\) |
| \((2,1)\) | \(7\) |
| \((1,2)\) | \(10\) |
| \((2,2)\) | \(11\) |
因为该点距离左上格点在 \(x\) 和 \(y\) 方向都偏移 \(0.1\),所以双线性插值为:
\[ 0.9 \times 0.9 \times 6 + 0.1 \times 0.9 \times 7 + 0.9 \times 0.1 \times 10 + 0.1 \times 0.1 \times 11 = 6.5 \]
同理可以算出四个采样点的值:
\[ (1.1,1.1) \Rightarrow 6.5 \]
\[ (2.9,1.1) \Rightarrow 8.3 \]
\[ (1.1,2.9) \Rightarrow 13.7 \]
\[ (2.9,2.9) \Rightarrow 15.5 \]
因此这个简化版 RoI Align 的 \(2 \times 2\) 输出是:
\[ \begin{bmatrix} 6.5 & 8.3 \\ 13.7 & 15.5 \end{bmatrix} \]
真实实现中,每个 bin 里可以采多个点,再对采样值做 average pooling 或 max pooling;但核心思想不变:RoI Align 不把 RoI 边界强行取整,而是在连续坐标上采样,并用双线性插值读取 feature map 的值。
4.5.3 两者差异的直觉总结
RoI Pool 和 RoI Align 的输入、输出目标一样,都是把任意大小的 RoI 变成固定大小特征。但它们处理坐标的方式不同:
| 方法 | 坐标处理 | 得到固定大小特征的方式 | 主要问题或优势 |
|---|---|---|---|
| RoI Pool | 小数坐标取整,吸附到网格 | 每个 bin 内 max pooling | 简单,但会产生 misalignment |
| RoI Align | 保留小数坐标 | 在采样点做双线性插值,再池化 | 对齐更精确,适合 Mask R-CNN |
一句话记忆:RoI Pool 是“先对齐到格子再池化”,RoI Align 是“保留真实位置再插值采样”。
4.6 Faster R-CNN 与 Region Proposal Network(RPN)
Fast R-CNN 仍依赖外部 proposal 方法,运行时间会被 proposal 阶段拖慢。Faster R-CNN 的核心是让 CNN 自己生成 proposals,即加入 RPN。
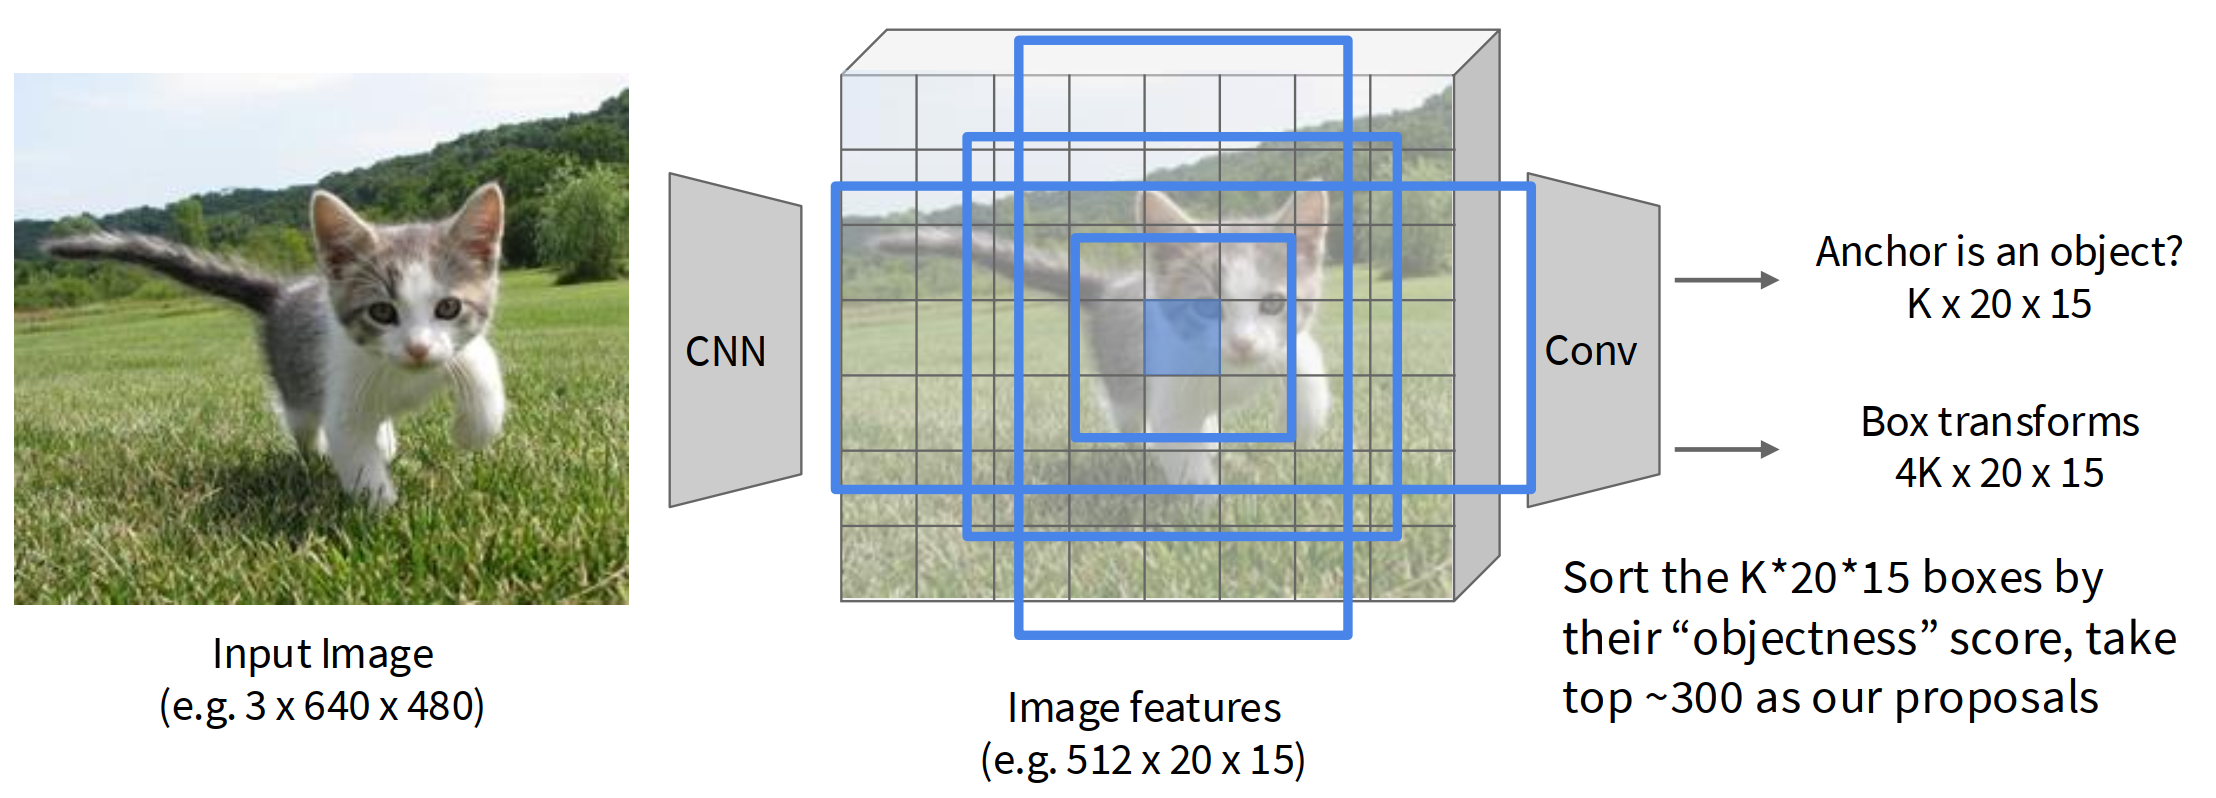
RPN 在 backbone feature map 的每个位置放置若干 anchor boxes。若 feature map 大小为 \(20 \times 15\),每个位置有 \(K\) 个 anchor,则 RPN 输出:
- objectness 分数:\(K \times 20 \times 15\),判断每个 anchor 是否包含目标。
- box transforms:\(4K \times 20 \times 15\),为每个 anchor 回归框修正量。
随后按 objectness 排序,取 top proposals,例如约 300 个,送入第二阶段分类和边界框回归。
Faster R-CNN 是典型的两阶段检测器:
| 阶段 | 运行频率 | 功能 |
|---|---|---|
| 第一阶段 | 每张图一次 | backbone + RPN,生成候选框 |
| 第二阶段 | 每个候选区域一次 | RoI Pool/Align,预测类别和 box offset |
训练时通常联合优化四个损失:RPN objectness 分类、RPN box 回归、最终类别分类、最终 box 回归。
4.7 单阶段检测器:YOLO / SSD / RetinaNet
单阶段检测器不再显式分成 proposal 和 per-region 分类两个阶段,而是在规则网格上直接预测框和类别。以 YOLO 为例:
- 将图像划分为 \(S \times S\) 网格。
- 每个网格预测 \(B\) 个 bounding boxes。
- 每个 box 输出目标置信度 \(P(\mathrm{object})\) 和框参数 \((x,y,h,w)\)。
- 同时预测类别概率 \(P(\mathrm{class})\)。
课件给出的通用输出形式是:
\[ S \times S \times (5B + C) \]
其中 5 对应 \((d_x,d_y,d_h,d_w,\mathrm{confidence})\),\(C\) 是类别数。
取舍:Faster R-CNN 通常更慢但更准确;SSD/YOLO 等单阶段方法速度更快,但早期版本准确率常弱一些。更大、更深的 backbone 往往能提升检测性能。
4.8 DETR:用 Transformer 做目标检测
DETR(Detection Transformer)尝试把检测建模为集合预测问题。它直接从 Transformer 输出一组 boxes,不使用 anchors,也不预测相对 anchor 的 box transforms。
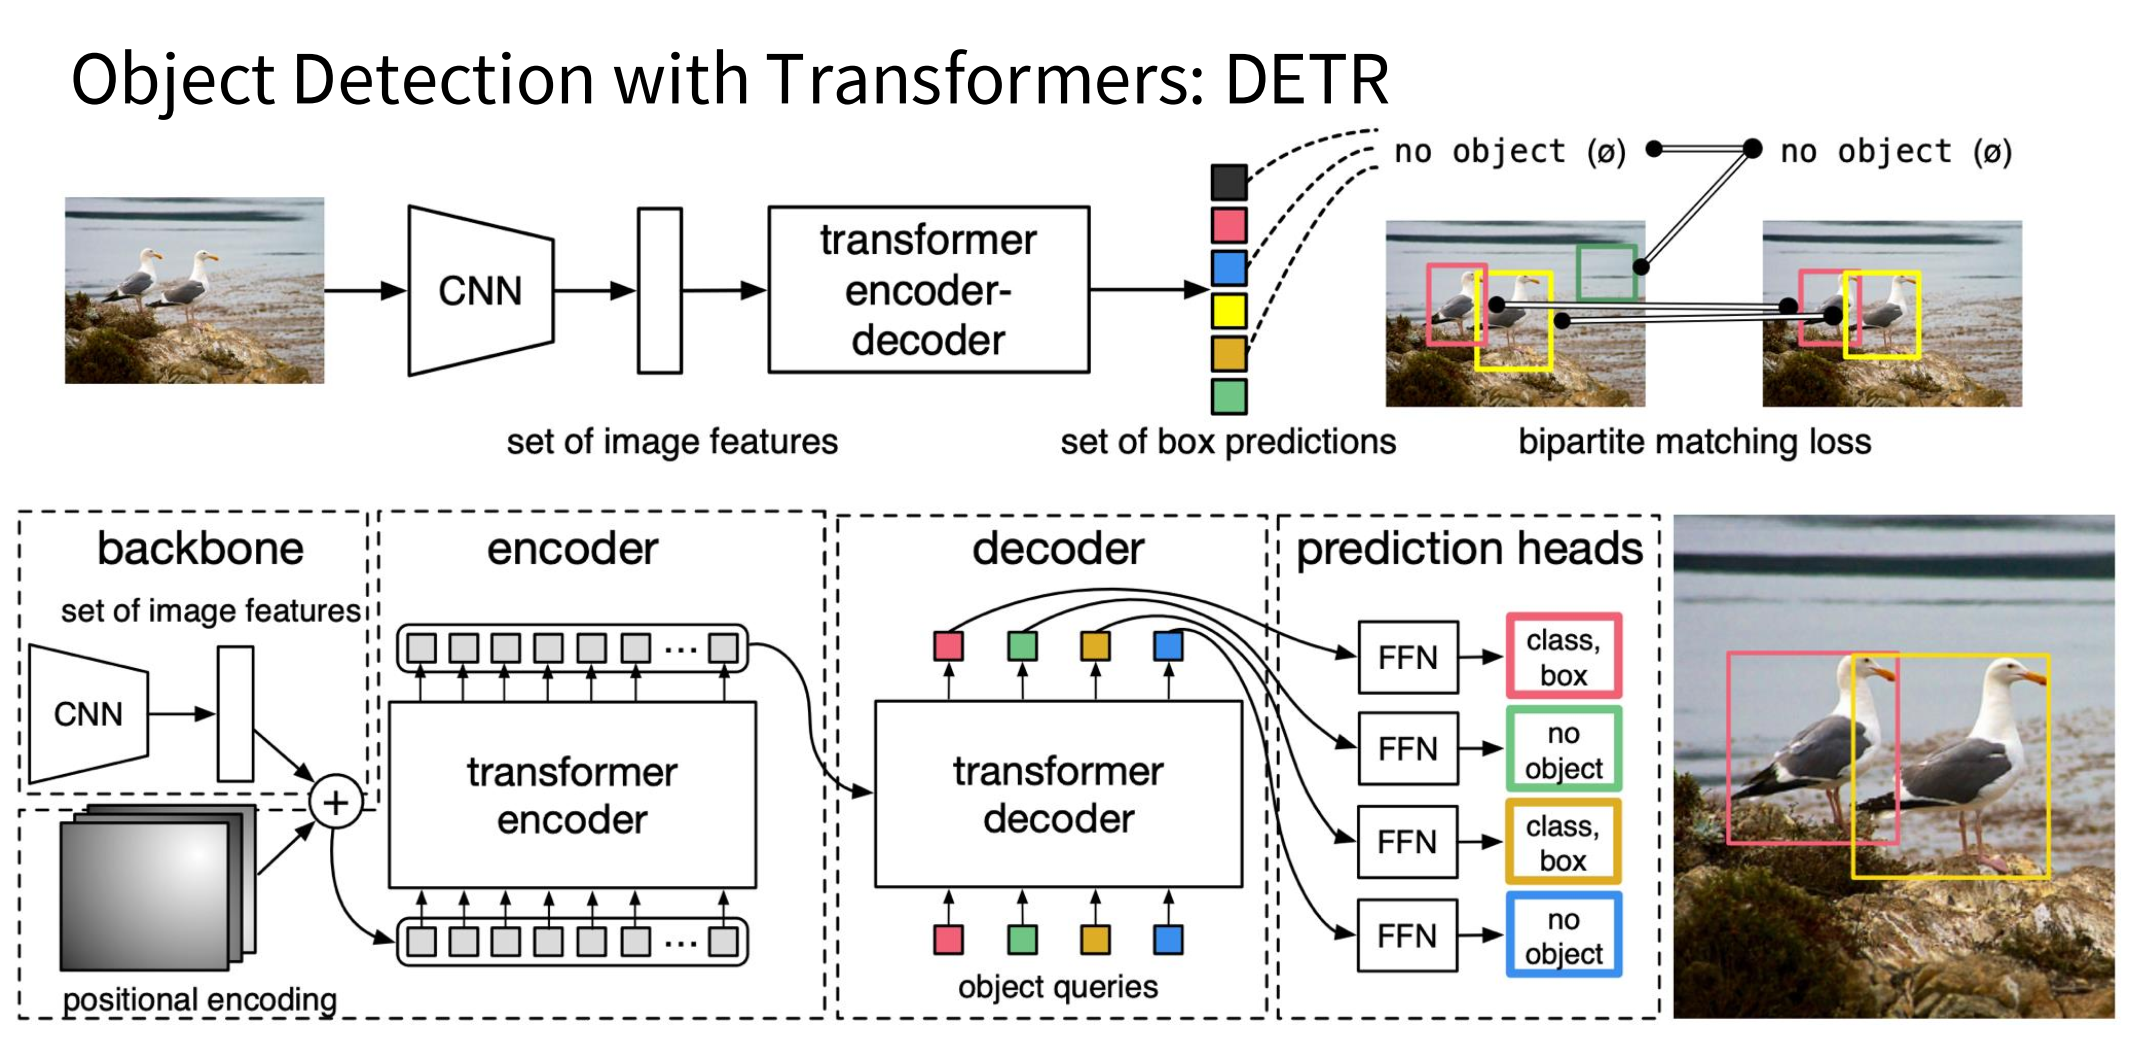
训练时,DETR 用二分图匹配(bipartite matching)把预测框集合与 ground-truth 框集合对应起来,然后监督类别和框坐标。它的意义是把目标检测从大量手工设计的 anchor、NMS、proposal 流程中抽象出来,但实际训练和收敛也有自己的挑战。
5 实例分割(Instance Segmentation)
实例分割结合了目标检测和语义分割:它既要区分每个物体实例,又要给出每个实例的像素级 mask。
5.1 Mask R-CNN
Mask R-CNN 在 Faster R-CNN 基础上增加一个 mask 分支:
- backbone + RPN 生成候选 RoI。
- 使用 RoI Align 得到对齐后的 RoI 特征,例如 \(256 \times 14 \times 14\)。
- 分类头输出 \(C\) 类分数。
- box 头输出每类边界框坐标,维度为 \(4C\)。
- mask head 用小型卷积网络为每个 RoI 预测 \(C \times 28 \times 28\) 的二值 mask。
Mask R-CNN 的关键点是 mask 分支在每个 RoI 上独立工作,因此输出的是实例级 mask,而不是整张图的语义标签图。课件还指出 Mask R-CNN 可以扩展到人体姿态估计等任务。
5.2 开源框架
课件列出了常见实现:
- TensorFlow Detection API:支持 Faster R-CNN、SSD、R-FCN、Mask R-CNN 等。
- Detectron2(PyTorch):支持 Mask R-CNN、RetinaNet、Faster R-CNN、RPN、Fast R-CNN、R-FCN 等。
实际项目中常用预训练模型在自定义数据集上微调,而不是从零开始训练完整检测或分割系统。
6 可视化与模型理解(Visualization and Understanding)
6.1 可视化第一层滤波器
第一层卷积滤波器直接作用于 RGB 像素,因此可以可视化为小图像。AlexNet 的第一层滤波器形状为 \(64 \times 3 \times 11 \times 11\);ResNet 和 DenseNet 常见第一层为 \(64 \times 3 \times 7 \times 7\)。
第一层滤波器通常学到边缘、颜色对比、方向纹理等低级视觉模式。这说明 CNN 的早期层更接近通用图像特征。
6.2 Saliency Map:哪些像素影响分类
Saliency Map 用反向传播回答“哪些像素对某个类别分数最重要”。流程是:
- 前向传播得到某个类别的未归一化分数 \(S_c\)。
- 计算该分数对输入图像像素 \(I\) 的梯度:
\[ \frac{\partial S_c}{\partial I} \]
- 对梯度取绝对值,并在 RGB 通道上取最大值,得到每个像素的重要性。
梯度越大,说明该像素的微小变化对类别分数影响越大。Saliency Map 的优点是简单、适用于很多模型;缺点是通常比较噪声化,只能提供局部敏感性解释。
6.3 CAM:Class Activation Mapping
CAM 适用于最后卷积层后接 Global Average Pooling 和线性分类层的结构。
设最后卷积特征为:
\[ f \in \mathbb{R}^{H \times W \times K} \]
Global Average Pooling 得到:
\[ F_k = \frac{1}{HW}\sum_{h,w} f_{h,w,k} \]
分类层权重为 \(w \in \mathbb{R}^{K \times C}\),类别 \(c\) 的分数为:
\[ S_c = \sum_k w_{k,c}F_k \]
代入 \(F_k\):
\[ S_c = \frac{1}{HW}\sum_{h,w}\sum_k w_{k,c}f_{h,w,k} \]
因此类别 \(c\) 在空间位置 \((h,w)\) 的激活图可以定义为:
\[ M^c_{h,w} = \sum_k w_{k,c}f_{h,w,k} \]
直觉:如果某些通道对类别 \(c\) 的分类权重大,而这些通道在某些空间位置激活强,那么这些位置就是模型判断类别 \(c\) 的关键区域。
CAM 的限制是它依赖特定结构,通常只能用于最后卷积层。
6.4 Grad-CAM
Grad-CAM 改进了 CAM 的限制,可以选择任意卷积层或中间激活层。流程如下:
- 选择某层激活:
\[ A \in \mathbb{R}^{H \times W \times K} \]
- 计算类别分数 \(S_c\) 对激活 \(A\) 的梯度:
\[ \frac{\partial S_c}{\partial A} \in \mathbb{R}^{H \times W \times K} \]
- 对梯度做全局平均池化,得到每个通道的重要性权重:
\[ \alpha_k = \frac{1}{HW}\sum_{h,w}\frac{\partial S_c}{\partial A_{h,w,k}} \]
- 用权重对激活通道加权求和,并通过 ReLU 得到热力图:
\[ M^c_{h,w} = \mathrm{ReLU}\left(\sum_k \alpha_k A_{h,w,k}\right) \]
ReLU 的作用是保留对类别 \(c\) 有正贡献的区域。Grad-CAM 常用于判断模型是否真的看到了目标区域,还是依赖背景、纹理或数据集偏差。
6.5 中间特征与 Guided Backprop
除了解释最终类别,也可以选择某个中间通道或神经元,计算其激活值对输入像素的梯度。这能帮助理解某一层某个通道偏好什么图案。
Guided Backprop 会在 ReLU 反向传播时只保留正梯度,使可视化图像更清晰。课件展示的 maximally activating patches 和 guided backprop 说明:高层神经元往往响应更复杂的语义部件,而低层神经元更像边缘或纹理检测器。
6.6 ViT 特征可视化
ViT 没有传统 CNN 的卷积通道和空间 feature map,但仍可以可视化 patch token、注意力模式或中间特征。课件只简要展示了 ViT feature visualization,核心启发是:Transformer 的可解释性通常围绕 token 间关系、注意力图和 patch-level 表征展开。
7 复习重点与易混点
7.1 必须掌握的核心概念
- 语义分割 vs 实例分割:语义分割只按类别标像素,不区分同类实例;实例分割要给每个物体单独 mask。
- 目标检测输出不定长:多目标检测的根本困难是每张图目标数量不同,因此需要 proposals、anchors、grid prediction 或 set prediction 等机制。
- R-CNN 系列演进:R-CNN 对每个 proposal 独立跑 CNN;Fast R-CNN 共享整图卷积特征;Faster R-CNN 用 RPN 取代外部 proposal。
- RoI Pool vs RoI Align:RoI Pool 会量化/吸附坐标,可能造成错位;RoI Align 用双线性插值避免量化,更适合 mask 预测。
- 两阶段 vs 单阶段检测器:两阶段通常更准确但慢;单阶段通常更快,直接在 dense grid/anchors 上预测类别和框。
- CAM vs Grad-CAM:CAM 依赖最后 conv + GAP + 线性分类结构;Grad-CAM 用梯度获得通道权重,可用于更多层。
7.2 典型考试问法
为什么滑动窗口做语义分割低效?
因为相邻 patch 大量重叠,却要重复跑 CNN,不能复用共享卷积特征。
为什么语义分割网络需要下采样再上采样?
下采样扩大感受野、降低计算量、获得高级语义;上采样恢复空间分辨率,使输出能对齐输入像素。
转置卷积和普通卷积的 stride 有什么相反关系?
普通 stride 卷积中,卷积核在输入上移动 \(s\) 个像素,输出移动 1 个位置;转置卷积中,输入移动 1 个位置,卷积核在输出上移动 \(s\) 个像素。
Faster R-CNN 的四个训练损失是什么?
RPN objectness 分类、RPN box 回归、最终目标类别分类、最终 box 回归。
YOLO 的输出张量为什么是 \(S \times S \times (5B+C)\)?
每个网格预测 \(B\) 个框,每个框有 4 个坐标加 1 个置信度,共 \(5B\);同时预测 \(C\) 个类别分数。
Grad-CAM 中 \(\alpha_k\) 的含义是什么?
\(\alpha_k\) 是类别分数对第 \(k\) 个通道激活的平均梯度,表示该通道对目标类别的重要程度。
7.3 一句话总览
本讲把现代视觉识别从“整图分类”扩展到“像素级和实例级理解”,并展示了两条主线:一条是通过 FCN、U-Net、R-CNN、Faster R-CNN、Mask R-CNN 等架构逐步解决空间输出问题;另一条是用 Saliency、CAM、Grad-CAM 和特征可视化理解模型到底在看什么。