1 自监督学习的核心问题与基本范式
1.1 为什么需要自监督学习
传统视觉模型在分类、语义分割、目标检测、实例分割等任务中通常依赖大量人工标注数据。大规模监督训练的主要问题是:标注昂贵、标注规模有限,并且很多下游任务没有足够大的人工标注数据集。
自监督学习(Self-Supervised Learning, SSL)的目标是利用大量未标注数据学习有用的视觉表示。它不需要人工标签,而是从数据本身自动构造训练信号。例如,把图像旋转后让模型预测旋转角度,或者遮住图像一部分后让模型重建缺失内容。
1.2 Pretext task 与 downstream task
自监督学习通常分为两个阶段:
| 阶段 | 数据 | 目标 | 训练信号来源 | 产物 |
|---|---|---|---|---|
| 预训练任务(Pretext Task) | 大量未标注数据 | 学习通用特征 | 从数据自动生成标签或目标 | Encoder / feature extractor |
| 下游任务(Downstream Task) | 少量标注数据 | 完成实际应用 | 人工标注 | 分类器、检测器、分割模型等 |
pretraining 指“预训练过程”;pretext
task 指“为了预训练而构造的代理任务”。pretext
有“借口、托辞”的意思,因为模型真正目标不是学会预测旋转角度、补全图像或解拼图,而是借这些任务逼自己学到可迁移的表示。
预训练任务可以看作“无人工标注的数据任务”,但训练形式仍然经常是监督学习目标,例如分类或回归。关键区别在于:标签不是人给的,而是由数据变换、遮挡、时序关系或样本配对规则自动产生的。
1.3 如何评价自监督方法
评价自监督方法时,不能只看 pretext task 本身做得多好。一个模型把旋转角度预测得很准,并不一定说明它学到了对分类、检测、分割都好的表示。因此更重要的是评估表示质量。
常见评价方式包括:
- Linear Evaluation Protocol / linear probing:冻结预训练好的 encoder,只在其输出特征上训练一个线性分类器。如果线性分类器表现好,说明特征本身已经具有较强的可分性。
- Fine-tuning:把预训练模型迁移到下游任务上继续训练。它更接近真实应用,也更能发挥模型潜力。
- Clustering / t-SNE:用聚类指标或可视化观察表示空间是否按语义分离。
- 鲁棒性与泛化:测试模型在新数据集、分布变化或有限标注场景下是否仍然有效。
- 计算效率:比较训练时间、显存、批大小需求和分布式训练成本。
2 基于图像变换的预训练任务
2.1 旋转预测
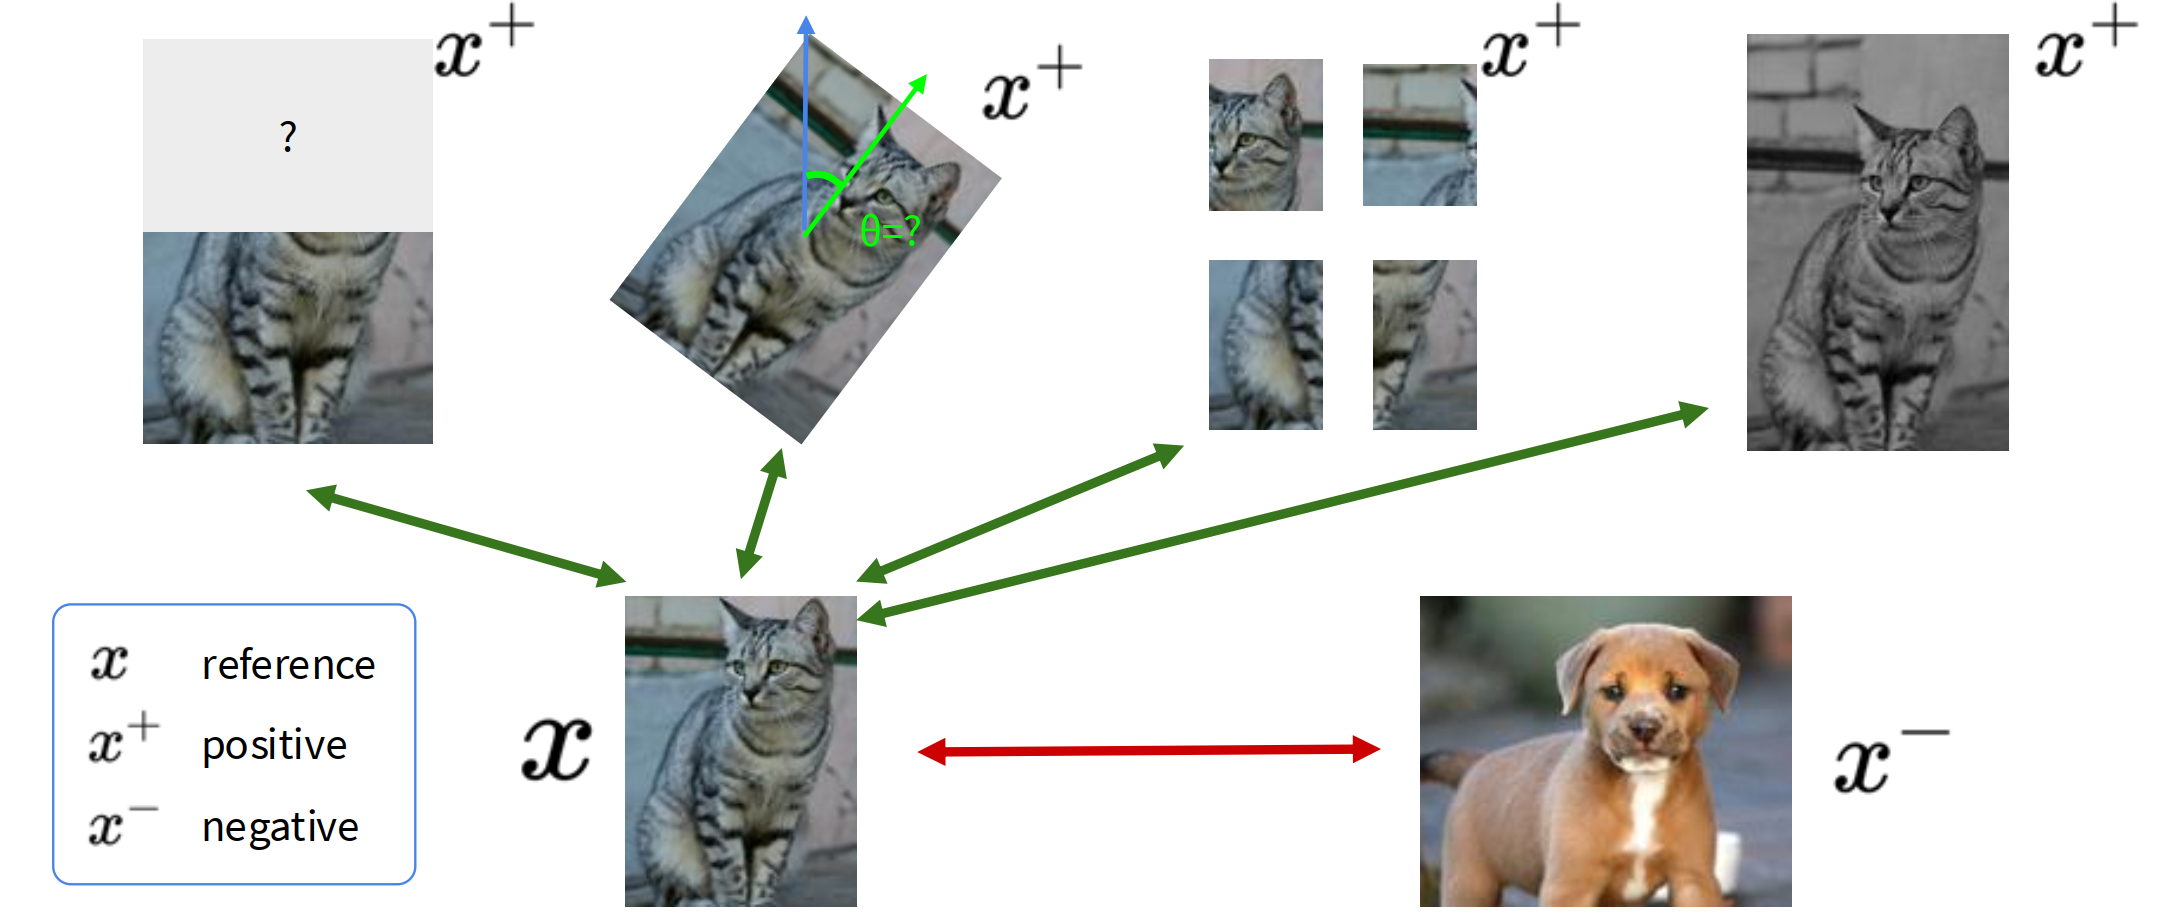
旋转预测(rotation prediction)的基本做法是把输入图像整体旋转 \(0^\circ\)、\(90^\circ\)、\(180^\circ\) 或 \(270^\circ\),然后训练模型做四分类,预测图像被旋转了多少。
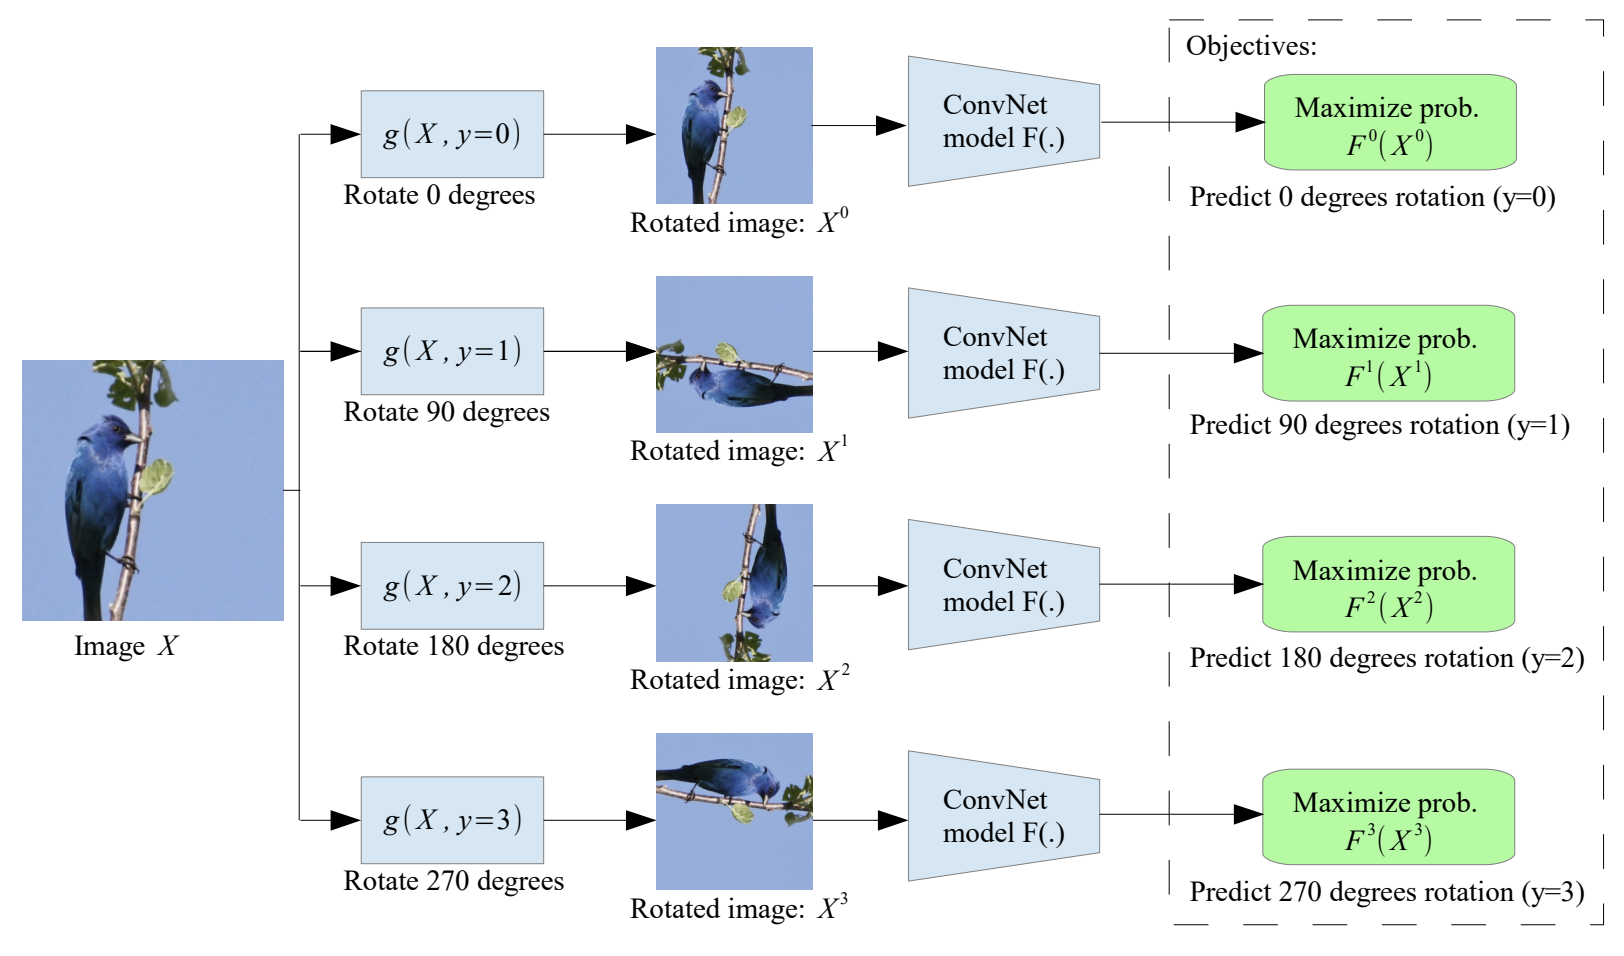
这个任务背后的假设是:如果模型要判断一张图是否“正着放”,它必须理解物体通常的姿态、方向和场景布局。比如模型要知道车通常在地面上,人头通常在身体上方,天空通常在图像上部。这种知识被称为一种视觉常识(visual commonsense)。
旋转预测的优点是标签自动生成、实现简单,并且能促使模型学习物体形状和方向信息。缺点是它与具体任务绑定较强,学到的表示未必对所有下游任务都最优。
2.2 相对 patch 位置预测与拼图任务
相对 patch 位置预测要求模型判断两个图像块之间的空间关系,例如一个 patch 位于另一个 patch 的上方、左下方或右侧。
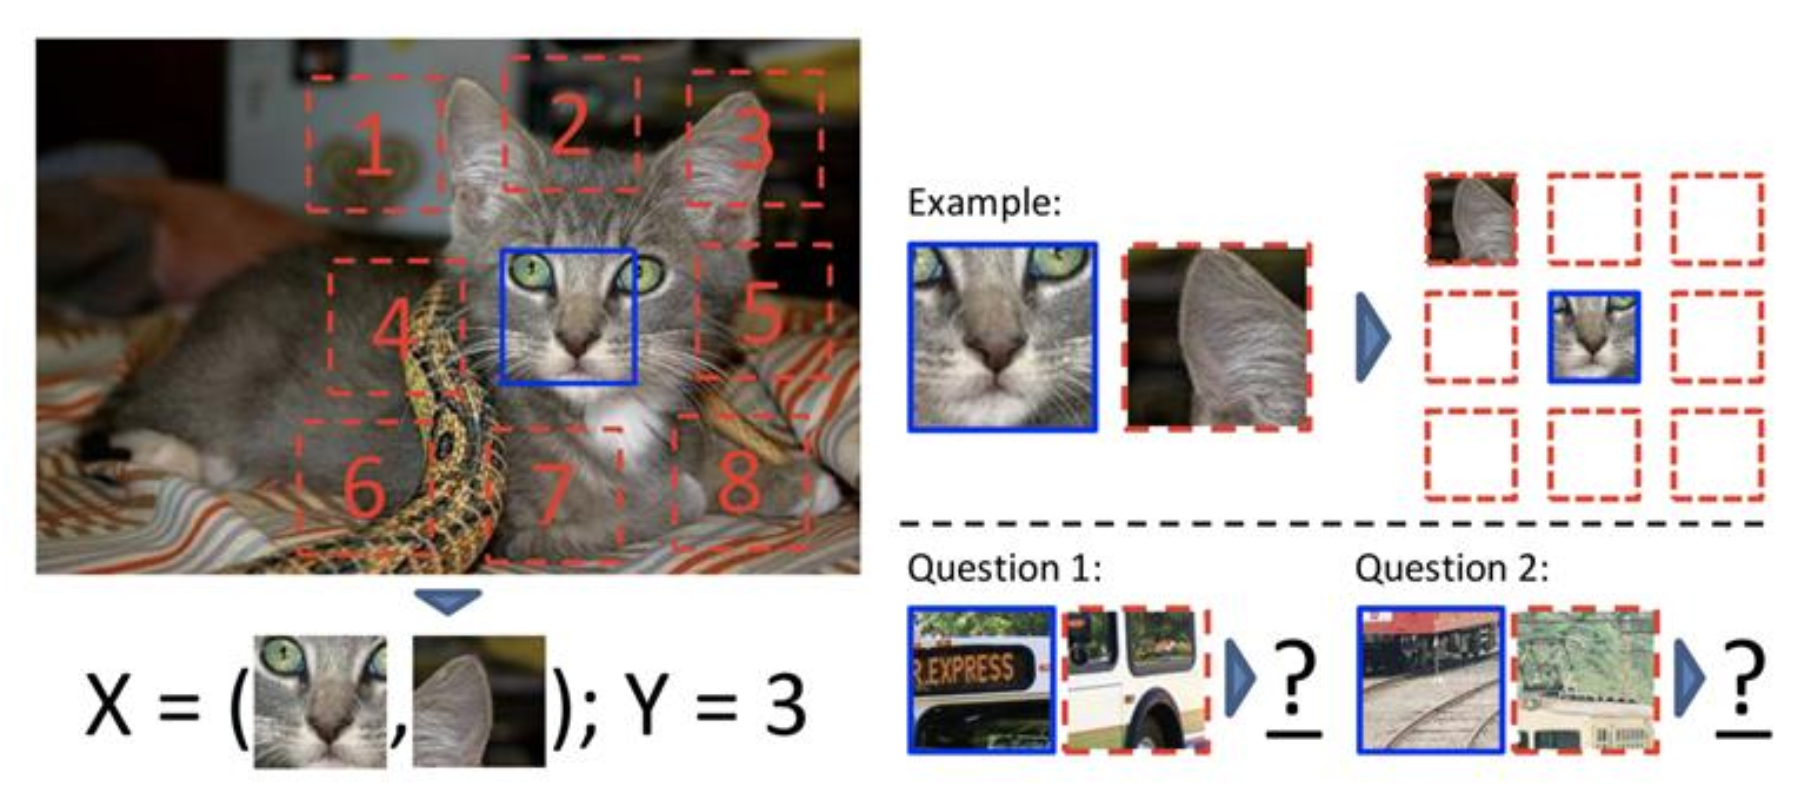
拼图任务(jigsaw puzzle)进一步把图像切成多个 patch 并打乱顺序,模型需要恢复合理排列。
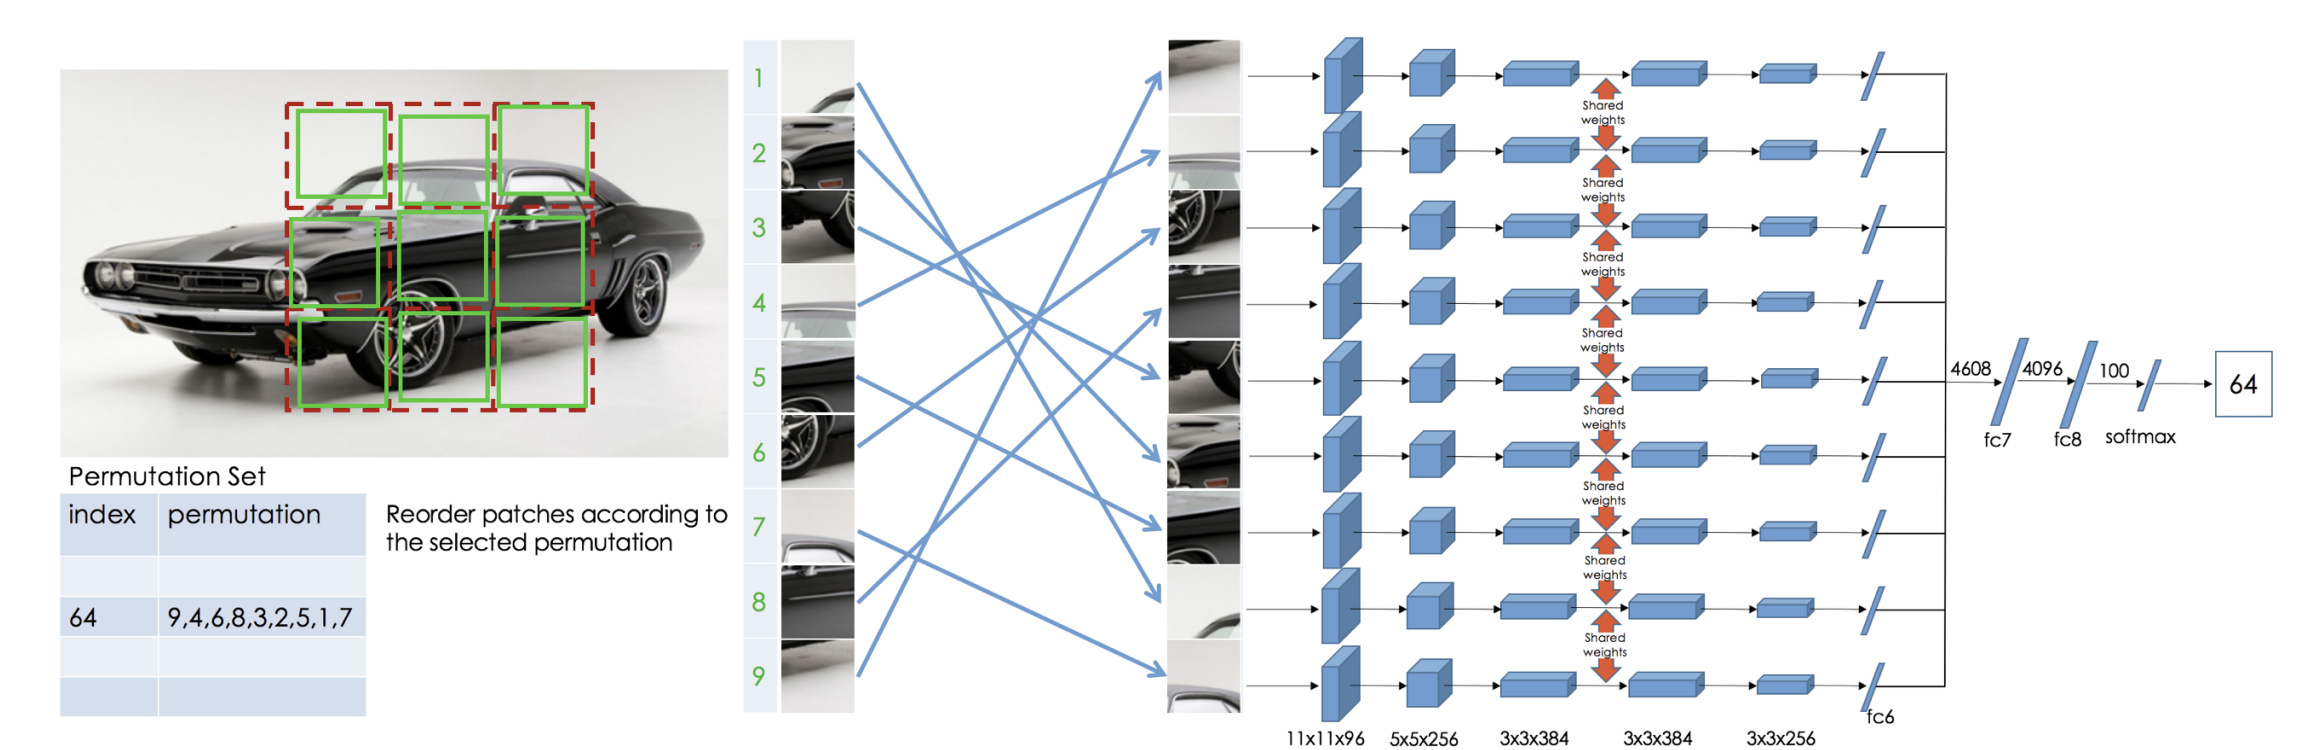
这类任务迫使模型理解局部纹理与全局结构之间的关系。只看一个 patch 的颜色或纹理通常不够,模型还需要知道物体部件如何组合成完整对象。
需要注意的是,这类任务容易被低层线索“作弊”。例如 patch 边缘的颜色连续性可能泄露相邻关系。实际设计时通常要加入随机间隔、颜色扰动等机制,减少模型只靠浅层统计规律解题。
2.3 图像修复与 inpainting
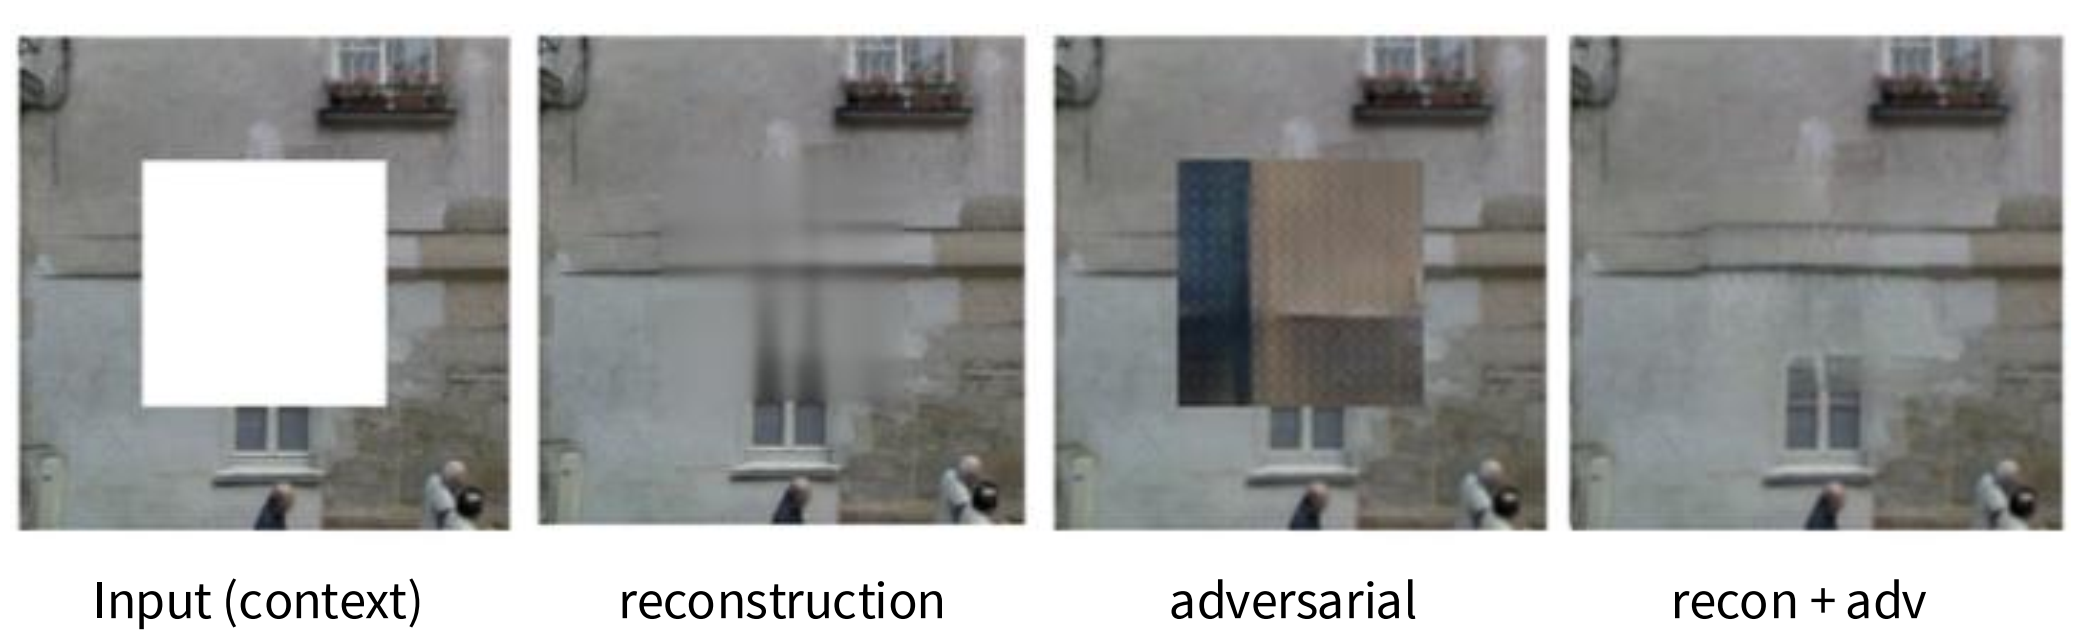
图像修复(inpainting)会遮住图像的一部分,让模型根据上下文预测缺失像素。典型结构是 encoder-decoder:encoder 把可见区域压缩成表示,decoder 根据表示重建被遮挡区域。
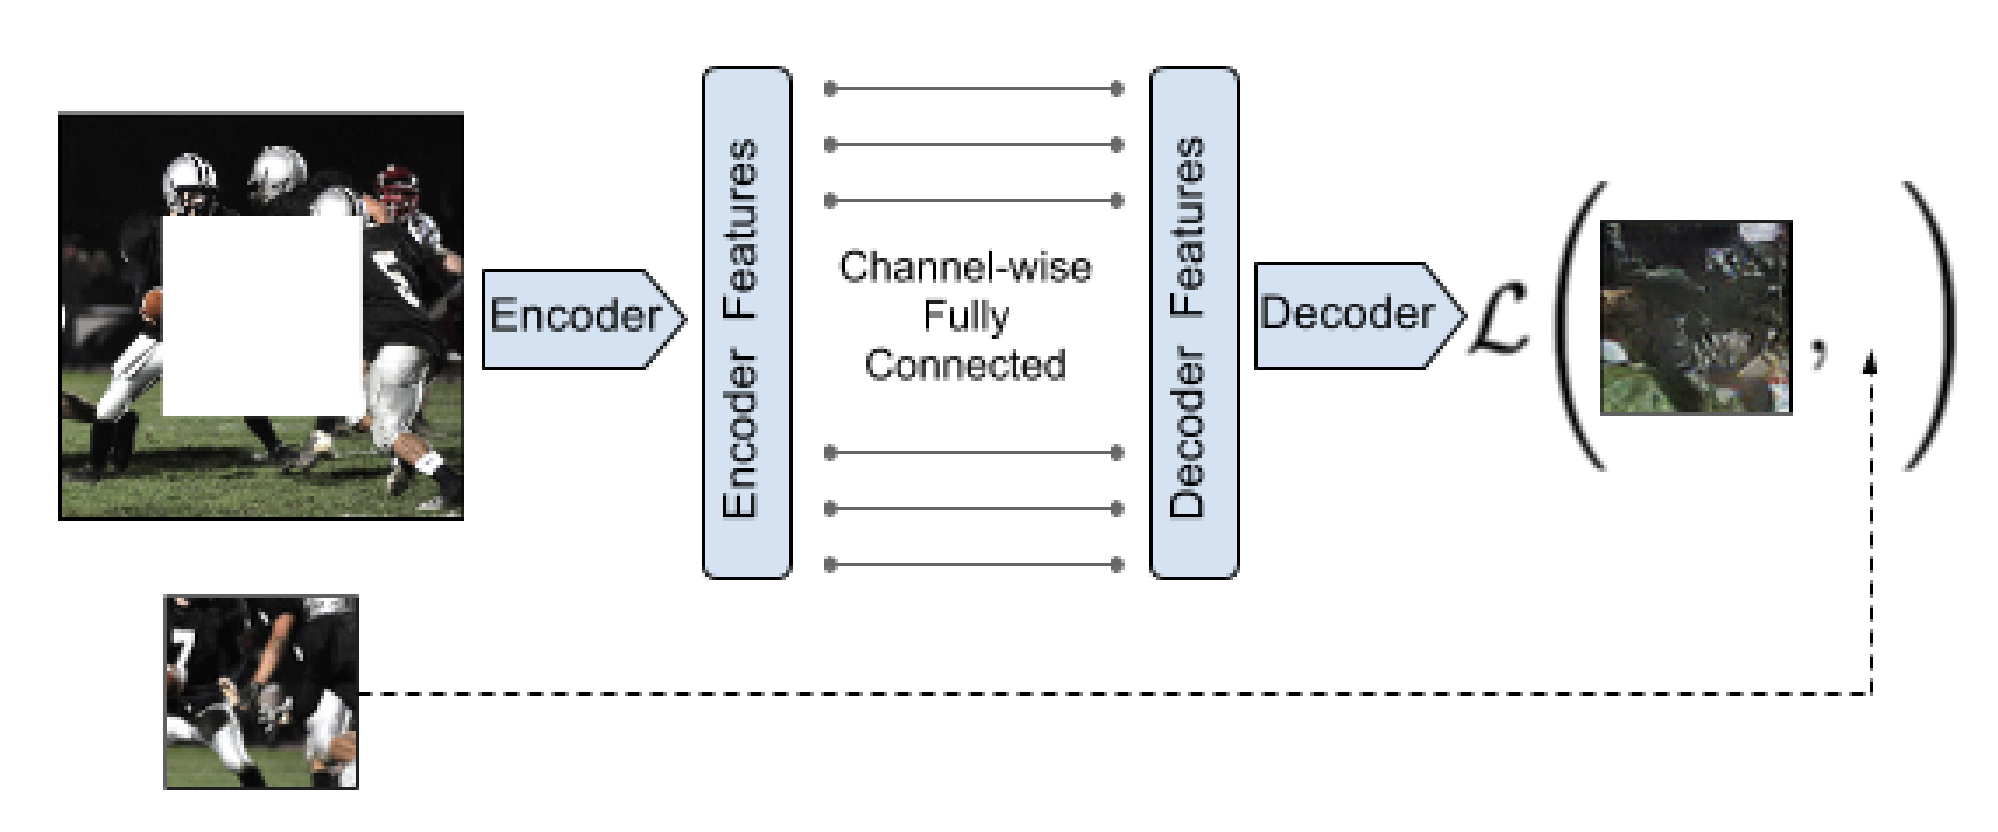
Context Encoder 的训练损失分为两部分:重建损失加上对抗损失。
\[ L(x) = L_{\text{recon}}(x) + L_{\text{adv}}(x) \]
这里的 \(x\) 是原始真实图像,\(L(x)\) 表示对这张图像训练一次时的总损失。它不是单纯的像素误差,而是同时要求模型“补得像原图”和“补得像真实自然图像”。
2.3.1 重建损失
重建损失写为:
\[ L_{\text{recon}}(x) = \left\|M * \left(x - F_\theta((1-M)*x)\right)\right\|_2^2 \]
\(M\) 是二值 mask:
\[ M = \begin{cases} 0, & \text{not masked} \\ 1, & \text{masked} \end{cases} \]
因此 \((1-M)*x\) 表示把被遮挡区域置为 0,只保留未遮挡的上下文。这个被破坏的图像会输入到 encoder-decoder 网络 \(F_\theta\) 中:
\[ \hat{x}=F_\theta((1-M)*x) \]
也就是说,\(F_\theta\) 的任务是:只看没有被 mask 的上下文,预测整张图像或至少预测缺失区域。然后公式中的 \(x-\hat{x}\) 比较真实图像和模型输出,外面再乘以 \(M\):
\[ M * (x-\hat{x}) \]
这一步非常关键,因为 \(M=1\) 的地方才是缺失区域,\(M=0\) 的地方是原本可见的上下文。乘以 \(M\) 后,损失只保留被遮挡区域的误差,忽略未遮挡区域的误差。最后取平方 \(L_2\) 范数:
\[ \left\|M * (x-\hat{x})\right\|_2^2 \]
所以 \(L_{\text{recon}}\) 的完整含义是:让模型根据上下文生成缺失区域,并只在缺失区域上惩罚预测像素与真实像素的差异。
2.3.2 对抗损失
对抗损失写为: \[ L_{\text{adv}} = \max_D \mathbb{E} \left[ \log(D(x)) + \log\left(1-D(F((1-M)*x))\right) \right] \]
这里的 \(D\) 是判别器(discriminator)。\(D(x)\) 表示判别器认为真实图像 \(x\) 是真图的概率;\(D(F((1-M)*x))\) 表示判别器认为模型补全后的图像是真图的概率。这个式子来自 GAN 的二分类目标:
- 对真实图像 \(x\),判别器希望 \(D(x)\) 越接近 1 越好,所以 \(\log(D(x))\) 越大越好。
- 对补全图像 \(F((1-M)*x)\),判别器希望判断它是假的,也就是 \(D(F((1-M)*x))\) 越接近 0 越好,所以 \(\log(1-D(F((1-M)*x)))\) 越大越好。
\(\max_D\) 表示对判别器来说,它要最大化这个目标,也就是尽量分清真实图像和 inpainted image。与此同时,生成补全图像的网络 \(F_\theta\) 会被训练得尽量骗过判别器,使 \(D(F((1-M)*x))\) 变大。这样就形成了对抗学习:判别器越来越会识别假图,生成网络越来越会补出逼真的缺失区域。
直观地说,\(L_{\text{recon}}\) 负责“补的位置和颜色是否接近答案”,\(L_{\text{adv}}\) 负责“补出来的东西看起来是否自然”。只用 \(L_{\text{recon}}\) 容易得到模糊的平均结果;加入 \(L_{\text{adv}}\) 可以让纹理和局部结构更真实。
以下是一个对比结果:
2.4 图像上色与 Split-Brain Autoencoder
图像上色(colorization)把灰度或部分颜色通道作为输入,让模型预测缺失颜色。这个任务要求模型理解物体语义,因为不同物体具有不同的颜色先验:天空常为蓝色,草地常为绿色,香蕉常为黄色。
Split-Brain Autoencoder 的思想是做跨通道预测:把图像通道分成两组,让一组预测另一组。模型如果要从亮度预测颜色,或者从颜色预测亮度,就需要学习跨通道的语义和外观关系。
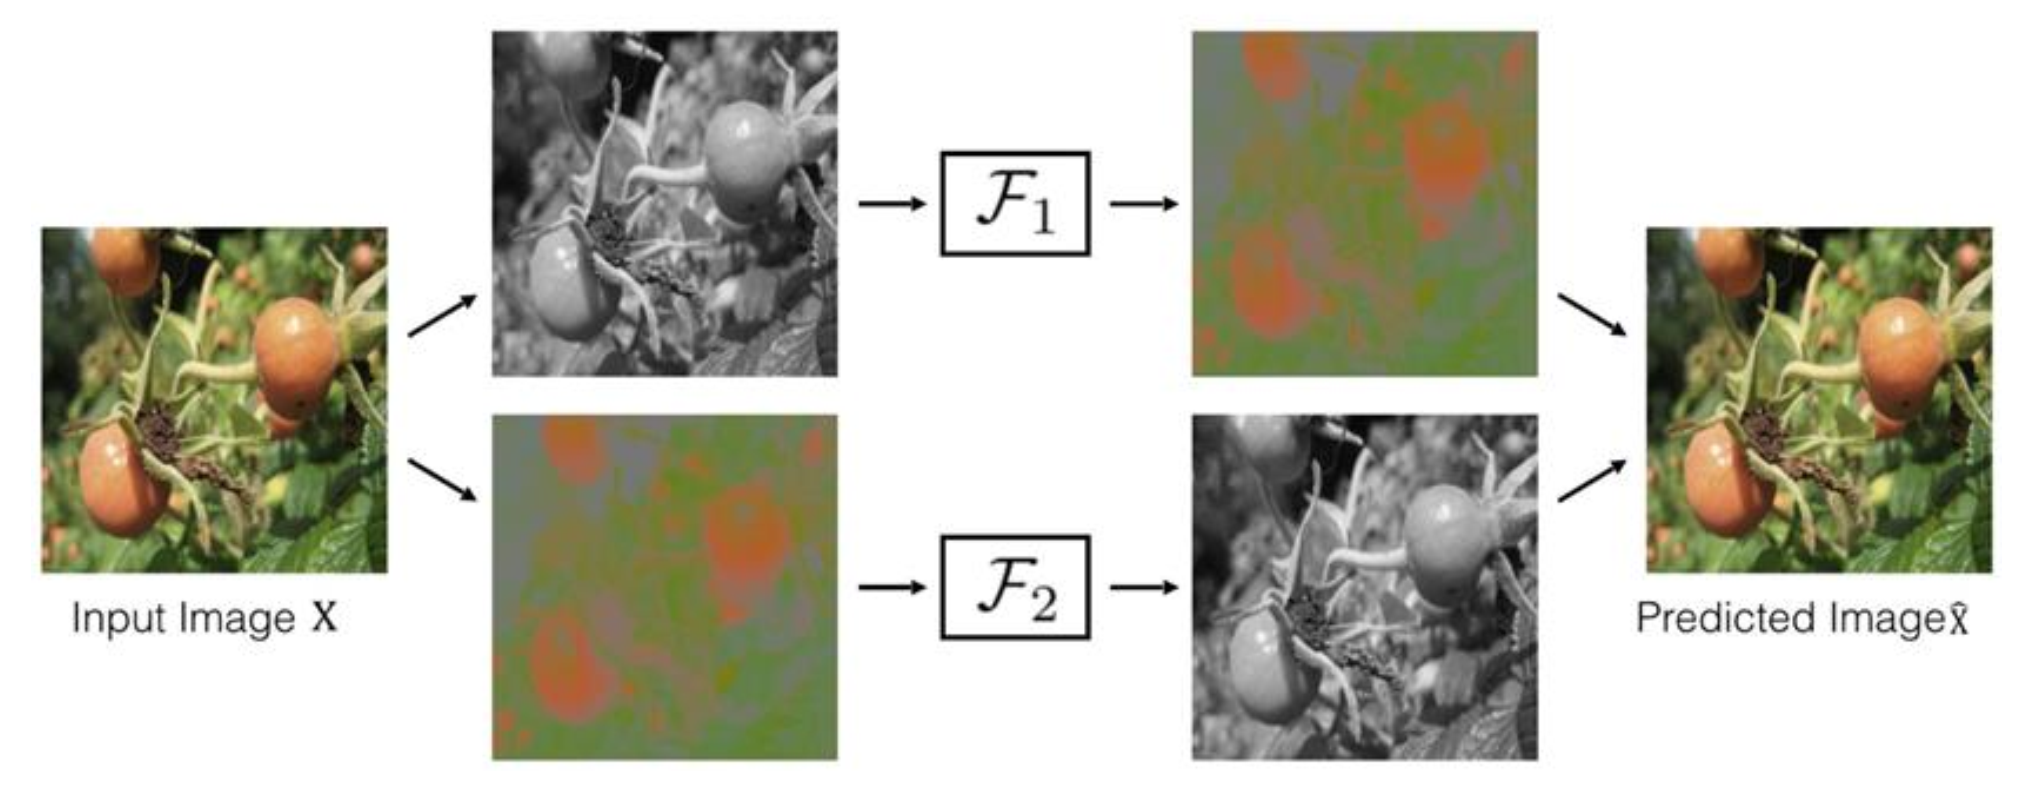
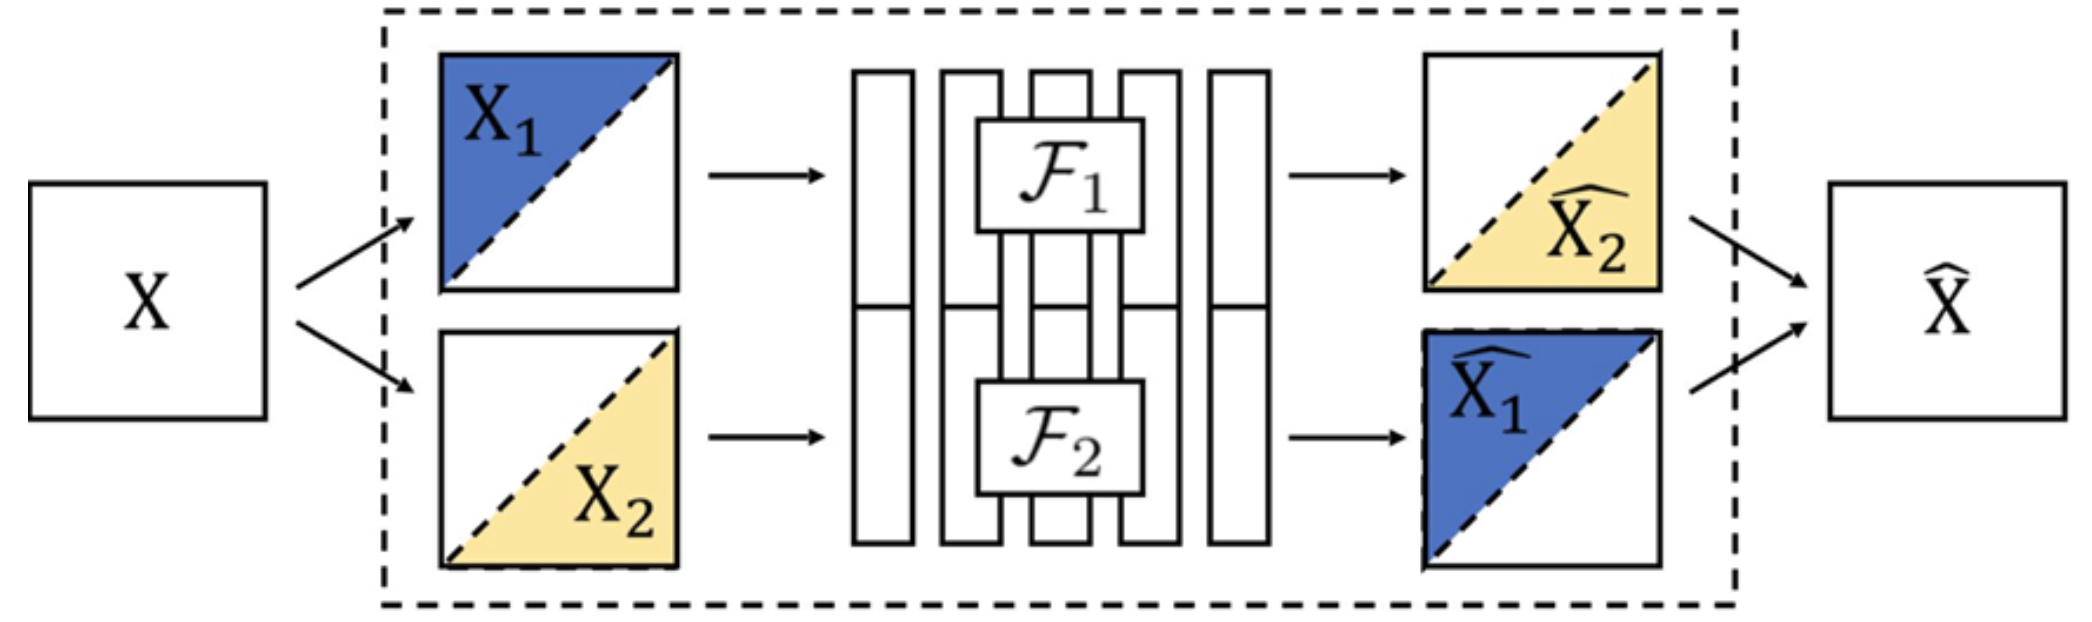
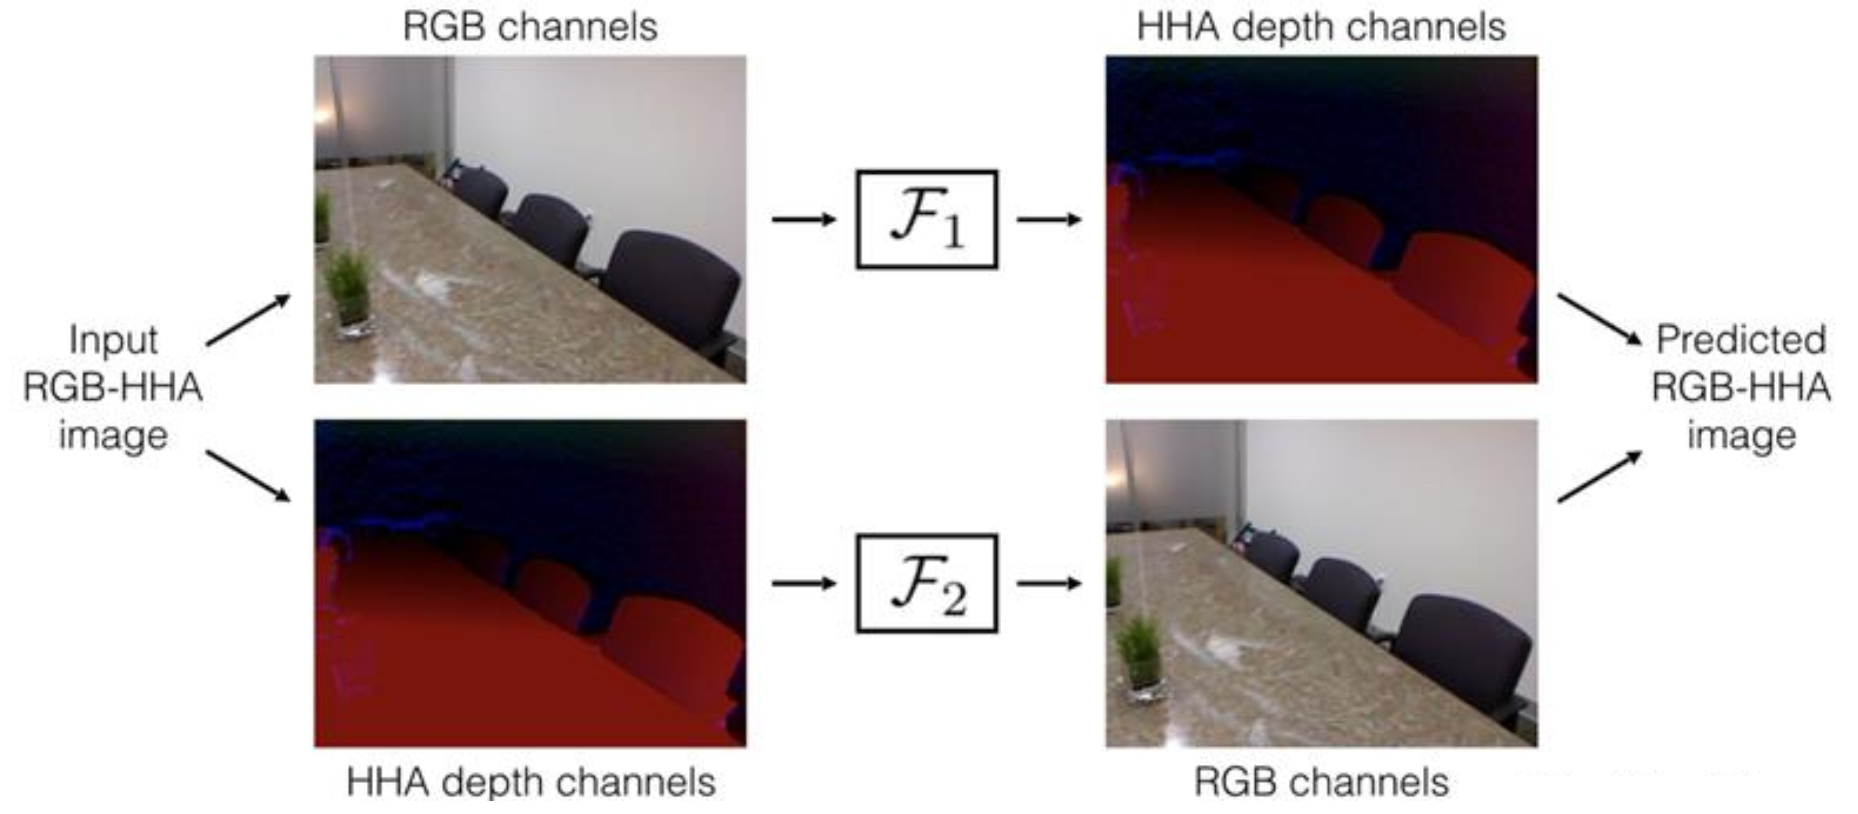
这个任务的一个重要特点是答案可能不唯一。一张灰度衣服可以是红色、蓝色或黑色。因此上色任务不能简单理解为确定性重建,它更像是在学习“哪些颜色与哪些语义区域相容”。
2.5 视频上色与无监督跟踪
视频上色扩展了图像上色:给定一个有颜色的参考帧和之后的灰度目标帧,模型需要把参考帧颜色传播到目标帧。核心假设是视频中同一物体或区域在相邻帧之间应保持颜色一致。
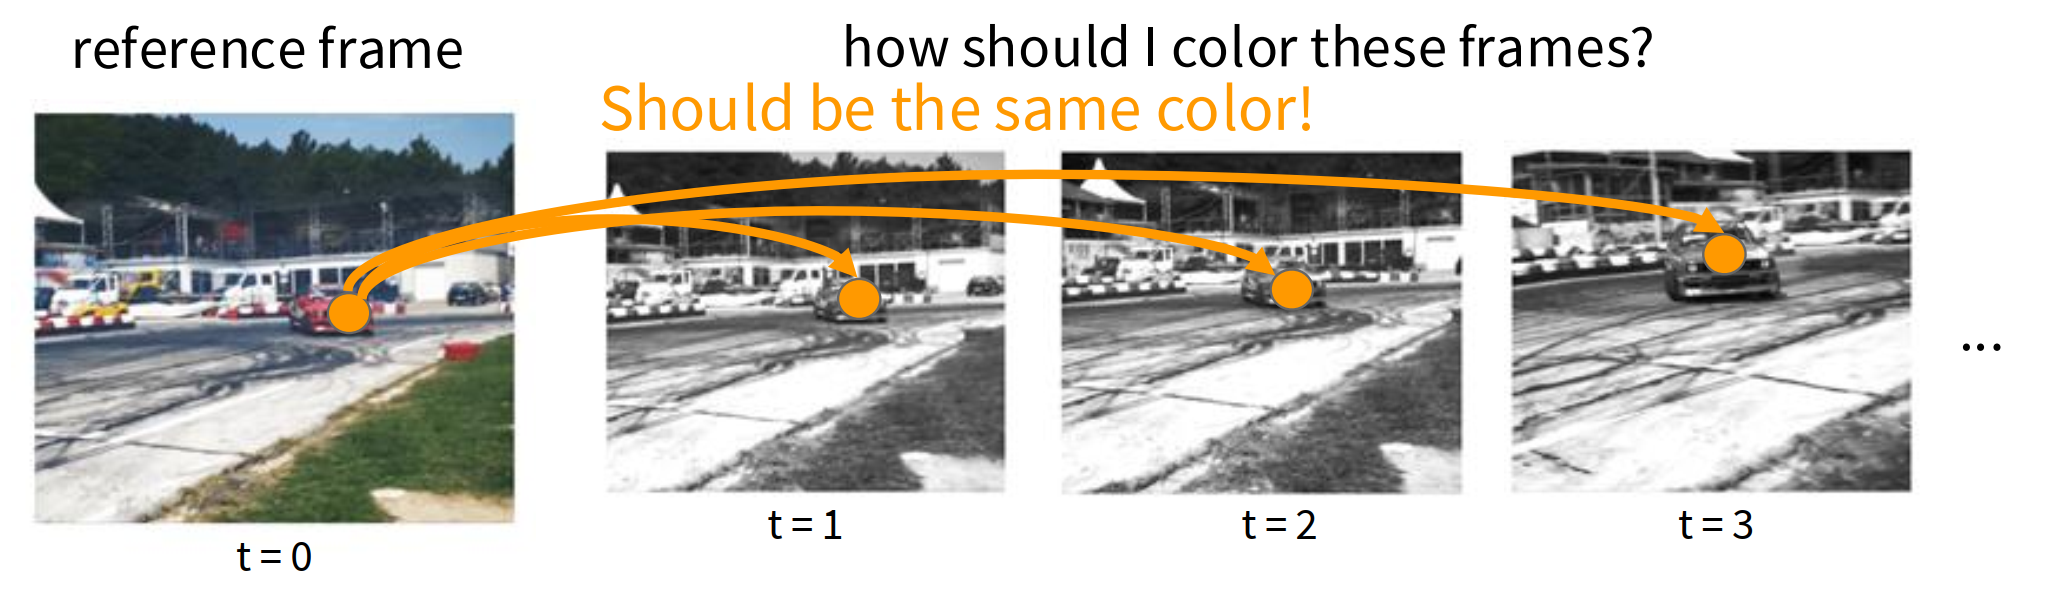
模型会在学习到的特征空间中建立参考帧与目标帧之间的对应关系。目标位置的颜色可以表示为参考帧颜色的加权和:
\[ y_i = \sum_j A_{ij} c_j \]
其中 \(A_{ij}\) 是目标位置 \(i\) 对参考位置 \(j\) 的注意力权重。训练目标是让预测颜色接近目标帧真实颜色。
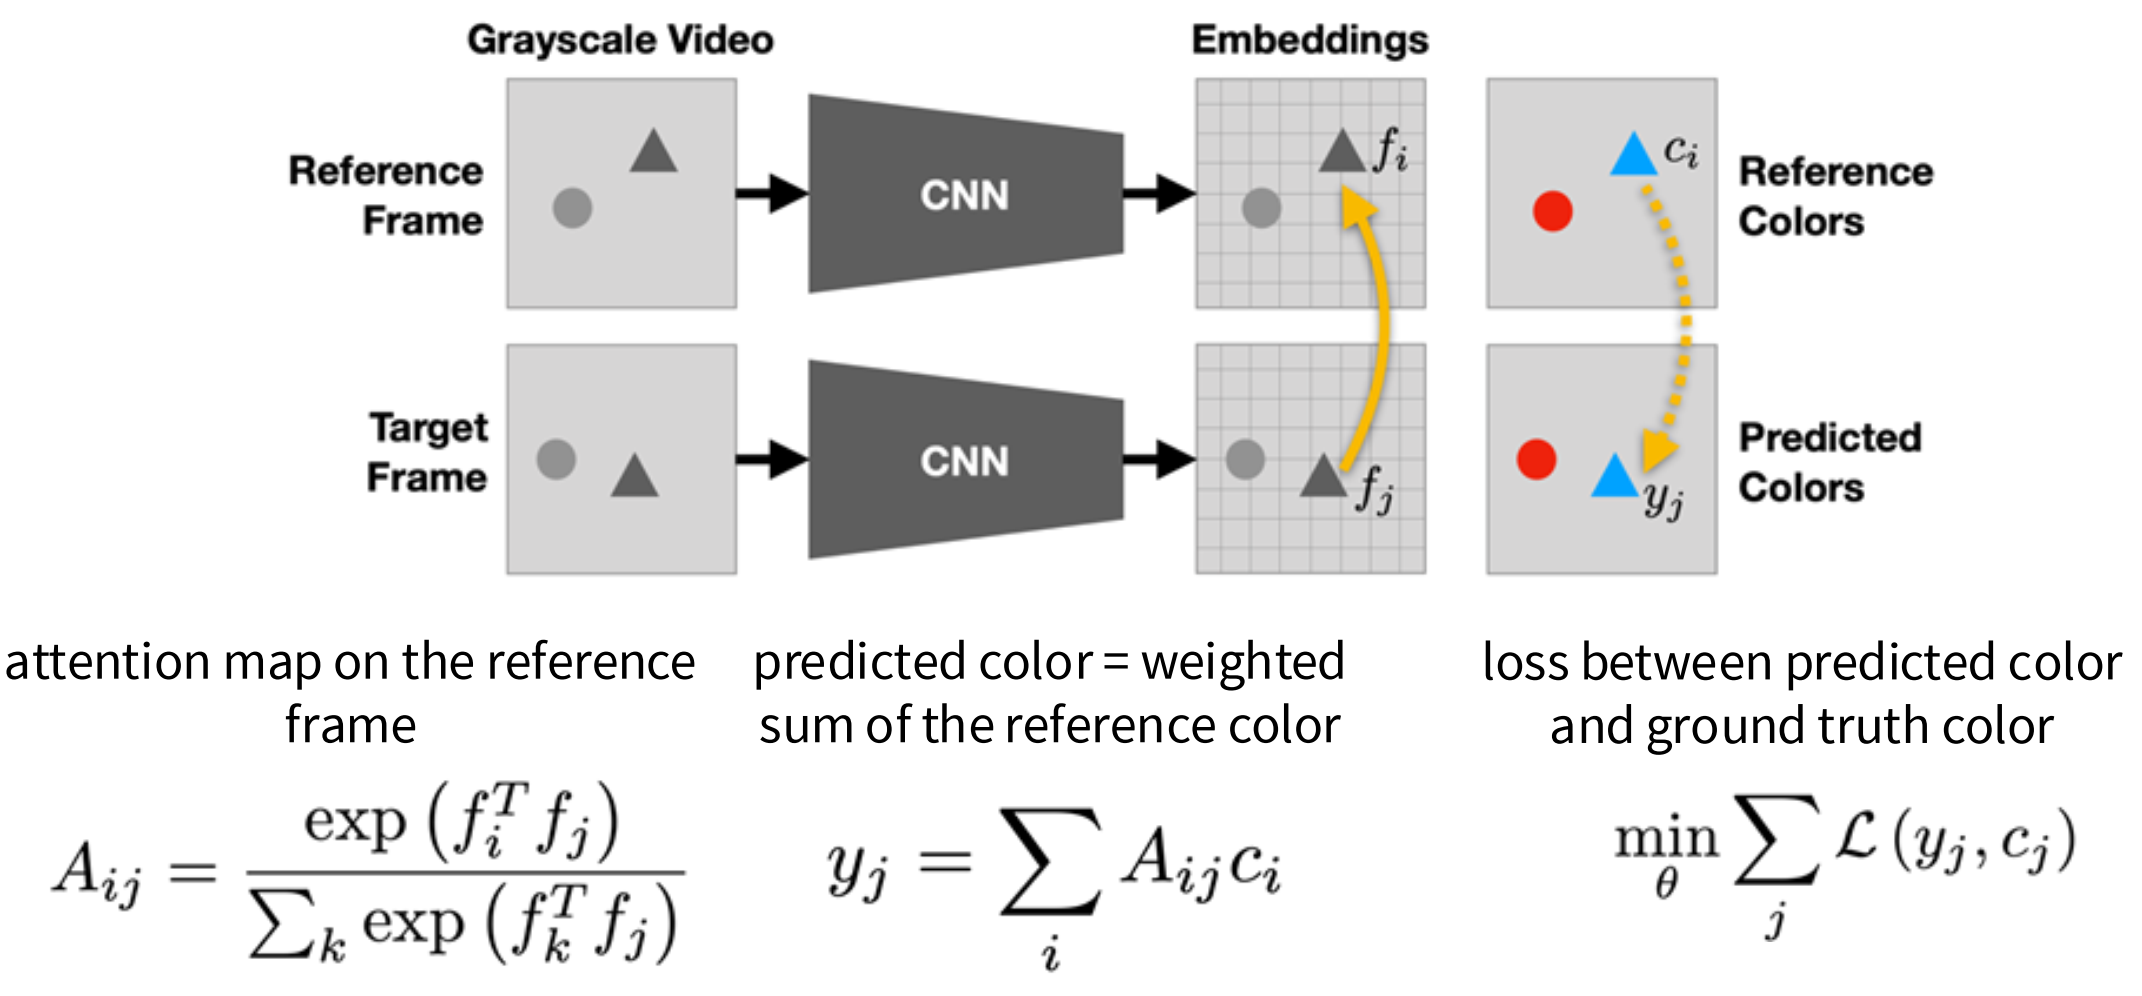
这个任务的有趣结果是:跟踪能力会从上色任务中涌现出来。因为要正确传播颜色,模型必须学会在帧间找到同一物体或同一区域,所以可以用学到的注意力传播分割 mask 或人体关键点。
2.6 图像变换类任务的小结
这类 pretext task 的共同点是让模型学习视觉常识。例如:
- 旋转预测要求理解物体通常朝向。
- 拼图任务要求理解局部部件与全局结构。
- inpainting 要求从上下文推断缺失内容。
- colorization 要求理解语义区域与颜色先验。
- 视频上色要求建立跨帧区域对应关系。
它们的主要问题是:每个任务都需要人为设计,而且学到的表示可能强烈绑定到某个特定任务,不一定足够通用。这引出了更一般的自监督目标:对比表示学习。
3 Masked Autoencoder(MAE)
3.1 MAE 的基本思想
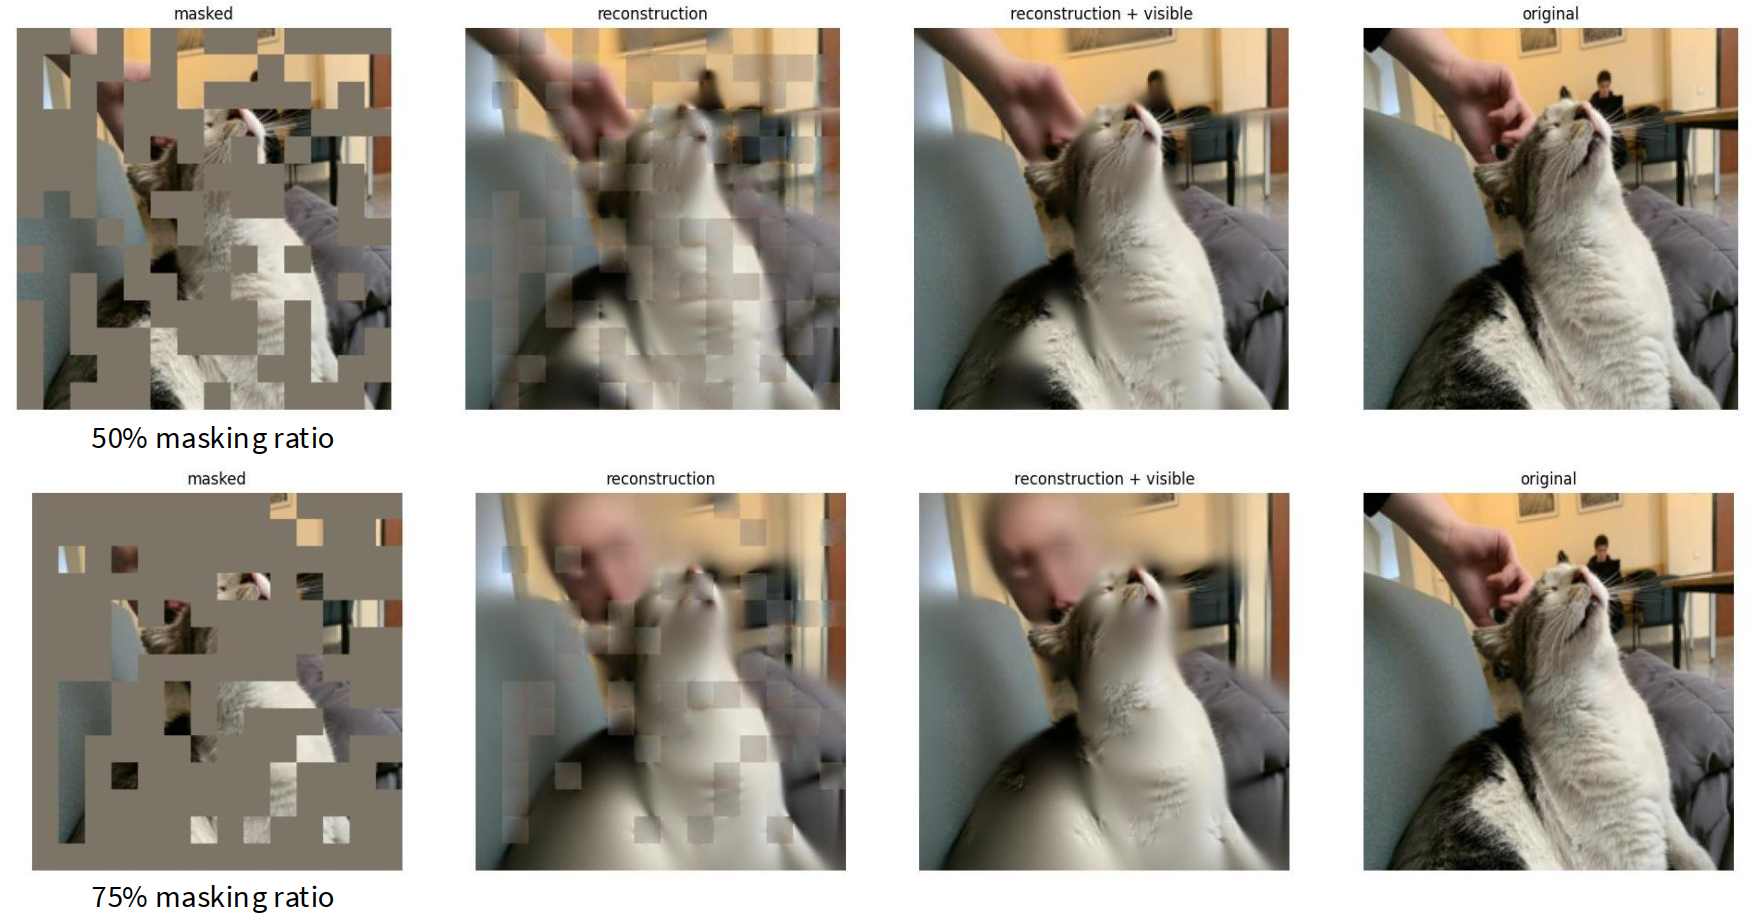
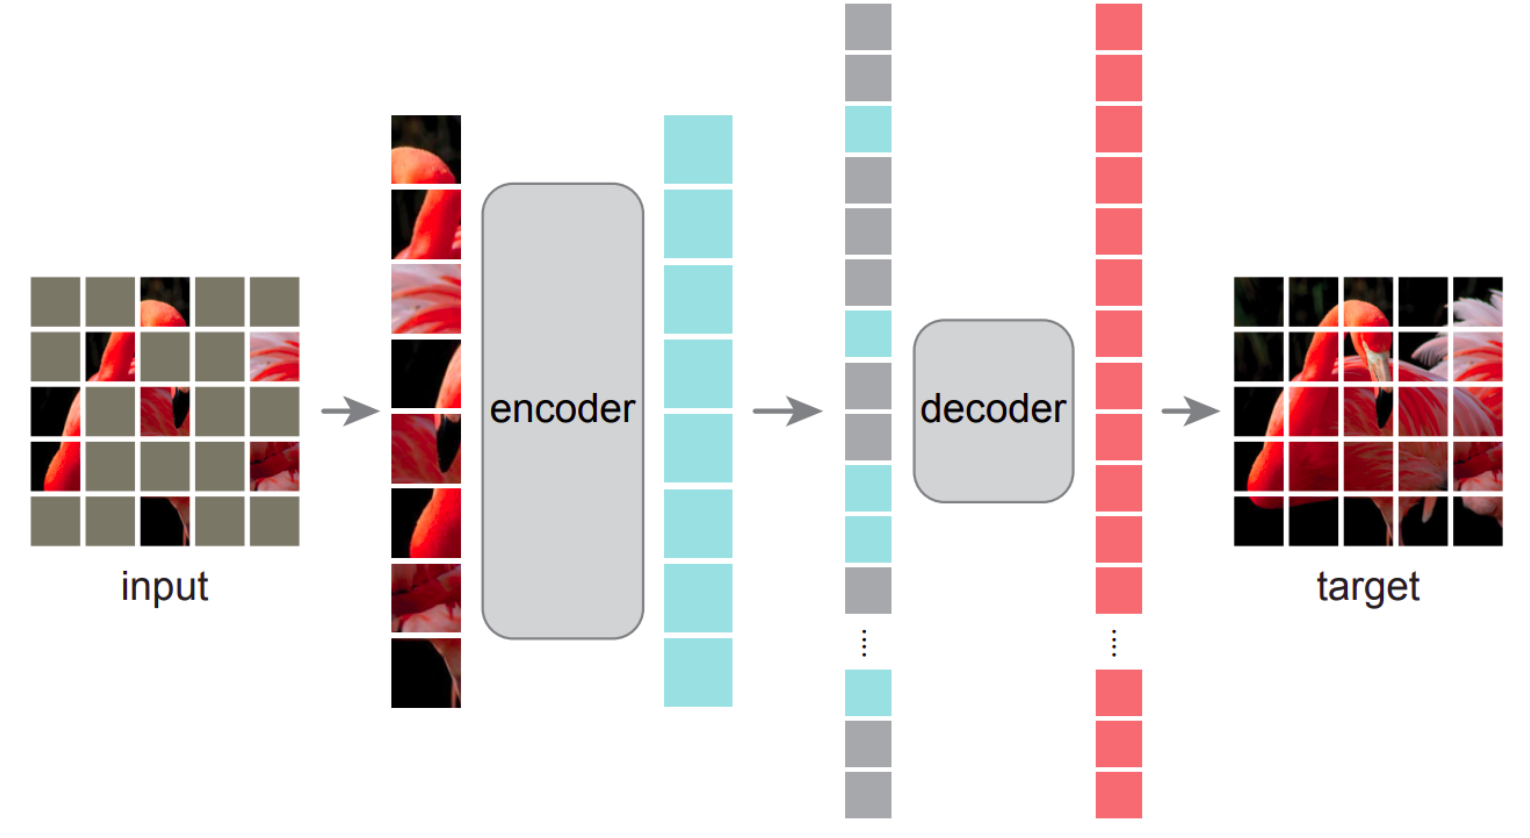
Masked Autoencoder(MAE)是一种重建式自监督方法,尤其适合 Vision Transformer(ViT)。它把输入图像切成不重叠 patch,随机遮住很大比例的 patch,例如 \(75\%\),只把剩下可见的 \(25\%\) patch 输入 encoder,再让 decoder 重建被遮住的 patch。
与普通 autoencoder 不同,MAE 的遮挡比例非常高。高遮挡比例让任务更难,也迫使模型学习更全局、更语义化的表示,而不是只根据局部纹理补一点细节。
3.2 MAE 的非对称结构
MAE 使用非对称 encoder-decoder 设计:
| 组件 | 输入 | 作用 | 训练后是否保留 |
|---|---|---|---|
| Encoder | 只接收未遮挡 patch | 学习表示 | 保留,用于下游任务 |
| Decoder | 接收 encoder 输出与 mask token | 重建像素 | 通常丢弃 |
encoder 只处理可见 patch,因此计算量显著下降,可以做得很大。decoder 负责重建任务,但它只在预训练时使用,下游任务一般使用 encoder 的表示。
3.3 MAE 的重建目标
MAE 使用像素空间的均方误差(MSE)作为损失,并且只在被 mask 的 patch 上计算:
\[ L_{\text{MAE}} = \frac{1}{|\Omega_M|}\sum_{i \in \Omega_M} \|x_i - \hat{x}_i\|_2^2 \]
其中 \(\Omega_M\) 表示被遮挡 patch 的集合。只对遮挡区域计算损失可以防止模型把精力浪费在复制已经可见的输入上。
3.4 Linear probing 与 fine-tuning
在 MAE 或其他自监督方法中,经常使用两种评价方式:
| 方法 | 是否更新预训练 encoder | 新增层 | 评估意义 |
|---|---|---|---|
| Linear probing | 不更新 | 一个线性层 | 测试表示是否线性可分 |
| Full fine-tuning | 更新 | 一个或多个任务层 | 测试模型适配下游任务后的能力 |
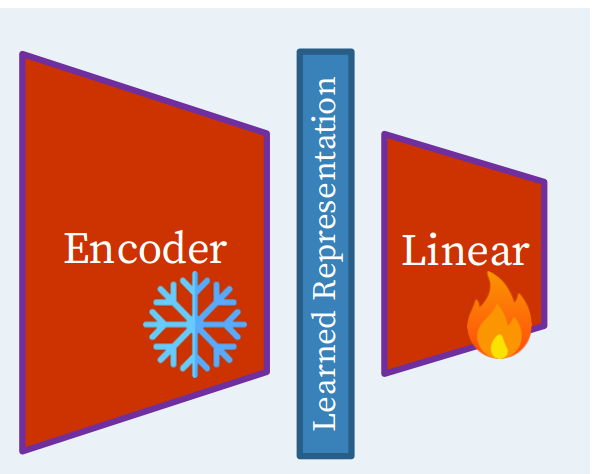
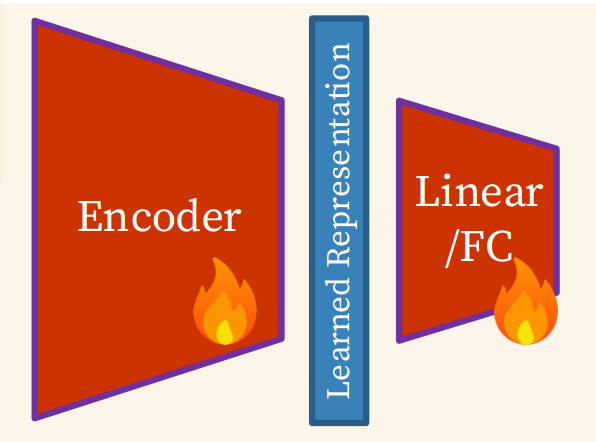
Linear probing 和 Full fine-tuning,前者冻结 Encoder,微调线性层;后者全部都要微调
这里的 linear probing 和 fine-tuning 与 1.3 中的评价方式是同一组概念。1.3 是自监督学习的一般评价方法;3.4 是把这两个方法放到 MAE 语境下,说明 MAE encoder 预训练完成后如何评估。
linear probing 条件更严格,因为 encoder 完全冻结;fine-tuning 更接近真实部署,因为模型可以根据下游任务调整。
3.5 MAE 的设计变量
MAE 的性能受多种超参数影响,包括 mask ratio、decoder 深度、decoder 宽度、是否在 encoder 中使用 mask token、重建目标、数据增强、mask 采样方法和训练时长。
MAE 的关键设计是:高比例随机遮挡 + 只编码可见 patch + 轻量 decoder + 只在遮挡 patch 上计算重建损失。
4 对比表示学习
4.1 从特定 pretext task 到通用 pretext task
图像变换类任务需要为每种数据设计特定任务。对比学习试图构造一个更通用的目标:给定一个参考样本 \(x\),让它的表示靠近正样本 \(x^+\),远离负样本 \(x^-\)。
在视觉任务中,正样本通常是同一图像的不同增强视图,负样本是其他图像。直观地说,模型应该学会:同一物体或同一实例在裁剪、颜色扰动、模糊等变化后仍然相似,而不同实例应该相互区分。
4.2 对比学习的一般形式
设 \(f\) 是 encoder,\(s(\cdot,\cdot)\) 是相似度函数。我们希望:
\[ s(f(x), f(x^+)) >> s(f(x), f(x^-)) \]
给定一个正样本和 \(N-1\) 个负样本,常见的 InfoNCE 损失为:
\[ L = -\log \frac{\exp(s(f(x), f(x^+))/\tau)} {\exp(s(f(x), f(x^+))/\tau) + \sum_{i=1}^{N-1}\exp(s(f(x), f(x_i^-))/\tau)} \]
其中 \(\tau\) 是温度参数,用来控制 softmax 分布的尖锐程度。
这个损失可以理解为一个 \(N\) 类 softmax 分类问题:在 \(N\) 个候选样本中,模型要找出哪个是参考样本的正样本。因此对比学习虽然没有人工标签,但训练目标仍然像监督分类。
这里通常写成 1 个正样本和很多负样本,是因为 InfoNCE 最常见的设置是“给定 reference,在候选集合里找唯一正样本”。例如 SimCLR 中,一张图像做两次增强,其中一个视图作为 \(x\),另一个就是它的 \(x^+\);同一 batch 里其他图像的增强视图都可以作为 \(x^-\)。这不意味着所有对比学习方法都只能有一个正样本,只是单正样本形式最标准,也最容易写成 softmax 分类问题。
4.3 InfoNCE 与互信息
InfoNCE 不只是一个“把正样本分类出来”的 loss,它还有一个信息论解释:InfoNCE 是 \(f(x)\) 和 \(f(x^+)\) 之间互信息(mutual information, MI)的下界。
4.3.1 互信息
互信息衡量两个随机变量之间共享信息的多少。对离散随机变量 \(X\) 和 \(Y\),互信息定义为:
\[ I(X;Y)=\sum_{x}\sum_{y}p(x,y)\log\frac{p(x,y)}{p(x)p(y)} \]
其中 \(p(x,y)\) 是联合分布,\(p(x)\) 和 \(p(y)\) 是边缘分布。如果 \(X\) 和 \(Y\) 相互独立,那么 \(p(x,y)=p(x)p(y)\),所以对数项为 \(\log 1=0\),互信息为 0;如果二者相关,那么联合分布会偏离边缘分布的乘积,互信息就会变大。
对连续随机变量,求和会变成积分:
\[ I(X;Y)=\int\int p(x,y)\log\frac{p(x,y)}{p(x)p(y)}\,dx\,dy \]
互信息也可以用熵来写:
\[ I(X;Y)=H(X)-H(X|Y)=H(Y)-H(Y|X) \]
这个形式的含义是:知道 \(Y\) 之后,\(X\) 的不确定性减少了多少;或者知道 \(X\) 之后,\(Y\) 的不确定性减少了多少。互信息是对称的,即 \(I(X;Y)=I(Y;X)\)。
在对比学习中,我们关心的随机变量不是原始 \(X,Y\),而是两种增强视图经过 encoder 后的表示,例如:
\[ Z=f(x), \quad Z^+=f(x^+) \]
因此更准确地说,目标是让 \(I(Z;Z^+)\) 尽可能大,也就是让同一图像两个增强视图的表示共享足够多的稳定信息。
如果知道 \(f(x)\) 之后,能显著减少我们对 \(f(x^+)\) 的不确定性,那么它们的互信息就高。在对比学习里,\(x\) 和 \(x^+\) 通常是同一张图像的两个增强版本。我们希望 encoder 学到的表示满足:
- 同一图像的不同增强视图仍然保留共同语义信息;
- 数据增强带来的无关变化,例如裁剪位置、颜色扰动、轻微模糊,不应该主导表示;
- 不同图像的表示应该容易区分。
因此,最大化 \(f(x)\) 与 \(f(x^+)\) 的互信息,直觉上就是让模型学到“两个视图共同拥有的稳定信息”。在视觉自监督学习中,这些稳定信息往往对应物体类别、形状、部件结构和场景语义。
4.3.2 InfoCNE
InfoNCE 的形式是:
\[ L_{\text{InfoNCE}}= -\log \frac{\exp(s(f(x), f(x^+))/\tau)} {\sum_{j=1}^{N} \exp(s(f(x), f(x_j))/\tau)} \]
其中候选集合 \(\{x_j\}_{j=1}^{N}\) 包含 \(1\) 个正样本和 \(N-1\) 个负样本。这个式子可以看成一个分类问题:给定 reference \(x\),模型要在 \(N\) 个候选里找出真正相关的 \(x^+\)。
为什么这和互信息有关?直觉是:如果 \(f(x)\) 和 \(f(x^+)\) 真的共享很多信息,那么只看 \(f(x)\) 就应该能在很多候选中准确找出 \(f(x^+)\)。反过来,如果表示没有保留语义信息,正样本和负样本的相似度差不多,模型就无法判断哪个候选与 \(x\) 对应。
理论上,InfoNCE 给互信息提供了一个下界。结合上面的记号,常见写法是:
\[ I(Z; Z^+) \ge \log N - L_{\text{InfoNCE}} \]
这个式子表达了两点:
- 当 \(L_{\text{InfoNCE}}\) 越小,右侧越大,说明模型得到的互信息下界越高。
- 当候选样本数量 \(N\) 越大,\(\log N\) 越大,这个下界有机会变得更紧。
所以 “The larger the negative sample size \(N\), the tighter the bound”。这里的 \(N\) 可以理解为分类题的候选数。候选越多,模型越难从中找出正样本;如果它仍然能找对,就说明表示中保留了更有辨别力的信息。
不过,更多负样本也会带来实际训练成本。SimCLR 直接用大 batch,让同一 batch 中其他样本都成为负样本,因此需要大量显存和分布式训练资源。MoCo 则用一个队列保存历史 key 作为负样本,使负样本数量不再受当前 minibatch size 限制。这也是为什么 InfoNCE 的理论需求会直接影响后面 SimCLR 和 MoCo 的系统设计。
5 SimCLR:实例级对比学习的简单框架
5.1 SimCLR 的训练流程
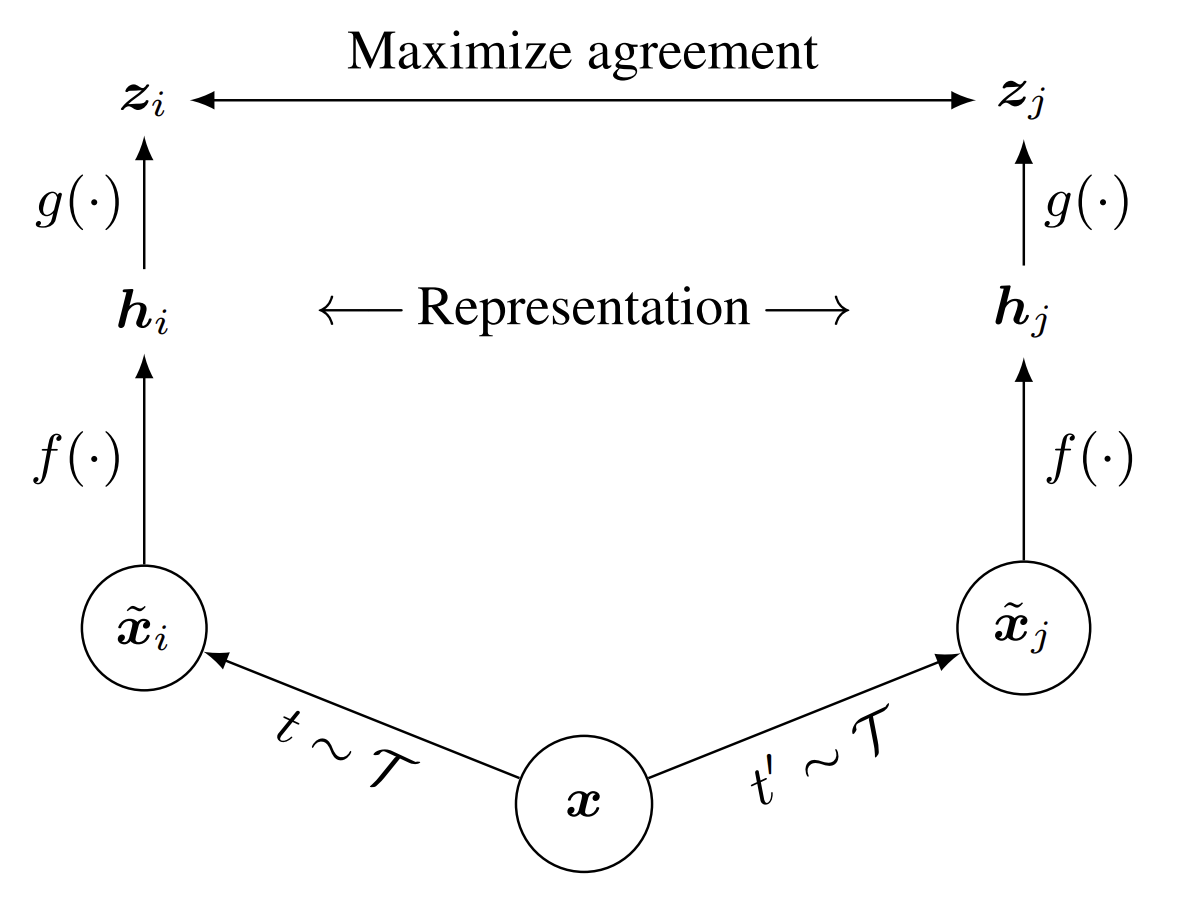
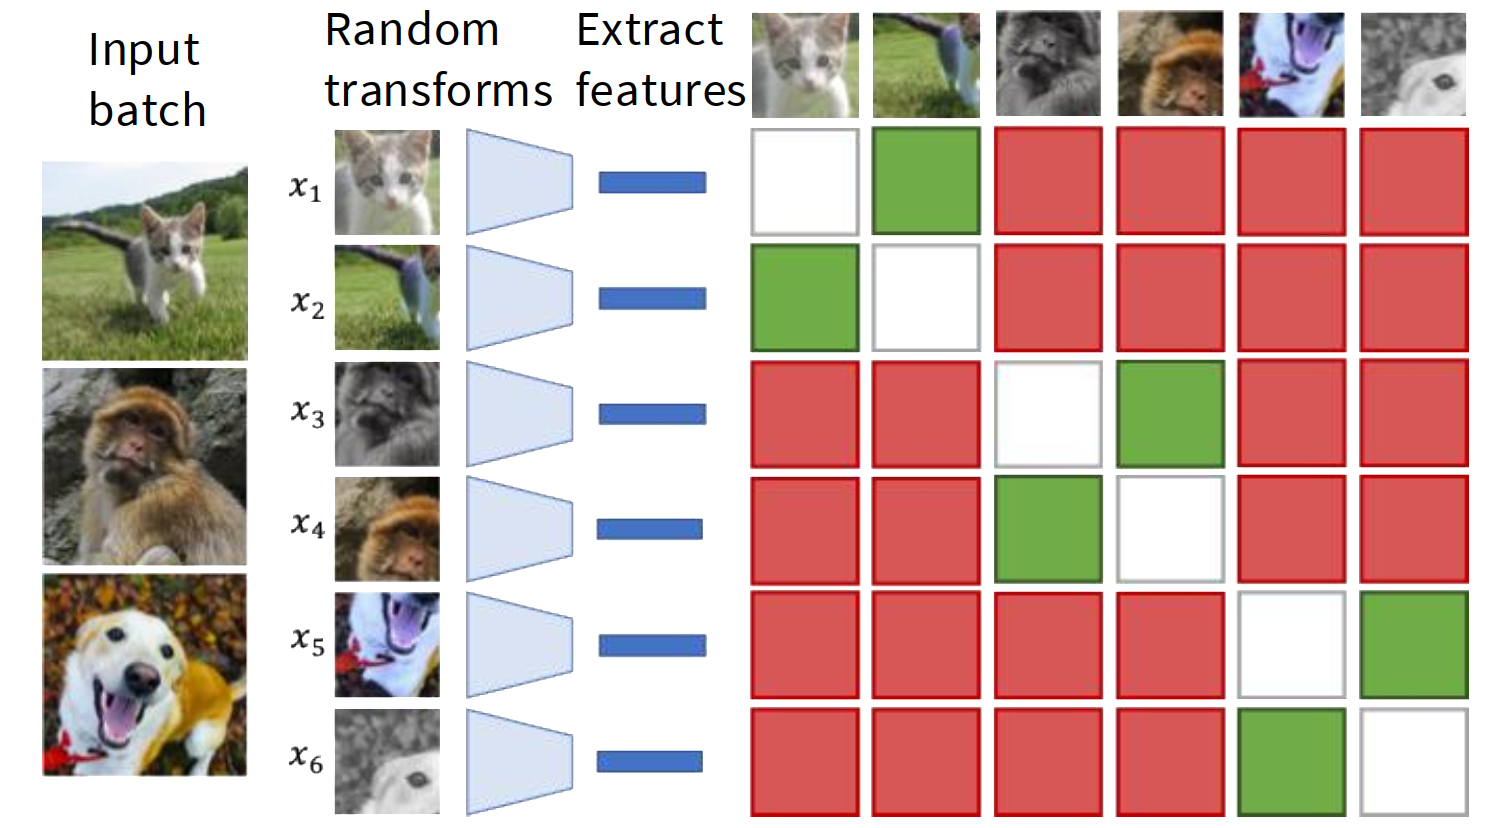
SimCLR(A Simple Framework for Contrastive Learning of Visual Representations)的核心流程是:
- 从一个 minibatch 中采样 \(N\) 张图像。
- 对每张图像采样两次随机数据增强,得到 \(2N\) 个视图。
- 同一原图产生的两个视图构成正样本对。
- batch 中其他视图作为负样本。
- 用 encoder \(f(\cdot)\) 提取表示,再用 projection head \(g(\cdot)\) 投影到对比学习空间。
- 在投影后的表示上计算 InfoNCE / NT-Xent 损失。
常用数据增强包括 random crop、color distortion 和 random blur。SimCLR 的一个重要经验结论是:强数据增强对视觉对比学习非常关键。
5.2 相似度函数与投影头
SimCLR 常用余弦相似度:
\[ \operatorname{sim}(u, v) = \frac{u^\top v}{\|u\|\|v\|} \]
projection head \(g(\cdot)\) 通常是一个小的非线性 MLP。它把 encoder 输出 \(h=f(x)\) 投影成 \(z=g(h)\),对比损失作用在 \(z\) 上,但下游任务常使用 \(h\)。
projection head 有助于表示学习的一个解释是:对比目标会鼓励表示对某些数据增强不变,但这些被丢弃的信息可能对下游任务仍有用。让 \(g\) 承担对比目标,可以让 \(h\) 保留更多通用信息。
5.3 SimCLR 的 batch 训练
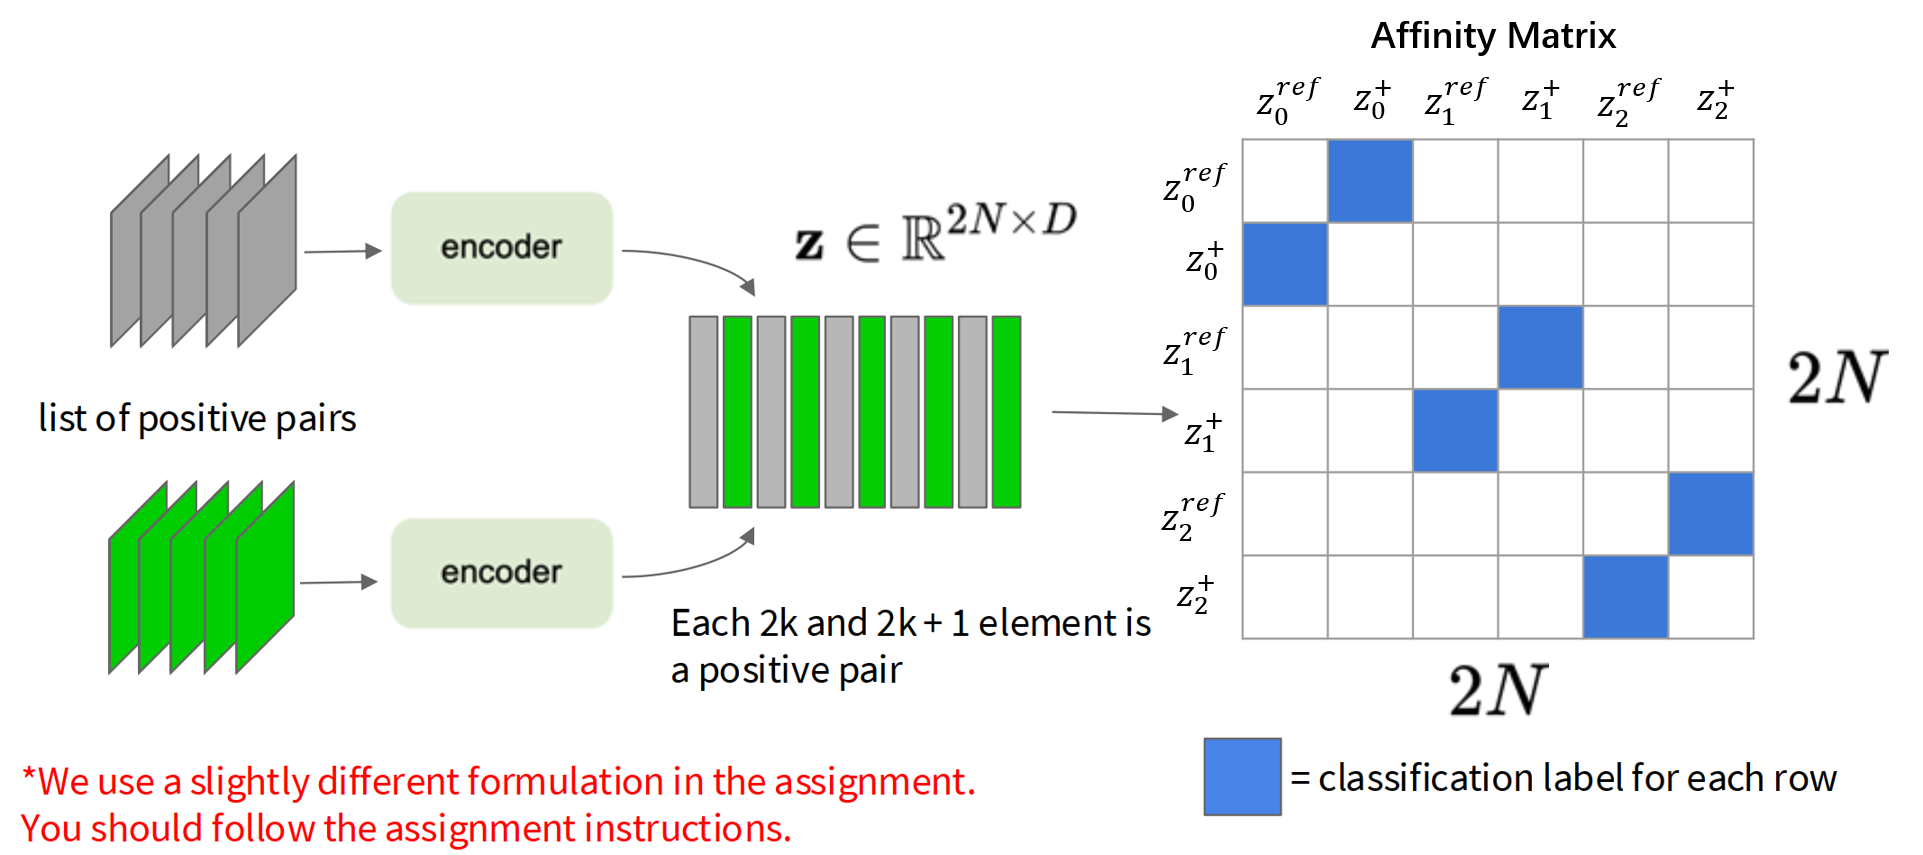
对于 \(2N\) 个增强视图,每个视图都轮流作为 reference。它的正样本是同一原图的另一个视图,其余 \(2N-2\) 个视图是负样本。整个 batch 的损失是所有 reference 损失的平均。
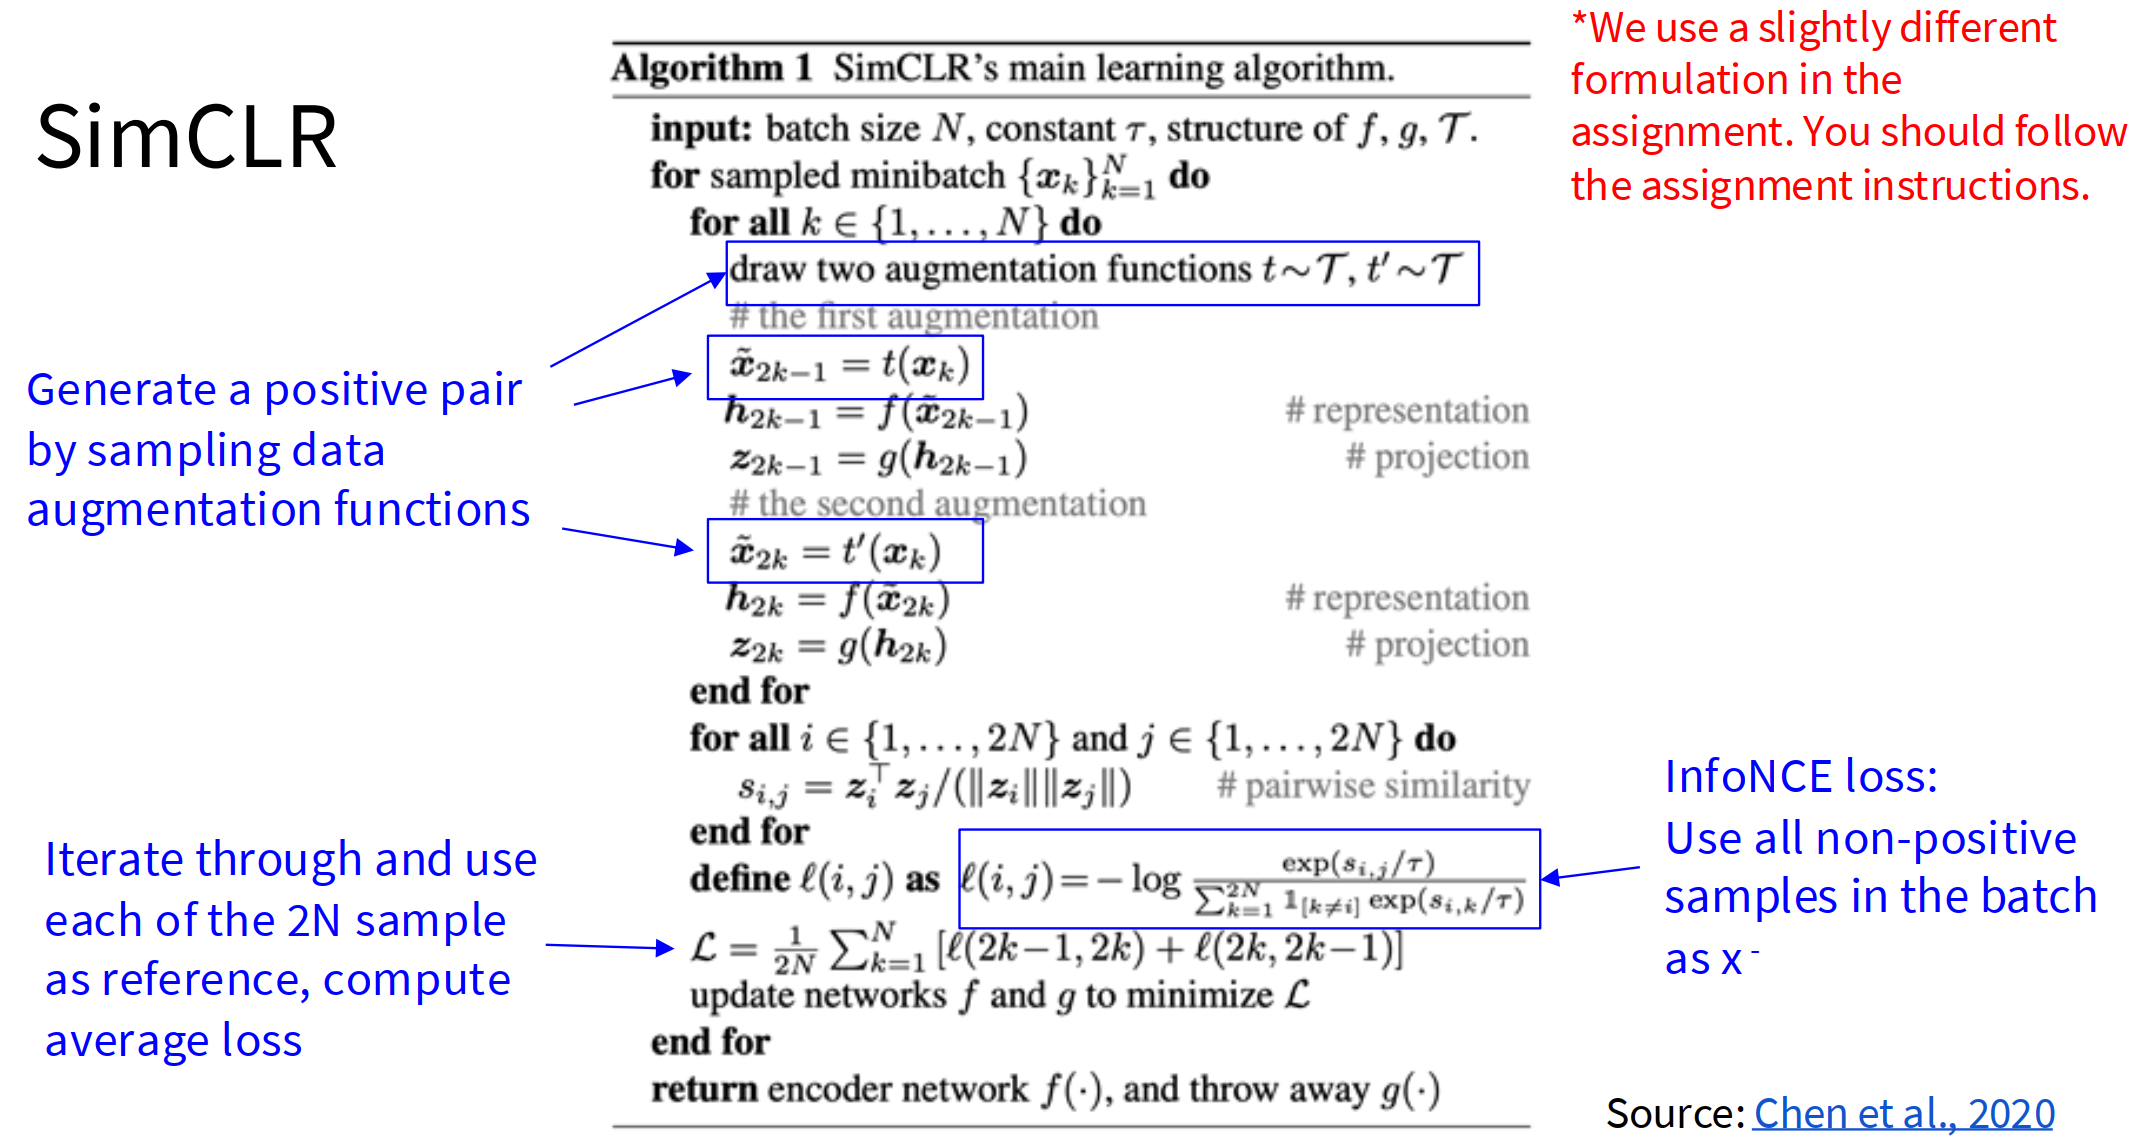
可以把这个过程看成构造一个 affinity matrix:矩阵每一行表示某个 reference 与所有候选视图的相似度,正确分类标签指向它的正样本列。
5.4 SimCLR 的优缺点
SimCLR 简洁、有效,并展示了数据增强、投影头和大 batch 对对比学习的重要性。但它的主要缺点是:为了获得足够多负样本,需要非常大的 batch size。大 batch 会带来很高显存占用,并且 ImageNet 级实验常需要分布式 TPU 训练。
6 MoCo:动量对比学习
6.1 MoCo 解决的问题
MoCo(Momentum Contrast)针对 SimCLR 对大 batch 的依赖,提出用一个运行队列保存大量负样本的 key 表示。这样负样本数量不再等于当前 minibatch 大小。
MoCo 的关键组件包括:
- query encoder \(f_q\):对当前 query 编码,并通过反向传播更新。
- key encoder \(f_k\):对 key 编码,不直接通过梯度更新。
- FIFO queue:保存之前 minibatch 的 key 表示,作为大量负样本。
- momentum update:用 query encoder 的参数缓慢更新 key encoder。
6.2 query 和 key 是什么
MoCo 里的 query 和 key 不是人工标签,也不是两类不同的数据。它们来自同一批原始图像的两种随机增强视图。
以一张原始图像 \(x\) 为例,MoCo 会对它做两次随机数据增强:
\[ x_q = t_q(x), \quad x_k = t_k(x) \]
其中 \(t_q\) 和 \(t_k\) 可以是 random crop、color jitter、blur 等增强函数。\(x_q\) 叫 query view,\(x_k\) 叫 key view。然后它们分别进入两个 encoder:
\[ q = f_q(x_q), \quad k^+ = f_k(x_k) \]
这里的 \(q\) 就是 query 表示,\(k^+\) 是它对应的 positive key。因为 \(x_q\) 和 \(x_k\) 来自同一张原图,所以它们应该表示同一个语义对象或场景,构成正样本对。
MoCo 还维护一个队列,里面存放很多过去 batch 产生的 key:
\[ \{k_1, k_2, \dots, k_K\} \]
这些 key 大多来自其他图像,所以对当前 query \(q\) 来说,它们是负样本。训练目标就是让当前 query \(q\) 更接近它自己的 positive key \(k^+\),远离队列里的 negative keys。
可以把 MoCo 想成一个检索任务:query 是当前要拿去搜索的表示,key 是候选库里的表示。模型要在一堆 key 里找出哪个 key 和 query 来自同一张原图。
6.3 动量更新
key encoder 通过动量规则更新:
\[ \theta_k \leftarrow m\theta_k + (1-m)\theta_q \]
其中 \(\theta_k\) 是 key encoder 参数,\(\theta_q\) 是 query encoder 参数,\(m\) 通常接近 1。这样 key encoder 变化较慢,队列中的旧 key 与当前 key encoder 仍然保持相对一致。
为什么要有两个 encoder?因为 MoCo 的负样本来自一个较长的历史队列。如果 key encoder 更新得太快,队列里旧 key 的表示空间会和当前模型不一致,训练就会不稳定。动量更新让 key encoder 缓慢跟随 query encoder,从而让队列中的 key 表示更加一致。
6.4 MoCo 的训练流程
MoCo 对同一图像做两次数据增强,得到 query view 和 key view。query view 经过 \(f_q\),key view 经过 \(f_k\)。正样本是同一图像的 key,负样本来自队列中的其他 key。计算 InfoNCE 后,只通过 query encoder 更新梯度;随后用动量规则更新 key encoder,并更新 FIFO 队列。
更具体地说,一次训练可以理解为:
- 对图像 \(x\) 做两次随机增强,得到 \(x_q\) 和 \(x_k\)。
- 用 query encoder 得到 \(q=f_q(x_q)\)。
- 用 key encoder 得到 positive key \(k^+=f_k(x_k)\)。
- 从队列中取出很多 old keys 作为 negative keys。
- 用 InfoNCE 让 \(q\) 匹配 \(k^+\),同时远离 negative keys。
- 反向传播只更新 \(f_q\)。
- 用动量公式更新 \(f_k\)。
- 把当前 batch 的 key 加入队列,同时弹出最旧的 key。
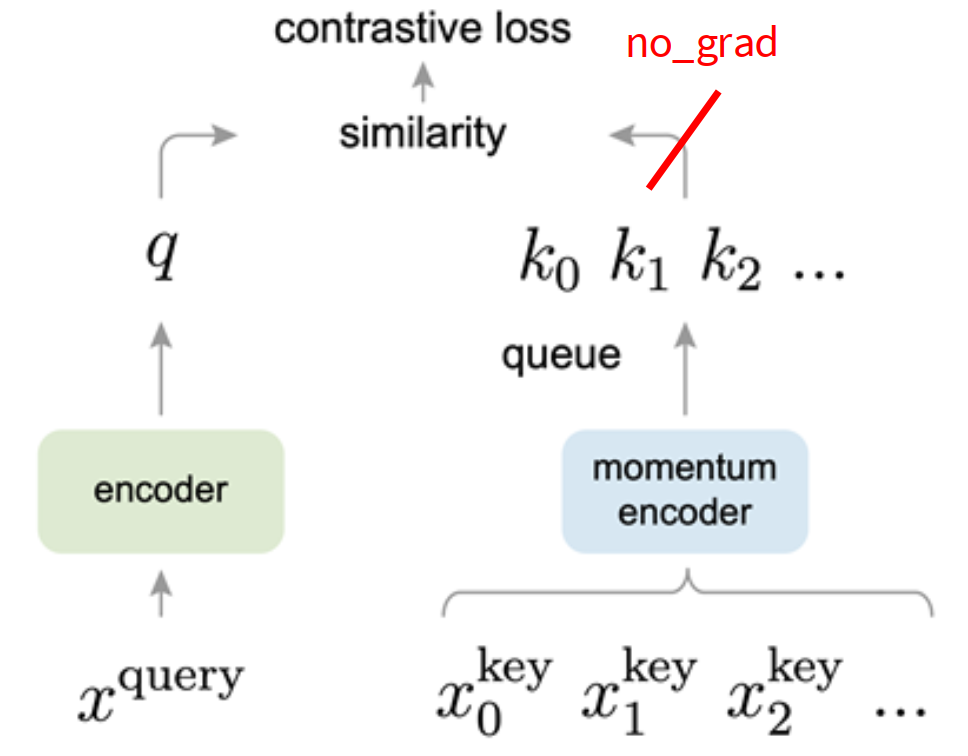
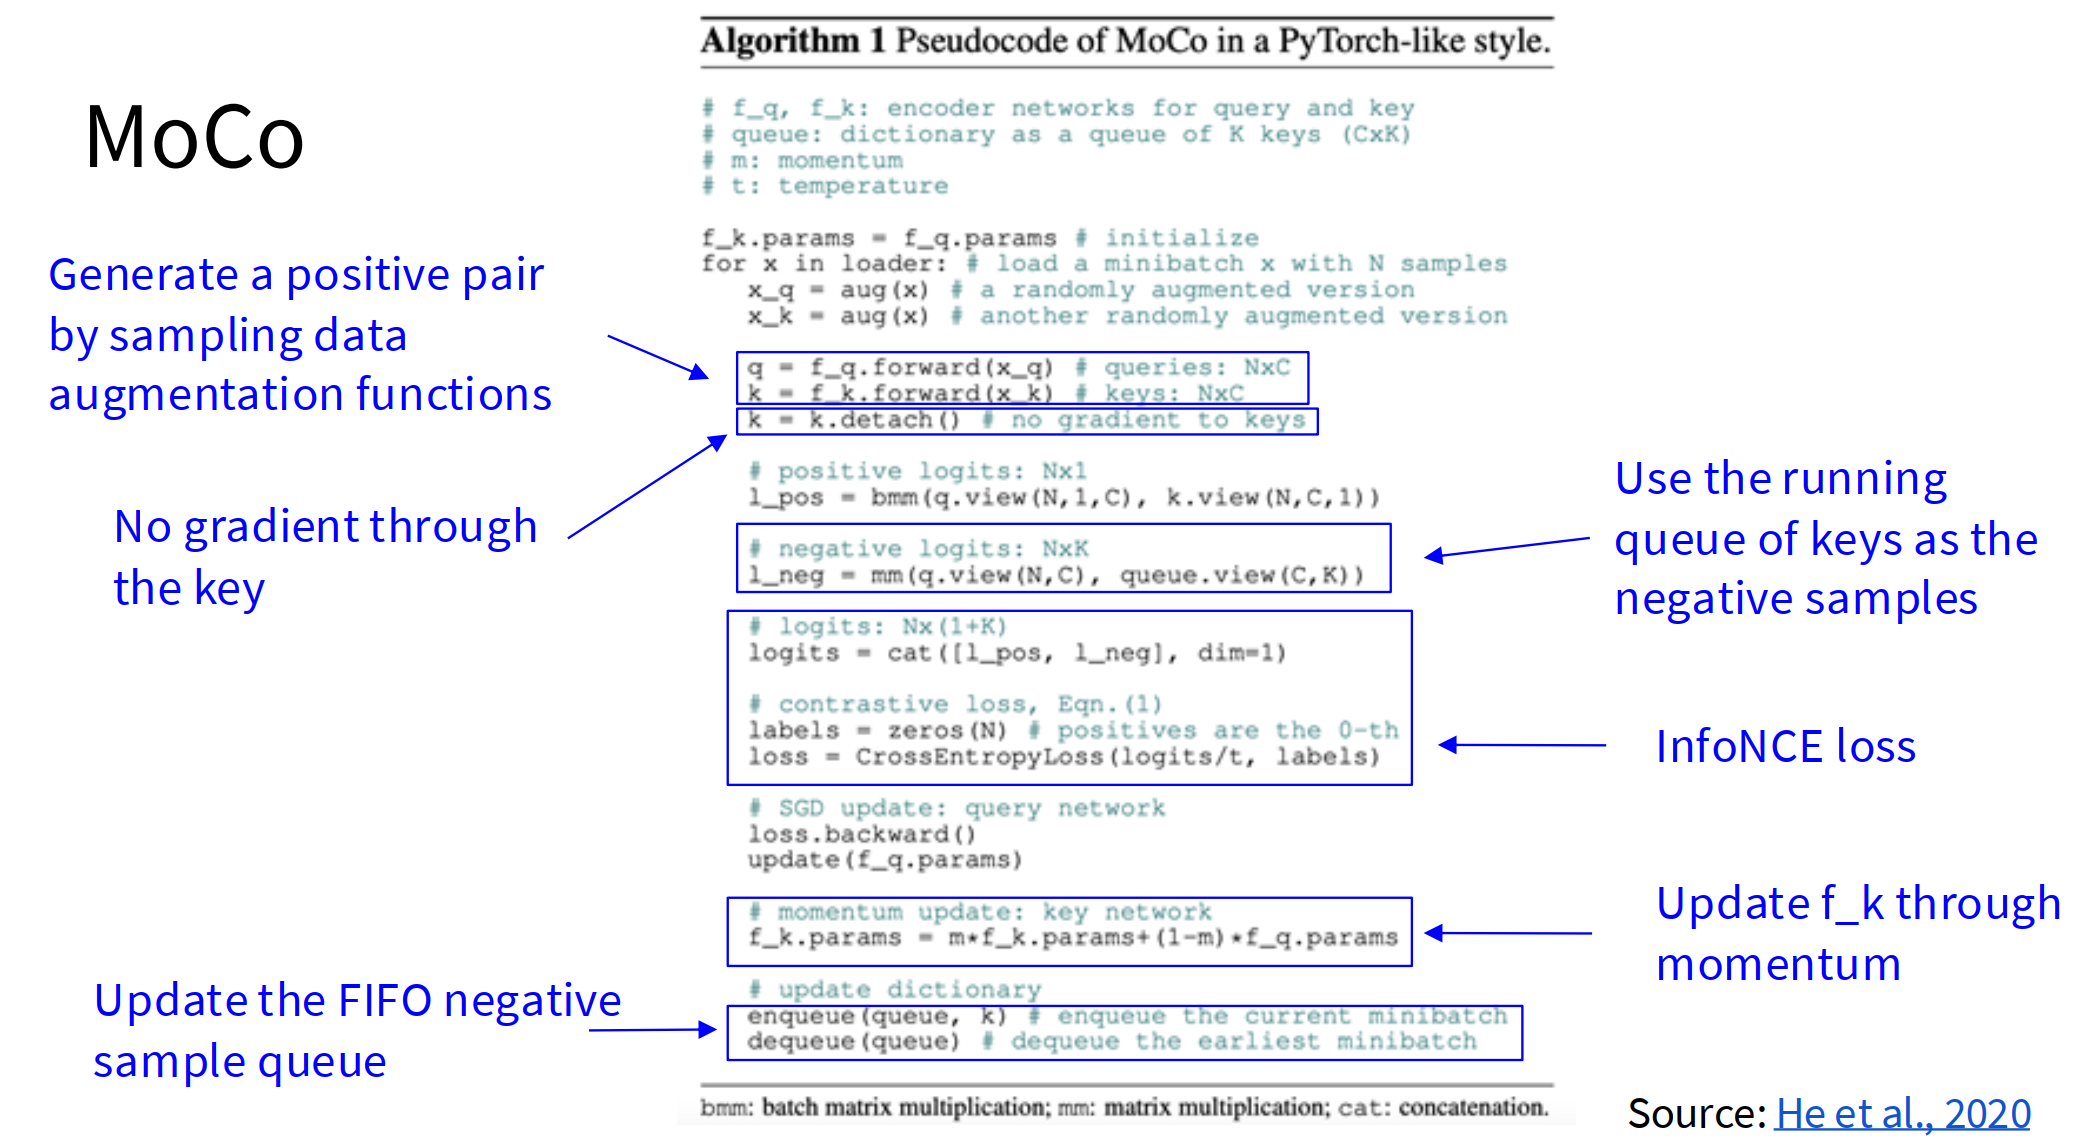
MoCo 的核心优点是:把负样本数量与 minibatch size 解耦。因此它能在较小 batch 下使用大量负样本,显存压力比 SimCLR 小。
6.5 MoCo v2 与 SimCLR 的结合
MoCo v2 吸收了 SimCLR 的两个关键经验:
- 使用非线性 projection head。
- 使用更强的数据增强。
同时保留 MoCo 的动量队列机制。非线性投影头和强数据增强对对比学习很重要;而 MoCo v2 通过队列机制,可以用远小于 SimCLR 的 batch size 获得强性能和更小内存占用。
7 CPC:序列级对比预测编码
7.1 Instance-level 与 sequence-level contrastive learning
SimCLR 和 MoCo 是实例级对比学习:正负样本主要基于“是否来自同一实例”。CPC(Contrastive Predictive Coding)是序列级对比学习:它利用序列或时序结构,让模型根据当前上下文预测未来表示,并在正确未来片段和错误未来片段之间做对比。
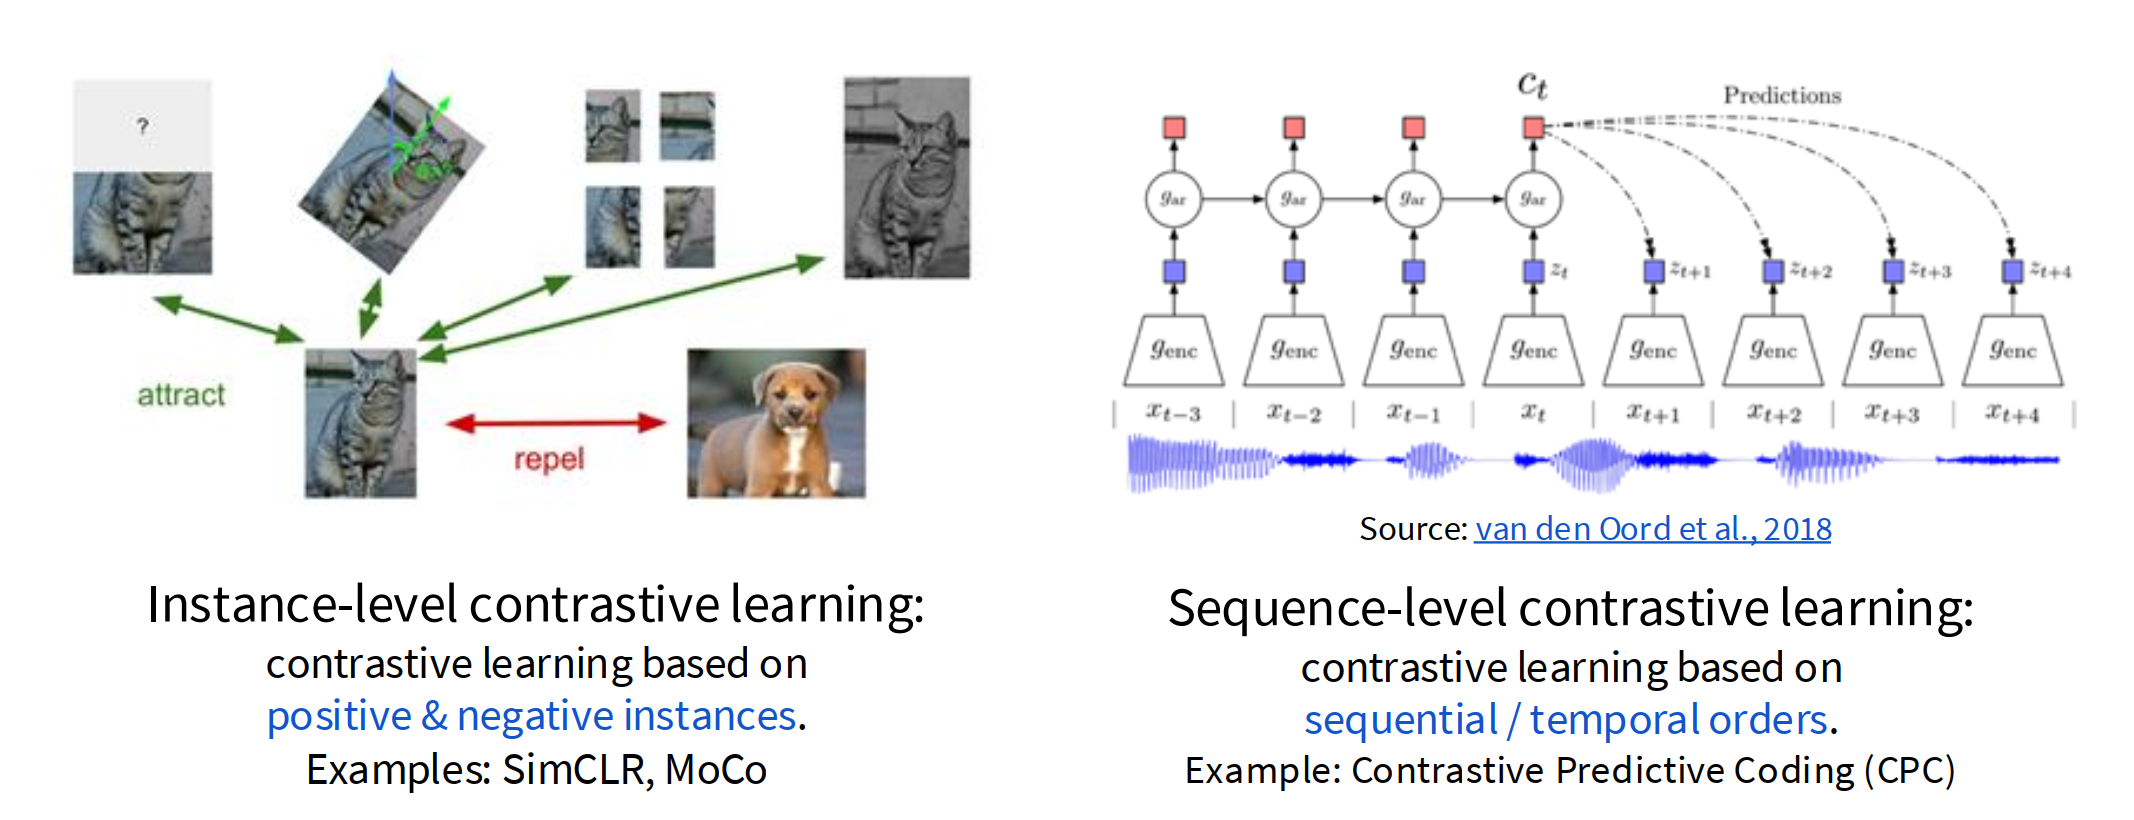
CPC 名称中三个词的含义是:
| 词 | 含义 |
|---|---|
| Contrastive | 在正确序列与错误序列之间做对比 |
| Predictive | 根据当前上下文预测未来模式 |
| Coding | 学习可迁移的特征编码 |
7.2 CPC 的模型结构
CPC 的基本步骤是:
- 用 encoder 把序列中每个样本 \(x_t\) 编码为 \(z_t = g_{\text{enc}}(x_t)\)。
- 用自回归模型(原论文使用 GRU-RNN)把过去上下文汇总为 \(c_t = g_{\text{ar}}(z_{\le t})\)。
- 用 \(c_t\) 同时预测未来多个步长的表示,即 \(z_{t+1},z_{t+2},\ldots,z_{t+K}\)。
- 在真实未来表示和负样本表示之间计算 InfoNCE。
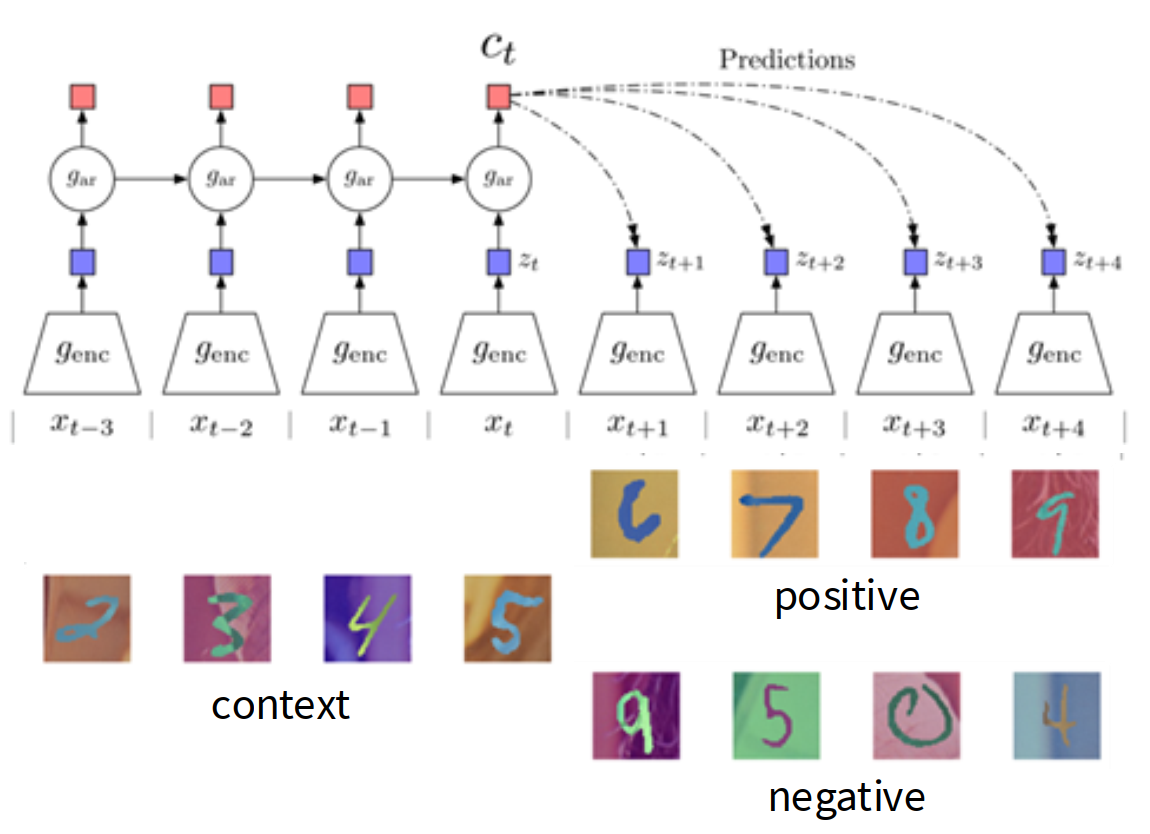
\(g_{enc}\) 对所有时间步 \(t\) 都是一样的,即共享参数;\(g_{ar}\) 也是一样。
时间相关的得分函数常写为: \[ s_k(z_{t+k}, c_t) = z_{t+k}^{\top} W_k c_t \]
其中,\(k\) 表示预测跨度。CPC 通常不是只选择一个 \(k\),而是令 \(k=1,2,\ldots,K\),让同一个上下文 \(c_t\) 同时完成多个未来时刻的预测。例如 \(K=12\) 表示分别预测 \(z_{t+1}\) 到 \(z_{t+12}\),而不是只预测 \(z_{t+12}\)。
如果 \(z_{t+k}\in\mathbb{R}^{d_z}\)、\(c_t\in\mathbb{R}^{d_c}\),那么:
\[ W_k\in\mathbb{R}^{d_z\times d_c} \]
\(W_k\) 是与预测跨度 \(k\) 对应的可学习线性预测头。得分函数可以拆成两步理解:
\[ \hat z_{t+k}=W_kc_t \]
\[ s_k(z_{t+k},c_t)=z_{t+k}^{\top}\hat z_{t+k} \]
首先,\(W_k\) 把上下文 \(c_t\) 转换为模型对未来第 \(k\) 步的预测向量 \(\hat z_{t+k}\);然后计算候选表示 \(z_{t+k}\) 与该预测向量的内积。内积越大,候选表示与当前上下文所暗示的未来越匹配。
每个预测跨度使用不同的矩阵 \(W_k\):\(W_1\) 学习如何预测紧邻的未来,\(W_2\) 学习如何预测未来第二步,依此类推。这是因为近距离预测主要依赖局部连续性,而较远距离预测需要更长期、更抽象的信息。\(W_k\) 不是 encoder 的参数,也不是 GRU 的状态转移矩阵,而是连接上下文空间与未来 latent 空间的预测头。
预测范围 \(K\) 没有固定值,需要根据数据的时间分辨率和任务选择。原始 CPC 的语音实验使用 \(K=12\):每个 latent step 大约对应 \(10\text{ ms}\),因而最远预测约 \(120\text{ ms}\)。消融实验比较了 \(K=2,4,8,12,16\),其中 \(K=12\) 的音素分类效果最好。图像实验把图像编码为 \(7\times7\) 的 patch 网格,并向下预测最多 5 行。一般来说,\(K\) 太小容易让模型只学习局部平滑性;\(K\) 太大则会使未来与当前上下文的相关性过弱,导致预测任务过难。
7.3 CPC 的 InfoNCE 损失函数
对于固定的上下文 \(c_t\) 和预测跨度 \(k\),CPC 构造一个候选集合 \(\mathcal X_k\)。其中包含一个真实未来表示 \(z_{t+k}\),以及 \(N-1\) 个从其他位置或其他序列采样的负样本 \(z_j^-\)。模型需要从这 \(N\) 个候选表示中识别真正属于当前上下文的未来。
第 \(k\) 个预测跨度的 InfoNCE 损失为:
\[ \mathcal L_k = -\log \frac{ \exp\left(z_{t+k}^{\top}W_kc_t\right) }{ \exp\left(z_{t+k}^{\top}W_kc_t\right) + \sum_{j=1}^{N-1} \exp\left((z_j^-)^{\top}W_kc_t\right) } \]
分子是真实未来表示与预测向量的指数得分,分母则包含真实未来和所有负样本的指数得分。因此,这个公式可以看成一个 \(N\) 分类交叉熵:正确类别是真实的 \(z_{t+k}\)。最小化 \(\mathcal L_k\) 会提高真实未来的得分,同时让它相对于负样本更加突出。
如果同时预测未来 \(K\) 步,则总损失通常对所有预测跨度求和或取平均:
\[ \mathcal L_{\text{CPC}} = \frac{1}{K}\sum_{k=1}^{K}\mathcal L_k \]
训练时,梯度会共同更新 encoder \(g_{\text{enc}}\)、自回归模型 \(g_{\text{ar}}\) 和所有预测矩阵 \(W_1,\ldots,W_K\)。因此,模型不会被要求逐像素或逐采样点生成未来,而是学习判断“哪个 latent representation 最符合当前上下文所暗示的未来”。这种目标让表示更多地保留跨时间共享的高层信息。
原始 CPC 还把指数形式的得分写为:
\[ f_k(x_{t+k},c_t) = \exp\left(z_{t+k}^{\top}W_kc_t\right) \]
它近似下面的密度比:
\[ f_k(x_{t+k},c_t) \propto \frac{p(x_{t+k}\mid c_t)}{p(x_{t+k})} \]
如果某个未来片段在给定上下文 \(c_t\) 后变得明显更可能,它的密度比和匹配得分都应该较高。InfoNCE 正是通过“一个条件分布中的正样本与多个边缘分布中的负样本”来学习这个密度比,并最大化当前上下文与未来之间互信息的下界:
\[ I(x_{t+k};c_t)\geq \log N-\mathcal L_k \]
7.4 CPC 的应用
CPC 可以用于音频、语言、图像等序列或可序列化数据。音频天然是时间序列;图像也可以切成 patch,并把上方 patch 行作为上下文,预测下方 patch 行。
CPC 可以应用到多种学习问题,并且能与其他 pretext task 方法相比取得不错效果;但在图像表示学习上,它通常不如更新的实例级对比学习方法强。
8 DINO 与其他自监督方法
8.1 DINO 的目标与核心思想
DINO(Self-Distillation with No Labels)是一种无标签自蒸馏方法。它使用两个结构相同、参数不同的网络:学生网络(student)和教师网络(teacher)。同一张图像经过不同随机增强后分别输入两个网络,学生需要预测教师对另一视图给出的输出分布。
传统知识蒸馏通常先训练一个性能较强且固定的 teacher,再让 student 模仿 teacher 的软标签。DINO 中没有预训练 teacher,也没有人工类别标签。teacher 在训练过程中由 student 参数的指数移动平均逐步构造,因此监督信号来自模型自身过去一段时间的集成状态,这就是“self-distillation with no labels”的含义。
DINO 的基本目标可以概括为:
\[ \text{同一图像的不同视图} \longrightarrow \text{相似的输出分布} \]
这种跨视图一致性迫使模型忽略裁剪、颜色扰动和尺度变化,同时保留不同视图共享的物体语义。DINO 不使用类别标签,也不显式构造负样本,而是通过 teacher-student 一致性、动量更新和防坍塌机制学习表示。
8.2 Student-Teacher 网络结构
设 student 和 teacher 的参数分别为 \(\theta_s\) 和 \(\theta_t\)。两个网络通常具有相同的 backbone 和 projection head,可以使用 Vision Transformer(ViT)或卷积网络:
\[ g_s(x;\theta_s),\qquad g_t(x;\theta_t) \]
其中 \(g_s(x)\) 和 \(g_t(x)\) 是 \(K\) 维 logits。这里的 \(K\) 个输出维度没有人工指定的语义类别,可以把它们理解为模型在训练过程中自行形成的潜在语义方向。projection head 只在自监督预训练阶段用于计算蒸馏损失,下游任务通常使用 backbone 的特征。
两个网络的更新方式不同:
- Student:通过损失函数反向传播,用优化器直接更新。
- Teacher:停止梯度,不进行反向传播,由 student 参数的指数移动平均更新。
因此 teacher 虽然不断变化,却比当前 student 更平滑、更稳定。它相当于近期多个 student 模型的参数集成,能够为 student 提供质量更高的训练目标。
8.3 Multi-Crop 与局部到全局学习
对于一张输入图像 \(x\),DINO 生成多个不同尺度的视图。典型设置包括两个覆盖图像较大区域的全局视图(global views),以及若干覆盖较小区域的局部视图(local views):
\[ \mathcal V= \{x_1^g,x_2^g,x_1^l,\ldots,x_m^l\} \]
其中 \(x_1^g,x_2^g\) 是全局视图,\(x_i^l\) 是局部视图。两类网络接收的视图范围不同:
- teacher 只处理两个全局视图;
- student 处理所有全局视图和局部视图。
teacher 的全局视图输出会监督 student 对其他视图的输出。例如,teacher 看到了包含整只狗的大范围裁剪,而 student 可能只看到狗头或狗腿的局部裁剪。student 仍需预测与 teacher 相近的语义分布,因此必须建立局部到全局(local-to-global)的语义联系。
Multi-crop 不只是增加数据增强数量。它同时带来两个重要作用:一方面,不同视图覆盖范围不同,使模型学习尺度不变性;另一方面,多个小尺寸局部视图的计算成本低于多个大尺寸视图,可以在可控计算量下提供更多训练配对。
8.4 输出概率与蒸馏损失
student 和 teacher 首先输出 \(K\) 维 logits,再通过带温度的 softmax 转换为概率分布。student 的输出分布为:
\[ P_s(x)^{(i)} = \frac{ \exp\left(g_s(x)^{(i)}/\tau_s\right) }{ \sum_{j=1}^{K} \exp\left(g_s(x)^{(j)}/\tau_s\right) } \]
teacher 的输出还需要先减去中心向量 \(c\):
\[ P_t(x)^{(i)} = \frac{ \exp\left((g_t(x)^{(i)}-c^{(i)})/\tau_t\right) }{ \sum_{j=1}^{K} \exp\left((g_t(x)^{(j)}-c^{(j)})/\tau_t\right) } \]
其中 \(\tau_s\) 和 \(\tau_t\) 分别是 student temperature 和 teacher temperature。teacher 通常使用较低温度,使输出分布更尖锐,形成信息更明确的软目标。
给定 teacher 视图 \(x\) 和不同的 student 视图 \(v\),DINO 使用交叉熵让 student 模仿 teacher:
\[ H(P_t(x),P_s(v)) = -\sum_{i=1}^{K} P_t(x)^{(i)}\log P_s(v)^{(i)} \]
总损失对所有允许的跨视图组合求平均:
\[ \mathcal L_{\text{DINO}} = \sum_{x\in\{x_1^g,x_2^g\}} \sum_{\substack{v\in\mathcal V\\v\neq x}} H(P_t(x),P_s(v)) \]
实际实现中还会除以有效视图配对数量和 batch size。条件 \(v\neq x\) 表示不让 student 与 teacher 对完全相同的视图做直接匹配,而是重点学习不同视图之间的一致性。
计算损失时,teacher 分支应用停止梯度(stop-gradient):
\[ P_t(x)=\operatorname{sg}(P_t(x)) \]
因此交叉熵的梯度只更新 student。teacher 输出在当前迭代中被当作固定目标。
8.5 Momentum Teacher 的更新
teacher 参数不是由梯度下降直接优化,而是由 student 参数的指数移动平均(Exponential Moving Average, EMA)更新:
\[ \theta_t \leftarrow m\theta_t+(1-m)\theta_s \]
其中动量系数 \(m\) 接近 1。较大的 \(m\) 表示 teacher 更新较慢,保留更长时间范围内的 student 信息;较小的 \(m\) 则会让 teacher 更快跟随 student。
这一机制与 MoCo 的 momentum encoder 形式相同,但用途不同:MoCo 用它保持队列中 key 表示的一致性,DINO 用它构造稳定的蒸馏目标。EMA teacher 可以近似看成多个历史 student 的集成:
\[ \theta_t^{(n)} \approx (1-m)\sum_{r=0}^{n-1}m^r\theta_s^{(n-r)} \]
最近的 student 权重较大,更早的 student 权重按指数衰减。相比直接复制当前 student,EMA 减少了单个 minibatch 梯度噪声造成的目标剧烈变化,使训练目标更稳定。
8.6 为什么不会表示坍塌
如果只要求 student 和 teacher 输出一致,模型可能找到没有意义的平凡解:无论输入什么图像,所有样本都输出同一个分布。这种现象称为表示坍塌(representation collapse)。DINO 主要通过 momentum teacher、centering 和 sharpening 的组合避免坍塌。
8.6.1 Centering
teacher logits 在 softmax 前减去中心向量 \(c\)。中心向量由 teacher 在 batch 中的平均输出进行指数移动平均:
\[ c \leftarrow m_c c + (1-m_c) \frac{1}{B} \sum_{b=1}^{B}g_t(x_b) \]
如果某个输出维度在几乎所有图像上都长期很大,centering 会减去该维度的平均偏置,防止所有样本都集中到同一个输出维度。它有助于维持不同输出维度之间的平衡,但单独使用时可能把输出推向接近均匀分布。
8.6.2 Sharpening
Sharpening 通过较小的 teacher temperature \(\tau_t\) 实现。温度越低,softmax 分布越尖锐:
\[ \tau_t\downarrow \quad\Longrightarrow\quad P_t(x)\text{ 更集中} \]
尖锐的 teacher 输出可以避免所有样本都得到完全均匀的目标,但如果没有 centering,又可能使所有样本集中在同一个维度。
因此两者具有互补作用:
| 机制 | 主要抑制的坍塌 | 单独使用的风险 |
|---|---|---|
| Centering | 所有样本被同一个维度支配 | 输出趋向均匀 |
| Sharpening | 所有样本都输出均匀分布 | 所有样本集中到同一维度 |
| 两者结合 | 同时抑制两种平凡解 | 需要合理设置温度和动量 |
Momentum teacher 进一步稳定目标,使 centering 和 sharpening 能够形成有效的动态平衡。DINO 因此不需要显式负样本、负样本队列或额外的 predictor 网络,也能避免坍塌并学习有区分力的表示。
8.7 DINO 的完整训练流程
一次训练迭代可以概括为:
- 对每张图像生成两个全局视图和若干局部视图。
- 把所有视图输入 student,只把全局视图输入 teacher。
- 两个网络通过 backbone 和 projection head 产生 logits。
- 对 teacher logits 进行 centering,并分别对 student 和 teacher 使用温度 softmax。
- 计算 teacher 全局视图与 student 其他视图之间的交叉熵损失。
- 停止 teacher 梯度,只通过反向传播更新 student。
- 使用 student 参数的 EMA 更新 teacher。
- 使用当前 batch 的 teacher logits 更新中心向量 \(c\)。
整个训练过程形成一个闭环:student 学习 teacher 的稳定目标,teacher 又由 student 的历史平均构成。随着 student 改进,teacher 的目标也逐渐改进,因此不需要外部标签或预训练模型。
8.8 DINO 学到的 ViT 表示
DINO 与 Vision Transformer 结合时出现了两项重要性质。
第一,ViT 最后一层中 \([\mathrm{CLS}]\) token 的自注意力图能够自动聚焦前景物体,并较清楚地勾勒物体边界。训练过程没有使用分割标签,因此这种空间结构是自监督目标产生的涌现性质。注意力图不等同于完整的语义分割模型,但说明 DINO 特征同时包含图像级语义和较强的局部空间信息。
第二,DINO 特征在不训练额外分类器的情况下也具有很好的近邻结构。使用冻结特征进行 \(k\)-近邻分类(\(k\)-NN)时,同类图像往往已经聚集在表示空间中。这说明语义信息可以直接从特征距离中读取,而不只是在线性分类器训练后才显现。
较小的 ViT patch size 通常会产生更细粒度的 token 和更准确的物体边界,也能提高表示质量,但 token 数量随 patch 变小而增加,从而显著提高自注意力的计算成本。DINO 的优势来自自监督目标、momentum teacher、multi-crop 和 ViT 结构的协同,而不是某一个组件单独决定。
8.9 DINO 与其他自监督方法的区别
| 方法 | 正样本或目标来源 | 是否显式使用负样本 | 目标网络更新 | 主要损失 |
|---|---|---|---|---|
| SimCLR | 同一图像的不同增强 | 是,来自 batch | 无 teacher | InfoNCE |
| MoCo | 同一图像的 query-key | 是,来自队列 | key encoder 使用 EMA | InfoNCE |
| BYOL | target 网络的表示 | 否 | target encoder 使用 EMA | 表示回归损失 |
| DINO | teacher 的软输出分布 | 否 | teacher 使用 EMA | 交叉熵蒸馏损失 |
| MAE | 被遮挡 patch 的像素或特征 | 否 | 无 teacher | 重建损失 |
DINO 与 MoCo 都使用 momentum encoder,但 DINO 不维护负样本队列。DINO 与 BYOL 都让 online/student 网络追随 EMA teacher,但 DINO 匹配的是温度 softmax 后的概率分布,并使用 centering 与 sharpening 防止坍塌。DINO 与 MAE 都不需要负样本,但 MAE 学习重建缺失内容,DINO 学习不同视图之间的语义一致性。
8.10 Dense Object Net
Dense Object Net 是 Dense Object Descriptors 的例子,目标是在像素级或点级学习密集对应关系。它可以看作把对比学习用于像素级特征描述符:同一物体表面对应点应具有相似表示,不同点或不同物体应被区分。
这种思想与视频上色中“通过对应关系传播颜色、mask 或关键点”相呼应:自监督目标如果设计得好,模型会学到可用于跟踪、对应和机器人感知的结构化表示。
9 复习重点与方法对比
9.1 核心概念
自监督学习的关键不是没有监督目标,而是监督信号来自数据本身。它通过 pretext task 学习 encoder,再迁移到 downstream task。
评价自监督模型时,下游任务表现通常比 pretext task 表现更重要。pretext task 是手段,表示质量才是目的。
对比学习的本质是拉近正样本、推远负样本。InfoNCE 可以看作在候选样本中识别正样本的 softmax 分类损失。
负样本数量很重要,但获取大量负样本会带来计算成本。SimCLR 用大 batch,MoCo 用队列。
9.2 方法对比表
| 方法 | 自监督信号 | 关键机制 | 优点 | 局限 |
|---|---|---|---|---|
| Rotation Prediction | 预测旋转角度 | 四分类 | 简单,标签自动生成 | 任务特异性强 |
| Jigsaw / Patch Location | 恢复空间关系 | patch 排列或相对位置 | 学习局部-全局结构 | 可能利用低层线索作弊 |
| Inpainting | 重建缺失区域 | encoder-decoder,重建损失 + 对抗损失 | 学习上下文语义,补全更真实 | 像素重建可能偏低层 |
| Colorization | 从灰度或部分通道预测颜色 | 语义到颜色先验 | 学习物体语义 | 多解问题,评价复杂 |
| Video Colorization | 跨帧传播颜色 | 注意力对应关系 | 可涌现跟踪能力 | 依赖视频时序 |
| MAE | 重建高比例 mask patch | 非对称 ViT autoencoder | 可扩展,适合大模型 | 重建目标与语义目标仍有差距 |
| SimCLR | 同图不同增强为正样本 | 大 batch + projection head | 简洁有效 | 显存需求大 |
| MoCo | 同图不同增强为正样本 | 动量 encoder + queue | 负样本多且省显存 | 队列一致性需动量维护 |
| CPC | 根据上下文预测未来 | 序列级 InfoNCE | 适合时序数据 | 图像表示上通常弱于实例级方法 |
| DINO | teacher-student 一致性 | 无标签自蒸馏 | 不显式依赖负样本 | 需要防止输出坍塌,训练机制较复杂 |
9.3 常见考试问题
pretext task 和 downstream task 的区别是什么?
pretext task 用未标注数据和自动生成目标训练表示;downstream task 是最终关心的应用,通常有人工标注,使用或微调预训练表示。
为什么不能只看 pretext task accuracy?
因为 pretext task 表现高不等于表示通用。自监督学习真正目标是让表示在分类、检测、分割等下游任务中有用。
InfoNCE 为什么像交叉熵?
因为它把“从 \(N\) 个候选样本中选出正样本”写成 softmax 分类问题,正样本得分应最大,负样本得分应较小。
SimCLR 为什么需要大 batch?
因为 batch 中非正样本被用作负样本。batch 越大,负样本越多,通常对比学习效果越好,但显存开销也越大。
MoCo 如何减少对大 batch 的依赖?
MoCo 使用 FIFO 队列保存历史 key 作为负样本,并用 momentum encoder 保持 key 表示稳定,从而把负样本数量和当前 minibatch size 解耦。
projection head 为什么有帮助?
对比目标需要不变性,可能丢弃对下游有用的信息。projection head 让对比损失主要作用在 \(z=g(h)\) 上,使 encoder 表示 \(h\) 能保留更多信息。
MAE 为什么使用高 mask ratio?
高遮挡比例使任务足够困难,模型不能只靠局部复制,而需要利用更全局的图像结构和语义信息。同时只编码少量可见 patch,可以降低 encoder 计算量。
CPC 与 SimCLR / MoCo 的主要区别是什么?
SimCLR 和 MoCo 是实例级对比学习,重点区分同一实例的不同视图与其他实例;CPC 是序列级对比学习,重点根据上下文预测未来序列表示。
linear probing 和 fine-tuning 有什么区别?
linear probing 冻结 encoder,只训练线性层,用来测表示本身;fine-tuning 会继续更新 encoder,用来测模型适配下游任务后的最终能力。
InfoNCE 和互信息有什么关系?
InfoNCE 可以看作互信息的下界。负样本越多,候选集合越大,如果模型仍能找出正样本,就说明表示中保留了更强的共享信息和区分能力。
- DINO 的 teacher 没有标签,也不进行反向传播,它如何得到更新?
DINO 使用 student 参数的指数移动平均更新 teacher。teacher 相当于近期多个 student 的平滑集成,为当前 student 提供比直接复制自身更稳定的软目标。
- DINO 没有负样本,如何避免表示坍塌?
Momentum teacher 提供稳定目标;centering 防止所有样本集中到同一个输出维度;sharpening 防止所有样本都输出均匀分布。三者配合,使不同图像能够形成有区分力的输出分布。
9.4 一句话总览
自监督学习的发展主线是:先通过人工设计的图像变换任务学习视觉常识,再发展到更通用的对比学习目标;SimCLR 表明大 batch、强增强和 projection head 十分关键,MoCo 用动量队列解决负样本规模问题,CPC 把对比思想推广到序列预测,而 MAE 和 DINO 则代表了重建式与蒸馏式自监督视觉学习的重要方向。