1 本讲主线:为什么 3D Vision 先要谈表示
这节课由 Stanford CS231n 的客座讲者 Jiajun Wu 主讲,主题是 3D Vision。老师在视频开头特别强调:这节课和前面几周的卷积网络、Transformer、视觉语言模型、生成模型不太一样,因为进入 3D 以后,第一个问题不是“用什么网络”,而是 3D 对象到底用什么数据结构表示。
2D 图像比较统一:一张 PNG/JPEG 基本就是一个像素矩阵,例如 \(200\times200\) 或 \(500\times500\)。即使任务不同,输入形式通常仍然是规则网格上的 RGB 像素。但 3D 对象没有这样统一的自然格式。一个 3D 对象可能包含:
- 几何(geometry):形状、表面、体积、拓扑。
- 纹理(texture):表面颜色和图案。
- 材料(material):透明、粗糙、金属、高光等反射属性。
- 尺度和结构:可以是杯子、椅子、人体,也可以是城市、树、河流状分叉结构。
课件开头的玻璃杯、城市航拍、自然分叉结构等图片就是在说明:3D 世界远比一张固定大小的像素图复杂。对象可以透明,可以有复杂拓扑,可以是大尺度场景,也可以有非常细的局部纹理和几何细节。因此,本讲先从 3D shape representation 讲起,再讨论深度学习如何和这些表示结合。
老师给出的核心问题可以概括为:
在 2D 中我们几乎默认使用 pixels;但在 3D 中,我们必须先决定用点、网格、体素、参数曲面、隐式函数、神经场还是结构化部件来表示对象。
这个选择会影响后面所有事情:存储、编辑、生成、渲染、动画、重建、分类、分割,以及是否容易与深度网络结合。
2 3D 几何表示的基本谱系
课件把 3D 几何表示先粗分为两大类:显式表示(explicit representations) 和 隐式表示(implicit representations)。
| 类别 | 代表形式 | 核心思想 | 典型优势 | 典型困难 |
|---|---|---|---|---|
| 显式表示 | 点云、polygon mesh、subdivision、NURBS、样条、参数曲面 | 直接给出表面上的点、面片,或给出能直接生成表面点的参数映射 | 容易采样表面点;适合传统图形学渲染和局部编辑 | 不一定容易判断任意空间点在物体内还是外;拓扑和不规则结构会给神经网络带来困难 |
| 隐式表示 | 代数曲面、CSG、距离函数、SDF、level set、occupancy/radiance field | 用函数关系定义表面、内部、密度或外观 | 内外测试、融合、分裂、布尔运算和可微查询方便 | 表面采样和高效渲染可能困难;密集空间查询代价高 |
老师在视频中补充了一个重要视角:每一种表示都不只是数学定义,它还决定了深度学习怎么用它。 图像输入是固定大小矩阵,所以 CNN 很自然;但 3D 点云是无序集合,mesh 是不规则图,体素是三维体积,隐式函数是连续坐标查询。深度学习在 3D 里起步相对晚,一个重要原因就是这些表示没有像图像像素那样统一、规则、容易批处理。
选择表示时要考虑:
- 存储:点云、mesh、体素、函数参数的存储方式完全不同。
- 形状创建:输入可以是照片、文字、手绘 stroke、CAD 操作或随机 latent code。
- 几何操作:编辑、简化、平滑、滤波、修补、配准、融合。
- 渲染:如何把 3D 表示变成 2D 图像。
- 逆渲染与重建:如何从 2D 图像反推 3D 几何和外观。
- 动画:人体、动物和可动对象还需要关节、形变和时序。
- 与深度学习结合:输入是否规则、是否可微、是否能批量训练、是否有足够数据。
3 显式表示:点云、网格与参数曲面
3.1 点云(Point Clouds)
点云是最简单的 3D 表示:一个对象由 \(N\) 个三维点表示,可以写成一个 \(3\times N\) 的矩阵,每列是一个点的 \((x,y,z)\) 坐标。点云通常没有 connectivity,也就是说它只告诉我们点在哪里,不告诉我们哪些点相邻、哪些点组成面片。
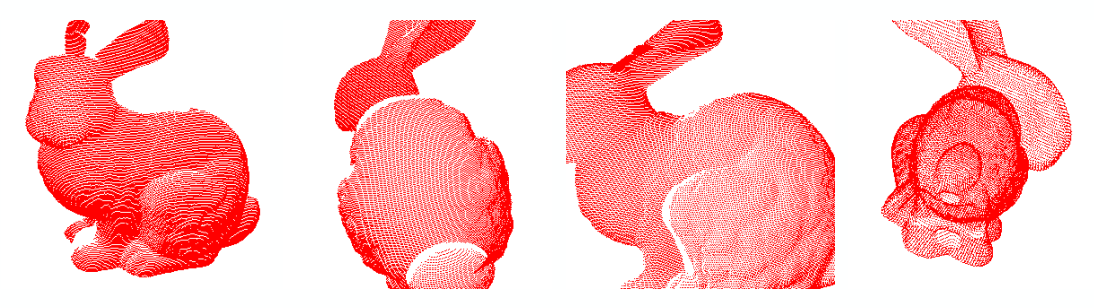
如果 \(N\) 很小,点云就会变成很粗糙的表面采样。例如椅背的细杆、杯子的薄边、兔子耳朵尖端,如果没有点采到,就等于表示里不存在。
在工程上,一个 batch 中每个样本的 \(N\) 通常是固定的,也就是说可以写成 \(B \times N \times 3\) 的张量。但在数学上,点云不要求每个对象点数相同。
点云有时还会附带法向量(surface normal)。因为如果要渲染点云,需要知道光从某个方向照来时如何与局部表面相互作用;只有点的位置不足以决定 shading。带有方向的点也常被称为 surfels。
3.1.1 点云从哪里来
点云常常是 3D 传感器的原始输出,例如:
- 深度相机和 RGB-D 传感器;
- 3D scanner;
- 结构光或激光扫描;
- 多视角重建;
- 手机 ARKit 等移动设备扫描。
这些系统得到的往往不是干净完整的对象,而是多个视角下的 raw scans。之后需要进行 registration(配准)、融合、去噪、补洞和纹理处理,才能得到更完整的形状。
3.1.2 点云的优势
点云的主要优点是自由、简单、接近传感器输出:
- 不受拓扑约束,几乎可以表示任何几何形状。
- 对大规模、多类别数据集友好。
- 可以直接从扫描设备或多视角重建中获得。
- 作为神经网络输入时,比 mesh 少了显式面结构的复杂性。
3.1.3 点云的困难
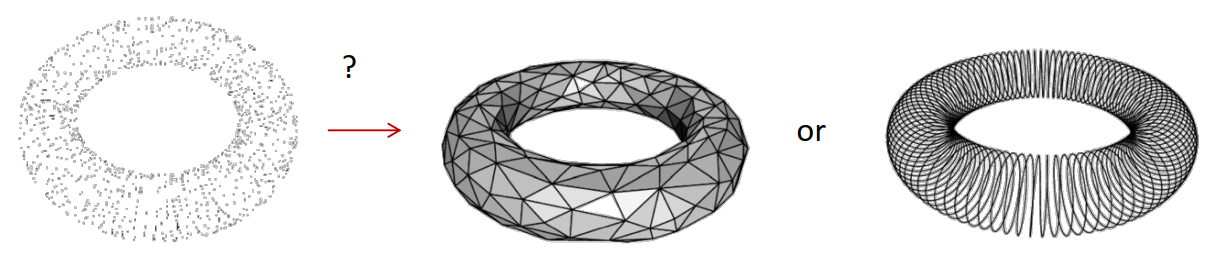
- 无连接关系:点云无法区分某些拓扑不同但采样点相似的形状。例如一圈采样点可能来自一个环面(torus),也可能来自几个断开的环形结构。(如上图)
- 采样不均匀:如果兔子头部点很多、尾部点很少,模型和渲染都会偏向高密度区域。点云算法往往需要考虑如何让采样尽量均匀。
- 不直接支持细分/简化/光滑渲染:这些操作通常依赖表面连接或局部邻域估计。
- 噪声与缺失:真实扫描点云常有噪声、遮挡、局部缺失和配准误差。
因此,点云是信息非常直接但也非常“不完整”的表示:它给出了空间采样,却没有给出表面的组织方式。
3.2 Polygon Meshes:最常用的图形学表示
多边形网格(polygonal meshes)在点的基础上加入连接关系。最常见的是三角网格:顶点构成边,边构成三角面,三角面拼接成表面。
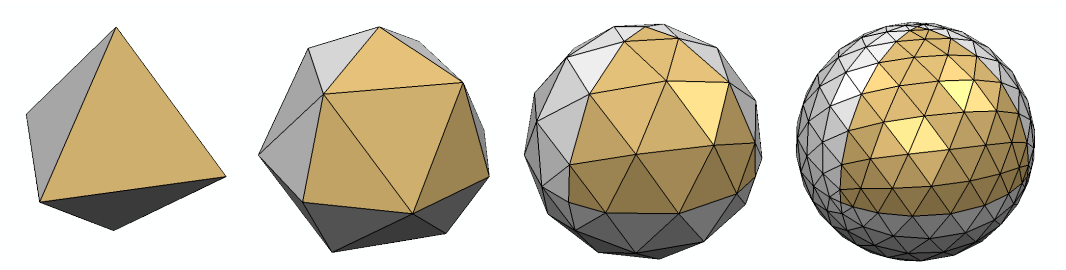
mesh 可以说是传统图形学、游戏、CAD 和很多渲染管线中最广泛使用的 3D 表示。原因是 mesh 不只是点集,它明确给出 surface faces,所以适合:
- 光栅化(rasterization)和 ray tracing;
- 纹理映射;
- 几何编辑;
- 碰撞检测;
- mesh subdivision、simplification、regularization。
课件中的 Digital Michelangelo Project 展示了 David 雕塑的巨大三角网格:约 2818 万 vertices 和 5623 万 triangles。Google Earth 则是更极端的大尺度例子:由卫星和航拍重建出的城市 mesh 可以达到 trillions of triangles。
3.2.1 Mesh 操作
| 操作 | 含义 | 图中直观效果 |
|---|---|---|
| Subdivision / Upsampling | 增加面片数量,通过插值获得更高分辨率 | 牛头从粗糙网格变得更细腻 |
| Simplification / Downsampling | 减少三角形数量,同时尽量保持外观 | 复杂模型变成更稀疏但仍可辨认的形状 |
| Regularization | 调整三角形大小和分布,使 mesh 更均匀 | 三角形更规则,便于后续处理 |
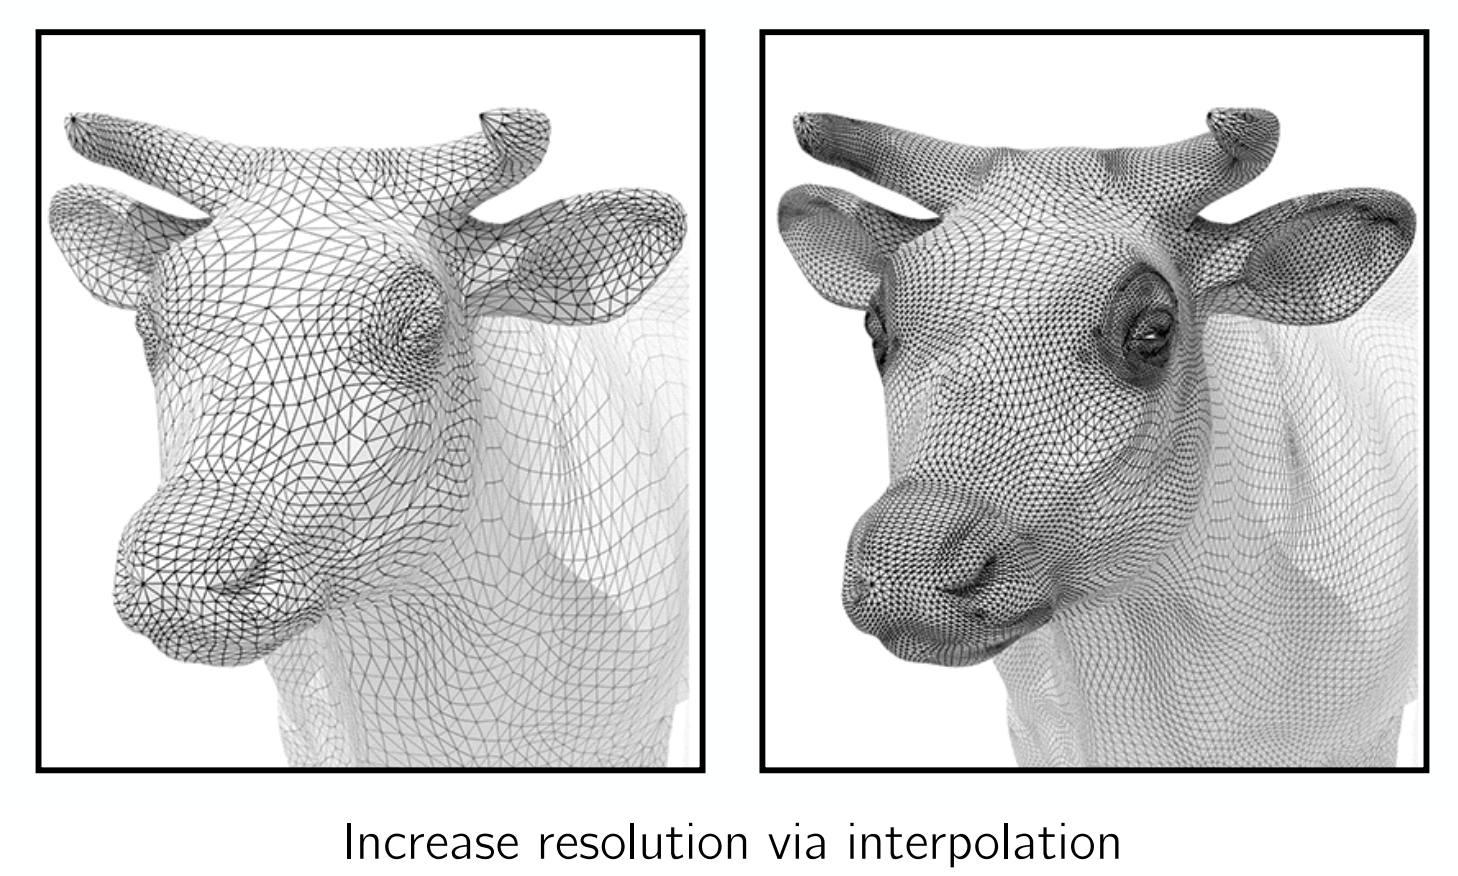
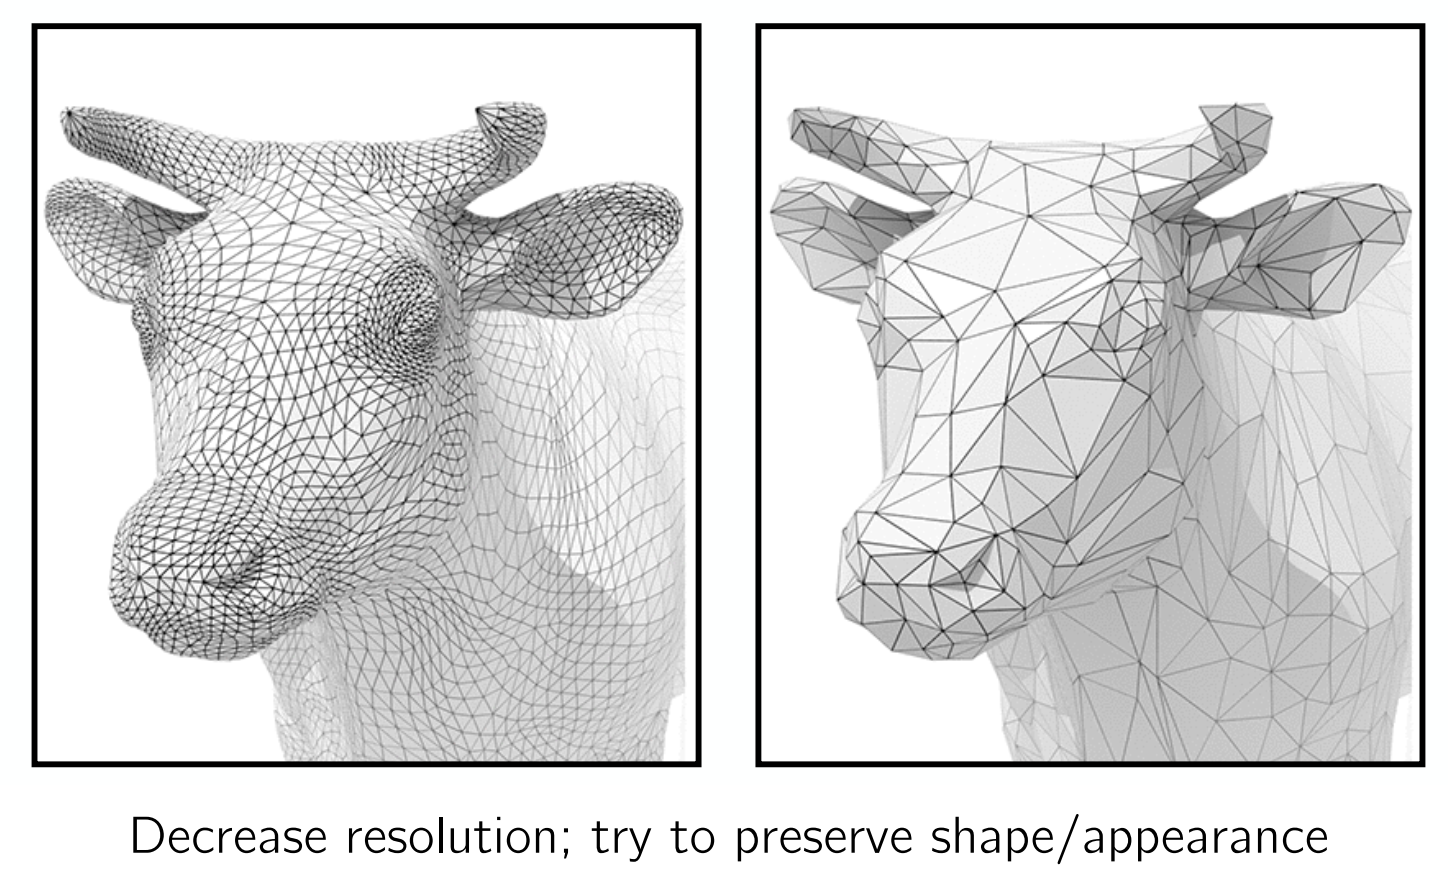
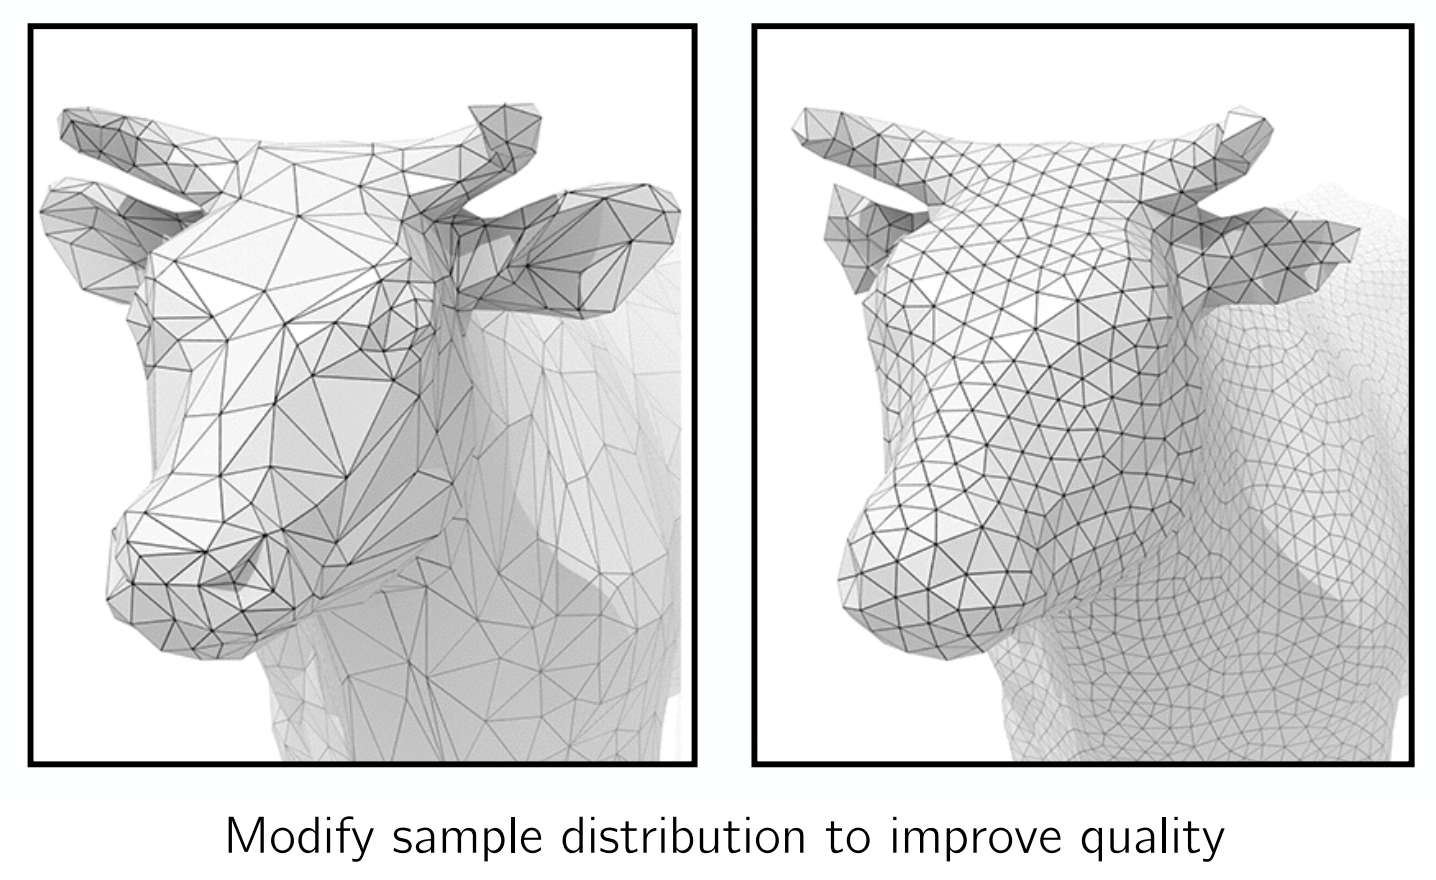
Upsampling, Downsampling and Regularization
3.2.2 Mesh 和深度学习为什么不好直接结合
视频中老师补充了一个很重要的历史原因:早期深度学习喜欢固定分辨率输入,例如图像矩阵;但 mesh 是高度不规则的:
- 每个对象顶点数不同;
- 每个面可能有 3、4、5 个顶点;
- 邻接关系不是规则网格;
- batch 处理和卷积定义都不直接。
这也是 3D deep learning 相比 2D vision 起步较慢的原因之一:3D 的主流表示不像像素矩阵那样天然适合 CNN。
3.3 参数表示(Parametric Representation)
参数表示把曲线或曲面看成一个低维参数空间到 3D 空间的映射:
\[ f:X\rightarrow Y,\quad X\subseteq\mathbb{R}^m,\ Y\subseteq\mathbb{R}^n. \]
对于 3D 曲面,通常是:
\[ s(u,v)=(x(u,v),y(u,v),z(u,v)). \]
并且 \(m=2\),\(n=3\)。
老师在视频中强调:很多曲线和曲面的 内在自由度(intrinsic dimensionality) 比它们嵌入的 3D 空间低。自由度可以理解为:描述或控制一个几何对象上的点,需要独立改变几个参数。例如曲线只有一个自由度,曲面通常只有两个自由度。参数表示正是利用低维参数来生成高维空间中的曲线或曲面。
3.3.1 圆与球面的例子
二维圆可以写成:
\[ p(t)=r(\cos t,\sin t),\quad t\in[0,2\pi). \]
三维球面可以写成:
\[ s(u,v)=r(\cos u\cos v,\sin u\cos v,\sin v), \]
其中 \(u\) 和 \(v\) 是两个自由度。
如果要采样参数曲面,只需要在参数域中采样 \((u,v)\),再代入函数,就能得到曲面上的点。这是显式参数表示最重要的优点。
3.3.2 Bézier 曲线、Bézier 曲面与 Subdivision
课件展示了 Bézier curves、piecewise Bézier、Bézier surfaces 和 subdivision curves/surfaces。它们的共同点是 用少量控制点或局部规则描述光滑曲线/曲面。
Bézier curve:用控制点拉出一条光滑曲线。
可以把它想象成绘图软件里的钢笔工具:起点和终点决定曲线从哪里开始、到哪里结束,中间控制点决定曲线怎样弯。曲线不一定穿过所有控制点,但会被控制点“吸引”。这种表示适合字体轮廓、图标边缘、动画路径、汽车或产品外形线等需要平滑轮廓的对象。
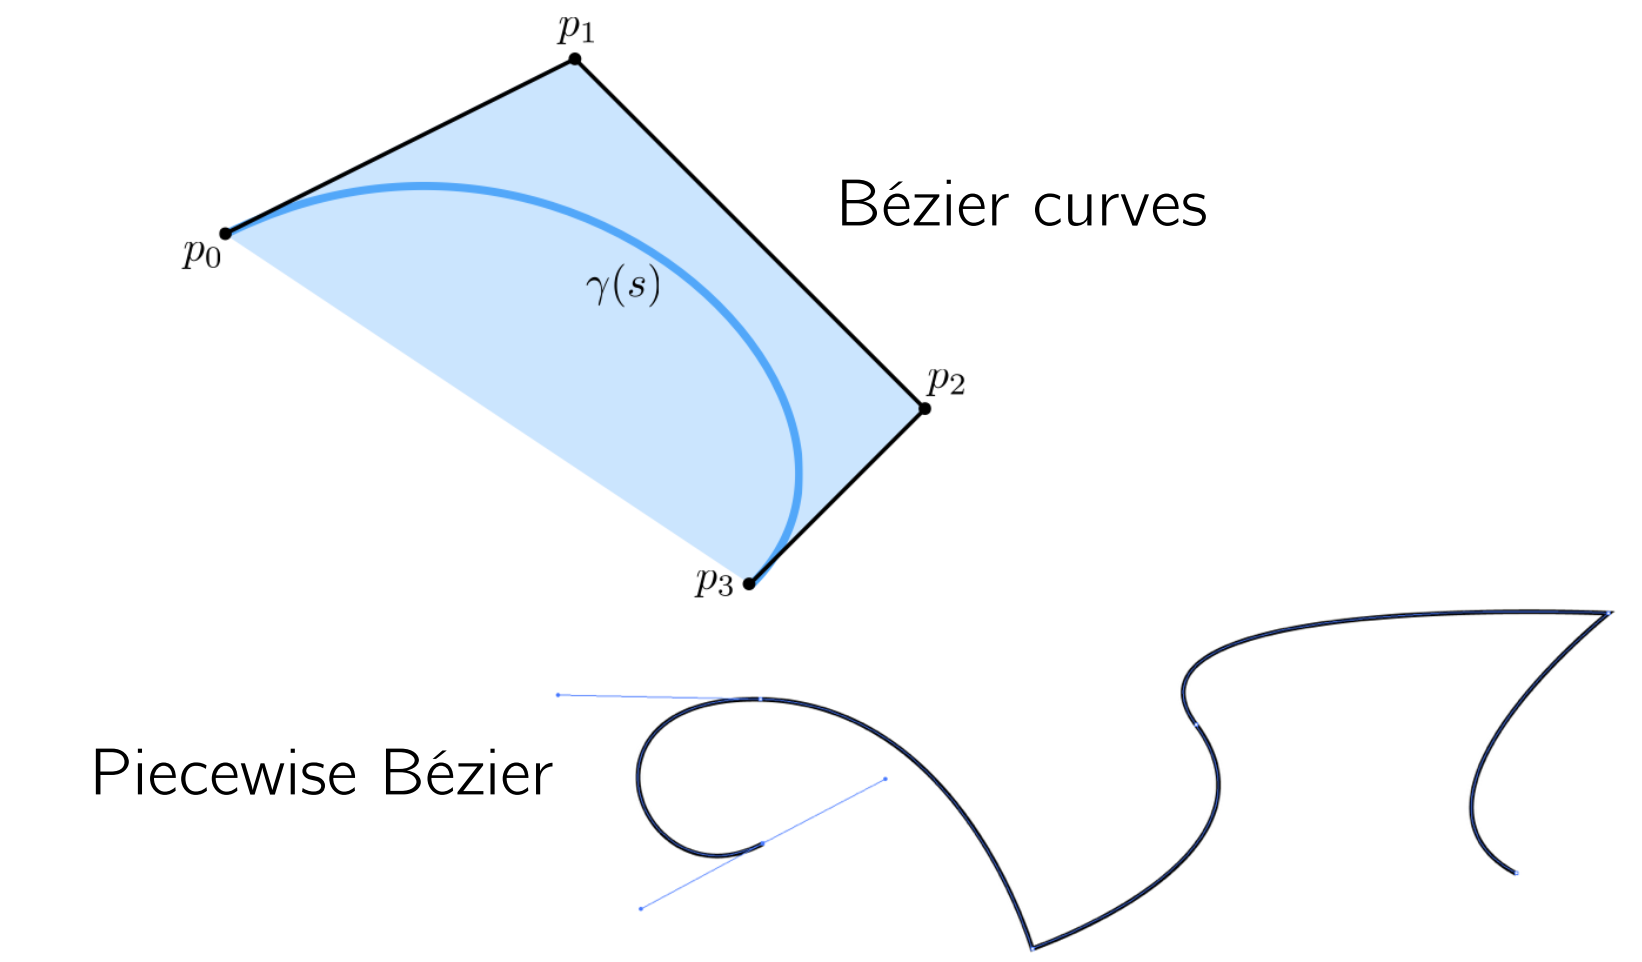
Piecewise Bézier:把多段 Bézier 曲线拼成复杂轮廓。
单独一段 Bézier 通常只能表达一段较简单的弯曲;如果要表示字母、花瓶外轮廓、车身侧面线条等复杂形状,就把很多段 Bézier 接起来。关键要求是拼接处尽量平滑,否则会出现明显折角。
Bézier surface:把 Bézier 曲线扩展成一张光滑曲面。
如果 Bézier curve 像一根被控制点拉动的弹性线,那么 Bézier surface 就像一张被控制点拉扯的橡胶布。移动控制点时,整张曲面会随之鼓起、凹下或弯曲。它可以看成从二维参数 \((u,v)\) 生成三维点 \((x,y,z)\) 的映射,因此属于参数曲面。
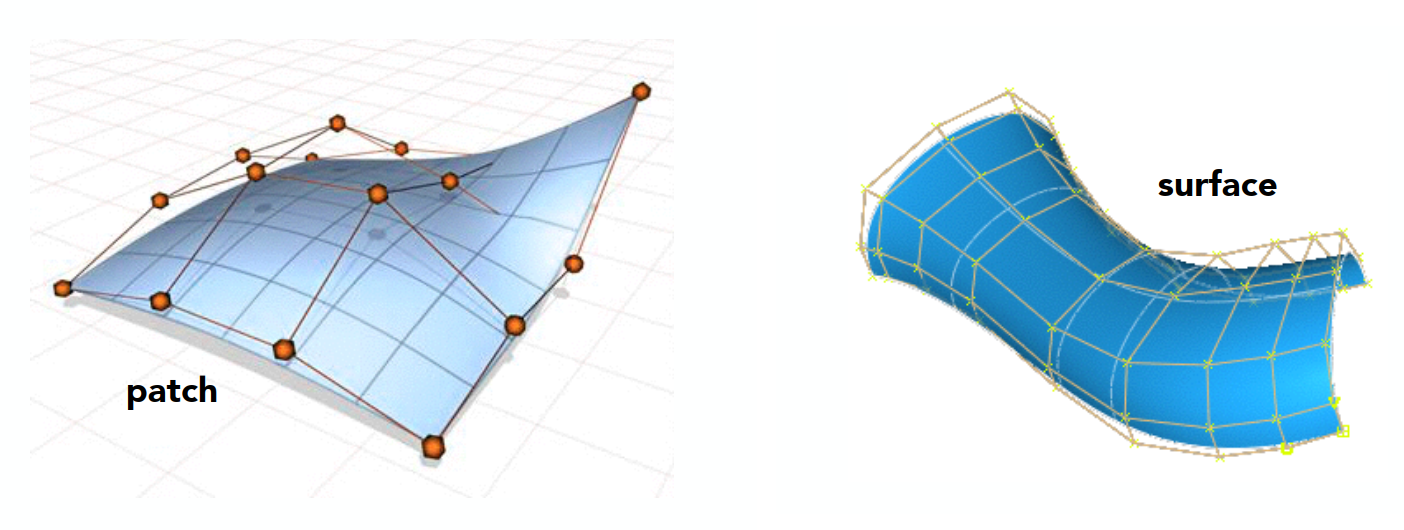
Subdivision curve/surface:从粗糙形状反复细分,逐渐变光滑。
它的思路不是直接写一条曲线公式,而是先给一个粗控制多边形或粗 mesh,然后不断插入新点、调整位置。重复多次后,原本粗糙的折线或多面体会变成光滑曲线/曲面。直觉上,它像把低分辨率模型不断“打磨”成更圆滑的模型。
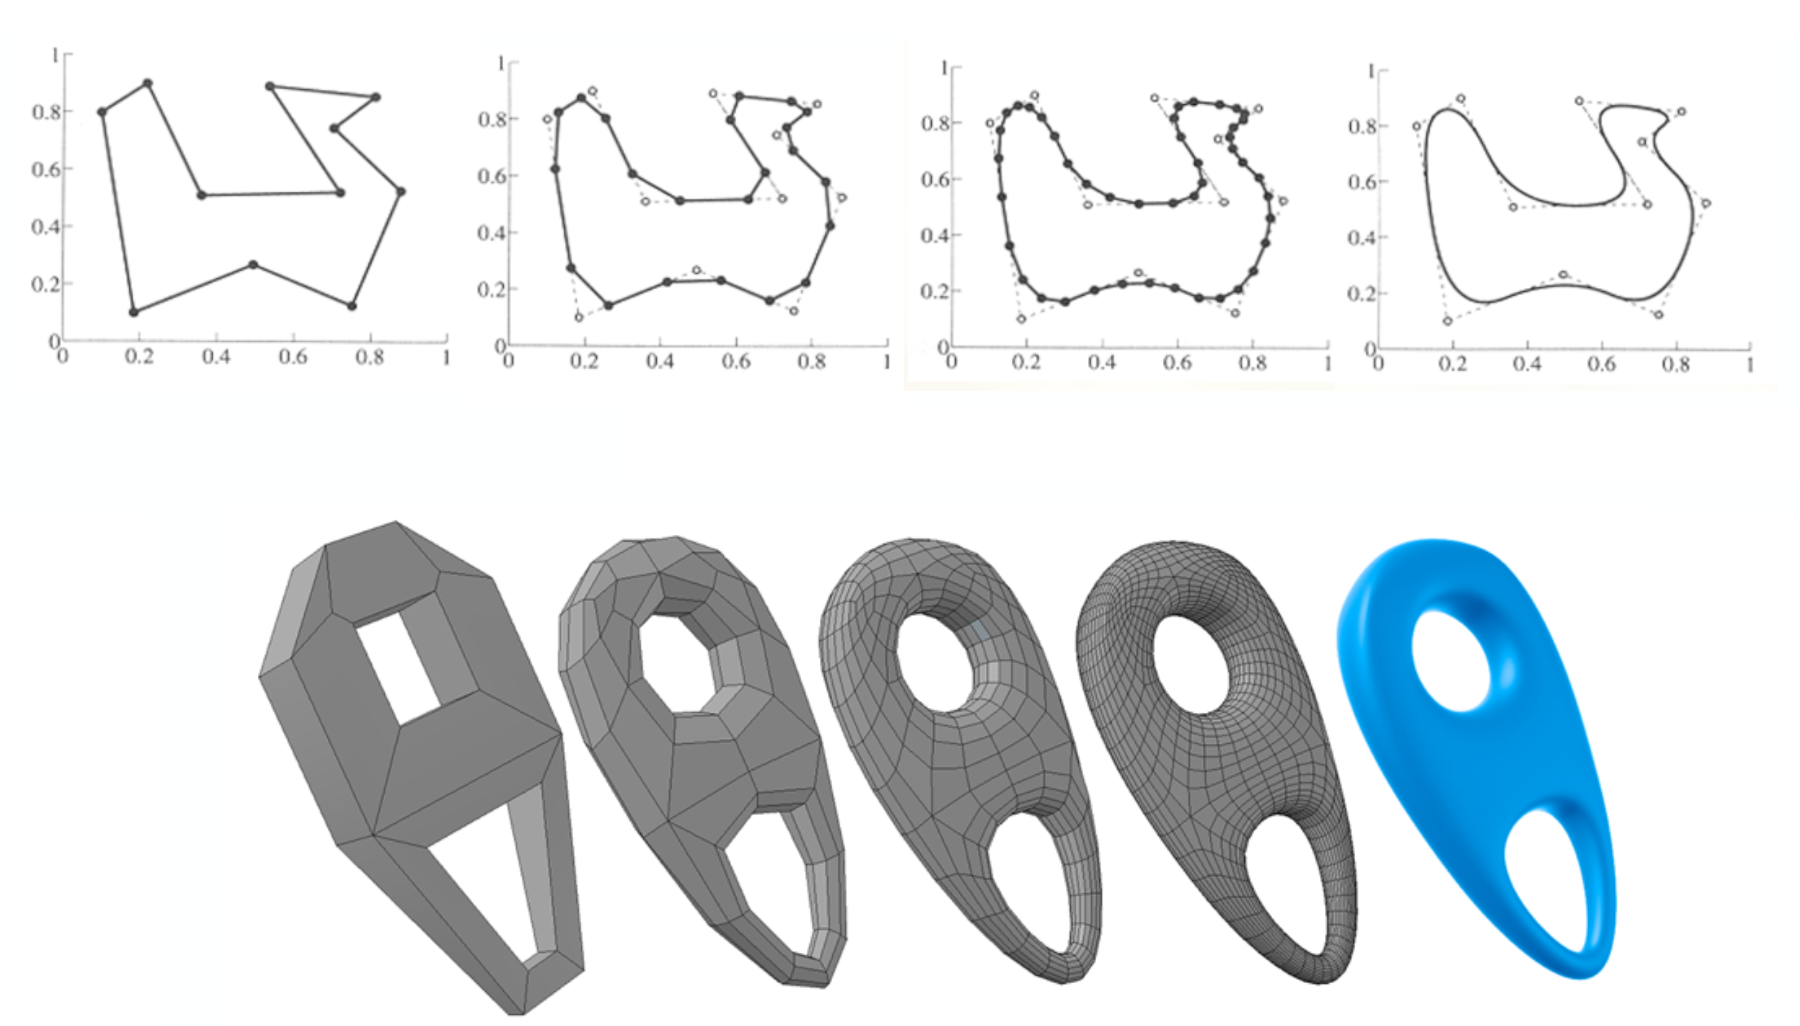
老师在视频里把这类表示和设计联系起来:桌子、椅子、工业零件等对象中有很多直线、曲面、对称结构和低维规则,仅用点或 mesh 可能丢失这种“设计意图”;参数表示可以更紧凑地表达这些规则。
4 隐式表示:函数、距离场、Level Set 与体素
4.1 显式表示的核心权衡
显式表示的最大优点是 采样容易。例如环面可以写作:
\[ f(u,v)=((2+\cos u)\cos v,\ (2+\cos u)\sin v,\ \sin u). \]
只要随机采样 \(u,v\),就能得到表面上的点。
但显式表示的一个典型困难是:判断任意空间点在物体内部还是外部很难。如果给定点 \((3/4,1/2,1/4)\),显式曲面本身不一定直接告诉我们这个点是否在闭合物体内部。老师将这个问题和神经渲染联系起来:很多 neural rendering 方法需要频繁查询某个 3D 位置的密度、颜色、材质或是否在物体内部;显式表示不一定天然支持这种查询。
4.2 隐式表示的定义
隐式表示用函数关系定义表面。最经典形式是:
\[ f(x,y,z)=0. \]
例如单位球面:
\[ x^2+y^2+z^2=1. \]
更一般地,函数值的符号可以表示内外:
- \(f(x,y,z)=0\):点在表面上;
- \(f(x,y,z)<0\):点在内部;
- \(f(x,y,z)>0\):点在外部。
隐式表示的优势正好和显式表示互补:给定一个查询点,直接代入函数,就能得到它与对象的关系。但如果要采样整个表面,即找到所有满足 \(f(x,y,z)=0\) 的点,就比较困难,需要数值方法。
这里容易产生一个误解:隐式表示好像只是把显式公式“移项”成 \(f(x,y,z)=0\)。对于球面、圆环面这类简单形状,确实常常可以在参数式和隐式方程之间互相转换。但两者的核心差别不是能不能描述同一个几何对象,而是 查询方向不同:
- 显式/参数表示更像“造点机器”:输入参数 \((u,v)\),直接输出表面点 \((x,y,z)\),所以采样表面很方便。
- 隐式表示更像“检测器”:输入任意空间点 \((x,y,z)\),输出 \(f(x,y,z)\),根据它是等于 0,小于 0 还是大于 0,告诉我们这个点在表面上、内部还是外部,所以空间查询很方便。
因此,同一个球面可以既有参数表示,也有隐式表示;但它们天然擅长的操作不同。显式表示适合生成表面点,隐式表示适合内外判断、距离查询、布尔组合、神经渲染中的密度或 occupancy 查询。
4.3 代数曲面与 CSG
代数曲面(Algebraic Surfaces)是多项式的零集合。球、环面、心形等规则形状都可以由多项式方程定义。它们适合规则几何,但很难单独表达真实世界中的复杂对象,比如一头牛、一把椅子或一个完整室内场景。
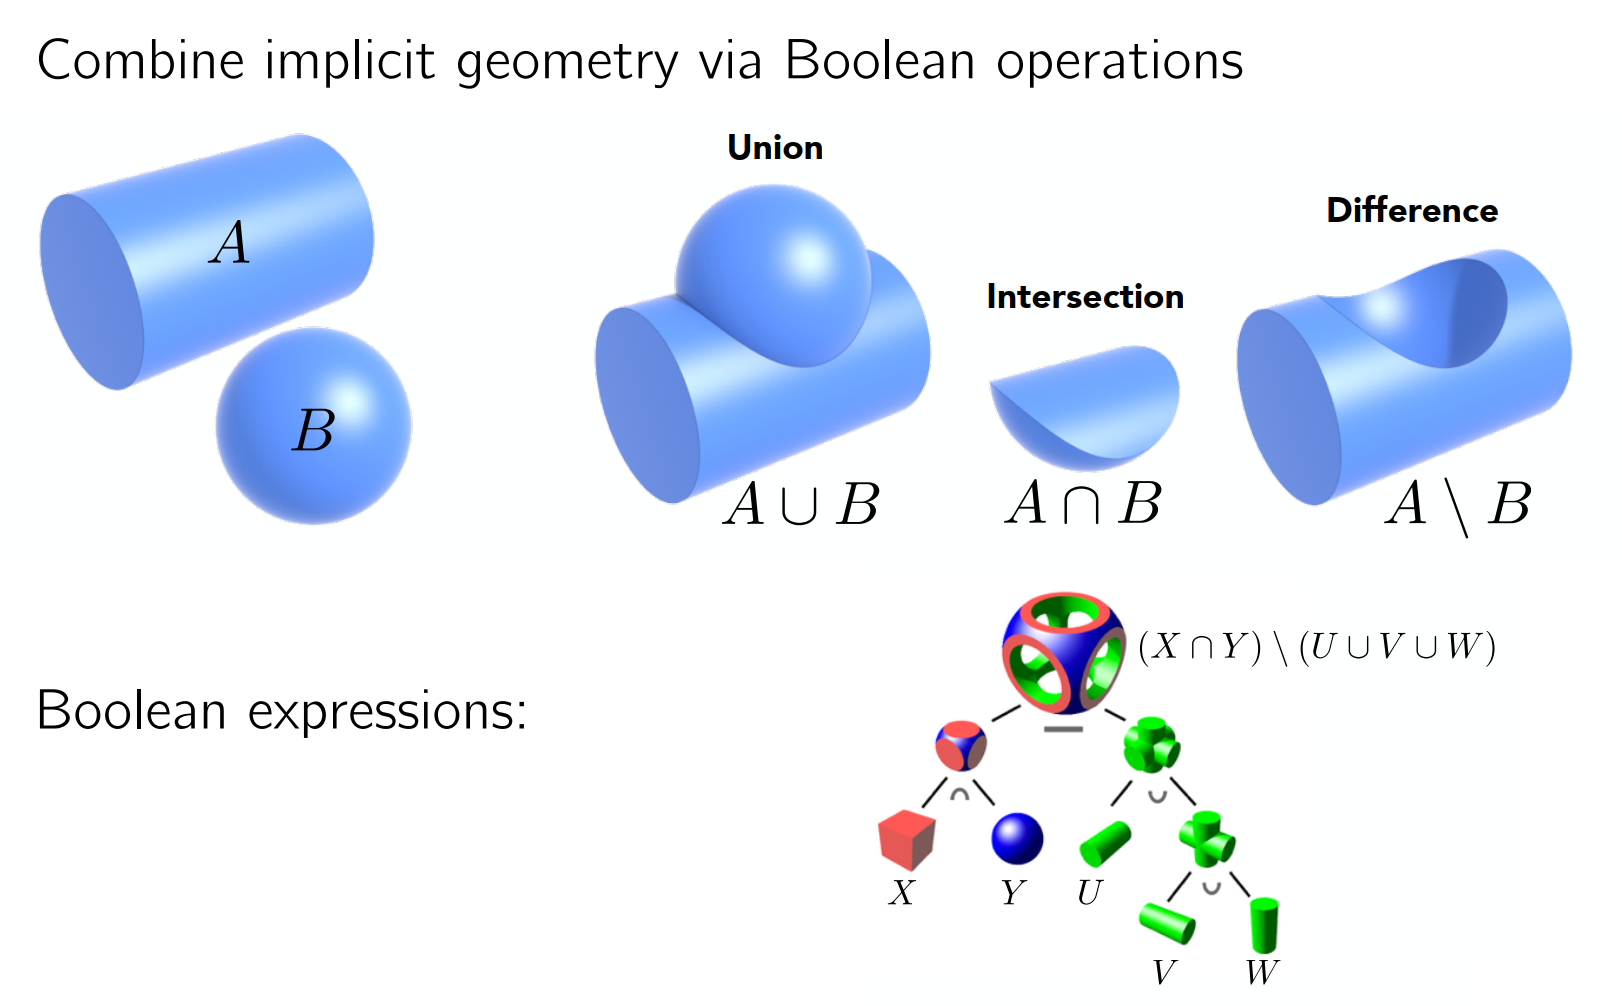
Constructive Solid Geometry(CSG) 用布尔运算组合简单隐式几何:
| 操作 | 表达 | 含义 |
|---|---|---|
| Union | \(A\cup B\) | 合并两个物体 |
| Difference | \(A\setminus B\) | 从 A 中挖掉 B |
| Intersection | \(A\cap B\) | 只保留重叠部分 |
视频中老师补充:CSG 和隐式函数组合在工业设计、制造和 CAD 中非常重要。因为函数值可以做加减、min/max、逻辑组合,所以复杂零件可以由简单体逐步组合出来。
4.4 距离函数与 SDF
4.4.1 SDF 的定义:带符号的表面距离
距离函数(Distance Function) 给出空间中任意点到物体表面的距离。若距离带正负号,就得到 符号距离函数(Signed Distance Function, SDF)。SDF 的值不仅告诉我们内外,还告诉我们离表面多远。
SDF 的直观理解:
\[ \mathrm{SDF}(x)= \begin{cases} -d(x,\partial\Omega), & x\text{ inside},\\ 0, & x\text{ on surface},\\ d(x,\partial\Omega), & x\text{ outside}. \end{cases} \]
其中 \(\partial\Omega\) 是物体表面。
例如半径为 \(1\)、中心在原点的球可以写成:
\[ \mathrm{SDF}(\mathbf{x})=\|\mathbf{x}\|_2-1. \]
如果 \(\mathbf{x}=(0,0,0)\),则 \(\mathrm{SDF}(\mathbf{x})=-1\),说明它在球内部,离表面距离为 \(1\);如果 \(\mathbf{x}=(1,0,0)\),则 \(\mathrm{SDF}(\mathbf{x})=0\),说明它在球面上;如果 \(\mathbf{x}=(2,0,0)\),则 \(\mathrm{SDF}(\mathbf{x})=1\),说明它在球外部,离表面距离为 \(1\)。
如果一个点看起来可以连到表面的多个位置,SDF 取的是其中的 最短距离。更准确地说:
\[ d(\mathbf{x},\partial\Omega)=\min_{\mathbf{y}\in\partial\Omega}\|\mathbf{x}-\mathbf{y}\|_2. \]
直觉上,可以想象以 \(\mathbf{x}\) 为圆心不断扩大圆,第一次碰到物体表面时的半径,就是 \(|\mathrm{SDF}(\mathbf{x})|\)。如果 \(\mathbf{x}\) 在物体内部,这个距离加负号;如果在物体外部,这个距离加正号。
4.4.2 例子:用 SDF 插值移动边界
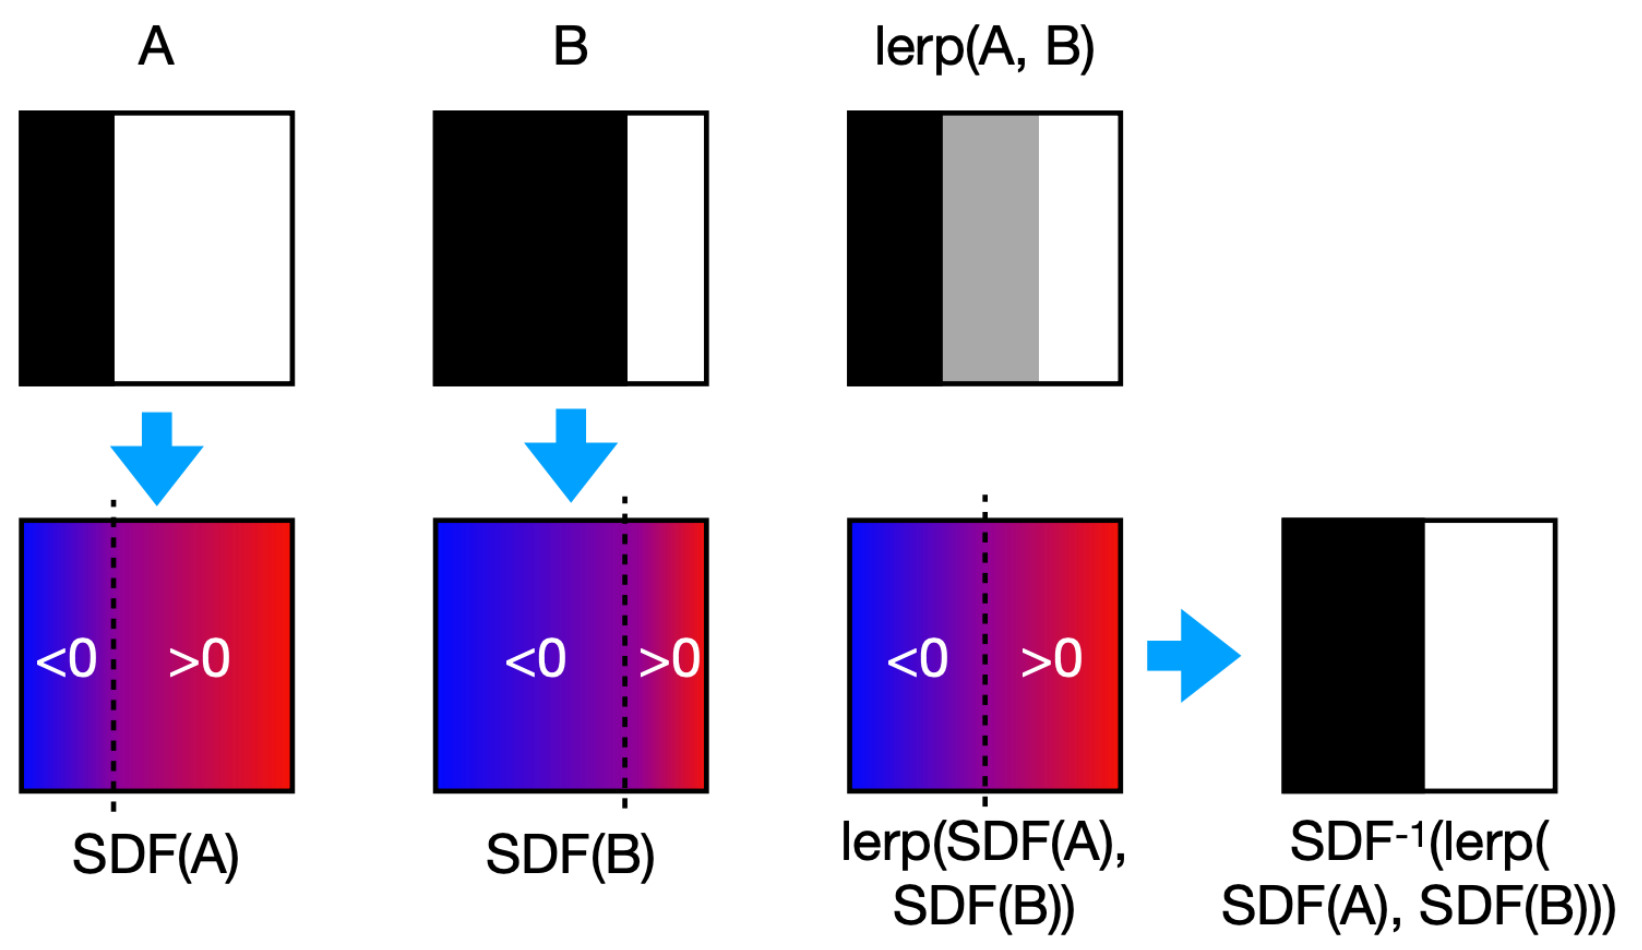
SDF 的一个重要优点是可以平滑组合或插值形状。下面是一个一维边界移动的例子:上方的 A 和 B 可以看成两个黑白形状,黑色表示物体内部,白色表示物体外部,黑白交界处就是边界。A 的边界偏左,B 的边界偏右。
如果把 A 和 B 转成 SDF,那么每个位置不再只是黑或白,而是有一个带符号距离值:
- \(SDF<0\):在物体内部;
- \(SDF=0\):在边界上;
- \(SDF>0\):在物体外部。
关键操作是对两个 SDF 做线性插值:
\[ \mathrm{lerp}(\mathrm{SDF}(A),\mathrm{SDF}(B)) =(1-t)\mathrm{SDF}(A)+t\mathrm{SDF}(B). \]
当 \(t=0\) 时得到 A;当 \(t=1\) 时得到 B;当 \(t=0.5\) 时得到介于 A 和 B 之间的中间 SDF。再从这个中间 SDF 中取 \(SDF=0\) 的位置,就得到一个边界位于 A 和 B 中间的新形状。
这页的核心直觉是:不要直接混合黑白占据结果,而是混合每个点到边界的带符号距离。 因为 SDF 包含“离边界多远”的信息,所以插值后边界会连续移动,而不是突然跳变。推广到 3D 后,同样可以对物体表面进行平滑变形、融合或生成中间形状。
4.5 Level Set:把隐式函数预采样到网格上
隐式函数很灵活,但复杂形状很难写成简单闭式公式。老师在视频中给出动机:如果每次查询“一点是否在牛的内部”都要组合成百上千个函数,那会非常慢。一个折中办法是 预查询(pre-query)大量空间点,并把结果存起来。
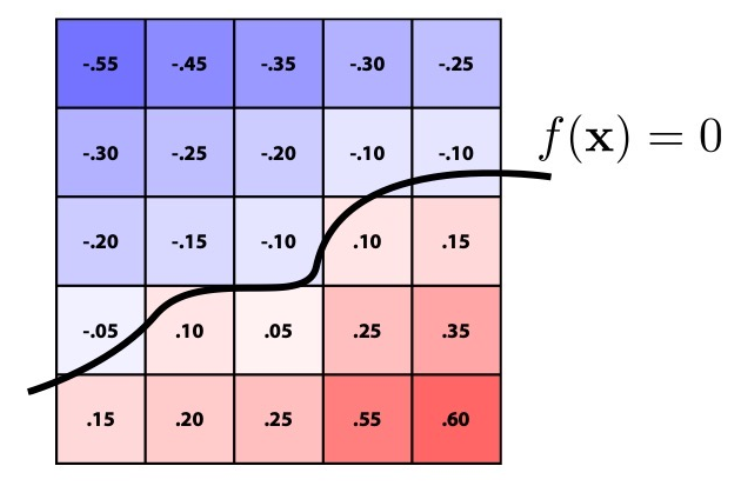
这就是 Level Set 的思想:在 3D 空间中采样一个规则网格,例如 \(100\times100\times100\),对每个格点预先计算函数值或距离值,然后把这些值存成三维矩阵。表面位于函数值从正到负变化的位置,也就是插值后 \(f=0\) 的地方。
预查询结束后,如果要判断一个点 \(\mathbf{x}\) 位于形状的内部、表面还是外部,通常采用 三线性插值 的方法。用周围 \(2\times2\times2=8\) 个格点的 \(\text{SDF}\) 做插值,得到 \(\hat{\mathrm{SDF}}(\mathbf{x})\),即 \(\mathbf{x}\) 的 \(\mathbf{SDF}\) 的估计值。然后判断:若\(\mathrm{SDF}(\mathbf{x})<0\),则在形状内部;若 \(\mathrm{SDF}(\mathbf{x})=0\),则在表面上;若 \(\mathrm{SDF}(\mathbf{x})>0\),则在形状外部。
Level Set 的特点:
- 本质上仍然是隐式表示,因为表面由 \(f=0\) 定义;
- 但它又是非参数的,因为函数值被离散存储在网格中;
- 可以更直观地控制复杂形状;
- 适合 CT/MRI 等体数据,因为医学图像天然就是体素网格。
4.6 体素(Voxels)
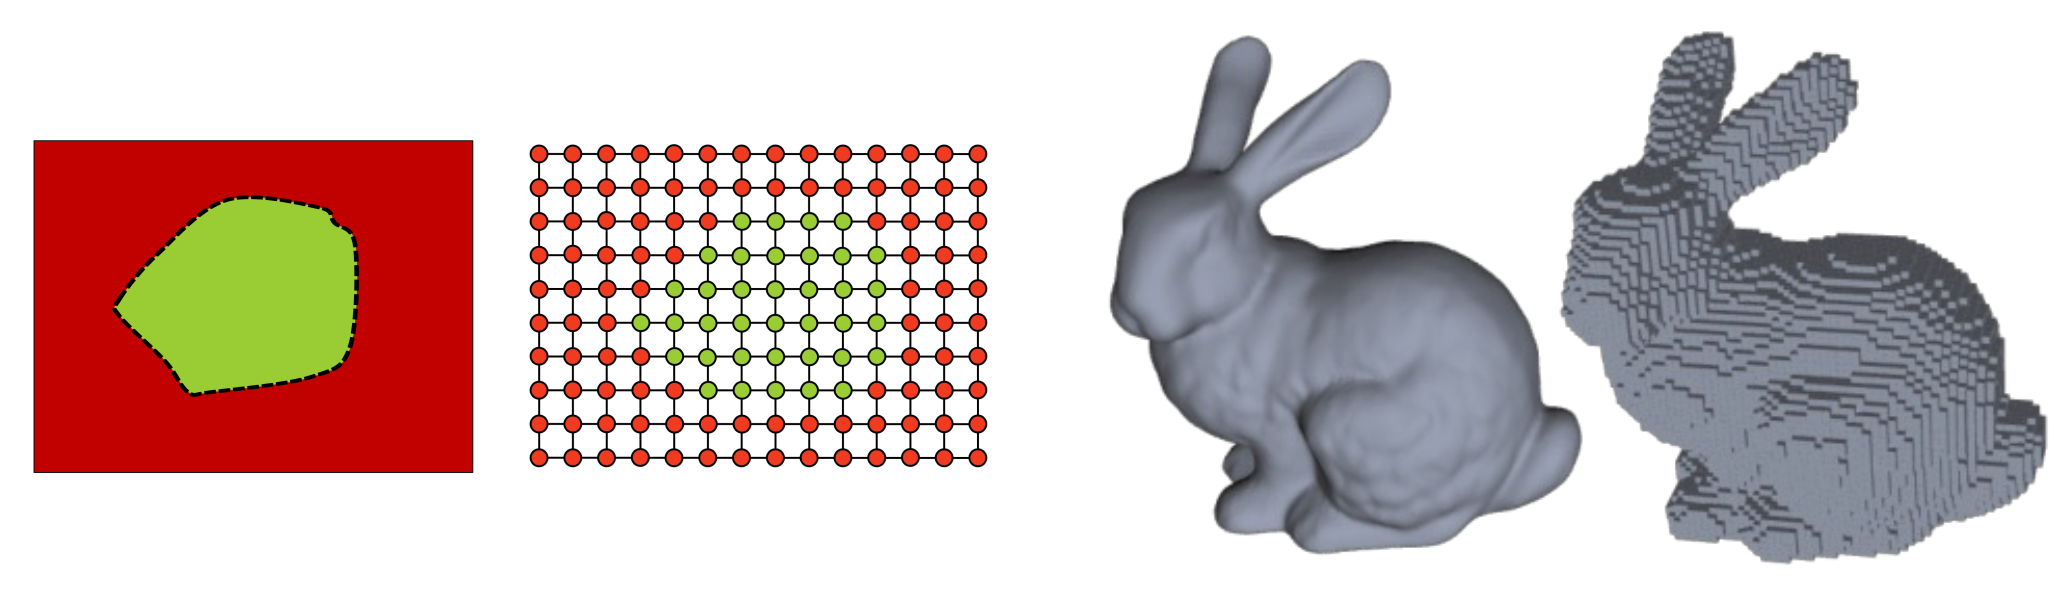
体素可以看成 3D 版像素。每个格子存储 occupancy、density、SDF、语义标签或颜色等值。体素非常适合 3D CNN,因为它把 3D 数据变成规则张量。
Occupancy(占据状态):表示这个 voxel 是否被物体占据。最简单是二值标签,\(1\) 表示在物体内部,\(0\) 表示在物体外部;也可以是 \([0,1]\) 之间的概率,表示模型认为这里有物体的置信度。
Density(密度/不透明度):表示这个位置对光线的阻挡、吸收或散射有多强。它不是简单回答“有没有物体”,而是回答“这里有多实、有多挡光”。在 NeRF 等体渲染方法中,density 会影响光线经过该位置时对最终像素颜色的贡献。
SDF(符号距离):表示 voxel 中心或格点到物体表面的带符号距离。负数表示在物体内部,零表示在表面上,正数表示在物体外部。
语义标签(semantic label):表示该 voxel 属于什么类别或部件,例如墙、地板、桌子、椅子腿、椅子背等。它常用于 3D scene parsing 或 part segmentation。
颜色(color):通常存储 RGB 三个通道,即 \((R,G,B)\)。如果需要透明度,也可以存 RGBA;在更复杂的神经渲染中,颜色还可能和观察方向有关。
但体素的核心问题是内存和计算量:三维分辨率增长很快。如果每个维度分辨率翻倍,总格子数变成原来的 8 倍。很多对象只在表面附近有信息,空空间占了大量格子,这会造成严重浪费。
4.7 3D 形状表示总结
3D shape representation 可以用两个维度来理解:
- 显式(Explicit) vs 隐式(Implicit):显式表示直接给出表面上的点、面片或参数曲面;隐式表示用函数、体素值或规则判断空间点和物体的关系。
- 非参数(Non-parametric) vs 参数(Parametric):非参数表示通常直接存储离散数据,例如点、网格、体素格点;参数表示用公式、控制点、规则或构造过程来生成形状。
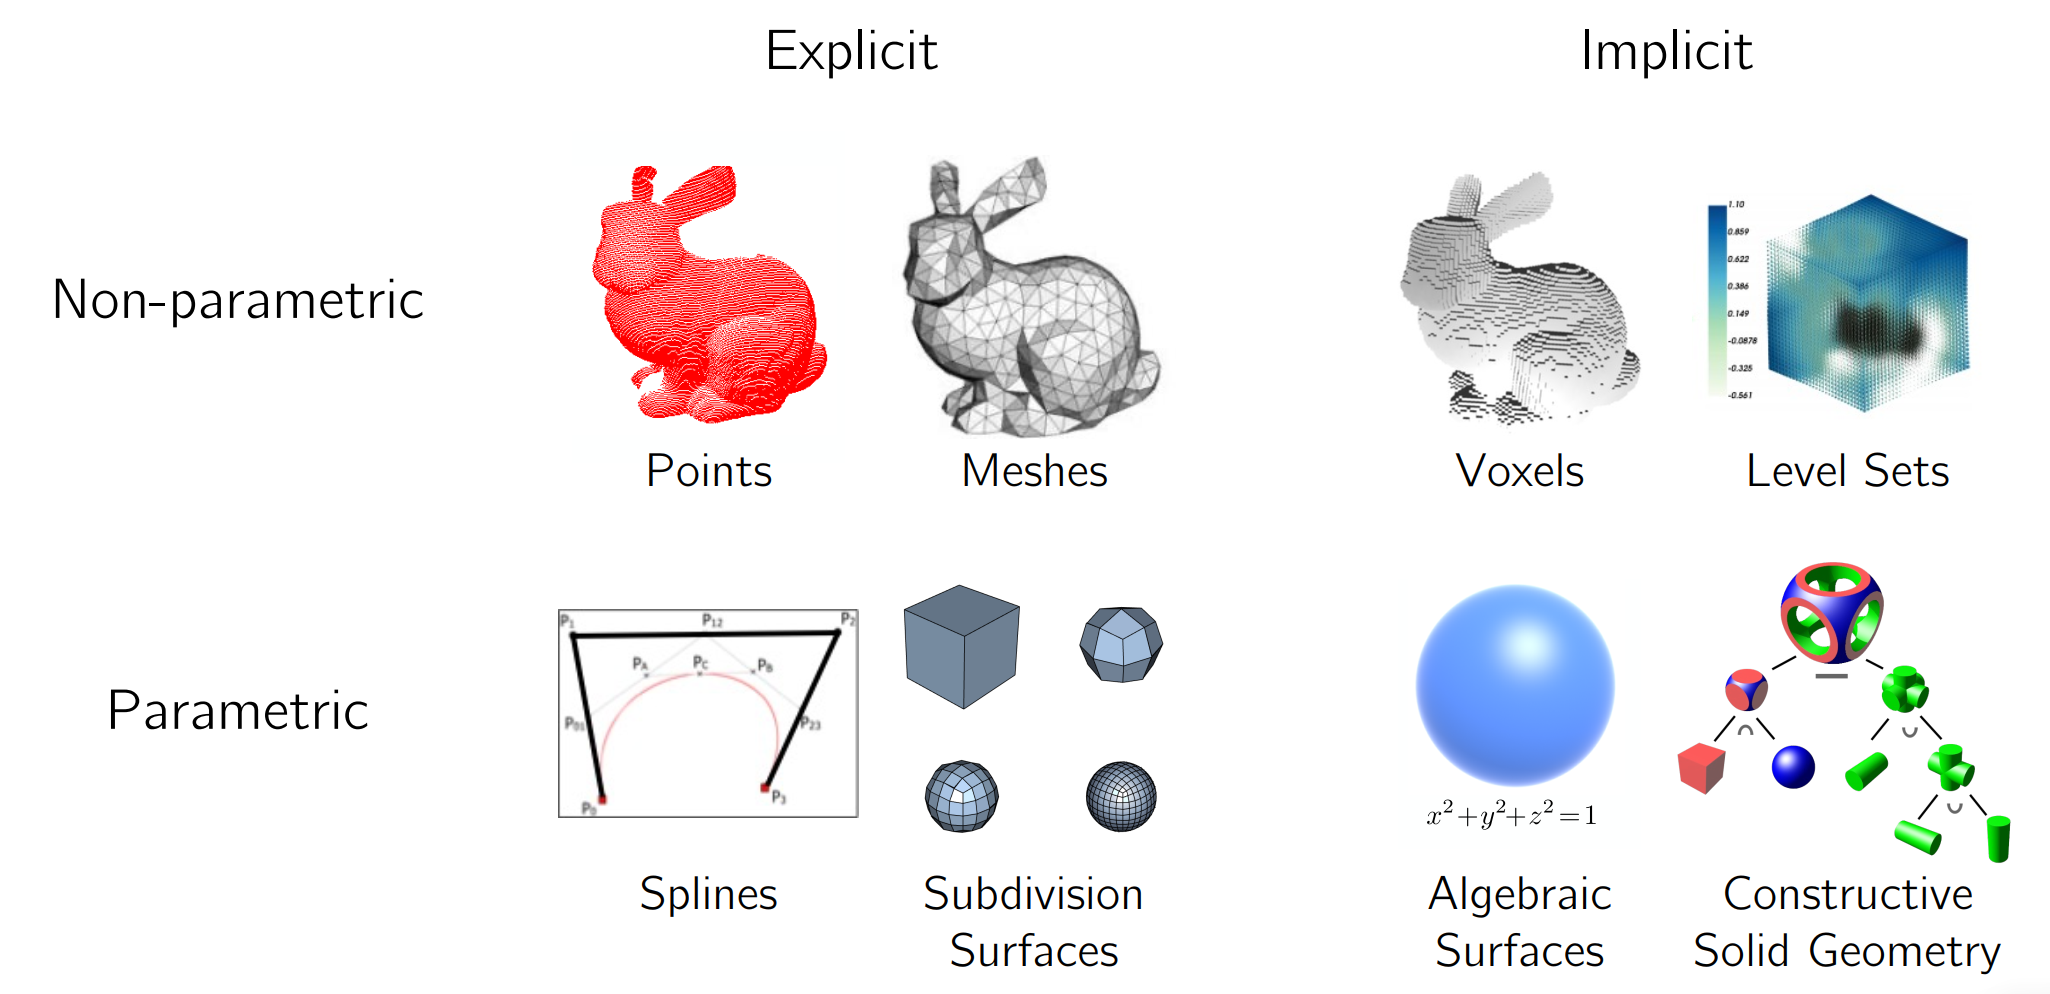
这张图提醒我们:3D 没有像 2D 像素那样统一的默认表示。选择表示时,要看任务更需要什么:
- 如果要直接处理扫描数据,点云很自然;
- 如果要高质量传统渲染,mesh 很自然;
- 如果要规则张量和卷积,voxel 很自然;
- 如果要查询任意空间点的内外、距离或密度,SDF/occupancy/radiance field 这类隐式表示更自然;
- 如果要表达工业零件、曲线曲面和设计意图,splines、subdivision、CSG 等参数化表示更自然。
因此,3D Vision 的很多方法差异,本质上不是网络结构不同,而是底层形状表示不同。表示一变,存储方式、采样方式、损失函数、渲染方式和神经网络结构都会随之改变。
5 3D 数据集:从小规模 CAD 到大规模真实扫描与视频
老师在视频中把数据集发展讲得很清楚:3D vision 很长时间里受限于数据规模。2D 图像有 ImageNet、互联网图像和海量视频;而 3D 数据的获取、清洗、标注和重建都困难得多。
5.1 早期数据集
Princeton Shape Benchmark 包含 1814 个样本和 182 个类别。这意味着平均每个类别大约只有 10 个样本左右。放到今天看很小,但在当时已经是重要基准。
2014 年以前,很多 3D 数据集规模都不大,即使有上万模型,类别一多,每类样本数仍然有限。这也是早期 3D 机器学习难以训练大模型的重要原因。
5.2 ShapeNet 与 ModelNet
ShapeNet 的出现类似 3D 领域的 ImageNet 时刻。
- ShapeNet:约 3M synthetic objects;
- ShapeNetCore:约 51.3K models,55 categories;
- ModelNet 后来被 ShapeNet 吸收。
ShapeNetCore 平均每类约 1000 个样本,虽然类别分布不均,但 chairs 和 cars 等大类终于有了足够样本。因此许多早期 3D deep learning 论文都集中在椅子和车上展示结果。
5.3 Objverse 与 Objverse-XL
Objverse 和 Objverse-XL 把规模进一步提高到约 800K 和 10M 级别的 3D assets。相比 ShapeNet,它们类别更多、模型更多,很多对象还带纹理。它们代表了大规模 synthetic 3D 数据的新阶段。
5.4 真实扫描与多视角视频
真实 3D 数据比合成 CAD 模型更难获取。
| 数据集 | 特点 | 重要性 |
|---|---|---|
| Object Scan | 10,933 RGB-D scans,441 models | 真实物体扫描数据 |
| CO3D | 约 19,000 videos,50 categories | 用手机/相机绕物体拍摄视频,支持真实物体重建 |
| ScanNet | 2.5M views,1500 RGB-D scans,camera poses,surface reconstructions,instance-level semantic segmentations | 室内场景理解的重要数据集 |
| ARKitScenes / ScanNet++ | 更近期的真实场景数据 | 更高质量图像和扫描 |
| PartNet | 细粒度、实例级、层次化部件标注 | 支持部件分割和结构理解 |
即使 CO3D 这类真实物体视频数据已经很有价值,和 2D 图像/视频数据规模相比仍有巨大差距。2D 数据可以达到十亿、百亿级,而真实 3D 数据往往还在十万量级附近。这也是现代 3D 研究重新重视 2D/视频 foundation models 的原因之一。
6 AI + Geometry 的任务与表示选择
AI + Geometry 的任务可分成三类。
6.1 生成式模型
生成式模型学习形状先验,用于:
- 3D shape generation;
- shape completion;
- geometry data processing;
- 从图像、文本或 latent code 生成 3D 对象;
- 同时生成几何与外观。
3D 生成不只是输出形状,还可能需要控制 viewpoint、texture、identity,以及最终渲染出的 2D 图像是否真实。
6.2 判别式模型
判别式模型学习 shape descriptors,用于:
- shape classification;
- retrieval;
- segmentation;
- view estimation;
- scene parsing。
6.3 2D-3D 联合建模
因为 2D 数据和 2D 模型更丰富,3D 研究一直在尝试利用 2D 监督:
- 多视角投影;
- differentiable projection/back-projection;
- differentiable rendering;
- neural rendering;
- 从 2D images/videos 学习 3D geometry 和 appearance;
- 融合文本等多模态输入。
早期 3D deep learning 先尝试把 3D 转成 2D 或 3D voxel 来套用已有网络;后来大家希望发展 3D-native 方法;而近年由于图像/视频 foundation models 太强,研究趋势又重新回到“如何利用 2D/视频大模型帮助 3D”。
7 多视角、体素、Octree:早期深度学习如何进入 3D
7.1 Multi-View CNN
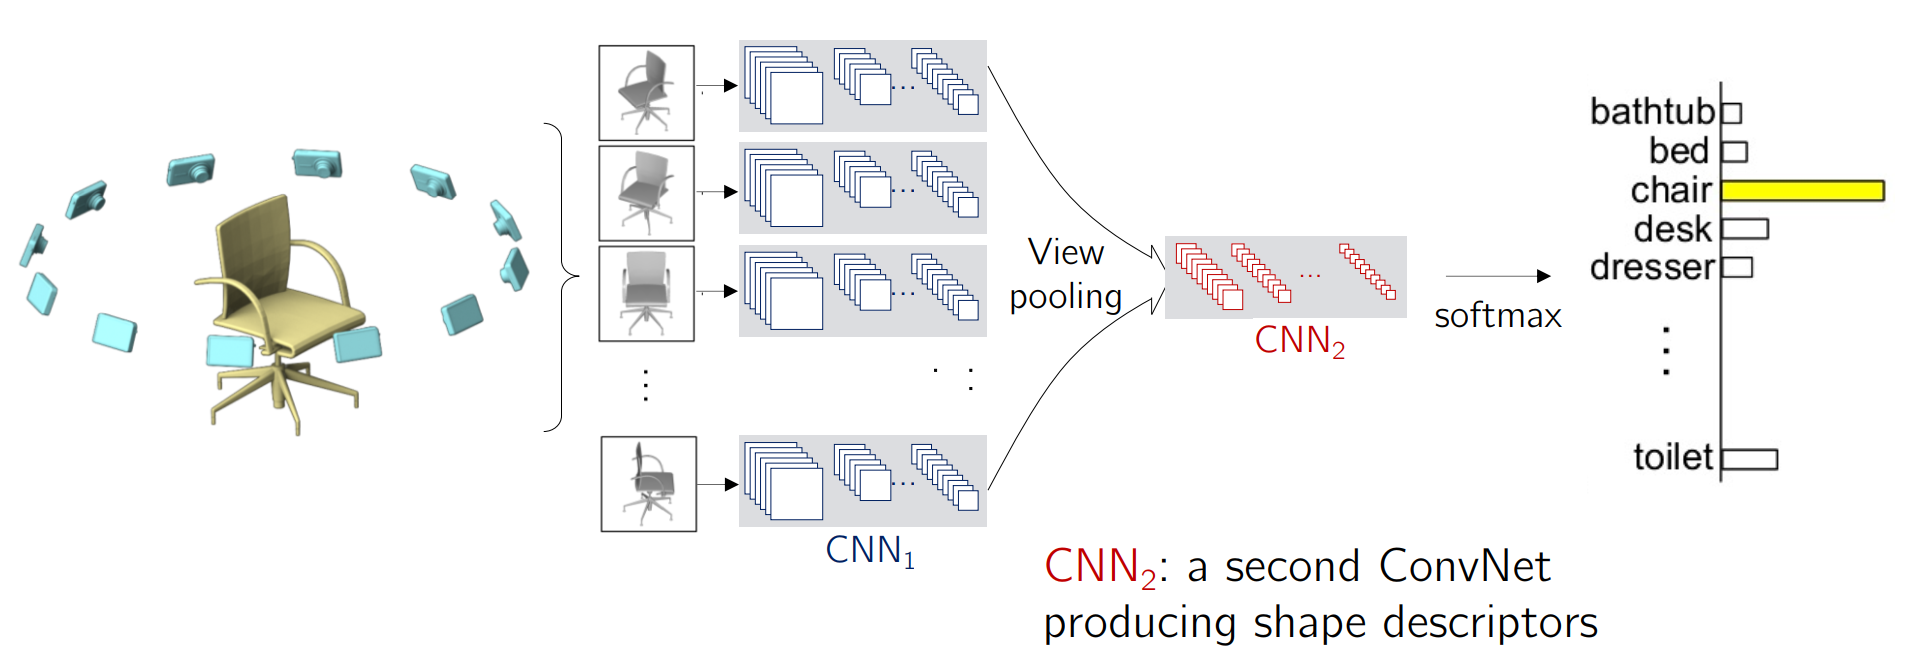
Multi-View CNN 的思路是把 3D 对象从多个相机角度渲染成 2D 图像,再用成熟的 2D CNN 处理。流程如下:
- 对同一个 3D 对象渲染多个 views。
- 每个 view 通过 CNN 提取图像特征。
- 通过 view pooling 对多个视角特征做逐元素 max pooling。
- 得到 shape descriptor,再用于分类或检索。
ModelNet40 上的结果显示,MVCNN 显著提升了分类和检索表现:
| Method | Classification Accuracy | Retrieval mAP |
|---|---|---|
| SPH | 68.2% | 33.3% |
| LFD | 75.5% | 40.9% |
| 3D ShapeNets | 77.3% | 49.2% |
| FV, 12 views | 84.8% | 43.9% |
| CNN, 12 views | 88.6% | 62.8% |
| MVCNN, 12 views | 89.9% | 70.1% |
| MVCNN + metric, 12 views | 89.5% | 80.2% |
| MVCNN, 80 views | 90.1% | 70.4% |
| MVCNN + metric, 80 views | 90.1% | 79.5% |
MVCNN 的优点是直接借用 2D CNN 的方法和预训练特征;缺点是必须选择投影视角,而且如果输入本身是 noisy/incomplete point cloud,渲染出的视图可能很差。
7.2 体素网络与 3D-GAN
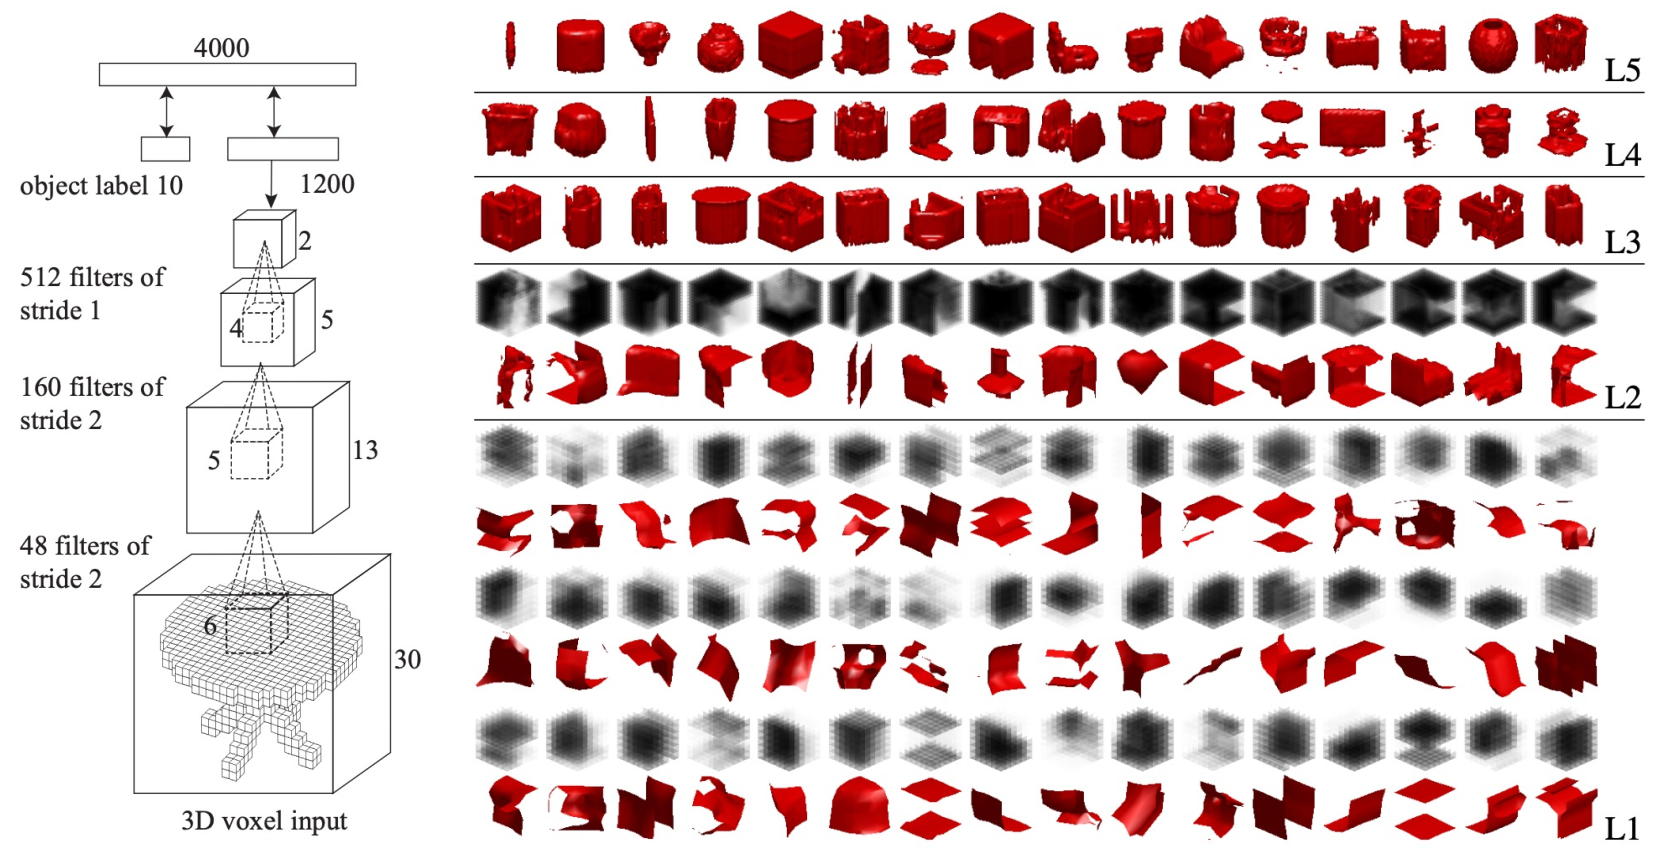
最直接的 3D-native 方法是把像素 CNN 扩展成体素 3D CNN。3D ShapeNets / 3D Conv Deep Belief Networks 使用 voxel occupancy grid 学习形状,可以做分类和生成。
之后 3D-GAN 把 GAN 从 2D pixels 扩展到 3D voxels:latent code 经过 generator 输出 3D voxel shape。这个思路很自然:GAN 可以生成 2D pixels,也可以生成 3D voxels,只是计算更重、分辨率更低。
7.3 Visual Object Networks:几何 + 渲染
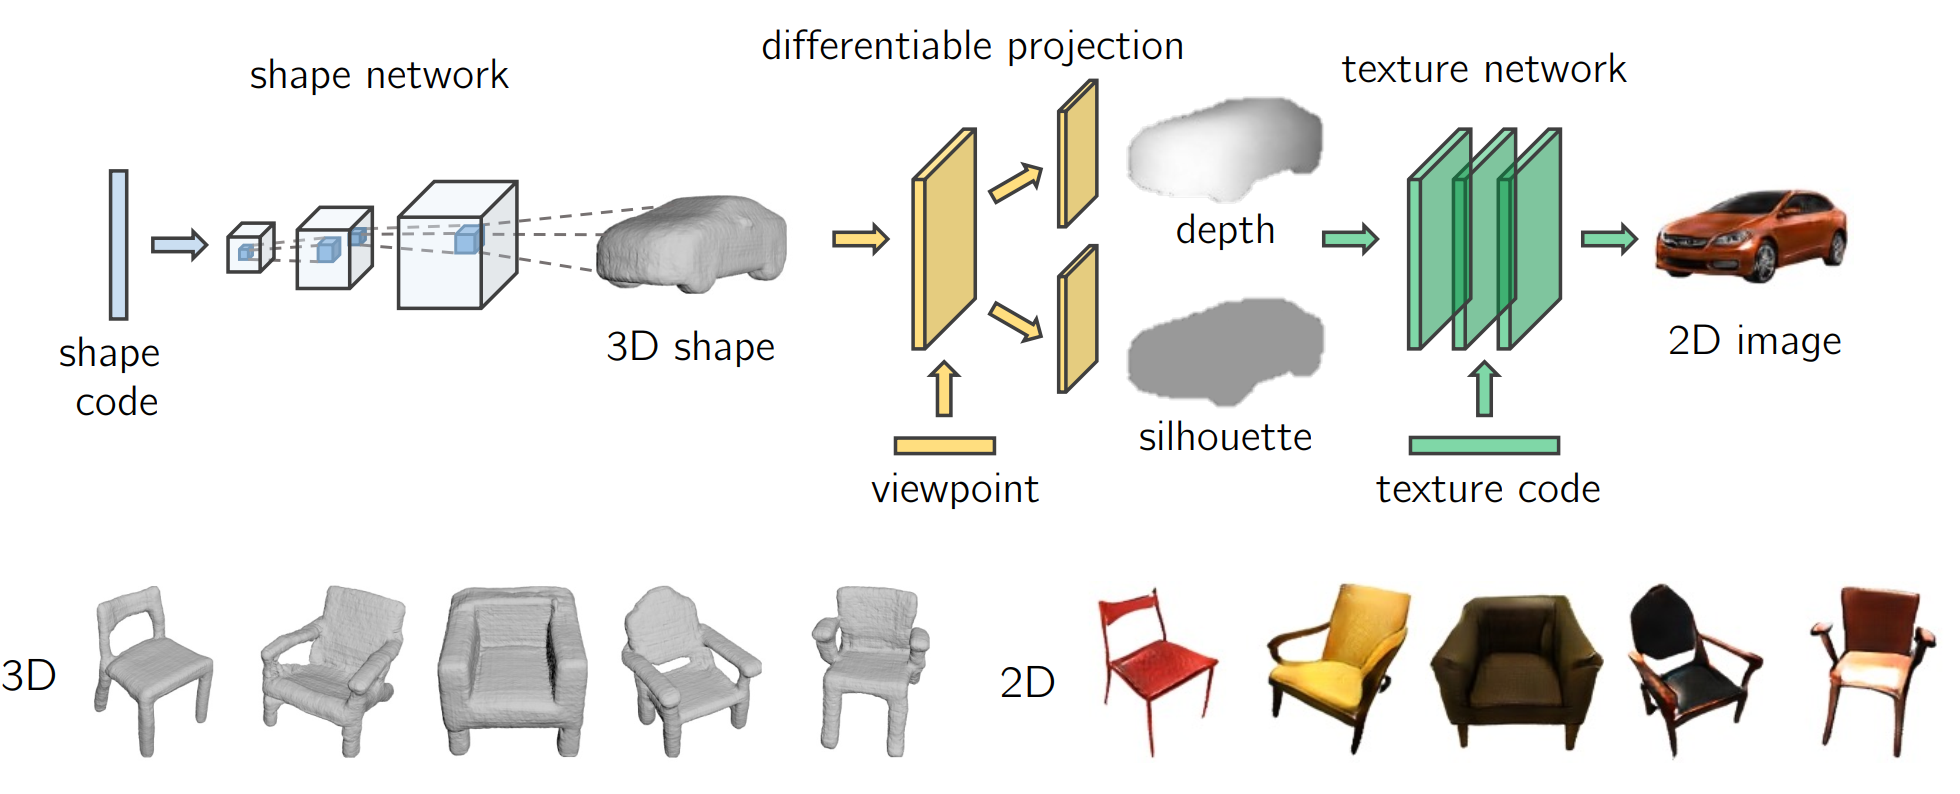
Visual Object Networks 把 3D generation 和 2D rendering 结合起来:
- shape network 生成 3D shape;
- texture network 生成 texture;
- viewpoint 控制相机;
- differentiable projection/rendering 输出 depth、silhouette(轮廓)或 RGB image;
- 2D 图像损失可以反向监督 3D 形状和外观。
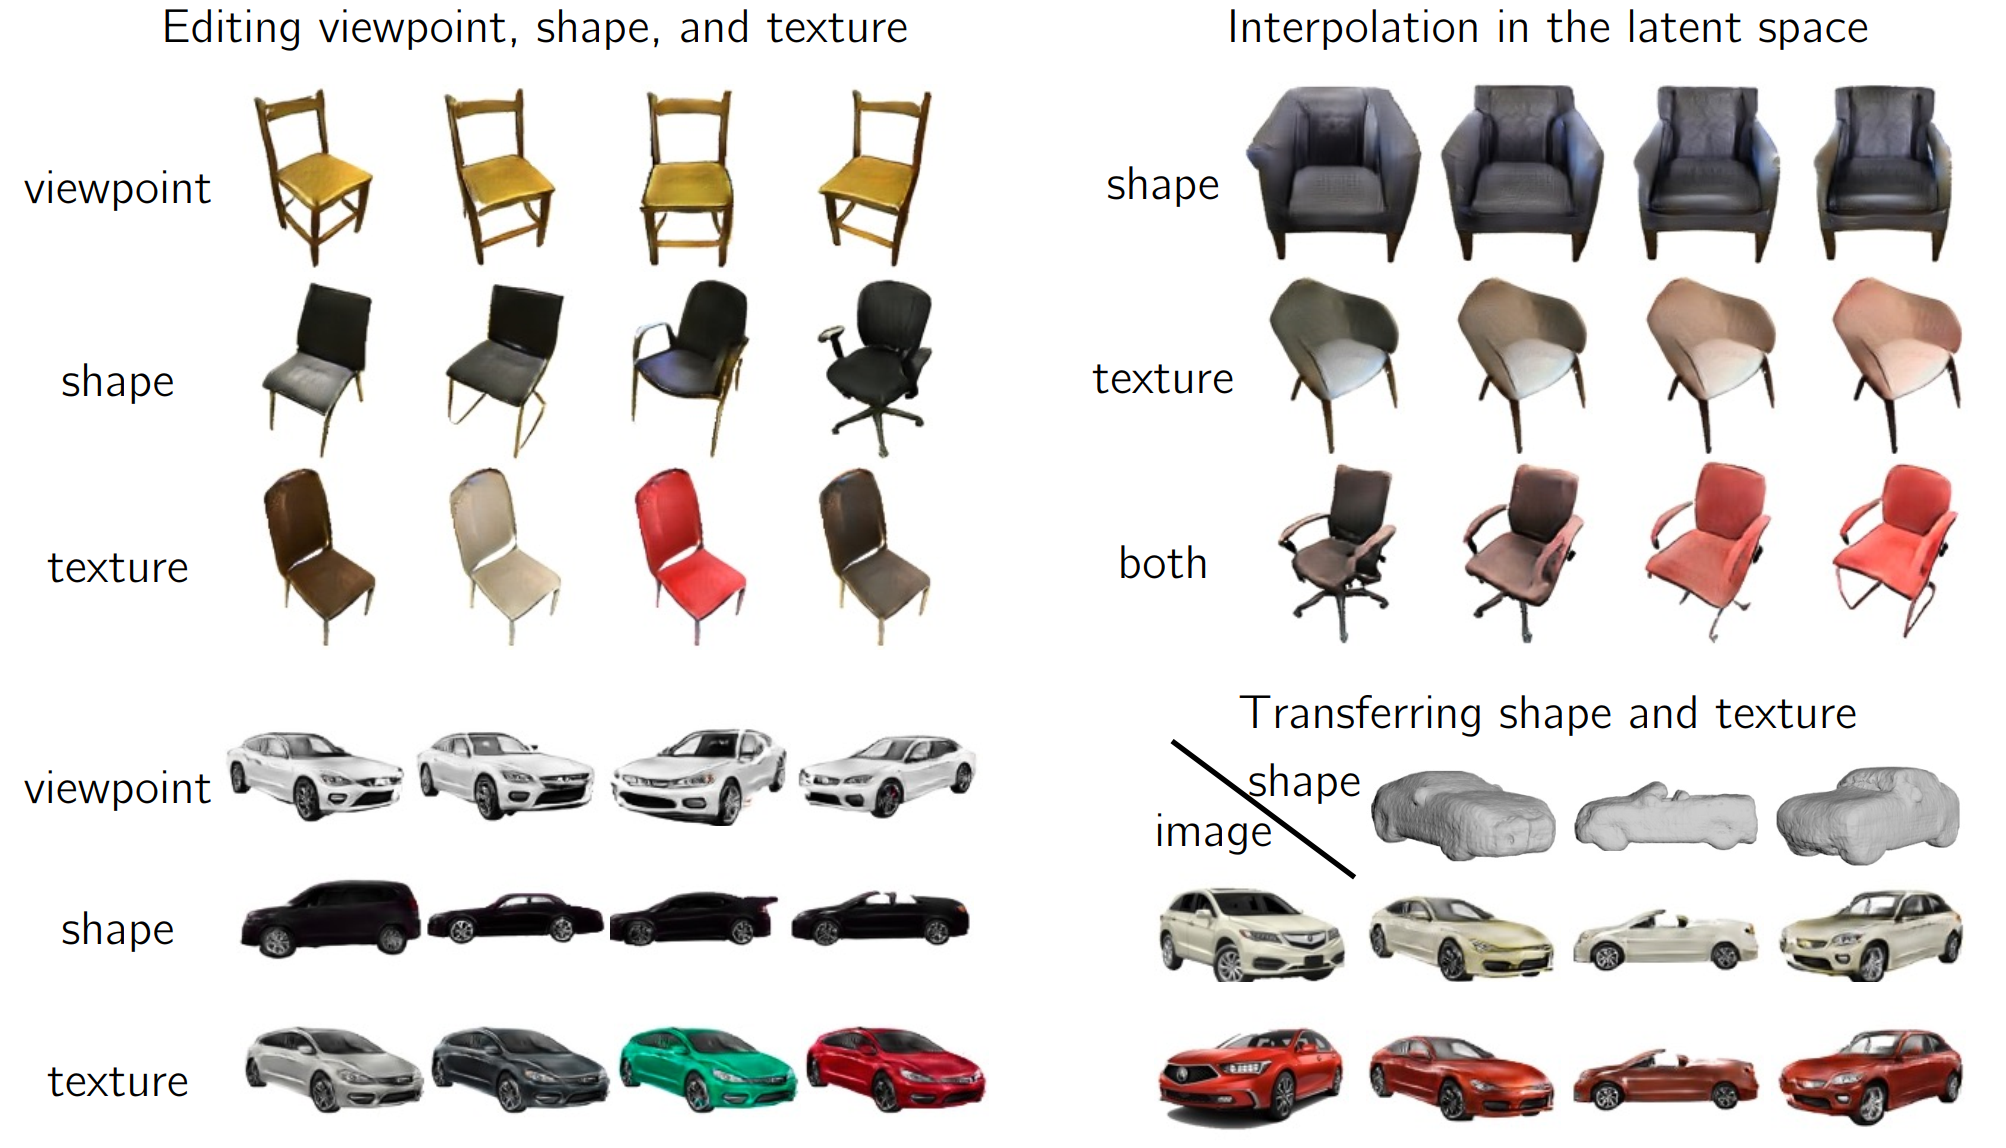
latent space 可以控制 viewpoint、shape、texture:可以固定形状改变视角,也可以固定视角改变物体身份,还可以把一辆车的 texture 转移到另一辆车的 shape 上。
7.4 Octree:稀疏体素与表面附近计算
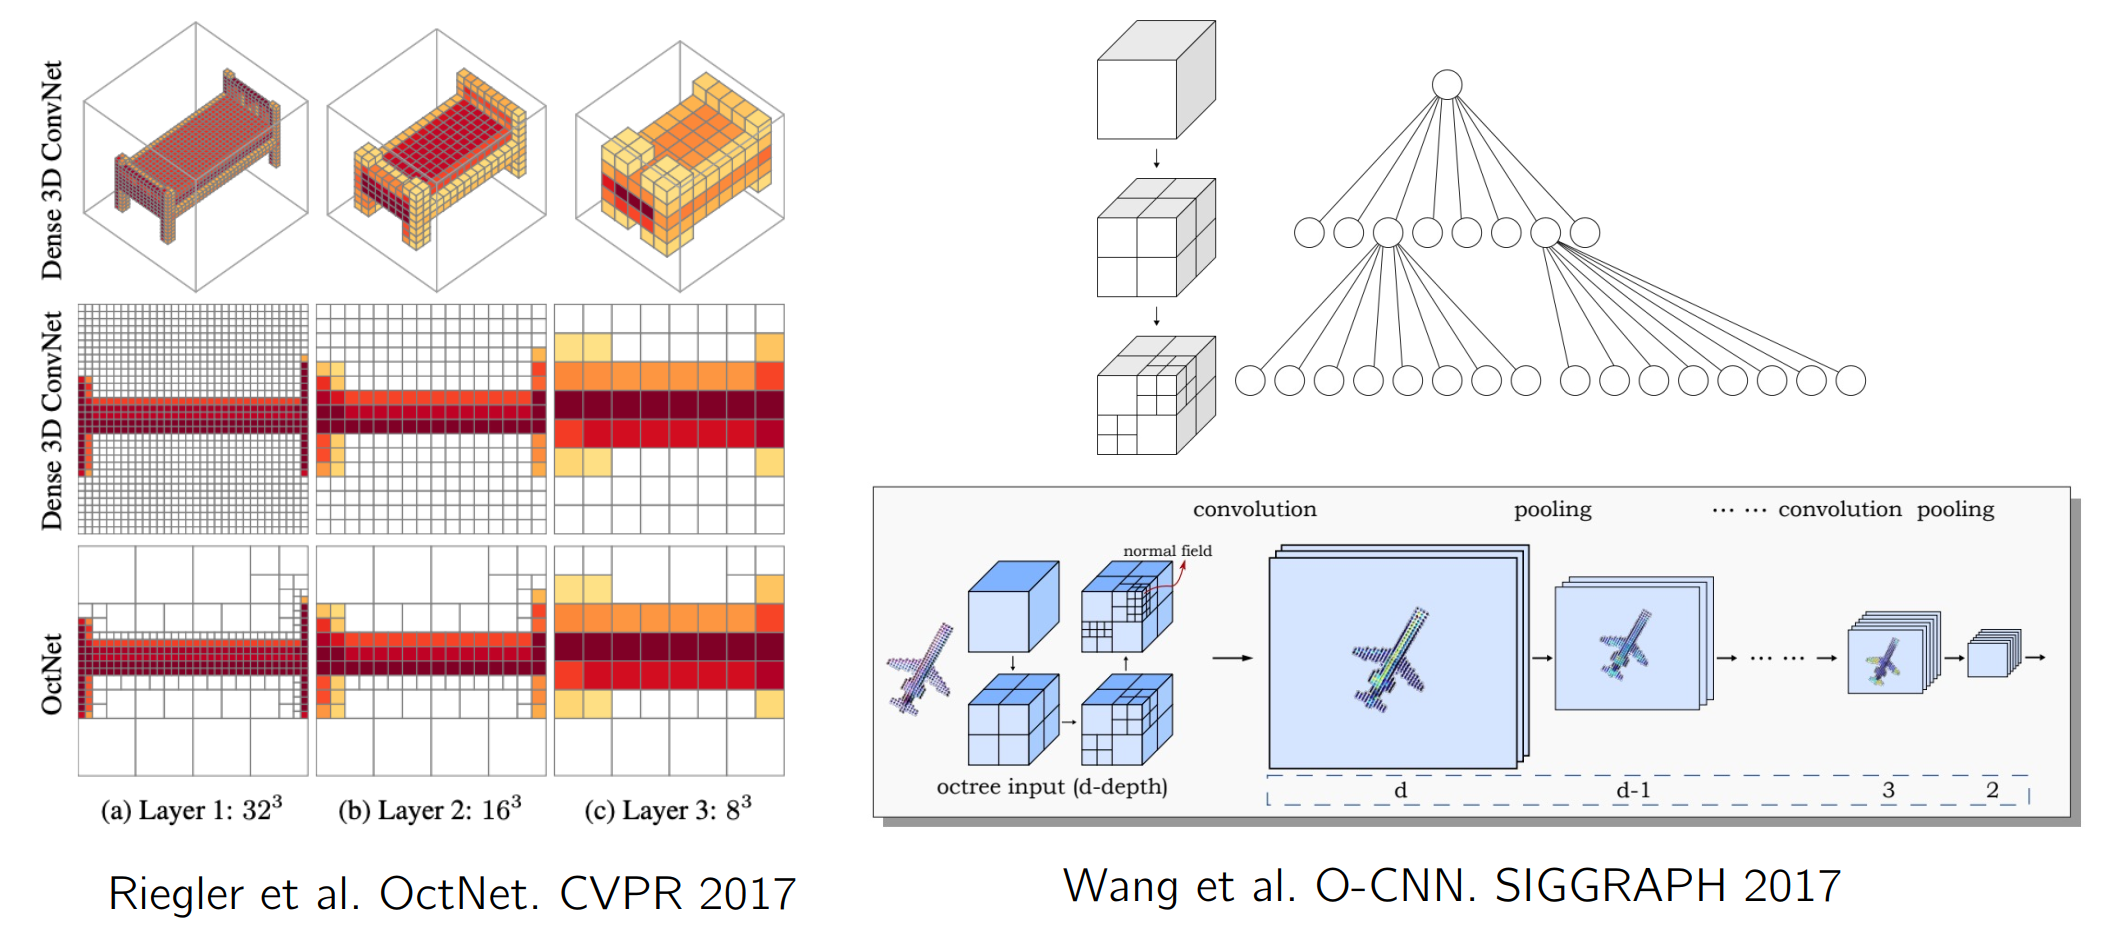
体素方法的问题是大量空间为空。Octree 的思想是递归划分空间:远离表面、信息少的区域用粗格子表示;接近表面和细节区域继续细分。
Octree 的优点:
- 存储稀疏表面信号;
- 把计算限制在靠近表面的区域;
- 高分辨率下比 dense voxel CNN 更省显存;
- 可以逐层生成 octree,避免完整 \(O(n^3)\) 重建。
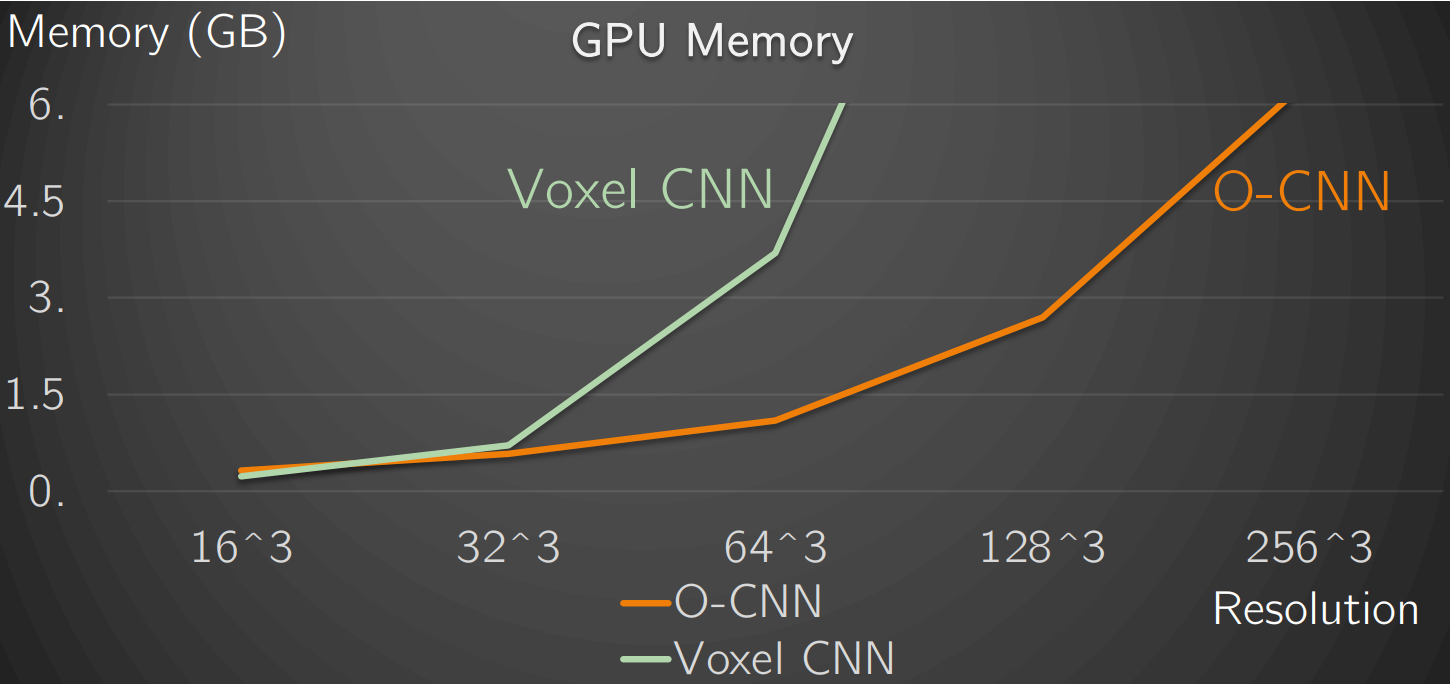
内存曲线说明:随着分辨率提高,Voxel CNN 的 GPU memory 快速增长,而 O-CNN 增长慢得多。
这里容易产生一个疑问:既然不同区域有粗格子和细格子,不同样本的 octree 结构也不一样,那输入给网络会不会很乱?答案是:Octree 确实比 dense voxel 不规则,但它不是无结构的乱,而是带规则坐标的稀疏层级网格。
可以把 octree 看成一层一层的网格:
- 第 0 层:一个大立方体;
- 第 1 层:最多 \(2^3\) 个格子;
- 第 2 层:最多 \(4^3\) 个格子;
- 第 \(d\) 层:最多 \(2^d\times2^d\times2^d\) 个格子。
实际计算时,只保留有用的 active cells,例如靠近表面或包含细节的格子;全空或信息少的区域就不继续细分。因此,全局坐标系统仍然是规则的,只是大量空格子被跳过了。网络通常按层处理这些 active cells:同一层的格子尺度一致,每个格子带有自己的空间坐标、层级和特征,卷积或信息传播只在存在的格子及其邻居之间进行。
不同样本的 octree 节点数通常不同。常见的做法是把多个样本的 active cells 打包成稀疏列表或稀疏张量,例如记录:
\[ (\text{batch id},x,y,z,\text{level},\text{feature}). \]
这样网络知道每个格子属于哪个样本、位于哪个层级和哪个空间位置。代价是实现比普通 3D CNN 更复杂;好处是避免把大量空空间塞进 GPU,把存储和计算集中在表面附近。
8 点云学习:PointNet、图网络与点集距离
8.1 从 Eulerian 到 Lagrangian
“Eulerian -> Lagrangian” 表示从固定空间网格转向随几何分布移动的表示。体素和 level set 是 Eulerian:格子固定在空间中;点云和 mesh 更像 Lagrangian:元素跟随对象表面分布。
8.2 PointNet
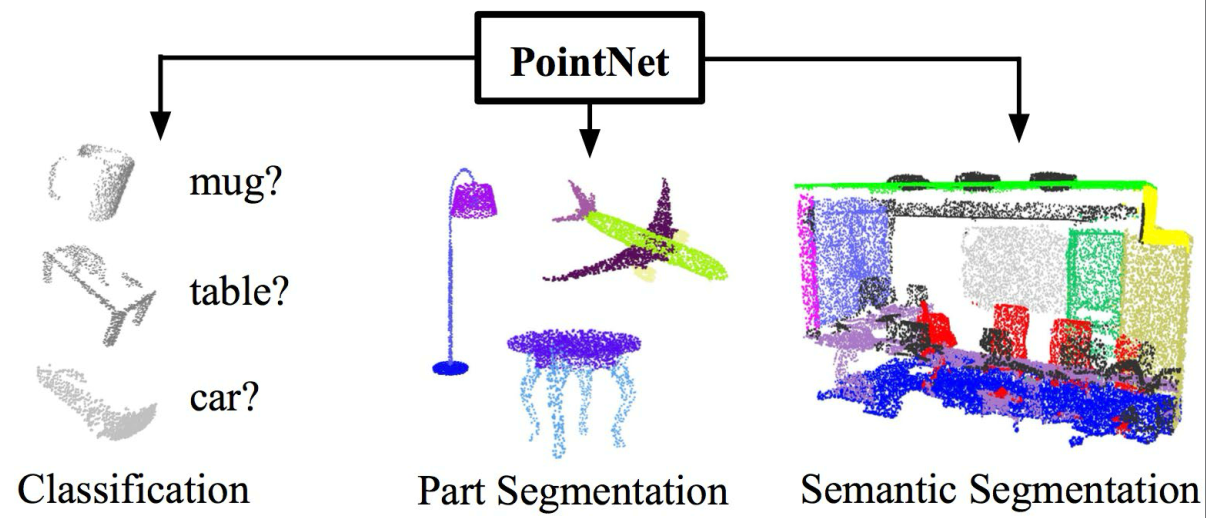
PointNet 是第一个非常有影响力的点云深度学习框架,可以用于:
- object classification;
- object part segmentation;
- semantic scene parsing。
点云模型必须满足两个关键必要条件:
Permutation Invariance
点云是无序集合,输入点顺序改变,输出不应改变。
Sampling Invariance
输出应该反映底层几何,而不是某一次采样的偶然性。
8.3 对称函数与 PointNet 形式
若函数满足:
\[ f(x_1,\ldots,x_n)=f(x_{\pi(1)},\ldots,x_{\pi(n)}) \]
对 \(\{1,2, \dots,n\}\) 的任意排列 \(\pi\) 成立,则它是对称函数。max、sum、average 都是对称聚合。对称函数正是实现 permutation invariance 的一种核心方法。
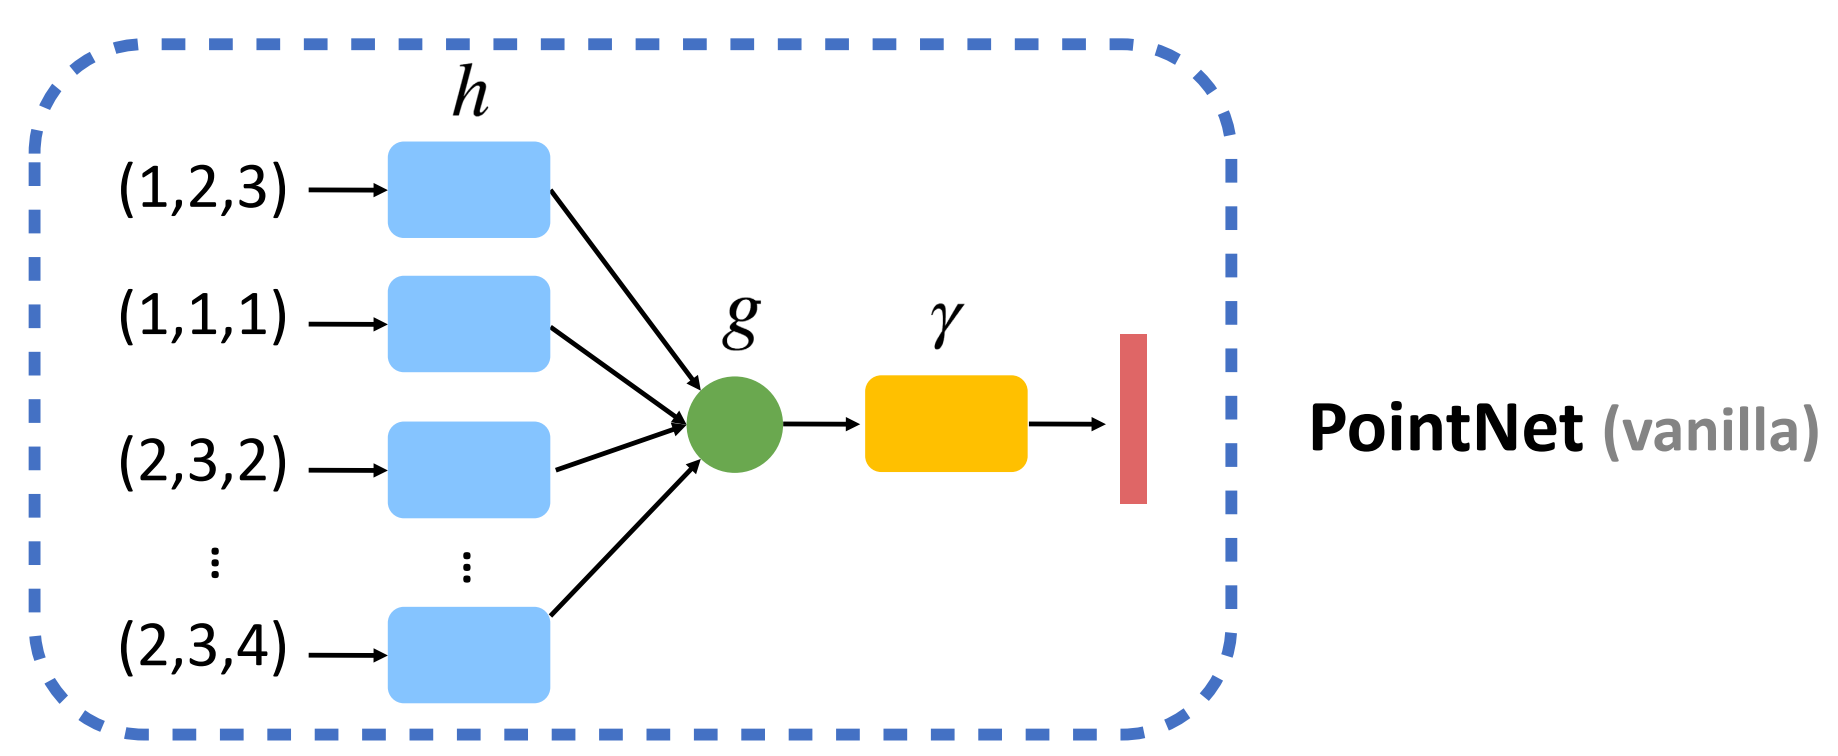
PointNet 的形式可以理解为:
\[ f(x_1,\ldots,x_n)=\gamma\left(g(h(x_1),\ldots,h(x_n))\right), \]
其中:
- \(h\):逐点 MLP,把每个点映射成特征;
- \(g\):对称聚合函数,常用 max pooling;
- \(\gamma\):聚合后的预测网络。
直接 max 聚合只能发现简单极值属性;PointNet 先用 \(h\) 学习丰富点特征,再用对称函数聚合,因此既有表达能力,又保持点顺序不变。
8.4 图神经网络处理点云
8.4.1 图神经网络基础:节点、边与消息传递
图神经网络(Graph Neural Network, GNN) 是专门处理图结构数据的神经网络。所谓图,由两类对象组成:
- 节点(nodes):图中的实体;
- 边(edges):节点之间的关系。
例如社交网络中,节点可以是用户,边表示好友关系;分子结构中,节点可以是原子,边表示化学键;在点云中,节点可以是 3D 点,边可以表示两个点在空间中互为邻居。
GNN 的核心思想是 message passing(消息传递):每个节点不仅看自己的特征,还会从邻居节点接收信息,然后更新自己的特征。一个典型过程可以概括为:
- 每个节点有初始特征,例如点云中的坐标、颜色、法向量或当前隐藏特征。
- 每个节点从相邻节点收集信息,例如邻居的位置、特征差异或边特征。
- 用 sum、mean、max 或一个小 MLP 聚合邻居信息。
- 用聚合后的信息更新当前节点特征。
- 重复多层后,一个节点的特征就会包含越来越大邻域的上下文。
直觉上,GNN 像是在图上做“局部交流”:第一层只和直接邻居交流,第二层可以间接看到二阶邻居,层数越深,感受野越大。它特别适合处理不规则结构,因为它不要求数据排成规则网格,只需要知道哪些节点相连。
8.4.2 点云为什么可以看成图
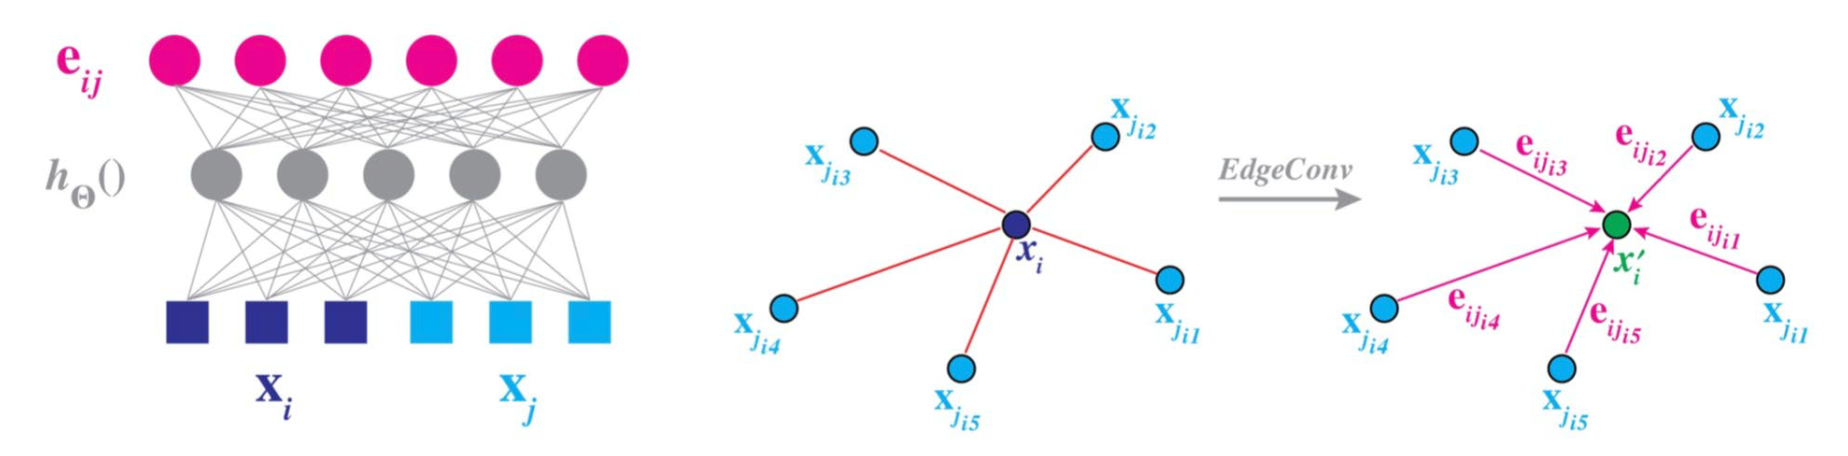
PointNet 对局部邻域建模较弱,因此后续方法把点云看成图:
- 点是 nodes;
- 邻域关系是 edges;
- message passing 在邻域间传播信息。
这样做的好处是:模型不再只把点云看成一堆独立点,而是能显式建模局部几何关系。例如,某个点附近的邻居如何排列,可以帮助判断这里是平面、边缘、角点,还是某个物体部件的局部结构。
在实践中,点云图的边通常不是人工标注的,而是根据邻近关系自动构建:
- 空间邻近:在 3D 坐标中找每个点最近的 \(k\) 个点,形成 \(k\)NN 图;
- 半径邻近:把一定半径内的点连成边;
- 特征邻近:在网络中间层,根据 learned feature 的相似性重新找邻居。
Dynamic Graph CNN 等方法会根据空间邻近或特征邻近构建动态图。所谓 dynamic,是指邻居关系可以随着网络层数和特征变化而更新,从而更好捕捉局部几何结构。
8.5 点集距离:Chamfer Distance 与 EMD
生成或重建点云时,需要把网络输出的点集和数据集中真实的点集作比较,从而写出 loss function。下面这两种距离可以用作 loss function。设 \(S_1,S_2\subseteq\mathbb{R}^3\)。
Chamfer Distance:
\[ d_{CD}(S_1,S_2)= \sum_{x\in S_1}\min_{y\in S_2}\|x-y\|_2+ \sum_{y\in S_2}\min_{x\in S_1}\|x-y\|_2. \]
它让每个点找另一个集合中的最近点,计算相对便宜,但可能产生多对一匹配。
Earth Mover’s Distance(EMD):
若 \(|S_1|=|S_2|\),
\[ d_{EMD}(S_1,S_2)= \min_{\phi:S_1\rightarrow S_2} \sum_{x\in S_1}\|x-\phi(x)\|_2, \]
其中 \(\phi\) 是双射。EMD 更像“搬运”一个点集到另一个点集,匹配更严格,但计算更贵。
9 参数化神经解码器与 AtlasNet
AtlasNet 的动机是:点云虽然摆脱了体素分辨率限制,但点是无序的,难以得到光滑表面。参数曲面能产生光滑表面,但复杂对象的闭式参数方程难以手写。于是可以用神经网络学习这个参数映射。
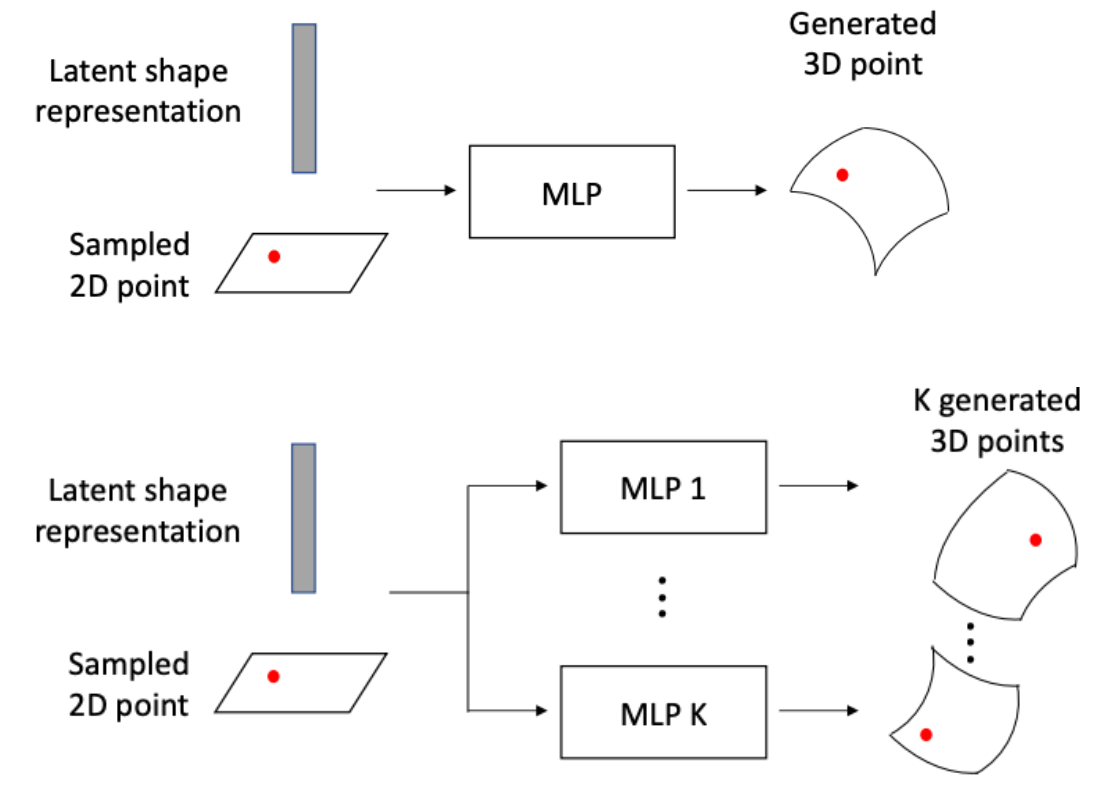
AtlasNet 把二维参数点 \((u,v)\) 和形状 latent code \(l\) 输入 MLP,输出 3D 点:
\[ \mathrm{MLP}(l,u,v)\rightarrow (x,y,z). \]
可以用“纸片折叠”类比这一过程:一个 MLP 可以把一张二维纸片折到三维空间中;多个小 MLP/patch 可以共同覆盖复杂对象表面。这就是 AtlasNet 名字中 atlas 的含义:用多个局部图册 patch 覆盖整体曲面。
与 voxel 和 point cloud 相比:
- voxel 受分辨率限制,表面粗糙;
- point cloud 更自由,但没有连续表面;
- AtlasNet 学习低维参数域到 3D 的映射,能产生更平滑的表面,并可进一步生成 mesh。
10 深度隐式函数、NeRF 与 3D Gaussian Splatting
10.1 为什么深度网络适合表示隐式函数
深度网络本质上是在学习一个复杂函数。例如图像分类中,网络学习从高维像素空间到低维类别标签的映射;这个函数很难手写,所以用神经网络逼近。
这个思路自然也适合 3D 隐式函数。与其把空间预采样成 voxel,再在 voxel 上做 3D CNN,不如直接学习一个函数:
\[ F_\theta(x,z)\rightarrow \text{occupancy or SDF}, \]
其中 \(x\) 是 3D 查询点,\(z\) 是形状 latent code。给定任意空间点,网络输出该点是否在物体内、离表面多远,或表面附近的密度。
代表方法包括:
- Occupancy Networks;
- DeepSDF;
- Deep Level Sets;
- Learning to Infer Implicit Surfaces without 3D Supervision。
这些方法把 3D shape 表示成连续神经隐式场,避免固定体素分辨率,但通常仍需要 3D shape supervision 或采样点监督。
10.2 NeRF:从几何隐式函数到几何 + 外观 + 2D 监督
NeRF(Neural Radiance Fields)主要解决的问题是 novel view synthesis(新视角合成):给定同一个场景或物体的多张 2D 照片,以及这些照片对应的相机位姿,学习一个可以从任意新视角渲染图像的 3D 表示。
它的目标是学习一个连续的神经场。这个神经场像一个“3D 世界查询器”:给定空间中的一个点和观察方向,网络返回这个位置的颜色以及这里有多挡光。
更具体地说,NeRF 学习的函数可以写成:
\[ F_\theta(\mathbf{x},\mathbf{d})\rightarrow(\sigma,\mathbf{c}), \]
其中:
- \(\mathbf{x}=(x,y,z)\) 是空间中的 3D 查询点;
- \(\mathbf{d}\) 是观察方向;
- \(\sigma\) 是该位置的 density,可以理解成密度、不透明度或“这里有多像有东西”;
- \(\mathbf{c}=(R,G,B)\) 是从方向 \(\mathbf{d}\) 看这个位置时的颜色。
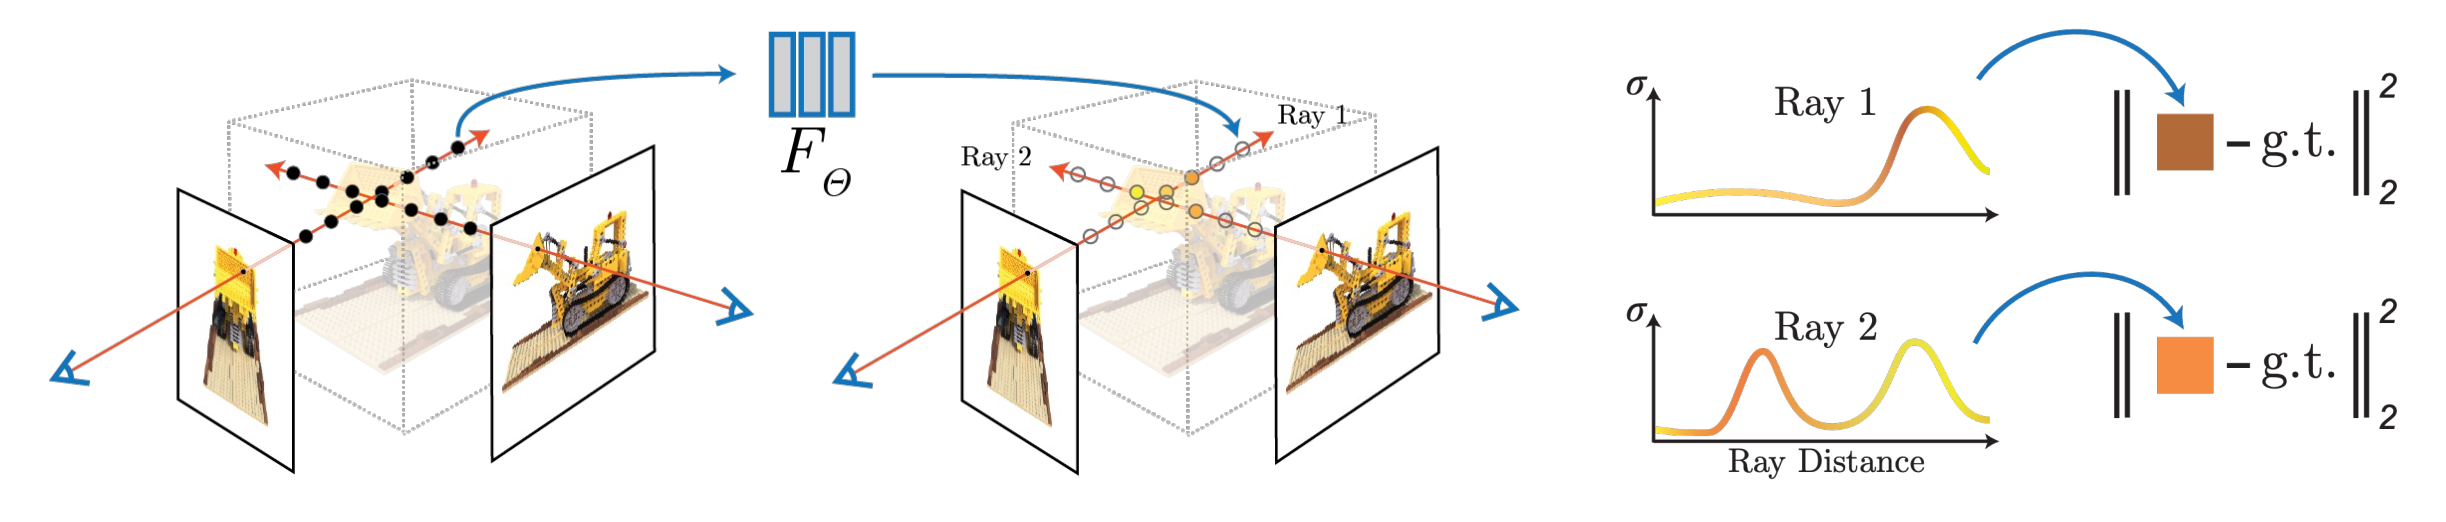
训练时,NeRF 沿着每个像素对应的相机光线采样许多 3D 点,查询这些点的 \(\sigma\) 和颜色,再通过可微体渲染把它们合成为一个预测像素颜色。这个预测颜色会和真实照片中的像素颜色比较,误差再反向传播更新网络。因此,NeRF 的关键桥梁是:
\[ \text{3D neural field}\xrightarrow{\text{volume rendering}}\text{2D image}. \]
这样一来,模型虽然学习的是 3D 场景表示,但监督信号可以来自普通 2D 图像,而不一定需要真实的 3D shape 标注。
NeRF 的关键跃迁不是凭空出现的。它很大程度上继承了 deep implicit functions 的思想,只是做了两个重要扩展:
不只表示几何,还表示 appearance/radiance。
网络输入空间位置和视角方向,输出颜色和体密度: \[ F_\theta(x,y,z,\theta,\phi)\rightarrow (RGB,\sigma). \]
通过可微体渲染从 2D images 学习。
不再必须有 3D shape supervision,而是从多视角图像和相机位姿训练。
10.3 体渲染公式
对一条相机光线:
\[ r(t)=o+td, \]
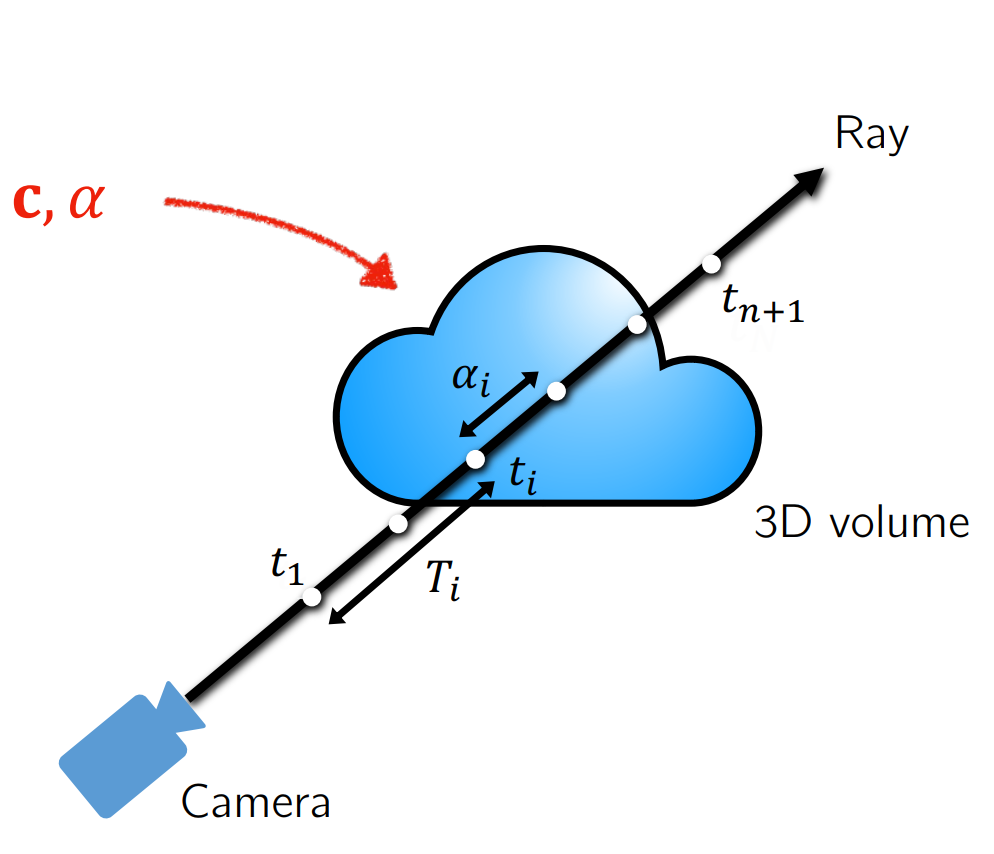
沿光线采样多个点,每个采样点由网络输出 density \(\sigma_i\) 和颜色 \(c_i\)。为了计算每一小段光线对最终像素的贡献,通常会先把 density \(\sigma_i\) 转换成 opacity/alpha:
\[ \alpha_i=1-\exp(-\sigma_i\delta_i), \]
其中 \(\delta_i\) 表示第 \(i\) 个采样点附近这一小段 ray interval 的长度。直觉上,\(\sigma_i\) 越大,说明该位置越“挡光”;\(\delta_i\) 越长,说明光线在这一段中穿过的距离越长;两者共同决定这一段的 \(\alpha_i\) 有多大。
最终像素颜色近似为:
\[ c\approx\sum_{i=1}^{n}T_i\alpha_i c_i. \]
其中:
\[ T_i=\prod_{j=1}^{i-1}(1-\alpha_j). \]
\(T_i\) 表示光线到达第 \(i\) 个采样点前还没有被前面点挡住的比例,\(\alpha_i\) 表示第 \(i\) 段贡献多少光,\(c_i\) 是该段颜色。因此,体渲染中的关系可以理解为:
\[ \sigma_i\rightarrow\alpha_i\rightarrow\text{最终像素颜色}. \]
也就是说,公式里虽然直接出现的是 \(\alpha_i\),但 \(\alpha_i\) 是由网络输出的 density \(\sigma_i\) 和采样间隔 \(\delta_i\) 计算得到的。因为这些计算在离散近似下可微,所以可以从图像重建损失反向训练神经场。
另外可以看到,体渲染公式对颜色 \(c_i\) 和透明度/不透明度参数 \(\alpha_i\) 是可微的,所以可以用反向传播训练网络。
NeRF 的意义在于:
- 用神经隐式函数表示 3D density 和 radiance;
- 用体渲染连接 3D 场和 2D 图像;
- 可以直接从 2D images 学习,而不局限于有大量 3D CAD 数据的类别;
- 新视角合成质量很高。
10.4 生成式隐式几何 + 渲染
课件后面把早期 voxel-based 生成模型替换成 radiance fields。也就是说,生成器不再只生成体素形状,而是生成一个隐式 radiance field,再通过 neural rendering 得到图像。这样可以保持 viewpoint、identity、texture 等控制能力,同时从图像数据中学习更真实的外观。
视频中提到 Pi-GAN 一类方法:用生成式神经网络输出隐式辐射场和密度,然后用 NeRF 风格渲染生成 2D 图像。它把 GAN 的生成能力、隐式表示和可微渲染结合起来。
10.5 3D Gaussian Splatting:为什么又回到稀疏显式基元
NeRF 的问题是慢。它需要沿每条光线采样大量空间点,并反复查询神经网络。很多查询点位于空空间,最终密度接近 0,却仍然消耗计算。
视频中老师用这一点解释 3D Gaussian Splatting 的动机:能否保留隐式/神经渲染的高质量,但避免在空空间密集采样?
3DGS 的思想是把场景表示成稀疏的 3D Gaussian blobs:
- 每个 Gaussian 像一个扩展点,不是无限小的点;
- 它有位置、尺度/协方差、不透明度和颜色;
- 渲染时只关注这些 blob 所在区域,而不是均匀查询整个空间;
- 可以高效投影到图像平面并 splat。
对比 NeRF 与 3DGS:
| 方法 | 参数化方式 | 渲染方式 | 优势 | 主要问题 |
|---|---|---|---|---|
| NeRF | 密集连续神经场 | 沿 ray 多点采样 + 体渲染 | 质量高、连续、可从 2D 学习 | 查询多,渲染慢 |
| 3D Gaussian Splatting | 稀疏 3D Gaussian blobs | 将 Gaussian 投影/splat 到图像 | 质量接近 NeRF,速度大幅提升 | 依赖显式基元优化和可见性处理 |
老师提到,3DGS 在质量指标上与 NeRF 接近,但渲染速度可以高很多,因为它不再把大量算力浪费在空空间查询上。
11 结构感知表示:几何细节之外的部件、关系与程序
课程最后讨论 structure-aware representation。老师强调,点云、mesh、voxel、implicit functions 更多表示的是几何细节,但真实物体还有结构规律,例如:
- 椅子有座面、靠背、腿、扶手;
- 左右腿应该对称;
- 椅腿应与座面连接并支撑整体;
- 房间里床通常靠墙,椅子常在桌子旁边;
- 建筑和场景有层次:房间包含桌椅,椅子包含部件。
课件用公式化图示表达:
\[ \text{Shape}=\text{Element Geometry}+\text{Element Structure}. \]
11.1 结构表示的层级
| 表示 | 核心思想 | 优点 | 局限 |
|---|---|---|---|
| Segmented Geometry | 把几何分割成段 | 简单,复用普通几何模型 | 部件完整性不保证 |
| Part Sets | 用部件集合表示对象 | 部件相对清晰 | 不建模关系,部件可能漂浮 |
| Relationship Graphs | 部件为节点,关系为边 | 可表达连接、支撑、对称、邻接 | 通用图生成较难 |
| Hierarchies | 用树表示 part-whole 层次 | 树模型更容易学习 | 不是所有关系都是树 |
| Hierarchical Graphs | 同时有层次和横向关系 | 表达力更强 | 标注昂贵,数据难获得 |
| Programs | 用程序生成形状 | 可表达循环、重复、参数和约束 | 学习和数据获取最难 |
11.2 StructureNet 与程序化趋势
StructureNet 用 hierarchical graph 表示椅子等对象:节点表示部件或 primitive,边表示关系,图卷积网络用于编码/解码可变度节点。这样可以生成满足部件约束的 3D 形状。
视频结尾还提到一个新趋势:大型语言模型已经能理解语义和约束,研究者开始探索让 LLM 输出 shape programs,再用隐式函数或其他几何表示生成具体部件细节。这说明未来 3D 表示可能会把语言、程序、部件结构和低层几何结合起来。
12 复习重点、公式与易混点
12.1 本讲主线
这节课可以用一条线串起来:
- 3D 不像 2D 有统一像素表示,因此必须先选择 shape representation。
- 显式表示直接给出表面或表面采样,采样容易,但内外查询和神经渲染查询不一定方便。
- 隐式表示用函数定义表面和内外,查询容易,但采样表面和高效渲染更困难。
- 3D 数据规模长期小于 2D 数据,因此 3D deep learning 一直在表示、数据和监督之间折中。
- MVCNN 借用 2D CNN,voxel 网络借用 3D CNN,Octree 解决体素稀疏性,PointNet 解决点云无序性。
- AtlasNet 用神经网络学习参数曲面映射,DeepSDF/Occupancy 用神经网络学习隐式函数。
- NeRF 把 deep implicit functions 扩展到 density + radiance,并通过可微体渲染从 2D 图像学习。
- 3DGS 重新引入稀疏显式基元,避免 NeRF 在空空间中密集查询。
- 结构感知表示进一步建模部件、关系、层次、对称、重复和程序。
12.2 关键公式
参数曲面
\[ s(u,v)=(x(u,v),y(u,v),z(u,v)). \]
隐式曲面
\[ f(x,y,z)=0. \]
Chamfer Distance
\[ d_{CD}(S_1,S_2)= \sum_{x\in S_1}\min_{y\in S_2}\|x-y\|_2+ \sum_{y\in S_2}\min_{x\in S_1}\|x-y\|_2. \]
EMD
\[ d_{EMD}(S_1,S_2)= \min_{\phi:S_1\rightarrow S_2} \sum_{x\in S_1}\|x-\phi(x)\|_2. \]
NeRF 体渲染
\[ c\approx\sum_{i=1}^{n}T_i\alpha_i c_i,\quad T_i=\prod_{j=1}^{i-1}(1-\alpha_j). \]
12.3 易混点
显式表示不等于一定更好渲染。
传统 mesh 很适合图形学渲染,但 NeRF/3DGS
证明隐式或混合表示也可以做高质量神经渲染。
体素和隐式函数有关但不相同。
体素可以存储
occupancy/SDF/density,因此常是隐式函数的离散化;但连续隐式函数可以在任意坐标查询,不受固定网格分辨率限制。
PointNet 的核心不是 MLP,而是集合不变性。
逐点 MLP 加 max pooling 的结构保证点顺序变化不会改变全局输出。
Chamfer 和 EMD 的区别在匹配约束。
Chamfer 是双向最近邻,便宜但可能多对一;EMD
是一对一最优搬运,更严格但更贵。
NeRF 不是突然出现的。
它继承 deep implicit functions 的连续场思想,并加入 radiance、view
direction 和可微 volume rendering,使得模型能从 2D images 学习 3D
appearance 和 geometry。
3DGS 不是简单点云。
它的 Gaussian
是带尺度、形状、不透明度和颜色的扩展基元。它像点云一样稀疏高效,但比普通点有更强的局部体积和渲染表达能力。
12.4 可能考法
- 比较 point cloud、mesh、voxel、implicit function 的优缺点。
- 解释为什么 3D deep learning 比 2D vision 更难直接套用 CNN。
- 给定 \(f(x,y,z)\),判断点在表面、内部还是外部。
- 写出 Chamfer Distance、EMD 或 NeRF 体渲染公式,并解释变量。
- 说明 MVCNN 的 view pooling 为什么能产生多视角 shape descriptor。
- 解释 PointNet 如何满足 permutation invariance。
- 比较 NeRF 和 3D Gaussian Splatting 的表示和效率差异。
- 说明为什么结构感知表示需要建模部件关系,而不仅是几何表面。
12.5 一句话总结
3D Vision 的核心不是某一种网络结构,而是围绕 3D 表示展开的系统性权衡:如何存储几何、如何查询内外和外观、如何渲染成图像、如何从有限 3D 数据和海量 2D 数据中学习,以及如何让生成的形状不仅有表面细节,还具有合理的部件结构。