1 本讲主线:从专用模型到多模态基础模型
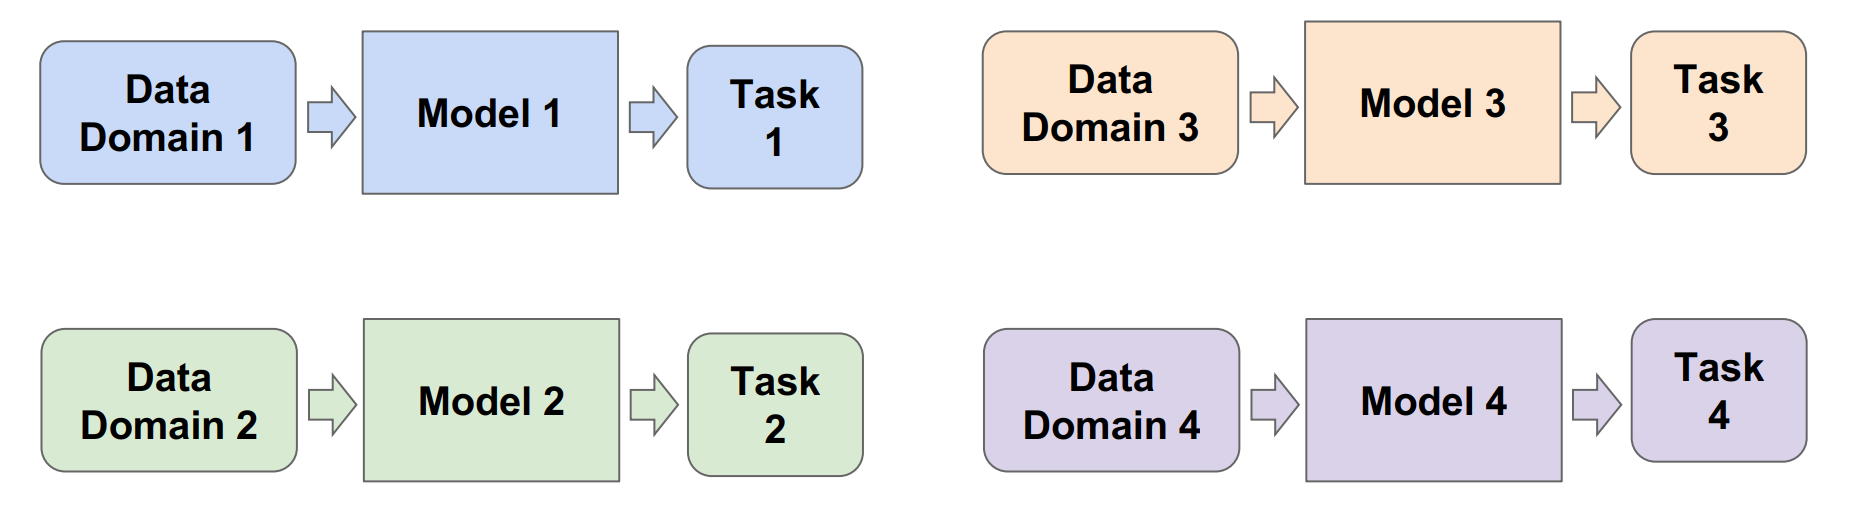
这节课讨论 多模态基础模型(Multi-Modal Foundation Models)。前面很多视觉任务通常遵循一个专用模型范式:为一个数据域和一个任务收集训练集、训练一个专门模型、再在对应测试集上评估。例如图像分类、目标检测、图像 captioning、语义分割都可以分别训练各自的模型。
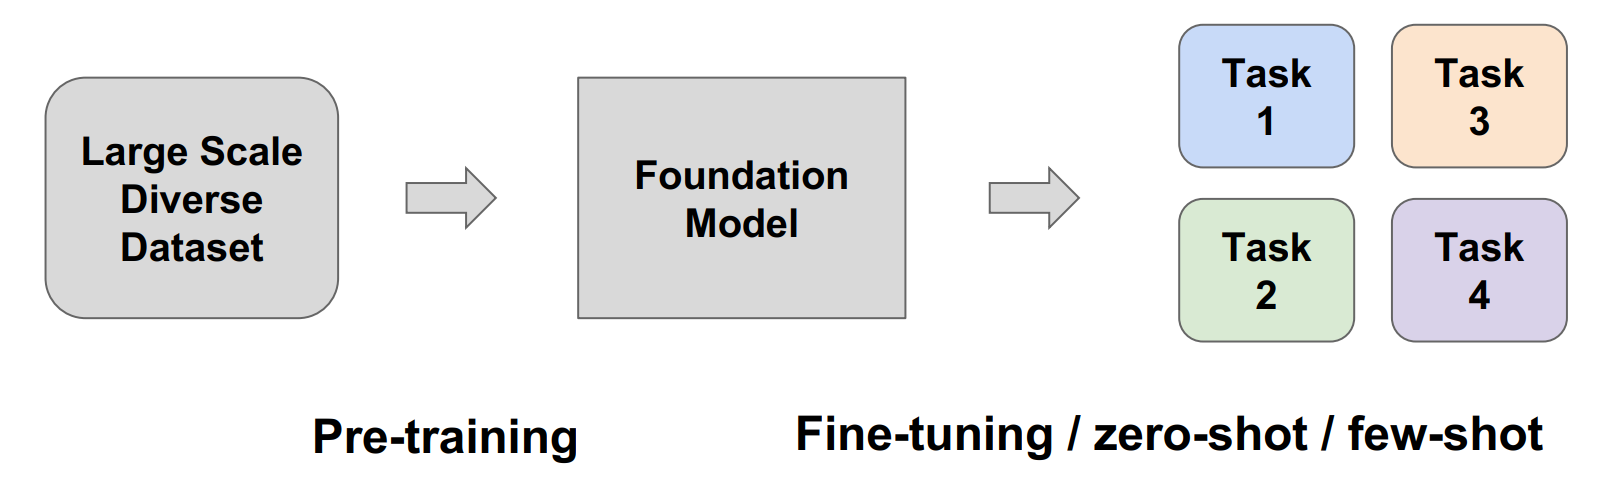
基础模型范式改变了这个流程。它先在大规模、多样化的数据上进行预训练,得到一个可以作为“底座”的模型,然后通过 fine-tuning、zero-shot、few-shot 或 prompt/in-context learning 适配到许多下游任务。关键变化不是某一个任务精度更高,而是 同一个预训练模型能迁移到大量任务,并且适配成本显著降低。
语言模型是最熟悉的例子。GPT 类模型先在 Common Crawl 等大规模文本上做预训练,再通过提示、少量样例或微调处理数学、翻译、符号推理、问答等任务。本讲不展开语言模型本身,而是关注视觉相关的多模态基础模型:分类基础模型、视觉语言模型、分割基础模型,以及多个模型的组合。
本讲出现的主要模型谱系如下:
| 类别 | 代表模型 | 输入 | 输出 | 核心能力 |
|---|---|---|---|---|
| 语言基础模型 | ELMo、BERT、GPT、T5 | 文本 | 文本或表征 | 通用语言理解与生成 |
| 分类/检索基础模型 | CLIP、CoCa | 图像和文本 | 相似度、类别、检索结果 | 开放词表分类和图文匹配 |
| 视觉语言模型 | LLaVA、Flamingo、GPT-4V、Gemini、Molmo | 图像和文本 | 文本 | 视觉问答、captioning、OCR、推理 |
| 其他视觉基础模型 | Segment Anything、Whisper、DALL-E、Stable Diffusion、Imagen | 取决于模型 | mask、音频文本、图像等 | 某类输出空间中的通用能力 |
| 模型组合 | LMs + CLIP、Visual Programming | 多个模型和工具 | 程序结果或组合答案 | 用组合获得单模型没有的能力 |
2 基础模型的共同特征与视觉多模态分类
判断一个模型是否是基础模型,最核心的标准是:它是否对许多不同任务具有通用性和鲁棒性。大参数量、大数据量、自监督预训练目标很常见,但这些更像是实现路径,不是定义本身。一个模型参数很大却只能做一个窄任务,并不能自动成为基础模型。
视觉基础模型的难点在于,视觉任务的输出空间比语言更分散。分类输出是类别,检测输出是 bounding box,分割输出是 mask,captioning 输出是文本,机器人任务可能输出动作。多模态基础模型的一个长期目标,就是让视觉输入能和语言、空间、动作等多种输出空间连接起来。
本讲先从分类基础模型开始,因为它最容易看清楚“开放词表”和“zero-shot”的思想:如果图像和文本能嵌入同一个空间,那么类别标签不再只能来自固定训练集,而可以由自然语言 prompt 动态给出。
3 CLIP:用图文对比学习构造开放词表分类器
3.1 从 SimCLR 到 CLIP
CLIP 的思想可以从 SimCLR 的自监督学习目标理解。SimCLR 把同一张图像的不同增强视图拉近,把 batch 中其他图像推远,从而学习无需人工标签的图像表征。它的核心是 对比学习(contrastive learning):相似样本的 embedding 应该接近,不相似样本的 embedding 应该远离。
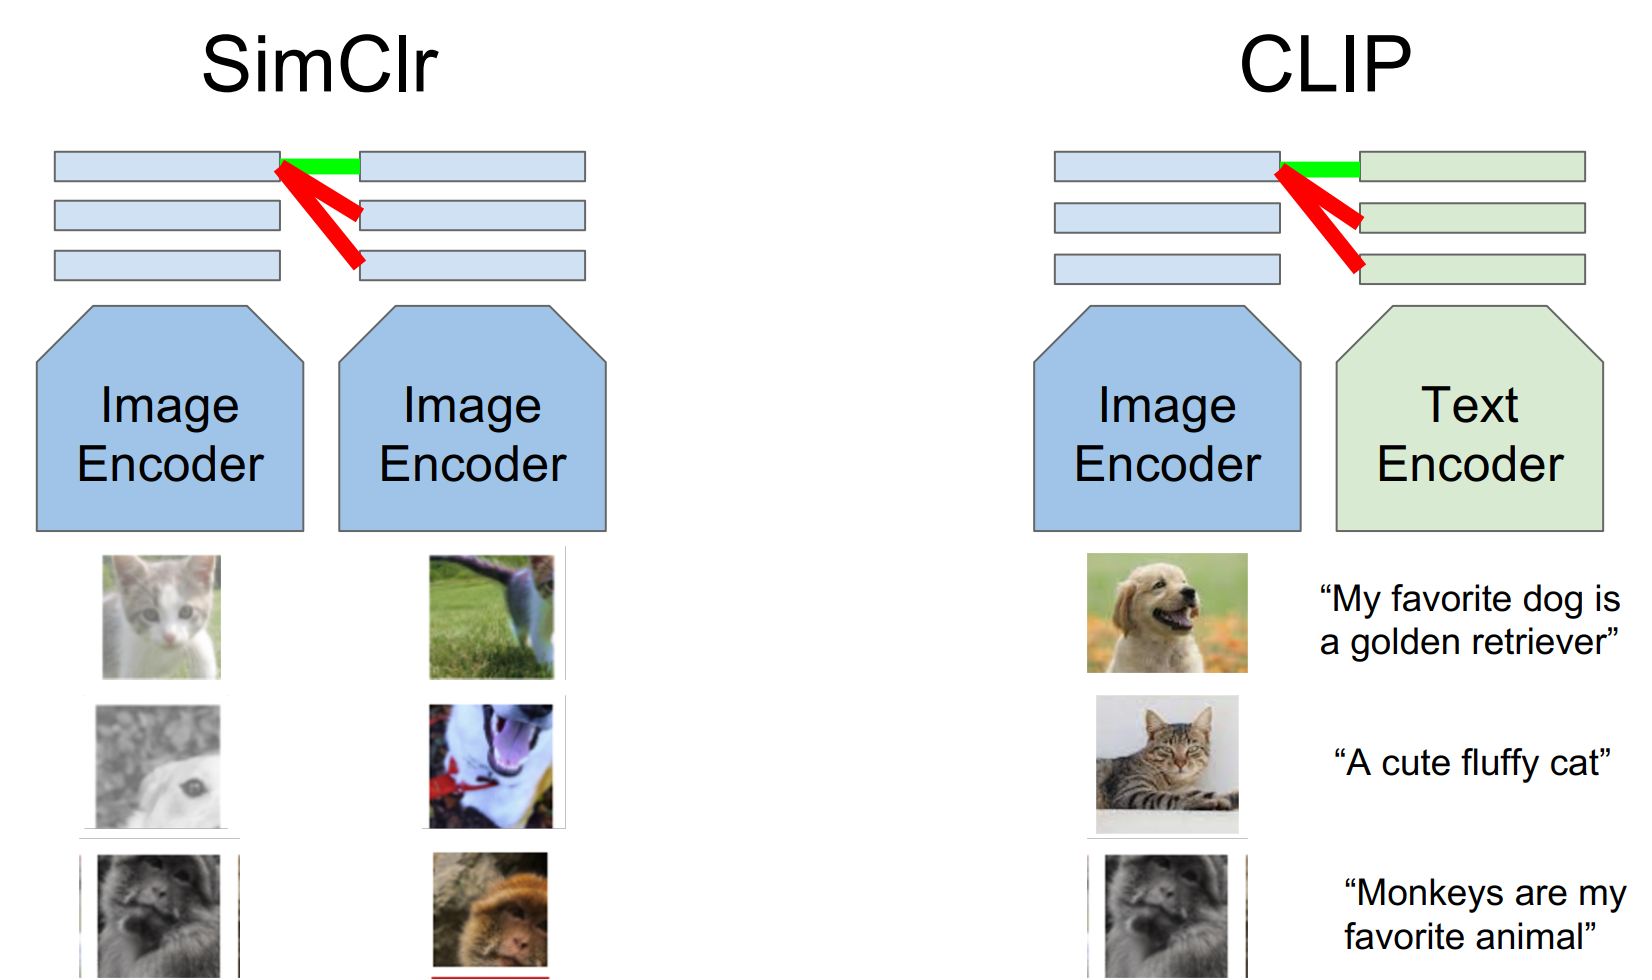
CLIP 把这个目标从“图像-图像”扩展为“图像-文本”。它包含两个编码器:
- 图像编码器(image encoder):把图像编码成向量。
- 文本编码器(text encoder):把 caption、短语、类别 prompt 编码成向量。
训练时,一个 batch 里有多个图像-文本配对。正确配对的图像向量和文本向量被拉近,错误配对被推远。训练完成后,模型可以给任意图像和任意文本短语一个匹配分数,通常用向量点积或 cosine similarity 表示。
设一个 batch 中有 \(n\) 个正确配对的图文样本,第 \(i\) 张图像经过 image encoder 得到向量 \(u_i\),对应文本经过 text encoder 得到向量 \(v_i\)。两者的匹配分数用内积表示为 \(\langle u_i, v_i \rangle\)。CLIP 的训练目标可以写成双向 softmax contrastive loss。第一项:
\[ \mathcal{L}_{\text{image}\rightarrow\text{text}} = \sum_{i=1}^{n} -\log \frac{\exp(\langle u_i, v_i\rangle)} {\sum_{j=1}^{n}\exp(\langle u_i, v_j\rangle)} \]
这一项固定图像 \(u_i\),在 batch 中所有文本 \(\{v_j\}_{j=1}^{n}\) 里选择正确 caption \(v_i\)。分子是正确图文对的相似度,分母把同一 batch 里的其他文本都当作负例,因此优化会让 \(\langle u_i, v_i\rangle\) 相对其他 \(\langle u_i, v_j\rangle\) 更大。
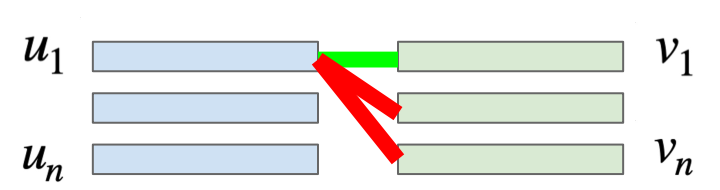
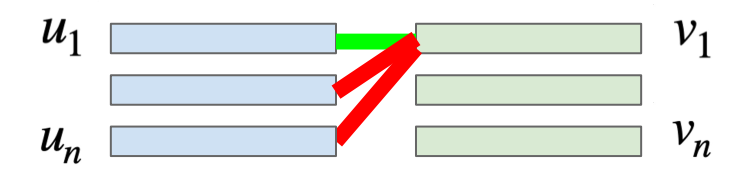
正方向与反方向
然后把反方向也加进来: \[ \mathcal{L}_{\text{text}\rightarrow\text{image}} = \sum_{i=1}^{n} -\log \frac{\exp(\langle u_i, v_i\rangle)} {\sum_{j=1}^{n}\exp(\langle u_j, v_i\rangle)} \]
这一项固定文本 \(v_i\),在 batch 中所有图像 \(\{u_j\}_{j=1}^{n}\) 里选择正确图像 \(u_i\)。最终损失函数就是两项相加或取平均:
\[ \mathcal{L}_{\text{CLIP}} = \mathcal{L}_{\text{image}\rightarrow\text{text}} + \mathcal{L}_{\text{text}\rightarrow\text{image}} \]
因此,CLIP 不只是让正确图文对接近,还同时训练两个检索方向:给图像找正确文本、给文本找正确图像。这个双向目标使图像 embedding 和文本 embedding 落在同一个语义空间里,为后面的 zero-shot 分类和图文检索打基础。
3.2 训练数据、相似度输出与 linear probe 迁移
CLIP 能够规模化训练,一个重要原因是互联网天然包含大量图像-文本配对。很多网页、百科、新闻和图片站点会给图片配标题、说明文字或 alt-text。例如网页中的 Mount Rainier 图片可能带有描述性文本,这类图文共现数据不需要人工为固定类别打标签,却能提供丰富的自然语言监督。CLIP 的训练数据就是从互联网大规模抓取图像及其相关文本得到的。
训练结束后,CLIP 得到的不是一个传统的固定类别分类头,而是一个可以计算图像和文本相似度的模型。给定任意图像 \(x\) 和任意文本 \(t\),image encoder 输出 \(u=f_{\theta}(x)\),text encoder 输出 \(v=g_{\phi}(t)\),二者的匹配程度可以用 \(\langle u, v\rangle\) 或归一化后的 cosine similarity 表示。这个相似度就是后面做图文检索、zero-shot 分类和 prompt matching 的基础。
从迁移学习角度看,CLIP 也可以按传统自监督预训练流程使用:
- 预训练(pre-training):先在不需要人工类别标签的 pretext task 上训练网络,这里的 pretext task 就是图文对比学习。
- 迁移到下游任务(transfer):把预训练好的 image encoder 迁移到 image classification、object detection、semantic segmentation 等任务。
- 线性探针(linear probe)评估:冻结预训练 encoder,只在其特征上训练一个很小的线性分类器,用来测试这些特征是否已经包含可分的语义信息。
linear probe 的意义是把“表征质量”和“大规模微调能力”分开。如果冻结 CLIP image encoder 后,一个简单线性分类器就能在多个数据集上表现不错,说明 CLIP 的视觉特征本身已经具有较强通用性。
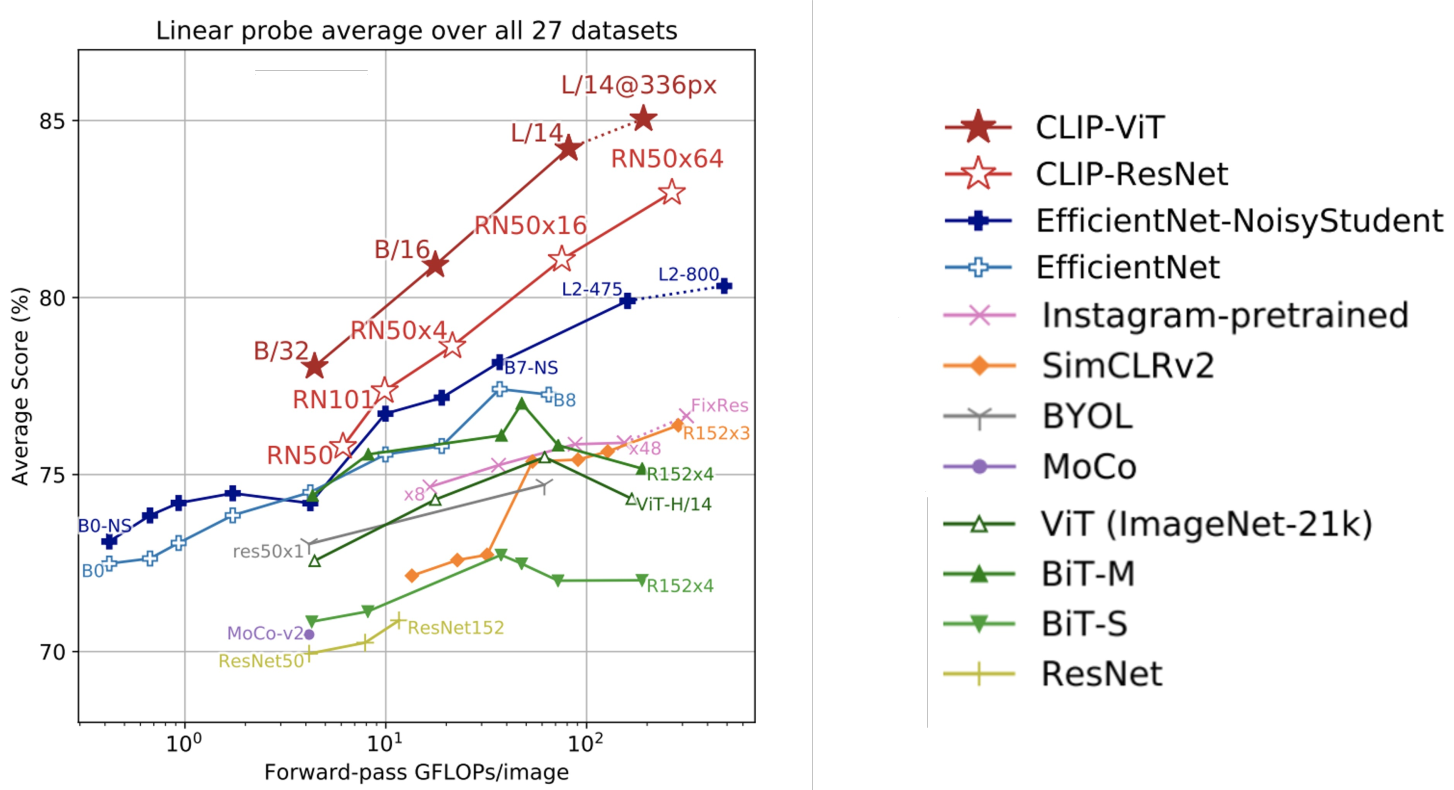
不过,linear probe 仍然需要下游数据集的标注来训练分类器,因此它和后面要讲的 zero-shot 用法不同。zero-shot 分类不训练新的分类头,而是直接用文本 encoder 生成类别向量;linear probe 则是把 CLIP 当作特征提取器,再用少量监督训练一个线性层。
3.3 CLIP 为什么能做 zero-shot 分类
CLIP 最巧妙的用法是:用文本编码器临时构造分类器。假设分类任务有三类:plane、dog、bird。传统分类器需要训练一个最后的线性分类头;CLIP 则可以把每个类别写成文本 prompt,例如:
A photo of a planeA photo of a dogA photo of a bird
然后用文本编码器得到每个类别的向量。对一张新图像,用图像编码器得到图像向量,再计算它和所有类别文本向量的相似度,取相似度最高的类别作为预测结果。
这可以理解为一个特殊的 1-nearest-neighbor 分类器:训练样本不是人工标注图像,而是由类别名称或 prompt 生成的文本向量。因为类别可以用自然语言任意写出,所以 CLIP 具有 开放词表(open-vocabulary) 能力。
3.4 Prompt engineering 与 prompt ensembling
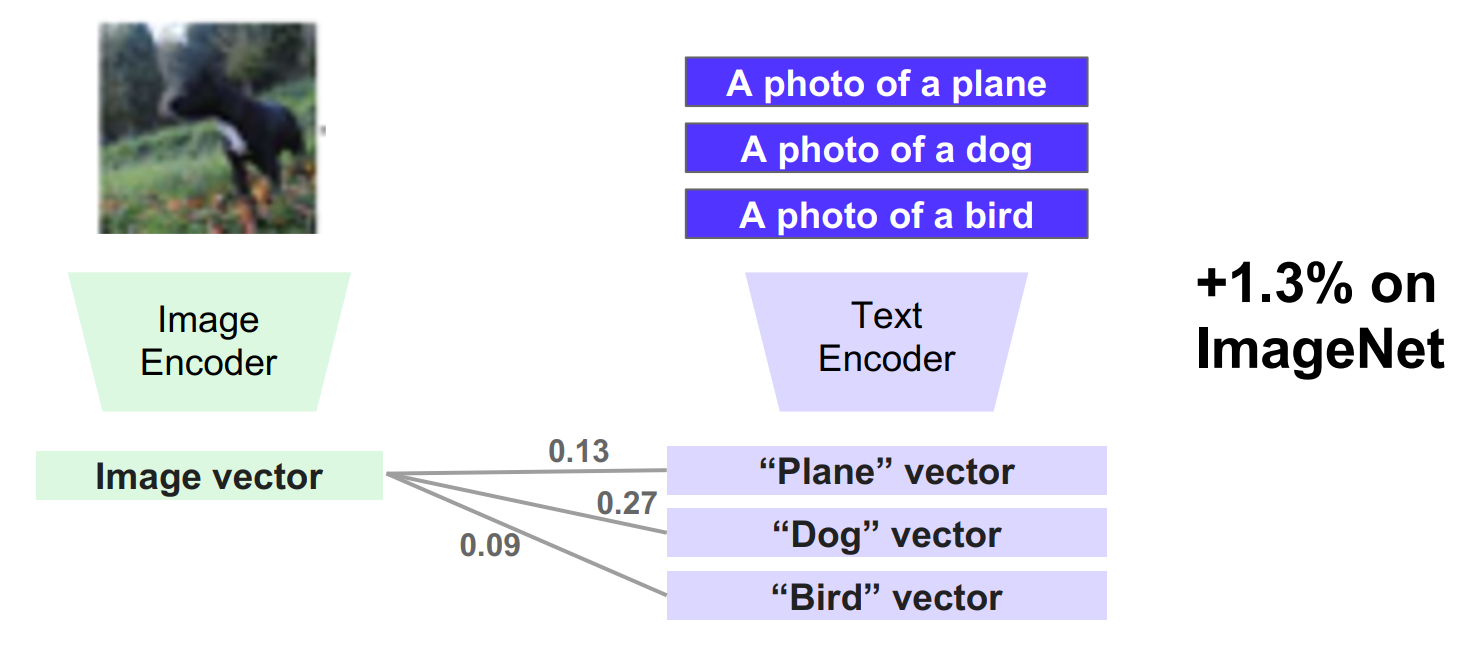
直接使用类别词通常不如使用短语,因为 CLIP 训练时见到的是自然语言
caption,而不是孤立标签。比如 dog 可以换成
A photo of a dog,这在 ImageNet 上能带来提升。
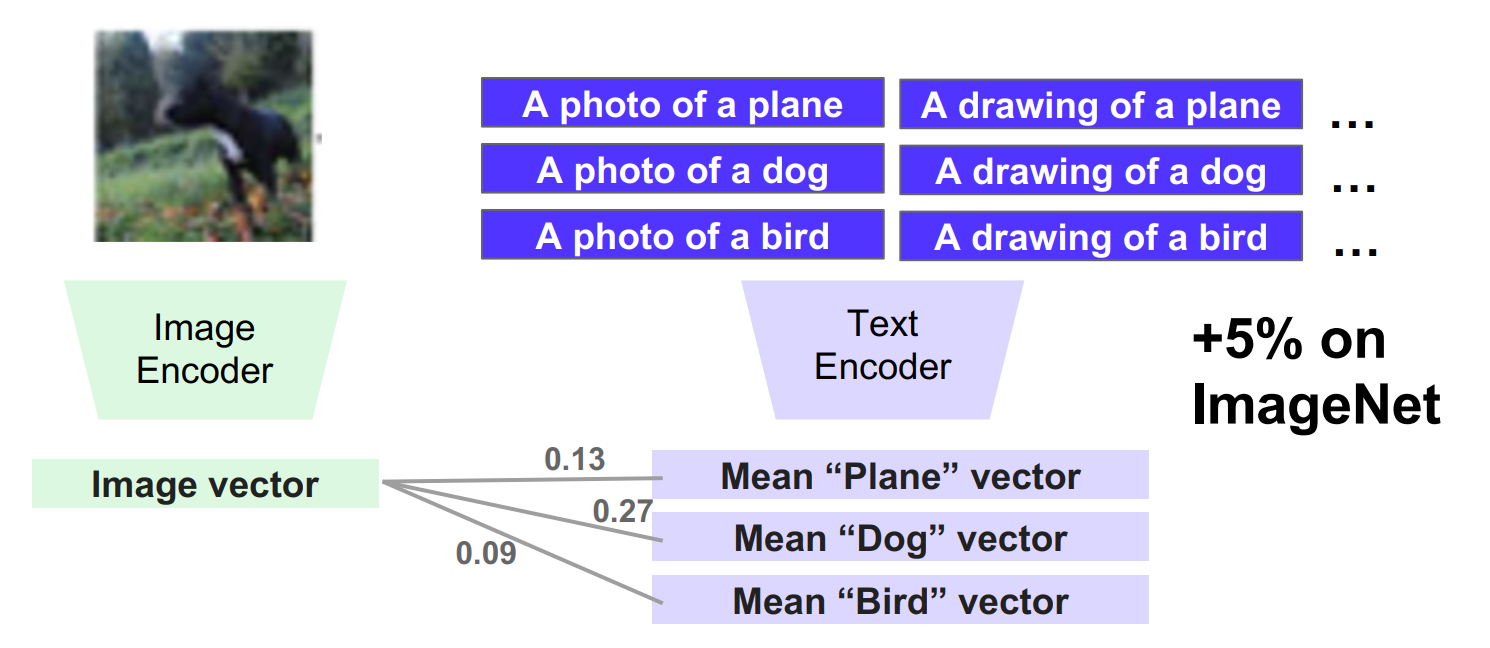
单个 prompt 也可能有偏差。更稳健的方法是为同一类别构造多个 prompt,例如:
A photo of a dogA drawing of a dogA blurry photo of a dogA close-up photo of a dog
对同一类别的多个文本向量取平均,得到类别原型向量。这样可以减少某个 prompt 表述方式带来的偶然偏差。多 prompt 平均可以进一步提升 ImageNet zero-shot 表现。
zero-shot 是指模型在没有见过某个下游任务的训练样本、也没有为这个任务重新训练参数的情况下,直接完成这个任务。
3.5 CLIP 的规模效应
CLIP 在 zero-shot ImageNet 上接近有监督 ResNet-101 的表现,但它没有使用 ImageNet 人工标签。它能做到这一点,很大程度来自两个规模因素:
| 对比项 | 传统 ImageNet ResNet | CLIP |
|---|---|---|
| 模型规模 | ResNet-101 约 4450 万参数 | Transformer-based CLIP 约 3.07 亿参数 |
| 数据规模 | ImageNet 约 128 万张人工标注图像 | 约 4 亿图文对 |
| 监督信号 | 固定类别标签 | 自然语言 alt-text / caption |
| 迁移方式 | 线性 probe 或微调 | zero-shot、linear probe、检索 |
这里的重要结论是:自然语言监督 + 大规模互联网图文对,使模型获得了比固定类别标签更广泛的语义覆盖。这也是 CLIP 在 ObjectNet、sketch、graphic image、adversarial dataset 等分布偏移数据上表现好的原因之一。
4 CoCa:在对比学习上加入生成式 caption objective
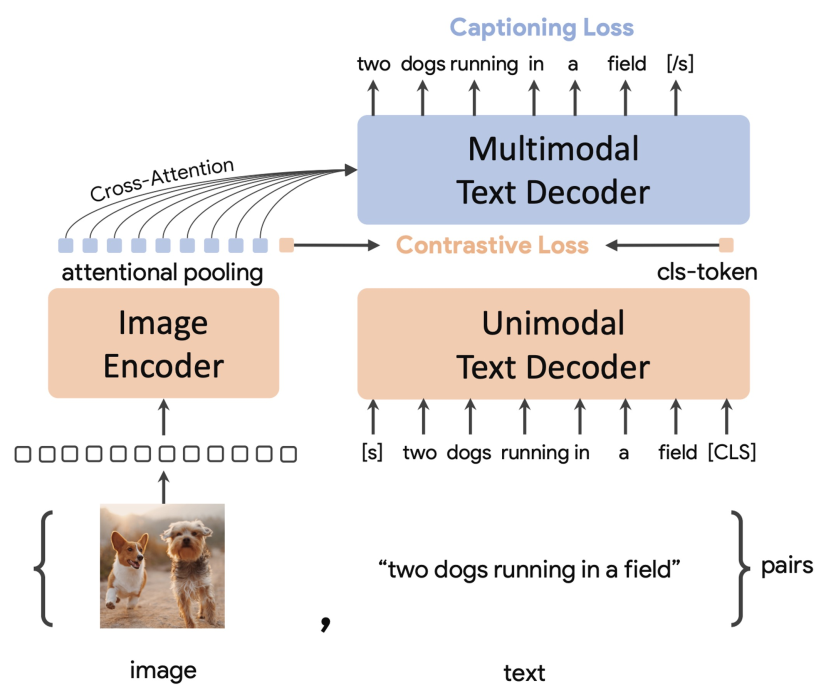
CLIP 的目标主要是判断图像和文本是否匹配。CoCa(Contrastive Captioner)在这个基础上加入了一个生成式目标:它保留图像编码器和文本编码器的对比学习,同时增加一个 decoder,让模型根据图像特征生成 caption。
这样做的动机是:判断“这是猫还是狗”只需要较粗的语义信息,而生成一段准确描述需要理解更多细节,例如对象、属性、关系、动作和场景。captioning loss 迫使模型学习更丰富的视觉语义。
CoCa 的结构可以理解为三个主要模块:image encoder、unimodal text decoder 和 multimodal text decoder。前两个模块产生用于 contrastive loss 的全局图像/文本表征,最后一个模块通过 cross-attention 读取图像特征并做 caption generation。
4.1 Image Encoder
Image encoder 负责把输入图像变成视觉特征。可以把它理解成类似 ViT 的结构:图像先被切成 patches,每个 patch 被映射成一个 token,然后经过 Transformer 层进行 self-attention。若图像大小是 \(H\times W\),patch size 是 \(P\times P\),patch token 数大约是:
\[ N=\frac{H}{P}\times\frac{W}{P} \]
例如 \(224\times224\) 图像配 \(16\times16\) patch,会得到 \(14\times14=196\) 个 patch
tokens。实际实现还可能额外加入 [CLS] token、pooling token
或使用 attention pooling,所以最终序列长度不一定严格等于 patch 数。
CoCa 需要 image encoder 提供两类信息:
| 输出 | 用途 |
|---|---|
| 全局 image embedding | 和全局 text embedding 做 contrastive loss,用于图文匹配、检索、zero-shot 分类 |
| 图像 token 序列 | 给 multimodal text decoder 做 cross-attention,用于生成 caption |
全局 image embedding 可以理解为整张图的语义摘要;图像 token 序列则保留更多空间和局部细节。经过 Transformer self-attention 后,每个 patch token 已经带有一定全局上下文,但它仍然对应图像中的某个区域,因此适合被 caption decoder 查询。
4.2 Unimodal Text Decoder
Unimodal text decoder 只处理文本,不看图像。它的作用是产生一个全局 text embedding,用来和 image encoder 输出的全局 image embedding 做 contrastive loss。
这里容易混淆:它功能上确实像“text encoder”,因为它要把文本变成向量;但 CoCa 论文把它叫 text decoder,原因是整个文本路径采用 decoder-style Transformer。也就是说,文本模块是为了后面的自回归 caption generation 设计的,前半段先不接图像 cross-attention,只用文本 token 自身建模。
可以把这一段理解为:
1 | caption text |
它输出的 text embedding 与 image embedding 对齐,目标和 CLIP 类似:正确图文对相似度高,不匹配图文对相似度低。这样 CoCa 保留了 CLIP-style 图文检索和 zero-shot 分类能力。
4.3 Multimodal Text Decoder
Multimodal text decoder 在 unimodal text decoder 后面继续处理文本,但它会通过 cross-attention 读取 image encoder 输出的图像 token。它负责 caption generation,也就是根据图像和已经生成的前文预测下一个 token:
\[ p(y_t \mid y_{<t}, image) \]
这一部分和普通语言模型生成文本类似,需要 causal mask,预测第 \(t\) 个词时只能看 \(y_{<t}\),不能看未来 token。区别在于,它除了看前文,还能通过 cross-attention 查询图像 token,从而决定当前要描述哪个对象、属性、动作或关系。
整体流程可以写成:
1 | image tokens from image encoder |
因此,CoCa 的两个训练目标对应两个层次:
| 训练目标 | 使用模块 | 学到的能力 |
|---|---|---|
| Contrastive loss | image encoder + unimodal text decoder | 图文全局对齐,适合检索和分类 |
| Captioning loss | image encoder + multimodal text decoder | 生成细节描述,学习对象、属性、关系和局部视觉信息 |
这也是 CoCa 相比 CLIP 的核心变化:它不只要求模型判断“图像和文本是否匹配”,还要求模型能“根据图像生成文本”。生成任务提供了更密集的训练信号,所以 captioning loss 可以推动视觉表征学习到更丰富的语义细节。
CoCa 相比 CLIP 在多种 ImageNet 变体上有显著提升,并推动视觉编码器从纯监督分类训练转向大规模图文预训练。这个转折点很重要:后来的很多视觉 backbone 不再主要依赖固定标签监督,而依赖互联网图文数据或其他自监督/弱监督目标。
5 CLIP-style 模型的优势、局限与数据问题
5.1 优势
CLIP-style 模型的第一个优势是效率。图像和文本都被编码成向量后,分类或检索只需要向量点积。大规模检索中,可以预先把数十亿图像编码好,再用文本 query 做近邻搜索。
第二个优势是开放词表。类别不再局限于训练时的固定 label set,而可以由文本 prompt 动态定义。对于新数据集,只要能写出类别描述,就有机会直接使用 zero-shot。
第三个优势是容易和其他模型组合。例如 CuPL 会用语言模型为少见类别生成详细描述,再把这些描述交给 CLIP 做分类。这种组合把语言模型的世界知识和 CLIP 的图文匹配能力接了起来。
5.2 局限一:组合性不足
CLIP 经常难以区分细粒度组合关系。典型例子是:
there is a mug in some grassthere is some grass in a mug
这两个句子包含相同对象词,但空间关系不同。CLIP 可能把它们映射到很接近的位置,因为它更擅长捕捉图像级对象共现,而不一定可靠建模对象间关系。Winoground、CREPE、ARO 等 benchmark 都在测试这类 组合性(compositionality) 问题。
问题根源之一是对比学习依赖 batch 内的负样本。如果 batch 里只有“猫”和“卡车”这样的简单负样本,模型只需要学到粗粒度语义就能完成任务。更大的 batch 更可能包含细粒度的相似负样本,例如不同犬种,从而迫使模型学习更细概念。但即使 batch size 达到 32000,也很难保证出现“mug in grass”和“grass in mug”这种需要理解关系才能区分的较难的负样本(hard negative)。
5.3 局限二:hard negative 不是万能解
一种自然想法是手工构造 hard negatives,例如
horse eating grass 和
grass eating horse,强迫模型关注词序和关系。但 hard
negative fine-tuning 也会带来问题:有些看似 negative 的样本其实是
hard positives,例如 “a black cat and a brown dog” 与
“a brown dog and a black cat”
在某些图像中可能都成立。过强地把它们推开,可能破坏模型已有的语义泛化能力。
因此,CLIP 的改进不是简单把 batch 做得更大或 hard negative 做得更多,而是需要更好的数据构造、训练目标和 grounding 信号。
5.4 局限三:图像级 caption 监督太粗
图像级 caption 通常只描述整张图的主要内容。例如一张客厅图像的 caption
写着
living room,并不会告诉模型沙发在哪里、植物在哪里、窗户在哪里。对于需要定位、计数、分割、空间关系推理的任务,图像级文本监督缺少局部
grounding。
一个方向是加入 region captions 和 bounding box 坐标,使模型知道文本短语对应图像的哪个区域。另一个方向是让模型输出点、mask 或其他空间结构,让推理过程直接落到像素上。
5.5 局限四:再大的互联网数据也不等于完整知识
即使收集 50 亿图像,也不可能覆盖所有类别、关系、文化场景、细粒度物种、专业领域和罕见概念。更重要的是,互联网图文对是 incidental data:它们是顺手上传、随意写 caption 或 alt-text 得来的,不一定包含任务所需的精确信息。
所以本讲反复出现的主题是:数据规模重要,但数据意图和质量同样重要。foundation model 的前沿不仅是模型结构,也包括数据过滤、数据设计、人工标注和 evaluation。
6 视觉语言模型:从 LLaVA 到 Flamingo
6.1 VLM 的目标
CLIP 输出的是图文相似度,适合分类和检索,但它不会自然生成解释、回答问题或进行多轮推理。视觉语言模型(Vision-Language Models, VLMs)的目标是:让模型接受图像和文本作为输入,并输出文本。
这个目标利用了大语言模型的自回归性质。语言模型已经能通过 next-token prediction 做数学、情感分析、推理、问答等任务;如果能把视觉信息接入语言模型,就可以把大量视觉任务统一成“读图后生成文本”的形式。
6.2 LLaVA:把 CLIP 图像 token 接到 LLM
LLaVA 的核心思想很直接:使用预训练视觉编码器提取图像特征,再通过一个可训练的线性层把图像特征映射到 LLM 的输入 embedding 空间,然后让 LLM 像处理文本 token 一样处理这些视觉 token。
LLaVA 的训练 recipe 可以概括为:
- 初始化一个预训练语言模型作为 LLM decoder,例如 LLaMA。
- 初始化一个预训练图像编码器,例如 CLIP ViT。
- 选择图像特征 token。实践中常使用 CLIP ViT 的倒数第二层 patch tokens,因为它们比最终 CLS token 更保留空间和语言相关信息。
- 训练一个新的 linear layer,把视觉特征投影到 LLM embedding space。
- 使用包含输入图像、输入指令、输出文本的数据微调 LLM 和投影层。
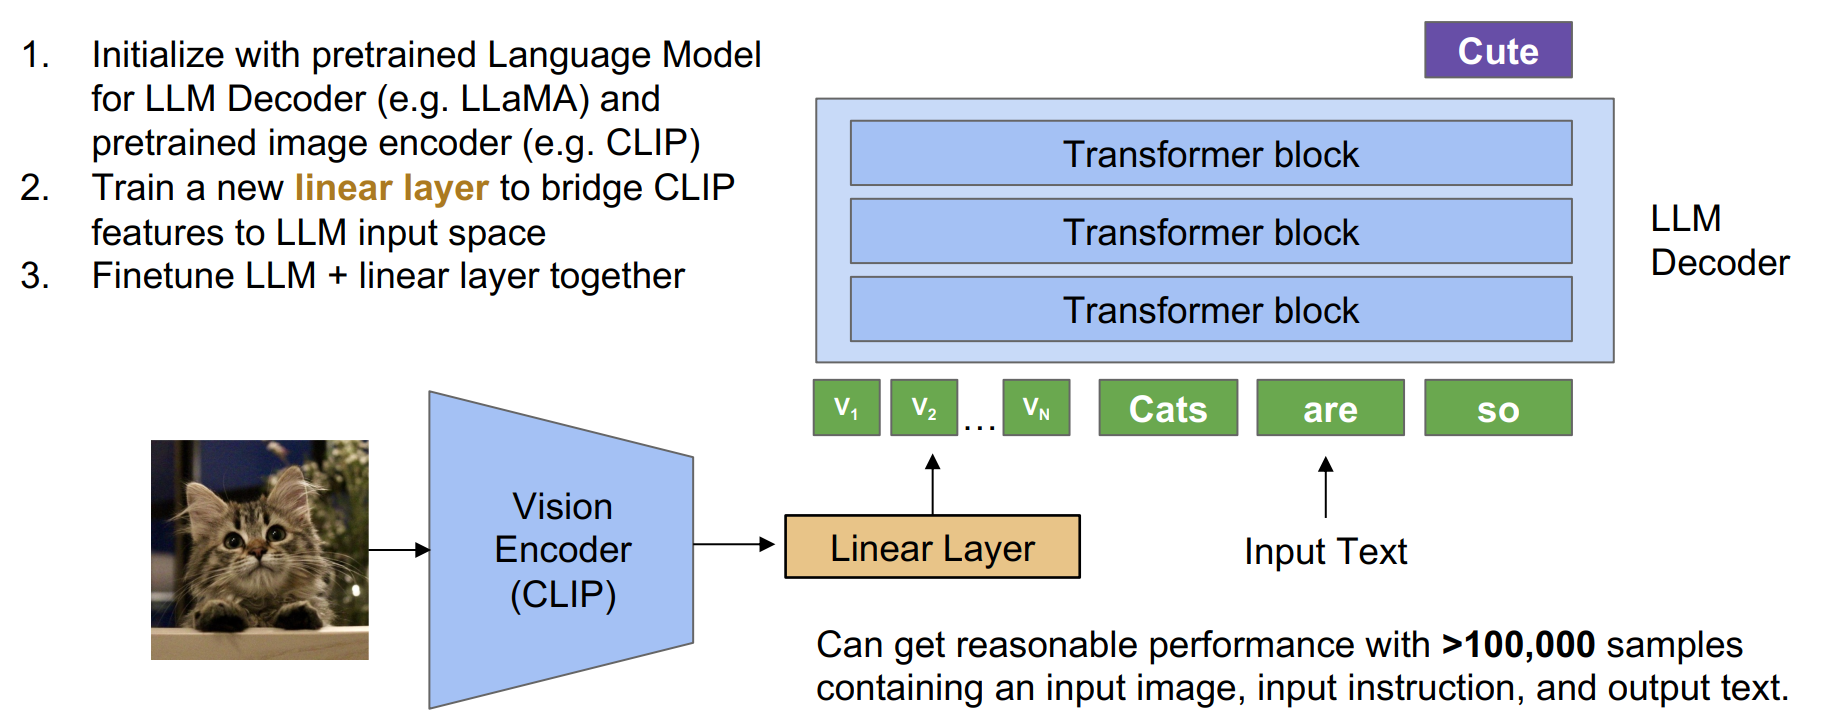
这里的关键点是:CLIP 最终层为了 contrastive objective 服务,很多空间 patch token 未必被直接监督;倒数第二层往往保留更有用的空间细节。对于 VLM,图像不只是一个全局类别向量,而要提供局部对象、位置、文字和关系信息。
6.3 Flamingo:在每层 LLM 中注入视觉信息
Flamingo 延续“视觉编码器 + 大语言模型”的思路,但改变了视觉特征和语言模型的融合方式。LLaVA 更像是把视觉 token 当作输入前缀喂给 LLM;Flamingo 则把视觉特征通过 gated cross-attention 注入到 LLM 的多层处理中。
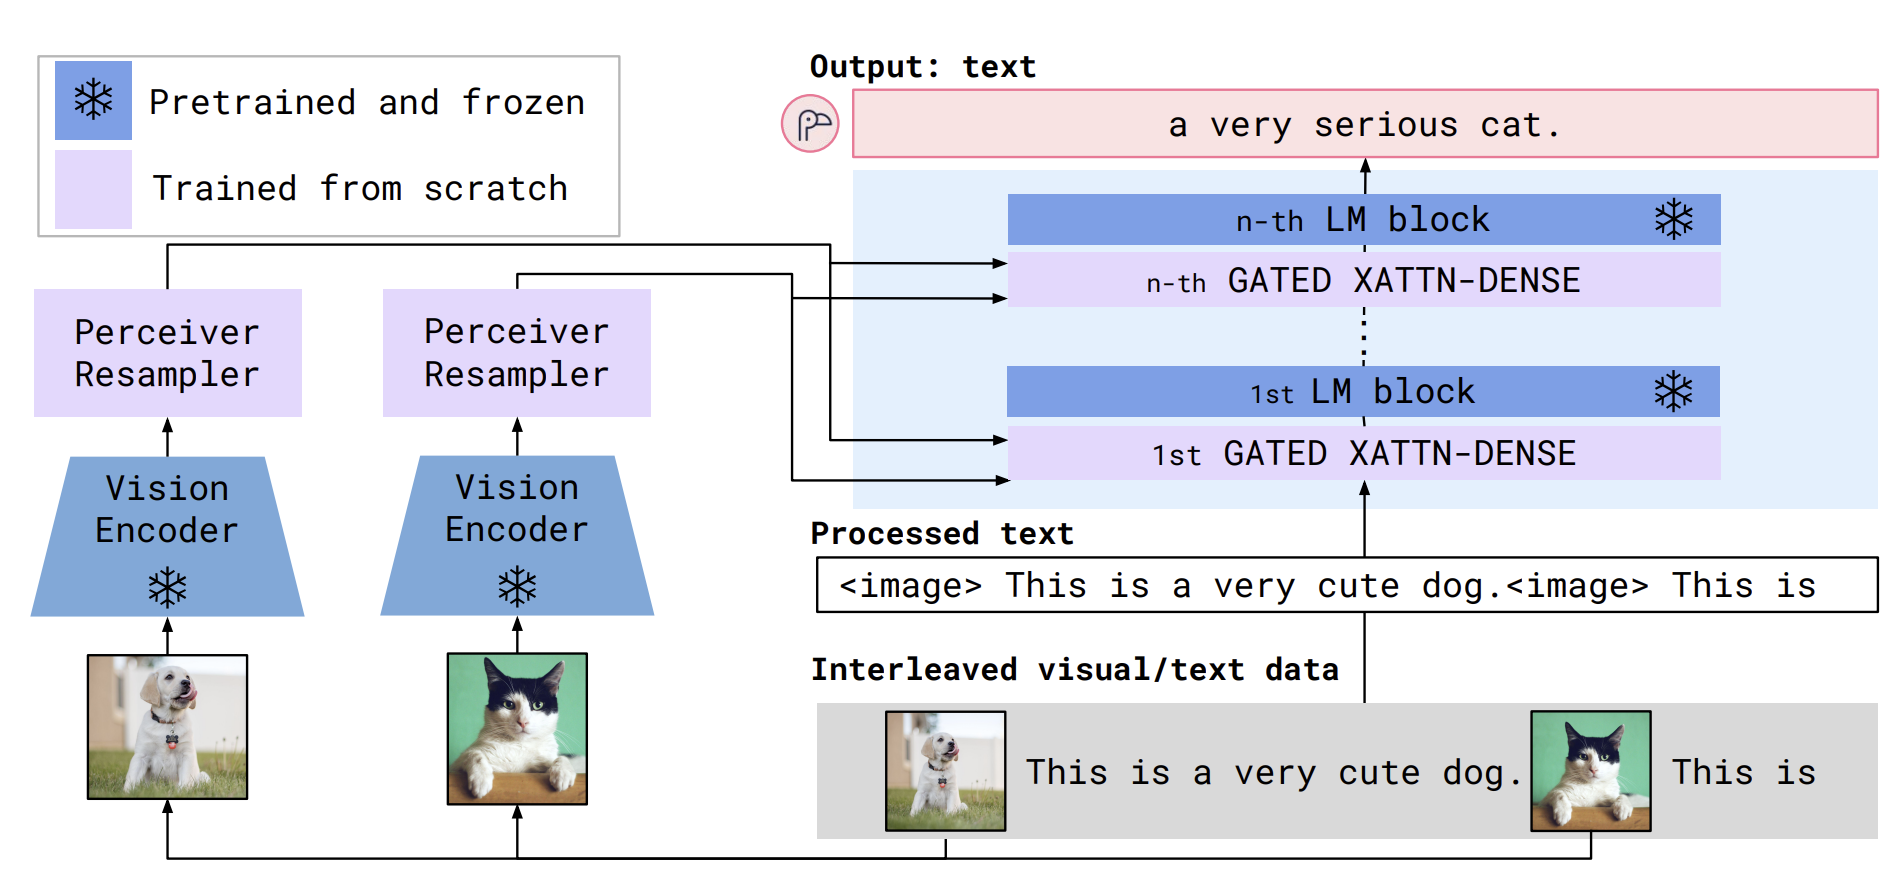
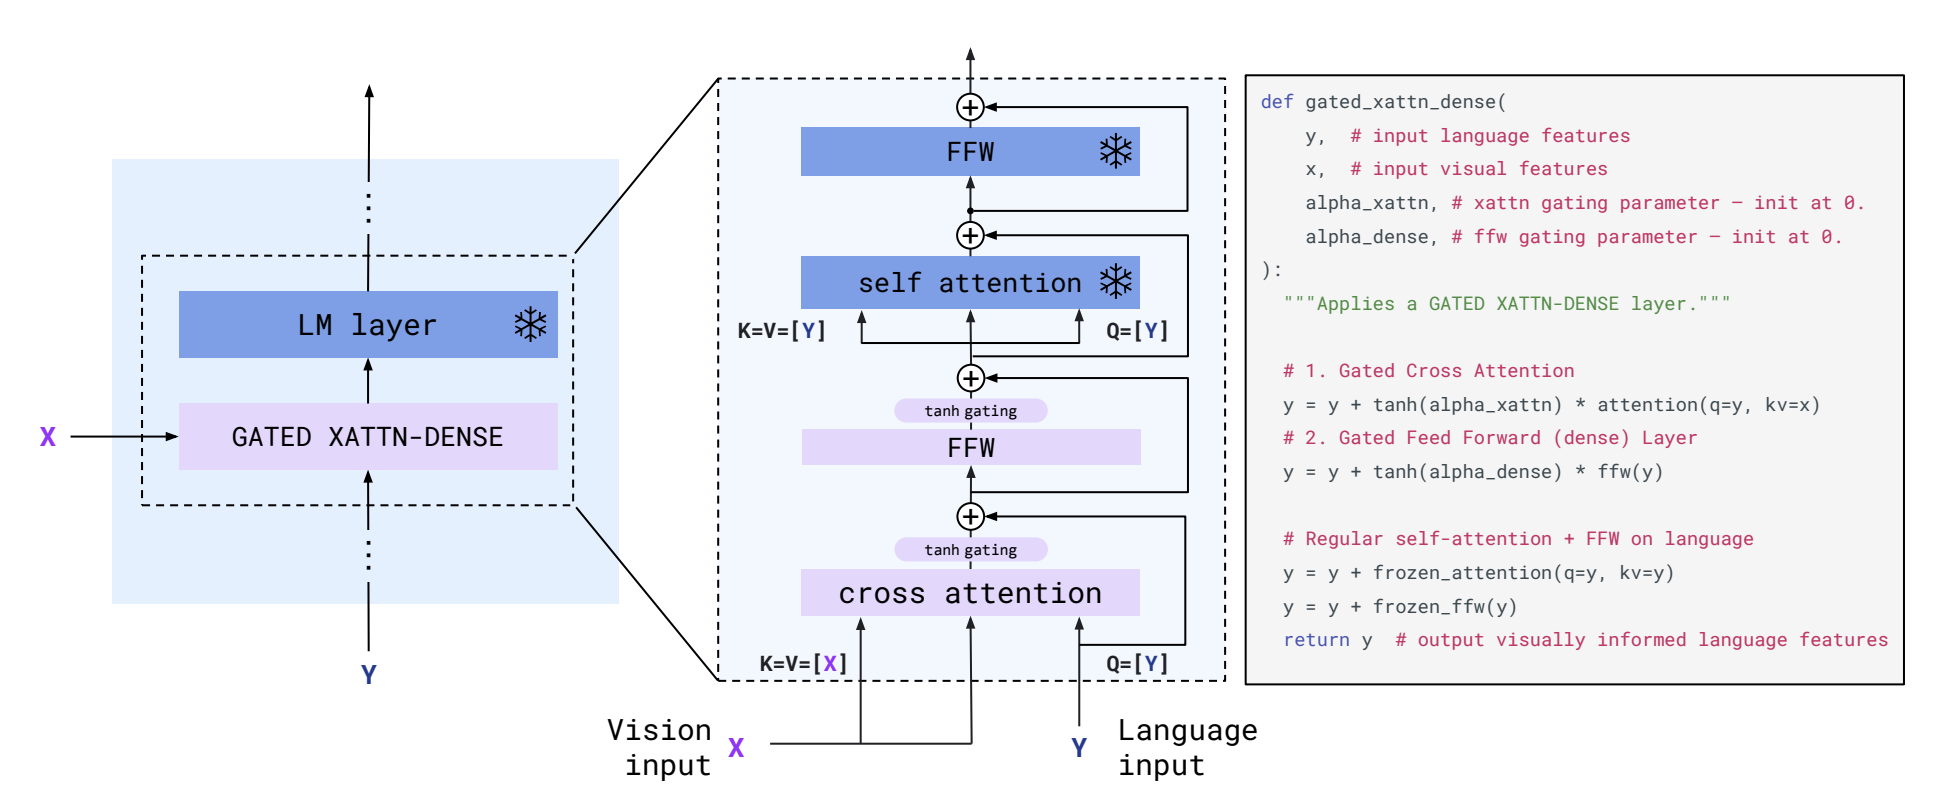
Flamingo 的两个关键可训练组件是:
| 组件 | 作用 |
|---|---|
| Perceiver sampler | 把变长的图像/视频 token 下采样成固定数量、固定维度的视觉 token,便于每层 LLM 使用 |
| Gated cross-attention layer | 插入到 LLM 层附近,让语言 token 在生成过程中按需 attend 到视觉特征 |
Flamingo 的许多预训练组件保持 frozen,包括语言模型和视觉模型。训练主要集中在 perceiver sampler 和 cross-attention 模块。这样做的好处是保留已有大模型能力,同时用相对少的新增参数获得视觉条件生成能力。
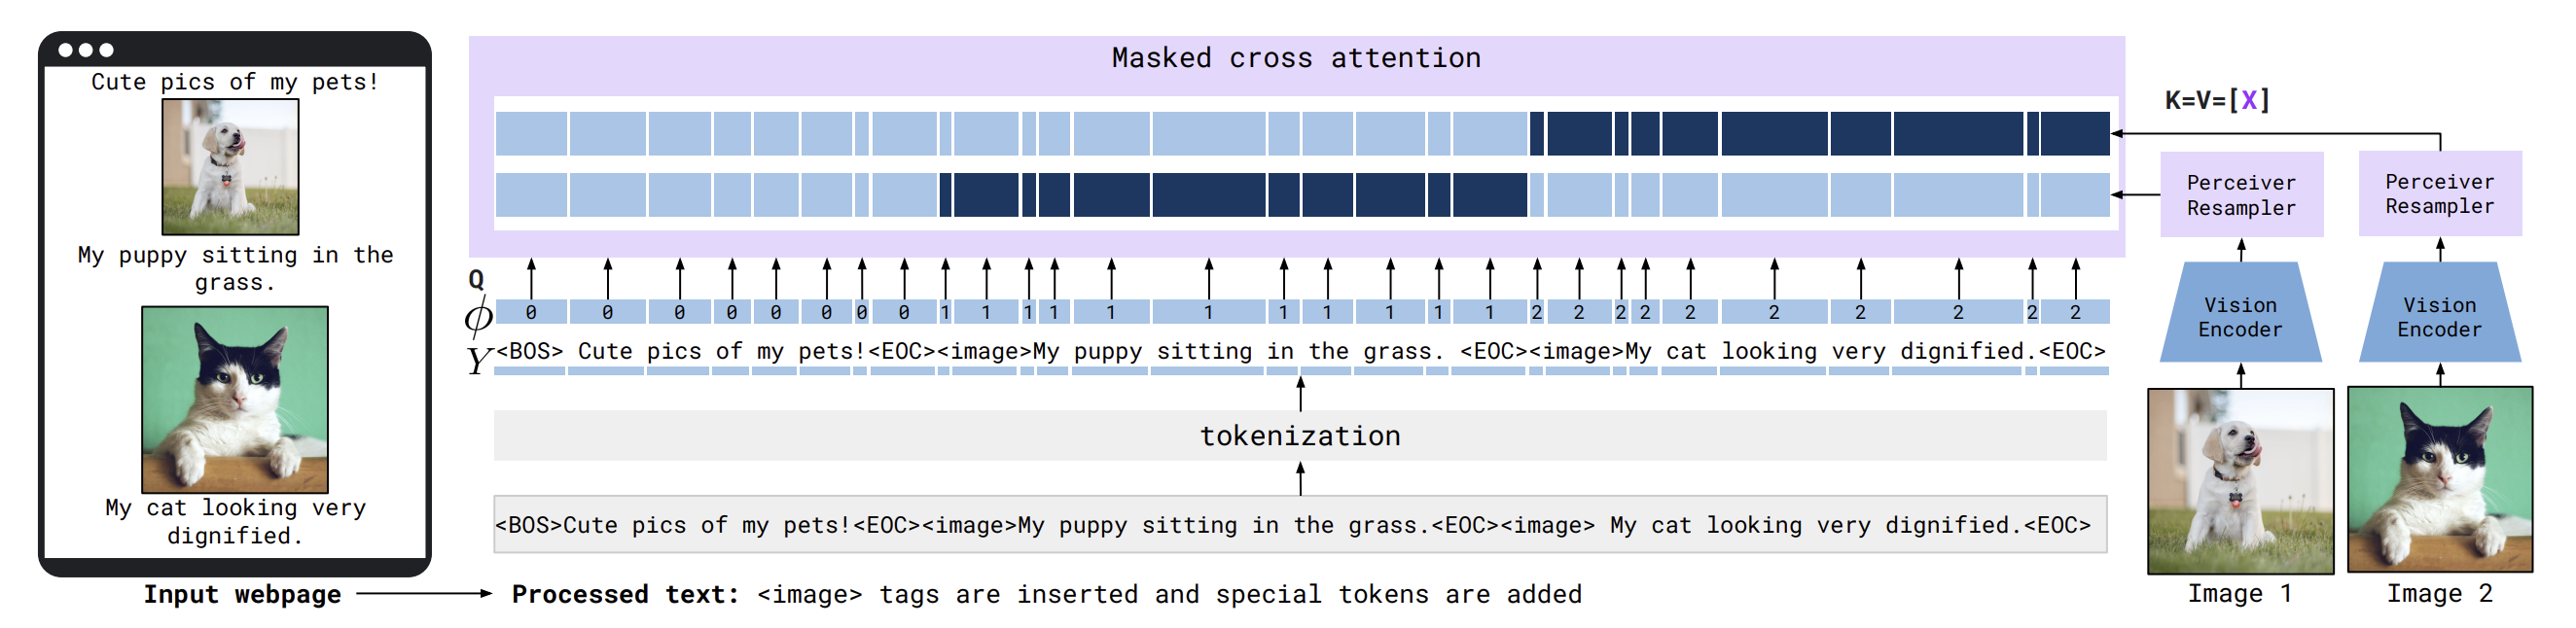
Flamingo 的训练数据也接近语言建模形式:文本序列中用
<image> 标记图像出现的位置,用
<eos>
标记文本结束。模型学习根据前面的图像和文本上下文自动补全后续文本。这使它能够做
few-shot in-context learning,例如给几个图像-caption
示例后,让模型为新图像生成 caption 或回答问题。
6.4 从少数 benchmark 到通用视觉理解评估
Flamingo 之后,视觉语言模型的评估不再只集中在 ImageNet 或少量分类 benchmark。只要一个视觉任务能表述为问答,就可以构造 benchmark:captioning、counting、OCR、图表理解、空间关系、常识推理、文档理解、视频理解等都可以纳入评估。这也推动了 GPT-4V、GPT-4o、Gemini、Claude、Qwen-VL、InternVL 等模型快速发展。
7 开放视觉语言模型与 Molmo:数据质量、开放性和 grounding
7.1 “开源模型”和“可复现模型”的区别
2024-2025 年的视觉语言模型生态可分成几类:
| 类别 | 特征 | 研究价值 |
|---|---|---|
| API-only | 只提供接口,不开放权重、数据、训练代码 | 使用方便,但难以复现和研究 |
| Open weights | 可下载权重 | 能部署和微调,但训练方法未必透明 |
| Distilled models | 由 GPT/Gemini 等强模型蒸馏得到 | 性能可能好,但依赖闭源教师模型 |
| Completely open | 开放权重、数据、代码、评估 | 最有利于研究社区理解和复现 |
许多所谓 open-weight VLM 其实是从 GPT 或 Gemini 蒸馏出来的。它们可以使用,但不能告诉研究社区如何从零构建一个强 VLM,因为关键教师模型仍然闭源。
7.2 Molmo 的开放性和性能
Molmo 的目标是缩小开放研究社区与闭源 API 模型之间的差距。它强调开放权重、开放数据、开放代码和开放评估。课上给出的评估包括一个大规模人类偏好实验:约 870 名标注者、32.5 万 pairwise comparisons。Molmo-72B 在视觉任务偏好评估中接近 GPT-4o,并超过 Gemini 1.5 Pro 和 Claude 3.5;Molmo-7B 也能在单 GPU 场景下表现出很强的视觉能力。
这些数字不只是“模型排名”,它们说明一个研究信号:高质量开放数据和训练流程可以让开放模型接近闭源模型能力。
7.3 Molmo 的关键:让推理 grounded in pixels
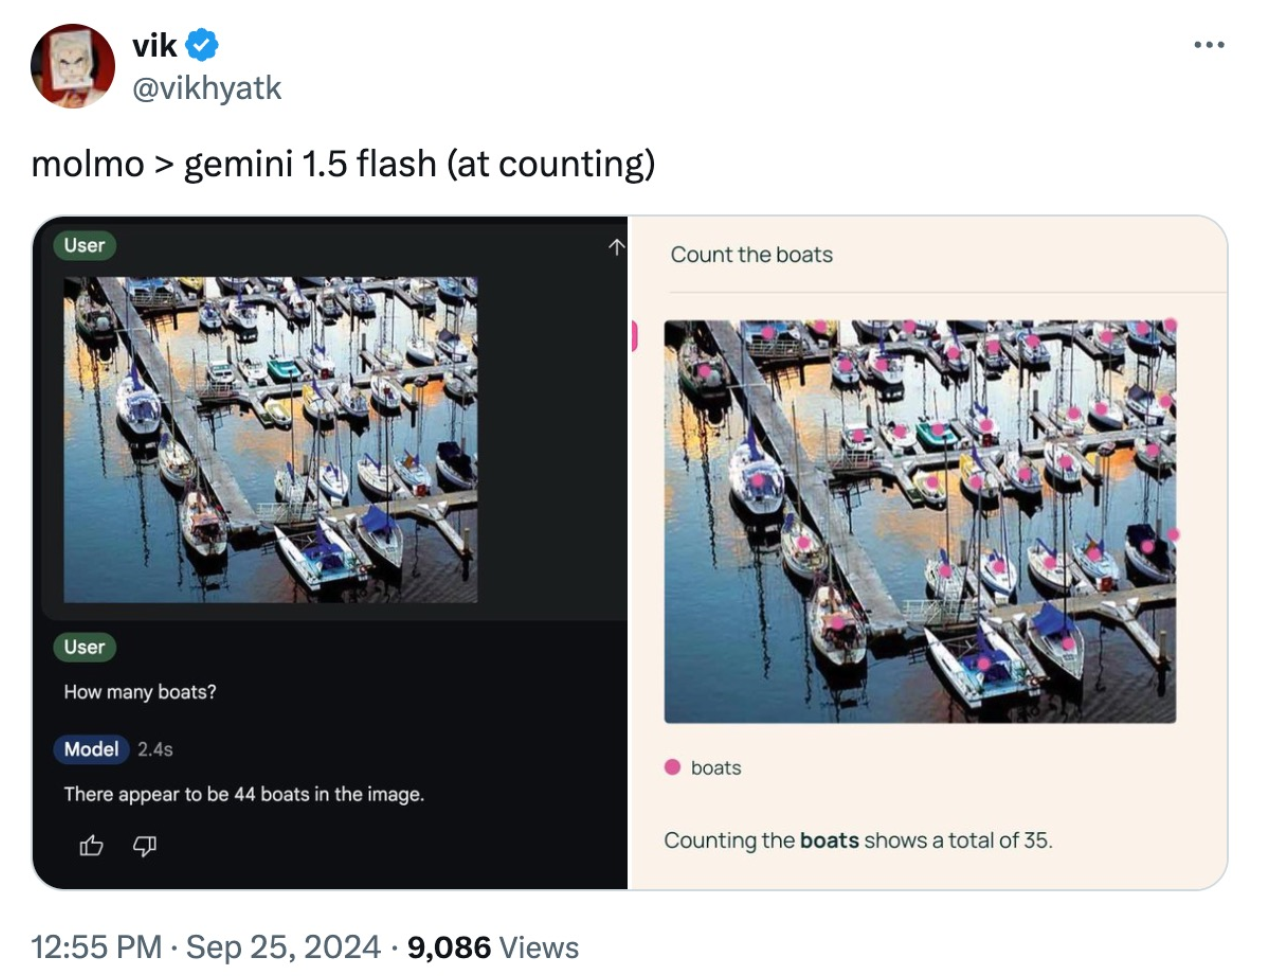
Molmo 的一个重要能力是直接在像素上 grounding。例如当问题是“图中有几艘船”时,模型不仅输出数字,还会指向它数到的每艘船。这样做有两个意义:
- 计数过程有可检查的视觉证据,降低纯文本幻觉。
- 模型学习到“回答之前先定位相关对象”的习惯,更适合机器人、导航、交互式视觉任务。
这也连接到前面 CLIP 的局限:图像级 caption 无法告诉模型对象在哪里,而指向、框、mask 等空间输出可以提供更强的 grounding。
7.4 PixMo:质量优先的数据设计
Molmo 不是靠互联网随便抓取海量图文对来取胜。课上对比了 LLaMA 3.1V 的 60 亿图文对和 Molmo 的 PixMo 70 万图文对,强调 quality over quantity。
互联网数据是 incidental 的:caption 往往像
pink, japan, aesthetic image 或
love this winter picture,它们对视觉细节帮助有限。PixMo
数据更
intentional:标注者会描述对象、数量、位置、文字、背景、风格、颜色和细节。为了降低人工输入成本,标注者可以对图像说
60 到 90 秒,再自动把语音转成文本作为 dense caption。
这种数据设计带来的启发是:多模态模型需要的不只是“更多图片”,而是覆盖任务能力的视觉信息。例如 OCR 需要文字细节,计数需要对象数量,导航需要空间关系,机器人操作需要可作用对象和位置。
8 Segment Anything Model:分割任务中的基础模型
8.1 什么是分割基础模型
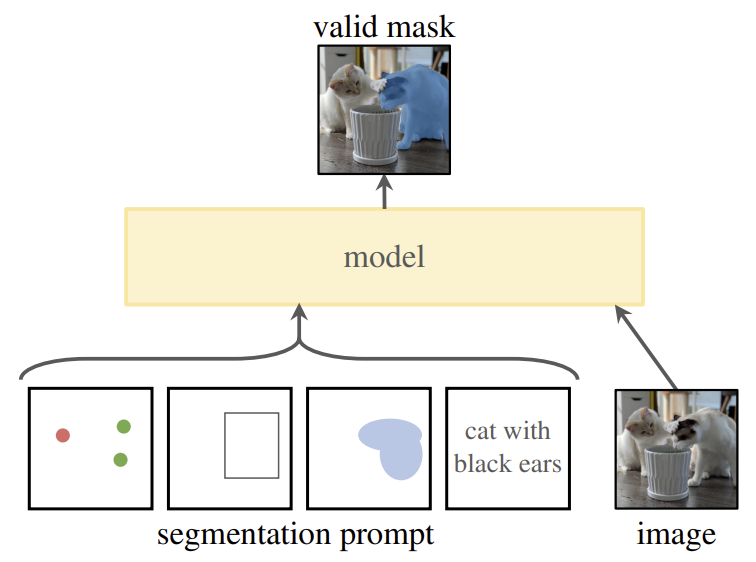
传统分割模型通常在固定类别集合上训练。例如 COCO 有约 80 类,模型输出这些类别的 mask。SAM(Segment Anything Model)的目标更通用:用户可以通过点、框、文本或其他 prompt 指定感兴趣对象,模型输出对应 mask,类别不必固定在训练标签表中。
因此,SAM 试图回答两个问题:
- 如何让模型知道用户想分割什么?
- 如何收集足够广、足够密的 mask 数据,让模型能泛化到大量类别和场景?
8.2 SAM 架构
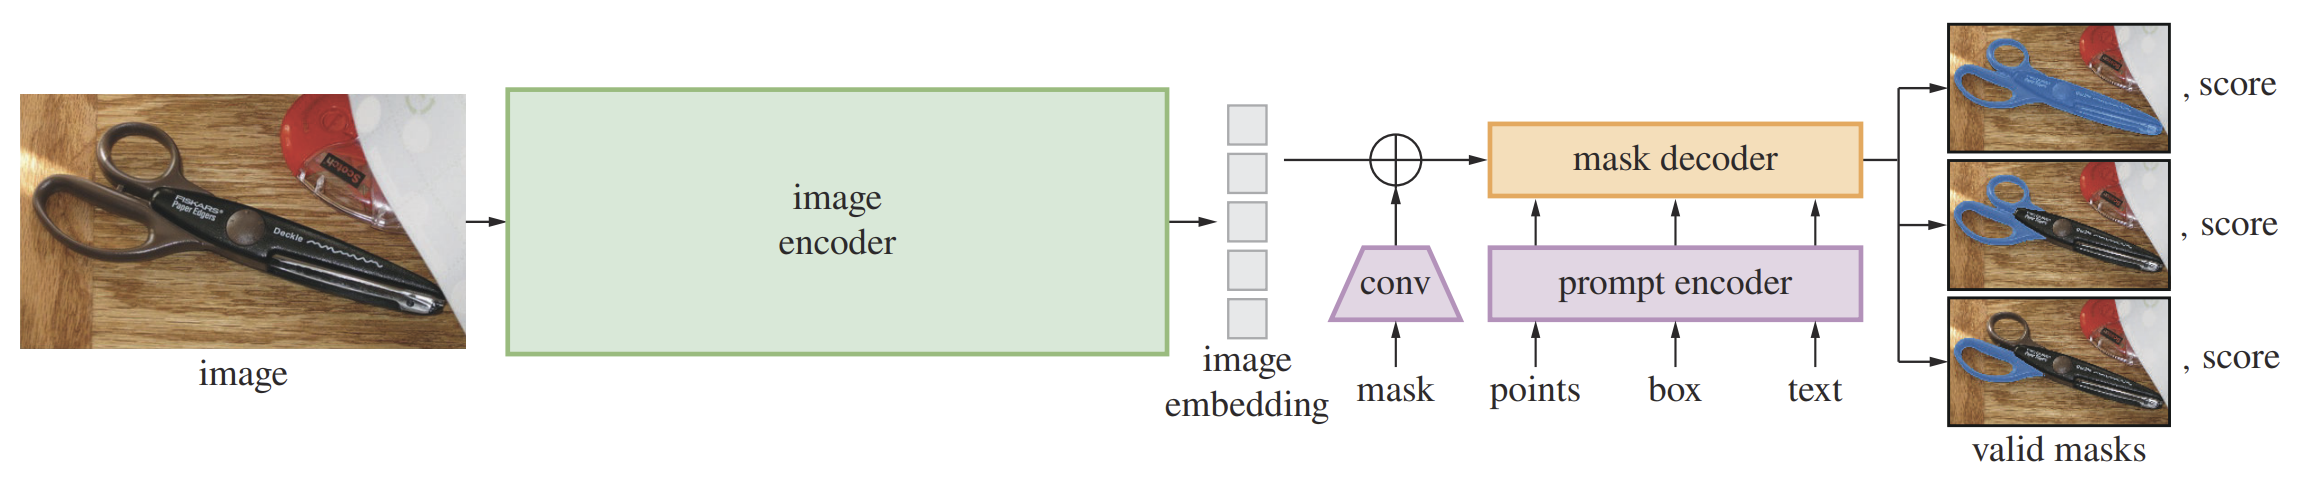
SAM 的基本结构包含三部分:
| 模块 | 输入 | 输出/作用 |
|---|---|---|
| Image encoder | 图像 | 提取图像特征,可离线缓存 |
| Prompt encoder | 点、框、文本、mask 等 prompt | 把用户意图编码为 token |
| Mask decoder | 图像特征 + prompt 特征 | 输出一个或多个 segmentation masks 及置信度 |
这里的 mask prompt 指的是:用户给模型一个已有的粗略分割掩码,让 SAM 基于这个 mask 继续细化、修正或生成更准确的分割结果。
这种设计把“看图”和“响应用户 prompt”分开。图像编码器可以先处理整张图,之后用户每次点选或画框,只需要轻量 decoder 快速生成 mask。
8.3 Prompt ambiguity 与多 mask 输出
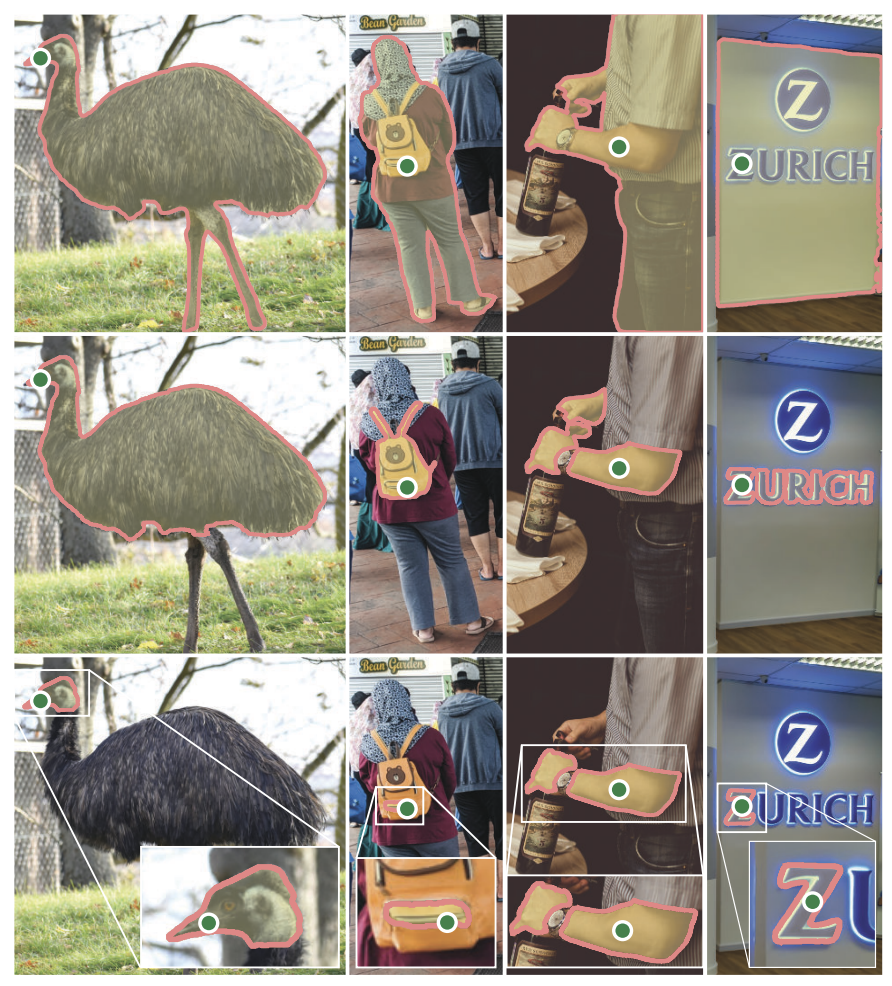
分割 prompt 本身经常有歧义。用户点到剪刀上,一个合理 mask 可以是整把剪刀,也可以是某个手柄,也可以是一个更细的部件。如果模型只输出一个 mask,并且这个 mask 与标注不一致,就会被惩罚;但这个“错误”可能只是歧义造成的。
SAM 的做法是输出多个 mask,代表不同粒度的解释,并为每个 mask 输出 confidence score。训练时只对最接近 ground truth 的 mask 计算 loss。这样模型不会因为其他合理解释被过度惩罚,也能在推理时把选择权留给用户。
8.4 数据飞轮:human-in-the-loop + model-in-the-loop
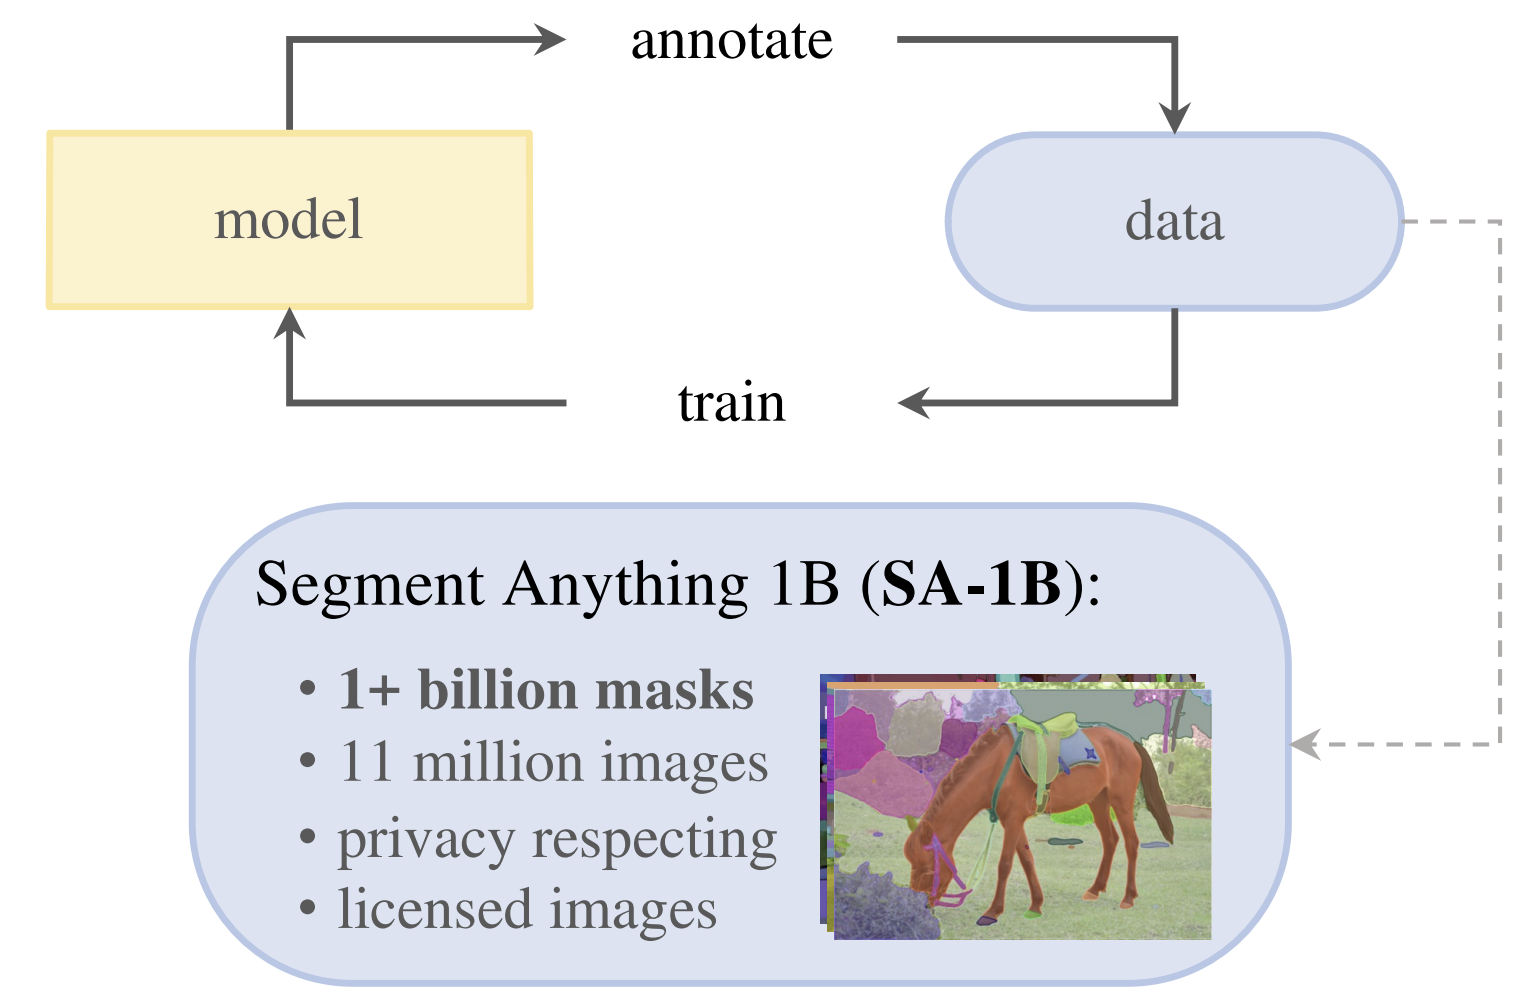
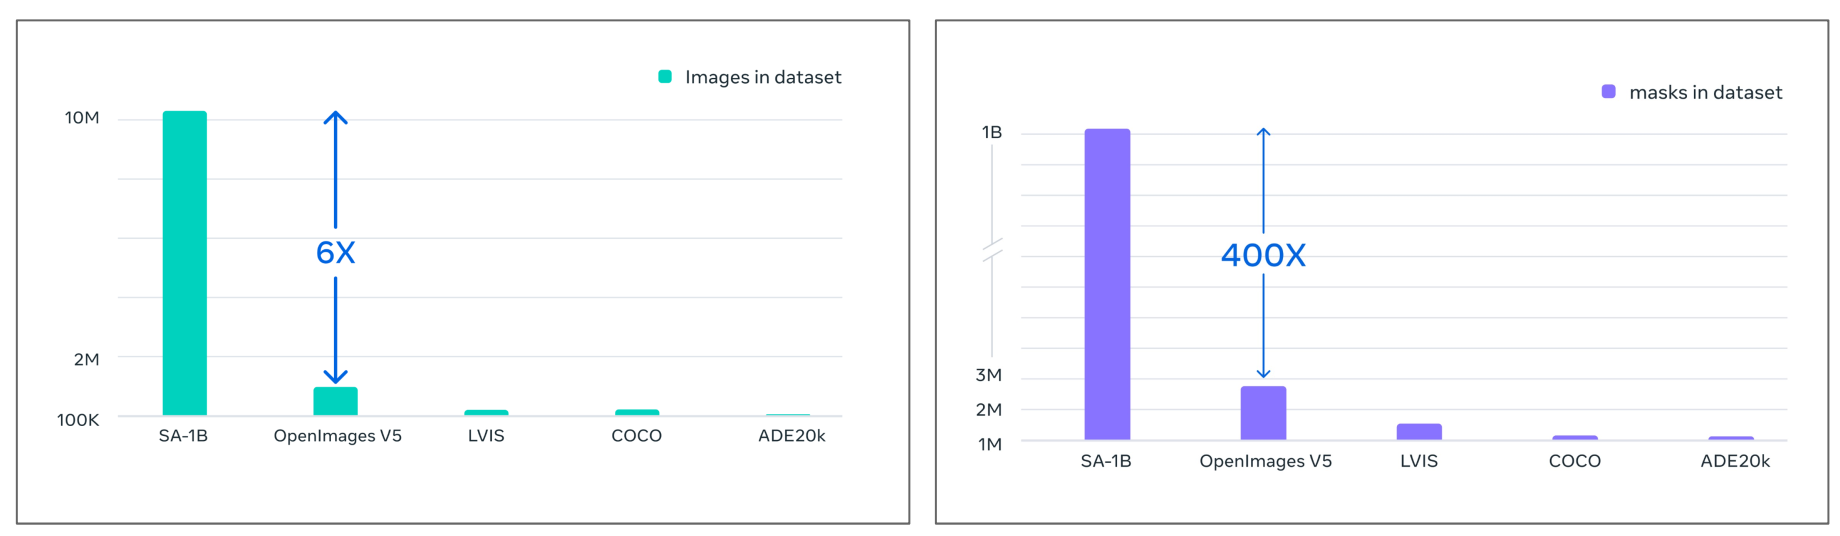
SAM 的另一个关键是数据。过去分割数据集规模相对小,覆盖类别有限。SAM 通过迭代式数据收集扩大 mask 数量:先用人工标注一批数据训练模型,再用模型提出 mask,让人类修正,然后继续训练和收集。这个 human-in-the-loop / model-in-the-loop 过程把分割 mask 数据扩展到远大于传统数据集的规模。
本讲在 SAM 上再次强调同一个结论:对于许多视觉任务,互联网不会自然提供足够好的监督信号。要构建真正可泛化的基础模型,常常必须主动设计数据收集流程。
9 Chaining 与 Visual Programming:把多个模型组合成新能力
9.1 CuPL:语言模型帮助 CLIP 认识罕见概念
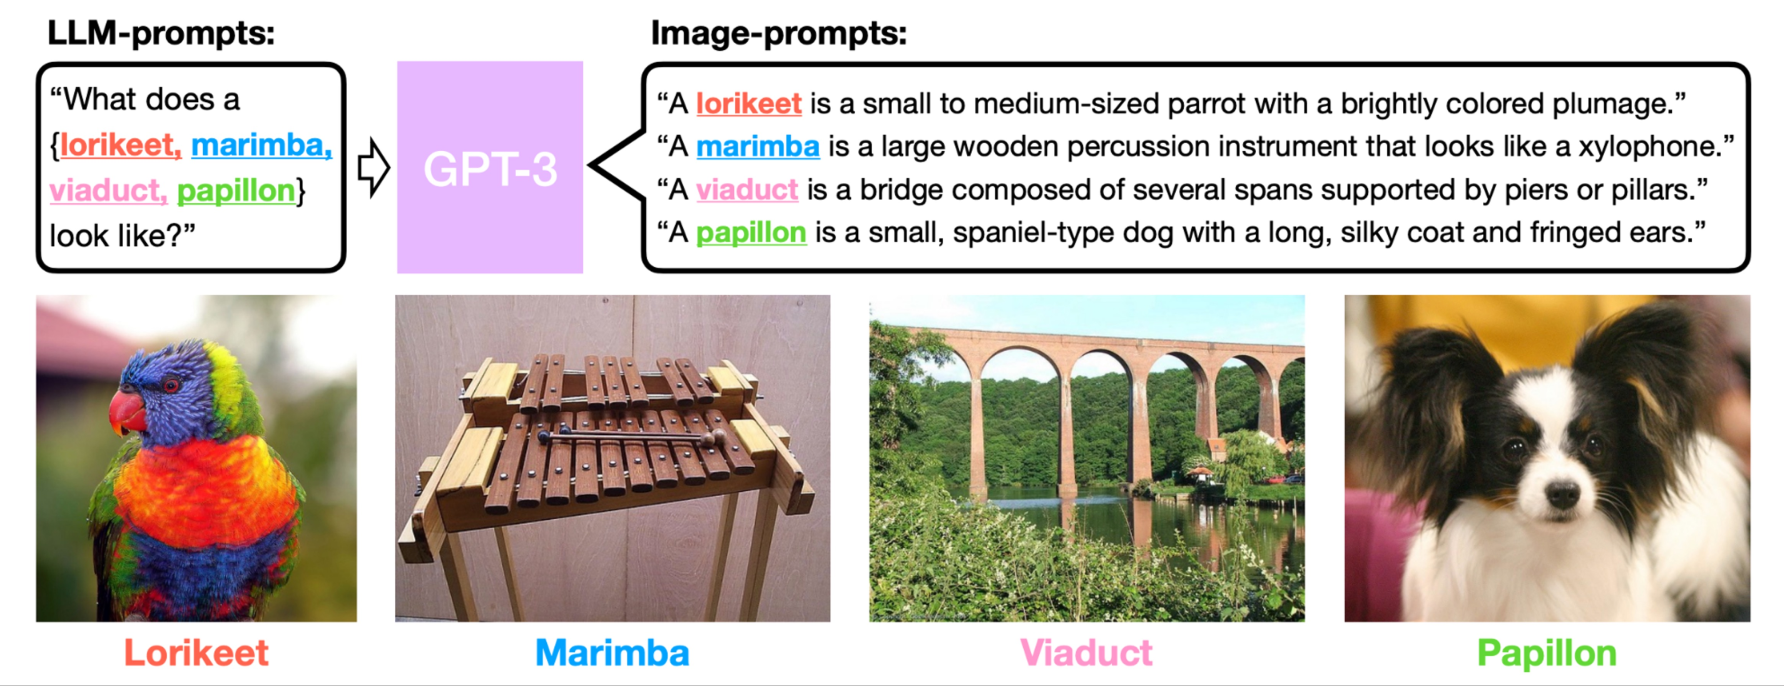
Chaining
的基本思想是:把不同模型的长处组合起来,获得单个模型没有的能力。CuPL(Customized
Prompts via Language Models)是一个简单例子。CLIP 可能没见过
marimba、papillon、lorikeet
这些细粒度类别,直接用类别名分类会失败。但语言模型可能知道这些概念的文字描述,例如外观、形状、颜色、使用场景。
流程是:
- 用语言模型为每个类别生成详细描述。
- 把描述作为 CLIP 的文本 prompt。
- 用图像向量和描述向量匹配进行分类。
这相当于把语言模型的世界知识转化为 CLIP 可用的视觉类别原型。
9.2 VisProg:让语言模型生成视觉程序
Visual Programming(VisProg)的思想更一般:对于复杂视觉问题,不必训练一个新模型,可以让语言模型生成一个程序,把现有视觉模块组合起来。
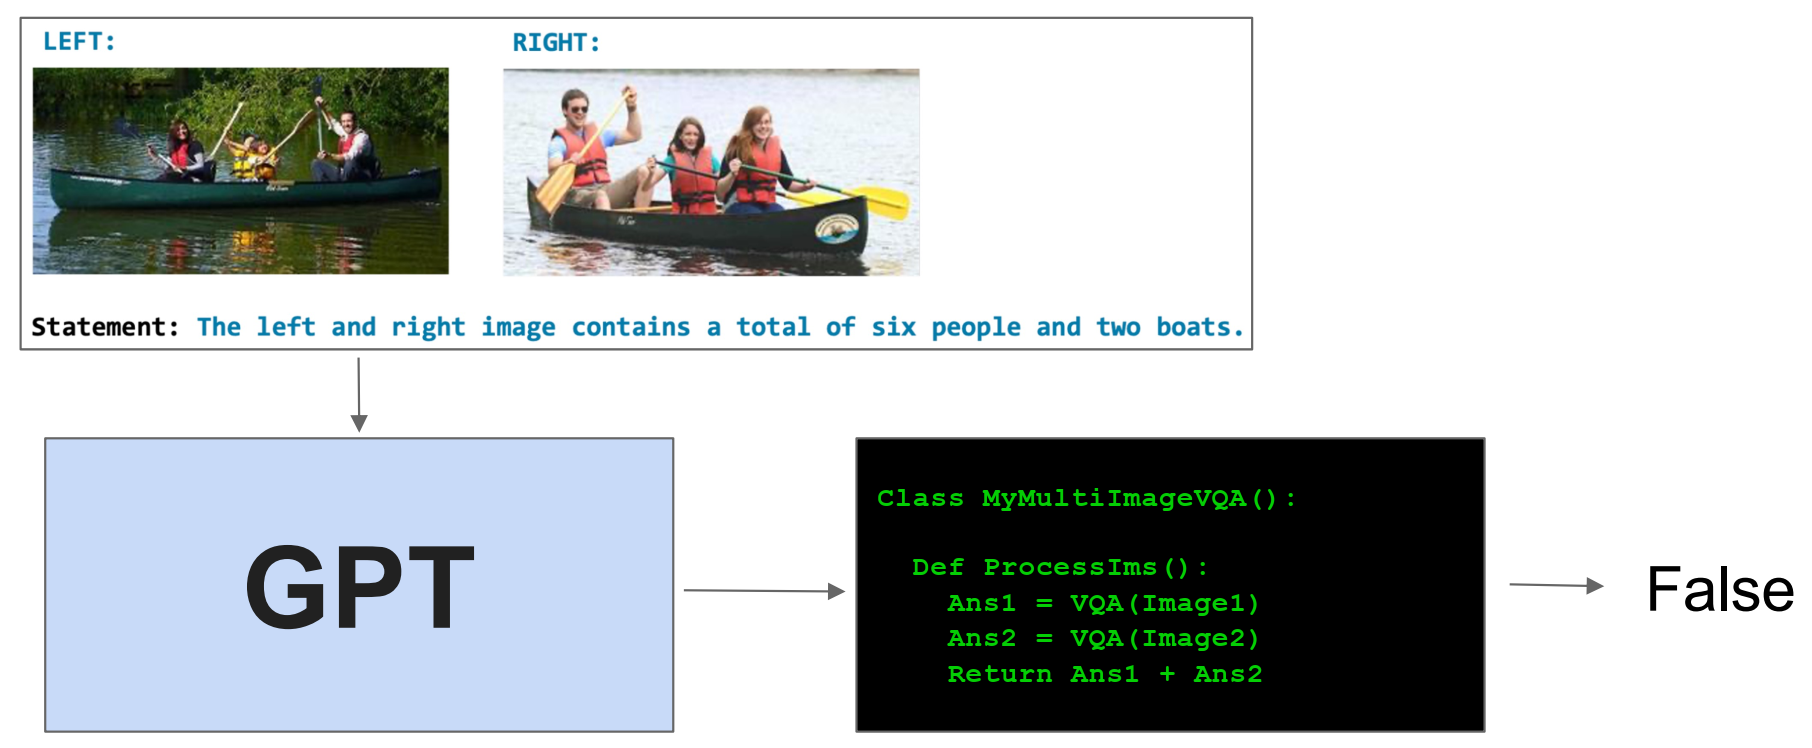
例如问题是“两张图里一共有 6 个人和 2 条船吗?”一个程序可以:
- 对第一张图调用 object detector,检测人和船。
- 对第二张图调用 object detector,检测人和船。
- 把两张图的检测数量相加。
- 判断总数是否满足问题。
这类程序可以调用 VQA、object detector、face detector、segmentation model、OCR、image editing model 等工具。语言模型负责根据问题选择工具、安排步骤、组合输出。
9.3 Chaining 的优势和代价
(Chaining 的定义见 9.1)Chaining 的优势是模块化、可解释、能力扩展快。只要已有工具足够好,就可以用程序组合获得新能力,不必为每个任务重新训练端到端模型。
代价也明显:
- 需要加载和运行多个模型,计算开销可能很高。
- 工具调用通常是串行的,延迟较大。
- 程序生成依赖语言模型,可能生成错误步骤。
- 每个工具的错误会向后传播。
- 要想生成好程序,需要好的 in-context examples 或检索系统。
因此 2025 年的重要研究方向之一,是在 chaining 和端到端模型之间寻找平衡:有些能力可以先通过 agent/tool/program 组合实现,再逐渐蒸馏进单个模型;有些任务仍然适合保留外部工具和 verifier。
10 复习重点与易混点
10.1 核心概念速查
| 概念 | 一句话理解 | 易考点 |
|---|---|---|
| Foundation Model | 大规模预训练后可迁移到许多任务的底座模型 | 定义重点是通用性,不是单纯参数量 |
| Zero-shot | 不用目标任务训练样本,直接用模型解决新任务 | CLIP 用文本 prompt 构造分类器 |
| Few-shot / in-context learning | 给少量示例,让模型在上下文中适配任务 | Flamingo 展示了视觉 few-shot 能力 |
| Contrastive learning | 拉近匹配对,推远不匹配对 | CLIP 用图文对做对比学习 |
| Open-vocabulary | 类别由自然语言定义,不限固定 label set | CLIP、SAM 都体现开放输入/输出思想 |
| Grounding | 把语言或推理结果落到图像区域、点、框或 mask 上 | Molmo 指向计数,SAM 用 prompt 输出 mask |
| Chaining | 把多个模型/工具组合起来完成任务 | CuPL 和 VisProg 是典型例子 |
10.2 CLIP、LLaVA、Flamingo、SAM 对比
| 模型 | 核心输入 | 核心输出 | 关键结构 | 代表能力 |
|---|---|---|---|---|
| CLIP | 图像 + 文本 | 相似度 | 双编码器 + contrastive loss | zero-shot 分类、图文检索 |
| CoCa | 图像 + 文本 | 相似度 + caption | contrastive encoder + caption decoder | 更强视觉表征 |
| LLaVA | 图像 + 指令文本 | 文本 | CLIP encoder + linear projector + LLM | 视觉问答、指令跟随 |
| Flamingo | 图像/视频 + 文本上下文 | 文本 | Perceiver sampler + gated cross-attention | few-shot VLM |
| Molmo | 图像 + 文本 | 文本 + 点/grounding | 开放 VLM + intentional data | 像素 grounded 推理 |
| SAM | 图像 + prompt | mask | image encoder + prompt encoder + mask decoder | promptable segmentation |
10.3 本讲反复出现的三条主线
第一,任务接口正在被统一。CLIP 把分类变成图文匹配,VLM 把许多视觉任务变成问答生成,SAM 把分割变成 promptable mask prediction,VisProg 把复杂视觉推理变成程序组合。
第二,数据比模型结构更核心。CLIP 依赖 4 亿图文对,CoCa 通过 caption objective 增强视觉语义,Molmo 依赖高质量 PixMo dense captions,SAM 通过迭代标注扩展 mask 数据。基础模型不是只靠更大 transformer,而是靠合适的监督信号覆盖更广能力。
第三,grounding 是多模态模型走向可靠性的关键。只输出文本容易 hallucinate;如果模型能指向对象、输出 mask、调用 verifier 或展示中间证据,结果更容易检查,也更适合机器人、编辑、导航等需要和现实世界交互的任务。
10.4 容易混淆的问题
CLIP 的 zero-shot 分类不是“没有类别”。 它仍然需要候选类别集合,只是类别由文本 prompt 给出,不需要为这些类别训练新的分类头。
CLIP 的图文相似度不等于强视觉推理。 它擅长全局语义匹配和检索,但对空间关系、组合性、计数、局部定位常常不可靠。
LLaVA 和 Flamingo 都是视觉接入 LLM,但融合位置不同。 LLaVA 更像把图像 token 投影成 LLM 输入 token;Flamingo 在多层中加入 gated cross-attention,让语言生成过程反复读取视觉特征。
开放权重不等于完全开放。 如果数据、代码、评估或教师模型不开放,研究社区仍然难以复现模型能力。Molmo 的重点之一就是把开放性扩展到权重、数据、代码和 eval。
SAM 不是传统固定类别分割器。 它的核心是 promptable segmentation:用户通过点、框、文本等指定目标,模型输出 mask;类别集合不是固定 COCO label set。
Chaining 不是免费午餐。 它能快速组合能力,但需要可靠工具、好的程序生成、足够算力和错误验证。很多系统会同时使用生成模型、工具调用和 verifier 来降低 hallucination。
10.5 可能的考试/面试问法
- 为什么 CLIP 可以做 zero-shot image classification?请说明文本编码器如何构造类别原型。
- Prompt ensembling 为什么能提升 CLIP 的分类表现?
- CoCa 相比 CLIP 多了什么训练目标?为什么 captioning loss 可能学到更丰富的视觉表征?
- 为什么 CLIP 对
mug in grass和grass in mug这类例子容易失败? - LLaVA 如何把 CLIP 图像特征接入 LLM?为什么常用倒数第二层 patch tokens?
- Flamingo 的 perceiver sampler 和 gated cross-attention 分别解决什么问题?
- Molmo 为什么强调 intentional data?它和从互联网抓取 alt-text 的数据有什么不同?
- SAM 为什么要输出多个 mask?训练时为什么只对最佳 mask 计算 loss?
- Visual Programming 如何用已有视觉模块解决复杂 VQA?它的优缺点是什么?
- 为什么 grounding 可以缓解多模态模型 hallucination,但不能彻底保证正确性?