1 机器人学习的问题设定
机器人学习研究智能体如何在环境中感知状态、采取动作、接收反馈,并逐步学会完成任务。它把计算机视觉从“理解一张图像”推进到“依据视觉与多模态观测改变现实世界”。核心困难在于:动作会改变后续数据,而现实世界通常具有随机性、部分可观测性和安全约束。
1.1 与监督学习、自监督学习的区别
| 学习范式 | 可用数据 | 学习目标 | 典型任务 |
|---|---|---|---|
| 监督学习(Supervised Learning) | 成对样本 \((x,y)\) | 学习从输入 \(x\) 到标签 \(y\) 的映射 | 分类、回归、检测、分割、图像描述 |
| 自监督学习(Self-Supervised Learning) | 无人工标签的数据 \(x\) | 从数据本身构造监督信号,学习潜在结构或表征 | 表征学习、降维、密度估计 |
| 机器人学习(Robot Learning) | 智能体与环境交互所得的观测、动作与反馈 | 学习能够最大化长期任务收益的行为 | 移动、操作、游戏、对话、具身任务 |
机器人学习的特殊之处是闭环交互:策略决定机器人接下来会看到什么数据。因此,训练数据不再天然独立同分布,模型的错误还可能把系统带到训练集中从未出现过的状态。
1.2 状态、动作、奖励与策略
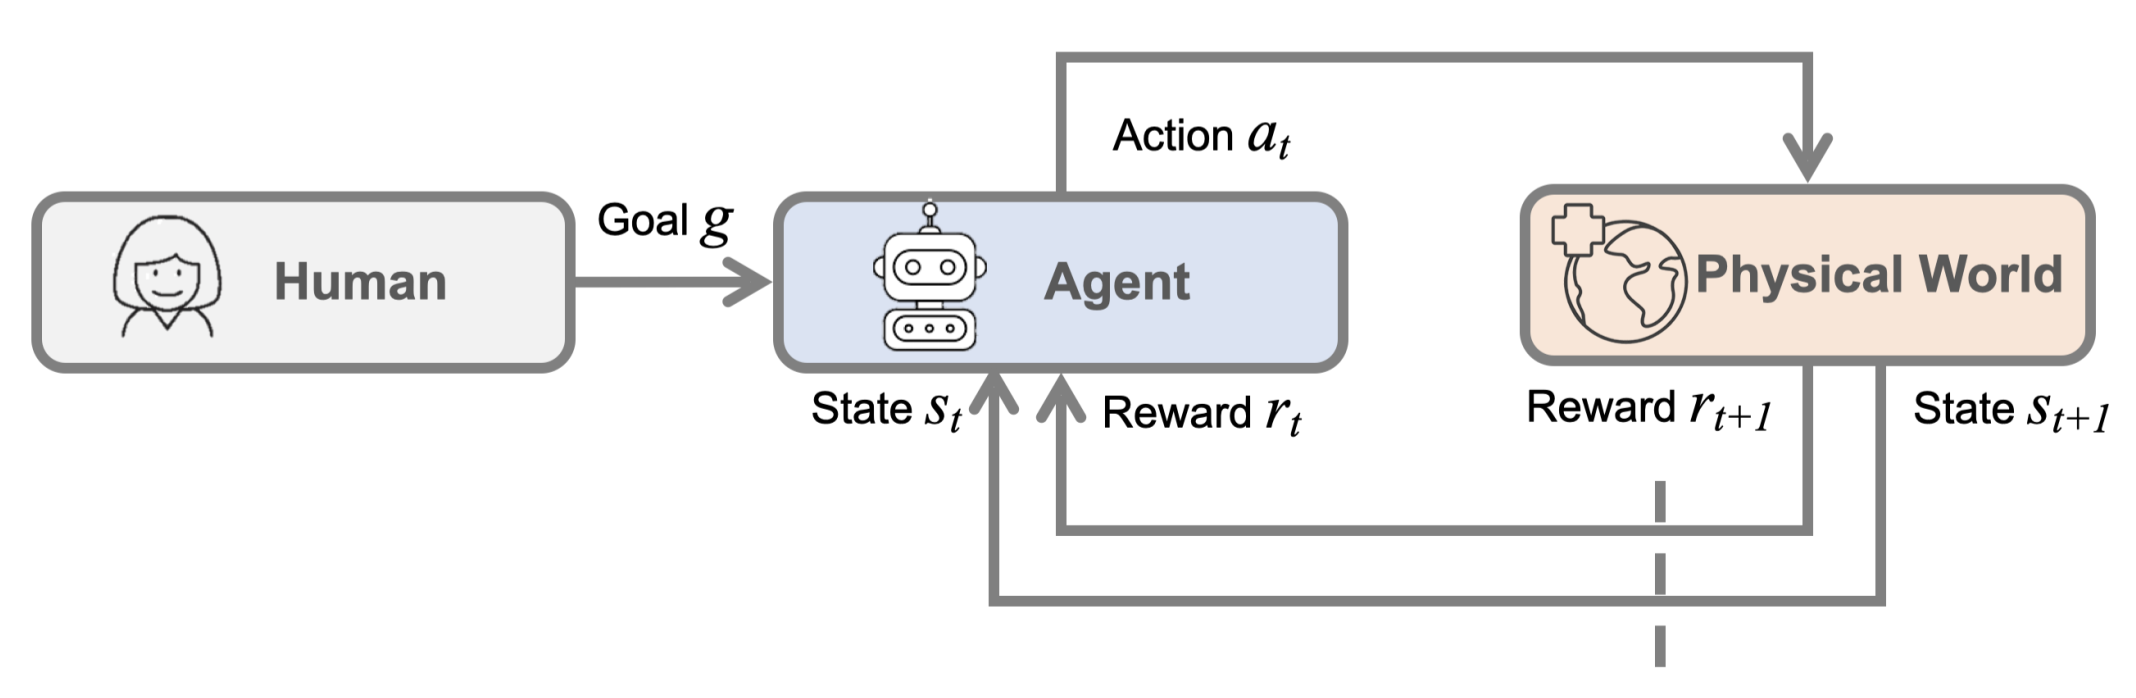
机器人学习任务通常可用以下元素描述:
- 状态(state)\(s_t\): 时刻 \(t\) 对任务有关信息的描述,例如关节角、速度、物体位置或图像。
- 观测(observation)\(o_t\): 传感器实际提供的信息。当观测不能完整决定真实状态时,问题是部分可观测的。
- 动作(action)\(a_t\): 智能体对环境施加的控制,如方向键、关节力矩或机械臂末端位姿。
- 奖励(reward)\(r_t\): 对当前结果的数值评价。奖励可以稠密地逐步给出,也可以只在任务末尾出现。
- 策略(policy)\(\pi(a_t\mid s_t)\): 根据当前状态选择动作的规则;确定性策略可写为 \(a_t=\pi(s_t)\)。
- 状态转移(transition)\(P(s_{t+1}\mid s_t,a_t)\): 执行动作后环境如何演化。
典型目标是最大化折扣累计回报:
\[ G_t=\sum_{k=0}^{\infty}\gamma^k r_{t+k},\qquad 0\leq\gamma<1. \]
\(\gamma\) 控制对未来奖励的重视程度。机器人必须兼顾眼前收益与长期后果,这也是序列决策区别于逐样本预测的关键。
1.3 不同任务中的统一抽象
| 任务 | 状态或观测 | 动作 | 奖励 |
|---|---|---|---|
| 杆车平衡 | 杆角度、角速度、车位置与速度 | 对小车施加水平力 | 杆保持直立时每步得分 |
| 机器人行走 | 全部关节的位置、角度与速度 | 关节力矩 | 保持直立并向前移动 |
| Atari 游戏 | 最近若干帧游戏画面 | 方向与按钮控制 | 游戏分数的增减 |
| 围棋 | 棋盘上全部棋子的位置 | 下一手落子位置 | 终局胜负奖励 |
| 文本生成 | 当前词序列 | 下一个词 | 下一词正确与否 |
| 对话系统 | 当前对话历史 | 下一句回复 | 人类满意度 |
| 布料折叠 | 布料的视觉/几何状态 | 机械臂末端运动 | 是否成功折叠 |
勘误: 课件在布料折叠示例中把状态写成了“Current conversation”,应是沿用了对话系统页面的文字;这里合理的状态应为布料当前的视觉、几何或粒子状态。
2 机器人感知与感知—行动闭环
2.1 机器人感知的任务
机器人感知(Robot Perception)要从非结构化现实世界中提取可用于行动的信息。现实场景中存在不完整的物体知识、传感器噪声、动作误差、动态环境以及其他智能体,因此识别出物体类别只是起点;系统还要估计位置、形状、可操作区域、接触关系和未来变化。
机器人通常融合多模态传感器,例如 RGB/深度相机、激光雷达、触觉、力/力矩传感器、关节编码器和音频。不同模态互补:视觉覆盖范围广但会受遮挡影响,触觉只有接触后才产生却能直接反映接触状态,本体感觉则提供机器人自身姿态。
2.2 机器人视觉与普通计算机视觉
机器人视觉具有三个相互关联的属性:
- 具身性(embodied): 机器人拥有物理身体,动作会立即改变环境,也会改变自身之后的感觉输入。
- 主动性(active): 机器人可以为了消除不确定性主动移动相机、改变视角或触碰物体,即主动感知(active perception)。
- 情境性(situated): 决策发生在具体的“此时此地”,感知结果必须及时服务于当前行为,而非停留在抽象描述。
普通视觉系统常采用“固定数据集输入 → 输出预测”的开环形式;机器人系统则不断执行:
\[ o_t \rightarrow \text{状态估计/表征} \rightarrow a_t \rightarrow \text{环境变化} \rightarrow o_{t+1}. \]
因此,闭合感知—行动环(perception-action loop)是机器人学习的核心挑战。感知误差会导致错误动作,错误动作又会产生更困难的观测,形成误差累积。
3 强化学习
强化学习(Reinforcement Learning, RL)让智能体通过试错与环境交互,学习最大化长期奖励的策略。
3.1 强化学习为何比监督学习困难
- 随机性(stochasticity): 相同的 \((s_t,a_t)\) 可能产生不同的 \(r_t\) 和 \(s_{t+1}\)。
- 信用分配(credit assignment): 当前奖励可能由很早以前的动作导致,必须判断哪些动作真正贡献了结果。
- 环境不可微(nondifferentiability): 通常无法对真实世界直接计算 \(\partial r_t/\partial a_t\),也就不能把梯度穿过世界反向传播。
- 数据非平稳(nonstationarity): 策略改变后,访问的状态分布也随之改变;智能体收集的数据取决于自己的行为。
- 探索—利用权衡: 只执行当前认为最优的动作可能错过更好方案,但探索又可能代价高昂或不安全。
3.2 动作价值函数与深度 Q 网络
动作价值函数(action-value function)衡量在状态 \(s\) 采取动作 \(a\) 后,并继续按照某策略行动的期望长期回报:
\[ Q^{\pi}(s,a)=\mathbb{E}_{\pi}\left[\sum_{k=0}^{\infty}\gamma^k r_{t+k}\mid s_t=s,a_t=a\right]. \]
深度 Q 网络(Deep Q-Network, DQN)使用神经网络 \(Q(s,a;\theta)\) 近似各动作的价值。下面介绍 Atari 使用的深度 Q 网络。
Atari 2600 是一个游戏平台,里面有一系列经典电子游戏,例如 Pong、Breakout、Space Invaders 等。这些游戏常被用作强化学习基准:
- 状态: 游戏画面的像素。
- 动作: 左、右、开火等有限的控制指令。
- 奖励: 游戏分数的增加或减少。
- 目标: 学会选择动作,使长期累计分数最高。
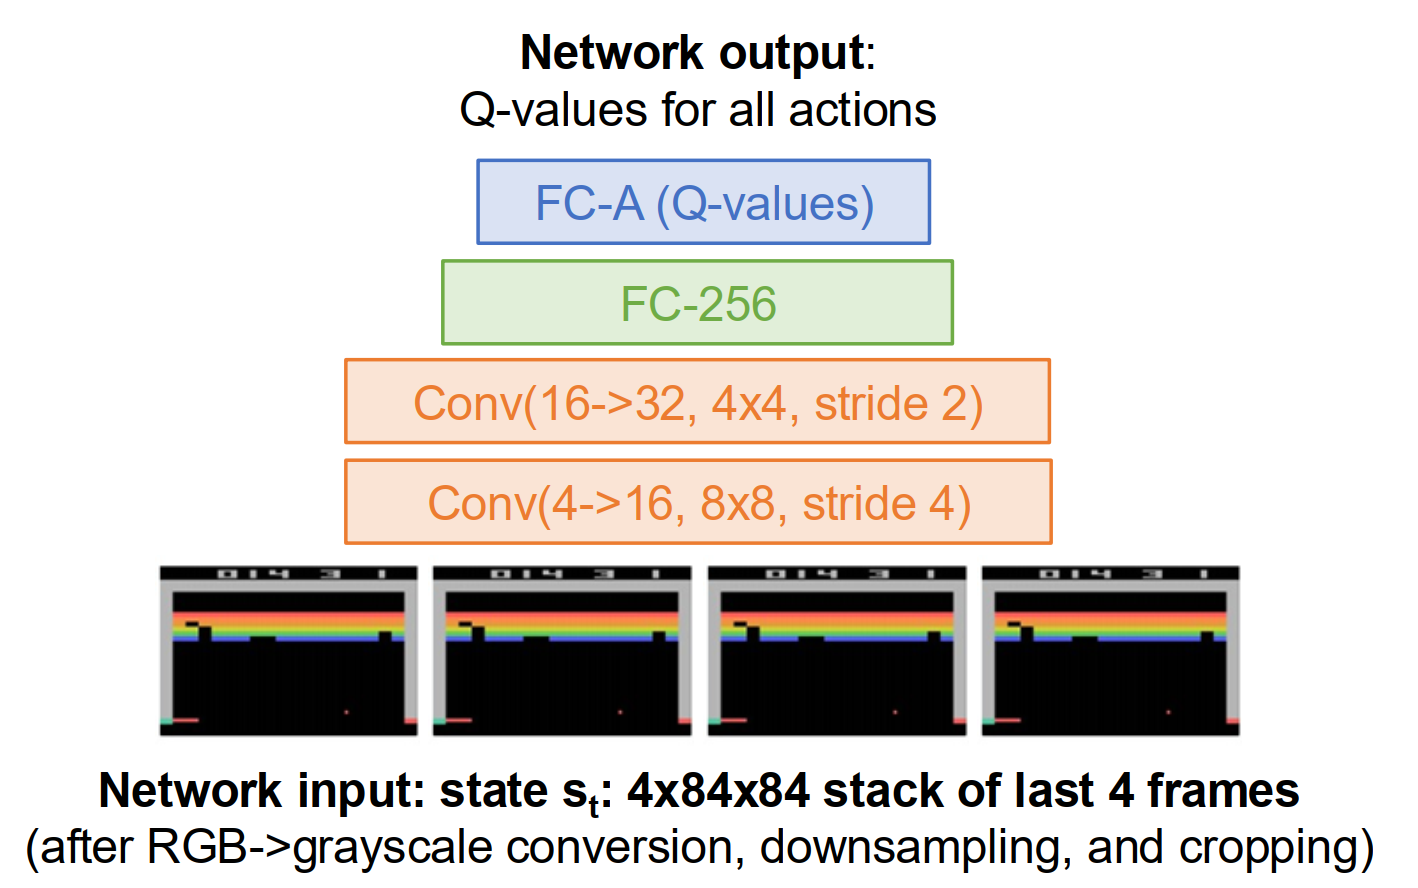
Atari 的深度 Q 网络的输入是最近 4 帧灰度图像。最近 4 帧能够提供运动信息。例如,只看一张图无法判断球正在向左还是向右移动;结合前后多帧就可以估计运动方向和速度。这 4 帧灰度图像会被堆叠为 \(4\times84\times84\) 的输入,经过卷积层和全连接层,最后一次性输出所有离散动作的 \(Q\) 值。
决策时通常选择使得 \(Q\) 最大的动作:
\[ a_t=\arg\max_a Q(s_t,a;\theta). \]
3.3 从 Atari 到复杂游戏与机器人
围棋系统展示了模仿学习、强化学习、搜索与模型规划的不同组合:
- AlphaGo: 结合人类棋谱模仿学习、树搜索和强化学习。
- AlphaGo Zero: 不依赖人类示范,通过自我对弈学习。
- AlphaZero: 将相同思想推广到围棋、国际象棋和将棋。
- MuZero: 学习用于规划的潜在动力学模型,不要求显式重建完整游戏规则。
更复杂的例子包括星际争霸 II 的 AlphaStar 和 Dota 2 的 OpenAI Five。机器人领域中,强化学习已用于四足运动、灵巧手魔方操作和手内物体重定向。
3.4 无模型强化学习的局限
无模型强化学习(model-free RL)直接从交互中学习价值或策略,不显式学习环境动力学。其主要问题是:
- 需要大量试错,现实机器人采样昂贵且慢;
- 探索可能损坏机器人、物体或周围环境;
- 策略内部机制难以解释,失败前也不容易预测;
- 对新任务或新环境的复用能力有限。
人类往往依靠直观的世界模型预演动作后果,因此模型学习有望提高样本效率和适用范围。
4 世界模型与基于模型的规划
4.1 基本思想
基于模型的方法先学习状态转移:
\[ P(s_{t+1}\mid s_t,a_t), \]
再利用模型预测候选动作的后果并进行规划。可在长度为 \(H\) 的动作序列上优化:
\[ a_{t:t+H-1}^{*}=\arg\max_{a_{t:t+H-1}} \sum_{k=0}^{H-1}\gamma^k\hat r(s_{t+k},a_{t+k}). \]
由于学到的模型不可能完全准确,若一次性执行整段计划,预测误差会随时间累积。常用模型预测控制(Model Predictive Control, MPC):
- 根据当前状态优化一段动作序列;
- 只执行第一个动作;
- 获取新的真实观测;
- 从新状态重新规划。
GPU 可并行评估大量候选动作或加速基于梯度的动作优化。关键设计问题是状态 \(s_t\) 应采用何种表征。
4.2 不同的动力学表征
| 表征 | 核心思想 | 优点 | 局限与适用任务 |
|---|---|---|---|
| 像素动力学(pixel dynamics) | 直接预测未来图像或像素运动 | 无需人工定义物体状态,保留完整视觉信息 | 维度高,容易把容量消耗在与任务无关的外观细节上 |
| 关键点动力学(keypoint dynamics) | 用少量可跟踪关键点表示物体并预测其运动 | 紧凑、具有一定几何可解释性 | 关键点可能不足以描述形变或复杂接触 |
| 粒子动力学(particle dynamics) | 用粒子集合表示物体几何与材料状态 | 适合颗粒、食材、软体和弹塑性材料 | 粒子构建、对应关系和长时预测较困难 |
深度视觉前瞻(Deep Visual Foresight)属于像素级预测路线;关键点方法通过自监督对应关系获得紧凑状态;粒子方法则能处理颗粒堆操纵和 RoboCook 中的长时程弹塑性食材操作。粒子预测页面比较了夹取、按压等操作下多视角的预测结果与真实结果,用于判断模型是否学到材料形变与工具交互规律。
4.3 模型误差与规划误差
规划器可能主动寻找模型的漏洞:某个动作序列在模型中得分很高,在真实世界中却失败。这称为模型偏差(model bias)的利用。MPC 能通过频繁重新观测减轻误差,但不能彻底消除它。可靠系统还需要不确定性估计、保守规划、真实数据校准以及安全约束。
5 模仿学习
模仿学习(Imitation Learning)利用专家示范数据进行监督学习。示范通常由状态/观测与专家动作组成:
\[ \mathcal D=\{(o_t,a_t^{E})\}_{t=1}^{N}. \]
它绕过了手工设计奖励和危险的随机探索,但性能受到示范质量、覆盖范围与数据分布影响。
5.1 行为克隆与分布偏移
行为克隆(Behavior Cloning, BC)直接拟合专家动作,例如:
\[ \theta^*=\arg\min_{\theta}\sum_{(o,a^E)\in\mathcal D} \ell\bigl(\pi_{\theta}(o),a^E\bigr). \]
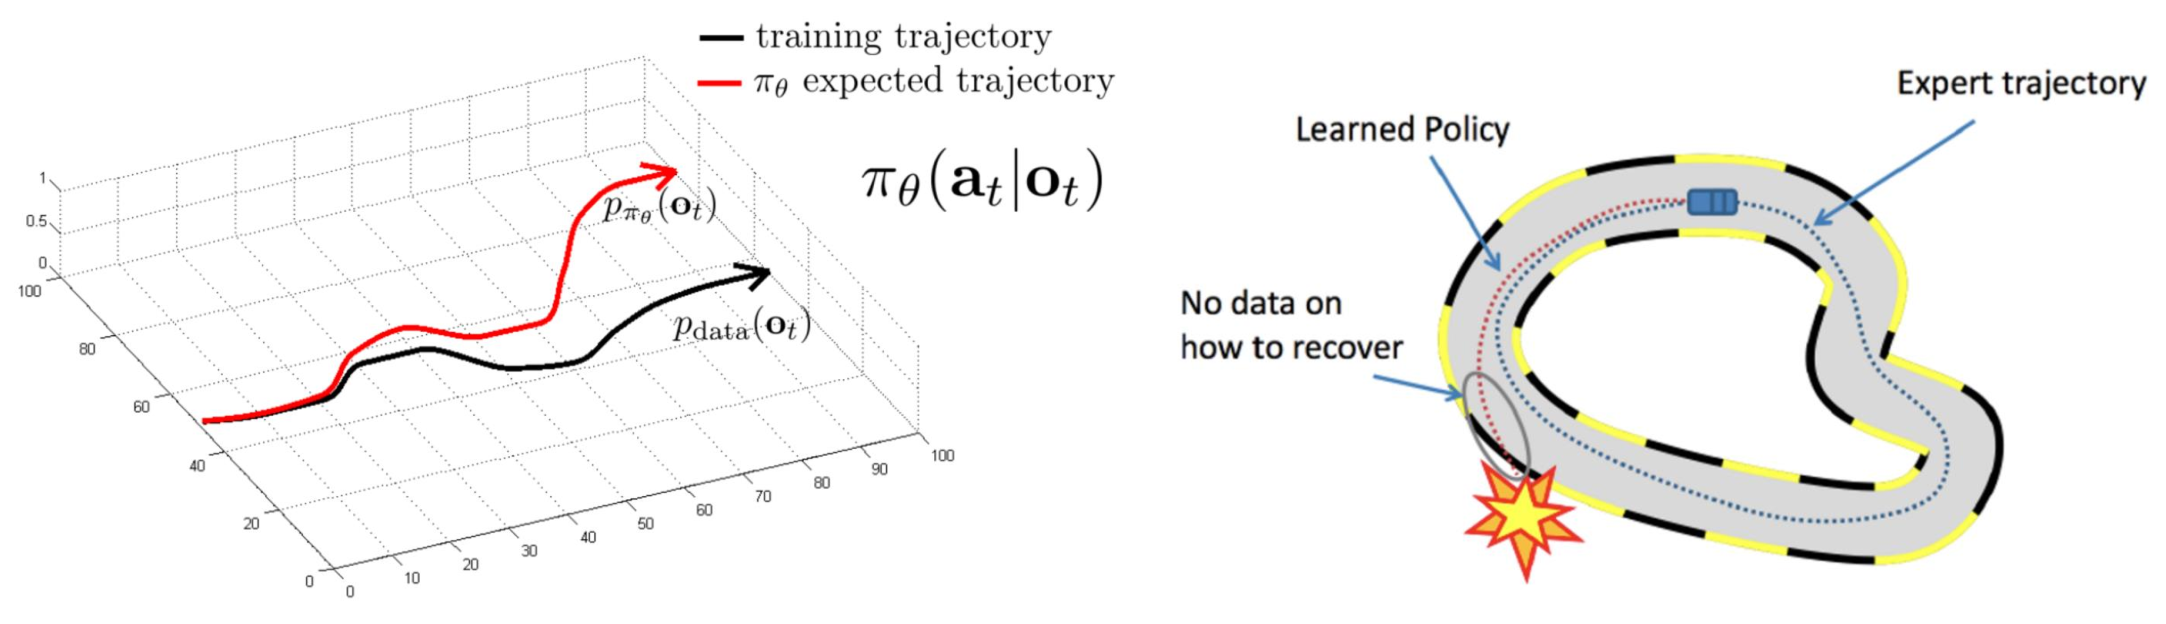
BC 的训练数据来自专家访问的状态分布 \(p_{\text{data}}(o)\),部署时数据却来自学习策略自身的分布 \(p_{\pi_\theta}(o)\)。即便单步错误很小,机器人也可能逐渐偏离专家轨迹,进入训练集没有覆盖的状态;由于没有“如何恢复”的示范,错误会继续累积。这就是协变量偏移(covariate shift)与复合误差。
例如,自动驾驶策略在每一步只产生很小的方向误差,但数十步后可能接近道路边缘;训练数据若只包含居中驾驶,就无法告诉策略如何回到车道中央。
5.2 迭代收集专家示范
可通过类似 DAgger 的闭环过程修复覆盖不足:
- 用当前数据训练策略;
- 让当前策略在环境中执行并访问其真实会遇到的状态;
- 请专家为这些状态标注正确动作或进行接管;
- 将新数据加入训练集并重新训练;
- 重复以上过程。
这样得到的数据逐渐覆盖学习策略的状态分布,尤其包含偏离轨迹后的恢复动作。代价是专家必须反复参与,而且真实执行仍需考虑安全。
5.3 逆强化学习
普通强化学习已知环境和奖励,通过优化得到行为:
\[ (\text{环境},\text{奖励})\longrightarrow \text{RL}\longrightarrow \text{行为}. \]
逆强化学习(Inverse Reinforcement Learning, IRL)则已知环境并观察专家行为,反推出能够解释该行为的奖励:
\[ (\text{环境},\text{专家行为})\longrightarrow \text{IRL}\longrightarrow \text{奖励}. \]
学习奖励比逐动作复制更有机会迁移到新状态,因为奖励描述“专家想实现什么”。但多个奖励函数可能解释同一行为,奖励识别具有歧义;得到奖励后通常还需要再运行强化学习求策略,计算成本较高。
5.4 隐式行为克隆
显式策略(explicit policy)直接输出动作:
\[ \hat a=F_{\theta}(o). \]
这种回归形式面对多模态示范时可能输出多个合理动作的平均值,而平均动作本身可能不合理。隐式行为克隆(Implicit Behavior Cloning, IBC)学习观测—动作对的能量函数 \(E_{\theta}(o,a)\),推理时搜索最低能量动作:
\[ \hat a=\arg\min_{a\in\mathcal A}E_{\theta}(o,a). \]
能量函数(energy function)是一个给“观测—动作组合”打分的函数。能量越低,动作越合适;能量越高,动作越不合适。能量面可以表达多个低谷,因此较适合“一种观测对应多个合理动作”的任务。其代价是推理时需要采样或优化动作,速度和稳定性取决于优化过程。
5.5 扩散策略
扩散策略(Diffusion Policy)把动作或动作序列看作条件生成问题。训练时学习在观测条件下去除动作噪声;推理时从噪声动作开始,经过 \(K\) 次迭代逐步生成高概率动作轨迹。它与能量模型关系紧密:去噪网络所给出的方向可视为引导动作走向低能量区域的梯度场。
相较简单回归,扩散策略能够:
- 表达多峰动作分布,保留多种合理操作方式;
- 联合生成一段连续动作,使时间一致性更强;
- 适应高维、连续的机器人控制信号。
其主要代价是多步采样带来的推理延迟,因此实际机器人还需在生成质量、控制频率与计算预算之间折中。
6 机器人基础模型
6.1 定义与目标
机器人基础模型(Robotic Foundation Model)试图从大规模、多任务、跨机器人数据中学习通用策略。模型不必显式输出状态或转移函数,而直接把观测/状态与目标映射到动作:
\[ \pi(a\mid o,g). \]
这类模型也称视觉—语言—动作模型(Vision-Language-Action Model, VLA)或大行为模型(Large Behavior Model, LBM)。它们希望像语言模型生成合理文本一样,生成连贯、合理的机器人轨迹。但“看起来合理”并不等于安全、任务成功或最优,物理执行对错误的容忍度远低于纯数字输出。
6.2 发展脉络
课件列举了 RT-1、RT-2、RT-X、OpenVLA、\(\pi_0\)(Pi-Zero)、Helix、Hi Robot、Gemini Robotics、\(\pi_{0.5}\)、GR00T 和 DYNA-1 等代表性系统。整体趋势包括:
- 从单一机器人、单一任务扩展到跨任务与跨本体(cross-embodiment)训练;
- 把视觉—语言模型的语义知识与连续控制结合;
- 从离散动作 token 发展到更适合高频连续控制的生成式动作模型;
- 通过预训练学习通用能力,再通过后训练适配具体任务、机器人和场景。
6.3 \(\pi_0\) 的训练范式
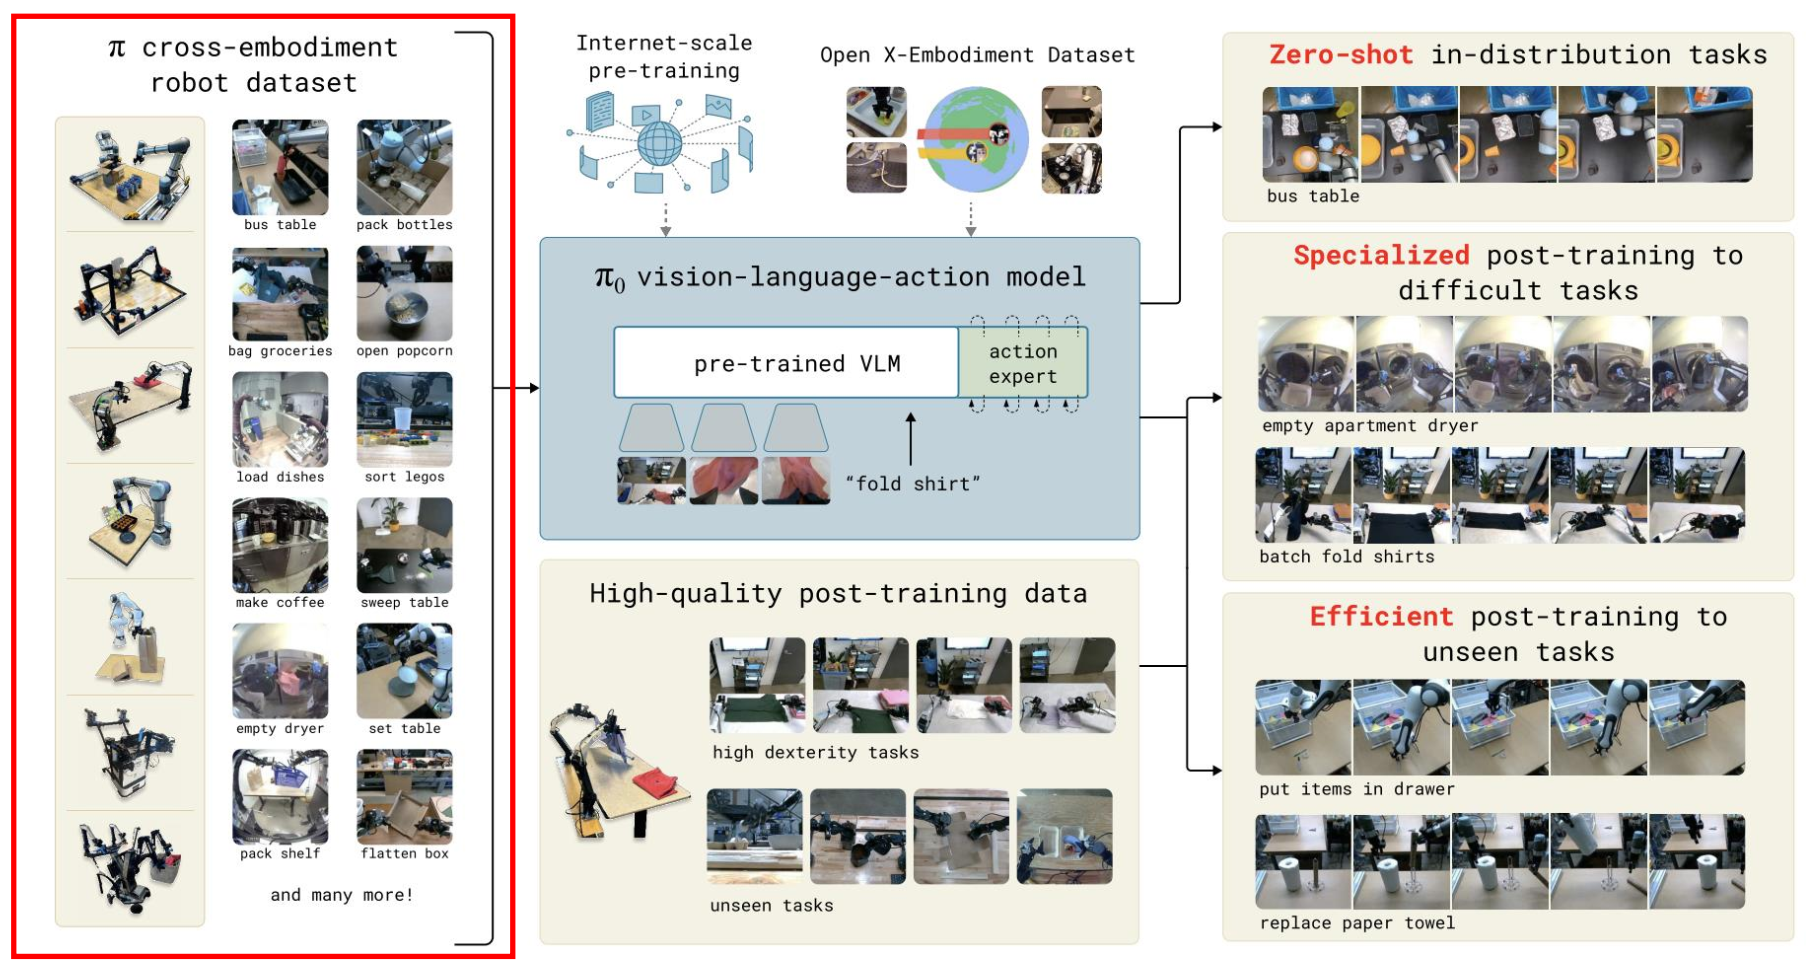
\(\pi_0\) 的整套方法可以概括为:
\[ \text{多来源数据} \longrightarrow \pi_0\text{ 视觉—语言—动作模型} \longrightarrow \text{零样本执行或任务适配} \]
6.3.1 跨本体机器人数据
\(\pi\) 跨本体机器人数据集(cross-embodiment robot dataset)包含多种机器人平台和操作任务。“本体(embodiment)”指机器人的具体物理身体,包括机械臂数量与结构、夹爪类型、相机位置及动作控制空间。数据覆盖擦桌子、装瓶、装杂货、打开包装、装载碗碟、制作咖啡、摆放餐具、整理货架和压平纸盒等任务。
每段示范数据大致可以表示为:
\[ (\text{图像},\text{语言任务},\text{机器人状态},\text{动作序列})。 \]
跨本体训练的目标是从不同硬件中提取共享的操作规律。例如,不同机器人执行抓取时采用的关节控制量并不相同,但都需要识别目标、接近物体、闭合夹爪并移动到目标区域。模型由此学习较通用的任务语义和操作技能,而不只记住某一种机器人的运动方式。
不同本体的动作不能直接视为完全相同,实际训练仍需通过统一动作表示、归一化或本体条件信息处理硬件差异。
6.3.2 多来源预训练
\(\pi_0\) 的预训练结合三类互补数据:
| 数据来源 | 主要提供的能力 |
|---|---|
| 互联网规模图像—文本数据 | 物体识别、语言理解、视觉语义与常识 |
| Open X-Embodiment 数据 | 更多机器人平台、场景和操作任务 |
| \(\pi\) 跨本体机器人数据 | 连续动作、物理交互与高质量操作经验 |
互联网数据通常没有机器人动作,主要使模型理解“场景中有什么”和“语言要求完成什么”;机器人数据进一步使模型学习“具体应该怎样做”。因此可以把二者的关系概括为:互联网数据帮助模型看懂、听懂,机器人交互数据帮助模型做出来。
6.3.3 视觉—语言—动作模型结构
\(\pi_0\) 将相机图像、语言指令和机器人本体状态映射为连续动作序列:
\[ \pi_0:(I_t,l,x_t)\longrightarrow A_t=(a_t,a_{t+1},\ldots,a_{t+H-1}), \]
其中 \(I_t\) 是视觉观测,\(l\) 是类似“fold shirt”的语言任务,\(x_t\) 是机器人状态,\(A_t\) 是未来一段动作。
模型包含两个功能互补的部分:
- 预训练视觉—语言模型(pre-trained VLM): 识别物体、理解场景和语言目标,提供任务相关的语义特征。
- 动作专家(action expert): 根据视觉—语言特征和机器人状态生成连续动作块,负责把“要做什么”转化为“机械臂具体怎样运动”。
动作专家采用生成式连续控制思路,适合表达机器人任务中的多模态动作。例如折衣服可能存在不同但都合理的抓取点和折叠顺序;模型应保留这些不同模式,而不是简单平均为无效动作。
6.3.4 高质量后训练
大规模预训练数据覆盖面广,但示范质量、任务定义和动作精度可能不一致,而且复杂技能的数据相对稀少。因此,通用预训练之后还需使用高质量数据进行后训练(post-training),主要包括:
- 高灵巧任务(high-dexterity tasks): 精细抓取、柔性物体操作、双臂协调等对接触、精度和时序要求较高的任务。
- 未见任务(unseen tasks): 预训练阶段未专门覆盖的新任务,通过少量针对性示范把已有子技能重新组合起来。
这一过程类似“通用基础模型 + 少量领域数据”的适配范式:预训练负责获得广泛能力,后训练负责把能力集中到特定困难任务上。
6.3.5 三种部署能力
| 能力 | 是否针对目标任务继续训练 | 含义 | 课件示例 |
|---|---|---|---|
| 分布内零样本执行(zero-shot in-distribution) | 否 | 新实例与预训练任务和环境相似,可直接调用已有能力 | 擦桌子 |
| 困难任务专门化(specialized post-training) | 是 | 使用高质量数据强化长时程或高难度技能 | 清空烘干机、批量折叠衬衫 |
| 未见任务高效适配(efficient post-training) | 是,但数据需求较少 | 利用预训练技能,通过少量新示范学习新任务 | 把物品放入抽屉、更换纸巾卷 |
这里尤其要区分“零样本”和“未见任务高效适配”。零样本表示部署前不再针对当前任务训练,但任务仍与训练分布相似;未见任务适配则确实需要新示范,只是由于模型已经具备抓取、移动、放置和语言理解等基础能力,所需数据比从头训练少。
还要区分三种泛化:
- 分布内泛化: 新样本仍与训练任务和环境相近;
- 组合泛化: 将已见技能按新的目标或顺序组合;
- 分布外泛化: 场景、物体、任务或机器人本体发生明显变化。
演示视频能直观呈现成功案例,但不能替代统一、重复且具有统计意义的评估。\(\pi_0\) 的整体思想是:先从互联网知识和多种机器人的示范中学习通用操作能力,再用少量高质量数据适配具体困难任务。
7 评估、世界模型与终身学习挑战
7.1 真实世界评估
机器人模型最终要在现实中执行,所以真实世界成功率最有意义。然而它昂贵、缓慢且噪声大:物体初始位置、光照、摩擦、硬件状态和操作人员都可能影响结果。
训练损失与真实成功率的相关性可能很弱。 原因包括:
- 训练目标只是代理目标,任务评价关心的是最终成功;
- 训练多为单步或短片段预测,测试需要长时闭环执行;
- 小的单步动作误差可能在长轨迹中累积;
- 离线数据分布与部署时访问的状态不同。
因此评估应报告多次独立试验的成功率、任务完成度、失败类型、执行时间与安全事件,而不能只报告训练损失。
7.2 仿真评估与 sim-to-real 差距
仿真可快速、并行、低成本地评估,但存在仿真到现实差距(sim-to-real gap),对刚体、可变形物体和布料的影响程度不同。建立类似 ImageNet 的具身智能基准还需要:
- 高效生成大量三维资产与交互属性;
- 将现实场景数字化;
- 程序化生成真实而多样的环境;
- 验证仿真成绩与真实成功率之间的相关性。
若二者相关性不足,仿真排名并不能可靠预测现实性能。常见缓解方式包括域随机化、系统辨识、真实数据微调和混合评估。
7.3 从基础策略到基础世界模型
课件把世界模型定义为动作条件下的未来预测(action-conditioned future prediction)。同一批机器人交互数据既能训练基础策略,也能训练基础世界模型:
\[ (o_t,a_t)\longrightarrow \hat o_{t+1:t+H}. \]
策略回答“现在应该做什么”,世界模型回答“如果这样做,之后会发生什么”。二者结合后,可以先预测多个候选行为的结果,再选择更安全或更有价值的行为。
未来的重要问题包括:
- 世界模型应采用二维视频、三维场景还是结构化对象表征?
- 是否加入几何、接触和守恒定律等结构先验?
- 如何结合数据驱动学习与物理模型?
- 模型预测质量与真实任务成功率是否具有稳定相关性?
7.4 面向具身智能的基础模型
通用 LLM/VLM 主要从互联网文本和图像中学习,并非为物理交互设计,因此可能缺乏几何、接触、可供性和动力学理解。机器人需要的不只是“知道物体是什么”,还要知道“从哪里抓、施加多大力、动作后会发生什么”。
一个发展方向是把从人类反馈强化学习扩展为从具身反馈强化学习(RL from Embodied Feedback):利用执行成功、碰撞、力觉、轨迹偏差和环境变化等反馈改进策略。
7.5 适应、终身学习与系统工程
部署后的机器人需要:
- 适应新场景、物体与硬件变化;
- 适应不同用户的偏好;
- 从成功和失败经验中持续自我改进;
- 避免学习新技能时遗忘旧技能。
同时,机器人研究本质上是系统工程。即使模型本身表现良好,传感延迟、推理速度、控制频率、模块通信、时间同步、错误恢复和算力限制仍可能使系统失败。端到端模型不能消除系统级约束。
8 全课方法对比与复习要点
8.1 方法总览
| 方法 | 主要监督信号 | 是否显式学习世界模型 | 优点 | 核心问题 |
|---|---|---|---|---|
| 无模型强化学习 | 环境奖励 | 否 | 可直接优化长期回报 | 样本效率低,探索不安全 |
| 基于模型的学习与规划 | 转移数据与任务目标 | 是 | 可预演后果、提高样本效率 | 模型误差会被规划器利用 |
| 行为克隆 | 专家状态—动作对 | 否 | 简单稳定,无需奖励设计 | 分布偏移与误差累积 |
| 迭代专家示范 | 当前策略访问状态上的专家标签 | 否 | 学到偏离后的恢复行为 | 需要持续专家参与 |
| 逆强化学习 | 专家轨迹 | 学奖励函数 | 能表达专家意图并潜在迁移 | 奖励歧义,计算代价高 |
| 隐式行为克隆 | 专家动作与对比动作 | 否 | 适合多峰动作分布 | 推理需搜索最小能量动作 |
| 扩散策略 | 专家动作序列 | 否 | 高维、多模态、时间一致 | 多步采样产生延迟 |
| 机器人基础模型 | 大规模多任务、跨本体交互数据 | 通常直接学策略 | 通用性与迁移潜力强 | 数据、评估、安全和系统可靠性 |
8.2 高频理解题
- 为什么机器人视觉是具身、主动且情境化的? 因为机器人有物理身体,能主动改变视角和环境,而且感知必须服务于当前时刻的闭环行为。
- 为什么 RL 数据不是固定分布? 策略决定动作,动作决定下一个状态,所以策略更新会改变后续训练数据的分布。
- 为什么 BC 会发生复合误差? 训练只覆盖专家状态,部署时的小误差会把策略带入未见状态,之后错误继续累积。
- 为什么 MPC 只执行第一步再规划? 用新的真实观测反复纠正模型预测误差,降低长时开环规划的误差累积。
- 像素、关键点、粒子状态如何取舍? 像素信息最完整但维度高;关键点紧凑却可能漏掉形变;粒子适合复杂材料但建模与计算更困难。
- 隐式策略和扩散策略为何适合机器人动作? 机器人示范常具有多种合理解;它们能表达多峰分布,避免回归平均得到无效动作。
- 为什么训练损失不能代替真实成功率? 代理损失、闭环误差累积、分布偏移和现实噪声都会破坏两者的对应关系。
- 基础策略与基础世界模型有什么互补性? 前者提出动作,后者预测动作后果;结合后可比较候选方案并进行规划或安全检查。
8.3 一句话主线
本讲的逻辑可以概括为:机器人先通过多模态感知理解当前世界,再用强化学习、世界模型规划或专家示范学习动作;大规模跨任务数据进一步催生通用机器人策略,而可靠评估、物理世界建模、持续适应与系统工程仍是走向通用具身智能的关键瓶颈。